阅读时间:约 42 分钟 难度:进阶 前置知识:面向对象设计基础、软件架构基本概念 分类:工程效能、测试与 DDD
大纲
- 引子:为什么代码写着写着就变成"大泥球"
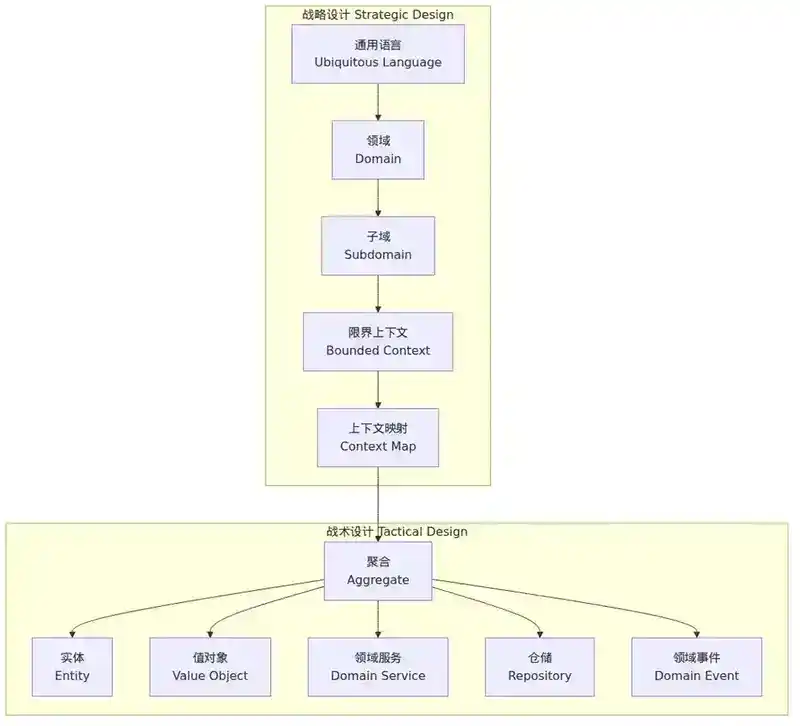
- DDD 全景:战略设计与战术设计的分工
- 通用语言(Ubiquitous Language):团队说同一种话
- 领域与子域:把问题空间切开来看
- 限界上下文(Bounded Context):模型的有效边界
- 上下文映射(Context Map):限界上下文之间的关系
- 从战略到战术:如何落地一个限界上下文
- 常见误区与反模式
- 本章小结
- 面试追问(Q&A)
一、引子:为什么代码写着写着就变成"大泥球"
想象一个电商系统——最初只是"用户下单、支付、发货"三个模块。半年后,营销团队要求加优惠券,运营团队要求加活动页,财务团队要求加发票和对账。每个需求来了,开发者在现有代码上打补丁:Order 类塞进了优惠计算逻辑,User 类挂上了会员等级和积分,Product 类开始关心库存预警……
两年后,你打开这个项目,看到的是一个 3000 行的 OrderService,里面混杂了支付回调、库存扣减、优惠计算、物流通知、发票开具——没人敢动,因为动一处可能炸十处。
这就是 Martin Fowler 所说的 大泥球(Big Ball of Mud)。它的根本原因不是代码写得烂,而是团队对"这个系统到底在做什么"没有统一的认知模型——每个人理解的"订单"不一样:营销眼里的订单是"转化",仓储眼里的订单是"拣货单",财务眼里的订单是"应收"。当所有这些理解被塞进同一个类、同一张表、同一个服务时,混乱是必然的。
领域驱动设计(Domain-Driven Design,DDD)正是为了解决这个问题而生。它的核心洞察是:软件的核心复杂度不在技术,而在业务领域本身。DDD 把应对这种复杂度的方法分成两个层次——战略设计(宏观)和战术设计(微观)。本文聚焦战略设计。
二、DDD 全景:战略设计与战术设计的分工
在深入细节之前,先建立全局视角。Eric Evans 在 2003 年出版的《领域驱动设计》中将 DDD 分为两大块:
| 层次 | 关注点 | 核心工具 | 回答的问题 |
|---|---|---|---|
| 战略设计 | 业务领域的整体结构 | 领域、子域、限界上下文、上下文映射、通用语言 | "我们在做什么?边界在哪里?各模块如何协作?" |
| 战术设计 | 单个限界上下文内部的设计 | 实体、值对象、聚合、领域服务、仓储、领域事件 | "这个边界内部的代码怎么写?" |
战略设计画地图,战术设计盖房子。 没有地图就盖房,结果就是——房子盖在沼泽地上,地基歪了,后面怎么修都是歪的。
本文覆盖战略设计的五个核心概念。它们的逻辑关系是:
通用语言(贯穿全程)
    ↓
领域 → 拆分为 → 子域(核心域 / 支撑子域 / 通用子域)
    ↓
每个子域 → 映射到 → 一个或多个限界上下文
    ↓
限界上下文之间 → 通过 → 上下文映射 → 定义协作关系
三、通用语言(Ubiquitous Language):团队说同一种话
3.1 什么叫"通用语言"
想象一个需求评审会:
- 产品经理说:"用户下单后,如果 30 分钟没支付,订单就自动取消。"
- 开发听完,在代码里定义了一个
OrderStatus.CANCELLED。 - DBA 建表时用了字段名
is_canceled(只用一个 l)。 - 测试写的用例标题是"超时未支付订单自动关闭"。
同一个概念——"取消订单"——在不同角色嘴里是完全不同的词。当系统规模扩大,这种术语分裂导致:
- 代码里的
cancel、canceled、cancelled、close、expire混用 - 产品说的"订单关闭"和开发理解的"订单取消"是两件事
- 新人入职半年搞不清一个业务词的确切含义
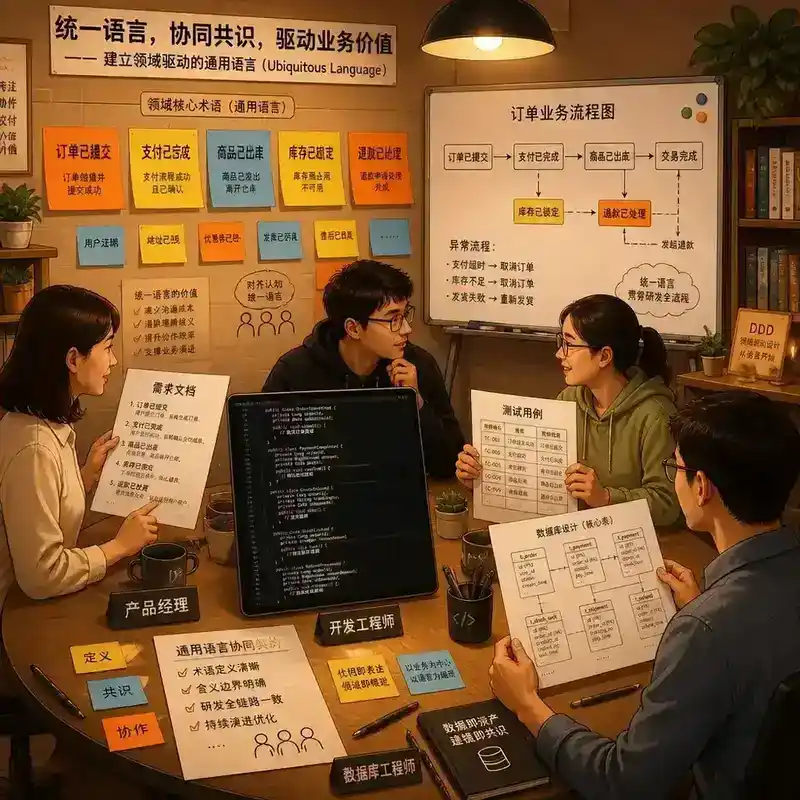
通用语言就是:团队(业务专家 + 开发 + 测试 + 运维)共同维护的一套术语表,每个术语有唯一、精确的定义,并且直接出现在代码中。
3.2 通用语言的核心原则
原则一:术语必须出现在代码里。
如果领域专家说"订单履约",那么代码里应该有 Fulfillment、FulfillmentService,而不是一个叫 OrderProcessManager 的东西。代码中的类名、方法名、变量名就是通用语言的具象化。
// ❌ 领域专家说"履约",代码叫 process
orderService.process(orderId, warehouseId);

// ✅ 领域专家说"履约",代码就叫 fulfill
fulfillmentService.fulfill(orderId, warehouseId);
原则二:一个概念在"它的"限界上下文内只有一种含义。
同一个词在不同上下文中可以有不同定义。比如"客户"——在 CRM 上下文里关心的是联系方式、等级、跟进记录;在订单上下文里关心的是收货地址、支付偏好。不需要强行统一——这正是限界上下文的由来。
原则三:通用语言是活的,随业务演化。
每发现一个"产品和开发对同一个词的理解不一样"的时刻,就是一次完善通用语言的机会。这不是一次性文档,而是持续演化的团队资产。
3.3 如何建立通用语言
- 事件风暴(Event Storming):把领域专家和开发拉到一间屋子里,用橙色便签写"领域事件"(如"订单已提交""支付已完成""商品已出库"),在讨论中自然收敛术语。
- 术语表维护:用一张简单的 Markdown 表格记录术语定义,放在项目仓库里,随代码一起版本管理。
- 代码评审中的术语检查:CR 时如果发现代码里的命名和术语表不一致,视为阻塞性问题。
面试潜台词:当面试官问"你怎么保证业务和代码对齐",答案就是通用语言。这比"多写注释"有说服力得多。
四、领域与子域:把问题空间切开来看
4.1 什么是领域(Domain)
领域就是你正在用软件解决的那个业务范围。电商领域、物流领域、金融风控领域——这些都是领域。它不是一个技术概念,而是一个业务概念。
DDD 说的"领域"等于"问题空间"(Problem Space)。你的软件是解(Solution Space),领域是问题。理解问题的结构,才能做出匹配的解。
4.2 子域的三分类
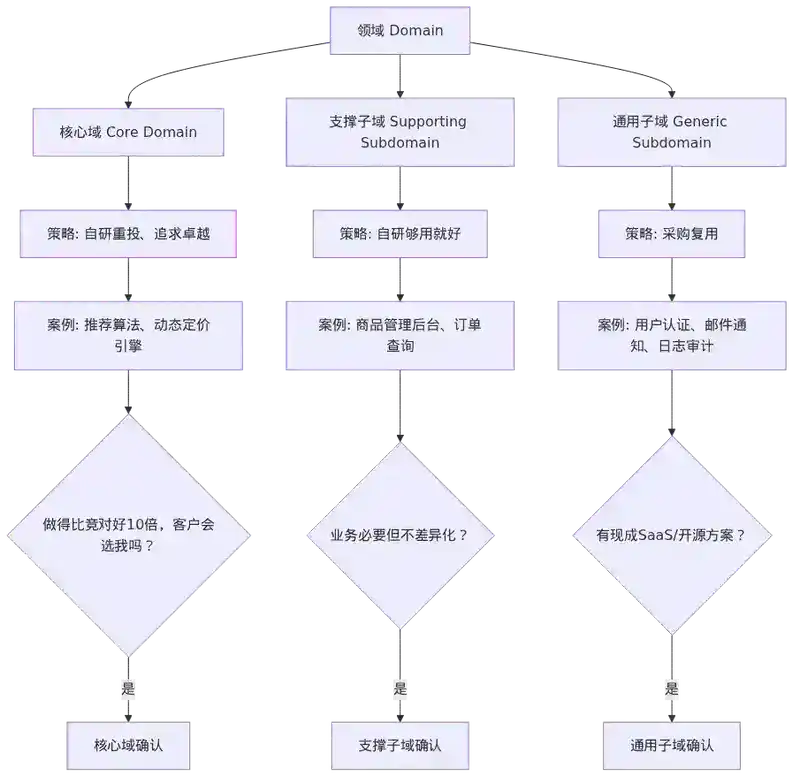
任何一个有点规模的领域,内部都会自然地分化出不同"重要性"的子领域。DDD 把它们分为三类:
| 类型 | 定义 | 特征 | 投入策略 | 电商案例 |
|---|---|---|---|---|
| 核心域(Core Domain) | 让公司区别于竞争对手的东西 | 复杂、独特、高价值 | 重兵投入,自研,追求卓越 | 推荐算法、动态定价引擎 |
| 支撑子域(Supporting Subdomain) | 支撑核心业务但不是差异化能力 | 有复杂度但非独有 | 自研或定制化外包,够用就好 | 商品管理后台、订单查询 |
| 通用子域(Generic Subdomain) | 每个公司都要做、没差异化的东西 | 成熟、有现成方案 | 采购/复用/外包,不要自研 | 用户认证、邮件通知、日志审计 |
这个三分法的真正威力不在于分类本身,而在于它直接驱动资源分配决策。
4.3 核心域的识别陷阱
很多团队会犯同一个错误:把所有东西都说成核心域。
- "登录注册当然是核心域,用户进不来怎么下单?"
- "支付是核心域,钱相关的事能不重要?"
重要的 ≠ 核心域。核心域是让你和竞争对手拉开差距的能力。京东和淘宝的登录注册都没什么区别——它是"关键但不核心"的支撑子域。但京东的仓储调度和淘宝的推荐算法就不一样——那才是各自的核心域。
判断标准:如果这个东西做得比竞争对手好 10 倍,客户会因此选你而不是竞争对手吗?如果答案是否定的——它不是核心域。
4.4 子域与组织结构
康威定律(Conway's Law)在此同样生效:系统的架构会复制组织的沟通结构。如果三个子域被扔给同一个团队做,这三个子域最终会耦合成一个——因为团队内部沟通太方便了。反之,如果核心域和支撑子域分给不同团队,且物理隔离(不同代码仓库、独立部署),各自演化的独立性就自然得到保障。
这就是 DDD 战略设计暗含的组织设计信号——子域边界 = 团队边界。
五、限界上下文(Bounded Context):模型的有效边界
5.1 概念定义
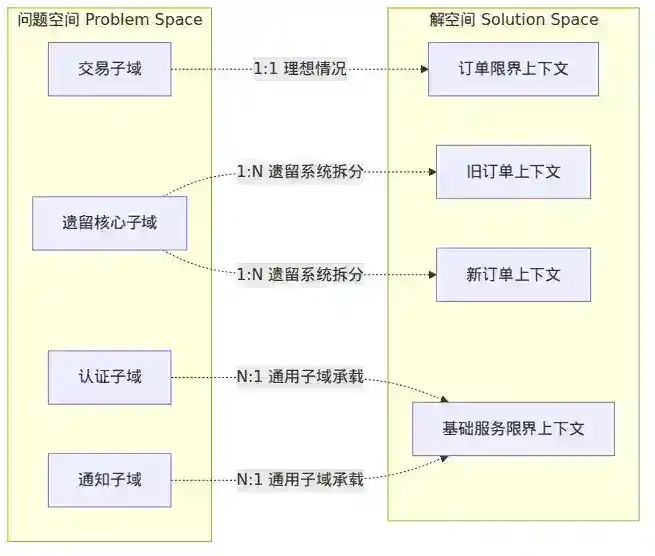
如果说"子域"是对问题空间的切分,那"限界上下文"就是对解空间的切分。它是 DDD 中最重要的概念,没有之一。
限界上下文(Bounded Context)是一个显式的边界,在这个边界内部,一个领域模型的所有术语、规则和逻辑保持一致且无歧义。
通俗理解:一个限界上下文 = 一套"方言"的有效范围。 在四川话说"鞋子"(hái zi)很正常,在普通话里就可能被理解为"孩子"。如果你知道自己在四川话的上下文里,就不会搞混。
5.2 限界上下文 vs 子域
这是最容易被混淆的两个概念:
| 维度 | 子域(Subdomain) | 限界上下文(Bounded Context) |
|---|---|---|
| 在哪一侧 | 问题空间(Problem Space) | 解空间(Solution Space) |
| 是什么 | 业务的逻辑分区 | 模型的语义边界 |
| 谁来定 | 业务专家 + 领域分析 | 架构师 + 开发团队 |
| 关系 | 一个子域对应 1~N 个限界上下文 | 一个限界上下文服务于一个子域 |
理想情况下,子域和限界上下文是一对一的。但工程现实中常有偏差:一个子域可能因为遗留系统的原因被拆成多个限界上下文,或者一个限界上下文承载了两个小通用子域的功能。
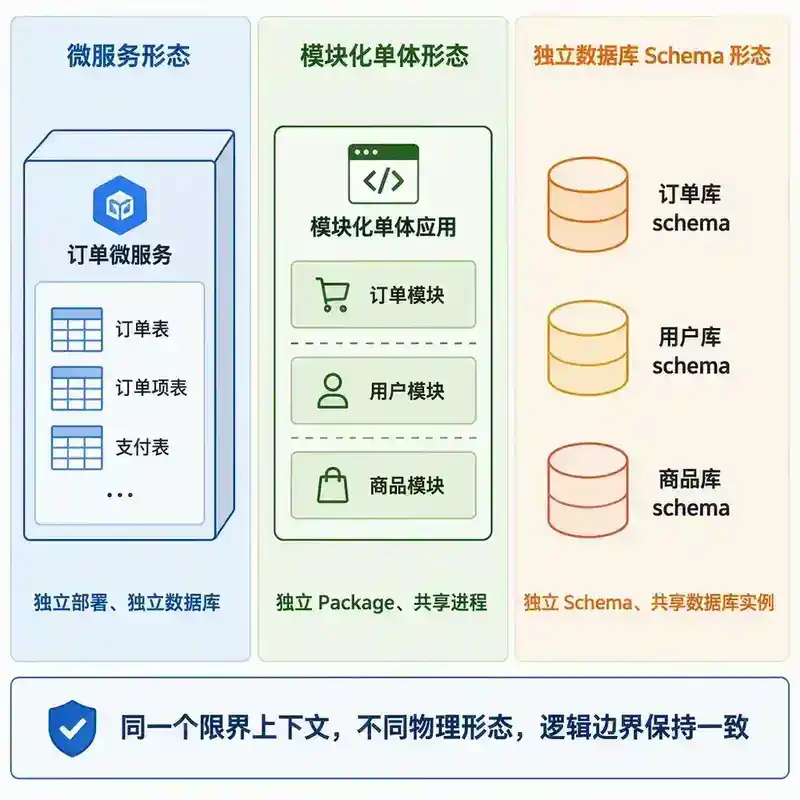
5.3 限界上下文的物理形态
限界上下文不是一个抽象概念——它最终要落地为代码。常见的物理形态包括:
- 一个微服务:最典型的实现。订单上下文 = 订单微服务。
- 一个模块/包:在模块化单体中,限界上下文表现为一个独立的 Maven/Gradle 模块。
- 一组数据库表:每个限界上下文拥有自己的数据存储,不和其他上下文共享表。
关键约束:一个限界上下文内部,一个业务概念只能有一个含义。 比如在"订单上下文"中,Order 就是买卖双方的一次交易。至于这个 Order 对应的物流状态,那是"物流上下文"的事——在那个上下文里,同一个 Order 可能被建模为 Shipment。
5.4 限界边界带来的数据策略
当团队决定"每个限界上下文有自己的数据库"时,一个经典疑问随之而来:那订单数据怎么在多个上下文之间保持一致?
答案是:它们不需要一致。它们需要各自为自己的用途持有恰好够用的数据。
- "订单上下文"有订单的完整信息:商品明细、金额、优惠、支付信息。
- "物流上下文"只关心订单中和发货相关的部分:
orderId、收货地址、商品 SKU + 数量。这些数据在"订单已支付"事件发生时通过异步消息同步过来。 - "对账上下文"只关心
orderId、实付金额、支付渠道、交易流水号。
这看起来像是"数据冗余",但它消除了跨服务的同步 RPC 调用和分布式事务——每个上下文在自己的数据上独立工作。代价是最终一致性和数据同步管道的维护成本。
认知转换:从"数据是共享资产"转向"数据是限界上下文的私有资产,通过事件共享投影"——这是微服务数据架构中最关键的一步跃迁。
六、上下文映射(Context Map):限界上下文之间的关系
6.1 什么是上下文映射
有了限界上下文,下一步自然的问题就是:它们之间怎么协作?
上下文映射(Context Map) 就是用一组标准化的关系模式来描述限界上下文之间的协作关系。它不是代码,而是一种架构沟通工具——通常画成一张图,每个框是一个限界上下文,连线标注关系类型。
6.2 七种上下文映射关系
Eric Evans 定义了以下关系模式:
1. 共享内核(Shared Kernel)
两个(或多个)上下文共享一部分模型代码。通常是两个团队协商出一块"谁改都要通知对方"的公共区域。
典型场景:订单上下文和发票上下文共享一个 Money 值对象(金额 + 币种)。不共享整个模型,只共享真正需要一致的部分。
约束:共享内核应该尽可能小,且任何修改必须双方评审通过。
2. 客户-供应商(Customer-Supplier)
一个上下文(下游/客户)依赖另一个上下文(上游/供应商)提供的能力或数据。上游有义务满足下游的合理需求,但上游掌握最终决定权。
典型场景:推荐引擎(客户)需要从商品管理上下文(供应商)获取商品信息。商品管理团队会优先处理推荐团队的需求,但商品数据模型仍由商品管理团队独立决策。
3. 遵奉者(Conformist)
下游完全接受上游的模型,不做任何翻译或适配。下游放弃了建模自主权来换取简单。
典型场景:报表上下文直接接受订单上下文的模型结构,因为报表只需要"原样展示"数据,不值得再做一层转换。
风险:如果上游模型设计糟糕,下游也跟着遭殃。选这条路的前提是你信任上游的建模水平,且下游确实没有独立的建模需求。
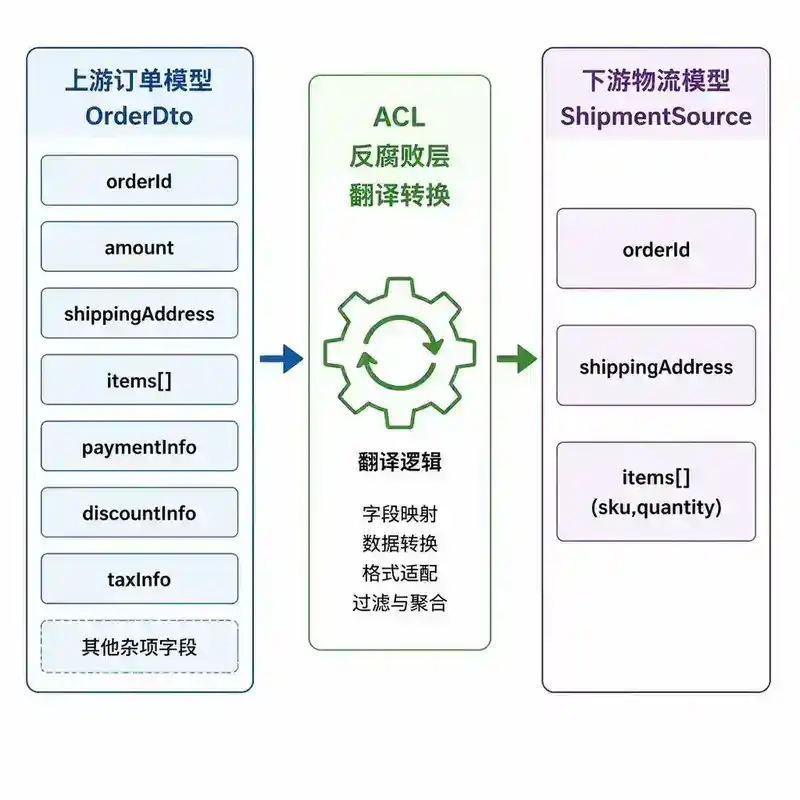
4. 反腐败层(Anticorruption Layer, ACL)
下游在上游模型和自己模型之间加一个翻译层,把上游的概念转换成自己领域的概念。这是最常用也最推荐的外部集成模式。
// 下游(物流上下文)通过 ACL 调用上游(订单上下文)的 HTTP API
public class OrderAcl {
    private final OrderApiClient orderApiClient;  // 上游的 HTTP 客户端

    public ShipmentSource translate(String orderId) {
        // 调用上游,拿到的是"订单模型"
        OrderDto upstreamOrder = orderApiClient.getOrder(orderId);

        // 翻译成"物流模型"
        return new ShipmentSource(
            upstreamOrder.getOrderId(),
            upstreamOrder.getShippingAddress(),  // 只取自己关心的字段
            upstreamOrder.getItems().stream()
                .map(item -> new ShipmentItem(item.getSku(), item.getQuantity()))
                .toList()
        );
    }
}
ACL 的价值:上游改模型、换接口、换协议——只改 ACL 内部实现,下游领域模型纹丝不动。

5. 开放主机服务(Open Host Service, OHS)
上游用一套标准化的 API(通常是 REST 或 gRPC)对外暴露服务,让下游用标准协议消费,降低下游集成的复杂度。
典型场景:用户认证上下文提供标准的 OAuth 2.0 接口,任何下游只需要遵循 OAuth 协议即可集成。
6. 发布语言(Published Language)
和 OHS 配套——上游定义的与实现无关的数据交换格式。通常表现为:
- 一套共享的 proto/avro/thrift 定义
- 一组 DTO 的 jar 包
- 一个标准的事件 schema
它和 OHS 的区别:OHS 是"怎么调",发布语言是"数据长什么样"。
7. 各行其道(Separate Ways)
两个上下文之间不需要协作——各自独立演化,不集成。这不是失败,而是清醒的选择:不是所有的限界上下文都需要互联。
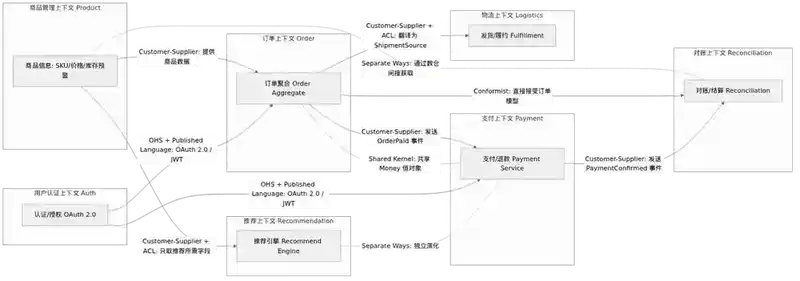
6.3 组合使用
实际架构中,很少只用一种关系。一个典型的组合:
用户认证上下文 --[OHS + Published Language]--> 订单上下文
订单上下文 --[Customer-Supplier]--> 物流上下文(通过 ACL 翻译)
支付上下文 --[Conformist]--> 对账上下文
推荐上下文 --[Customer-Supplier + ACL]--> 商品管理上下文
订单上下文 --[Shared Kernel: Money]--> 发票上下文
报表上下文 --[Separate Ways]--> 所有其他上下文(通过数仓,不直连)
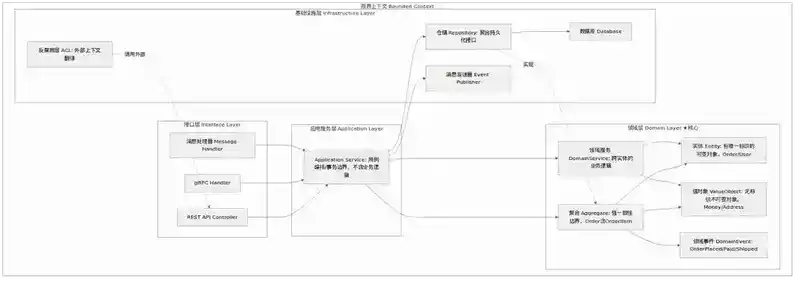
七、从战略到战术:如何落地一个限界上下文
战略设计最终要落到代码里。当你清晰地定义了一个限界上下文后,它内部的战术设计通常遵循以下分层:
限界上下文
  ├── 接口层(REST API / gRPC / 消息处理器)
  │     └── 把外部请求翻译成领域操作
  ├── 应用服务层(Application Service)
  │     └── 编排领域对象完成一个用例,不包含业务逻辑
  ├── 领域层(Domain Layer)
  │     ├── 实体(Entity):有唯一标识的可变对象,如 Order、User
  │     ├── 值对象(Value Object):无标识的不可变对象,如 Money、Address
  │     ├── 聚合(Aggregate):一组强一致性的实体和值对象的集群
  │     ├── 领域服务(Domain Service):不属于某个实体的业务逻辑
  │     └── 领域事件(Domain Event):业务中的重要事件
  └── 基础设施层(Infrastructure)
        ├── 仓储(Repository):聚合的持久化抽象
        ├── 消息发送器
        └── 外部服务客户端(ACL 所在)
战术设计的细节属于 250 号知识点,这里不展开。本文的战略设计就是为了回答:在你动手写这些代码之前,你画的那张"上下文地图"是什么?
八、常见误区与反模式
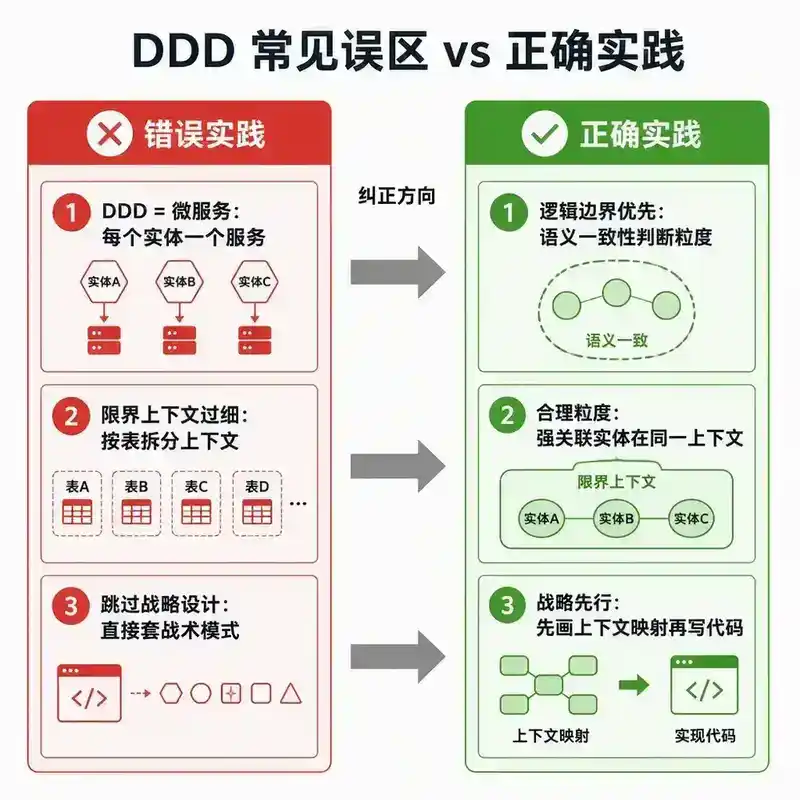
误区 1:DDD = 微服务
DDD 是 2003 年提出的,微服务是 2014 年左右兴起的。限界上下文不等于微服务。限界上下文是逻辑边界,微服务是物理边界。你可以把多个限界上下文部署在一个进程中(模块化单体),也可以把一个限界上下文拆成多个服务——虽然后者一般不建议。
误区 2:限界上下文画得太细
"每个实体一个微服务"——这是经典的反模式。限界上下文的粒度判断标准不是"这个实体大不大",而是**"这个模型里的术语能不能保持语义一致"**。Order 和 OrderItem、Payment 如果在同一个业务场景里密切相关且共享术语,就该在同一个限界上下文里。
误区 3:每个上下文一个数据库 = 数据完全不共享
"不共享数据库"不等于"不共享数据"。数据通过 API、消息、事件在上下文之间流动——共享的是数据的投影(projection),不是数据的读写权。
误区 4:把 DDD 当成"代码设计模式大全"
DDD 的核心价值在战略设计——搞清楚边界和关系。战术模式(聚合、仓储等)是锦上添花。团队最常见的问题是:跳过了战略设计直接套战术模式,然后困惑"为什么我们的代码还是有 3000 行的 Service"。
误区 5:通用语言 = 一份术语表文档
通用语言的核心不在文档,而在对话和代码。如果团队不养成"发现歧义时停下来对齐术语"的习惯,术语表写得再漂亮也是摆设。
九、本章小结
DDD 战略设计的五个概念形成了一条完整的推理链:
- 领域是你面对的业务问题空间。
- 子域帮你识别哪些部分值得重兵投入(核心域),哪些部分够用就行(支撑子域/通用子域)。
- 通用语言确保团队用一个声音说话,术语表不但写在文档里,还写在代码里。
- 限界上下文为每个子域划定模型的语义边界——边界内,一个词只有一种含义;边界间,同一个词可以有不同的建模。
- 上下文映射定义限界上下文之间的协作关系——共享内核、客户-供应商、遵奉者、反腐败层、开放主机服务、发布语言、各行其道。
把这五个概念内化之后,你再看一个软件系统,脑子里自然会出现"这里有两个上下文混在一起了""这个调用链上没有 ACL,下游被上游污染了""核心域和通用子域的投入比例失衡了"——这是从一个"写代码的人"到"设计系统的人"的关键转变。
十、面试追问(Q&A)
以下问题从面试官视角提出,旨在考察你是否真正理解 DDD 战略设计的思想而不仅仅是背诵定义。
Q1:给你一个现有的电商单体系统(20 万行 Java 代码),老板说要做微服务拆分。你用 DDD 的战略设计怎么入手?
点击展开参考答案
我不会从代码开始。第一步是拉上业务方做事件风暴,把核心业务流程用领域事件串起来,这个过程自然会发现子域边界。
第二步,识别核心域。我会问业务方两个问题:"如果这个功能做到业界第一,客户会因此选我们吗?""如果这个功能宕机 4 小时,客户会因此流失吗?"——前者的答案是核心域,后者是支撑子域中的关键部分。
第三步,划定限界上下文。规则是:如果一个概念在两个不同的上下文中含义不同(比如"订单"在交易和物流中完全不一样),就应该拆开。如果两个实体在任何场景下都是强一致性的(比如 Order 和 OrderItem),就在一个上下文里。
第四步,定义上下文映射。先识别最关键的调用链路(比如"下单"涉及哪些上下文),标注每个调用是同步还是异步、上游提供什么接口、下游用什么模式消费。
最后一步,挑一个边界最清晰、依赖最少、出问题影响最小的限界上下文,先拆出来——跑通整个流程(独立部署、数据迁移、灰度切流),积累经验后再拆核心域。
关键原则:先拆边界清晰的,再拆核心的;先拆依赖少的,再拆依赖多的。 任何企图一步到位的拆分计划都会死于复杂性。
Q2:你提到了核心域、支撑子域、通用子域的三分类。但现实中老板会说"每个功能都是核心的"。你怎么推动团队做取舍?
点击展开参考答案
这是一个组织问题,而不是技术问题。我会用三个手段:
- 用钱说话:把每个子域的投入算出来(人力、服务器成本、维护成本),放在老板面前。"我们有 10 个开发,如果所有 12 个子域都当核心域做,每个子域不到 1 个人——没有一个能做好。如果集中 5 个人做推荐引擎(核心域),2 个人维护其他(通用+支撑),推荐能比竞对好 30%。"
- 用"不做会怎样"倒推:对每个子域问"如果这个功能我们不做自研、直接用 SaaS/开源方案,业务会不会受损?"绝大多数通用子域的答案是"不会"。
- 承认现实、渐进投入:不是所有核心域一开始就看得很清楚。可以先按"疑似核心域"投入少量资源探索(spike),验证确实是差异化能力后再重兵投入。这个逻辑老板能接受。
最终,DDD 三分类的价值不在于分类的正确性,而在于它迫使团队做出有意识的资源优先级决策——而不是无意识地把资源平均撒在所有需求上。
Q3:同一个"商品"概念,在交易上下文里叫 Product,在库存上下文里叫 InventoryItem,在推荐上下文里叫 RecommendableItem。这是设计问题还是 DDD 的正确实践?
点击展开参考答案
这恰恰是 DDD 的正确实践。 这正是限界上下文的核心价值。
在交易上下文里,"商品"关心的是 SKU、价格、可售状态;在库存上下文里,"商品"关心的是数量、货位、安全库存;在推荐上下文里,"商品"关心的是类目、标签、相似度。它们不是同一个模型——强行统一成一个 Product 类会导致这个类膨胀到不合理的尺寸,而且每个上下文的需求变更都会影响其他上下文。
面试官追问:"那你怎么保证这三个上下文看到的'同一个物理商品'(比如一部 iPhone 15 128G 黑色)是关联的?"
答:通过一个全局唯一标识(如 SKU 编码)关联,但每个上下文持有自己需要的属性。库存上下文通过"商品上架"事件同步 SKU 到自己的 InventoryItem 表里,只保存 SKU、仓库 ID、数量——不关心价格和推荐标签。当商品价格变了,交易上下文更新自己的 Product 表,库存上下文不需要知道这件事。
这是数据投影模式:每个上下文拥有自己关心的数据子集的本地副本,通过领域事件保持最终一致。
Q4:如果一个限界上下文内部的代码开始膨胀到难以维护(比如超过 10 万行),你觉得应该怎么处理?
点击展开参考答案
首先,不急着拆。先问:膨胀的是业务逻辑还是技术细节?
- 如果是业务逻辑膨胀:说明一个限界上下文承载了过多的子域概念。回去重新审视子域划分——可能有一些支撑子域混进了核心域。考虑将一个限界上下文拆分成两个。
- 如果是技术细节膨胀(比如大量的数据转换、外部集成、缓存逻辑):这是战术层的问题,不是战略层的。在限界上下文内部做模块化——用 Package 隔离不同职责,或者引入 Port-Adapter(六边形架构)把技术实现和领域逻辑分离。
如果真的需要拆分,规则是:新拆分出来的限界上下文必须有自己独立的通用语言模型。 如果拆完之后两个上下文用完全相同的术语,说明拆分没有意义——只是在把一个物理服务拆成两个,而不是在做领域建模。
最后补充:一个限界上下文 10 万行并不必然意味着有问题。我见过的支付上下文(含对账、退款、分账)就是 10 万+ 行,但它内部模型一致、术语统一、变更独立——那就让它继续作为一个限界上下文存在。代码行数不是拆分与否的标准,语义一致性才是。
Q5:你们的团队刚引入 DDD,但产品经理说"我不懂什么限界上下文,我只关心需求能不能按时上线"。你怎么推动通用语言的落地而不让业务方觉得你在浪费时间搞方法论?
点击展开参考答案
不要让业务方感觉到你在"搞 DDD"。 DDD 是你的思维工具,不是你要推销给业务方的标签。
具体做法:
- 事件风暴不需要提 DDD。跟产品经理说:"我们来梳理一下关键业务流程,用便签贴在墙上,看看有哪些关键事件。"产品和开发都能参与,产出是流程图——这本身就是通用语言的物料。
- 用具体案例说明价值。不说"我们需要统一术语",而说:"上次'订单取消'这个需求,你理解的是全额退款,开发理解的是标记作废不退钱——上线后发现不对,我们花了两天改。如果一开始我们就约定好'取消'的确切含义,这两天的成本是零。"
- 术语从产品 PRD 里直接提取。不需要额外写术语表——PRD 里新出现的业务名词,开发在评审时问一句"这个是什么意思,能不能加个定义",然后记到项目 Wiki 里。每次只要加一行。
- 代码评审时对齐。TL 在 CR 时说:"你这变量叫
cancelReason,但 PRD 里说的是'作废原因',统一用voidReason。"这是最自然的通用语言落地——不需要开会。
核心思想:DDD 战略设计的产出物(通用语言、限界上下文、上下文映射)应该是团队日常工作的自然副产品,而不是额外的工作负担。
Q6:你怎么在"过度设计"和"设计不足"之间找到平衡?什么情况下你决定不需要做 DDD?
点击展开参考答案
这是一个非常好的问题——DDD 最大的陷阱就是过度使用。
我会用三个标准来判断 DDD 是否适用:
- 业务复杂度:如果系统只是 CRUD——数据进去、存起来、查出来、展示——不需要 DDD。一个后台管理系统、一个简单的数据看板,用三层架构(Controller-Service-DAO)足够了,DDD 的聚合和仓储是杀鸡用牛刀。
- 业务变化速度:如果业务逻辑频繁变化,DDD 的价值就大——因为限界上下文隔离了变更影响。如果业务很稳定(比如一个已经运行 10 年的老系统的维护),投入 DDD 改造的 ROI 很低。
- 跨团队协作规模:如果只有 3 个开发在一个代码库里工作,非正式沟通就能解决上下文混淆。但如果 5+ 个团队共享一个代码库或数据库,限界上下文和上下文映射的价值急剧上升。
避坑建议:不要上来就搞全套 DDD。选择系统中业务逻辑最复杂的 1~2 个模块,尝试用 DDD 的思维重构它们。如果产出物(通用语言、限界上下文)确实改善了沟通和代码质量,再逐步推广。如果团队觉得"这就是我们平时应该做但没做到的事"——方向对了;如果团队觉得"这些概念好难、好重"——可能这个系统不需要 DDD,或者你推得太快了。
阅读提示:如果你能流畅回答以上 6 个问题中的 4 个,说明你已经掌握了 DDD 战略设计的核心思想——不仅是"知道概念",更是"知道什么时候用、怎么推、怎么防坑"。下次面试中,主动提 DDD 战略设计而不是背战术模式,会让面试官对你的架构判断力留下更深的印象。