阅读时间:约 45 分钟 | 难度:中高级 | 分类:18 工程效能、测试与 DDD
目录
- 问题定义:为什么单元测试不够
- 测试金字塔再审视:集成测试的定位
- Testcontainers:用容器消除环境差异
- Testcontainers 核心模块深度拆解
- Spring Boot 集成测试:从 @DataJpaTest 到 @SpringBootTest
- 消费者驱动契约测试(CDC):问题的重新定义
- Pact 框架:契约测试的工业级实现
- 契约测试工作流:从消费者到提供者的闭环
- 测试环境治理:告别「环境能跑就行」
- 测试数据管理:造数、隔离与清理
- CI/CD 中的集成测试策略:速度与信心的平衡
- 常见反模式与避坑指南
- 面试追问与参考答案
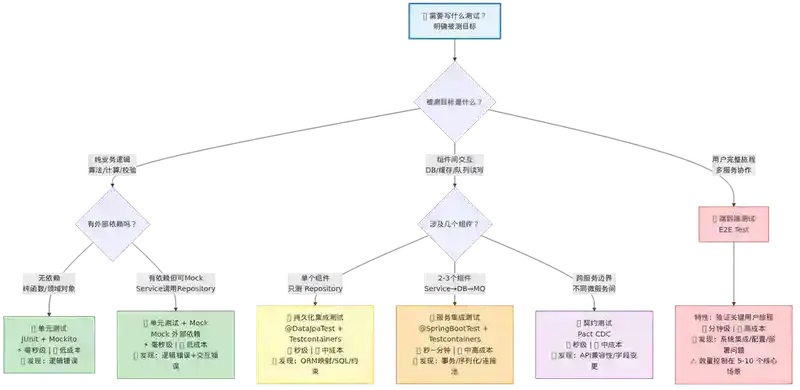
1. 问题定义:为什么单元测试不够
单元测试验证的是隔离单元的正确性——你 Mock 了所有外部依赖,确认 UserService.register() 在「数据库返回成功」的假设下,正确地调用了 EmailService.sendWelcomeEmail()。这很好,但问题在于:Mock 的假设可能和真实行为不一致。
举个真实的翻车案例:
// 单元测试中 Mock 了 Repository
when(userRepository.save(any(User.class))).thenReturn(savedUser);
when(emailService.sendWelcomeEmail(anyString())).thenReturn(true);

// 测试通过 ✓
User result = userService.register("alice@example.com", "password123");
assertEquals("alice@example.com", result.getEmail());
你上线后发现:数据库的 email 字段有唯一约束,但 password 字段长度只有 20 个字符,"password123" 恰好是 11 个字符,而生产环境中用户密码经过 BCrypt 编码后固定 60 个字符——直接写不进去。
这不是虚构的。单元测试无法覆盖的问题包括:
| 问题类型 | 单元测试能发现吗? | 真实案例 |
|---|---|---|
| ORM 映射错误(字段名拼写、类型不匹配) | ❌ | @Column(name = "create_at") vs 数据库 created_at |
| SQL 方言差异 | ❌ | H2 的 LIMIT 1 vs MySQL 的 LIMIT 1 没问题,但 MERGE 语句完全不同 |
| 序列化/反序列化不兼容 | ❌ | JSON 字段新增 isActive,消费者还在读 active |
| 数据库约束冲突 | ❌ | 唯一索引、外键级联、检查约束 |
| 消息队列契约不一致 | ❌ | 生产者发 {"orderId": 123},消费者期望 {"order_id": 123} |
| 连接池耗尽 | ❌ | 集成测试中真实连接泄露会在几秒内暴露 |
| 事务传播行为异常 | ❌ | REQUIRES_NEW 在单元测试中 Mock 了事务管理器,看不出嵌套回滚问题 |
集成测试的核心价值不是替代单元测试,而是验证组件之间的交互契约——包括与数据库、消息队列、外部 HTTP 服务、文件系统等基础设施的真实交互。
把集成测试理解为「验证假设」的活动会更有用:单元测试验证业务逻辑,集成测试验证你对依赖行为的假设是否正确。
2. 测试金字塔再审视:集成测试的定位
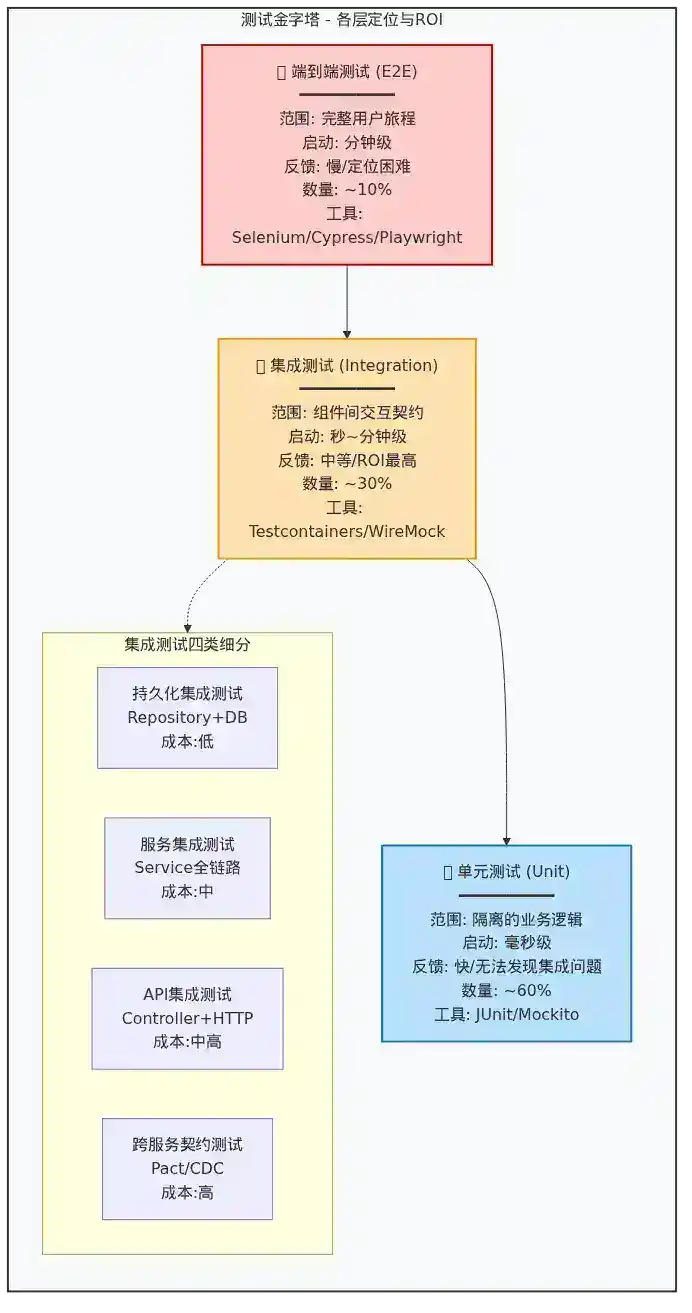
经典测试金字塔告诉我们:单元测试多、集成测试少、端到端测试极少。但实际项目中,很多人把这句话理解成了「尽量少写集成测试,最好不写」——这是对金字塔的误读。
金字塔的核心不是数量,而是 ROI(投资回报率):
                    执行速度
                    ↑
        ┌──────────┐
        │   E2E    │  慢(分钟级)  → 覆盖面广,但定位问题难
        ├──────────┤
        │ 集成测试  │  中(秒~分钟)→ 验证组件交互,ROI 最高
        ├──────────┤
        │ 单元测试  │  快(毫秒级)  → 验证逻辑正确性,但无法发现集成问题
        └──────────┘
                    → 反馈精度
一个健康的测试策略应该是:
- 单元测试(~60%):验证纯业务逻辑,不依赖外部系统
- 集成测试(~30%):验证与外部系统的正确交互,使用真实依赖或轻量替代
- 端到端测试(~10%):验证关键用户旅程,确保系统整体可用
注意这个比例不是死板的教条。对于一个数据密集型应用(报表系统、ETL 管道),集成测试的比例应该远高于 30%;对于一个纯计算库(加密算法库、数学工具库),单元测试可能占 90% 以上。
集成测试的进一步分类(按范围从小到大):
- 持久化集成测试:只测试 Repository 层与真实数据库的交互
- 服务集成测试:测试 Service 层的完整链路,带真实数据库和消息队列
- API 集成测试:通过 HTTP 请求测试 Controller 层,带真实依赖
- 跨服务契约测试:验证两个服务之间的 API 契约一致性
这四种测试的执行成本递增,应当根据风险和变更频率决定每层的覆盖密度。
3. Testcontainers:用容器消除环境差异
在 Testcontainers 出现之前,集成测试的环境管理是一个噩梦:
- 团队成员的本地 MySQL 版本各不相同(5.6、5.7、8.0)
- CI 环境的 PostgreSQL 带有某些插件,本地没有
- 「在我机器上能跑」成了集成测试领域最常见的话
- 用 H2 内存数据库代替 PostgreSQL 跑测试,结果上线后因为
jsonb类型不支持而炸了
Testcontainers 的核心理念简单到残酷:用 Docker 容器提供与生产环境一致的依赖服务,测试结束后自动销毁。
3.1 第一个 Testcontainers 测试
@Testcontainers
class UserRepositoryTest {

    @Container
    static PostgreSQLContainer<?> postgres = new PostgreSQLContainer<>("postgres:15")
            .withDatabaseName("testdb")
            .withUsername("test")
            .withPassword("test");

    @DynamicPropertySource
    static void configureProperties(DynamicPropertyRegistry registry) {
        registry.add("spring.datasource.url", postgres::getJdbcUrl);
        registry.add("spring.datasource.username", postgres::getUsername);
        registry.add("spring.datasource.password", postgres::getPassword);
    }

    @Autowired
    private UserRepository userRepository;

    @Test
    void shouldPersistAndRetrieveUser() {
        User user = new User("alice@example.com", "Alice");
        userRepository.save(user);

        Optional<User> found = userRepository.findByEmail("alice@example.com");
        assertThat(found).isPresent();
        assertThat(found.get().getName()).isEqualTo("Alice");
    }
}
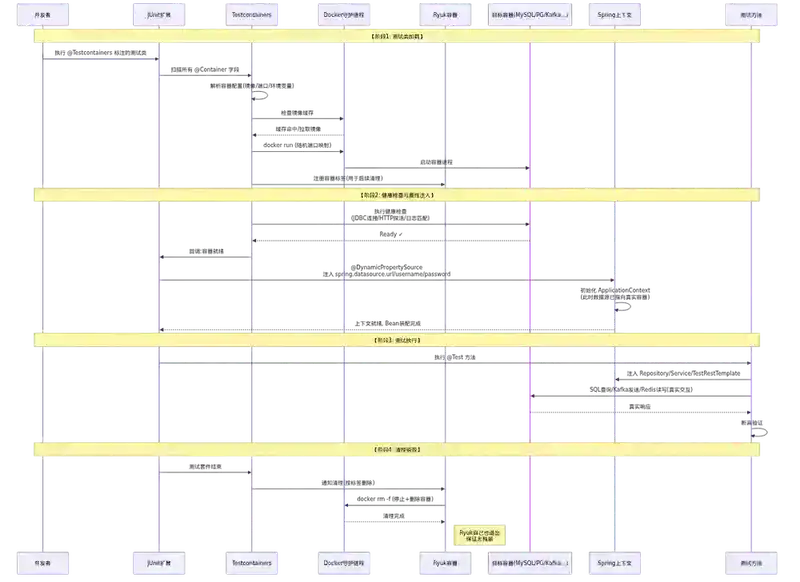
这段代码做了什么:
@Testcontainers激活 Testcontainers 的 JUnit 5 扩展@Container static确保同一个容器在所有测试方法间复用(类级别单例)@DynamicPropertySource在 Spring 上下文启动之前动态注入数据库连接信息- 测试结束后,Testcontainers 自动停止并删除容器
3.2 为什么 Testcontainers 比嵌入式数据库好
很多人问:「用 H2 不就行了?又轻又快。」答案是不行,因为集成测试的目的是验证假设,而 H2 让你建立的是错误的假设:
// 这条 SQL 在 H2 上正常运行,在 PostgreSQL 上直接报错
@Query("SELECT * FROM users WHERE metadata->>'role' = :role")
List<User> findByRole(@Param("role") String role);
H2 的 ->> 运算符行为和 PostgreSQL 不完全一致。你用 H2 跑通了这个测试,然后坚信代码没问题——这就是最危险的假阳性。
Testcontainers 的成本并非零(容器启动 2-5 秒),但换来的是真正的信心。如果你担心速度,可以通过以下方式优化:
static容器在同一个测试类中复用,不会每个@Test都重启- 使用
ryuk容器(Testcontainers 自动管理)统一清理,无需手动维护 - CI 中预拉取镜像,避免每次下载
4. Testcontainers 核心模块深度拆解
Testcontainers 提供了专用模块来简化常见中间件的配置。每个模块封装了镜像选择、端口映射、健康检查和 API 适配。
4.1 数据库模块
// MySQL
@Container
static MySQLContainer<?> mysql = new MySQLContainer<>("mysql:8.0");

// PostgreSQL
@Container
static PostgreSQLContainer<?> postgres = new PostgreSQLContainer<>("postgres:15");

// 通过 TC_INITSCRIPT 初始化表结构
@Container
static PostgreSQLContainer<?> postgresWithSchema = new PostgreSQLContainer<>("postgres:15")
        .withInitScript("schema.sql");
关键细节:
- 容器启动后会等待数据库 ready(通过 JDBC 连接探测),不会出现测试先于数据库启动的竞态
withInitScript在容器启动后、Spring 上下文初始化前执行,保证 schema 就绪- 多个
@Container static数据库可以同时运行,端口自动映射不冲突
4.2 Kafka 模块
@Container
static KafkaContainer kafka = new KafkaContainer(
        DockerImageName.parse("confluentinc/cp-kafka:7.5.0"));

@DynamicPropertySource
static void kafkaProperties(DynamicPropertyRegistry registry) {
    registry.add("spring.kafka.bootstrap-servers", kafka::getBootstrapServers);
}
Kafka 集成测试的常见陷阱:容器内 Kafka 广告给外部的地址需要特殊配置。Testcontainers 的 KafkaContainer 内置了这个处理,但如果你用 GenericContainer 手动启动 Kafka,会发现消费者连不上——因为 Kafka 默认广告的是容器内部 IP。
4.3 Redis 模块
@Container
static GenericContainer<?> redis = new GenericContainer<>("redis:7-alpine")
        .withExposedPorts(6379);
4.4 自定义 Dockerfile 容器
@Container
static GenericContainer<?> customService = new GenericContainer<>(
        new ImageFromDockerfile()
                .withDockerfile(Paths.get("src/test/resources/Dockerfile")))
        .withExposedPorts(8080)
        .waitingFor(Wait.forHttp("/health").forStatusCode(200));
当你需要测试与一个内部微服务的集成时,可以直接用项目的 Dockerfile 构建镜像并启动——确保测试环境与生产部署完全一致。
4.5 容器生命周期管理
理解 Testcontainers 的生命周期对于高效使用至关重要:
@Container static    → JVM 内共享,测试类间复用(通过 ryuk 管理)
@Container instance  → 每个测试类独立容器
手动 start/stop      → 完整控制权,适合非 JUnit 场景
static 容器在 Testcontainers 中的实现:容器进程独立于 JVM(通过 Docker daemon),所以即使 JVM 崩溃,ryuk 容器也会按标签清理资源。
5. Spring Boot 集成测试:从 @DataJpaTest 到 @SpringBootTest
Spring Boot 为不同粒度的集成测试提供了分层注解,选择正确的注解可以显著影响测试执行速度。
5.1 测试切片(Test Slices)
| 注解 | 加载的 Bean | 适用场景 | 启动时间 |
|---|---|---|---|
@DataJpaTest |
Repository + EntityManager + 数据源 | 持久化层测试 | ~2s |
@DataJdbcTest |
JdbcTemplate + 数据源 | 纯 JDBC 测试 | ~1s |
@JdbcTest |
JdbcTemplate + 数据源(无 Repository) | SQL 脚本验证 | ~1s |
@DataMongoTest |
MongoTemplate + MongoDB Repository | MongoDB 测试 | ~2s |
@JsonTest |
Jackson ObjectMapper | 序列化/反序列化 | <1s |
@RestClientTest |
RestTemplate/WebClient Builder | HTTP 客户端测试 | ~1s |
@WebMvcTest |
Controller + MVC 基础设施 | Controller 层 | ~2s |
@WebFluxTest |
WebFlux Controller | 响应式 Controller | ~2s |
@SpringBootTest |
完整 ApplicationContext | 端到端集成测试 | 5-15s |
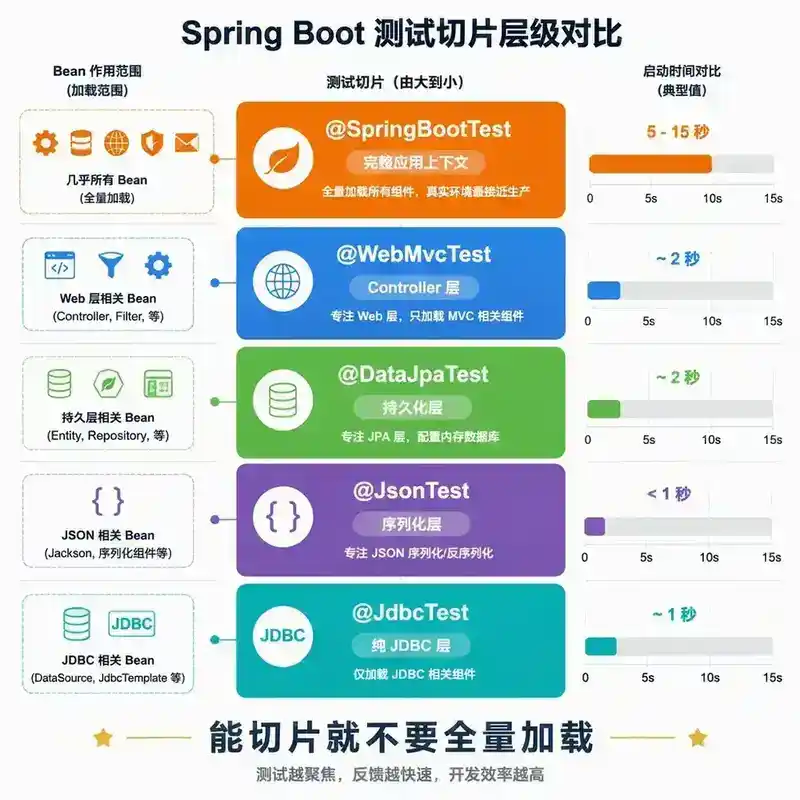
核心原则:能切片就不要全量加载。@DataJpaTest 只加载持久化相关 Bean,比 @SpringBootTest 快 3-5 倍。
5.2 @DataJpaTest + Testcontainers 实战
@DataJpaTest
@Testcontainers
class OrderRepositoryTest {

    @Container
    static PostgreSQLContainer<?> postgres = new PostgreSQLContainer<>("postgres:15");

    @DynamicPropertySource
    static void datasourceConfig(DynamicPropertyRegistry registry) {
        registry.add("spring.datasource.url", postgres::getJdbcUrl);
        registry.add("spring.datasource.username", postgres::getUsername);
        registry.add("spring.datasource.password", postgres::getPassword);
    }

    @Autowired
    private OrderRepository orderRepository;

    @Autowired
    private TestEntityManager em;

    @Test
    void shouldFindOrdersByStatus() {
        // TestEntityManager 提供便捷的 persistAndFlush
        Order order = new Order("ORD-001", OrderStatus.PENDING);
        em.persistAndFlush(order);

        List<Order> pending = orderRepository.findByStatus(OrderStatus.PENDING);
        assertThat(pending).hasSize(1);
    }
}
注意:@DataJpaTest 默认会尝试配置一个嵌入式数据库(H2)。当检测到 Testcontainers 注入的 DataSource 时,它会自动使用该数据源。但如果不想有任何歧义,可以在 application-test.properties 中排除自动配置:
spring.autoconfigure.exclude=org.springframework.boot.autoconfigure.jdbc.DataSourceAutoConfiguration
5.3 多容器集成测试
@SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT)
@Testcontainers
class OrderServiceIntegrationTest {

    @Container
    static PostgreSQLContainer<?> postgres = new PostgreSQLContainer<>("postgres:15");

    @Container
    static KafkaContainer kafka = new KafkaContainer(
            DockerImageName.parse("confluentinc/cp-kafka:7.5.0"));

    @Container
    static GenericContainer<?> redis = new GenericContainer<>("redis:7-alpine")
            .withExposedPorts(6379);

    @DynamicPropertySource
    static void properties(DynamicPropertyRegistry registry) {
        registry.add("spring.datasource.url", postgres::getJdbcUrl);
        registry.add("spring.datasource.username", postgres::getUsername);
        registry.add("spring.datasource.password", postgres::getPassword);
        registry.add("spring.kafka.bootstrap-servers", kafka::getBootstrapServers);
        registry.add("spring.redis.host", redis::getHost);
        registry.add("spring.redis.port", () -> redis.getMappedPort(6379));
    }

    @Autowired
    private TestRestTemplate restTemplate;

    @Autowired
    private KafkaTemplate<String, Object> kafkaTemplate;

    @Test
    void shouldCreateOrderAndPublishEvent() {
        // 1. 发送 HTTP 请求创建订单
        OrderRequest request = new OrderRequest("item-1", 2);
        ResponseEntity<OrderResponse> response = restTemplate.postForEntity(
                "/api/orders", request, OrderResponse.class);

        assertThat(response.getStatusCode()).isEqualTo(HttpStatus.CREATED);
        String orderId = response.getBody().getOrderId();

        // 2. 验证 Kafka 消息已发送(使用 Awaitility 轮询等待)
        await().atMost(5, TimeUnit.SECONDS)
                .untilAsserted(() -> {
                    ConsumerRecord<String, Object> record = consumeOne("order-created");
                    assertThat(record.key()).isEqualTo(orderId);
                });

        // 3. 验证数据库状态
        Order savedOrder = orderRepository.findById(orderId).orElseThrow();
        assertThat(savedOrder.getStatus()).isEqualTo(OrderStatus.CREATED);
    }
}
多容器测试的关键点:
- 所有容器都是
static级别,测试类间复用 @SpringBootTest(webEnvironment = RANDOM_PORT)启动嵌入式 Web 服务器TestRestTemplate提供 HTTP 客户端,自动解析相对路径Awaitility处理异步验证(Kafka 消息消费是异步的)
6. 消费者驱动契约测试(CDC):问题的重新定义
6.1 传统集成测试的困境
微服务架构下,假设有一个订单服务(Order Service)消费用户服务(User Service)的 API:
Order Service (消费者)  ───HTTP───>  User Service (提供者)
需要: GET /users/{id} 返回 {id, name, email}
传统的端到端测试方案是:启动两个服务,发请求,检查结果。问题:
- 环境耦合:测试 Order 需要 User 可用
- 反馈慢:启动两个服务 + 数据库 = 30 秒起步
- 覆盖不完整:只有同时修改两个服务的测试才能发现 API 不兼容问题
6.2 契约测试的思维转变
契约测试(Contract Testing)的核心思想是让消费者定义它需要的 API 形态,然后由提供者验证自己是否满足所有消费者的期望。
这背后的哲学转变很重要:
| 传统思维 | 契约测试思维 | |
|---|---|---|
| 谁定义 API? | 提供者定义,消费者适应 | 消费者表达需求,提供者满足 |
| 如何发现不兼容? | 联调/集成环境/E2E 测试 | 提供者 CI 中自动验证所有契约 |
| 修改 API 的风险 | 不知道谁在用,不敢改 | 契约文件明确记录了所有消费者依赖 |
| 测试隔离性 | 需要启动依赖服务 | 消费者和提供者独立验证 |
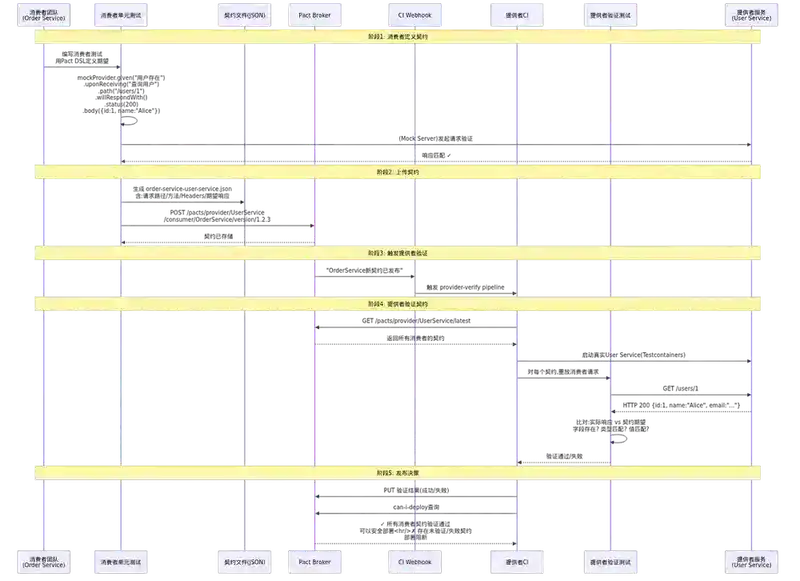
6.3 消费者驱动契约(CDC)工作流
1. 消费者编写测试 → 生成契约文件(JSON)
2. 契约文件发布到 Pact Broker(契约交换中心)
3. 提供者 CI 拉取契约文件 → 验证 API 满足契约
4. Broker 提供兼容性矩阵 → 告知是否可以安全部署
契约文件是一个 JSON 文档,描述了:
{
  "consumer": { "name": "Order Service" },
  "provider": { "name": "User Service" },
  "interactions": [
    {
      "description": "获取用户信息",
      "request": {
        "method": "GET",
        "path": "/users/123",
        "headers": { "Accept": "application/json" }
      },
      "response": {
        "status": 200,
        "headers": { "Content-Type": "application/json" },
        "body": {
          "id": 123,
          "name": "Alice",
          "email": "alice@example.com"
        }
      }
    }
  ]
}
这个文件的核心含义是:Order Service 期望 User Service 的**GET /users/123**返回如上格式的 JSON。提供者的 CI 会用这个文件重放请求,验证真实 API 的返回是否匹配。
7. Pact 框架:契约测试的工业级实现
Pact 是目前最成熟的 CDC 框架,支持 Java、JavaScript、Go、Python 等主要语言。它的核心理念是「为契约而测试,而非为集成而测试」。
7.1 消费者端:生成契约
@ExtendWith(PactConsumerTestExt.class)
@PactTestFor(providerName = "UserService", port = "8080")
class OrderServiceConsumerPactTest {

    @Pact(consumer = "OrderService")
    public V4Pact createUserPact(PactDslWithProvider builder) {
        return builder
            .given("用户 123 存在")
            .uponReceiving("获取用户信息请求")
                .path("/users/123")
                .method("GET")
                .headers("Accept", "application/json")
            .willRespondWith()
                .status(200)
                .headers(Map.of("Content-Type", "application/json"))
                .body(newJsonBody(body -> {
                    body.stringType("name", "Alice");
                    body.stringType("email", "alice@example.com");
                    body.integerType("id", 123);
                }).build())
            .toPact(V4Pact.class);
    }

    @Test
    @PactTestFor(pactMethod = "createUserPact")
    void shouldFetchUser(MockServer mockServer) {
        // Pact 启动了一个 Mock Server,行为与契约定义一致
        UserClient client = new UserClient(mockServer.getUrl());

        User user = client.getUser(123L);

        assertThat(user.getName()).isEqualTo("Alice");
        assertThat(user.getEmail()).isEqualTo("alice@example.com");
    }
}
这段代码的关键理解:
@Pact方法定义了期望的交互——这不是测试,而是契约文档- Pact 框架基于这个定义启动一个 Mock HTTP Server
@Test方法所用的UserClient连接到 Mock Server,验证消费者的代码正确解析了响应- 测试通过后,Pact 自动生成契约 JSON 文件到
target/pacts/
7.2 提供者端:验证契约
@Provider("UserService")
@PactBroker(url = "https://pact-broker.example.com")
@SpringBootTest(webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT)
class UserServiceProviderPactTest {

    @LocalServerPort
    private int port;

    @BeforeEach
    void setUp(PactVerificationContext context) {
        context.setTarget(new HttpTestTarget("localhost", port));
    }

    @TestTemplate
    @ExtendWith(PactVerificationInvocationContextProvider.class)
    void verifyPacts(PactVerificationContext context) {
        context.verifyInteraction();
    }

    // 设置提供者状态:Pact 的 given() 会触发此方法
    @State("用户 123 存在")
    void user123Exists() {
        userRepository.save(new User(123L, "Alice", "alice@example.com"));
    }
}
提供者验证的核心流程:
- 从 Pact Broker 拉取所有消费者的契约文件
- 启动提供者服务(这里是 Spring Boot 应用)
- 按契约文件中的
request向真实服务发送 HTTP 请求 - 检查真实响应的状态码、Header 和 Body 是否与契约匹配
- 将验证结果回传给 Pact Broker
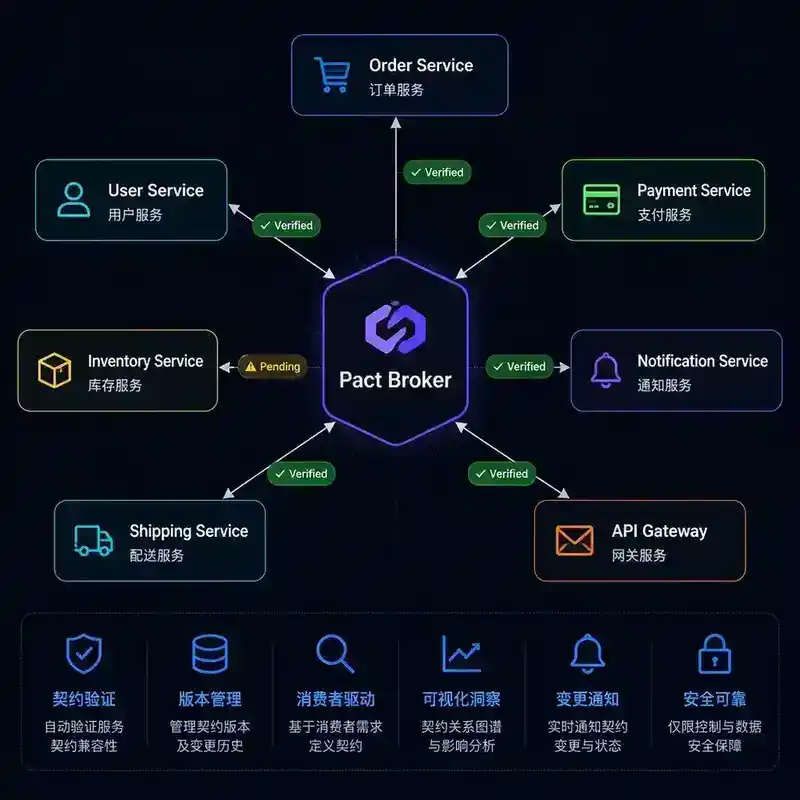
7.3 Pact Broker:契约交换中心
Broker 是 Pact 生态的关键组件,它不仅是契约文件的存储,更是服务间关系拓扑的可视化工具。
Broker 提供的关键能力:
- 兼容性矩阵(Can I Deploy?):查询某个服务的某个版本是否可以安全部署
- Webhook:提供者验证通过后自动触发下游消费者的 CI
- 版本标记:标记契约版本为
production/staging,区分生产流量和开发流量 - 网络图:可视化所有服务间的契约依赖关系
Pact Broker 页面(概念上):
┌────────────────────────────────────────────┐
│ Order Service (Consumer)                    │
│  ├── 期望 User Service 的 GET /users/{id}   │
│  ├── 期望 Inventory Service 的 POST /stock  │
│  └── 期望 Payment Service 的 POST /pay      │
│                                              │
│ User Service (Provider)                      │
│  ├── 被 Order Service 消费                   │
│  ├── 被 Notification Service 消费            │
│  └── 最后一次验证:✅ 2026-09-09 10:30       │
└────────────────────────────────────────────┘
8. 契约测试工作流:从消费者到提供者的闭环
8.1 完整的 CI 集成流程
sequenceDiagram
    participant C as 消费者 CI
    participant B as Pact Broker
    participant P as 提供者 CI

    C->>C: 运行消费者 Pact 测试
    C->>B: 上传契约文件 (consumer=OrderService v1.2.0)
    B->>P: Webhook 触发提供者验证
    P->>B: 拉取所有未验证的消费者契约
    P->>P: 启动提供者服务
    P->>P: 重放每个契约文件中的请求
    P->>B: 上传验证结果 (✅/❌)
    B->>C: 通知验证结果
    Note over C,P: 提供者验证通过 → 消费者可以安全部署
8.2 can-i-deploy 检查
在消费者部署之前,CI 管道应当执行:
# 查询 Pact Broker:OrderService v1.2.0 可以部署到生产吗?
pact-broker can-i-deploy \
  --pacticipant OrderService \
  --version 1.2.0 \
  --to-environment production
Broker 的返回逻辑:
- 如果所有提供者都验证了此版本的契约 →
✅ YES - 如果有提供者未验证或验证失败 →
❌ NO, missing verification from UserService
这个机制确保了:只有契约被所有提供者验证通过的消费者版本才能上线。
8.3 契约测试与 API 版本管理
契约测试和 API 版本化是互补的,不是替代关系:
- 契约测试:验证消费者和提供者的具体交互格式是否一致
- API 版本化(如
/api/v1/usersvs/api/v2/users):管理不兼容变更的整体策略
当提供者需要做不兼容变更时,流程是:
- 提供者发布新版本 API(
/api/v2/users) - 消费者迁移到新 API,更新其契约文件
- Pact Broker 显示旧 API 的消费者数量降为零
- 提供者安全删除旧 API
如果没有契约测试,提供者永远不知道是否还有消费者在使用旧 API——这导致 API 只增不减,系统逐渐腐化。
9. 测试环境治理:告别「环境能跑就行」
9.1 集成测试环境的问题
很多团队的集成测试环境是一个共享的「测试环境」——一个虚拟机或容器集群,所有人都往上面部署。这导致:
- 环境争抢:「谁把我的数据改了?这个测试刚才还能跑的」
- 数据污染:A 的测试插入了 1000 条数据,B 的测试因为数据量变化而超时
- 配置漂移:环境被手动修改过,和 IaC 定义的不一致
- 版本冲突:A 需要 User Service v2.1,B 需要 v2.0,共享环境只能装一个版本
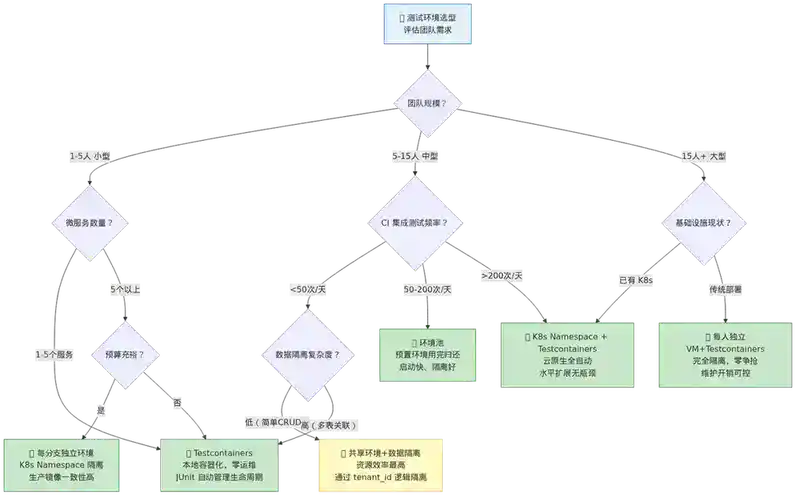
9.2 解决方案矩阵
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| 每人/每分支独立环境 | 完全隔离,零争抢 | 资源成本高,维护开销大 | 大型团队,微服务数量 >20 |
| Testcontainers(本地容器化) | 隔离好,启动快,零成本 | 只适合单服务或少量依赖 | 中小团队的首选方案 |
| 共享环境 + 数据隔离 | 资源效率高 | 数据隔离实现复杂 | 数据库密集型测试 |
| 环境池(预置环境,用完归还) | 启动快,隔离好 | 需要管理池的可用性和预热 | 高频集成测试 (>100 次/天) |
| Kubernetes Namespace 隔离 | 环境一致性高(生产镜像) | 启动慢,依赖 Kubernetes | 云原生团队 |
9.3 推荐实践:Testcontainers + 模块化组合
对于大多数 Java 微服务团队,Testcontainers 已经能覆盖 90% 的集成测试场景:
集成测试环境 = Testcontainers 容器组 + application-test.properties
# docker-compose-test.yml(CI 中的可选后备方案)
version: "3.8"
services:
  postgres:
    image: postgres:15
    environment:
      POSTGRES_DB: testdb
    ports:
      - "5432"
  kafka:
    image: confluentinc/cp-kafka:7.5.0
    environment:
      KAFKA_ADVERTISED_LISTENERS: PLAINTEXT://localhost:9092
Testcontainers 的优势在于不需要 Docker Compose——一切由 JUnit 扩展管理,容器的生命周期与测试生命周期严格绑定。
10. 测试数据管理:造数、隔离与清理
10.1 测试数据困境
集成测试面临一个单元测试没有的问题:数据从哪里来,到哪里去?
- 单元测试中,你 Mock 了 Repository,数据存在于 JVM 堆中,测试结束自然消失
- 集成测试中,数据被写入真实数据库,必须显式清理
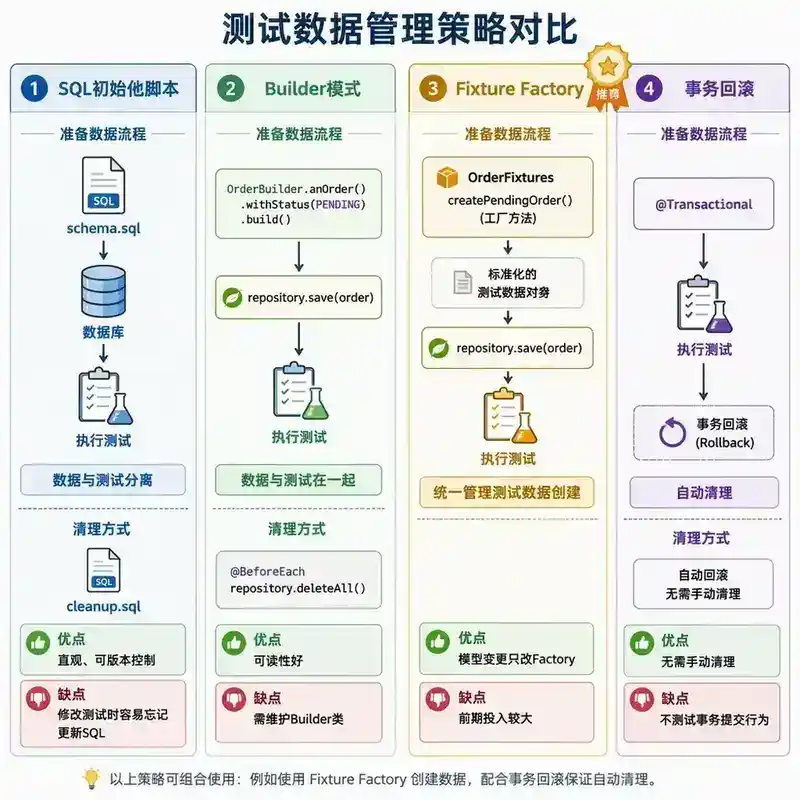
10.2 数据准备策略
方式一:SQL 初始化脚本
@Sql(scripts = "/sql/init-orders.sql", executionPhase = Sql.ExecutionPhase.BEFORE_TEST_METHOD)
@Sql(scripts = "/sql/cleanup.sql", executionPhase = Sql.ExecutionPhase.AFTER_TEST_METHOD)
@Test
void shouldCalculateOrderTotal() { ... }
优点:直观、可版本控制。缺点:数据和测试逻辑分离,修改测试时容易忘记更新 SQL。
方式二:Builder + Repository
@Test
void shouldFindPendingOrders() {
    // Arrange: 使用 Builder 模式构造测试数据
    Order order = OrderBuilder.anOrder()
            .withStatus(OrderStatus.PENDING)
            .withItems(2)
            .build();
    orderRepository.save(order);

    // Act
    List<Order> pending = orderService.findPendingOrders();

    // Assert
    assertThat(pending).hasSize(1);
}
优点:数据与测试在一起,可读性好。缺点:需要维护 Builder 类。
方式三:Test Fixture Factory(推荐)
@Component
public class OrderFixtures {
    @Autowired
    private OrderRepository orderRepository;

    public Order createPendingOrder(String orderId) {
        Order order = new Order(orderId, OrderStatus.PENDING);
        return orderRepository.save(order);
    }
}
Fixture Factory 统一管理测试数据创建,避免分散在测试中的 new Order(...) 重复代码。当领域模型变更时,只需要修改 Factory。
10.3 数据清理策略
| 策略 | 实现 | 优缺点 |
|---|---|---|
| 事务回滚 | @Transactional + @Rollback |
✅ 自动清理,❌ 不测试事务提交行为 |
| @Sql 清理脚本 | DELETE FROM orders |
✅ 简单,❌ 慢(全表删除) |
| 表截断 | TRUNCATE TABLE orders |
✅ 快,❌ 无法在事务中执行,需注意外键 |
| 每次新建数据库 | Testcontainers 为每个测试类建库 | ✅ 完全隔离,❌ 启动慢 |
| Testcontainers 重用容器 | static 容器 + 每个 @Test 前清理 |
✅ 速度与隔离的折中 |
推荐组合:static Testcontainers 容器 + @BeforeEach 中清理关键表 + 每个 @Test 只插入自己需要的数据。
10.4 处理「雪球数据」
雪球数据(Snowball Data)是指多个测试共享同一个数据库实例,测试数据逐渐累积导致测试间相互影响的场景。
避免雪球数据的两条铁律:
- 每个测试只能依赖自己插入的数据(不假设其他测试留下了什么)
- 清理必须在
**@BeforeEach**而非**@AfterEach**中执行(因为如果测试中途崩溃,@AfterEach不会执行,残留数据会影响后续测试)
11. CI/CD 中的集成测试策略:速度与信心的平衡
11.1 测试分层执行
在 CI 管道中,测试应当按执行速度分层,快速反馈给开发者:
git push
  │
  ├─ 1. 编译 + 静态检查 (30s)
  ├─ 2. 单元测试 (1-2min)
  ├─ 3. 持久化集成测试 (2-3min)    ← @DataJpaTest + Testcontainers
  ├─ 4. API 集成测试 (3-5min)       ← @SpringBootTest + Testcontainers
  ├─ 5. 契约验证 (1-2min)           ← Pact 提供者验证
  └─ 6. E2E 测试 (10-15min)         ← 仅主分支
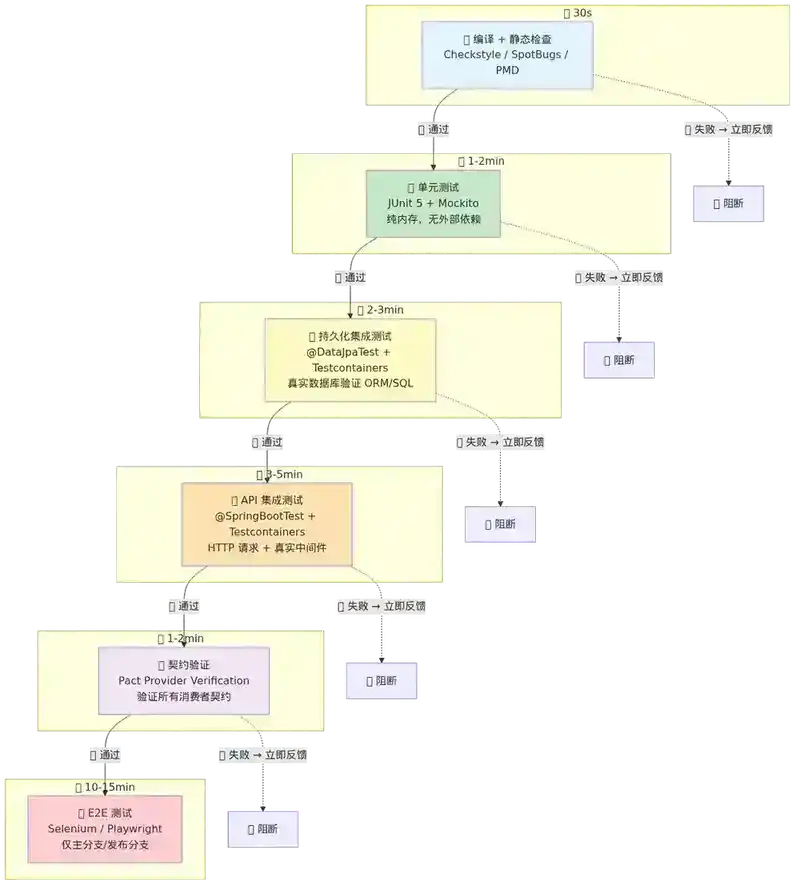
越快的测试越早运行——如果单元测试失败,就没必要启动 Testcontainers 跑集成测试。
11.2 Testcontainers 在 CI 中的注意事项
# .github/workflows/ci.yml 关键配置
jobs:
  integration-test:
    runs-on: ubuntu-latest
    services:
      # 可选:如果 CI 不支持 Docker-in-Docker
      docker:
        image: docker:24-dind
    steps:
      - uses: actions/checkout@v4
      - name: Run integration tests
        run: ./gradlew integrationTest
        env:
          # 关键:CI 中 Testcontainers 需要连接 Docker daemon
          DOCKER_HOST: unix:///var/run/docker.sock
          TESTCONTAINERS_RYUK_DISABLED: "false"
CI 常见问题:
- Docker-in-Docker (DinD):某些 CI 环境需要在容器内运行 Docker,此时需要挂载
/var/run/docker.sock或使用 DinD service - 镜像拉取速度:CI 每次从零拉取
postgres:15可能需要 30 秒。配置 Docker 层缓存或 CI 预拉取镜像 - 资源限制:CI runner 通常只有 2 CPU / 4GB 内存,不要同时运行过多容器
11.3 契约测试的 CI 集成
消费者 CI:
  1. 运行消费者 Pact 测试 → 生成契约文件
  2. 上传契约文件到 Pact Broker
  (不需要启动提供者服务)

提供者 CI(由 Pact Broker Webhook 触发或定时执行):
  1. 从 Broker 拉取所有消费者的契约文件
  2. 启动提供者服务(通常 + Testcontainers 数据库)
  3. 重放所有契约请求 → 验证响应
  4. 将验证结果回传到 Broker
12. 常见反模式与避坑指南
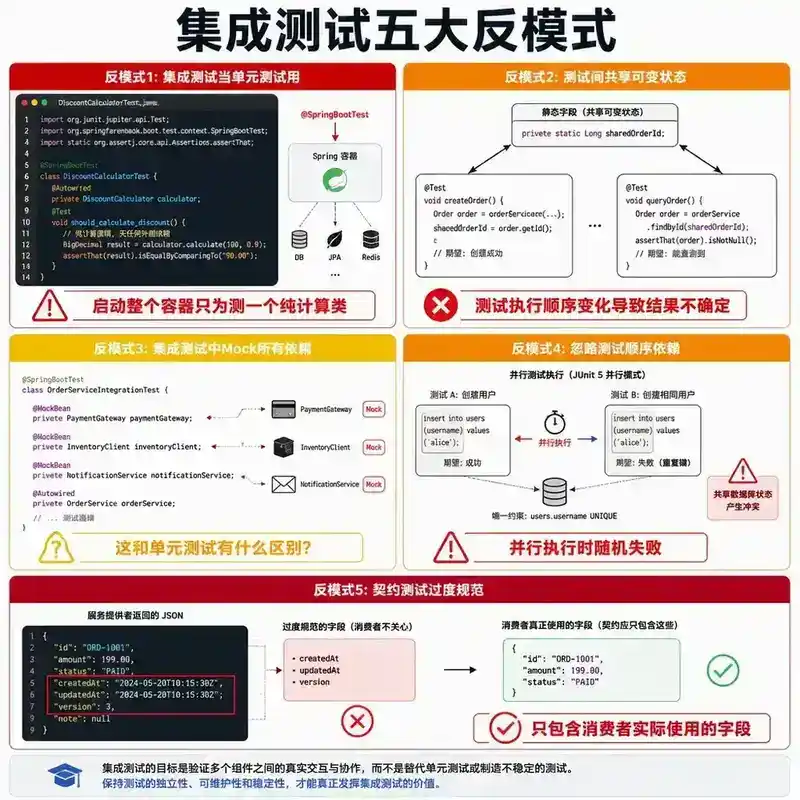
反模式 1:集成测试当单元测试用
// 反模式:用 @SpringBootTest 测试纯业务逻辑
@SpringBootTest
class DiscountCalculatorTest {
    @Autowired
    private DiscountCalculator calculator;  // 启动整个容器只为这个

    @Test
    void shouldApplySeasonalDiscount() {
        assertThat(calculator.calculate(100, "SUMMER")).isEqualTo(80);
    }
}
DiscountCalculator 是一个纯计算类,不依赖任何外部系统。用单元测试即可,启动 Spring 容器是浪费。
反模式 2:测试之间共享可变状态
// 反模式:static 字段在测试间共享
static Long sharedOrderId;  // ❌ 测试执行顺序变化会导致结果不确定

@Test
void shouldCreateOrder() {
    sharedOrderId = orderService.create(new OrderRequest(...));
}

@Test
void shouldCancelOrder() {
    orderService.cancel(sharedOrderId);  // 依赖上一个测试先执行
}
每个测试应该完全独立。如果确实需要共享初始化逻辑,用 @BeforeEach。
反模式 3:集成测试中 Mock 了所有依赖
// 反模式:@SpringBootTest 中又 Mock 了全部外部服务
@SpringBootTest
class OrderServiceTest {
    @MockBean
    private PaymentGateway paymentGateway;  // 全 Mock 了
    @MockBean
    private InventoryClient inventoryClient;
    @MockBean
    private NotificationService notificationService;

    // 这和单元测试有什么区别?
}
如果你 Mock 了所有外部依赖,为什么不直接写单元测试?集成测试的价值就是验证真实交互。
反模式 4:忽略测试顺序依赖
当测试被并行执行时(如 Maven Surefire 的 parallel=classes),顺序依赖的测试会随机失败。避免方式:
- 每个测试独立准备数据
@BeforeEach清理而非@AfterEach- 显式声明
@TestMethodOrder(MethodOrderer.Random.class)来暴露顺序依赖
反模式 5:契约测试中的过度规范
// 反模式:在契约中规定了不关心的字段
.willRespondWith()
    .body(newJsonBody(body -> {
        body.stringType("name", "Alice");
        body.stringType("email", "alice@example.com");
        body.integerType("id", 123);
        body.stringType("createdAt", "2026-01-01T00:00:00Z");  // 消费者根本不关心
        body.stringType("updatedAt", "2026-01-01T00:00:00Z");  // 也不关心
        body.integerType("version", 1);                         // 也不关心
    }).build())
契约应该只包含消费者实际使用的字段。包含过多字段会导致契约过于脆弱——提供者改变了消费者不用的字段,契约验证也会失败。
13. 面试追问与参考答案
Q1:为什么在微服务架构中,集成测试比单体架构更重要?
参考答案:单体架构中,所有模块在同一个进程中运行,编译器能检查类型不匹配,IDE 能跟踪方法调用链。微服务架构中,服务间通过网络边界通信——编译器无法检查 API 兼容性,IDE 无法跨服务跳转。API 契约只存在于文档(如果写了的话)或口头约定中。集成测试和契约测试是用机器可验证的方式替代这些隐式契约。
Q2:Testcontainers 和 Docker Compose 在集成测试场景下如何选择?
参考答案:
- Testcontainers 适合:开发阶段的日常集成测试,JUnit 中程序化管理容器,与测试生命周期自动绑定,不需要额外配置文件。缺点是不适合非 JVM 项目。
- Docker Compose 适合:需要编排多容器拓扑的复杂场景(如启动整套微服务),或在 CI 中作为固定基础设施层。缺点是生命周期需要手动管理。
最佳实践:在代码中用 Testcontainers,在 CI 的 E2E 阶段用 Docker Compose,两者不是互斥的。
Q3:你如何判断一个测试是「值得写的集成测试」还是「应该用单元测试替代」?
参考答案:问三个问题——
- 这个测试失败时,能否定位到具体的代码行还是外部系统?如果能直接定位到代码行,单元测试更合适。
- 测试的核心目的是验证业务逻辑还是验证集成假设?如果是前者,单元测试就够了。
- 如果改用 Mock,测试的信心会降低多少?如果 Mock 的行为和生产差异巨大(如 H2 vs PostgreSQL),集成测试是必需的。
Q4:Pact 的消费者驱动契约模式有什么局限性?
参考答案:
- 契约爆炸:当消费者数量很多时,提供者需要验证大量契约,CI 时间增长。需要按重要性分级(可选契约 vs 强制契约)。
- 只能验证请求/响应格式:无法验证业务逻辑正确性。契约通过不代表业务正确。
- 提供者状态管理的复杂度:
@State需要在提供者端维护精确的数据库状态,随着测试增多变得脆弱。 - 非 HTTP 协议的契约:Pact 主要支持 HTTP 和消息队列,对于 gRPC、GraphQL 的支持相对较弱。
Q5:如果你们的 CI 集成测试运行需要 20 分钟,你会怎么优化?
参考答案:
- 分层执行:将持久化层测试(
@DataJpaTest)、API 层测试(@SpringBootTest)分开成独立 CI job,并行运行 - 容器预热:CI 中预置常用容器镜像,或在 Pod 中常驻 Testcontainers 容器供多阶段复用
- Spring Context 缓存:确保相同配置的
@SpringBootTest共享 ApplicationContext(Spring 默认会做,但要避免@MockBean导致缓存失效) - 增量测试:只运行变更代码相关的测试(如用 Gradle 的
--tests过滤或使用 Test Impact Analysis 工具) - 优化测试数据:才用
TRUNCATE代替DELETE,避免每次@BeforeEach重建过多数据 - 评估测试价值:删除那些从未失败的测试(高维护成本、低发现问题概率)
Q6:描述一个你经历过的集成测试「假阳性」案例,以及你如何修复的?
参考答案:(引导面试者结合自己的经验回答,以下是一个典型答案框架)
我们曾用 H2 内存数据库跑 Repository 测试,所有测试通过。上线到 PostgreSQL 后,一个查询直接在生产环境报错——原因是 SQL 中使用了 LIMIT ? OFFSET ? 的占位符语法,H2 接受任何位置的占位符,但 PostgreSQL 的 PreparedStatement 要求占位符只出现在合法表达式位置。
修复方案:
- 引入 Testcontainers 替代 H2,确保测试数据库与生产一致
- 在 CI 中增加数据库兼容性检查(如 jOOQ 的 SQL 方言校验)
- 将这个问题加入团队 Code Review Checklist:「是否使用了数据库特有的 SQL 语法?」
下一篇:248|代码质量与重构:SOLID、代码异味、静态检查、评审和渐进式重构
面试官视角深度追问
以下问题从面试官视角出发,考察候选人是否真正在生产环境中落地过集成测试与契约测试体系,而非仅停留在理论层面。
追问 1:从零搭建 vs 渐进引入
场景:你接手了一个已运行 3 年、200+ 微服务的系统,目前没有集成测试,只有少量单元测试和手工联调。CTO 要求半年内将线上故障中由接口不兼容导致的比例从 30% 降到 5% 以下。
追问:
- 你的第一步是什么?选择哪个服务或哪个链路作为切入点?
- 你会优先推集成测试还是契约测试?为什么这个顺序?
- 如何说服 5 个团队在 sprint 中为测试分配 20% 的时间?给出你的「销售话术」和量化数据。
- 半年后 CTO 要求看 ROI 报告,你如何量化集成测试和契约测试的投资回报?
追问 2:契约测试的爆炸半径
场景:你们团队维护一个核心用户服务,有 15 个消费者团队。某天你要重构一个字段从 改为 。15 个消费者中有 3 个的契约测试失败了。
追问:
- 你如何判断这 3 个失败是消费者需要适配还是提供者不应该改?决策标准是什么?
- 有没有可能契约测试通过了,但生产上仍然出问题?(提示:考虑语义兼容性,如 → 虽然类型不同但值等价)
- 如果其中一个消费者团队的契约已过期 3 个月未更新,你敢不敢忽略它的验证结果直接上线?依据是什么?
- 如何防止契约测试从「保护网」变成「阻碍变更的锁链」?
追问 3:Testcontainers 的性能与成本边界
场景:你们的 CI 流水线中,每个 PR 触发 800 个集成测试,全部使用 Testcontainers 启动 PostgreSQL + Redis + Kafka。当前耗时 18 分钟,CI 资源月费 2 万元。
追问:
- 你会从哪些维度优化?请给出优先级排序和每项的预期收益(分钟/元)。
- Testcontainers 的 模式有什么隐藏风险?什么场景下绝对不能用?
- 如果架构师提议「把集成测试从 CI 移到 nightly build,PR 只跑单元测试」,你同意吗?给出你的权衡分析。
- 有没有场景你宁愿用 embedded database(如 H2)而非 Testcontainers?给出具体场景和原因。
追问 4:测试环境治理的混沌现实
场景:你们有 3 套测试环境(dev / staging / pre-prod),30 个团队共享。经常出现「我部署上去被测服务还没启动完,依赖的服务被别人覆盖部署了」的情况。
追问:
- 你如何设计一个方案让 30 个团队互不干扰地进行集成测试?列出至少 3 种可选方案并对比它们的成本、隔离度和维护负担。
- K8s Namespace 隔离 + Testcontainers Cloud 的方案中,每个团队的数据库 schema 如何管理?谁负责 schema 迁移?
- 如果老板说「我们没有预算搞环境治理,你们自己想办法」,你会怎么做?给出最小成本、最大效果的土办法。
- 描述一个你经历过的环境问题导致测试假阳性的真实案例,以及你是如何发现根因的。
追问 5:集成测试的测试数据困境
场景:你们的订单服务集成测试需要依赖用户服务、库存服务、支付服务的真实接口。每次跑测试都要先在这三个服务中创建测试数据,但三个服务的数据模型经常变更。
追问:
- 你会怎么设计测试数据的生命周期管理?数据由谁创建、谁清理、什么时候清理?
- 如果某个依赖服务暂时不可用(比如支付服务的 staging 环境挂了),你的集成测试应该直接失败、跳过、还是 fallback 到 Mock?为什么?
- 你怎么确保测试数据不会污染生产数据?(考虑共享数据库、错误配置、人为失误等场景)
- 「测试数据工厂」和「生产数据脱敏子集」两种策略,你分别会在什么阶段使用?
追问 6:监控你的测试体系
场景:团队推行集成测试一年后,测试数量从 0 增长到 3000 个,但最近连续 3 个版本上线后仍有接口兼容性问题导致回滚。
追问:
- 你如何判断当前的测试体系是「覆盖不够」还是「覆盖方向错了」?从哪些指标可以区分?
- 你怎么发现「从未失败过的测试」和「假阳性频率最高的测试」?发现之后怎么处理?
- 如果一个集成测试连续 50 次运行都通过,它还有价值吗?你的处理策略是什么?
- 描述你怎么给测试体系建立「健康度仪表盘」——至少包含 5 个核心指标,并说明每个指标的告警阈值。
追问 7:契约测试的团队协作反模式
场景:A 团队是提供者,B 团队是消费者。B 团队在契约中写了 50 个字段的期望,但实际只用 3 个。A 团队每次修改任意字段,契约验证就会失败,导致 A 团队越来越不想写契约测试。
追问:
- 这个问题的根因是什么?是工具问题、流程问题还是人的问题?
- 你如何设计一个机制来防止消费者「过度规范」契约?可以从工具约束、流程规则、团队协议三个层面回答。
- Pact Broker 的 在什么情况下会给出错误的「可以部署」判断?
- 如果让你设计一个「契约健康分」,你会用哪些维度来量化一个契约的质量?
追问 8:架构演进中的测试策略调整
场景:你们正在从 REST 同步调用迁移到 Kafka 异步消息。原有的契约测试全部基于 HTTP 请求/响应,新架构下服务间通过消息通信。
追问:
- 异步消息场景下的「契约」应该如何定义?与同步 API 契约的核心区别是什么?
- Pact 的 Message Pact 能覆盖哪些场景,不能覆盖哪些场景?对于不能覆盖的,你怎么办?
- 消息 Schema Registry(如 Confluent Schema Registry)和 Pact 在契约管理上的角色有什么不同?它们是什么关系?
- 在迁移过渡期(部分服务用 REST,部分用 Kafka),你怎么确保契约测试不会出现覆盖盲区?
本文阅读时间约 45 分钟(不含追问模块),追问模块建议面试准备时间 30–40 分钟。