一、为什么要理解 BeanDefinition 和 refresh()
上一篇讲了 Bean 从"半成品"变成"成品"的生命周期(081/082),但那一切都建立在一个前提之上:容器已经知道要创建哪些 Bean、用什么方式创建。这个"知道"的过程,就是 BeanDefinition 的解析与注册;而把整个容器从"配置"变成"运行时对象图"的总指挥,就是 AbstractApplicationContext.refresh()。
不理解这两块,你会遇到这些说不清楚的问题:为什么 @Configuration 类里的 @Bean 方法之间互相调用不会重复创建 Bean?为什么 @ComponentScan 扫描到的类和手写 XML 注册的 Bean 最终能公平竞争、互相注入?为什么有些 BeanFactoryPostProcessor 能改掉别的 Bean 的定义,而有些不能?答案都在 BeanDefinition 的数据结构和 refresh() 的执行顺序里。
二、BeanDefinition:容器眼中的"Bean 说明书"
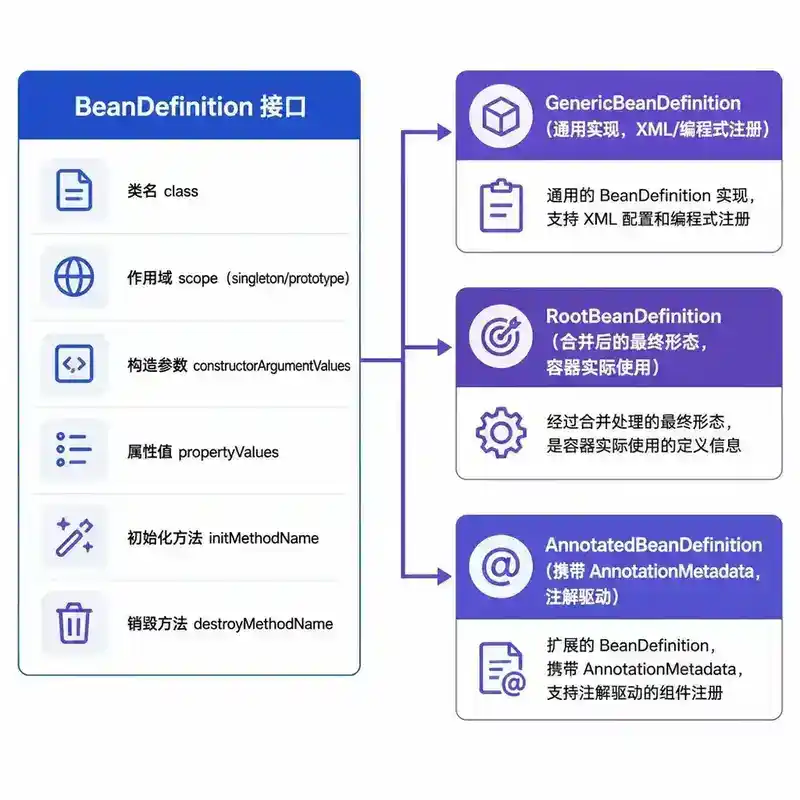
Spring 容器在创建 Bean 之前,并不认识"类",它只认识 BeanDefinition。这是一份纯元数据的说明书,描述一个 Bean 应该怎么被创建,而不是 Bean 本身。
public interface BeanDefinition {
    String getBeanClassName();       // 全限定类名(可能还没被加载)
    String getScope();               // singleton / prototype / request ...
    boolean isLazyInit();            // 是否延迟初始化

    String[ ] getDependsOn();         // 显式依赖的其他 Bean

    boolean isPrimary();             // @Primary 标记
    String getFactoryBeanName();     // 工厂 Bean 的名字(@Bean 方法场景)
    String getFactoryMethodName();   // 工厂方法名
    ConstructorArgumentValues getConstructorArgumentValues();
    MutablePropertyValues getPropertyValues();
    String getInitMethodName();
    String getDestroyMethodName();
}
关键认知:BeanDefinition 里没有对象,只有"如何造出对象"的配方。这意味着解析阶段(读取 XML/扫描注解/处理 Java Config)完全不涉及 Bean 实例化,只是在往一张"配方表"里填数据。这也是为什么 Spring 容器启动时可以先把所有配方收集齐、做完各种加工(后处理器修改配方),再统一按需生产。
2.1 三种常见实现类
GenericBeanDefinition:最通用的实现,XML 和大多数编程式注册场景使用。RootBeanDefinition:合并后的最终形态。父子 BeanDefinition(parent属性)合并、factory-bean解析之后,容器内部实际持有并用来创建 Bean 的是它,而不是原始的 GenericBeanDefinition。AnnotatedBeanDefinition:额外携带AnnotationMetadata,让容器在不触发类加载的情况下就能读到类上的注解信息(比如判断是否有@Primary、@Lazy),这是注解驱动配置能高效工作的基础。
三、配置解析:三条路都通向 BeanDefinition
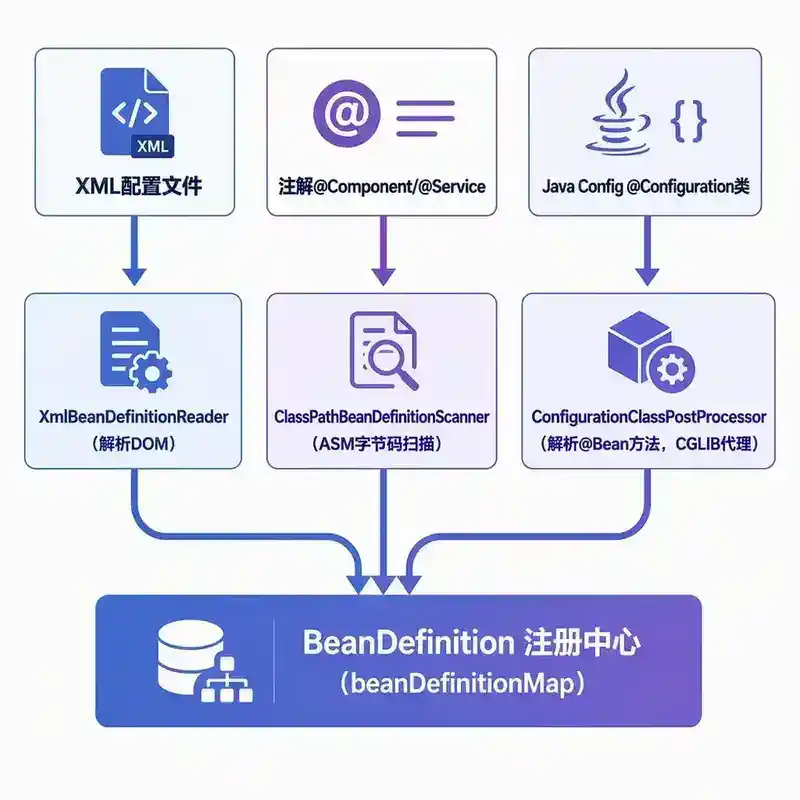
不管你用 XML、注解还是 Java Config,最终目的都是同一个:产出一批 BeanDefinition 并塞进容器。路径不同,但落点相同。
3.1 XML 路径:BeanDefinitionReader
XmlBeanDefinitionReader reader = new XmlBeanDefinitionReader(registry);
reader.loadBeanDefinitions("classpath:applicationContext.xml");
XmlBeanDefinitionReader 把 XML 解析成 DOM,再委托 BeanDefinitionParserDelegate 把每个 <bean> 标签转换成一个 BeanDefinitionHolder(包含 BeanDefinition + beanName + alias),最后统一注册。
3.2 注解路径:扫描 + 元数据读取
AnnotatedBeanDefinitionReader annotatedReader = new AnnotatedBeanDefinitionReader(registry);
annotatedReader.register(AppConfig.class);            // 直接注册指定类

ClassPathBeanDefinitionScanner scanner = new ClassPathBeanDefinitionScanner(registry);
scanner.scan("com.example.service");                  // 扫描包,找 @Component 家族
ClassPathBeanDefinitionScanner 底层用 ASM 读取 .class 文件的字节码提取注解信息,不需要真正加载类就能判断一个类是否标注了 @Component/@Service/@Repository。这是性能考量:如果扫描 1000 个类就要触发 1000 次类加载,启动会非常慢。
3.3 Java Config 路径:ConfigurationClassPostProcessor
@Configuration 类和其中的 @Bean 方法是最特殊的一条路——它靠一个内置的 BeanFactoryPostProcessor 实现:ConfigurationClassPostProcessor。它做的事情概括为四步:
- 找出所有
@Configuration类(以及被@Import、@ComponentScan间接引入的配置类)。 - 解析每个配置类里的
@Bean方法,把每个方法转换成一个 BeanDefinition,factory-bean指向配置类本身,factory-method指向该方法。 - 处理
@Import、@ComponentScan、@PropertySource等注解,递归展开配置树。 - 用 CGLIB 给
@Configuration类生成子类代理(除非标注了proxyBeanMethods = false)——这一步就是"同一个@Bean方法在配置类内部互相调用为什么不会重复创建 Bean"的答案:调用会被代理拦截,先去容器里查有没有现成的单例,有就直接返回,没有才真正执行方法体。
@Configuration
public class AppConfig {
    @Bean
    public OrderService orderService() {
        return new OrderService(orderRepository()); // 代理拦截,不会重复创建 orderRepository
    }

    @Bean
    public OrderRepository orderRepository() {
        return new OrderRepository();
    }
}
四、注册:BeanDefinitionRegistry 与那张关键的表
所有解析出来的 BeanDefinition,最终都要调用一次注册:
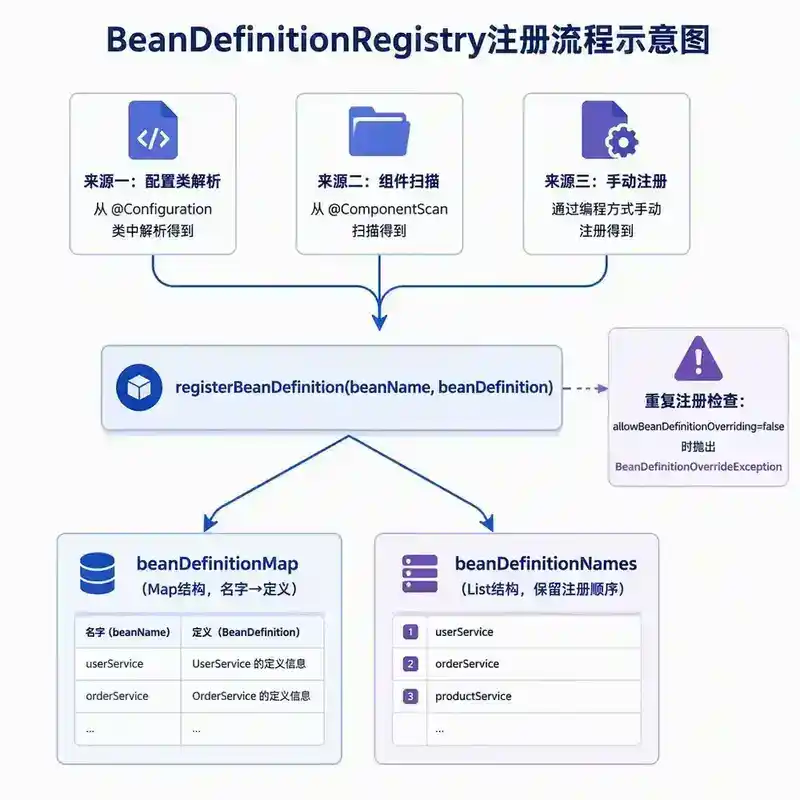
void registerBeanDefinition(String beanName, BeanDefinition beanDefinition)
    throws BeanDefinitionStoreException;
DefaultListableBeanFactory 实现了这个接口,内部核心是两个字段:
private final Map<String, BeanDefinition> beanDefinitionMap = new ConcurrentHashMap<>(256);
private volatile List<String> beanDefinitionNames = new ArrayList<>(256);
beanDefinitionMap 是名字到定义的映射,beanDefinitionNames 保留了注册的先后顺序——这一点常被忽略,但很重要:Spring 在没有显式 @Order 或 depends-on 的情况下,很多地方(比如同类型多个 Bean 找不到 @Primary 时的报错列表、按类型批量获取 Bean 的默认顺序)都依赖这个注册顺序,本质上是"配置文件/包扫描的顺序决定了默认行为"。
注册阶段还会做一次重复定义检查:如果同名 BeanDefinition 已存在,默认策略是允许覆盖(allowBeanDefinitionOverriding,Spring Boot 2.1 起默认改为 false,重复定义会直接抛异常),这也是很多人升级 Spring Boot 后遇到 BeanDefinitionOverrideException 的根源。
五、后处理器:在"造之前"改配方,在"造出来后"改成品
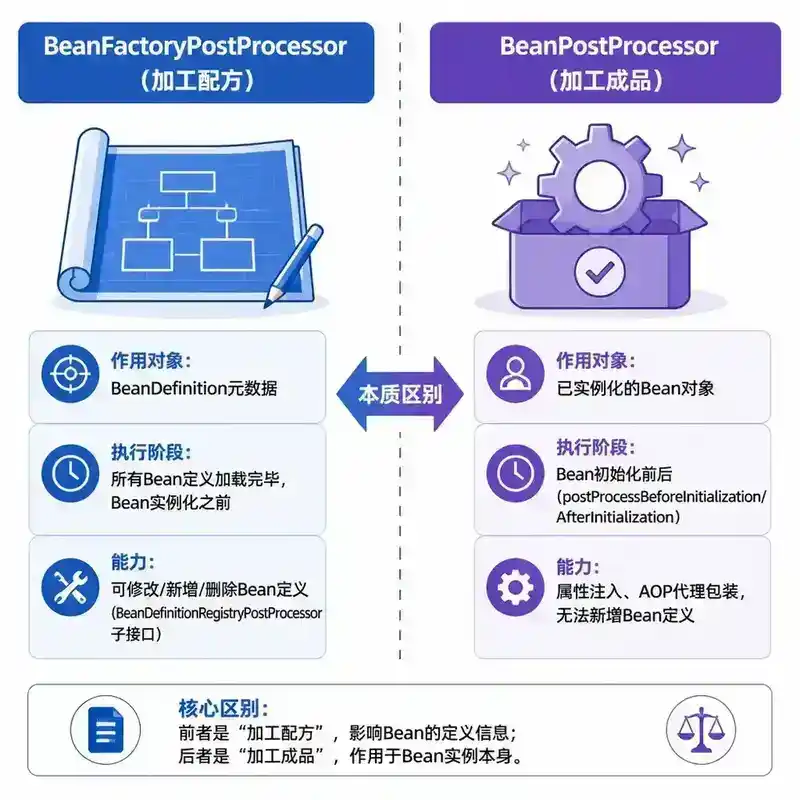
Spring 有两类容易混淆的后处理器,区分它们的关键是问一句:它加工的是 BeanDefinition,还是 Bean 实例?
5.1 BeanFactoryPostProcessor:加工配方
public interface BeanFactoryPostProcessor {
    void postProcessBeanFactory(ConfigurableListableBeanFactory beanFactory)
        throws BeansException;
}
它在所有 BeanDefinition 已经加载完毕、但还没有任何 Bean 被实例化的时间点执行,能拿到的是 BeanFactory 这个"配方仓库",可以修改任意 BeanDefinition 的属性(比如改 scope、改属性值、甚至删除某个定义)。经典例子:PropertySourcesPlaceholderConfigurer 就是在这一步把 ${jdbc.url} 之类的占位符替换成真实值。
它有一个更强大的子接口 BeanDefinitionRegistryPostProcessor:
public interface BeanDefinitionRegistryPostProcessor extends BeanFactoryPostProcessor {
    void postProcessBeanDefinitionRegistry(BeanDefinitionRegistry registry)
        throws BeansException;
}
它不仅能改配方,还能新增/删除配方(注册全新的 BeanDefinition)。前面提到的 ConfigurationClassPostProcessor 正是它的实现——因为解析 @Bean 方法本质上就是"凭空造出新的 BeanDefinition 塞进去",普通的 BeanFactoryPostProcessor 做不到这件事。
5.2 BeanPostProcessor:加工成品
这个在上一篇讲过:作用于已经实例化的 Bean,postProcessBeforeInitialization/postProcessAfterInitialization 包裹的是真实对象,能做的是属性注入、AOP 代理、包装成新对象,但改不了"这个 Bean 该怎么被创建"这件事——因为创建已经发生了。
一句话记住区别:BeanFactoryPostProcessor 面向图纸,BeanPostProcessor 面向成品。
六、refresh():容器启动的总指挥
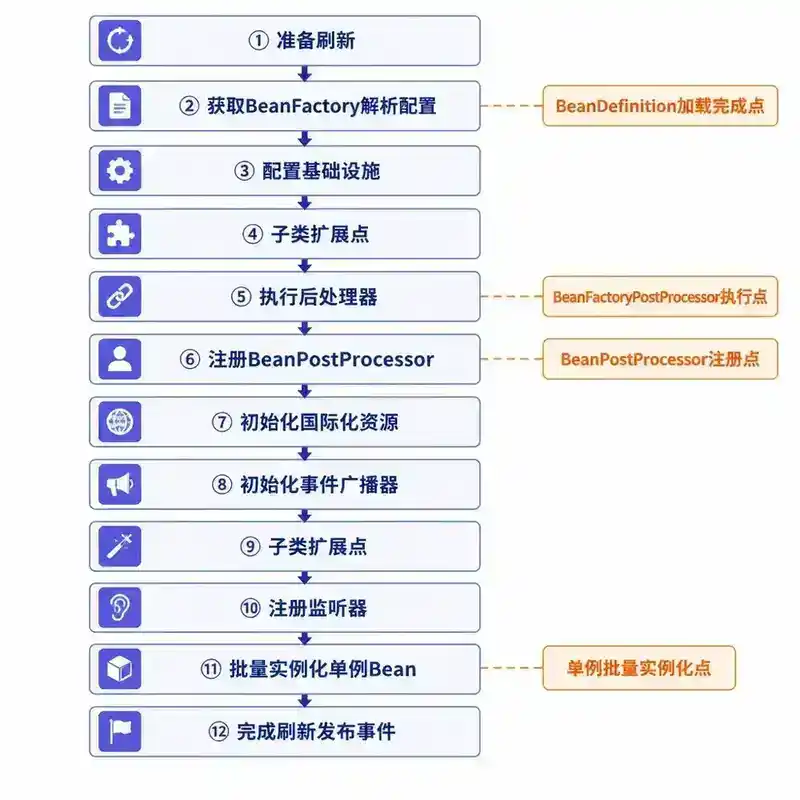
ApplicationContext.refresh() 是 Spring 容器生命周期的核心方法,它把"一堆配置"变成"一个可用的运行时容器"。这个方法有十二个步骤,模板方法模式,AbstractApplicationContext 定义骨架,具体细节留给子类扩展点。
public void refresh() throws BeansException {
    synchronized (this.startupShutdownMonitor) {
        // 1. 准备刷新:记录启动时间,校验必需的环境属性
        prepareRefresh();

        // 2. 获取全新的 BeanFactory:解析配置,完成 BeanDefinition 的加载和注册
        ConfigurableListableBeanFactory beanFactory = obtainFreshBeanFactory();

        // 3. 配置 BeanFactory:类加载器、SpEL 解析器、内置的几个 BeanPostProcessor
        prepareBeanFactory(beanFactory);

        // 4. 子类扩展点:Web 容器在这里注册 ServletContext 相关 Bean
        postProcessBeanFactory(beanFactory);

        // 5. 执行所有 BeanFactoryPostProcessor(含 BeanDefinitionRegistryPostProcessor)
        invokeBeanFactoryPostProcessors(beanFactory);

        // 6. 注册所有 BeanPostProcessor(此时只注册,不执行)
        registerBeanPostProcessors(beanFactory);

        // 7. 初始化国际化资源 MessageSource
        initMessageSource();

        // 8. 初始化事件广播器 ApplicationEventMulticaster
        initApplicationEventMulticaster();

        // 9. 子类扩展点:SpringBoot 内嵌 Tomcat/Netty 在这里启动
        onRefresh();

        // 10. 注册事件监听器 ApplicationListener
        registerListeners();

        // 11. 实例化所有非懒加载的 singleton Bean(真正开始 new 对象、走生命周期)
        finishBeanFactoryInitialization(beanFactory);

        // 12. 完成刷新:发布 ContextRefreshedEvent,启动生命周期回调(Lifecycle 接口)
        finishRefresh();
    }
}
这十二步里,最值得记住的三个"分水岭":
- 第 2 步之后:所有 BeanDefinition 已经就位(解析、注册完成),但没有一个 Bean 被创建。
- 第 5~6 步:BeanFactoryPostProcessor 修改配方、BeanPostProcessor 注册就位,为第 11 步的批量创建做准备。这里有个容易踩的坑——第 6 步只是"注册"BeanPostProcessor,如果某个 BeanFactoryPostProcessor 在第 5 步意外触发了某个 Bean 的提前实例化,那么这个 Bean 就会错过部分还没注册的 BeanPostProcessor,是很多"@Autowired 不生效""AOP 代理没生效"问题的根源。
- 第 11 步:这才是真正批量
getBean(),走完整套实例化 → 属性填充 → Aware → 初始化的流程(就是上一篇的内容)。
Object obtainFreshBeanFactory() {
    refreshBeanFactory();                 // 内部会调用 loadBeanDefinitions(beanFactory)
    return getBeanFactory();
}
这里就是配置解析(第三节)和注册(第四节)真正发生的地方——obtainFreshBeanFactory() 表面上是一个方法,实际上把前面讲的整条"解析 -> 注册"链路都串起来了。
七、invokeBeanFactoryPostProcessors 内部的执行顺序陷阱
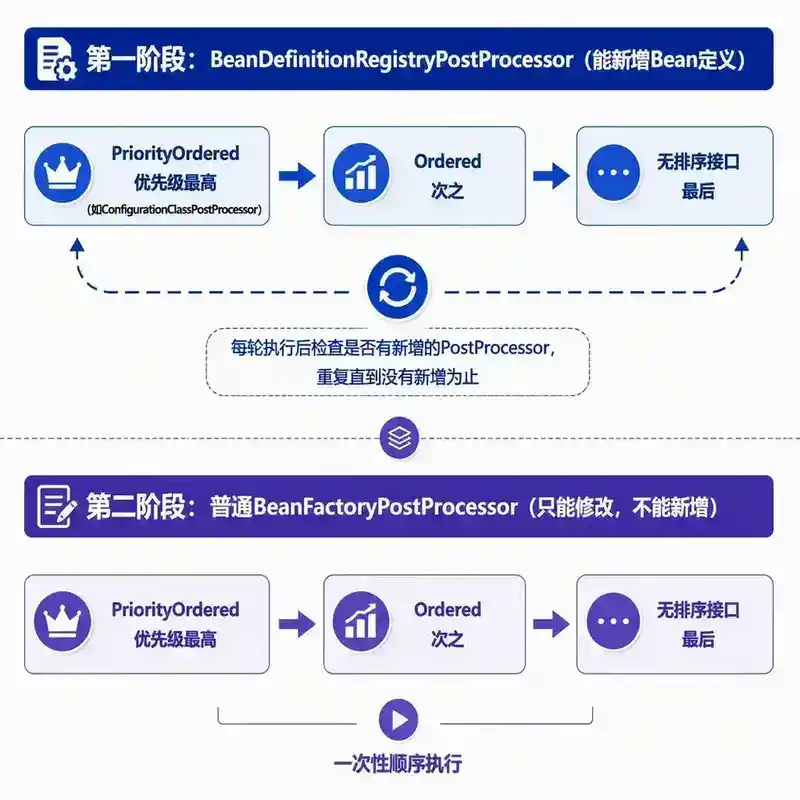
第 5 步内部本身还有精细的优先级规则,理解它能避免"我的 BeanFactoryPostProcessor 怎么没生效/生效顺序不对"的困惑:
- 先执行所有
BeanDefinitionRegistryPostProcessor:- 先按
PriorityOrdered排序执行(ConfigurationClassPostProcessor就属于这一档,最先跑,保证@Bean方法产生的 BeanDefinition 尽早注册)。 - 再按
Ordered排序执行。 - 最后执行没有排序接口的。
- 每一轮执行完都要重新检查是否有新的 BeanDefinitionRegistryPostProcessor 被注册进来(因为上一轮可能又扫出了新的配置类),直到没有新增为止。
- 先按
- 再执行普通的
BeanFactoryPostProcessor(同样按 PriorityOrdered -> Ordered -> 无序的顺序)。
这个"循环检查新增"的设计,正是为了支持 @Import 嵌套配置类、@ComponentScan 递归扫描这种"越处理越发现新配置"的场景。
八、一张图看懂整体链路
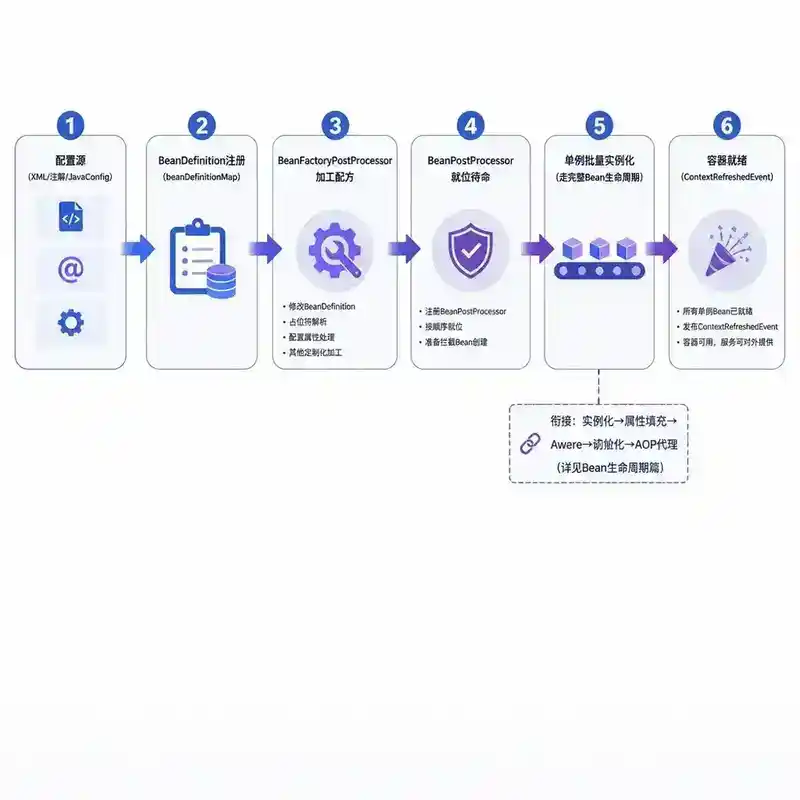
把配置解析、注册、后处理器、refresh() 串成一条时间线:配置源(XML/注解/Java Config) → 各自的 Reader/Scanner/PostProcessor 转换成 BeanDefinition → 注册进 beanDefinitionMap → invokeBeanFactoryPostProcessors 加工配方 → registerBeanPostProcessors 就位待命 → finishBeanFactoryInitialization 批量创建单例(走完整的 Bean 生命周期) → finishRefresh 容器就绪。
九、常见误区
- "BeanDefinition 就是 Bean" —— 不对。BeanDefinition 是纯元数据,是"配方";Bean 是根据配方 new 出来的对象。容器启动早期可以有几百个 BeanDefinition,但一个 Bean 实例都还没创建。
- "@Bean 方法互相调用会创建两个实例" —— 只有在
proxyBeanMethods = false(或者手写new Xxx()而不通过配置类方法调用)时才会。默认 CGLIB 代理会拦截方法调用,走单例缓存。 - "BeanFactoryPostProcessor 和 BeanPostProcessor 是一回事,只是名字像" —— 作用对象完全不同:一个改配方,一个改成品,本质区别决定了能力边界(前者能新增 Bean 定义,后者不能)。
- "refresh() 只是初始化 Bean" —— 只是第 11 步的事。前面 10 步做了大量准备工作:解析配置、注册定义、加工元数据、准备后处理器、初始化事件体系。
十、总结
BeanDefinition 与容器 refresh() 是 Spring IoC 容器"从配置到运行"的中枢:
- BeanDefinition 是纯元数据的"配方",不涉及对象实例化。
- 三条配置路径(XML/注解/Java Config)最终都转换为 BeanDefinition,殊途同归。
- 注册中心是
beanDefinitionMap+ 有序的beanDefinitionNames,重复注册默认会报错(Spring Boot 2.1+)。 BeanFactoryPostProcessor(尤其是能新增定义的BeanDefinitionRegistryPostProcessor)加工配方;BeanPostProcessor加工成品,二者不可混淆。refresh()十二步是模板方法,核心分水岭是:BeanDefinition 就位 → 后处理器就位 → 批量实例化单例 → 容器就绪。
延伸阅读
- Spring 源码:
AbstractApplicationContext.refresh()、ConfigurationClassPostProcessor.processConfigBeanDefinitions() - 《Spring 源码深度解析》第 3、7 章
- 本系列相关篇目:081(Spring IoC 与 DI)、082(Bean 生命周期)、096(Spring Boot 自动配置)、100(Spring 扩展点)
面试官视角提问(不计入阅读时间)
以下问题不是复述文档内容,而是模拟面试官会追问的场景题,检验你是否真正理解 BeanDefinition 和 refresh() 的运行机制,而不是背了流程图。
Q1:如果你写的**BeanDefinitionRegistryPostProcessor**在**postProcessBeanDefinitionRegistry()**里直接调用了**beanFactory.getBean("someBean")**,会出什么问题?
会触发这个 Bean 的提前实例化,问题出在两点:一是此时 registerBeanPostProcessors()(第 6 步)还没执行完,很多 BeanPostProcessor(比如做 AOP 代理的 AbstractAutoProxyCreator)还没注册进容器,这个 Bean 创建时会错过它们,拿到的是一个没有被代理包装的"裸对象";二是如果这个 Bean 后续又被其他还没执行完的 BeanDefinitionRegistryPostProcessor 修改了 BeanDefinition(比如改了属性值),修改会完全不生效,因为对象已经用旧的配方造出来了。这是"@Autowired 不生效""事务不生效"这类诡异问题的常见根源之一。
Q2:为什么容器内部实际创建 Bean 时用的是**RootBeanDefinition**,而不是你注册进去的**GenericBeanDefinition**?
因为原始的 BeanDefinition 可能只是"半成品"——比如通过 parent 属性引用了父 BeanDefinition,或者 factory-bean/factory-method 指向另一个 Bean 的工厂方法,这些信息在创建 Bean 之前必须先"合并"成一份完整、自洽的定义。getMergedBeanDefinition() 会做这件事,合并结果就是 RootBeanDefinition。用一句话概括:GenericBeanDefinition 是"你写的配方片段",RootBeanDefinition 是"容器算出来的完整配方",容器只信任后者。
Q3:两个**@Configuration**类通过**@Import**互相引用(A import B,B import A),**ConfigurationClassPostProcessor**会死循环吗?
不会。ConfigurationClassParser 内部维护了一个已处理配置类的集合(configurationClasses),处理到某个类之前会先检查是否已经处理过,处理过就跳过,天然阻断了循环导入。但这不代表循环 @Import 没有代价——它意味着两个配置类在概念上强耦合,通常是设计问题的信号,面试官更想听到的是"我会怎么重新拆分配置"而不是"反正不会死循环"。
Q4:**allowBeanDefinitionOverriding=false**(Spring Boot 2.1+ 默认值)时,同一个 bean name 在 XML 和**@ComponentScan**里都定义了,报错发生在哪个阶段?你怎么快速定位到底是哪两个定义冲突?
报错发生在注册阶段(registerBeanDefinition() 内部检测到重名且不允许覆盖时),也就是 obtainFreshBeanFactory() 里,早于任何 BeanFactoryPostProcessor 和 Bean 实例化——所以你在异常堆栈里看到的一定是启动早期就失败,而不是运行时才报错。定位方法:异常信息 BeanDefinitionOverrideException 会直接打印出新旧两个 BeanDefinition 的 resourceDescription(来源文件/类),不需要靠猜。
Q5:一个自定义**BeanFactoryPostProcessor**(没实现**PriorityOrdered**/**Ordered**)想修改**ConfigurationClassPostProcessor**处理**@Bean**方法后生成的某个 BeanDefinition,一定能生效吗?
大概率能生效,但顺序是关键:ConfigurationClassPostProcessor 本身实现了 PriorityOrdered,且属于 BeanDefinitionRegistryPostProcessor,会在所有普通 BeanFactoryPostProcessor之前跑完(先执行完全部 Registry 类,再执行普通类)。所以只要你的后处理器是普通 BeanFactoryPostProcessor,理论上一定能"看到"@Bean 方法产生的 BeanDefinition 并修改它。但如果反过来——你想在一个 BeanDefinitionRegistryPostProcessor 里修改另一个同样是 Registry 类型、且排在你后面执行的后处理器的产物,那就要靠 @Order/PriorityOrdered 精确控制先后顺序了,顺序错了就会改了个"还不存在"的定义,静默失败。
Q6:**@Configuration**类如果标注了**proxyBeanMethods = false**,**@Bean**方法之间互相调用会怎样?为什么有些场景官方反而推荐关掉它?
关掉之后 CGLIB 代理不再生成,@Bean 方法间的直接调用就是纯 Java 方法调用,不会走单例缓存拦截,每次调用都会真正执行方法体、创建新对象——这在过去等于隐性 bug。但 Spring Boot 从某个版本起对"轻量级配置类"(proxyBeanMethods=false)做了优化:跳过 CGLIB 子类化可以显著减少启动时间和内存占用(尤其在大量配置类、Native Image/GraalVM 场景下更明显),前提是你能保证配置类内部的 @Bean 方法之间不存在互相调用依赖(改用方法参数注入依赖,而不是直接调用另一个 @Bean 方法)。这是"性能"和"隐式单例保证"之间的权衡,不是简单的对错问题。
Q7:如果一个**ApplicationListener**在**initApplicationEventMulticaster()**(第 8 步)执行之前就被注册,它会不会错过 refresh() 早期发布的事件?
会有丢失风险,但 Spring 专门处理了这个问题:在 ApplicationEventMulticaster 真正初始化之前(比如某些 BeanFactoryPostProcessor 阶段发布的事件),事件会被临时存入 earlyApplicationEvents 集合;等到第 10 步 registerListeners() 完成、监听器都注册齐了之后,容器会把这些"暂存"的早期事件重新广播一遍。所以只要监听器在 registerListeners() 之前完成注册(哪怕事件更早发布),最终仍然收得到——这是很多人不知道的一个"补偿机制"。
Q8:一个标了**@Lazy**的 Bean,它的 BeanDefinition 会不会因为"懒加载"而跳过注册?
不会。@Lazy 影响的只是第 11 步(finishBeanFactoryInitialization)批量创建单例时是否立刻实例化——懒加载的 Bean 会被跳过,直到第一次被 getBean() 或被别的 Bean 注入触发时才真正创建。但它的 BeanDefinition 在注册阶段(远早于第 11 步)就已经和其他 Bean 一样进了 beanDefinitionMap,容器从一开始就"知道"它的存在,只是暂缓生产。区分"配方已登记"和"产品已下线"这两件事,是理解 @Lazy 的关键。