一、承接 089:传播行为解决"事务边界",隔离级别解决"事务之间怎么互相看见"
089 讲的传播行为回答的是"一个事务方法调用另一个事务方法时,两者是不是同一个物理事务";而这篇要讲的隔离级别(Isolation),回答的是完全不同的另一个问题:当两个(甚至更多)物理事务并发执行时,一个事务能"看见"另一个事务尚未提交、正在修改的数据到什么程度。这是 @Transactional 注解里除了 propagation 之外最容易被问到、也最容易被想当然回答的一个属性,因为大多数人平时根本不配置它——默认值背后藏着的东西,恰恰是面试爱挖的坑。
二、三种并发异象:脏读、不可重复读、幻读
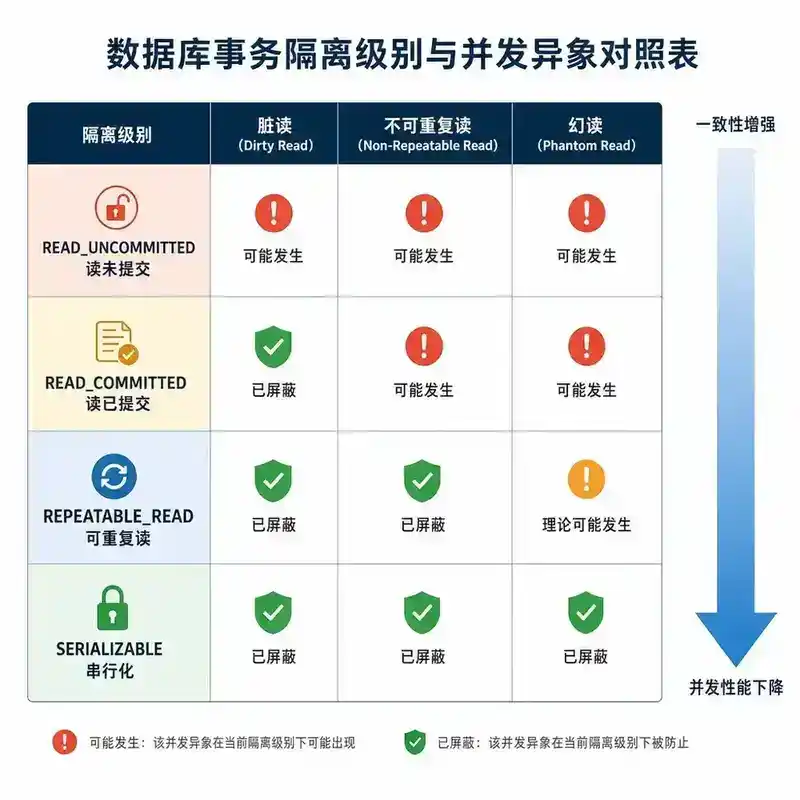
要理解隔离级别,必须先理解它到底"隔离"的是什么问题。SQL 标准定义了三种由并发事务引发的异常现象,隔离级别越高,能屏蔽的异象越多:
脏读(Dirty Read):
  事务A修改了一行数据但还没提交,事务B读到了这个未提交的修改;
  如果事务A之后回滚,事务B读到的数据就是"从未真实存在过"的脏数据。

不可重复读(Non-repeatable Read):
  事务A在同一个事务内,两次读取同一行数据,
  中间事务B修改并提交了这行数据,导致A两次读到的结果不一致。

幻读(Phantom Read):
  事务A在同一个事务内,两次执行同样条件的范围查询(比如 WHERE age > 20),
  中间事务B插入了一条满足条件的新记录并提交,导致A第二次查询多出了"幻影"记录。
SQL 标准定义的四种隔离级别,就是按"能屏蔽哪些异象"划分的:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| READ_UNCOMMITTED(读未提交) | 可能发生 | 可能发生 | 可能发生 |
| READ_COMMITTED(读已提交) | 已屏蔽 | 可能发生 | 可能发生 |
| REPEATABLE_READ(可重复读) | 已屏蔽 | 已屏蔽 | 理论上可能发生(MySQL InnoDB 实际已屏蔽) |
| SERIALIZABLE(串行化) | 已屏蔽 | 已屏蔽 | 已屏蔽 |
隔离级别越高,数据一致性越强,但代价是并发性能越差(更多的锁、更长的等待),这是一条贯穿整篇文章的核心权衡。
三、Spring 的 Isolation 枚举与 DEFAULT 的真实含义
public enum Isolation {
    DEFAULT(-1),           // 使用底层数据源的默认隔离级别,Spring 自己不做任何设置
    READ_UNCOMMITTED(1),
    READ_COMMITTED(2),
    REPEATABLE_READ(4),
    SERIALIZABLE(8)
}
@Transactional(isolation = Isolation.REPEATABLE_READ)
public void transferMoney(String from, String to, BigDecimal amount) {
    // ...
}
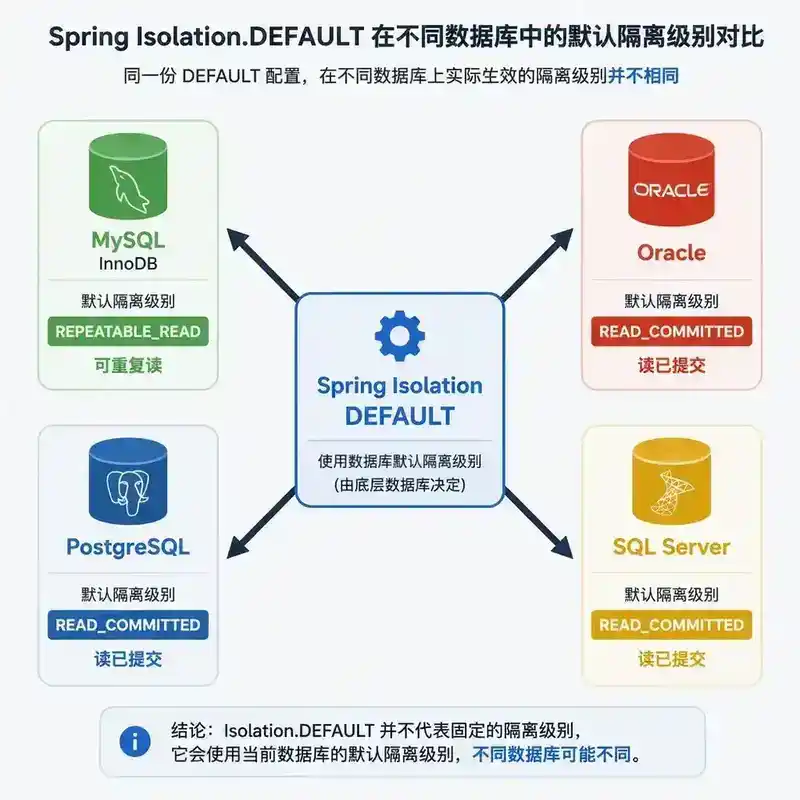
最容易被问错的一点:Isolation.DEFAULT不是"Spring 有一个统一的默认隔离级别",而是"完全不干预,交给底层数据库自己的默认值"。不同数据库的默认隔离级别其实并不一样:
MySQL(InnoDB)      默认:REPEATABLE_READ
Oracle               默认:READ_COMMITTED
PostgreSQL           默认:READ_COMMITTED
SQL Server           默认:READ_COMMITTED
也就是说,同一份 Spring 代码、同一个 @Transactional(isolation = Isolation.DEFAULT)(或者根本不写 isolation 属性,因为 DEFAULT 本身就是缺省值),如果把底层数据库从 MySQL 换成 Oracle,实际生效的隔离级别是不一样的——这不是 bug,而是 DEFAULT 语义的必然结果。这也是为什么"MySQL 默认隔离级别是什么"这类问题经常被拿出来单独考,因为它和 Spring 层面的默认行为是直接挂钩的。
四、隔离级别是怎么真正传递到数据库的:JDBC 这一层
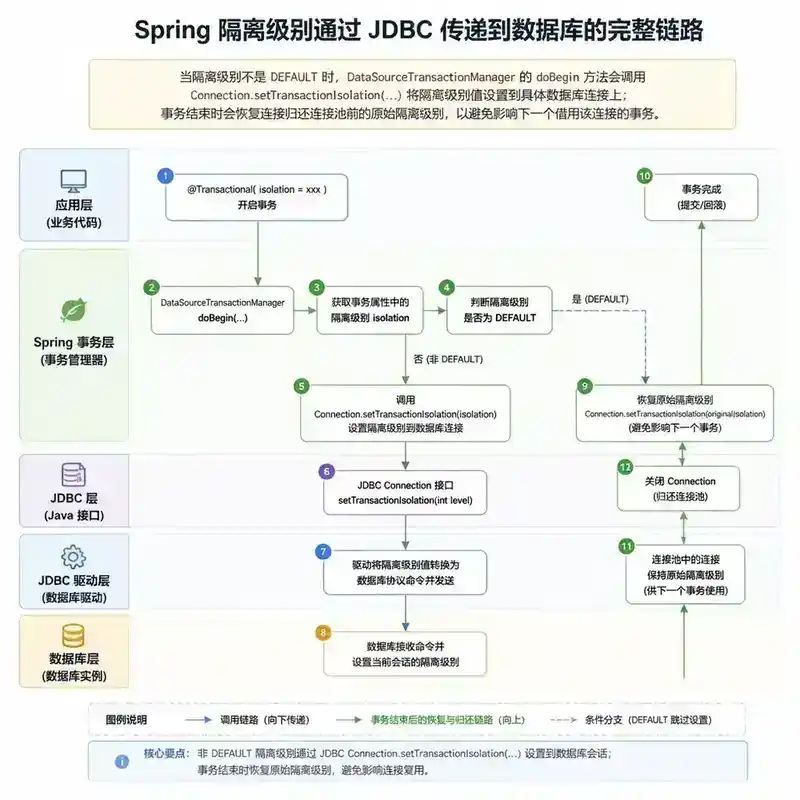
// DataSourceTransactionManager#doBegin 简化后的核心逻辑
protected void doBegin(Object transaction, TransactionDefinition definition) {
    DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction;
    Connection con = txObject.getConnectionHolder().getConnection();

    // 关键:只有在明确指定了非 DEFAULT 的隔离级别时才会调用这一行
    if (definition.getIsolationLevel() != TransactionDefinition.ISOLATION_DEFAULT) {
        int previousIsolationLevel = con.getTransactionIsolation();
        con.setTransactionIsolation(definition.getIsolationLevel()); // 直接调用 JDBC 标准接口
        txObject.setPreviousIsolationLevel(previousIsolationLevel); // 记录旧值,事务结束后要恢复
    }

    con.setAutoCommit(false); // 关闭自动提交,事务边界正式开始
}
链路很直接:Spring 的 Isolation 枚举值,最终就是通过标准 JDBC 接口 Connection.setTransactionIsolation(int) 设置到具体的数据库连接上的——这一行代码调用完成之后,"隔离级别"这件事就完全交给数据库引擎自己去实现了(不同数据库内部用锁、MVCC 快照等不同机制实现同一个隔离级别语义,这已经不是 Spring 或 Java 层能管的事)。还有一个容易被忽略的细节:事务结束后 Spring 会把隔离级别恢复成设置之前的旧值(previousIsolationLevel),因为数据库连接是从连接池借来的,如果不恢复,下一个借到这个连接的、完全不相关的事务会"继承"上一次遗留的隔离级别设置,造成难以定位的诡异 bug。
五、和 089 的知识点交叉:加入已有事务时指定不同隔离级别会怎样
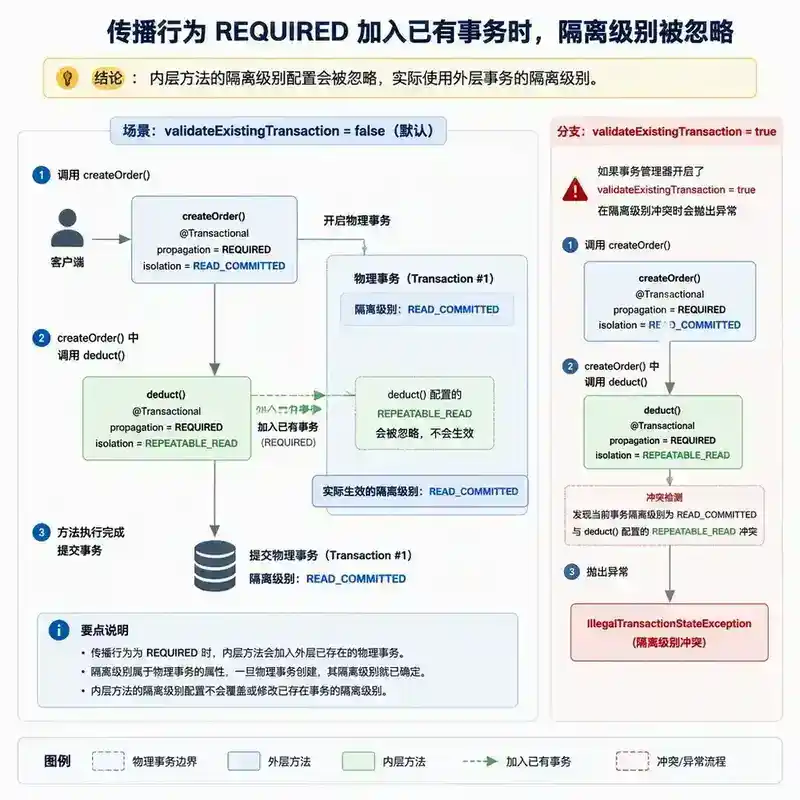
这是把 089(传播行为)和本篇(隔离级别)真正串起来的一个关键场景:
@Service
public class OrderService {
    @Autowired private InventoryService inventoryService;

    @Transactional(isolation = Isolation.READ_COMMITTED) // 外层:READ_COMMITTED
    public void createOrder(String item) {
        saveOrder(item);
        inventoryService.deduct(item); // REQUIRED,加入外层事务
    }
}

@Service
public class InventoryService {
    // REQUIRED(默认)+ 指定了 REPEATABLE_READ
    @Transactional(propagation = Propagation.REQUIRED, isolation = Isolation.REPEATABLE_READ)
    public void deduct(String item) {
        // 这里配置的 REPEATABLE_READ 会生效吗?
    }
}
答案是:不会生效。因为 deduct 的传播行为是 REQUIRED,它加入的是 createOrder 已经开启的那个物理事务——隔离级别是物理事务级别的属性(对应 JDBC 连接的一次 setTransactionIsolation 调用),只有在真正开启一个新物理事务的那一刻才会生效。既然 deduct 只是加入已有事务而没有新开事务,它自己配置的 REPEATABLE_READ 根本没有机会被应用,实际生效的隔离级别仍然是最外层 createOrder 设置的 READ_COMMITTED。Spring 默认对这种"隔离级别声明冲突"是静默处理、不报错的;只有显式把事务管理器的 validateExistingTransaction 属性设为 true,Spring 才会在检测到这种冲突时抛出 IllegalTransactionStateException,主动提醒开发者"你配置的隔离级别被忽略了"。这个默认静默的行为,是这个知识点上最容易踩坑、也最容易在面试里被问到"为什么我配置的隔离级别没生效"的根因。
六、只读事务(readOnly):不是数据库层面的强制约束
@Transactional(readOnly = true)
public List<Order> queryOrders(String userId) {
    return orderMapper.selectByUserId(userId);
}
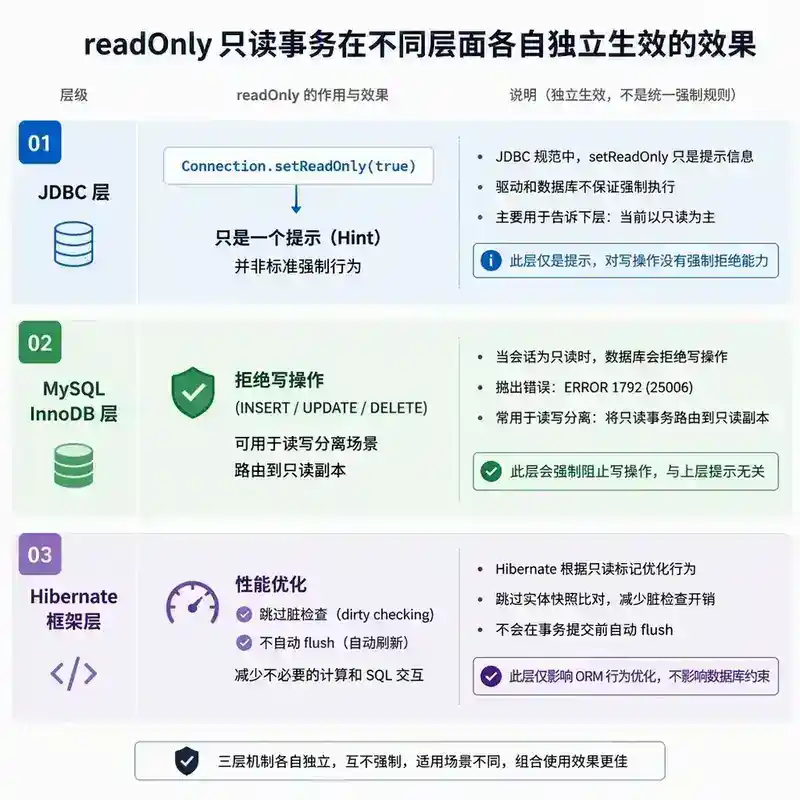
readOnly = true 常被误解为"数据库会强制阻止这个事务执行写操作",但这不是 JDBC 标准规定的行为——Connection.setReadOnly(true) 只是一个提示(hint),具体效果完全取决于数据库驱动的实现:
MySQL(InnoDB):确实会拒绝在只读事务里执行 INSERT/UPDATE/DELETE,抛出异常;
                部分 MySQL 中间件/连接池方案还会利用这个标志把只读事务路由到只读副本(读写分离)。
Oracle/PostgreSQL:readOnly 更多是优化提示,不一定强制拒绝写操作
                  (具体行为随版本和配置有差异,不能一概而论)。
除了数据库驱动层面的效果,Spring/Hibernate 这一层还会利用 readOnly 做性能优化:Hibernate 在 readOnly 的 Session 下会跳过脏检查(dirty checking)和自动 flush,因为反正不会有写操作需要同步到数据库,省掉这部分开销;readOnly 本质上是"一个信号,被多个层面(数据库驱动、连接池路由、ORM 框架)分别拿去做了不同的优化",而不是一条统一的、语言层面强制生效的规则——这正是它容易被简化成"只读事务=不能写"这种不准确说法的原因。
七、事务超时(timeout):从物理事务开启那一刻开始计时
@Transactional(timeout = 5) // 单位:秒
public void batchProcess(List<String> items) {
    for (String item : items) {
        process(item); // 如果整体耗时超过 5 秒,事务会被标记超时并回滚
    }
}
// AbstractPlatformTransactionManager 内部,事务开启时会记录一个deadline
// DefaultTransactionStatus 持有 TransactionDeadline,之后每次关键操作前都会检查
if (transaction.hasTimeout() && System.currentTimeMillis() > transaction.getDeadline()) {
    throw new TransactionTimedOutException("事务超时:deadline已过");
}
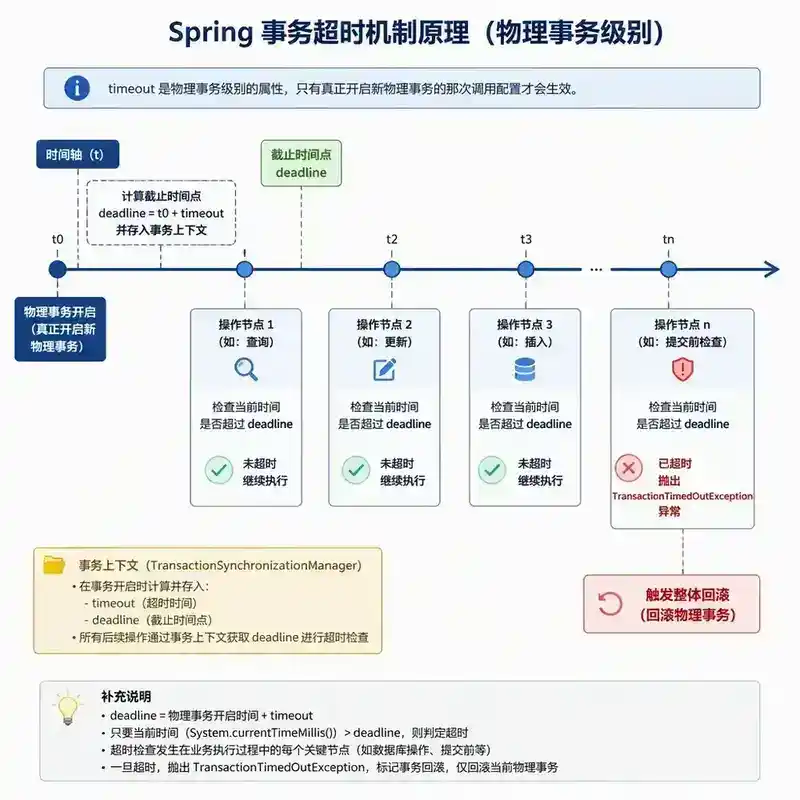
超时机制的实现原理很直接:事务真正开启(物理事务开始)的那一刻,Spring 会计算出一个截止时间点(deadline),存放在事务上下文里;之后事务执行过程中的一些关键操作(比如获取新的 JDBC 连接、执行某些底层数据库操作)会检查当前时间是否已经超过这个 deadline,一旦超过就抛出 TransactionTimedOutException 并触发回滚。这里有一个和 089 传播行为、以及本篇隔离级别完全一致的规律:**timeout**同样是物理事务级别的属性——如果一个方法的传播行为是 REQUIRED 并加入了已有的物理事务,它自己配置的 timeout 同样不会生效,真正起作用的是最外层、真正开启这个物理事务的那个方法上配置的 timeout 值。这是隔离级别、超时、传播行为三者背后共享的同一条底层规律:凡是绑定在"物理事务"这个粒度上的属性,只有真正开启新物理事务的那次调用配置才有意义,中途加入进来的方法上重复配置这些属性大多是无效的。
八、常见误区
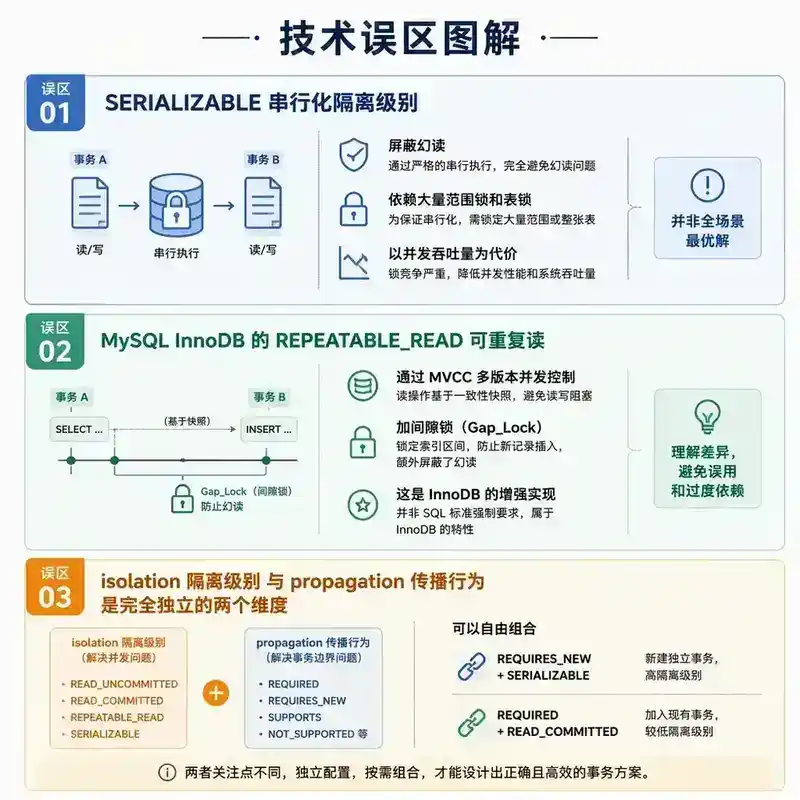
// 误区一:以为 SERIALIZABLE 绝对不会有幻读问题,是"完全安全"的隔离级别
// 现实:SERIALIZABLE 确实按 SQL 标准屏蔽了幻读,但代价是大量使用范围锁/表锁,
// 高并发写场景下会导致严重的锁等待甚至死锁,"绝对安全"是以吞吐量为代价换来的,
// 生产环境极少直接用 SERIALIZABLE,通常用其他机制(乐观锁、版本号)替代

// 误区二:认为 MySQL 的 REPEATABLE_READ 和 SQL 标准定义的 REPEATABLE_READ 完全等价
// 现实:MySQL InnoDB 的 REPEATABLE_READ 通过 MVCC + 间隙锁(Gap Lock)额外做到了
// 屏蔽幻读(标准里 REPEATABLE_READ 理论上是可能发生幻读的),这是 InnoDB 的增强实现,
// 不是 SQL 标准对 REPEATABLE_READ 的强制要求,把这个当成所有数据库的通用行为是常见的以偏概全

// 误区三:把 isolation 和 propagation 混为一谈
// isolation 解决"并发事务之间互相看见什么",propagation 解决"方法调用之间事务边界怎么划分",
// 两者是完全独立的两个维度,一个事务可以是 REQUIRES_NEW + SERIALIZABLE,
// 也可以是 REQUIRED + READ_COMMITTED,四种传播行为和四种隔离级别是可以自由组合的
九、总结
- 隔离级别解决的是"并发事务之间互相看见什么",通过屏蔽脏读、不可重复读、幻读三种异象,级别越高一致性越强、并发性能代价越大。
**Isolation.DEFAULT**不是统一默认值,而是"完全交给底层数据库自己的默认隔离级别",MySQL 默认 REPEATABLE_READ,Oracle/PostgreSQL/SQL Server 默认 READ_COMMITTED。- 隔离级别最终通过标准 JDBC 接口
**Connection.setTransactionIsolation**设置到数据库连接上,是物理事务级别的属性,事务结束后 Spring 会恢复连接原来的隔离级别。 - 传播行为为 REQUIRED 加入已有事务时,方法自己配置的 isolation/timeout 会被静默忽略,实际生效的是真正开启物理事务那个方法的配置;开启
validateExistingTransaction才会在冲突时报错。 **readOnly**不是 JDBC 标准强制的写操作拦截,而是分层生效的优化提示,数据库驱动、连接池路由、ORM 框架各自基于这个标志做不同的优化,效果因技术栈而异。**timeout**同样从物理事务开启那一刻开始计时,和隔离级别共享同一条规律——只对真正开启新物理事务的调用生效。
延伸阅读
- 相关源码:
DataSourceTransactionManager#doBegin、AbstractPlatformTransactionManager、TransactionDefinition、Isolation枚举 - 本系列相关篇目:087(Spring AOP 原理)、088(JDK 动态代理与 CGLIB)、089(Spring 事务传播行为)、091-092(声明式事务失效场景、事务实现原理)
提问回答模块(面试官视角,不计入阅读时长)
以下问题不是对文章内容的复述,而是模拟面试官会如何在这个话题上继续追问、绕开常见答案去考察真正的理解深度。
Q1:MySQL InnoDB 在 REPEATABLE_READ 下用 MVCC 实现"可重复读",那 InnoDB 是不是完全不需要加锁就能做到这一点?加锁和 MVCC 是什么关系?
不是完全不加锁——MVCC 解决的只是普通快照读(Snapshot Read)场景下的可重复读和幻读问题:一个事务在开始时(或者第一次查询时,取决于具体实现细节)拍下一份数据快照,之后同一事务内所有普通**SELECT**都读这份快照,自然读不到别的事务后续提交的修改。但如果查询语句带了**SELECT ... FOR UPDATE**或者是**UPDATE**/**DELETE**这类当前读(Current Read),InnoDB 必须读取最新的已提交数据并加锁(行锁+间隙锁),因为这类操作要基于最新状态做修改,不能基于一份过时的快照去改。所以完整答案是:MVCC 负责快照读场景的一致性,锁机制负责当前读场景的一致性和互斥,两者是配合工作、覆盖不同场景的两套机制,不是"用了 MVCC 就不需要锁"这么简单的替代关系。
Q2:如果一个只读查询方法配置了**@Transactional(readOnly = true)**,但方法体里不小心写了一条**UPDATE**语句,在 MySQL 环境下会发生什么?这个错误能不能在编译期或启动期被发现?
在 MySQL/InnoDB 环境下,运行时会直接抛出异常(类似 java.sql.SQLException: Connection is read-only. Queries leading to data modification are not allowed),因为 readOnly=true 最终会调用 Connection.setReadOnly(true),MySQL 驱动层面真的会拒绝这条写语句——但请注意这完全是运行时才会暴露的问题,Spring 和 Java 编译器都不会在编译期或启动期检测"一个标了 readOnly 的方法体内是否包含写操作",因为这需要静态分析方法体内所有可能执行的 SQL(包括通过 ORM 间接生成的 SQL),这在通用场景下是不可行的。这道题背后真正想考察的是:**readOnly**是一个开发者自己承诺的契约,框架层面只能在运行时被动检测违约,不能主动阻止你在标注了只读的方法里写代码——一旦线上验证不足,这类 bug 很容易一直潜伏到某次真的触发了写操作才暴露。
Q3:如果两个事务分别用 REPEATABLE_READ 和 READ_COMMITTED 隔离级别,同时对同一行数据做"读取-计算-更新"(比如库存扣减:先查库存、再算新值、再更新),哪种隔离级别更容易出现"更新丢失"问题?靠隔离级别能不能根本解决这类问题?
两种隔离级别都无法从根本上解决"读取-计算-更新"模式下的更新丢失(Lost Update)问题——这正是这道题的陷阱所在。即使是 SERIALIZABLE,如果两个事务各自基于自己读到的旧值独立计算出新值再写回(而不是用 UPDATE stock SET count = count - 1 WHERE id = ? 这种数据库原子操作,也不是显式加锁),仍然可能出现后提交的事务用自己计算的(基于同样旧值算出的)新值覆盖掉先提交事务的结果——数据库层面根本不知道"这次更新在语义上依赖了之前那次读取的值",隔离级别控制的是"事务之间能看见什么",不控制"应用代码在看见数据之后打算怎么处理它"。真正的解法要么是把"读取-计算-更新"下沉成一条数据库原子语句、要么是显式用 SELECT ... FOR UPDATE 加悲观锁、要么用版本号做乐观锁——这也是为什么"提高隔离级别"经常被误认为能解决并发更新问题,但实际上解决的维度完全不对。
Q4:如果用的是 Spring 的声明式事务,且业务方法内部调用了两次不同**@Transactional**方法,分别配置了**isolation = REPEATABLE_READ**和**isolation = SERIALIZABLE**,但传播行为都是默认的 REQUIRED,最终请求实际会经历几种隔离级别?
只会经历一种——取决于是哪个方法先开启了物理事务。如果这两次调用是从一个更外层已经处于事务中的方法触发的,那么无论内部这两个方法各自声明了什么隔离级别,它们都会加入外层已经存在的物理事务,各自声明的隔离级别都不会生效,实际生效的是最外层那次真正开启物理事务时使用的隔离级别。如果这两次调用互相独立(比如两次分开的、顶层的方法调用,中间没有共同的外层事务),那么第一次调用会用它自己声明的隔离级别真正开启一个新物理事务,第二次调用(如果确实是独立的顶层调用)也会用它自己声明的隔离级别开启另一个新物理事务——这时会经历两种隔离级别,但仍然不是"两次调用都用了各自的隔离级别在同一个事务里生效"这种理解。这道题的考察点和文章第五节讲的规律完全一致,只是换了个具体数字来检验是否真的理解了"隔离级别只在真正开启新物理事务时生效"这条规则。
Q5:如果团队里有人提议"为了绝对安全,把所有**@Transactional**方法统一改成 SERIALIZABLE",作为技术评审你会从哪几个角度反驳或补充条件?
至少要从三个角度展开:① 性能代价——SERIALIZABLE 在大多数数据库实现里意味着大量范围锁/表级锁甚至强制串行化执行冲突事务,高并发写场景下会导致锁等待队列迅速堆积,吞吐量可能出现数量级的下降,这对大部分业务系统是不可接受的代价;② 死锁概率上升——更大范围、更长时间的加锁意味着不同事务之间互相等待对方持有的锁的概率也上升,需要额外评估死锁检测和重试机制是否到位;③ "绝对安全"本身就是个需要拆解的诉求——很多所谓的并发安全问题(比如 Q3 提到的更新丢失)根本不是隔离级别能解决的维度,真正该做的是针对具体的并发场景(库存扣减用原子更新语句或乐观锁、需要行级互斥用显式 SELECT FOR UPDATE)采取精确的手段,而不是用一个全局最高隔离级别的"大锤"去尝试覆盖所有场景——这样做往往是隔离级别用得越高,越掩盖了本该在业务逻辑层面被正确处理的并发设计缺陷。
Q6:如果一个系统同时对接了 MySQL 和 Oracle 两种数据库(比如做数据库迁移的过渡期),一段业务代码统一用**Isolation.DEFAULT**,从 MySQL 切到 Oracle 后开始出现偶发的数据不一致问题,你会怎么排查、怎么解决?
排查思路应该直接对照本文第三节的核心结论:Isolation.DEFAULT 在 MySQL 上实际是 REPEATABLE_READ,切到 Oracle 后实际变成了 READ_COMMITTED——如果原有业务逻辑(哪怕不是刻意设计的)依赖了 REPEATABLE_READ 才能保证的"同一事务内多次读取结果一致"这个特性(比如先查询一遍库存判断是否充足、过一会儿再查一遍库存做校验),切到 Oracle 后同一事务内两次查询完全可能读到不同的结果(因为 Oracle 的 READ_COMMITTED 每次语句执行都基于最新已提交数据,而不是像 MySQL REPEATABLE_READ 那样基于事务开始时的快照),这正是典型的"隐式依赖了数据库默认隔离级别差异"导致的迁移 bug。解决方式应该是不再依赖**DEFAULT**,显式在**@Transactional**上声明业务真正需要的隔离级别(比如显式写 Isolation.REPEATABLE_READ),让代码的行为不再随底层数据库切换而改变——这也是为什么严谨的团队通常建议在做多数据库兼容或迁移场景时,绝对不要依赖 Isolation.DEFAULT 的隐式行为。