引言:从"哪里会失效"到"到底是怎么跑起来的"
上一篇讲了声明式事务的五种典型失效场景,核心结论是"只有调用经过代理才会触发事务逻辑"。但这句话只回答了"什么时候不生效",没有回答"当调用真的经过代理时,内部具体发生了什么"。这篇文章就是把这个黑盒打开:从 @EnableTransactionManagement 怎么让一个普通方法变成"事务方法",到 TransactionInterceptor 拦截到调用之后的每一步决策,再到 PlatformTransactionManager 怎么真正地向数据库开一个物理事务、提交或回滚。理解了这条完整链路,前面所有的"失效场景"都会变成这条链路上某一步没有被触发的自然推论,而不需要死记硬背。
一、从注解到代理:事务能力是怎么被"装"进 Bean 里的
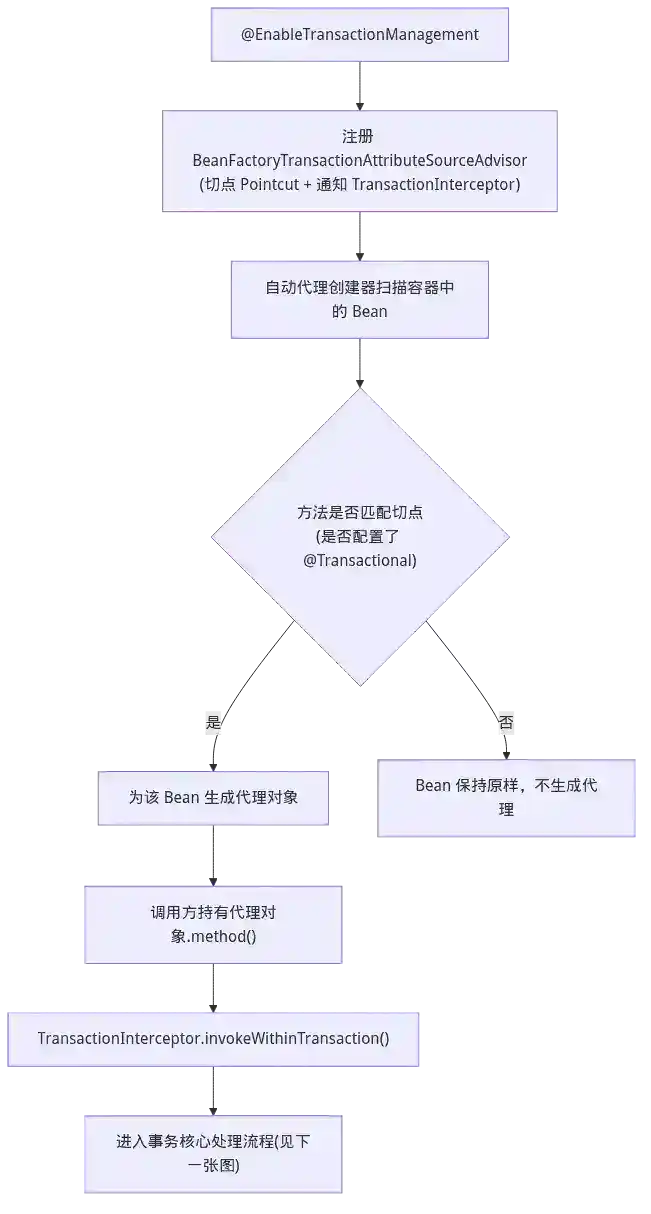
@EnableTransactionManagement 背后注册了几个关键组件,其中最核心的是 BeanFactoryTransactionAttributeSourceAdvisor——它本质上是一个 Advisor(通知器),由两部分组成:
- Pointcut(切点):判断"这个方法是否配置了
@Transactional",具体实现是TransactionAttributeSourcePointcut,内部委托给AnnotationTransactionAttributeSource去解析方法和类上的注解 - Advice(通知):也就是
TransactionInterceptor本身,真正执行事务逻辑的地方
容器启动阶段,Spring 的自动代理创建器(InfrastructureAdvisorAutoProxyCreator)会扫描每一个 Bean,检查容器里所有的 Advisor(包括这个事务 Advisor),只要发现某个 Bean 里有方法能匹配上 Pointcut,就会给这个 Bean 生成代理对象,并把匹配的 Advisor 织入代理的拦截器链。这一步就是"贴了 @Transactional 的 Bean 为什么会变成代理对象"的全部原因——不是框架"认识"这个注解本身,而是 Pointcut 判断出了匹配,触发了代理创建。
二、TransactionInterceptor:真正的决策中枢
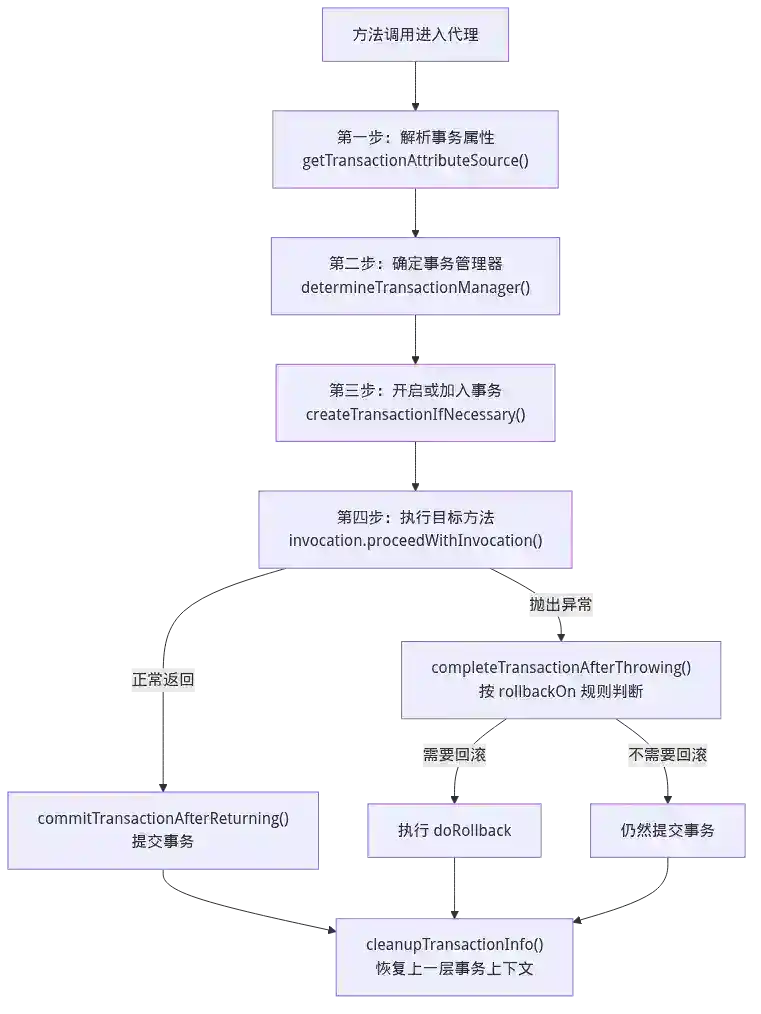
代理对象每次方法调用,都会先经过拦截器链,事务相关的逻辑集中在 TransactionAspectSupport.invokeWithinTransaction() 里(TransactionInterceptor.invoke() 只是把这个方法包了一层)。这个方法的逻辑可以拆成清晰的五步:
protected Object invokeWithinTransaction(Method method, Class<?> targetClass,
        InvocationCallback invocation) throws Throwable {

    // 第一步:解析这个方法的事务属性(propagation、isolation、rollbackFor...)
    TransactionAttribute txAttr = getTransactionAttributeSource().getTransactionAttribute(method, targetClass);

    // 第二步:确定用哪个 PlatformTransactionManager
    PlatformTransactionManager tm = determineTransactionManager(txAttr);

    // 第三步:按传播行为开启或加入事务,得到 TransactionInfo(事务上下文快照)
    TransactionInfo txInfo = createTransactionIfNecessary(tm, txAttr, joinpointIdentification);

    Object retVal;
    try {
        // 第四步:真正执行目标方法
        retVal = invocation.proceedWithInvocation();
    } catch (Throwable ex) {
        // 异常路径:按 rollbackOn 规则判断回滚还是提交
        completeTransactionAfterThrowing(txInfo, ex);
        throw ex;
    } finally {
        // 清理:恢复上一层事务上下文(如果是嵌套调用)
        cleanupTransactionInfo(txInfo);
    }

    // 第五步:正常返回,提交事务
    commitTransactionAfterReturning(txInfo);
    return retVal;
}
把这五步拆开看,091 里几乎每个失效场景都能在这里找到对应的"断点":第一步找不到事务属性(非 public 方法)、第二步找错了事务管理器(多数据源未指定)、第四步压根没被调用(自调用绕过了整个方法)、异常路径判断走了不回滚的分支(异常类型不对或被内部吞掉)。这条主干逻辑,就是理解所有具体行为的坐标系。
三、:传播行为在这里落地
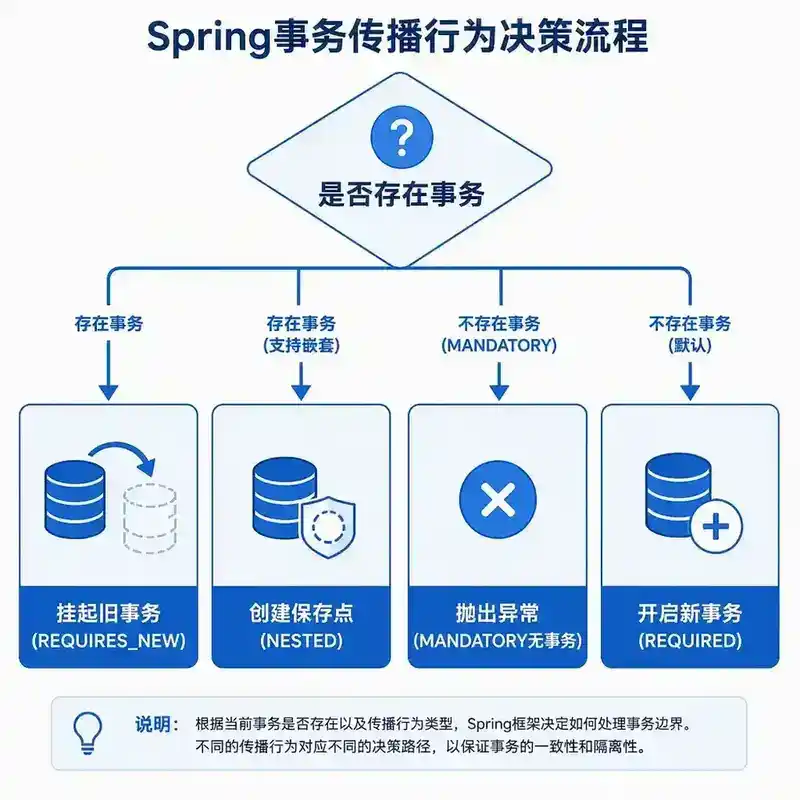
这一步调用的是 PlatformTransactionManager.getTransaction(TransactionDefinition),具体实现在 AbstractPlatformTransactionManager 里,核心分支逻辑是:
public final TransactionStatus getTransaction(TransactionDefinition definition) {
    Object transaction = doGetTransaction();   // 获取当前线程已绑定的事务资源(可能为空)

    if (isExistingTransaction(transaction)) {
        // 已存在事务:按传播行为分支处理(REQUIRES_NEW 挂起、NESTED 建 Savepoint...)
        return handleExistingTransaction(definition, transaction, debugEnabled);
    }

    if (definition.getPropagationBehavior() == PROPAGATION_MANDATORY) {
        throw new IllegalTransactionStateException("Transaction propagation 'mandatory' but no existing transaction found");
    }

    if (isPropagationRequired(definition)) {
        // REQUIRED / REQUIRES_NEW 等:开启全新的物理事务
        return startTransaction(definition, transaction, debugEnabled, suspendedResources);
    }
    // SUPPORTS / NOT_SUPPORTED 等:以非事务方式继续
    return prepareTransactionStatus(definition, null, true, newSynchronization, debugEnabled, null);
}
这一段就是 089 讲过的传播行为的真实落地位置——所有的"加入已有事务"还是"开新事务"的判断,都发生在这一层,跟具体用什么数据库无关,是数据库无关的通用逻辑。
四、物理事务的真正开启:
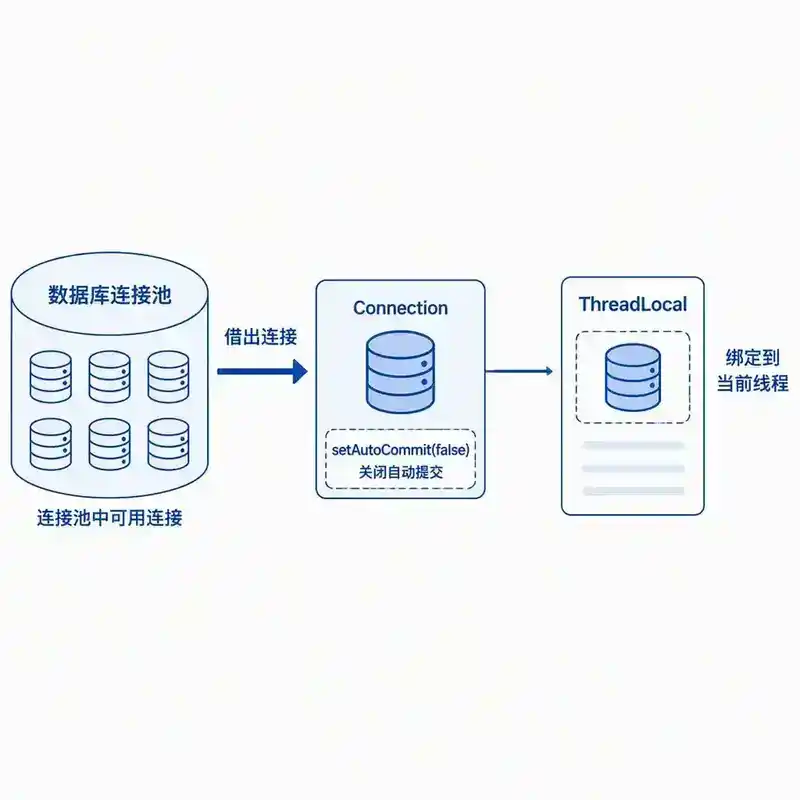
如果决定要开一个全新的物理事务,最终会调用到具体 PlatformTransactionManager 实现类的 doBegin 方法。以最常见的 DataSourceTransactionManager 为例:
protected void doBegin(Object transaction, TransactionDefinition definition) {
    DataSourceTransactionObject txObject = (DataSourceTransactionObject) transaction;
    Connection con = null;
    try {
        if (!txObject.hasConnectionHolder()) {
            Connection newCon = obtainDataSource().getConnection();   // 从连接池借一个物理连接
            txObject.setConnectionHolder(new ConnectionHolder(newCon), true);
        }
        con = txObject.getConnectionHolder().getConnection();

        Integer previousIsolationLevel = DataSourceUtils.prepareConnectionForTransaction(con, definition);
        txObject.setPreviousIsolationLevel(previousIsolationLevel);

        if (con.getAutoCommit()) {
            txObject.setMustRestoreAutoCommit(true);
            con.setAutoCommit(false);          // 关键一步:关闭自动提交,事务正式开始
        }
        // 把这个连接绑定到当前线程,后续同一线程内的 SQL 操作都会用这个连接
        TransactionSynchronizationManager.bindResource(obtainDataSource(), txObject.getConnectionHolder());
    }
    catch (Throwable ex) {
        // ... 异常处理,释放连接
    }
}
这里有三个关键动作,缺一不可:从连接池借出一个物理连接、关闭这个连接的自动提交模式、把连接绑定到当前线程的**ThreadLocal**。091 里"跨线程失效"的根本原因就在最后这一步——绑定动作只作用于发起绑定的那条线程,其他线程读取同一个 ThreadLocal 天然是空的。
五、提交与回滚:物理事务的收尾
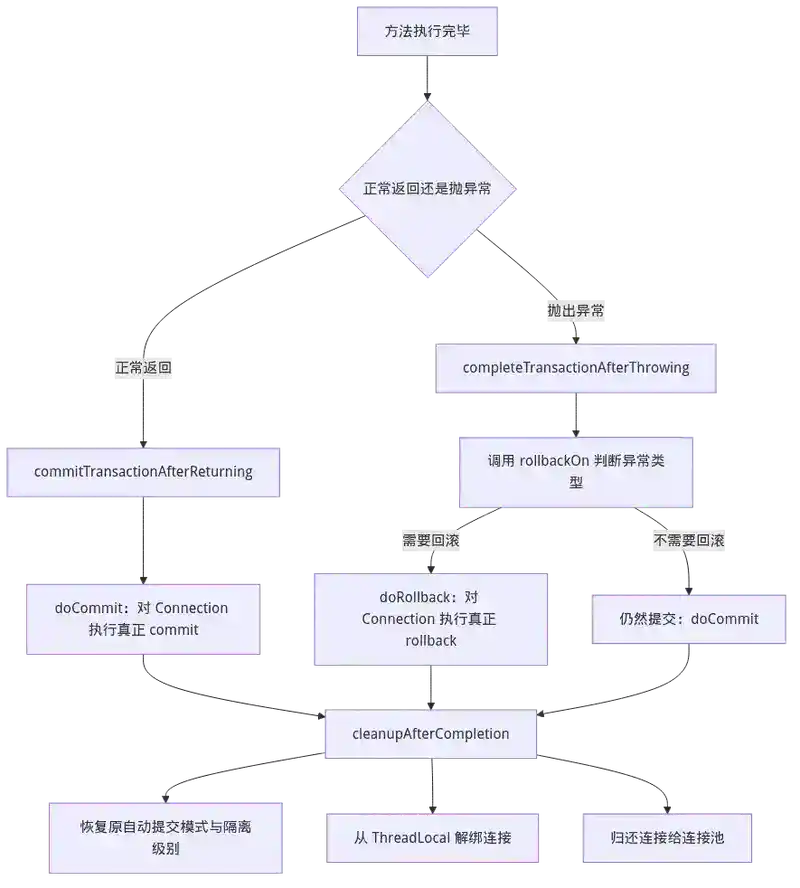
方法执行完毕后,如果是正常返回,走 commitTransactionAfterReturning → processCommit,最终调用 doCommit:
protected void doCommit(DefaultTransactionStatus status) {
    Connection con = ((DataSourceTransactionObject) status.getTransaction()).getConnectionHolder().getConnection();
    con.commit();   // 真正对数据库执行 COMMIT
}
如果是异常路径,completeTransactionAfterThrowing 会先调用 txInfo.transactionAttribute.rollbackOn(ex) 判断这个异常类型是否应该回滚(这正是 091 里 DefaultTransactionAttribute.rollbackOn() 的调用现场),决定回滚就调用 doRollback:
protected void doRollback(DefaultTransactionStatus status) {
    Connection con = ((DataSourceTransactionObject) status.getTransaction()).getConnectionHolder().getConnection();
    con.rollback();   // 真正对数据库执行 ROLLBACK
}
不管提交还是回滚,最后都会执行 cleanupAfterCompletion:恢复连接原来的自动提交模式和隔离级别、把连接从 TransactionSynchronizationManager 上解绑、归还连接给连接池。这一整套"借出连接 → 使用 → 归还连接"的生命周期,跟一次普通的 JDBC 连接池借用没有本质区别,Spring 事务管理器只是在合适的时机插入了 setAutoCommit(false) 和最终的 commit()/rollback()。
六、代理边界:事务能力止步于何处
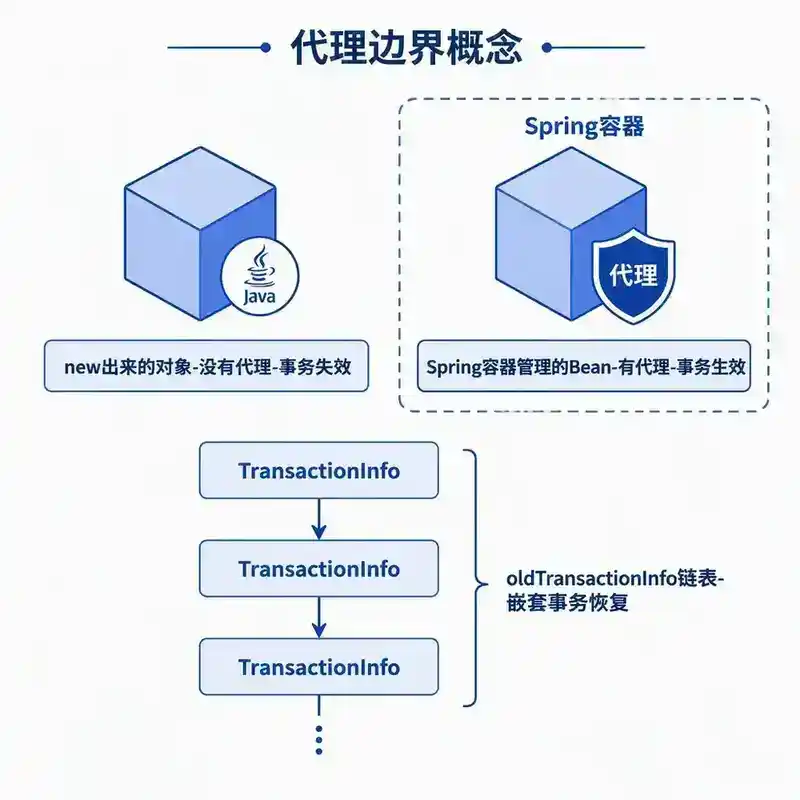
理解了整条链路之后,"代理边界"这四个字就有了具体含义——事务能力只存在于代理对象包裹的那一层方法调用,边界之外的东西框架管不到:
- 不是 Spring Bean 的对象没有代理。如果你在代码里
new OrderService()而不是从容器里拿,这个实例永远不会被套上代理,@Transactional在它身上从头到尾都不存在。 - 代理只包一层,不会穿透方法调用栈之外的东西。一次方法调用触发一次
invokeWithinTransaction,嵌套调用会形成一条TransactionInfo链表——每次进入一个新的事务方法,当前的TransactionInfo会被记录为"上一个"(oldTransactionInfo),方法退出时通过cleanupTransactionInfo弹出恢复,行为类似调用栈的入栈出栈。这也是为什么内层方法的传播行为(比如REQUIRES_NEW)执行完之后,外层方法能自动"回到"自己原来的事务上下文。 - 多个切面共同作用于同一个方法时,顺序由
**Advisor**的顺序决定,事务切面和别的切面(比如@Async、自定义日志切面)谁先执行、谁包在最外层,取决于@Order或Ordered接口的配置。如果顺序不对,可能出现"事务已经提交了,异步任务才拿到线程"之类的诡异现象——这也是"代理边界"的一种体现:事务只能保证自己包裹的那一层,包裹顺序本身也是需要显式控制的。
七、声明式事务与编程式事务:同一套引擎,两种触发方式
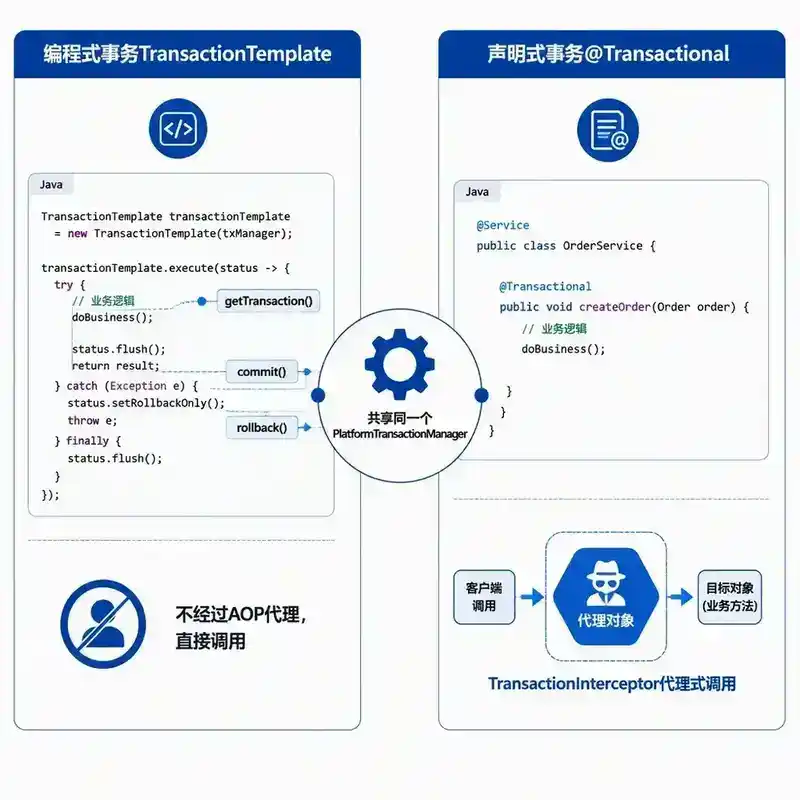
很多人以为 TransactionTemplate(编程式事务)和 @Transactional(声明式事务)是两套独立的机制,其实它们共享的是完全同一个 PlatformTransactionManager,区别只在于谁来调用**getTransaction**/**commit**/**rollback**:
// 编程式:自己手动调用,没有任何代理参与
transactionTemplate.execute(status -> {
    orderMapper.insert(order);
    return null;
});

// 声明式:由 TransactionInterceptor 代理式地调用,方法本身"感觉不到"事务的存在
@Transactional
public void createOrder(Order order) {
    orderMapper.insert(order);
}
TransactionTemplate.execute() 内部做的事情,跟 TransactionInterceptor.invokeWithinTransaction() 几乎一模一样——开启事务、执行回调、正常返回提交、抛异常回滚。唯一的差别是编程式事务不依赖 AOP 代理,代码里显式地写出了事务边界,因此完全不受"自调用失效"的困扰(因为它压根不需要经过代理),但代价是业务代码和事务管理逻辑耦合在了一起。这也解释了为什么"自调用问题"是声明式事务特有的坑——它是 AOP 代理机制带来的副作用,不是事务管理本身的缺陷。
八、小结:一条链路,串起所有细节
@EnableTransactionManagement
    → 注册 BeanFactoryTransactionAttributeSourceAdvisor(Pointcut + TransactionInterceptor)
    → 自动代理创建器扫描到匹配的方法,生成代理对象
    → 调用代理对象方法
        → TransactionInterceptor.invokeWithinTransaction()
            → 解析事务属性 → 确定事务管理器 → getTransaction()(传播行为在此分支)
                → doBegin():借连接、关自动提交、绑定 ThreadLocal
            → 执行目标方法
            → 正常返回:doCommit()  |  异常:rollbackOn() 判断 → doRollback()
            → cleanupAfterCompletion():恢复状态、解绑、还连接
这条链路上每一环出问题,都会对应到一种具体的"事务失效"或"行为异常"表现。把这张图记在脑子里,比记住任何一条零散的"注意事项"都更有用。
文末答疑:面试官会怎么问
Q1:如果同一个方法上叠加了**@Transactional**和一个自定义的**@Around**切面,两者的执行顺序不确定会导致什么问题?你会怎么排查和解决?
A:AOP 的多个 Advisor 作用于同一个方法时,执行顺序由 Advisor 的排序决定(@Order 或实现 Ordered 接口,数值越小越先执行、包裹在最外层)。如果自定义切面的顺序比事务切面更靠外,自定义切面里看到的"进入方法"其实是在事务开启之前,"退出方法"是在事务提交/回滚之后——这种情况下如果自定义切面依赖当前线程有一个已经开启的事务(比如想读取 TransactionSynchronizationManager 里的连接),就会拿不到。排查手段是打断点或者加日志观察实际的拦截器调用顺序,确认自己期望的"在事务内部"还是"在事务外部"执行,再用 @Order 显式声明顺序,不要依赖 Spring 默认的注册顺序(那是不稳定的隐式行为)。
Q2:**TransactionSynchronizationManager**除了绑定数据库连接之外,还提供了**registerSynchronization**这样的回调注册能力,这在什么场景下有用?和事务生命周期是什么关系?
A:TransactionSynchronization 接口允许在当前事务的关键节点(提交前、提交后、回滚后、完成后)注册回调,典型场景是"事务提交成功之后才发一条消息"——如果直接在业务方法里发消息,一旦事务后续回滚,消息已经发出去了造成数据不一致;通过 TransactionSynchronizationManager.registerSynchronization() 注册一个 afterCommit 回调(Spring 也封装了更易用的 @TransactionalEventListener(phase = AFTER_COMMIT)),可以保证消息发送严格发生在数据库事务真正提交之后。这本质上是给"事务边界"这件事开了一个可编程的扩展点,让业务逻辑能感知到事务的真实结果,而不是靠猜测方法有没有抛异常。
Q3:**AbstractPlatformTransactionManager**是一个模板方法模式的典型实现,**doBegin**、**doCommit**、**doRollback**都是留给子类实现的抽象步骤。如果要新增一种数据源类型的事务支持(比如某种新的 NoSQL 存储),你需要关注哪些环节,模板方法模式在这里解决了什么问题?
A:模板方法模式把"事务生命周期的通用流程"(传播行为判断、异常处理、清理逻辑)固化在父类里,把"跟具体资源打交道的细节"(怎么获取连接、怎么真正提交、怎么真正回滚)留给子类实现,这样新增一种存储的事务支持时,只需要关注 doGetTransaction、doBegin、doCommit、doRollback、doSuspend/doResume 这几个抽象方法怎么对接目标存储的原生事务 API,完全不需要重新实现传播行为、隔离级别兜底、超时控制这些通用逻辑。这也是为什么 Spring 生态里 JDBC、JPA、Hibernate、甚至一些消息中间件都能有各自的 PlatformTransactionManager 实现,却共享同一套 @Transactional 编程模型——关键就在于父类把"稳定不变的骨架"和"因资源而变的细节"做了干净的切分。
Q4:如果一个方法内部先执行了一段只读查询,又执行了一段写操作,**@Transactional(readOnly = true)**会不会阻止这次写操作被提交?如果没有阻止,**readOnly**这个属性的实际约束力体现在哪一层?
A:readOnly 在 Spring/JDBC 层面严格来说只是一个"提示"(hint),不是强制拦截写 SQL 的开关——具体是否真正拒绝写操作,取决于底层数据库/驱动的实现(例如 MySQL InnoDB 在只读事务里确实会拒绝写操作并报错,但这是数据库自己的行为,不是 Spring 强制的)。它的实际约束力体现在多个独立的层面:JDBC 层面通过 Connection.setReadOnly(true) 传递提示,部分数据库据此报错或路由到只读副本;ORM 框架(如 Hibernate)会据此跳过脏检查和自动 flush 来换取性能优化。所以回答这个问题时要点明:readOnly 不是一条统一的强制规则,而是一组分散在不同层面、各自独立生效的优化和提示信号,具体行为必须结合实际用的数据库和框架来判断,不能一概而论。