阅读时间:约 45 分钟 | 分类:15 安全架构
一、你无法防御你看不见的攻击
2023 年某金融机构被黑客潜伏 243 天后才被发现,攻击者早已完成了从初始入侵到横向移动的全过程。事后复盘发现:安全日志里有所有攻击痕迹,但没人看,也没人告警。
这不是孤例。Mandiant 的 M-Trends 报告显示,全球平均"驻留时间"(从入侵到被发现)为 16 天。16 天,足够攻击者把整个内网翻一遍。
安全日志与审计系统不是"锦上添花"的可观测性补充——它是安全架构的最后一道防线。防火墙可以被绕过,WAF 可以被绕过,但攻击者的一举一动,只要落到了日志里,就留下了不可磨灭的痕迹。本文从日志收集、安全事件监控、入侵检测到应急响应,构建一条完整的"看见→识别→响应"链路。
二、安全日志基础:什么该记、什么不该记
2.1 日志的"四要素"
一条合格的安全日志必须包含四个关键信息:
| 要素 | 说明 | 示例 |
|---|---|---|
| Who | 谁发起的操作 | 用户ID、源IP、User-Agent |
| What | 做了什么操作 | 登录、查询、删除、修改权限 |
| When | 什么时间 | 精确到毫秒的时间戳,且必须 NTP 同步 |
| Result | 操作结果 | 成功/失败/被拒绝,失败原因码 |
缺失任何一个要素,日志的审计价值就大打折扣。比如只记录了 "用户登录失败" 但没有源 IP,当攻击者暴力破解时,你连封禁哪个 IP 都不知道。
2.2 安全日志的分类
访问日志:记录谁在什么时候访问了什么资源。Nginx 的 access.log 是最典型的例子,但安全日志远不止于此——你需要记录 API 调用、数据库查询、文件访问、管理后台操作等所有敏感入口。
认证日志:登录、登出、Token 刷新、密码修改、MFA 验证。认证日志是暴力破解检测和账号劫持检测的核心数据源。
授权日志:权限变更、角色分配、资源授权。任何权限提升操作都是高危事件,必须记录审批链。
操作日志(Audit Log):对核心业务数据的增删改操作。不仅要记录"谁在什么时候改了什么",还要记录改之前的值和改之后的值——这在数据纠纷和合规审计中至关重要。
系统日志:进程启动/停止、服务状态变更、资源使用异常。系统日志是发现后门进程和异常服务的关键。
网络日志:防火墙规则变更、网络连接记录、DNS 查询日志。网络日志在追踪横向移动时价值最大。
2.3 日志的"不该记"
日志记录不是越多越好。有三个雷区必须避开:
绝对不能在日志中记录明文密码。即使只是"调试用",也不行。日志系统通常比业务系统有更宽松的访问控制,一旦日志泄露,所有用户的密码也就泄露了。
敏感个人信息的脱敏。手机号、身份证号、银行卡号、家庭住址等信息,在写入日志时必须脱敏。GDPR 和《个人信息保护法》对此有明确要求——日志也是存储个人信息的载体。
Token 和 Session ID 的截断。完整记录 JWT Token 或 Session ID 相当于把认证凭证写进了日志。建议只记录前 8 位作为标识即可。
三、日志收集架构:从产生到入库
3.1 为什么需要专门的日志收集层
"直接写 ES 不就行了?"——这是很多创业初期团队的做法。随着业务增长,问题会逐个暴露:
耦合风险:应用直接写 Elasticsearch,如果 ES 挂了,日志会丢失,而且应用可能因为日志写入阻塞而影响业务。
性能影响:每条日志都做一次网络 IO 写入存储,在高并发场景下,日志写入会成为性能瓶颈。
多源异构:你的日志来源包括 Java 应用(Log4j/Logback)、Nginx、MySQL 慢查询日志、Kubernetes 审计日志、云平台操作日志……每种日志格式不同,需要统一解析和标准化。
流量削峰:出现安全事件时,日志量可能瞬间暴涨数倍。没有缓冲层,存储系统会被直接冲垮。
3.2 经典日志收集架构
一套成熟的日志收集架构分为四层:
应用层(日志产生)
    ↓
采集层(Agent 采集,如 Filebeat/Fluentd)
    ↓
缓冲层(消息队列削峰,如 Kafka)
    ↓
处理层(解析/富化/过滤,如 Logstash/Flink)
    ↓
存储层(Elasticsearch / ClickHouse / S3)
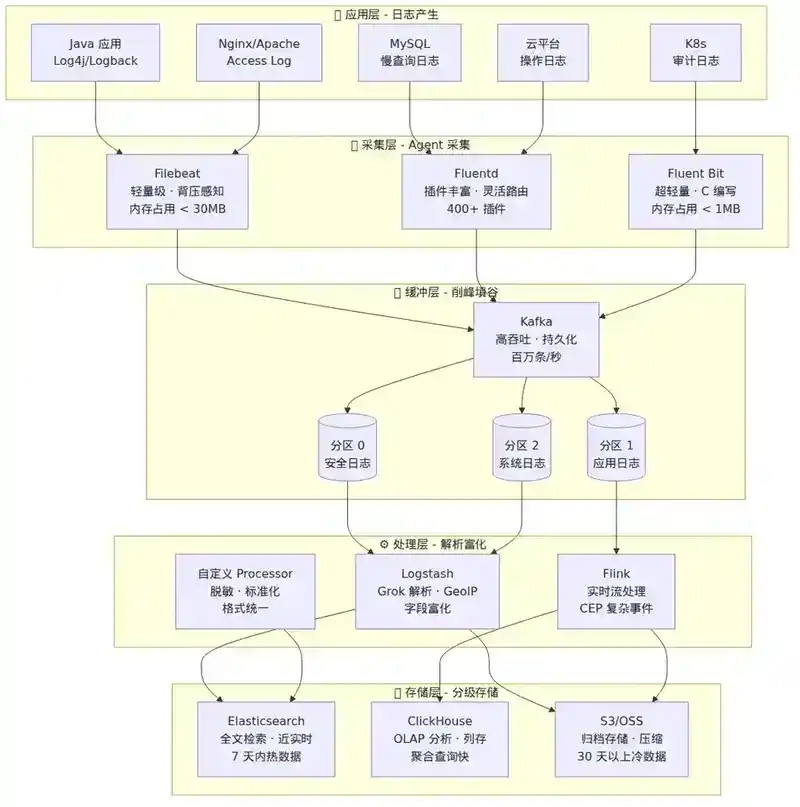
采集层的核心诉求是轻量和可靠。Filebeat 是 ELK 生态的标准选择,它的特点:
- 用 Go 编写,内存占用极低(通常 < 30MB)
- 内置背压感知——下游处理不过来时自动放慢采集速度
- 支持文件轮转检测和多行日志合并
# filebeat.yml 典型配置
filebeat.inputs:
  - type: log
    enabled: true
    paths:
      - /var/log/app/*.log
    multiline.pattern: '^\d{4}-\d{2}-\d{2}'
    multiline.negate: true
    multiline.match: after
    fields:
      app: order-service
      env: production
    fields_under_root: true

output.kafka:
  hosts: ["kafka1:9092", "kafka2:9092"]
  topic: "security-logs"
  partition.round_robin:
    reachable_only: true
  compression: snappy
缓冲层使用 Kafka 有几个关键设计决策:
分区策略:不要按应用名分区,按日志级别分区更合理——安全告警日志(ERROR/CRITICAL)可以设置更短的消费延迟,普通 INFO 日志允许更长延迟。或者按时间窗口分区,方便后续按时间范围消费。
数据保留:Kafka 在这里不是永久存储,而是削峰缓冲。保留 7 天足够——如果下游处理挂了 7 天还没恢复,那问题已经不是日志系统能解决的了。
处理层负责日志的标准化和富化:
// Logstash filter 配置示例
filter {
  grok {
    match => { "message" => "%{TIMESTAMP_ISO8601:timestamp} %{LOGLEVEL:level} %{DATA:logger} - %{GREEDYDATA:message}" }
  }
  date {
    match => ["timestamp", "ISO8601"]
    target => "@timestamp"
  }
  geoip {
    source => "client_ip"
    target => "geoip"
  }
  mutate {
    add_field => { "environment" => "production" }
    remove_field => ["@version", "host"]
  }
}
3.3 大规模日志架构:冷热分层
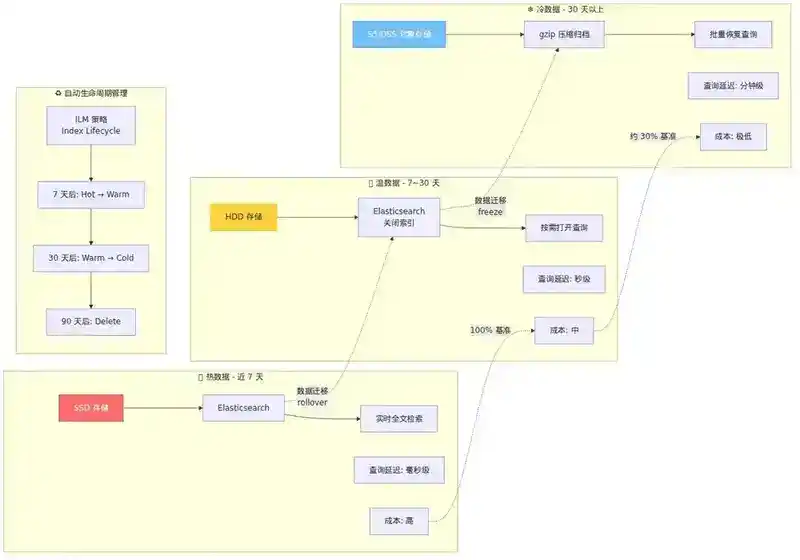
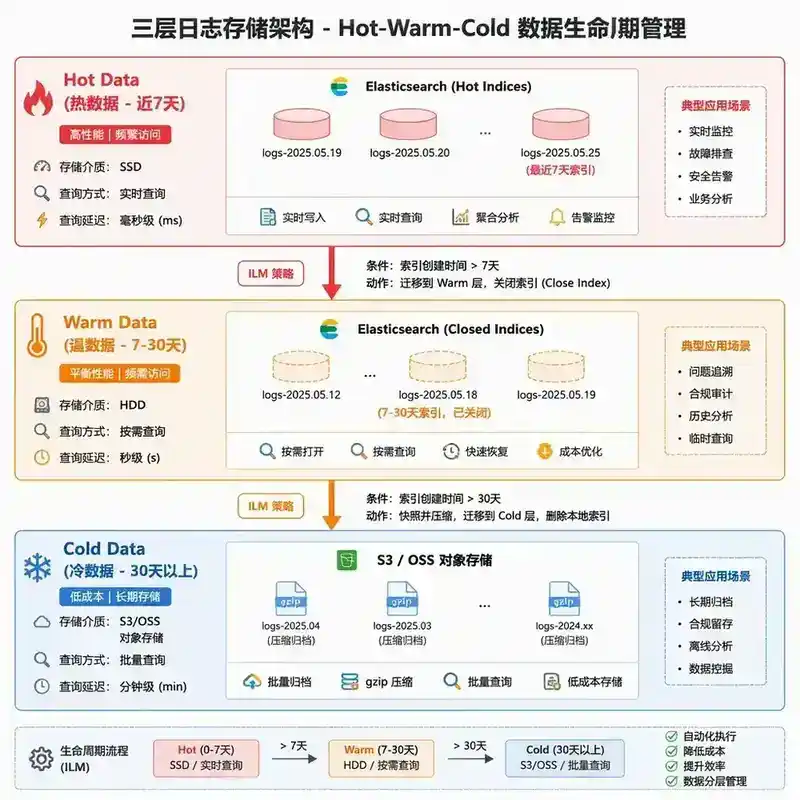
当每天日志量达到 TB 级别时,全量放 Elasticsearch 的成本会失控。成熟的方案是冷热分层:
- 热数据(近 7 天):存储在 SSD 节点的 Elasticsearch 或 ClickHouse,支持实时查询和告警
- 温数据(7-30 天):存储在 HDD 节点的 Elasticsearch,查询性能稍差但成本低
- 冷数据(30 天以上):压缩后存入 S3/OSS,按合规要求保留 6 个月到 3 年
// Elasticsearch ILM (Index Lifecycle Management) 策略
{
  "policy": {
    "phases": {
      "hot": {
        "actions": {
          "rollover": {
            "max_size": "50GB",
            "max_age": "1d"
          }
        }
      },
      "warm": {
        "min_age": "7d",
        "actions": {
          "shrink": { "number_of_shards": 1 },
          "forcemerge": { "max_num_segments": 1 }
        }
      },
      "cold": {
        "min_age": "30d",
        "actions": {
          "searchable_snapshot": {
            "snapshot_repository": "backup_repo"
          }
        }
      },
      "delete": {
        "min_age": "180d",
        "actions": { "delete": {} }
      }
    }
  }
}
四、安全事件监控:从日志到告警
4.1 告警规则的三个层次
第一层:基于阈值的规则(Threshold-based)
最基础的告警方式。比如"5 分钟内同一 IP 登录失败超过 10 次 → 触发暴力破解告警"。优点是简单可靠,缺点是只能检测已知模式。
# ElastAlert 规则示例 - 暴力破解检测
name: Brute Force Login
type: frequency
index: security-*
num_events: 10
timeframe:
  minutes: 5
filter:
  - query:
      query_string:
        query: "event:login_failure"
realert:
  minutes: 30
alert:
  - "slack"
  - "pagerduty"
第二层:基于行为的规则(Behavior-based)
不看单次操作,看行为模式。比如"某个用户在过去 30 天平均每天查询 50 条记录,今天突然查询了 5000 条 → 触发数据泄露告警"。这需要建立行为基线。
第三层:基于关联分析的规则(Correlation-based)
将多个看似无关的事件串联起来。比如"登录IP异常 + 新设备登录 + 权限变更 + 大文件下载"这四个事件如果同时发生,几乎可以确定是账号劫持后的数据窃取。这需要 SIEM(安全信息和事件管理)系统的支持。
4.2 告警疲劳与降噪
"安全团队每天收到 5000 条告警,其中 4990 条是误报"——这是安全行业的普遍困境。告警疲劳导致真正的攻击被淹没在噪音中。
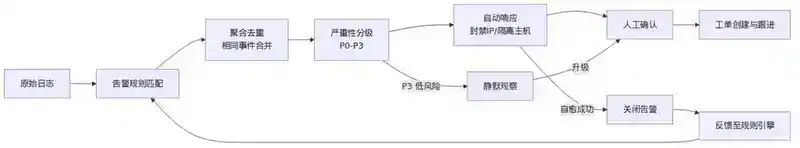
聚合策略:相同类型的告警不要逐条发送,聚合为一个事件。比如 100 次暴力破解尝试,只发一条告警:"检测到对 12 个账号的暴力破解尝试,源 IP: 203.0.113.5"。
严重性分级:不是所有告警都需要半夜把人叫醒。P0(紧急):直接威胁核心系统,需要立即人工介入。P1(高):可疑行为,需要 30 分钟内确认。P2(中):值得关注,可以在工作时间处理。P3(低):信息性告警,归档备查。
自愈机制:对于确定性的攻击(如已知的攻击签名、特定 IP 的扫描),自动触发封禁而不是发送告警。告警的终极目标是"不需要人工处理"。
4.3 从监控到检测:威胁建模
监控是被动的——你设定了规则,等事件触发。检测是主动的——你不断问"还有什么是我没看到的?"
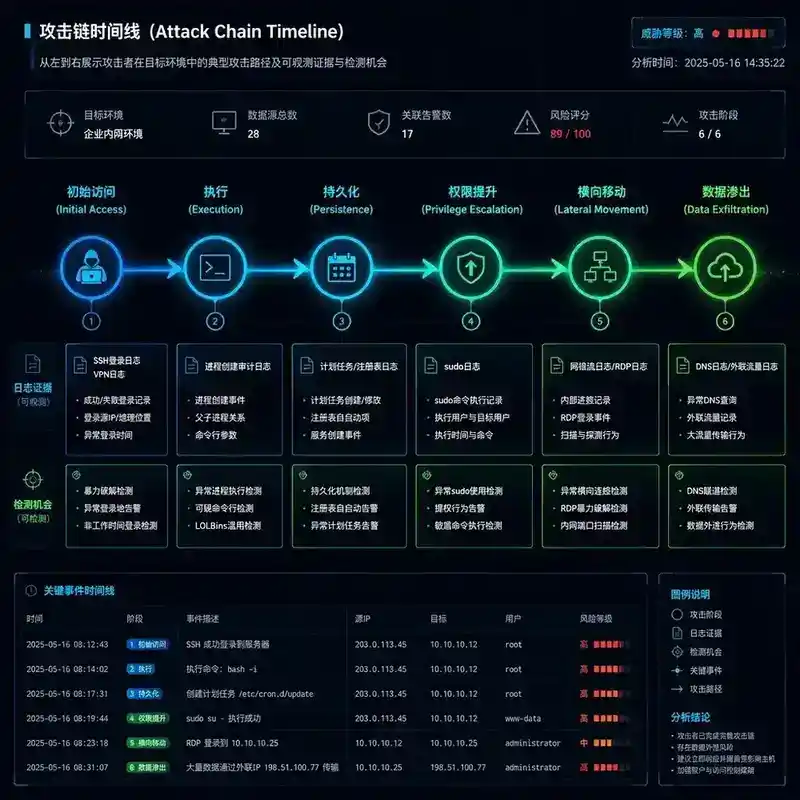
ATT&CK 框架映射:MITRE ATT&CK 是目前最权威的攻击行为知识库。将你的日志和告警映射到 ATT&CK 矩阵,找出覆盖盲区。
| ATT&CK 战术 | 对应日志源 | 盲区检查 |
|---|---|---|
| 初始访问(Initial Access) | 认证日志、VPN 日志 | 是否监控了所有入口? |
| 执行(Execution) | 进程创建日志、命令审计 | 是否监控了 shell 命令? |
| 持久化(Persistence) | 计划任务、服务注册、启动项 | 是否监控了计划任务创建? |
| 权限提升(Privilege Escalation) | sudo 日志、内核审计 | 是否监控了 sudo? |
| 横向移动(Lateral Movement) | 网络连接日志、SSH 日志 | 是否监控了内网连接? |
| 数据渗出(Exfiltration) | 出网流量日志、DNS 日志 | 大流量出站是否告警? |
五、入侵检测系统(IDS):签名与异常的双引擎
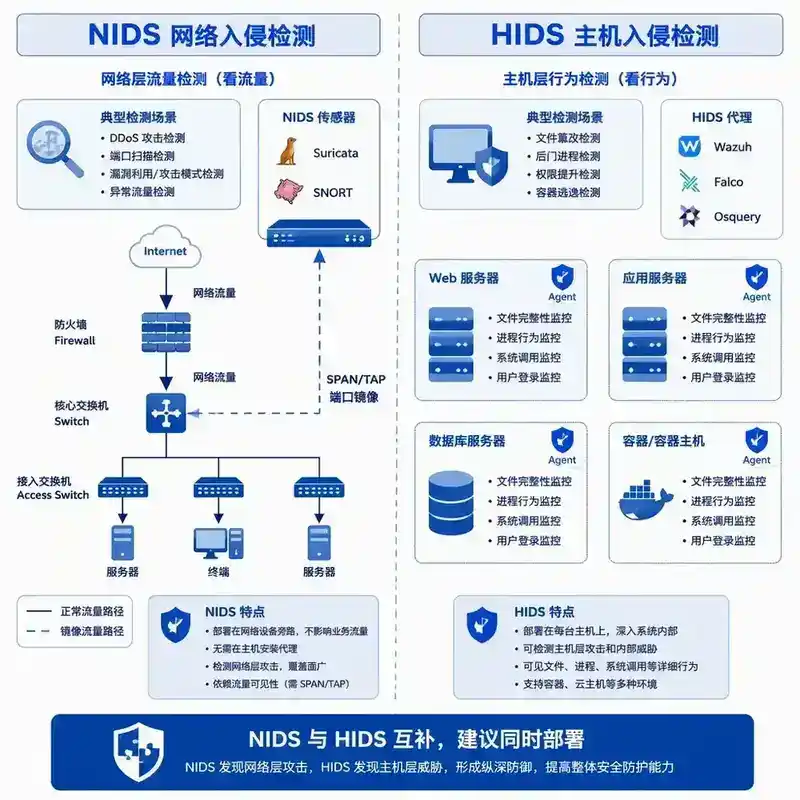
5.1 NIDS vs HIDS:部署位置决定检测能力
**NIDS(Network-based IDS)**部署在网络关键节点,通过镜像流量分析攻击行为。代表产品:Suricata、Snort。
NIDS 的优势在于全局视角——一台设备就能监控整个网段的东西向流量。但它有天然盲区:加密流量(TLS)看不见内容,而且面对 HTTPS 已成主流的现状,NIDS 的检测能力被大幅削弱。
**HIDS(Host-based IDS)**部署在每台主机上,监控文件完整性、进程行为、系统调用。代表产品:Wazuh、OSSEC、Falco。
HIDS 的优势在于深度——它能看到 NIDS 看不到的东西:文件被篡改、进程执行了异常命令、用户权限被提升。但 HIDS 的运维成本高——每台机器都要部署 Agent,Agent 本身也可能被攻击者干掉。
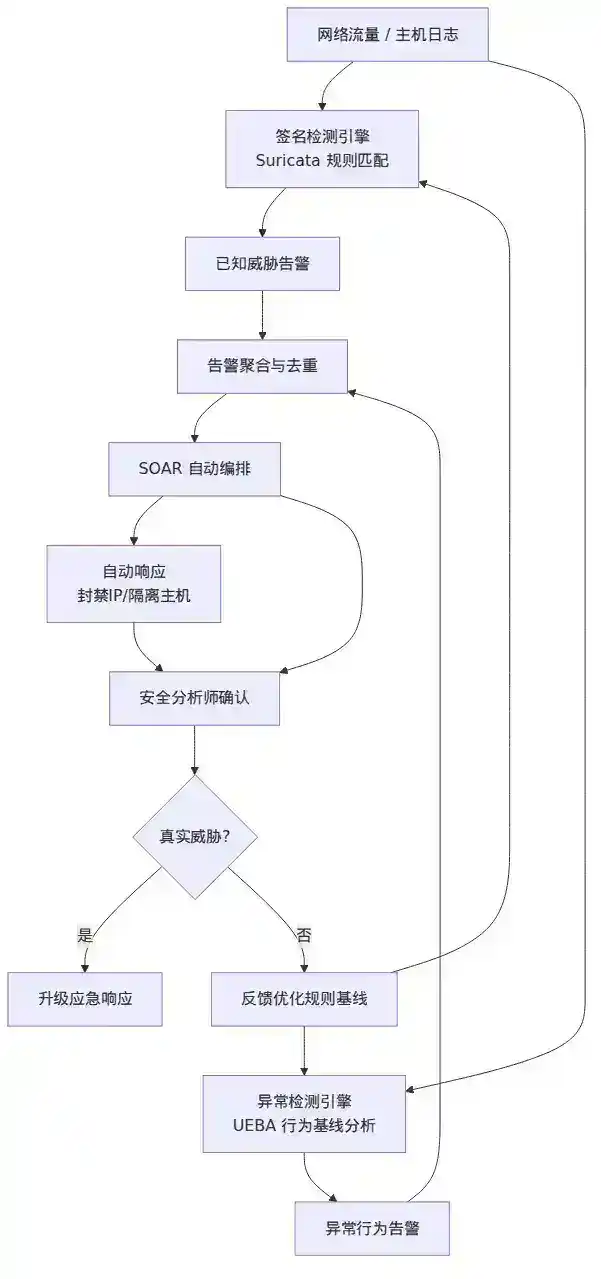
最佳实践是 NIDS + HIDS 的组合:NIDS 做广覆盖的流量异常检测,HIDS 做深度的主机行为分析,两者告警通过 SIEM 关联分析。
5.2 基于签名的检测:精准但滞后
签名检测是 IDS 最传统的检测方式。每条规则描述一个已知攻击的特征:
# Suricata 规则 - 检测 SQL 注入
alert http $EXTERNAL_NET any -> $HTTP_SERVERS $HTTP_PORTS (
    msg:"SQL Injection Attempt - UNION SELECT";
    flow:to_server,established;
    content:"UNION"; nocase;
    content:"SELECT"; nocase;
    distance:0;
    reference:url,owasp.org/www-community/attacks/SQL_Injection;
    classtype:web-application-attack;
    sid:1000001;
    rev:1;
)
签名检测的优点是精准——命中了规则基本就是攻击。缺点是滞后——只能检测已知攻击,0day 攻击没有签名。
5.3 基于异常的检测:广覆盖但高误报
异常检测通过学习"正常"行为基线,把偏离基线的事件标记为可疑。典型方法包括:
统计异常检测:对每个指标建立正常分布(如 CPU 使用率、网络流量、API 调用频率),偏离均值 3 个标准差 → 告警。问题是:电商大促期间流量暴涨是正常的,但模型不知道。
机器学习异常检测:用 Isolation Forest、Autoencoder 等算法,对多维特征建模。效果好于纯统计方法,但需要大量标注数据,且模型可解释性差——"为什么告警?因为模型说它是异常的"无法说服运维团队。
UEBA(用户实体行为分析):聚焦于"人"的行为。建立每个用户的正常行为画像(登录时间、常用设备、操作模式),当行为偏离画像时触发告警。UEBA 是目前检测账号劫持和内部威胁最有效的手段。
5.4 入侵检测的工程实践
规则不是越多越好。Suricata 默认规则集有 3 万条,全部启用会导致:
- 性能下降 50% 以上
- 告警淹没在噪音中
- 真正重要的告警被忽略
规则裁剪原则:先启用高置信度规则,根据实际环境调整——如果你没有 PHP 应用,就禁用所有 PHP 相关规则;如果你用了 WAF,就降低 Web 攻击规则的优先级,让 WAF 和 IDS 各司其职。
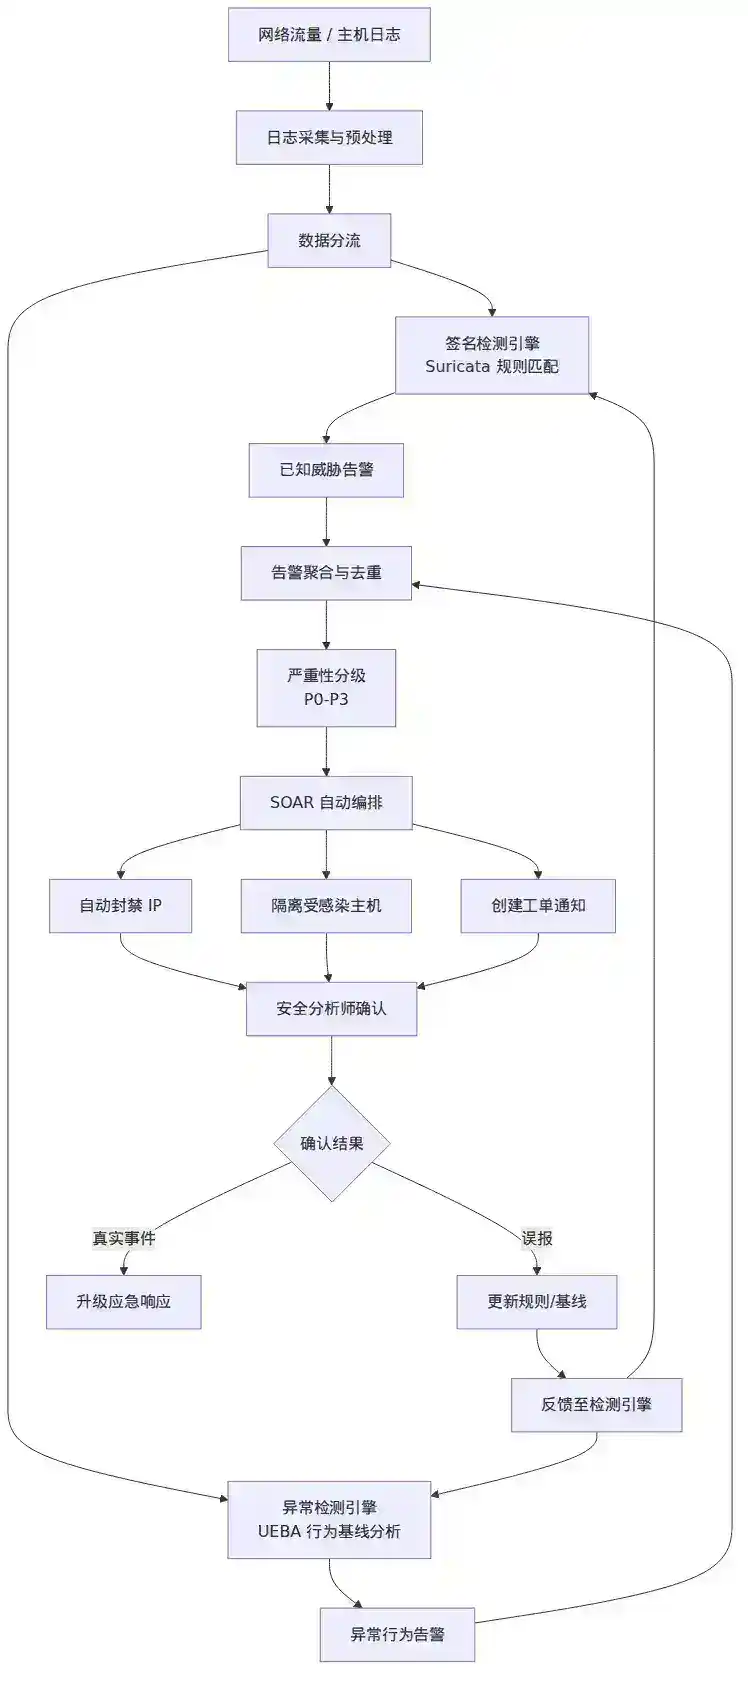
检测不是终点。IDS 告警必须和 SOAR(安全编排自动化与响应)联动。告警产生 → 自动查询威胁情报 → 自动封禁 IP → 自动创建工单 → 通知安全分析师。这才是完整的检测-响应闭环。
六、应急响应:当告警变成真实攻击
6.1 应急响应的六个阶段
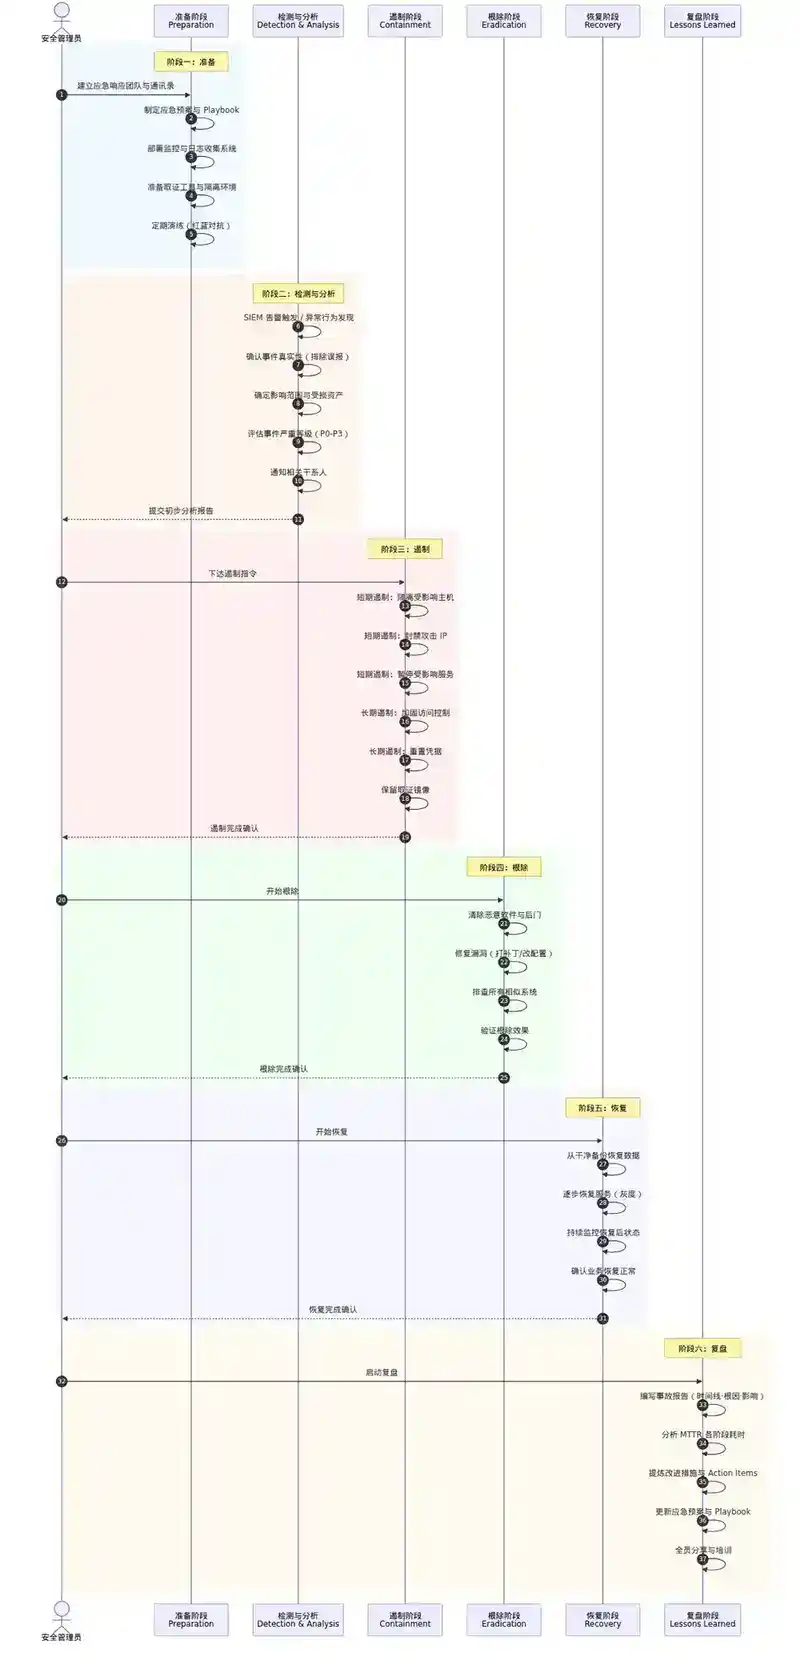
NIST SP 800-61 定义了应急响应的标准流程,六个阶段层层递进:
Phase 1:准备(Preparation)——不是在事件发生时才开始,而是在日常就做好。包括:建立应急响应团队(明确角色和联系方式)、准备好应急工具(取证工具、分析平台、通信渠道)、定期演练(红蓝对抗、桌面推演)。
Phase 2:检测与分析(Detection & Analysis)——确认事件是否为真实攻击。这一步最容易被匆忙跳过,但错误的判断会导致错误的方向。关键问题:攻击者是怎么进来的?影响了哪些系统?数据是否被窃取?
Phase 3:遏制(Containment)——阻止攻击蔓延。短期遏制:隔离受感染主机、禁用被劫持账号、阻断恶意 IP。长期遏制:在干净的环境中重建系统,等调查完成后再上线。
Phase 4:根除(Eradication)——彻底清除攻击者存在的痕迹。包括:删除恶意文件、后门、计划任务,修复被利用的漏洞,重置所有被泄露的凭证。
Phase 5:恢复(Recovery)——将系统恢复到正常状态。从已知干净的备份中恢复数据,逐步上线服务,加强监控以确认攻击者没有重新进入。
Phase 6:复盘(Lessons Learned)——最容易被跳过的阶段,却是最有价值的。复盘报告必须回答三个问题:为什么会发生?我们怎么发现的(发现得太晚了吗)?如何防止再次发生?
6.2 应急响应的关键决策
要不要拔网线?
拔网线是最直接的遏制手段,但代价很大:合法的业务中断、攻击者察觉后销毁证据、取证信息丢失。只有在以下情况才考虑拔网线:攻击正在实时进行(如数据正在被大量拖走)、攻击已经影响到用户安全(如用户数据被公开)。大多数情况下,网络隔离(VLAN 隔离、防火墙规则)比物理拔线更合适。
要不要通知用户?
数据泄露通知不是技术决策,而是法律和公关决策。但技术团队需要提供准确的信息:泄露了什么数据?涉及多少用户?泄露发生在什么时间范围?错误的信息比不通知更糟糕。
要不要付赎金?
勒索软件攻击中,这个决定最痛苦。从技术角度:付赎金后攻击者真的会解密吗(不一定——约 40% 的受害者付了钱也没拿回数据)?不付赎金能恢复吗(检查备份是否也被加密了)?法律团队和执法部门应该在决策链中,不应该是技术团队单独决定。
6.3 应急演练:红蓝对抗
纸面上的应急流程在真实事件中往往不堪一击。唯一的检验方式是演练。
桌面推演:不涉及实际系统,应急团队坐在一起走一遍流程。成本最低,适合每月一次。
模拟演练:在隔离环境中模拟攻击场景,应急团队需要实际登录系统、分析日志、执行遏制。比桌面推演真实得多。
红蓝对抗:红队(攻击方)在真实生产环境中尝试攻击,蓝队(防御方)在未知攻击方式的情况下进行检测和响应。这是最接近真实攻击的演练方式,但需要非常谨慎——红队的攻击可能意外影响生产。
七、安全审计:合规之外的工程价值
7.1 审计日志的工程价值
很多团队把审计日志视为"合规要求"——因为 ISO 27001、SOC2、等保要求,所以不得不做。但审计日志的工程价值远不止于此。
故障排查:当线上出现数据不一致时,审计日志是唯一能告诉你"谁改的、什么时候改的、改之前是什么"的证据。没有审计日志,你只能靠猜。
容量规划:审计日志记录的操作频率、数据量变化趋势,是容量规划的最真实数据源。
行为分析:通过审计日志可以分析用户的操作习惯,发现不合理的业务流程——比如某个操作需要 5 个步骤才能完成,说明产品设计有问题。
7.2 审计日志的不可篡改性
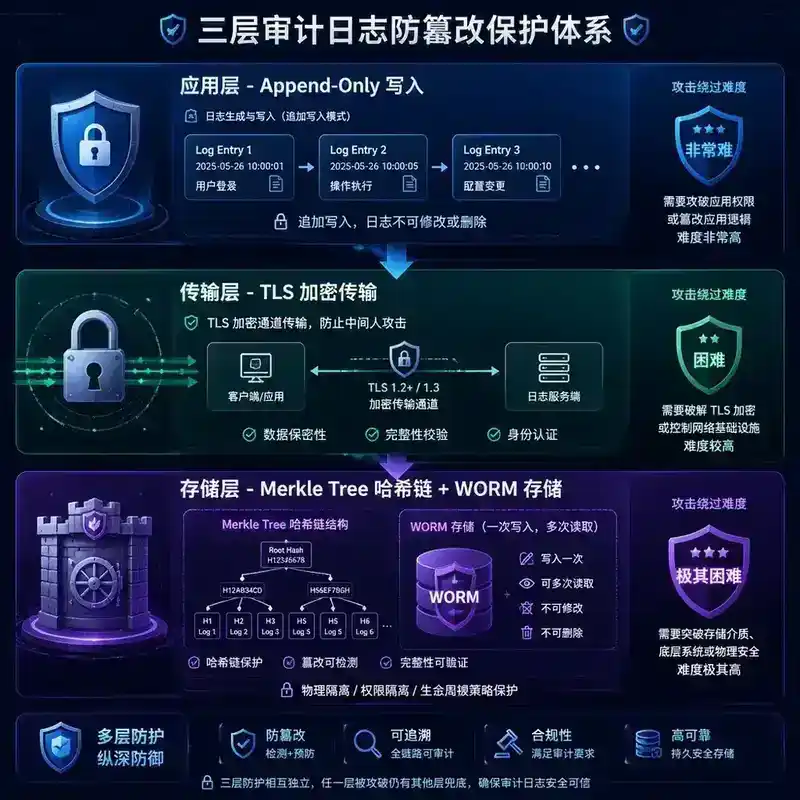
如果攻击者拿到 root 权限后可以删除审计日志,那审计就失去了意义。保护审计日志的完整性有三个层次:
写时保护:应用层写入审计日志时,使用 append-only 模式,禁止覆盖和删除。Linux 的 chattr +a 可以设置文件只能追加。
传输保护:日志从产生到集中存储的传输过程中,使用 TLS 加密,防止中间人篡改。
存储保护:使用区块链或 Merkle Tree 对日志做哈希链——每条日志的哈希包含前一条日志的哈希,篡改任何一条日志都会导致后续所有哈希不匹配。对于合规要求最高的场景,使用 WORM(Write Once Read Many)存储——写一次后不可修改、不可删除。
7.3 合规审计实战
等保 2.0 对日志审计的要求:
- 日志记录至少保留 6 个月
- 必须包含用户标识、操作时间、操作类型、操作结果
- 日志系统本身的操作也需要被审计
- 必须定期(至少每季度)进行日志审计检查
SOC2 对日志审计的要求:
- 所有对生产系统的访问都必须被记录和审计
- 日志必须防篡改,访问日志本身也需要被记录
- 必须建立异常检测机制,对可疑行为告警
- 必须定期审查访问权限和审计日志
八、工具链与最佳实践
8.1 开源技术栈推荐
| 层次 | 推荐工具 | 适用场景 |
|---|---|---|
| 日志采集 | Filebeat / Fluentd / Vector | 轻量 Agent,Vector 是 Rust 实现,性能最佳 |
| 缓冲队列 | Kafka / Redpanda | Kafka 是标准,Redpanda 兼容 Kafka 协议但性能更好 |
| 日志处理 | Logstash / Flink CEP | 简单处理用 Logstash,复杂事件处理用 Flink |
| 存储与检索 | Elasticsearch / OpenSearch / ClickHouse | ES 适合全文检索,ClickHouse 适合分析型查询 |
| 可视化 | Kibana / Grafana | Kibana 是 ELK 标配,Grafana 更灵活 |
| 入侵检测 | Suricata / Wazuh / Falco | NIDS 用 Suricata,HIDS 用 Wazuh,容器用 Falco |
| SIEM | Wazuh / Elastic Security | 开源 SIEM 首选 Wazuh,Elastic Security 集成度更高 |
| SOAR | Shuffle / n8n | 安全编排自动化,Shuffle 专为安全设计 |
8.2 最佳实践清单
- NTP 时间同步是第一优先级:日志时间不一致,关联分析就毫无意义。所有日志源必须同步到同一 NTP 服务器。
- 日志格式标准化:不要每个团队定义自己的日志格式。使用 ECS(Elastic Common Schema)或自定义统一 Schema,确保不同来源的日志可以关联查询。
- 告警必须可执行:每条告警的接收者必须知道"我该做什么"。如果告警只是"发现异常"而没有操作指引,就不应该发出去。
- 日志保留不是越久越好:保留时间 = 合规要求 + 业务需求。超过这个时间的数据是成本负担。
- 定期演练:应急响应流程不演练等于没有。每年至少做一次红蓝对抗。
- 日志系统本身也需要监控:日志采集 Agent 是否存活?Kafka 是否有积压?ES 集群是否健康?日志系统挂了 = 安全盲区。
九、面试问答
以下问题从面试官视角出发,考察你对安全日志与审计的深度理解和实战经验。
Q1:你们的日志系统每天处理多少数据量?如果日志量突然增加 10 倍,系统会怎样?
考察点:日志架构的容量规划和弹性设计。好的回答会提到 Kafka 削峰、ES 写入限流、处理层的背压机制,以及降级策略(比如极端情况下丢弃非安全日志,保证安全日志不丢失)。
Q2:你如何判断一条告警是真实的攻击还是误报?
考察点:告警分析和威胁情报的使用。好的回答会提到:查询威胁情报(IP 信誉、域名注册时间)、关联分析(同一 IP 还触发了什么告警)、上下文分析(这个用户在告警前后做了什么操作)、行为模式(这个操作是否符合这个用户的正常行为模式)。
Q3:如果攻击者拿到了 root 权限并清除了系统日志,你还能找到攻击痕迹吗?
考察点:日志防篡改和多重日志源。好的回答会提到:应用层日志(攻击者可能只清了系统日志但没清应用日志)、集中式日志平台(日志已经发送到远端,本地清除不影响)、网络流量日志(IDS/防火墙的独立日志)、审计日志的 append-only 和 WORM 存储机制。
Q4:你们的应急响应流程中,遏制阶段一般需要多长时间?这段时间内业务会受多大影响?
考察点:应急响应的工程化程度。好的回答会区分自动化遏制(如 SOAR 自动封禁 IP,秒级)和人工遏制(如隔离主机,可能需要 10-30 分钟),以及为不同级别的安全事件定义不同的遏制策略(低风险事件允许更长的分析时间,高风险事件先阻断再分析)。
Q5:如果让你从零搭建一套安全日志审计系统,你会怎么设计?
考察点:系统设计能力和安全视野。好的回答会覆盖:日志源梳理(哪些系统需要接入)、日志标准化(Schema 设计)、采集层(Agent 选型)、缓冲层(Kafka 容量规划)、处理层(解析和富化逻辑)、存储层(冷热分层、保留策略)、监控告警(告警规则设计、降噪策略)、应急响应(和 SOAR 的集成)、合规审计(审计报告的自动生成)。还需要说明为什么这样设计,而不是简单罗列组件。
Q6:ATT&CK 框架在你们的日志审计中是怎么用的?
考察点:对威胁建模的理解深度。好的回答会举具体例子:比如把现有的日志源和告警规则映射到 ATT&CK 矩阵的每个战术中,找出覆盖盲区。比如发现"我们没有任何日志能检测到持久化(Persistence)行为",然后针对性地部署 HIDS 监控计划任务创建和注册表修改。
Q7:你如何看待 AI 在安全日志分析中的应用?
考察点:对技术趋势的判断力。好的回答既不会盲目吹捧 AI,也不会全盘否定。会提到 AI 在日志模式识别、异常检测、告警降噪方面的价值,也会指出 AI 模型的可解释性差、需要大量标注数据、误报率仍然不低等现实问题。最终结论可能是:AI 是辅助工具,不是银弹——安全分析师的经验和判断仍然不可替代。
本文是"Java 技术专家 / 架构师面试:250 个高频考点"系列的第 230 篇。下一篇:231|数据安全与隐私保护:加密算法、密钥管理、脱敏与合规。