阅读时间:约 40-50 分钟 难度:进阶 适用:Java 技术专家 / 架构师面试备考
一、为什么需要理解 Docker 的原理?
面试中,Docker 相关的问题已经从"你用过 Docker 吗"变成了"解释一下 Docker 镜像的分层机制"、"如何优化 Dockerfile 构建速度"、"多阶段构建解决了什么问题"。仅仅会写 docker run 和 docker build 已经不够了——你需要理解背后的设计哲学。
本文从 Docker 最核心的三个概念切入:镜像构建、分层存储和Dockerfile 最佳实践,最后落到多阶段构建这一工程化利器。读完本文,你不仅能回答面试中的 Docker 问题,还能真正理解为什么这些设计是这样的。
二、Docker 架构速览:谁在干活?
在深入细节之前,先建立一个全局视图。Docker 采用经典的 Client-Server 架构,但这背后有三个关键组件在协同工作:
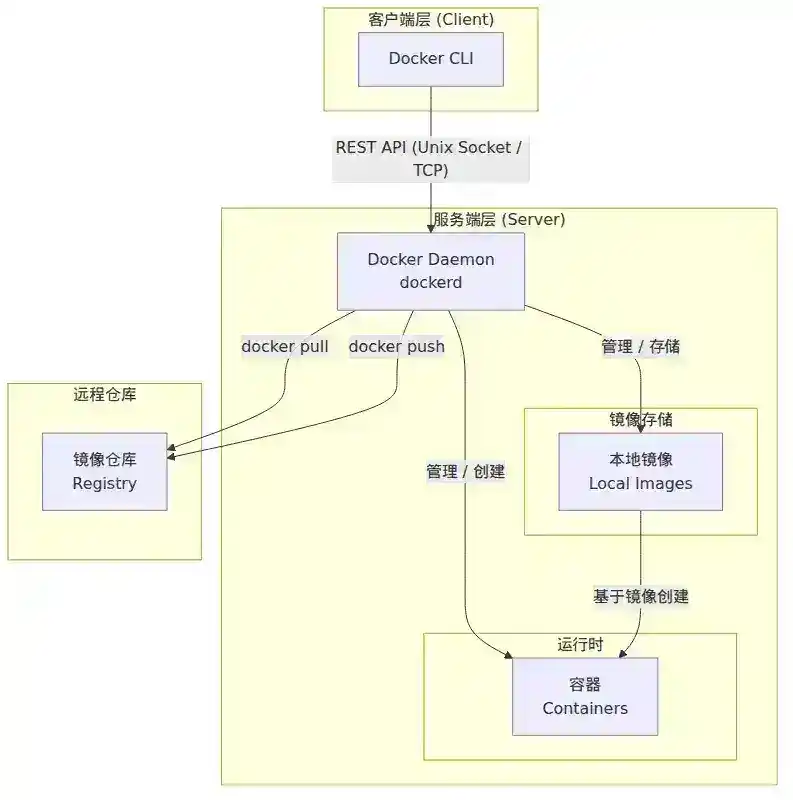
Docker Client:你敲下的 docker build、docker run,本质上是向 Daemon 发送 REST API 请求。Client 和 Daemon 可以在同一台机器上,也可以远程连接。
Docker Daemon:核心后台进程 dockerd。它负责管理镜像、容器、网络和存储卷。一个 Daemon 可以管理多个容器。
Registry:镜像仓库。docker pull 从 Registry 拉取镜像,docker push 推送镜像。Docker Hub 是默认的公共 Registry。
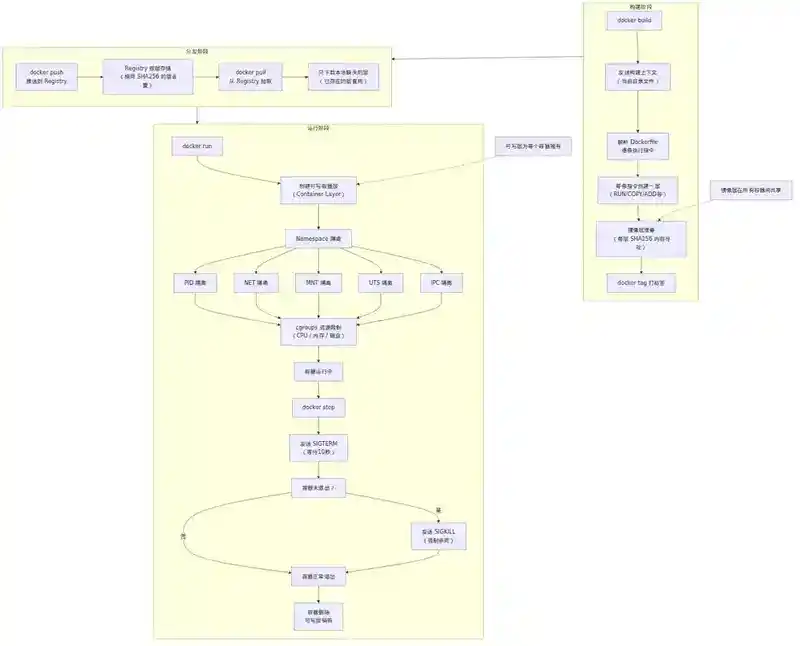
关键点:Docker 不是虚拟机。它没有自己的内核,而是与宿主机共享内核。它通过 Linux 的 namespace 做资源隔离,通过 cgroups 做资源限制,通过 UnionFS 做文件系统分层。理解这一点,是理解后续所有内容的前提。
三、镜像:静态的容器模板
3.1 镜像的本质
镜像是一个只读的、不可变的文件系统快照。它包含了运行一个应用所需的一切:代码、运行时、系统工具、库和配置。
但镜像不是一个大文件。它由多个层堆叠而成。你可以把镜像想象成一摞透明的玻璃板,每块玻璃板上画了一部分内容,从上往下看,就是完整的画面。
3.2 层是什么?
每一层代表镜像构建过程中的一个步骤。当你执行 docker build 时,Dockerfile 中的每一条指令(RUN、COPY、ADD 等)都会生成一个新的层。
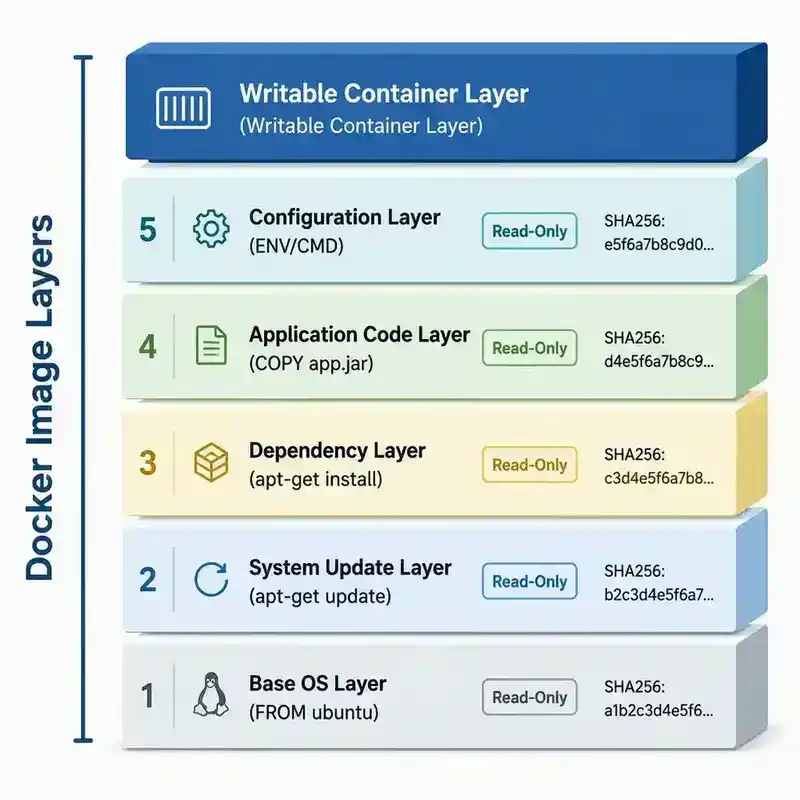
每一层都是前一层的增量变更。层通过内容寻址(基于 SHA256 哈希)进行标识,这意味着:
- 相同的层内容会产生相同的层 ID
- 如果一层没有变化,它的所有上层也不会变化(缓存机制的基础)
- 层是全局共享的——不同镜像可以共享相同的层
3.3 分层存储的底层实现:UnionFS 与 OverlayFS
UnionFS(联合文件系统) 是 Docker 分层存储的核心技术。它允许将多个文件系统目录(称为分支)挂载为一个统一的文件系统。
Docker 最常用的存储驱动是 OverlayFS(Linux 内核 3.18+ 原生支持)。它的工作方式如下:
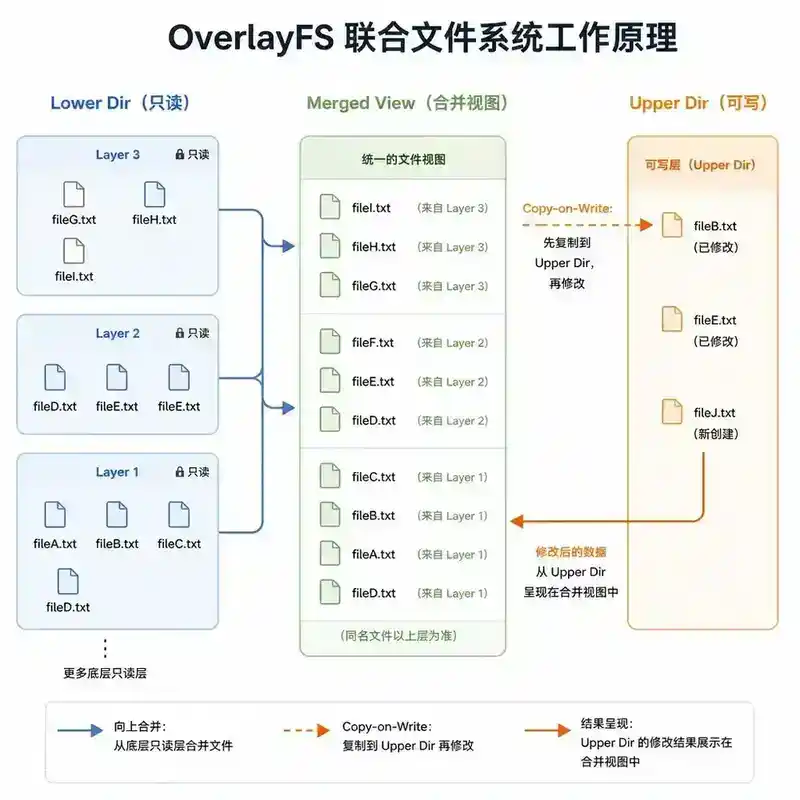
OverlayFS 的读文件流程:
- 先在 Upper Dir(可写层)查找文件
- 如果找不到,逐层向下在 Lower Dir 中查找
- 返回第一个找到的版本
OverlayFS 的写文件流程(Copy-on-Write):
- 如果要修改的文件在 Lower Dir 中,先将其复制到 Upper Dir
- 在 Upper Dir 的副本上进行修改
- 此后对该文件的读写都操作 Upper Dir 中的副本
这意味着什么? 删除镜像中的一个文件,镜像大小不会减小——你只是在 Upper Dir 中创建了一个"白名单"文件标记该文件被删除,而原始文件仍然存在于 Lower Dir 中。这就是为什么 docker images 显示的镜像大小不等于实际磁盘占用。
3.4 写时复制(Copy-on-Write)的深层含义
# 假设基础镜像有一个 500MB 的文件
# 你在容器中只修改了它的 1 个字节

# 实际发生的事情:
# 1. 500MB 文件从 Lower Dir 复制到 Upper Dir
# 2. 修改 1 个字节
# 3. 现在这 500MB 占用了 Upper Dir 的空间

# 如果容器被删除,Upper Dir 也一起被删除
# 但基础镜像的 500MB 文件仍然在 Lower Dir 中,可以被其他容器共享
面试关键点:CoW 策略使得 Docker 启动速度快(无需复制整个镜像),但写入性能差(首次写入需要复制)。这就是为什么数据库等 IO 密集型应用不适合直接放在容器中运行——除非使用 Volume 挂载。
四、容器:镜像的运行实例
4.1 容器 = 镜像 + 可写层
当你运行 docker run 时,Docker 在镜像层堆栈之上添加一个可写容器层(Container Layer)。这个可写层是临时的——容器删除后,可写层中的所有修改都会丢失。
4.2 容器与虚拟机的本质区别
| 维度 | Docker 容器 | 虚拟机 |
|---|---|---|
| 启动速度 | 秒级 | 分钟级 |
| 资源占用 | MB 级 | GB 级 |
| 隔离级别 | 进程级(共享内核) | 硬件级(独立内核) |
| 操作系统 | 共享宿主 OS | 每个 VM 独立 OS |
| 镜像大小 | 通常 100MB-1GB | 通常 10GB+ |
| 启动机制 | fork + namespace + cgroups | hypervisor + bootloader |
面试一句话总结:容器是进程级别的隔离,虚拟机是硬件级别的隔离。容器共享宿主机内核,因此只能运行与宿主机相同操作系统的容器(Linux 上不能直接运行 Windows 容器)。
五、Dockerfile 深度解析:从指令到层的映射
5.1 核心指令与层的关系
每一条 Dockerfile 指令都对应一层(或零层,如 FROM 不创建新层):
| 指令 | 是否创建层 | 说明 |
|---|---|---|
FROM |
否 | 引用已有镜像层,不创建新层 |
RUN |
是 | 每条 RUN 创建一层 |
COPY |
是 | 文件变化时创建新层 |
ADD |
是 | 同 COPY,增加自动解压和 URL 下载 |
CMD |
否 | 元数据,不创建层 |
ENTRYPOINT |
否 | 元数据,不创建层 |
ENV |
是 | 创建一层(持久化环境变量) |
EXPOSE |
否 | 元数据 |
VOLUME |
是 | 创建挂载点 |
WORKDIR |
是 | 创建一层 |
USER |
是 | 创建一层 |
ARG |
否 | 构建参数,不持久化 |
5.2 构建缓存机制
Docker 的构建缓存是逐层判断的。规则很简单:
- 从 Base Image 开始,逐条检查指令
- 如果当前指令与缓存中的指令完全相同(包括指令类型、参数),且父层缓存有效,则使用缓存
- 如果某条指令发生变化,该层及其所有后续层都需要重新构建
这就是为什么 Dockerfile 的指令顺序如此重要——把变化频率最低的放在前面。
# ❌ 不好的写法:每次代码变更,依赖都要重新安装
FROM node:18
COPY . /app           # 代码经常变,这行放了前面
RUN npm install       # 依赖安装被代码变更连累,缓存失效

# ✅ 好的写法:依赖安装层独立,代码变更不影响依赖缓存
FROM node:18
COPY package.json package-lock.json /app/  # 依赖描述文件不常变
RUN npm install                             # 依赖安装被缓存
COPY . /app                                 # 代码经常变,放在最后
5.3 为什么 RUN 指令要合并?
# ❌ 每条 RUN 创建一层,共 3 层,且 apt 缓存留在层中
RUN apt-get update
RUN apt-get install -y curl
RUN apt-get install -y vim

# ✅ 合并为一条 RUN,只创建 1 层,并在同层清理缓存
RUN apt-get update && \
    apt-get install -y curl vim && \
    rm -rf /var/lib/apt/lists/*
为什么要合并? 每一层都是只读的、不可变的。即使你在第 3 层删除了某个文件,第 1 层中的文件仍然存在,镜像大小不会减小。合并操作确保中间操作(如 apt-get update 产生的索引文件)不会残留。
六、Dockerfile 最佳实践
6.1 最小化镜像体积
原则:镜像只包含运行时必需的依赖,不包含构建工具、调试工具和不必要的文件。
# ❌ 生产环境镜像包含编译工具
FROM openjdk:11
RUN apt-get update && apt-get install -y maven git curl
COPY . /app
RUN mvn clean package -f /app/pom.xml
CMD ["java", "-jar", "/app/target/app.jar"]

# 问题:镜像包含 maven、git、curl 和完整的源代码
# 镜像体积可能超过 500MB
策略:
- 使用
.dockerignore排除不需要的文件(node_modules、.git、target 等) - 选择精简的基础镜像(alpine、slim 变体)
- 清理包管理器的缓存
- 使用多阶段构建(见下文)
6.2 选择合适的基础镜像
# 基础镜像大小对比
FROM openjdk:11              # ~628MB — 完整 JDK
FROM openjdk:11-jre          # ~285MB — 只有 JRE
FROM openjdk:11-jre-slim     # ~205MB — 精简版 JRE
FROM openjdk:11-jre-alpine   # ~110MB — Alpine Linux 上的 JRE
常见的精简基础镜像:
| 基础镜像 | 大小 | 适用场景 |
|---|---|---|
alpine:3.19 |
~5MB | 通用场景,需要自行安装依赖 |
debian:bookworm-slim |
~74MB | 需要 glibc 兼容性时 |
distroless |
~2MB | Google 提供的无 shell 镜像 |
scratch |
0MB | 空镜像,用于静态编译的二进制文件 |
⚠️ Alpine 的坑:Alpine 使用 musl libc 而非 glibc,某些 Java 应用(特别是依赖 JNI 的)可能遇到兼容性问题。不要盲目追求小镜像。
6.3 非 root 用户运行
# ❌ 默认以 root 运行
FROM node:18-alpine
COPY . /app
CMD ["node", "/app/server.js"]

# ✅ 创建专用用户
FROM node:18-alpine
RUN addgroup -g 1001 -S appgroup && \
    adduser -u 1001 -S appuser -G appgroup
COPY --chown=appuser:appgroup . /app
USER appuser
CMD ["node", "/app/server.js"]
为什么重要? 如果容器以 root 运行,一旦应用被攻破,攻击者可能通过容器逃逸漏洞获取宿主机 root 权限。USER 指令配合 Kubernetes 的 securityContext 是纵深防御的重要一环。
6.4 健康检查
FROM openjdk:11-jre-slim
COPY app.jar /app/app.jar
HEALTHCHECK --interval=30s --timeout=3s --retries=3 \
  CMD curl -f http://localhost:8080/actuator/health || exit 1
CMD ["java", "-jar", "/app/app.jar"]
HEALTHCHECK 让 Docker 和编排工具(Kubernetes、Docker Swarm)知道容器是否真正健康——进程存活不代表应用可用。
6.5 信号处理与优雅退出
# ❌ shell 形式:CMD 在 /bin/sh -c 中运行,PID 1 是 shell
# docker stop 发送的 SIGTERM 被 shell 吞掉,应用收不到
CMD java -jar /app/app.jar

# ✅ exec 形式:应用直接作为 PID 1,能收到 SIGTERM
CMD ["java", "-jar", "/app/app.jar"]
Docker 发送 docker stop 时:
- 向容器 PID 1 发送 SIGTERM
- 等待 10 秒(默认)
- 如果容器仍未退出,发送 SIGKILL 强制杀死
很多应用(尤其是 Java)需要在代码中处理 SIGTERM 来优雅关闭:
Runtime.getRuntime().addShutdownHook(new Thread(() -> {
    log.info("Received shutdown signal, draining connections...");
    // 关闭连接池、刷新缓冲区、完成未提交的事务
}));
6.6 环境变量与配置
# 构建时参数(ARG,不进入最终镜像)
ARG JAR_FILE=target/*.jar

# 运行时环境变量(ENV,进入镜像层)
ENV JAVA_OPTS="-Xms512m -Xmx1024m"
ENV SPRING_PROFILES_ACTIVE="production"

# 使用 ARG 和 ENV 配合
ARG VERSION=unknown
ENV APP_VERSION=$VERSION

COPY ${JAR_FILE} /app/app.jar
ENTRYPOINT ["sh", "-c", "java ${JAVA_OPTS} -jar /app/app.jar"]
ARG vs ENV:
ARG:仅在构建时可用,不会进入最终镜像层ENV:构建时和运行时都可用,会进入镜像层,且会被容器启动时的-e参数覆盖
七、多阶段构建:Dockerfile 的工程化利器
7.1 问题:传统构建的困境
# 传统构建:镜像包含所有构建工具和中间产物
FROM maven:3.8-openjdk-11
COPY . /app
RUN mvn clean package -DskipTests
CMD ["java", "-jar", "/app/target/app.jar"]

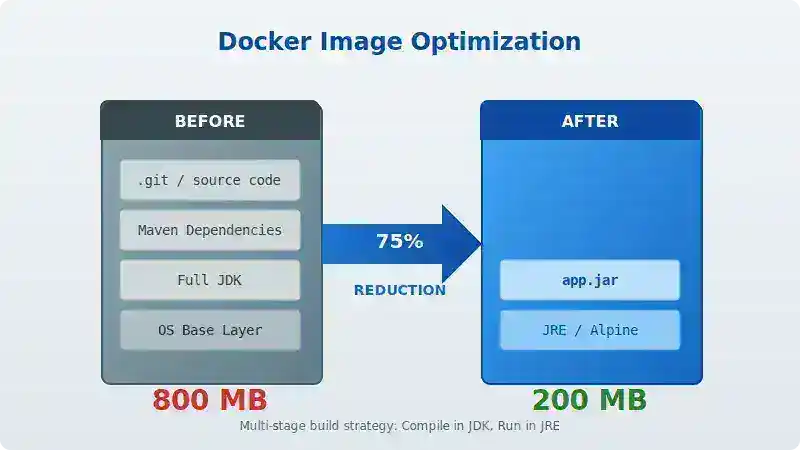
# 镜像大小:maven 镜像 ~500MB + 源代码 + 构建产物 = 可能 800MB+
# 生产环境实际只需要 JRE + jar 包,约 200MB
传统方案要么接受臃肿的镜像,要么使用复杂的构建脚本(先构建出 jar,再写第二个 Dockerfile 打包)。多阶段构建优雅地解决了这个问题。
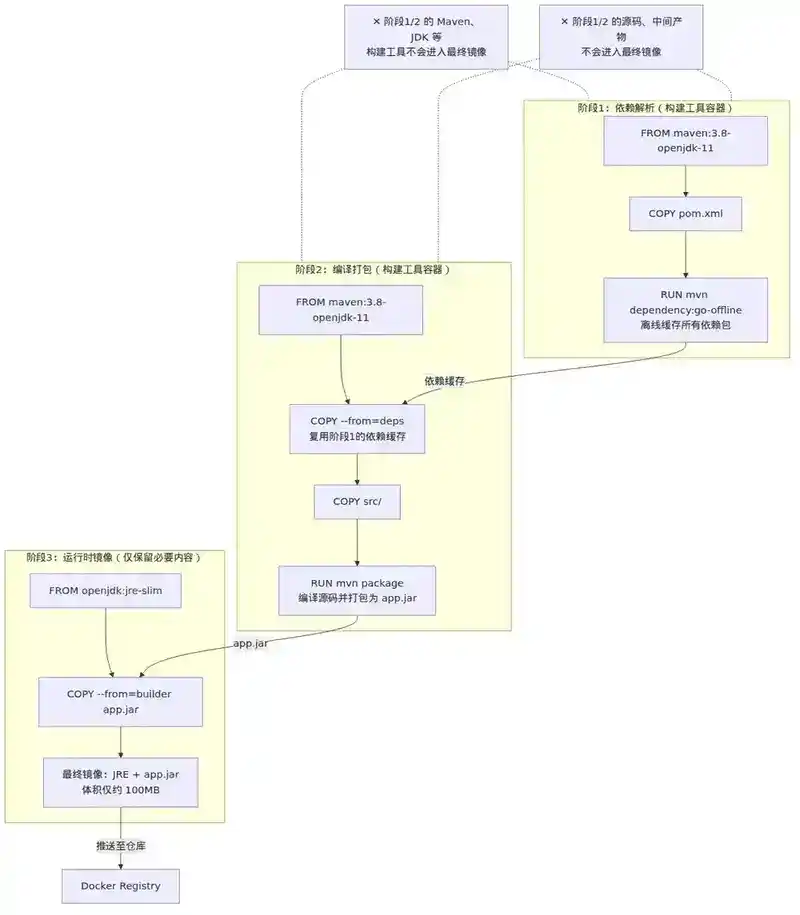
7.2 多阶段构建的基本用法
# ============ 第一阶段:构建阶段 ============
FROM maven:3.8-openjdk-11 AS builder
WORKDIR /app
COPY pom.xml .
# 先下载依赖(利用缓存)
RUN mvn dependency:go-offline -B
COPY src/ src/
RUN mvn clean package -DskipTests -B

# ============ 第二阶段:运行阶段 ============
FROM openjdk:11-jre-slim
WORKDIR /app
# 从构建阶段只复制最终产物
COPY --from=builder /app/target/*.jar app.jar
# 创建非 root 用户
RUN groupadd -r appuser && useradd -r -g appuser appuser
USER appuser
EXPOSE 8080
HEALTHCHECK --interval=30s --timeout=3s --retries=3 \
  CMD curl -f http://localhost:8080/actuator/health || exit 1
CMD ["java", "-jar", "app.jar"]
关键点:
FROM ... AS builder给构建阶段命名COPY --from=builder从构建阶段复制文件- 最终镜像只包含第二阶段的内容,构建工具和中间产物全部丢弃
- 可以在一个 Dockerfile 中使用多个
AS阶段
7.3 多阶段构建的高级模式
模式一:并行构建多个产物
# 构建前端
FROM node:18-alpine AS frontend-builder
WORKDIR /frontend
COPY frontend/ ./
RUN npm ci && npm run build

# 构建后端
FROM maven:3.8-openjdk-11 AS backend-builder
WORKDIR /backend
COPY backend/ ./
RUN mvn clean package -DskipTests

# 最终镜像:合并前后端产物
FROM openjdk:11-jre-slim
COPY --from=frontend-builder /frontend/dist /app/static
COPY --from=backend-builder /backend/target/app.jar /app/app.jar
CMD ["java", "-jar", "/app/app.jar"]
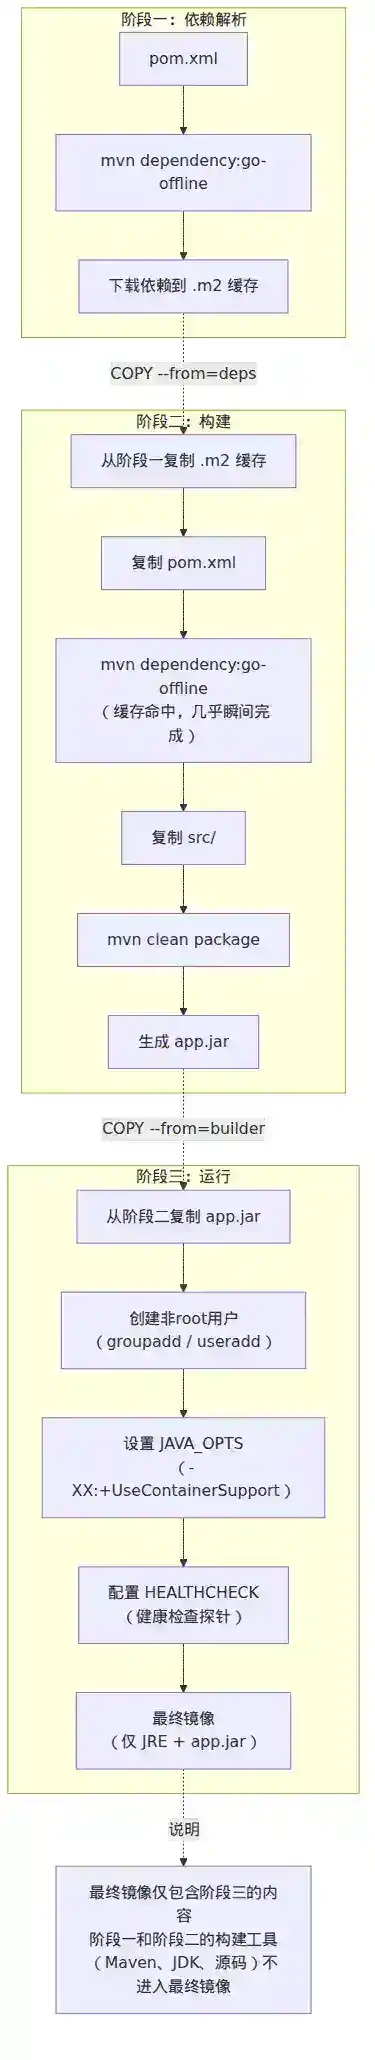
模式二:依赖分离优化缓存
# 阶段 1:解析依赖
FROM maven:3.8-openjdk-11 AS dependency-resolver
WORKDIR /app
COPY pom.xml .
RUN mvn dependency:resolve -B

# 阶段 2:构建(利用阶段 1 的缓存)
FROM maven:3.8-openjdk-11 AS builder
WORKDIR /app
# 从阶段 1 复制已解析的依赖
COPY --from=dependency-resolver /root/.m2 /root/.m2
COPY pom.xml .
# 现在 dependency:go-offline 几乎是瞬间完成
RUN mvn dependency:go-offline -B
COPY src/ src/
RUN mvn clean package -DskipTests -B

# 阶段 3:运行
FROM openjdk:11-jre-slim
COPY --from=builder /app/target/app.jar /app/app.jar
CMD ["java", "-jar", "/app/app.jar"]
模式三:静态编译 Go/Rust 应用
# 构建阶段
FROM golang:1.22-alpine AS builder
WORKDIR /app
COPY go.mod go.sum ./
RUN go mod download
COPY . .
RUN CGO_ENABLED=0 GOOS=linux go build -o server .

# 运行阶段:使用 scratch 空镜像
FROM scratch
COPY --from=builder /app/server /server
COPY --from=builder /etc/ssl/certs/ca-certificates.crt /etc/ssl/certs/
EXPOSE 8080
ENTRYPOINT ["/server"]
最终镜像只有编译后的二进制文件,大小可以做到 10MB 以内。
7.4 多阶段构建的底层原理
多阶段构建并非 Docker 引擎的高级特性——它只是构建器在构建过程中维护了多个中间镜像,并在 COPY --from= 时从对应中间镜像的文件系统中提取文件。最终 docker push 时,只推送最后一个阶段的镜像和它引用的层。
面试常问:多阶段构建的中间镜像会被推送吗?**不会。**只有最后一个 FROM 定义的镜像被标记和推送。中间阶段只存在于构建缓存中。
八、镜像构建优化实战
8.1 构建上下文优化
# 构建上下文 = docker build 命令执行时发送给 Docker Daemon 的文件集合
docker build -t myapp .

# 这个 "." 会把当前目录下的所有文件发送给 Daemon
# 如果目录下有 node_modules、target、.git 等大文件夹,构建会非常慢
.dockerignore 文件:
# 构建排除
node_modules
target

* .log

.git
.gitignore
.idea

* .iml

.vscode
Dockerfile
docker-compose.yml
README.md
8.2 BuildKit 与现代构建
Docker 18.09+ 引入的 BuildKit 是新一代构建引擎,带来显著改进:
# 启用 BuildKit
DOCKER_BUILDKIT=1 docker build -t myapp .
BuildKit 的核心能力:
- 并行构建不相关的阶段:多阶段构建中,相互独立的阶段可以并行执行
- 更精确的缓存失效:只重新构建真正变化的层
- 构建密钥挂载:安全地使用 SSH 密钥或 secrets 而不让它们进入镜像层
# syntax=docker/dockerfile:1
# BuildKit 的 secret 挂载:安全使用私钥,不进入镜像层
FROM node:18-alpine
RUN --mount=type=secret,id=npmrc,target=/root/.npmrc \
    npm install --production
- 缓存挂载:在构建之间保留包管理器缓存
# BuildKit 缓存挂载:apt 缓存跨构建保留
FROM ubuntu:22.04
RUN --mount=type=cache,target=/var/cache/apt \
    apt-get update && apt-get install -y curl
8.3 镜像层数 vs 层大小
一个常见的误区:以为层数越少越好,于是把所有操作合并到一个 RUN 中。实际上:
- 层数:影响的是
docker push/pull的并行度和元数据开销 - 层大小:影响的是存储占用和传输时间
Docker 的 OverlayFS 最多支持 128 层 Lower Dir。在 128 层以内,层数的影响远小于层大小。优化策略:
- 合并会产生大量临时文件的连续操作(如
apt-get update && install && clean) - 不合并长期稳定的操作(如
COPY package.json和RUN npm install分开,利用缓存) - 在可读性和效率之间取平衡——不要为了减少一层而写出难以理解的指令
九、实战:一个生产级的 Java 应用 Dockerfile
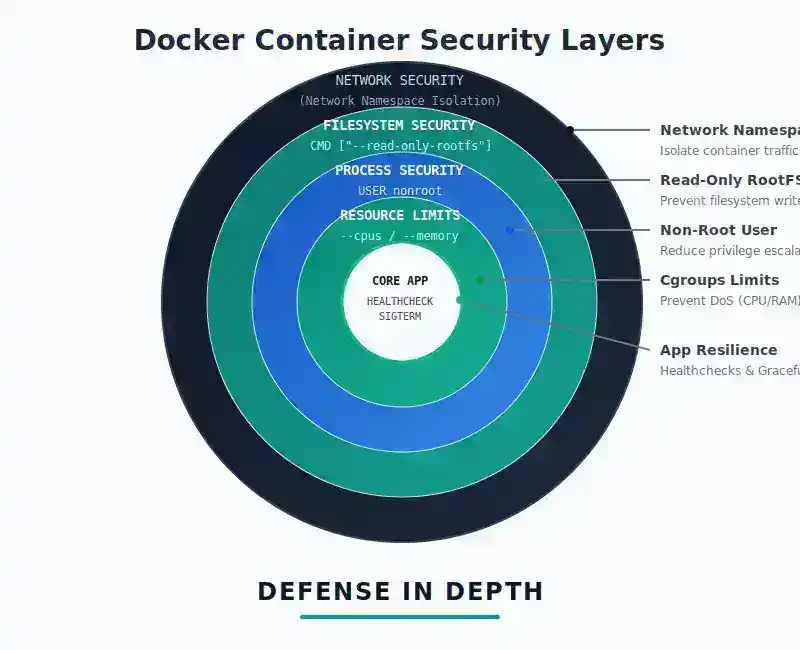
综合以上所有最佳实践,这是一个生产级 Java 应用的 Dockerfile 模板:
# syntax=docker/dockerfile:1
# 使用 BuildKit 语法

# ========== 阶段 1:依赖解析 ==========
FROM maven:3.8.6-openjdk-11-slim AS deps
WORKDIR /build
COPY pom.xml .
# 下载所有依赖(不含插件)
RUN mvn dependency:go-offline -B -q

# ========== 阶段 2:构建 ==========
FROM maven:3.8.6-openjdk-11-slim AS builder
WORKDIR /build
COPY --from=deps /root/.m2 /root/.m2
COPY pom.xml .
# 缓存命中后这一步几乎瞬间完成
RUN mvn dependency:go-offline -B -q
COPY src/ src/
RUN mvn clean package -DskipTests -B -q

# ========== 阶段 3:运行 ==========
FROM openjdk:11.0.16-jre-slim-bullseye AS runtime

# 创建非 root 用户
RUN groupadd --system --gid 1001 appgroup && \
    useradd --system --uid 1001 --gid appgroup appuser

WORKDIR /app

# 先复制依赖少的文件,最大化缓存利用率
COPY --from=builder /build/target/app.jar /app/app.jar

# 设置运行时环境变量
ENV JAVA_OPTS="-XX:+UseContainerSupport -XX:MaxRAMPercentage=75.0" \
    SPRING_PROFILES_ACTIVE="production"

# 健康检查
HEALTHCHECK --interval=30s --timeout=5s --start-period=60s --retries=3 \
    CMD curl -sf http://localhost:8080/actuator/health || exit 1

# 切换到非 root 用户
USER appuser

EXPOSE 8080

# exec 形式,确保信号传递
ENTRYPOINT ["sh", "-c", "java ${JAVA_OPTS} -jar /app/app.jar"]
关键设计决策:
| 决策 | 理由 |
|---|---|
-XX:+UseContainerSupport |
让 JVM 感知容器内存限制,避免 OOM |
-XX:MaxRAMPercentage=75.0 |
而非固定 -Xmx,适应不同容器规格 |
HEALTHCHECK --start-period=60s |
给 Java 应用足够的启动时间 |
| 三阶段构建 | 依赖解析、构建、运行完全分离 |
| 非 root 用户 | 安全基线要求 |
exec 形式的 ENTRYPOINT |
确保 Java 进程是 PID 1,能收到信号 |
十、面试高频问题:从原理到实战
10.1 Docker 镜像的分层存储是如何工作的?为什么修改一行代码不需要重新传输整个镜像?
参考答案:Docker 镜像由多个只读层堆叠而成,每层通过 SHA256 内容寻址。当修改一行代码时,只有从该代码对应的 COPY 层开始往上的层会失效重建。由于层是内容寻址的,未变化的层保持相同的 SHA256,Docker Daemon 和 Registry 通过比较 SHA256 来判断是否需要传输。因此,docker pull 或 docker push 只需传输变化的那几层,而不是整个镜像。
10.2 多阶段构建解决了什么问题?最终镜像中会包含构建阶段的层吗?
参考答案:多阶段构建解决了"构建环境"和"运行环境"分离的问题。传统方式要么接受臃肿的镜像(包含编译器、构建工具等),要么需要外部脚本维护多个 Dockerfile。多阶段构建将构建过程放在独立的中间阶段,最终只将运行时需要的产物复制到最终镜像。构建阶段的层不会进入最终镜像——docker push 只推送最后一个 FROM 定义的镜像。
10.3 为什么在 Dockerfile 中把 COPY package.json 和 RUN npm install 放在 COPY . . 前面?
参考答案:利用 Docker 的层缓存机制。Docker 逐层检查缓存,如果某层指令和上下文都没有变化,就使用缓存。package.json 变化频率远低于源代码,把它和 npm install 放在前面,意味着只有依赖真正变化时才重新安装,日常的代码改动不会触发依赖重装,显著加快构建速度。
10.4 如何减小 Docker 镜像的体积?列举至少四种方法。
参考答案:
- 选择精简基础镜像:如
alpine、slim变体,或distroless - 多阶段构建:构建工具不进入最终镜像
- 合并 RUN 指令:在同一条指令中安装和清理,避免中间文件残留
- 使用 .dockerignore:排除
node_modules、.git、构建产物等大文件 - 清理包管理器缓存:如
rm -rf /var/lib/apt/lists/* - 避免安装不必要的工具:生产镜像不需要 vim、curl、git 等调试工具
10.5 容器和虚拟机的核心区别是什么?什么场景下容器不适合?
参考答案:容器是进程级隔离,共享宿主机内核;虚拟机是硬件级隔离,每个 VM 有独立内核。容器启动快(秒级)、资源占用小(MB 级),但隔离性弱于虚拟机。
容器不适合的场景:
- 需要不同内核(如 Linux 宿主机上运行 Windows 容器)
- 需要强隔离的安全场景(多租户环境)
- 需要直接操作内核模块的应用
- 需要持久化存储的 IO 密集型应用(应使用 Volume 或外部存储)
10.6 Docker 的 Copy-on-Write 机制如何影响容器性能?
参考答案:CoW 使得容器启动极快(无需复制镜像),但首次写入操作需要从 Lower Dir 复制文件到 Upper Dir,产生额外 IO 开销。对于写密集型应用(如数据库),频繁的 CoW 操作会显著降低性能。解决方案是使用 Volume 或 bind mount 将频繁写入的目录挂载到宿主机文件系统,绕过 CoW 机制。
10.7 解释 CMD 和 ENTRYPOINT 的区别,以及 shell 形式和 exec 形式的差异。
参考答案:
CMD:提供默认命令,可被docker run后的参数覆盖ENTRYPOINT:定义容器的主命令,docker run后的参数作为追加参数- 两者通常配合使用:
ENTRYPOINT定义主程序,CMD提供默认参数
Shell 形式(CMD java -jar app.jar)在 /bin/sh -c 中运行,PID 1 是 shell,信号无法传递给应用。Exec 形式(CMD ["java", "-jar", "app.jar"])直接运行应用作为 PID 1,能正确接收 SIGTERM 信号,实现优雅关闭。
十一、总结
Docker 的核心理念是不可变基础设施——镜像一旦构建,在任何环境下都以相同的方式运行。这种理念通过以下机制实现:
- 分层存储:通过 UnionFS/OverlayFS 实现镜像分层和容器可写层,共享基础层减少存储和传输开销
- 内容寻址:每层通过 SHA256 哈希标识,确保一致性和缓存命中
- 写时复制:容器启动不复制镜像,首次写入时才复制,兼顾启动速度和存储效率
- 多阶段构建:将构建和运行环境分离,实现镜像最小化
掌握这些原理,你不仅能写出高效的 Dockerfile,还能在面试中深入讨论 Docker 的底层机制,展现出超越"会用"的工程深度。
附:面试官视角提问
以下问题从面试官视角设计,考察你对 Docker 原理的深入理解和工程经验。建议在阅读正文后尝试回答,再对照参考要点。
Q1:你在生产环境中遇到过 Docker 构建特别慢的情况,排查后发现是依赖下载每次都重新执行。你会如何优化 Dockerfile 来解决这个问题?请说明背后的原理。
Q2:如果让你设计一个 CI/CD 平台的镜像构建模块,你会如何利用 Docker 的分层缓存机制来加速构建?需要考虑多个项目共享缓存的情况。
Q3:假设你的 Java 应用在容器中运行,堆内存设置为 -Xmx3g,但容器内存限制为 4G。为什么容器仍然可能被 OOM Kill?你会如何排查和解决?
Q4:你的团队在 Docker 镜像中发现了一个安全漏洞,需要尽快修复。你如何在不重新构建所有镜像的情况下,快速定位受影响的镜像和容器?
Q5:你有一个 2GB 的 Docker 镜像,每次 CI 构建后推送到 Registry 需要 5 分钟。分析可能的瓶颈,并给出优化方案。
Q6:多阶段构建中,如果你需要在最终镜像中保留构建阶段的某些工具(如调试工具),你会怎么做?这样做有什么风险?
Q7:Docker 的 OverlayFS 最多支持 128 层,如果你的 Dockerfile 有 200 条 RUN 指令,会发生什么?你应该如何避免?
Q8:一个容器化的 Java 应用在收到 docker stop 后,等了 10 秒后被 SIGKILL 强制杀死,导致正在处理的请求丢失。你应该如何修改 Dockerfile 和应用代码来解决这个问题?
本文为"Java 技术专家 / 架构师面试:250 个高频考点"系列第 232 篇。
参考要点
Q1 参考要点:
核心原理是 Docker 的层缓存机制。Docker 逐层构建,当前层指令和上下文不变时使用缓存。优化策略:
- 分离依赖文件与源代码:先将
pom.xml/package.json等依赖描述文件 COPY 进去并执行依赖下载,再 COPY 源代码。这样日常代码改动不会触发依赖重装。 - 利用 BuildKit 缓存挂载:
RUN --mount=type=cache,target=/root/.m2 mvn package将 Maven 本地仓库跨构建保留,即使层重建,依赖也无需重新下载。 - 依赖预解析阶段:单独一个阶段执行
mvn dependency:go-offline,后续阶段COPY --from=复用已下载的依赖。
Q2 参考要点:
CI/CD 平台加速镜像构建的核心设计:
- 分层缓存共享:在构建节点上持久化 Docker 层缓存(
/var/lib/docker),多个项目的构建可共享公共基础层(如openjdk:11-jre-slim)。 - Registry 缓存代理:部署本地 Registry 作为缓存代理(如 Harbor 的代理缓存),减少从 Docker Hub 拉取公共镜像的延迟。
- 构建上下文最小化:CI 流程中严格控制构建上下文,通过
.dockerignore和--file指定 Dockerfile 路径,避免将整个仓库发送给 Daemon。 - BuildKit 远程缓存:使用
--cache-from和--cache-to将构建缓存推送到 Registry,不同构建节点可以拉取缓存。例如docker build --cache-from=registry.example.com/myapp:cache --cache-to=registry.example.com/myapp:cache。 - 多项目共享基础镜像:抽取出团队通用的基础镜像(包含 JDK、常用依赖),所有项目 FROM 这个基础镜像,统一维护和更新。
Q3 参考要点:
Java 容器 OOM 的核心原因:JVM 的内存占用不仅仅是堆内存(-Xmx),还包括:
- 堆外内存:DirectByteBuffer、NIO 使用的堆外内存
- Metaspace:类元数据存储(默认无上限,容器中必须设置
-XX:MaxMetaspaceSize) - 线程栈:每个线程默认 1MB,
-Xss设置,线程数 × 栈大小 - JIT 编译:CodeCache 占用
- GC 开销:GC 过程中的临时内存
- Native 内存:JNI 调用、NIO 等
总内存 ≈ 堆内存 + Metaspace + 线程数 × 栈大小 + 堆外内存 + JIT/GC 开销。当这个总和超过容器 4G 限制时,内核 OOM Killer 会杀死进程。
排查与解决:
- 使用
-XX:+UseContainerSupport -XX:MaxRAMPercentage=75.0让 JVM 感知容器限制 - 设置
-XX:MaxMetaspaceSize=256m限制元空间 - 控制线程池大小,避免创建过多线程
- 使用
docker stats和jcmd <pid> VM.native_memory summary分析实际内存占用 - 为容器预留 20-30% 内存给非堆使用
Q4 参考要点:
快速定位受漏洞影响的镜像和容器:
- 镜像扫描工具:使用 Trivy、Clair、Docker Scout 等工具扫描所有镜像,生成漏洞报告。
trivy image --severity CRITICAL myapp:latest - 镜像元数据查询:
docker images查看镜像的创建时间和标签,结合 CI/CD 构建记录定位是哪个版本的 Dockerfile 引入的漏洞。 - 镜像层分析:使用
docker history <image>查看每层信息,dive <image>交互式分析每层引入了哪些文件,定位是哪条指令引入了漏洞组件。 - 运行容器排查:
docker ps列出所有运行容器,docker inspect <container>查看容器使用的镜像 SHA256。 - 修复策略:更新基础镜像(
FROM openjdk:11-jre-slim改为最新版),或在依赖层修复后重建。由于分层缓存,只需重建受影响的层及上层,未变化的层自动复用。
Q5 参考要点:
2GB 镜像推送慢的瓶颈分析:
- 瓶颈判断:先确认是网络带宽瓶颈还是镜像层数过多。
docker push可以看到每层的推送速度。 - 镜像体积优化:
- 使用多阶段构建,去除构建工具和中间产物(可减少 60-80% 体积)
- 选择 alpine/slim 基础镜像
- 清理包管理器缓存
- 合并 RUN 指令,减少残留文件
- 层数优化:如果层数过多(>50),合并相关 RUN 指令减少层数,降低推拉时的元数据开销。
- Registry 优化:部署同机房/同区域的 Registry,减少网络延迟。使用 Harbor 等支持分层并发推送的 Registry。
- 增量推送:分层存储天然支持增量——只推送变化的层。如果优化后镜像体积仍大,确保 CI 构建时利用缓存,只产生最少的变化层。
Q6 参考要点:
在多阶段构建中保留调试工具有几种方式:
- 从构建阶段复制:
COPY --from=builder /usr/bin/curl /usr/bin/curl。风险:共享库依赖可能不完整,需要同时复制依赖的.so文件。 - 创建调试镜像变体:基于最终镜像再写一个
FROM阶段安装调试工具,仅用于调试场景,不用于生产部署。 - 使用 --target 构建到特定阶段:
docker build --target builder -t myapp:debug .构建并保留构建阶段镜像用于调试。
风险:调试工具增加了攻击面(curl 可被用于数据外传、shell 可用于命令执行),违反最小化原则。更推荐的做法是使用 Kubernetes 的 kubectl debug 或 docker exec 配合临时容器进行调试,而非在生产镜像中保留工具。
Q7 参考要点:
OverlayFS 的 128 层限制是 Linux 内核的硬限制(/proc/sys/fs/overlay/max-lower-layers),但 Docker 实际可用的层数更少(因为内核还占用一些)。
200 条 RUN 指令会导致:镜像构建可能失败(超过层数限制),或即使构建成功,挂载性能也会显著下降(每层都需要在 OverlayFS 中管理)。
避免方法:
- 合并 RUN 指令:将多个连续的 RUN 合并。例如
RUN apt-get update && apt-get install -y pkg1 pkg2 pkg3 && rm -rf /var/lib/apt/lists/* - 使用多阶段构建:每个阶段独立计算层数,最终镜像只包含最后一个阶段的层。
- 使用 COPY 替代多个 RUN:将需要运行的脚本 COPY 进去一次性执行,而非每个操作都写一条 RUN。
- 使用 .dockerignore 和构建上下文优化:减少不必要的文件变化导致的层重建。
面试加分点:实际工程中 Dockerfile 通常不会超过 20-30 条指令,如果真的需要 200 条 RUN,说明设计有问题——要么是构建逻辑过于复杂应该拆分为多个镜像,要么是 RUN 指令没有合理合并。
Q8 参考要点:
问题根因:Shell 形式的 CMD 或 ENTRYPOINT 在 /bin/sh -c 中运行,PID 1 是 shell 而非 Java 进程。docker stop 发送 SIGTERM 给 PID 1(shell),但 shell 不会将信号转发给子进程(Java 应用)。
Dockerfile 修改:
- 使用 exec 形式:
CMD ["java", "-jar", "/app/app.jar"],确保 Java 进程直接作为 PID 1 - 如果必须使用 shell 形式,用
exec替换 shell 进程:CMD exec java -jar /app/app.jar
应用代码修改:
Runtime.getRuntime().addShutdownHook(new Thread(() -> {
    log.info("SIGTERM received, starting graceful shutdown...");
    // 1. 停止接收新请求(标记健康检查为不健康)
    // 2. 等待现有请求处理完成(设置超时)
    // 3. 关闭连接池
    // 4. 刷新日志缓冲区
    // 5. 完成未提交的事务
}));
配合 Spring Boot:设置 spring.lifecycle.timeout-per-shutdown-phase=30s 和 server.shutdown=graceful,配合 docker stop -t 60 延长超时时间。
面试加分点:提到 Kubernetes 的 terminationGracePeriodSeconds 和 preStop hook,形成完整的优雅关闭链路:preStop hook → 摘流量 → SIGTERM → 应用优雅关闭 → 超时后 SIGKILL。