阅读时间:约 45 分钟 难度:中级 → 架构师 前置知识:数组与链表基础、HashMap 基本使用、分布式系统基本概念
一、从一道面试题切入
"10 亿个 URL,如何快速判断一个 URL 是否在其中?"
这个问题把哈希的所有关键矛盾都暴露了出来:空间不够怎么办(冲突)?数据分布不均怎么办(倾斜)?集群扩容时怎么迁移最少数据(一致性哈希)?
这篇文章从哈希函数的基础数学讲起,一路深入到分布式系统中一致性哈希的虚拟节点优化,最后落到 Redis Cluster、CDN、数据库分片这些工程场景。
二、哈希函数:把任意输入压缩成固定长度的"指纹"
2.1 定义
哈希函数是一个映射:
H: X → [0, M-1]
输入 X 可以是任意长度的字节序列,输出是一个固定范围内的整数。这个整数就是哈希值,也叫散列值、摘要、指纹。
2.2 一个好哈希函数的三个性质
确定性:同一个输入,永远输出同一个哈希值。这是最基本的要求——否则"查找"就无从谈起。
均匀性:哈希值在输出空间内均匀分布。理想情况下,每个桶被选中的概率相等。这个性质决定了哈希表的性能和一致性哈希的数据均衡度。
雪崩效应(Avalanche Effect):输入的一个 bit 变化,应该导致输出中大约一半的 bit 翻转。这保证了相似的输入不会产生相近的哈希值——避免聚集。
// 一个不好的哈希函数(仅作反例)
int badHash(String s) {
    return s.length();  // "abc" 和 "xyz" 哈希值相同,严重冲突
}

// JDK 中 String 的 hashCode —— 相对较好但仍可预测
// s[0]*31^(n-1) + s[1]*31^(n-2) + ... + s[n-1]
2.3 哈希碰撞的数学必然性
鸽巢原理(Pigeonhole Principle):如果要把 N+1 个物品放进 N 个抽屉,至少有一个抽屉有 ≥2 个物品。在哈希场景中:
- 输入空间无限大(任意长度)
- 输出空间有限(0 到 M-1)
- 必然存在不同的输入映射到同一个输出
所以冲突不是 bug,是哈希结构与生俱来的特性。关键不是"避免冲突",而是"如何处理冲突"。
生日悖论:在一个 365 天的"哈希空间"中,只需要 23 个人就有 50% 概率出现生日碰撞。推广到 M 个桶的哈希表:当插入约 √M 个元素时,碰撞概率接近 50%。这就是为什么 HashMap 的负载因子设为 0.75——在冲突变得不可接受之前就扩容。
三、冲突解决:链地址法 vs 开放寻址法
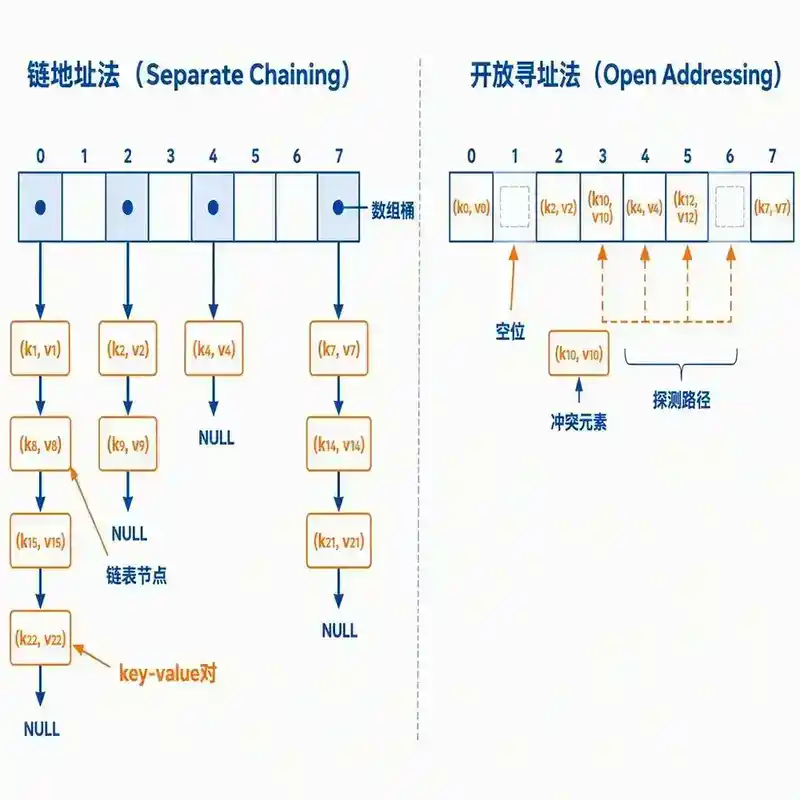
3.1 链地址法(Separate Chaining)
每个桶维护一个链表(或红黑树),冲突的元素追加到链表尾部。
桶下标 0: [k1,v1] → [k3,v3] → null
桶下标 1: [k2,v2] → null
桶下标 2: null
...
优点:
- 实现简单,删除容易
- 负载因子可以超过 1(链表可以无限长)
- 对哈希函数质量不那么敏感
缺点:
- 额外内存开销(链表节点对象头 + 指针)
- 缓存不友好——节点散布在堆内存各处,无法利用 CPU 缓存行
3.2 开放寻址法(Open Addressing)
所有元素都存储在数组本身。冲突时,按照探测序列(probe sequence) 寻找下一个空位。
三种探测策略:
| 策略 | 公式 | 特点 |
|---|---|---|
| 线性探测 | h(k, i) = (h'(k) + i) % M | 简单但易产生一次聚集(primary clustering) |
| 平方探测 | h(k, i) = (h'(k) + c₁i + c₂i²) % M | 缓解一次聚集,但产生二次聚集(secondary clustering) |
| 双重哈希 | h(k, i) = (h₁(k) + i × h₂(k)) % M | 性能最好,几乎消除聚集 |
一次聚集:多个 key 的初始位置相同,它们的探测路径完全重合,冲突越来越密集。像一个越来越拥挤的队伍。
ThreadLocal 的 ThreadLocalMap 就是用的开放寻址法(线性探测),因为它不需要额外的 Entry 节点对象,并且 ThreadLocal 的 key 数量通常很少。
3.3 两种策略的选型边界
| 维度 | 链地址法 | 开放寻址法 |
|---|---|---|
| 负载因子上限 | > 1 | < 1(必须) |
| 删除操作 | O(1) | 需要惰性删除标记 |
| 缓存友好度 | 差(内存不连续) | 好(数组连续) |
| 空间开销 | 链表节点对象头 | 仅数组本身 |
| 典型应用 | Java HashMap | ThreadLocalMap、Python dict |
四、Java HashMap 的哈希冲突处理——工业级的精致
4.1 不是直接用 hashCode()
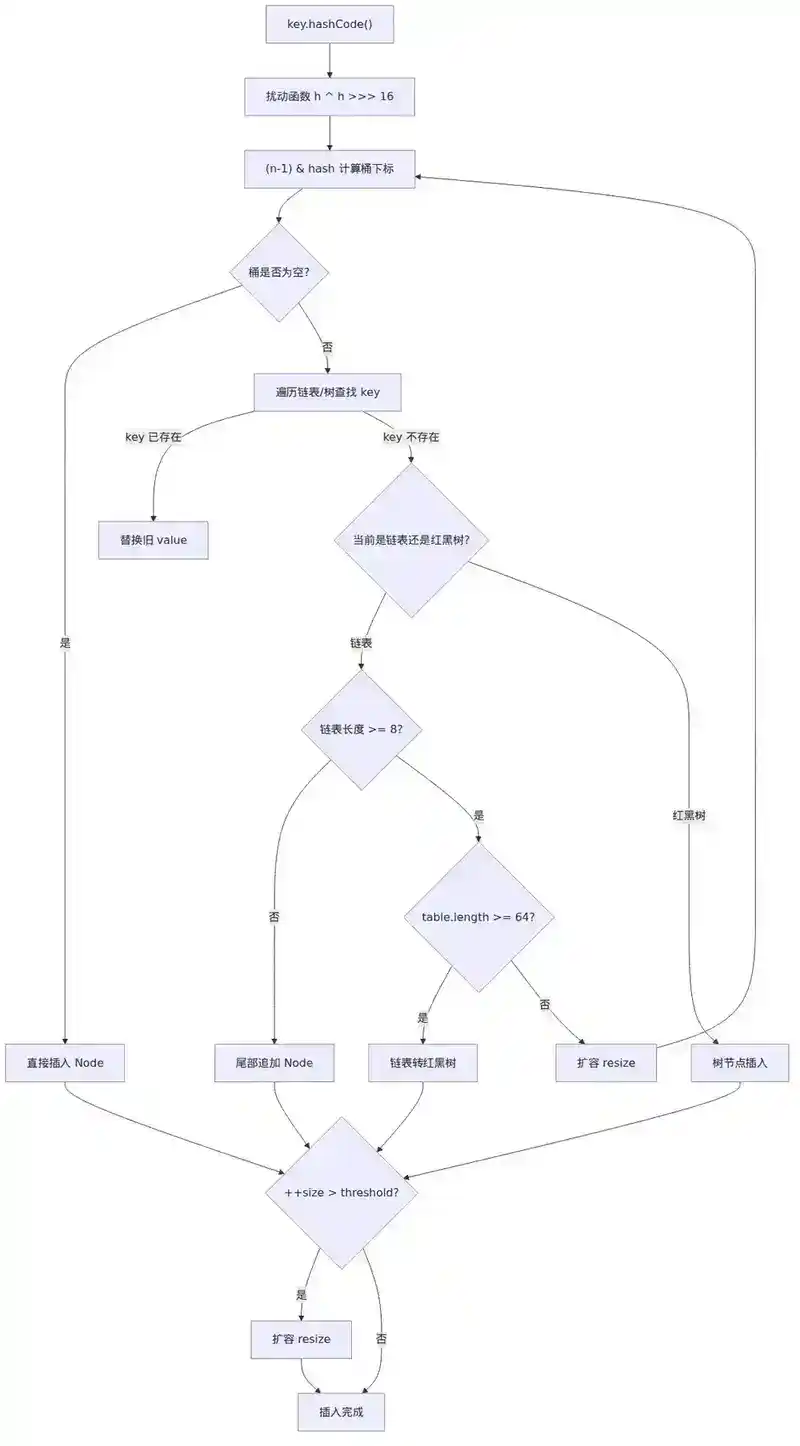
// JDK 8 HashMap.put() 的哈希值计算
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
这个 扰动函数 的设计非常巧妙:
- 将 hashCode 的高 16 位和低 16 位做 XOR
- 目的是让高位的信息也参与到低位中来
为什么需要扰动? HashMap 的桶下标计算是 (n-1) & hash,其中 n 是 2 的幂次。比如 n=16 时,n-1=15=0b1111,只有低 4 位参与运算。如果 hashCode 的高位变化很大但低位变化很小(很多对象的 hashCode 确实如此),就会造成严重的碰撞。
扰动函数把高位的差异"混合"到低位,让桶下标的分布更均匀。
4.2 链表转红黑树——JDK 8 的关键优化
// 链表 → 红黑树的条件
if (binCount >= TREEIFY_THRESHOLD - 1)  // TREEIFY_THRESHOLD = 8
    treeifyBin(tab, hash);

// treeifyBin 中还有容量检查
if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY)  // 64
    resize();  // 容量小于 64 时优先扩容而非树化
两个条件必须同时满足:
- 单个桶的链表长度 ≥ 8
- 整个 HashMap 容量 ≥ 64
为什么不直接用树? 红黑树节点(TreeNode)约占 32 字节,是普通 Node 的 2 倍。对于分布良好的哈希表,每个桶平均只有 0-1 个元素,用树得不偿失。所以只在极端冲突时才升级。
退化条件:当桶中元素降到 ≤ 6 时,树退化为链表。留出 2 个元素的缓冲区(6→8)避免频繁转换。
4.3 扩容时的元素迁移
// JDK 8 的 resize() 中,元素重新分布的核心逻辑
// 因为容量总是 2 的幂次,扩容后只需要判断新增的 1 个 bit
Node<K,V> loHead = null, loTail = null;  // 留在原位置的链表
Node<K,V> hiHead = null, hiTail = null;  // 移到新位置的链表

do {
    next = e.next;
    if ((e.hash & oldCap) == 0) {
        // 新增位为 0 → 留在原位
        ...
    } else {
        // 新增位为 1 → 移到 oldIndex + oldCap
        ...
    }
} while ((e = next) != null);
JDK 8 的优化:不需要重新计算哈希值。因为容量是 2 的幂次,只需要判断哈希值在新增的那一位上是 0 还是 1——如果是 0,留在原位置;如果是 1,偏移到 原位置 + oldCap。这个优化把 O(n) 的迁移操作中的常数因子降到了很低。
五、为什么需要一致性哈希——传统哈希的分布式困境
5.1 取模哈希的"全局洗牌"问题
在分布式缓存或数据库分片的场景,最朴素的路由策略是:
nodeIndex = hash(key) % N
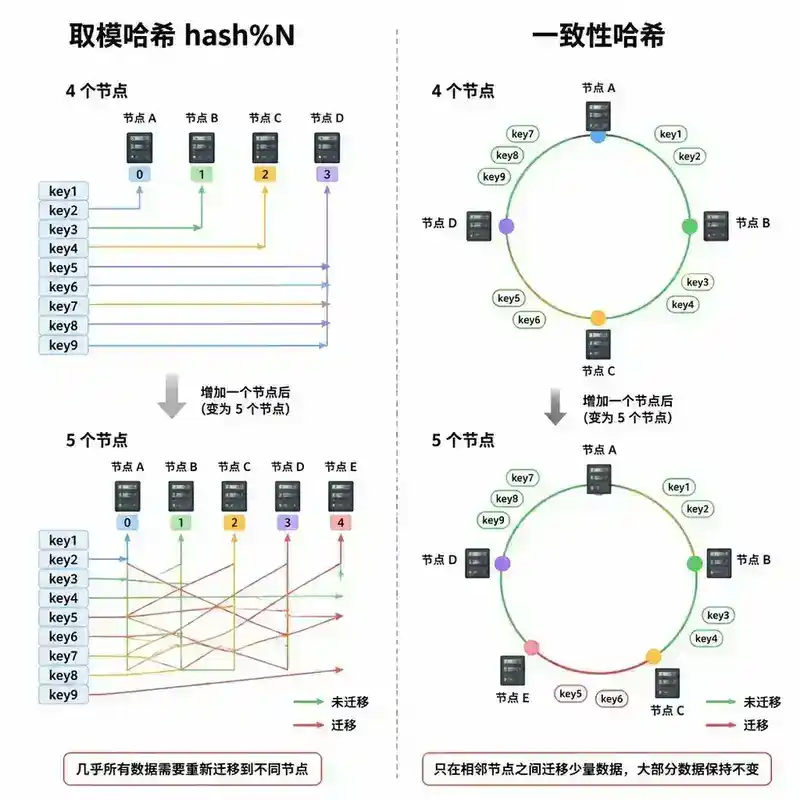
其中 N 是节点数量。这个方案的问题是:N 一旦变化,几乎所有 key 的路由都会改变。
假设 N 从 4 变成 5:
取模 4: key "user_1001" → 1, "user_2002" → 2, "user_3003" → 3, "user_4004" → 0
取模 5: key "user_1001" → 1, "user_2002" → 2, "user_3003" → 3, "user_4004" → 4
"user_4004" 的路由从节点 0 变成了节点 4。在实际系统中,影响比例约为 (N-1)/N ≈ 1 - 1/N。当 N=10 时,90% 的 key 需要重新分配——缓存雪崩、数据迁移风暴。
5.2 问题的本质
取模哈希的致命缺陷是:key 到节点的映射依赖于全局的节点数量 N。一致性哈希的核心思想就是消除这个对 N 的依赖——让 key 的映射只取决于 key 本身和节点在哈希空间中的位置。
六、一致性哈希:环形空间上的优雅解法
6.1 核心概念
想象一个 0 到 2³²-1 的环形哈希空间(hash ring):
- 对每个节点也计算哈希值,把节点"放置"在环上
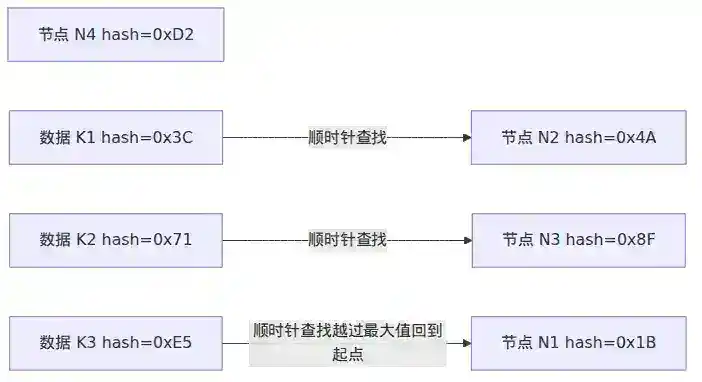
- 对每个 key 计算哈希值,在环上顺时针找到第一个节点
- 这个节点就是该 key 的归属
           0
      /         \
    N3(h=1B)    N1(h=3A)
     |     ring      |
    N2(h=2F)     K1(h=45)
      \         /
          2^32-1

K1(h=45) → 顺时针第一个节点 → N1(h=3A)
6.2 节点增减——只影响局部
新增节点:在环上插入新节点的哈希位置。只有原本路由到新节点顺时针方向下一个节点的那些 key 需要迁移到新节点。其余 key 完全不受影响。
移除节点:将节点从环上摘除。原本路由到该节点的 key 自动迁移到顺时针方向的下一个节点。
在理想情况下(节点均匀分布在环上),新增/移除一个节点平均只影响 1/N 的 key。这与取模哈希的 (N-1)/N 形成鲜明对比。
6.3 用二分查找实现 O(log V) 路由
在工程实现中,环用有序数据结构表示(如 Java 的 TreeMap 或跳表):
// 一致性哈希路由的核心代码
public Node route(String key) {
    int hash = hash(key);
    // ceilingEntry: 找到 >= hash 的最小 key
    // 如果找不到(hash 值大于所有节点),回到环的起点
    Map.Entry<Integer, Node> entry = ring.ceilingEntry(hash);
    if (entry == null) {
        entry = ring.firstEntry();
    }
    return entry.getValue();
}
使用红黑树(TreeMap),路由时间复杂度为 O(log V),其中 V 是虚拟节点数量。
七、虚拟节点:解决数据倾斜的关键机制
7.1 物理节点分布不均的问题
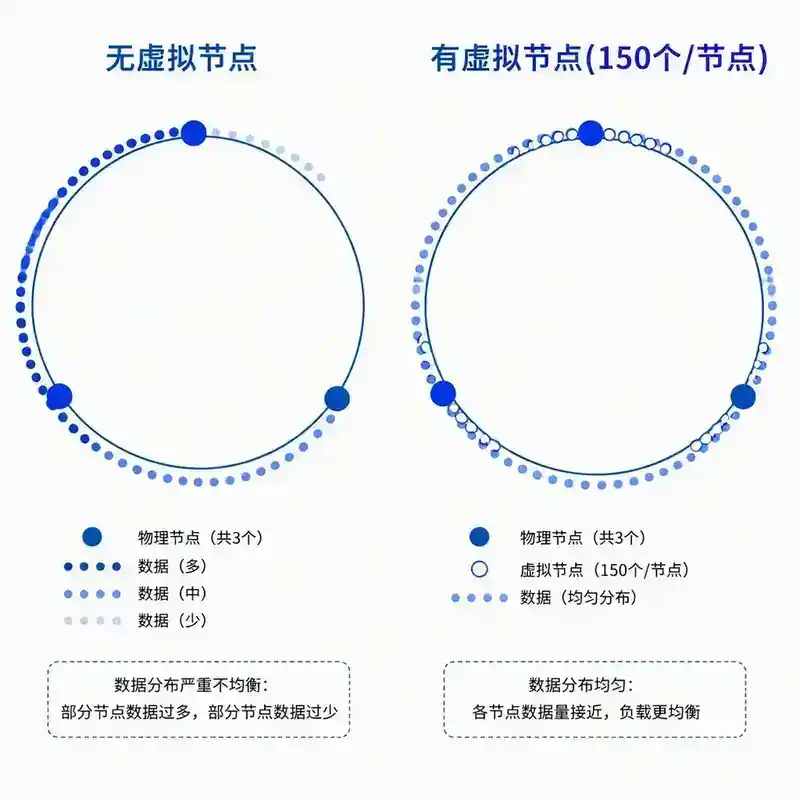
在没有虚拟节点的情况下,节点的哈希值在环上的分布取决于哈希函数的输出。即使哈希函数本身是均匀的,有限个节点在环上的位置也是随机的,必然导致弧段长度不等:
节点少、无虚拟节点时的极端情况:
[         N1         ] [N2] [           N3            ]
弧段极不均匀 → N3 的数据量是 N2 的十几倍
这就是数据倾斜(Data Skew)。
7.2 虚拟节点的原理
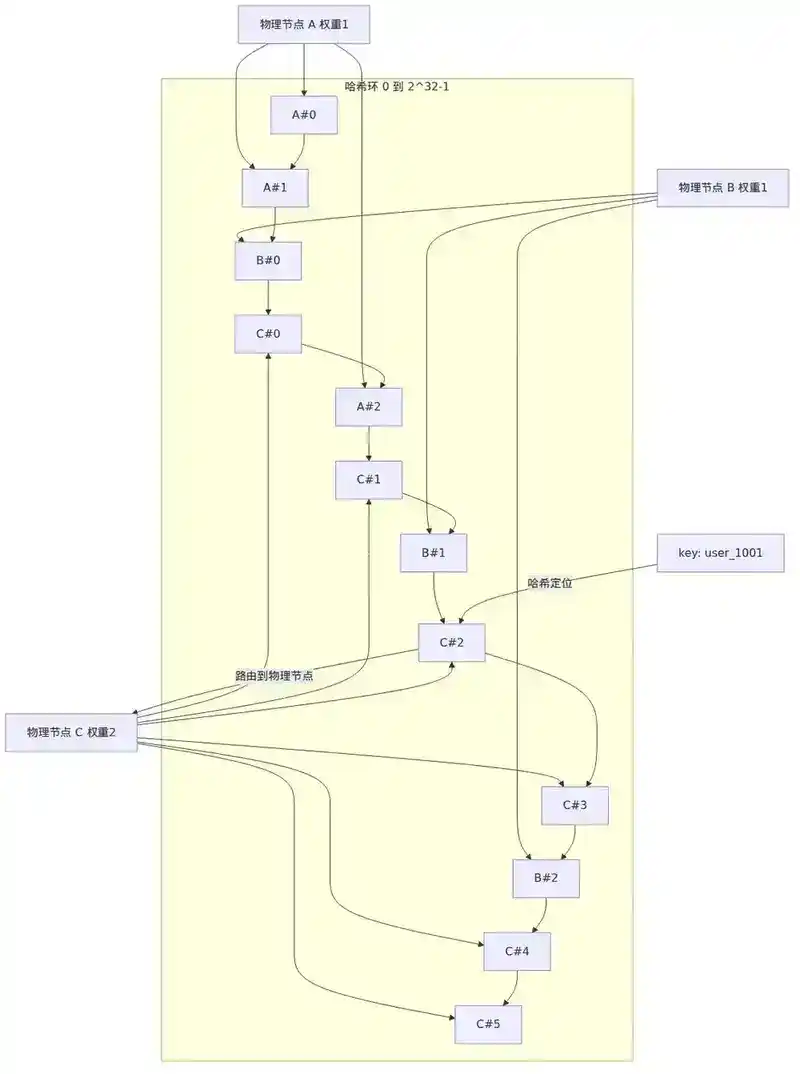
为每个物理节点创建多个虚拟节点,将它们分散到环上:
物理节点 A → 虚拟节点 A#0, A#1, A#2, ..., A#149
物理节点 B → 虚拟节点 B#0, B#1, B#2, ..., B#149
物理节点 C → 虚拟节点 C#0, C#1, C#2, ..., B#149

共 450 个虚拟节点散布在环上
key 找到虚拟节点 A#37 → 最终归属物理节点 A
虚拟节点数量越多,分布越均匀。 这符合大数定律——大量独立随机变量之和趋向稳定。
// 虚拟节点的实现模式
public class ConsistentHash {
    private final TreeMap<Integer, Node> ring = new TreeMap<>();
    private final int virtualNodeCount;

    public ConsistentHash(List<Node> physicalNodes, int virtualNodeCount) {
        this.virtualNodeCount = virtualNodeCount;
        for (Node node : physicalNodes) {
            addNode(node);
        }
    }

    private void addNode(Node node) {
        for (int i = 0; i < virtualNodeCount; i++) {
            int hash = hash(node.getKey() + "#" + i);
            ring.put(hash, node);
        }
    }
}
7.3 虚拟节点数量如何选择
| 物理节点数 | 推荐虚拟节点数 | 标准差/均值比 |
|---|---|---|
| 5 | 100-200 | < 10% |
| 10 | 100-150 | < 5% |
| 50 | 50-100 | < 3% |
| 100+ | 20-50 | < 2% |
经验公式:100-200 个虚拟节点/物理节点 在大多数场景下足够。过多的虚拟节点增加路由的 TreeMap 查询开销(O(log VN)),但收益递减。
7.4 加权虚拟节点
当节点能力不均时(如异构机器、不同规格的 Redis 实例),可以根据权重调整虚拟节点数:
// 权重高的节点分配更多虚拟节点
int virtualCount = baseCount * node.getWeight();
这使得能力更强的节点自动承担更多流量。
八、数据倾斜的全面分析
8.1 数据倾斜的三层原因
| 层次 | 原因 | 表现 |
|---|---|---|
| 算法层 | 哈希函数不均匀 | 某些哈希值出现概率更高 |
| 结构层 | 环上节点分布不均(无虚拟节点) | 弧段长度差异大 |
| 业务层 | key 本身聚集(热点 key) | 少量 key 的请求量极大 |
前两层可以通过一致性哈希 + 虚拟节点解决,第三层(热点 key)是任何哈希方案都无法根除的,需要额外的热点治理手段。
8.2 热点 key 的治理
对于无法通过哈希分散的热点(如明星微博的 timeline key),需要在应用层做处理:
- 本地缓存:在请求链路的最前端用 Caffeine/Guava Cache 拦截
- key 拆分:
hot_key→hot_key_0,hot_key_1, ...,hot_key_N,分散到不同节点 - 读写分离副本:热点 key 多副本只读,写入时同步更新
- 限流与降级:超过阈值时返回缓存中的旧值
九、工程实践:一致性哈希在各系统中的变形
9.1 Redis Cluster:哈希槽(Hash Slot)
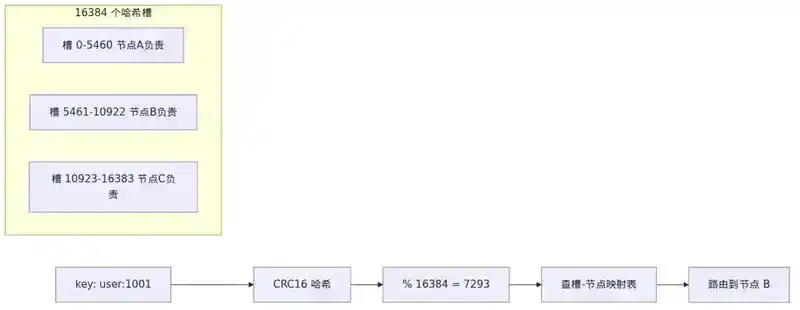
Redis Cluster 没有使用标准的一致性哈希环,而是用了 16384 个哈希槽:
slot = CRC16(key) % 16384
每个 Master 节点负责一部分槽(如节点 A 负责 0-5460,节点 B 负责 5461-10922,节点 C 负责 10923-16383)。
为什么不用一致性哈希环?
- 哈希槽是离散的(16384 个整数),迁移时可以按槽粒度精确控制
- 槽的数量固定,与节点数解耦——加节点只需移动部分槽
- Gossip 协议传播槽-节点映射关系,最终一致性即可
为什么是 16384?
- 槽映射信息在集群节点间通过心跳传播,每个槽占用 1 bit(bitmap),16384 个槽的 bitmap 恰好 2KB
- 2KB 是心跳包的一个合理大小——太大浪费带宽,太小槽粒度不足
- CRC16 产生 16 位输出(0-65535),16384 < 65535,分布效率合理
9.2 Nginx / API 网关的一致性哈希
upstream backend {
    hash $request_uri consistent;  # 基于 URI 的一致性哈希
    server backend1.example.com;
    server backend2.example.com;
    server backend3.example.com;
}
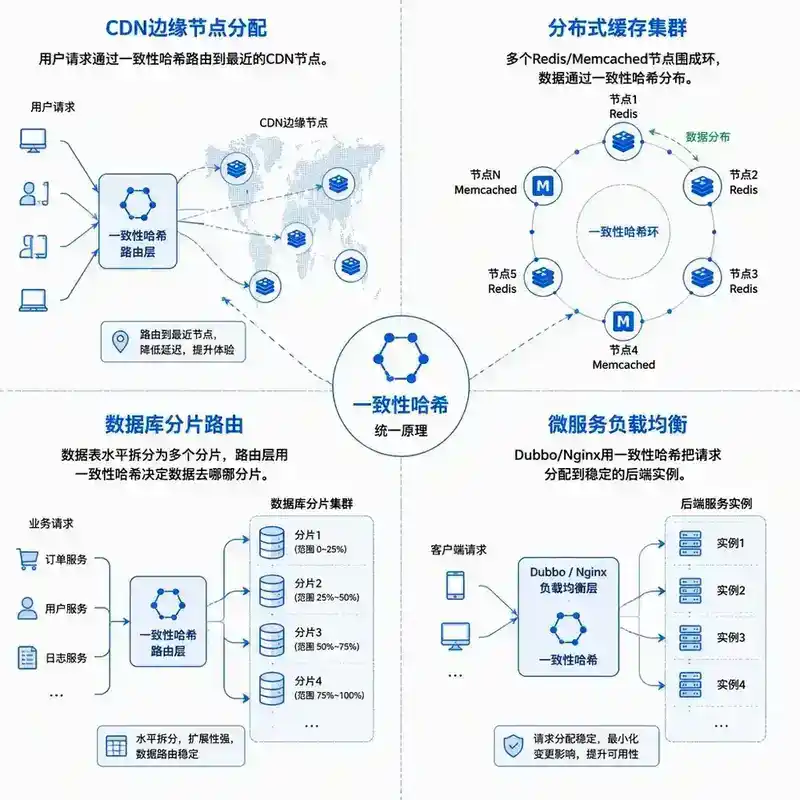
Nginx 的 consistent 参数使得同一个 URI 始终路由到同一台后端——这对带状态的 WebSocket 连接和有本地缓存的 API 非常重要。
9.3 Dubbo 一致性哈希负载均衡
// Dubbo 的一致性哈希负载均衡
// key 默认为调用的方法名 + 参数列表
ConsistentHashLoadBalance
// 同一个消费者对同一个方法的调用始终路由到同一个提供者
9.4 CDN 边缘节点分配
CDN 使用一致性哈希将用户请求分配到最近的边缘节点。这里的一致性哈希环引入了地理距离权重——靠近用户的节点拥有更大的弧段(更多的虚拟节点),使就近访问的概率最大化。
9.5 Amazon Dynamo 的分区策略
Dynamo 是一致性哈希的经典应用,每个物理节点负责环上的一段区间。数据复制到顺时针方向的 N 个后继节点,同时使用 Merkle 树 进行副本之间的差异检测和修复。
十、总结对比
| 维度 | 取模哈希 | 一致性哈希 | Redis 哈希槽 |
|---|---|---|---|
| 映射方式 | hash(key) % N | 顺时针查找环上节点 | CRC16(key) % 16384 |
| 节点变化影响 | 全局洗牌(~100%) | 局部(~1/N) | 局部(槽迁移) |
| 数据倾斜 | 均匀 | 需虚拟节点 | 按槽粒度可手动均衡 |
| 路由复杂度 | O(1) | O(log V) | O(1)(槽表直接查) |
| 典型应用 | 简单分库 | 分布式缓存、Dubbo | Redis Cluster |
🎯 面试问答模块
Q1:HashMap 的容量为什么必须是 2 的幂次?不是 2 的幂次会怎样?
面试官视角:基础题,但希望你从底层运算的角度解释,而不是背结论。
参考答案:核心原因是桶下标计算公式 (n-1) & hash。当 n 是 2 的幂次时,n-1 的低位全是 1,& 运算等价于取模,但比 % 快一个数量级。如果 n 不是 2 的幂次,& 运算的结果就不再均匀分布在 [0, n-1]——低位中 0 的位置对应的桶永远用不上,数据分布的熵会急剧下降。HashMap 的 tableSizeFor() 方法会将用户指定的任意容量向上取到最近的 2 的幂次。
Q2:一个分布式缓存集群有 10 个节点,现在需要扩容到 11 个。分别用取模哈希和一致性哈希(150 虚拟节点/物理节点),各需要迁移多少比例的数据?
面试官视角:考的是量化分析能力——架构师不能只说"少很多",要能给出数量级。
参考答案:取模哈希需要迁移 (N-1)/N ≈ 90% 的数据,几乎全量。一致性哈希在理想均匀分布下需要迁移 1/(N+1) ≈ 9% 的数据。实际中由于虚拟节点分布会有微小波动,但数量级差了一个量级。注意:迁移比例不等于缓存命中率下降的比例——新增节点后,部分迁移到新节点的 key 其实本来也没缓存(冷启动),所以miss率上升远小于 9%。
Q3:为什么 JDK 的 HashMap 在树化之前还要检查容量是否 ≥ 64?如果容量只有 16,冲突已经很严重了,为什么不能直接树化?
面试官视角:考察是否理解"扩容"和"树化"两种策略的工程权衡。
参考答案:扩容解决的是全局问题(整个表的负载因子太高),树化解决的是局部问题(个别桶冲突严重)。当容量很小时(如 16),优先扩容——因为扩容不仅降低负载因子,还可能把冲突桶里的元素拆散到不同位置,根本性地消除局部拥挤。如果容量已经是 64 但还是有桶超过 8 个元素,说明不是负载因子的问题,而是 hash 分布真的集中了,此时树化是唯一选择。这个两级决策:小容量扩容 > 大容量树化,是典型的"先用便宜手段,不行再上贵的"。
Q4:如果 key 的分布本身就极度不均匀(某些 key 的请求量远大于其他 key),一致性哈希能解决问题吗?不能的话,你怎么办?
面试官视角:从"哈希问题"升维到"热点问题",考察系统思维。
参考答案:不能。一致性哈希解决的是节点分布不均导致的数据量倾斜,不是 key 本身的热度倾斜。热点 key 不管放在哪个节点,那个节点都会被压垮。解决方案是多层的:① 本地缓存(Caffeine/Guava),在 JVM 内拦截热点请求;② key 分片(hot_key:{random_N}),将热点分散到集群的多个节点,读取时并发读再合并;③ 多级缓存,在 CDN/反向代理层就过滤掉;④ 实时热点检测 + 动态扩容热点节点的副本数。一致性哈希是基础设施层的均衡,热点治理是应用层的策略。
Q5:Redis Cluster 用了 16384 个固定槽位,而不是标准的一致性哈希环。这种设计有什么优劣?
面试官视角:对比分析两种方案,考察为什么不同系统做了不同选择。
参考答案:优势——① 槽是离散的、可数的,迁移粒度精确(以槽为单位),管理员可以明确知道"从 A 迁移 100 个槽到 B";② 槽-节点映射表(16384 个 entry)可以用位图高效传播,心跳包 2KB 搞定;③ 路由是 O(1) 的——CRC16 → 查槽表 → 直接发到目标节点,无需 TreeMap 的 O(log N) 查找。代价——① 槽数量固定 16384,不能动态调整粒度;② 单 key 无法分裂(一个 key 只能在一个槽),热点 key 的分片需要应用层处理;③ 扩容时槽迁移是离散的,不够平滑——一致性哈希加/减节点时流量逐渐漂移,而槽迁移是整批切。选择取决于场景:Redis 选择了运维可预测性 > 理论优雅性。
Q6:设计一个支持权重的一致性哈希实现,需要考虑哪些边界条件?
面试官视角:从理解到设计,考察工程落地能力。
参考答案:
public class WeightedConsistentHash {
    private final TreeMap<Integer, Node> ring;
    private final int baseVirtualNodes;

    public void addNode(Node node) {
        int count = baseVirtualNodes * node.getWeight();
        for (int i = 0; i < count; i++) {
            ring.put(hash(node.getKey() + "#" + i), node);
        }
    }

    public Node route(String key) {
        // ...TreeMap ceilingEntry...
    }

    // 边界条件:
    // 1. 权重变化时,需要 rebalance 而非简单的增删虚拟节点
    // 2. 权重为 0 的节点是否保留环上占位(一般保留一个)
    // 3. 新增高权重节点可能瞬间接管大量 key —— 需要灰度迁移
    // 4. hash("#" + i) 生成的虚拟节点可能恰好碰撞 —— 加盐或重试
    // 5. TreeMap 并发不安全 —— 读写分离或用 ConcurrentSkipListMap
}
关键边界:① 权重更新的rebalance——不是简单加减虚拟节点,要保证迁移量最小;② 虚拟节点哈希碰撞——hash(nodeId + "#" + i) 可能产生相同的哈希值,需要冲突处理或换哈希策略;③ 路由数据结构的并发安全——JDK 的 TreeMap 不是线程安全的,需要 ConcurrentSkipListMap 或读写锁。
📌 延伸思考:哈希和排序是计算机科学的两大基石。与本文相关的知识点:241|复杂度分析(帮你量化哈希结构的时间/空间取舍)、018|HashMap 数据结构(深入 Java 哈希表的内部实现)、137|Redis Cluster(哈希槽在工程中的完整落地)。把这三篇和本文串起来,你就拥有了从微观数据结构到宏观分布式架构的完整哈希知识体系。
下篇预告:考点 245|高频算法思想:二分、双指针、滑动窗口、回溯、贪心和动态规划