阅读时间:约 45 分钟 | 难度:中高级 | 分类:数据结构与算法
一、引言:为什么算法思想比刷题更重要
面试中有一个常见的误区:候选人 LeetCode 刷了 500 道题,结果遇到一道变种题当场卡住。原因很简单——他在背题,而不是在学思想。
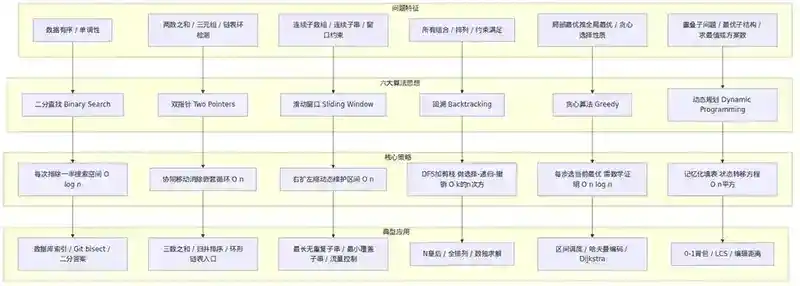
算法思想(Algorithmic Paradigm)是解题的"元能力"。一旦你掌握了二分、双指针、滑动窗口、回溯、贪心和动态规划这六种核心思想,面对任何新题都能从问题特征出发,推导出解法,而不是在记忆库里检索"这题我做过没有"。
本文的目标不是穷举所有题目,而是帮你建立从问题特征到算法思想的映射。读完这篇文章,你应该能回答:给定一个算法问题,我如何判断它该用哪种思想解决?
二、二分查找:不只是"找中间"
2.1 核心思想
二分查找(Binary Search)的本质是通过一次比较,排除一半的搜索空间。这个思想远比"在有序数组里找某个值"更深刻。
二分查找有两个关键前提:
- 单调性(Monotonicity):搜索空间存在某种单调性质,使得"如果条件在位置 x 成立,则在 x 之后(或之前)一定也成立"
- 随机访问:能在 O(1) 时间内访问任意位置
2.2 经典模板与边界陷阱
二分查找的代码看似简单,但边界条件极其容易出错。核心在于两个问题的答案:
- while 循环条件是
**left < right**还是**left <= right**? - mid 更新是
**left = mid + 1**还是**left = mid**?
答案取决于你的搜索区间定义。以最经典的左闭右闭区间 [left, right] 为例:
def binary_search(nums, target):
    left, right = 0, len(nums) - 1
    while left <= right:          # 左闭右闭,left == right 时区间仍有效
        mid = left + (right - left) // 2   # 防溢出写法
        if nums[mid] == target:
            return mid
        elif nums[mid] < target:
            left = mid + 1         # target 在右半部分
        else:
            right = mid - 1        # target 在左半部分
    return -1
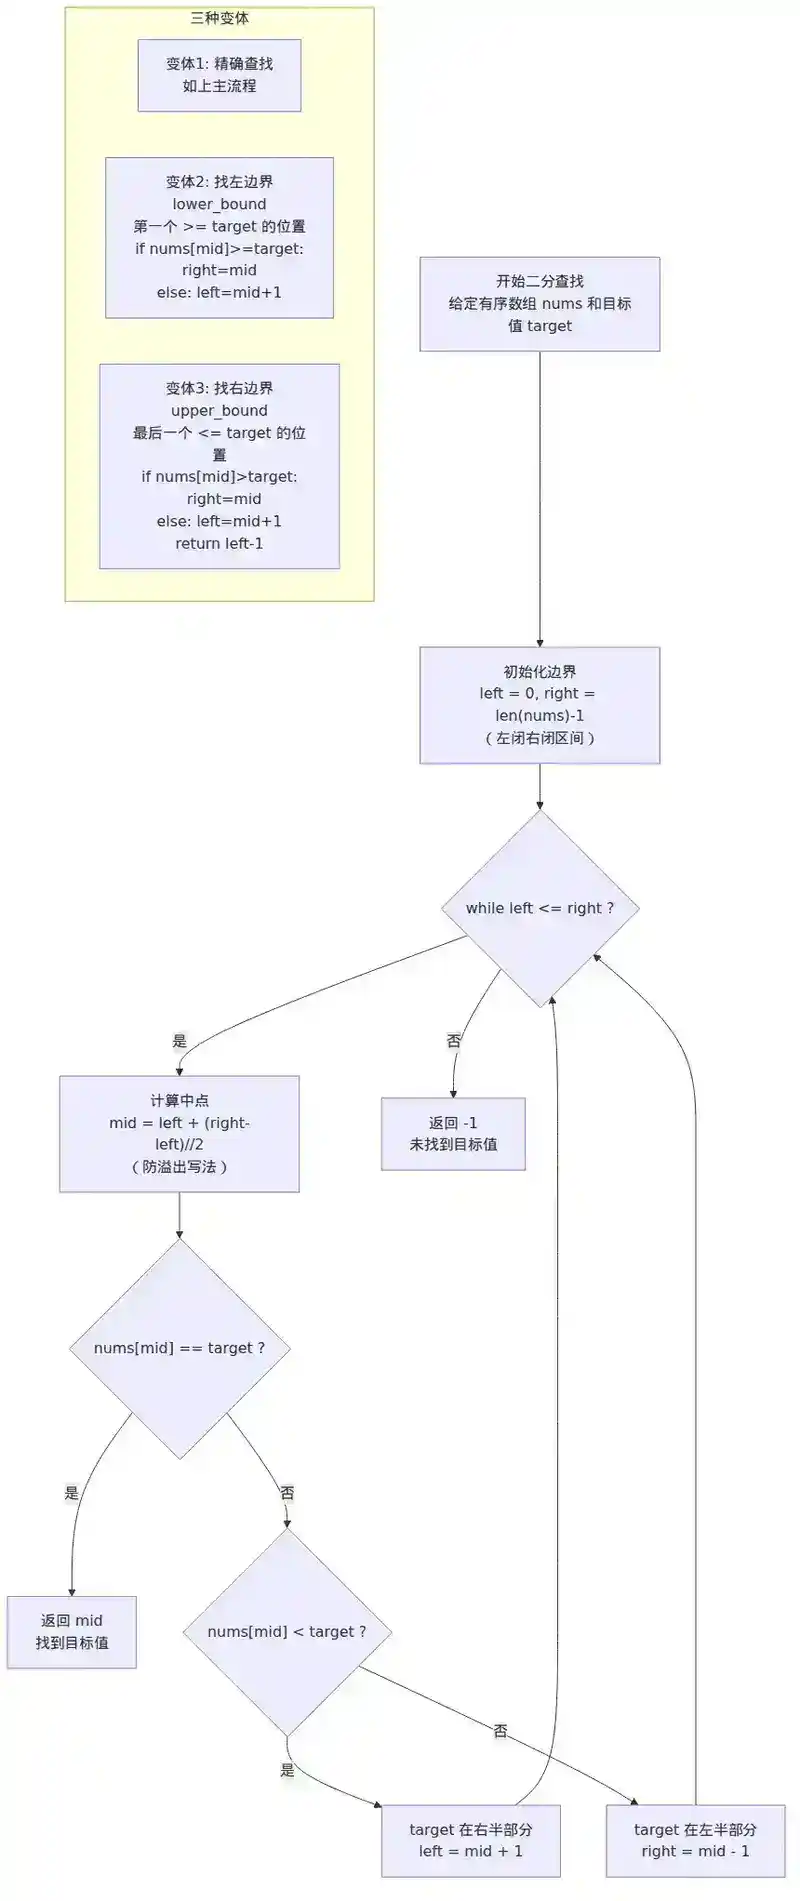
关键细节:mid = left + (right - left) // 2 而非 (left + right) // 2,因为后者在 left + right 超过 int 范围时会溢出。
2.3 二分查找的三种变体
真正考验功力的是二分查找的变体——找左边界和找右边界。这在"查找第一个大于等于 target 的元素"等场景中频繁出现。
找左边界(第一个 >= target 的位置):
def lower_bound(nums, target):
    left, right = 0, len(nums)
    while left < right:
        mid = left + (right - left) // 2
        if nums[mid] >= target:
            right = mid            # mid 可能是答案,但左边可能还有
        else:
            left = mid + 1
    return left
找右边界(最后一个 <= target 的位置):
def upper_bound(nums, target):
    left, right = 0, len(nums)
    while left < right:
        mid = left + (right - left) // 2
        if nums[mid] > target:
            right = mid
        else:
            left = mid + 1
    return left - 1
2.4 二分答案:二分思想的升维
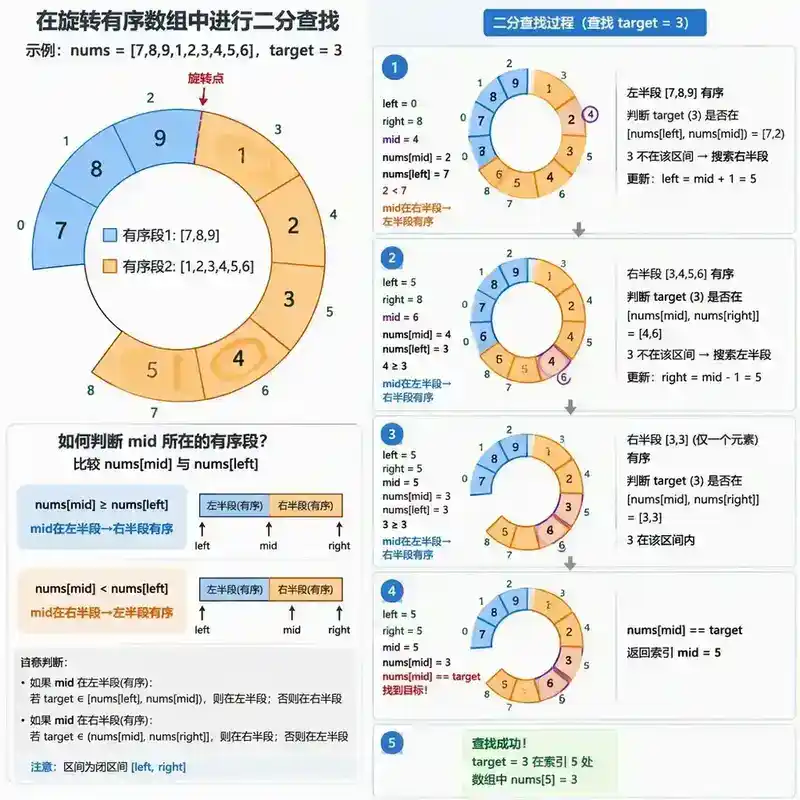
二分查找最强大的应用不是"在数组里找元素",而是二分答案(Binary Search on Answer)。当问题满足"答案越小越容易满足条件"(或反过来)的单调性时,就可以对答案空间进行二分。
经典问题:Koko 吃香蕉——有 n 堆香蕉,每堆 piles[i] 根,警卫 h 小时后回来。Koko 每小时选一堆吃 k 根(如果不够 k 根就吃完)。求能在 h 小时内吃完所有香蕉的最小速度 k。
分析:速度 k 越大,花费时间越少。存在单调性:如果速度 k 可行,则 k+1, k+2, ... 都可行。于是可以对 k 的范围 [1, max(piles)] 做二分。
def min_eating_speed(piles, h):
    def can_finish(k):
        return sum((p + k - 1) // k for p in piles) <= h

    left, right = 1, max(piles)
    while left < right:
        mid = left + (right - left) // 2
        if can_finish(mid):
            right = mid
        else:
            left = mid + 1
    return left
二分答案的适用特征:
- 问题问的是"最小值最大"或"最大值最小"
- 存在一个判定函数
check(x),且check(x)随 x 单调变化 - 答案范围可以确定上下界
2.5 二分查找的工程应用
在工程中,二分思想无处不在:
- 数据库 B+Tree 索引查找:在内部节点中二分定位到下一层
- Java Arrays.binarySearch():返回负值表示插入点
-(insertion_point) - 1 - Git bisect:用二分法定位引入 bug 的 commit
- 负载均衡中的一致性哈希环查找:在有序的虚拟节点列表中二分
- Redis 跳表(skiplist):多层索引本质是对链表加速的二分近似
三、双指针:一维空间的协同搜索
3.1 核心思想
双指针(Two Pointers)是指用两个指针在数据结构上移动,通过它们的协同来降低时间复杂度。双指针通常能将 O(n²) 的暴力解优化到 O(n)。
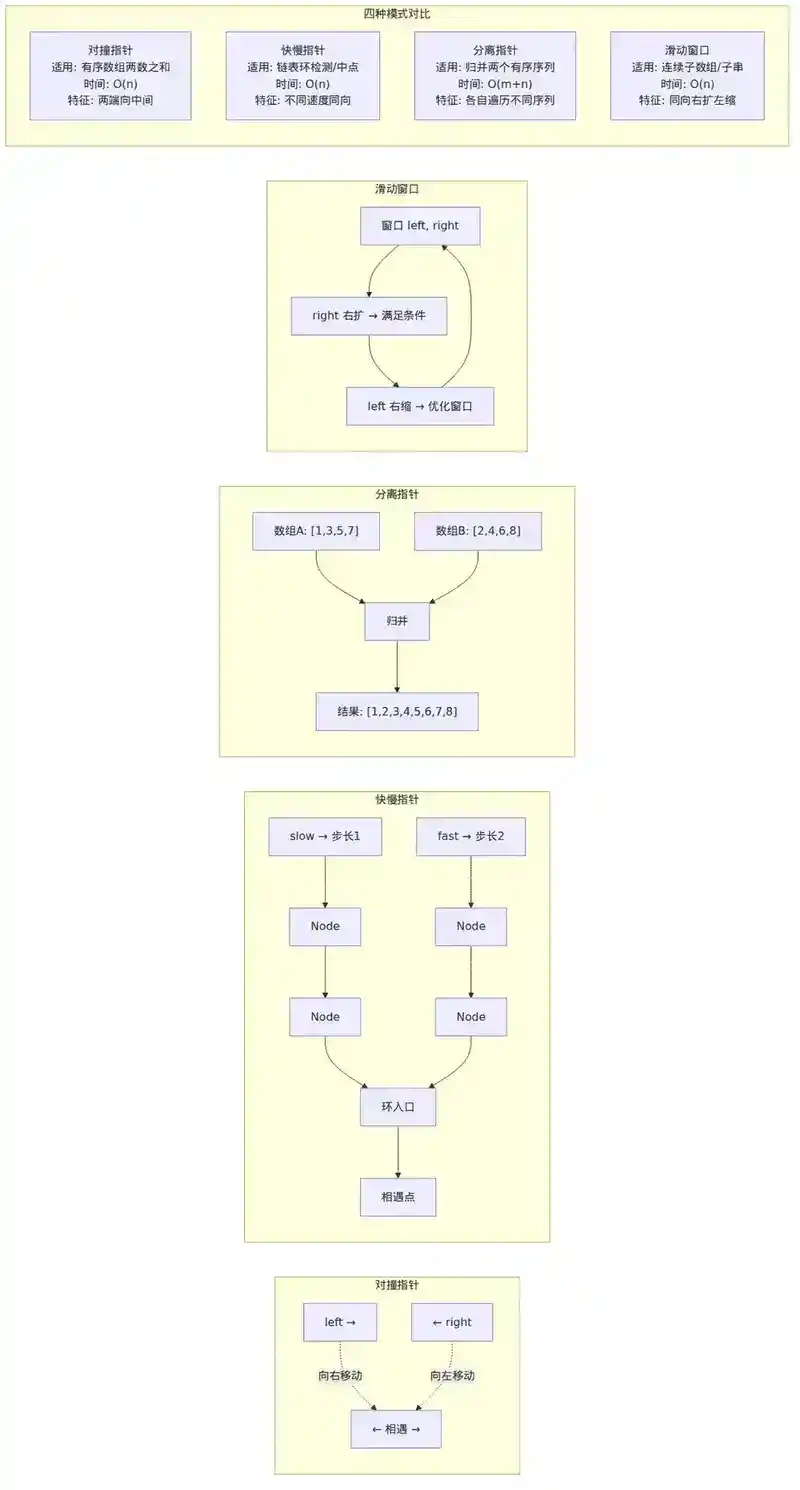
3.2 四种经典模式
模式一:对撞指针(Opposite Direction)
两个指针从两端向中间移动,适用于有序数组中的查找问题。
经典问题:两数之和 II(有序数组)——给定升序数组,找两个数之和等于 target。
def two_sum(nums, target):
    left, right = 0, len(nums) - 1
    while left < right:
        s = nums[left] + nums[right]
        if s == target:
            return [left, right]
        elif s < target:
            left += 1    # 和太小,左指针右移增大和
        else:
            right -= 1   # 和太大,右指针左移减小和

    return [ ]
为什么正确? 因为数组有序,nums[left] 增大或 nums[right] 减小会单调地改变和。每次移动一定是正确的方向,不会遗漏解。
模式二:快慢指针(Fast-Slow)
快指针每次走两步,慢指针每步走一步。主要用于链表问题。
经典问题:环形链表检测(Floyd 判圈算法):
def has_cycle(head):
    slow = fast = head
    while fast and fast.next:
        slow = slow.next
        fast = fast.next.next
        if slow == fast:
            return True
    return False
为什么快慢指针一定会相遇? 如果存在环,快指针每次比慢指针多走一步,相当于在环内以相对速度 1 追赶慢指针。由于环的长度有限,一定会在某个时刻追上。
找环的入口:相遇后,将慢指针重置到 head,快慢指针同步每次走一步,再次相遇点就是环的入口。这背后的数学原理是:设 head 到环入口距离为 a,环入口到相遇点距离为 b,相遇点到环入口距离为 c,则 a + b = n * (b + c),推导可得 a = (n-1)(b+c) + c。
模式三:分离指针(Separate Pointers)
两个指针分别遍历两个不同的序列,常用于归并操作。
经典问题:合并两个有序数组:
def merge(nums1, m, nums2, n):
    p1, p2, p = m - 1, n - 1, m + n - 1
    while p2 >= 0:
        if p1 >= 0 and nums1[p1] > nums2[p2]:
            nums1[p] = nums1[p1]
            p1 -= 1
        else:
            nums1[p] = nums2[p2]
            p2 -= 1
        p -= 1
模式四:滑动窗口(详见下一章)
3.3 双指针的泛化:N 数之和问题
三数之和问题(3Sum)是双指针思想的经典泛化:先排序固定一个数,然后在剩余部分用双指针找两数之和。
def three_sum(nums):
    nums.sort()

    res = [ ]

    for i in range(len(nums) - 2):
        if i > 0 and nums[i] == nums[i-1]:
            continue  # 跳过重复的固定值
        left, right = i + 1, len(nums) - 1
        while left < right:
            s = nums[i] + nums[left] + nums[right]
            if s == 0:
                res.append([nums[i], nums[left], nums[right]])
                while left < right and nums[left] == nums[left+1]:
                    left += 1
                while left < right and nums[right] == nums[right-1]:
                    right -= 1
                left += 1
                right -= 1
            elif s < 0:
                left += 1
            else:
                right -= 1
    return res
时间复杂度从 O(n³) 降到 O(n²),去重逻辑是面试中的高频扣分点。
四、滑动窗口:连续子数组/子串的利器
4.1 核心思想
滑动窗口是双指针的特化形式,专门用于处理连续子数组/子串问题。它维护一个窗口 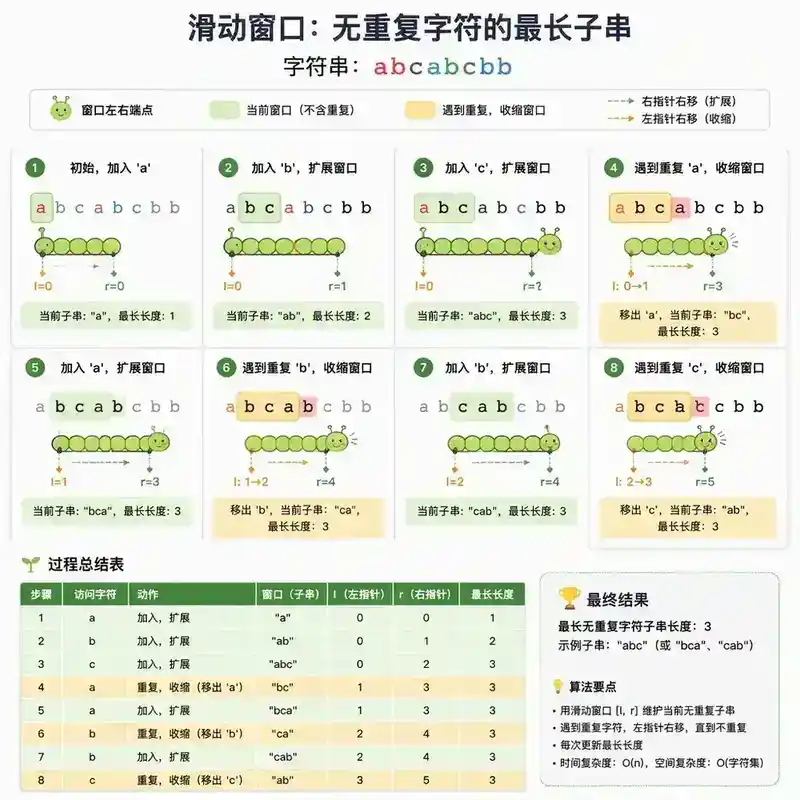
4.2 滑动窗口的通用框架
def sliding_window(s):
    left = 0
    window = {}  # 窗口内数据的状态
    result = 0

    for right in range(len(s)):
        # 1. 将 s[right] 加入窗口
        add_to_window(window, s[right])

        # 2. 当窗口不满足条件时,收缩左边界
        while not is_valid(window):
            remove_from_window(window, s[left])
            left += 1

        # 3. 更新结果(窗口现在是有效的)
        result = max(result, right - left + 1)

    return result
4.3 经典问题详解
最长无重复字符子串(Longest Substring Without Repeating Characters):
def length_of_longest_substring(s):
    window = {}
    left = 0
    max_len = 0

    for right, ch in enumerate(s):
        # 如果当前字符已在窗口内,收缩左边界
        if ch in window and window[ch] >= left:
            left = window[ch] + 1
        window[ch] = right
        max_len = max(max_len, right - left + 1)

    return max_len
执行过程可视化(以 "abcabcbb" 为例):
| 步骤 | right | ch | left | window | 窗口内容 | max_len |
|---|---|---|---|---|---|---|
| 1 | 0 | a | 0 | "a" | 1 | |
| 2 | 1 | b | 0 | "ab" | 2 | |
| 3 | 2 | c | 0 | "abc" | 3 | |
| 4 | 3 | a | 1 | "bca" | 3 | |
| 5 | 4 | b | 2 | "cab" | 3 | |
| 6 | 5 | c | 3 | "abc" | 3 | |
| 7 | 6 | b | 5 | "cb" | 3 | |
| 8 | 7 | b | 7 | "b" | 3 |
4.4 滑动窗口的变体
固定窗口:窗口大小固定,用于求固定长度子串的某种性质。
最小覆盖子串(Minimum Window Substring):当窗口不满足条件时右扩,满足后左缩求最小。
def min_window(s, t):
    need = {}
    for ch in t:
        need[ch] = need.get(ch, 0) + 1
    window = {}
    left = 0
    valid = 0  # 已满足条件的字符种类数
    start, length = 0, float('inf')

    for right, ch in enumerate(s):
        if ch in need:
            window[ch] = window.get(ch, 0) + 1
            if window[ch] == need[ch]:
                valid += 1

        while valid == len(need):
            if right - left + 1 < length:
                start, length = left, right - left + 1
            if s[left] in need:
                if window[s[left]] == need[s[left]]:
                    valid -= 1
                window[s[left]] -= 1
            left += 1

    return s[start:start+length] if length != float('inf') else ''
滑动窗口的适用信号:
- 问题要求"连续子数组/子串"
- 窗口内元素满足某种单调性(越大越可能满足条件)
- 时间复杂度要求 O(n)
五、回溯:穷举的艺术
5.1 核心思想
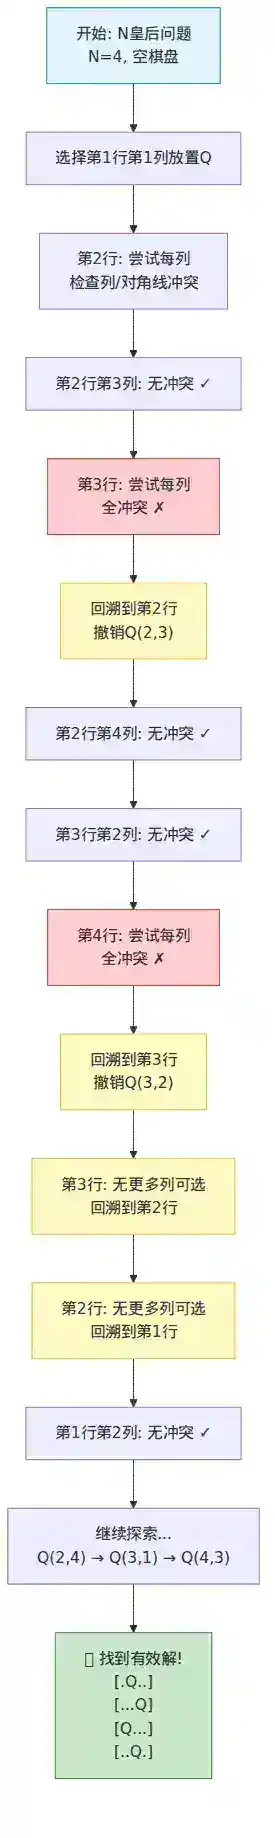
回溯(Backtracking)是一种系统地搜索解空间的方法。它通过递归构建候选解,当发现当前路径不可能产生有效解时,立即回退(剪枝),避免无效搜索。
回溯 = 深度优先搜索 + 剪枝。
5.2 回溯的通用框架
def backtrack(路径, 选择列表):
    if 满足结束条件:
        result.add(路径)
        return

    for 选择 in 选择列表:
        if 选择不合法:
            continue           # 剪枝
        做选择
        backtrack(路径, 选择列表)
        撤销选择
回溯的三要素:
- 路径(Path):已经做出的选择
- 选择列表(Choice List):当前可以做的选择
- 结束条件(Termination):到达决策树底层,无法再做选择
5.3 经典问题详解
N 皇后问题:在 N×N 的棋盘上放置 N 个皇后,使它们互不攻击。
def solve_n_queens(n):

    res = [ ]

    board = [['.'] * n for _ in range(n)]

    def is_valid(row, col):
        # 检查列
        for i in range(row):
            if board[i][col] == 'Q':
                return False
        # 检查左上对角线
        i, j = row - 1, col - 1
        while i >= 0 and j >= 0:
            if board[i][j] == 'Q':
                return False
            i -= 1
            j -= 1
        # 检查右上对角线
        i, j = row - 1, col + 1
        while i >= 0 and j < n:
            if board[i][j] == 'Q':
                return False
            i -= 1
            j += 1
        return True

    def backtrack(row):
        if row == n:
            res.append([''.join(row) for row in board])
            return
        for col in range(n):
            if not is_valid(row, col):
                continue  # 剪枝
            board[row][col] = 'Q'
            backtrack(row + 1)
            board[row][col] = '.'

    backtrack(0)
    return res
时间复杂度分析:N 皇后的解空间是 O(N!),但剪枝大幅减少了实际搜索量。对于 N=8,最坏 O(8!) = 40320 种可能,实际只需检查约 2000 个节点。
全排列问题:给定一个不含重复数字的数组,返回所有可能的排列。
def permute(nums):

    res = [ ]

    used = [False] * len(nums)

    def backtrack(path):
        if len(path) == len(nums):
            res.append(path[:])
            return
        for i in range(len(nums)):
            if used[i]:
                continue
            used[i] = True
            path.append(nums[i])
            backtrack(path)
            path.pop()
            used[i] = False


    backtrack([ ])

    return res
5.4 回溯与动态规划的关系
回溯和动态规划都涉及"在解空间中搜索最优解",但本质不同:
| 维度 | 回溯 | 动态规划 |
|---|---|---|
| 子问题关系 | 子问题之间独立 | 子问题重叠 |
| 搜索方式 | 深度优先 + 剪枝 | 自底向上填表 |
| 时间复杂度 | 通常指数级 | 通常多项式级 |
| 记忆化 | 不需要(路径不同) | 必须(避免重复计算) |
| 典型问题 | N皇后、排列组合、数独 | 背包、LCS、编辑距离 |
什么时候回溯可以加记忆化变成 DP? 当子问题有重叠且状态可以唯一标识时。例如"爬楼梯"问题,回溯思路是 dfs(n) = dfs(n-1) + dfs(n-2),加上 memo 就是记忆化搜索,进一步转化为 DP。
六、贪心算法:局部最优的全局赌博
6.1 核心思想
贪心算法(Greedy)在每一步选择中都采取当前状态下最优的选择,从而希望最终得到全局最优解。
贪心的关键问题不是"怎么做",而是"为什么对"——你需要证明局部最优能推出全局最优。
6.2 贪心正确性的证明方法
- 数学归纳法:证明如果前 k 步的贪心选择是最优的,则第 k+1 步的贪心选择也是最优的
- 交换论证法:假设存在一个最优解与贪心解不同,通过交换操作证明贪心解不劣于该最优解
- 拟阵理论:如果问题结构满足拟阵的遗传性和交换性,贪心一定最优
6.3 经典问题详解
跳跃游戏 II:给定非负整数数组,每个元素表示从该位置最多能跳的步数,求到达最后一个位置的最少跳跃次数。
def jump(nums):
    n = len(nums)
    if n == 1:
        return 0
    jumps = 0
    current_end = 0  # 当前跳跃能到达的最远位置
    farthest = 0     # 从当前区间内能到达的最远位置

    for i in range(n - 1):
        farthest = max(farthest, i + nums[i])
        if i == current_end:
            jumps += 1
            current_end = farthest
            if current_end >= n - 1:
                break
    return jumps
贪心在哪? 每次跳跃时,我们选择"当前可跳范围内,下一步能跳最远的位置"。这保证了跳跃次数最少。
区间调度(Interval Scheduling):给定 n 个区间,选择最多的互不重叠的区间。
def erase_overlap_intervals(intervals):
    intervals.sort(key=lambda x: x[1])  # 按结束时间排序
    count = 0
    end = float('-inf')
    for start, finish in intervals:
        if start >= end:
            count += 1
            end = finish
    return len(intervals) - count
为什么按结束时间排序? 每次选择结束时间最早的区间,给后面的区间留出最多的空间。这是经典的交换论证——任何最优解都可以通过替换为结束时间更早的区间而不减少区间数量。
6.4 贪心 vs 动态规划:什么时候贪心会失败
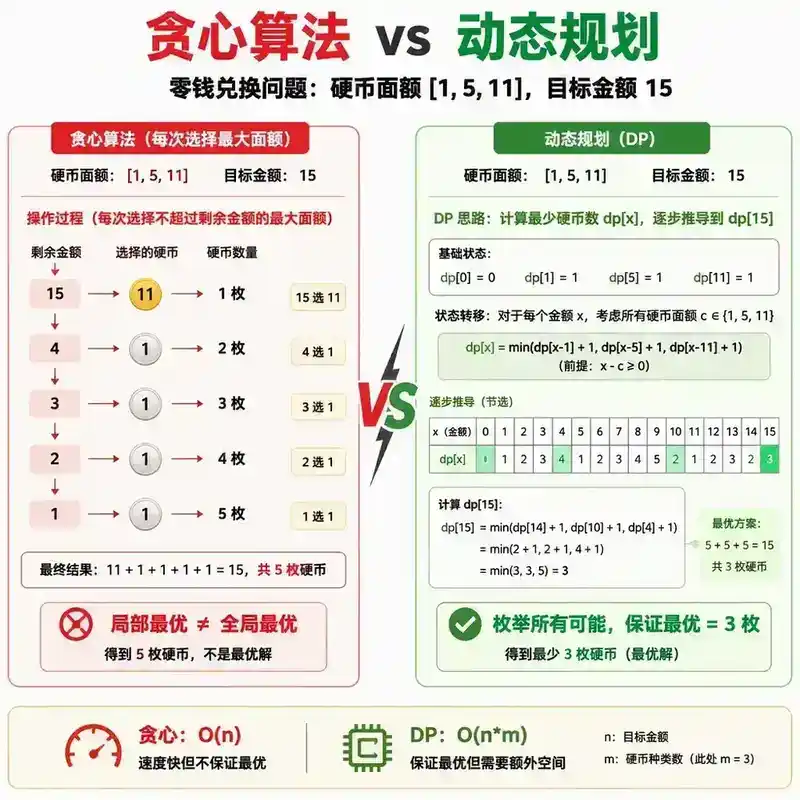
以零钱兑换问题为例:给定面额 [1, 5, 11] 的硬币,凑出 15 元的最少硬币数。
- 贪心:每次选最大面额 → 15 = 11 + 1 + 1 + 1 + 1(5 枚)
- DP:15 = 5 + 5 + 5(3 枚)← 最优解
贪心失败的原因:面额不满足"贪心选择性质"——即选最大面额不一定是最优子结构。DP 不会犯这个错误,因为它枚举了所有可能。
贪心适用的条件:
- 问题具有贪心选择性质(局部最优推全局最优)
- 问题具有最优子结构(最优解包含子问题的最优解)
- 常见于:区间调度、哈夫曼编码、最小生成树(Prim/Kruskal)、Dijkstra 最短路径
七、动态规划:重叠子问题的最优解
7.1 核心思想
动态规划(Dynamic Programming)的核心是记住已经解决过的子问题的答案,避免重复计算。它适用于具有重叠子问题和最优子结构的问题。
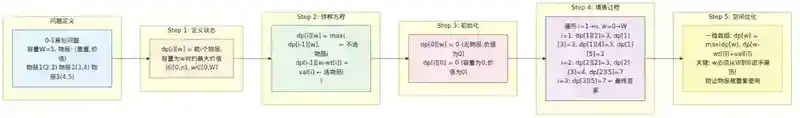
7.2 DP 的五步解题法
这是 LeetCode 上广为流传的 DP 解题框架,也是面试中最规范的答题思路:
- 定义状态(dp 数组的含义)
- 推导状态转移方程
- 确定初始条件和边界
- 确定遍历顺序
- 举例推导(验证)
7.3 经典问题详解
0-1 背包问题:给定 n 个物品,重量 w[i],价值 v[i],背包容量 W。每种物品只能选或不选,求最大价值。
第 1 步:定义状态dp[i][j] = 前 i 个物品,背包容量为 j 时的最大价值。
第 2 步:状态转移方程
dp[i][j] = max(
    dp[i-1][j],                    // 不选第 i 个物品
    dp[i-1][j-w[i]] + v[i]        // 选第 i 个物品(需要 j >= w[i])
)
第 3 步:初始化dp[0][j] = 0(0 个物品,价值为 0)
第 4 步:空间优化 注意到 dp[i][j] 只依赖于 dp[i-1][...],可以用一维数组滚动更新,但必须倒序遍历:
def knapsack(weights, values, W):
    dp = [0] * (W + 1)
    for i in range(len(weights)):
        for j in range(W, weights[i] - 1, -1):  # 倒序遍历!
            dp[j] = max(dp[j], dp[j - weights[i]] + values[i])
    return dp[W]
为什么倒序? 因为 dp[j] 依赖于上一轮(i-1)的 dp[j - w[i]]。如果正序遍历,dp[j - w[i]] 可能已经被本轮更新过了,变成"完全背包"(物品可重复选)。
最长公共子序列(LCS):给定两个字符串 text1 和 text2,返回最长公共子序列的长度。
def longest_common_subsequence(text1, text2):
    m, n = len(text1), len(text2)
    dp = [[0] * (n + 1) for _ in range(m + 1)]

    for i in range(1, m + 1):
        for j in range(1, n + 1):
            if text1[i-1] == text2[j-1]:
                dp[i][j] = dp[i-1][j-1] + 1
            else:
                dp[i][j] = max(dp[i-1][j], dp[i][j-1])

    return dp[m][n]
7.4 DP 的常见分类
| 类型 | 特征 | 典型问题 |
|---|---|---|
| 线性 DP | 状态是一维的 | 爬楼梯、打家劫舍、最大子数组和 |
| 背包 DP | 物品选择问题 | 0-1背包、完全背包、多重背包 |
| 区间 DP | 子问题由区间构成 | 最长回文子串、矩阵链乘法 |
| 树形 DP | 在树上做 DP | 二叉树最大路径和、打家劫舍 III |
| 状态压缩 DP | 用位掩码表示状态 | 旅行商问题(TSP)、N 皇后计数 |
| 数位 DP | 按数位统计 | 1~n 中数字 1 出现的次数 |
7.5 何时用 DP?识别信号
- 求最值:最大值、最小值、最长、最短、最多、最少
- 求方案数:有多少种方式/路径/组合
- 求可行性:是否存在某种方案
- 问题有明显的"阶段性":每个阶段做一次决策
- 数据规模:n 通常在 10² 到 10⁴ 之间(暗示 O(n²) DP)
八、六大思想选型指南
解决算法问题时,按以下顺序思考:
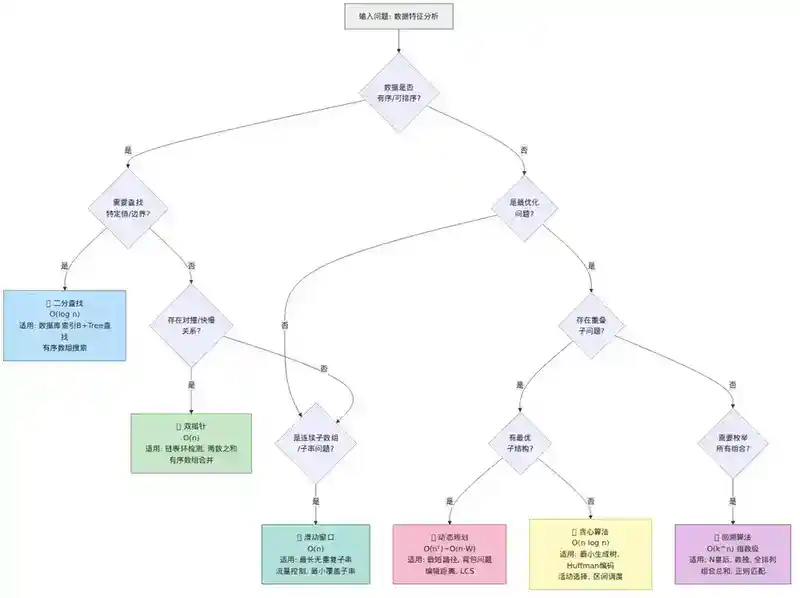
graph TD
    A[分析问题特征] --> B{数据是否有序?}
    B -->|是| C[二分查找/二分答案]
    B -->|否| D{是否求连续子数组/子串?}
    D -->|是| E[滑动窗口]
    D -->|否| F{是否穷举所有解?}
    F -->|是| G[回溯]
    F -->|否| H{是否有重叠子问题?}
    H -->|是| I[动态规划 / 记忆化搜索]
    H -->|否| J{是否局部最优推全局最优?}
    J -->|是| K[贪心算法]
    J -->|否| L[双指针 / 其他技巧]
快速判断表
| 问题特征 | 算法思想 | 时间复杂度 |
|---|---|---|
| 有序数据 + 查找 | 二分查找 | O(log n) |
| 有序数据 + 两数和/三数和 | 双指针(对撞) | O(n) / O(n²) |
| 链表 + 环/中点 | 快慢指针 | O(n) |
| 连续子数组/子串 + 约束 | 滑动窗口 | O(n) |
| 所有组合/排列 + 约束 | 回溯 | O(k^n) 最坏 |
| 最值 + 重叠子问题 | 动态规划 | O(n²) 或 O(n*k) |
| 最值 + 贪心选择性质 | 贪心 | O(n log n) 或 O(n) |
九、总结
六种算法思想不是孤立的技巧,而是一个完整的思维体系:
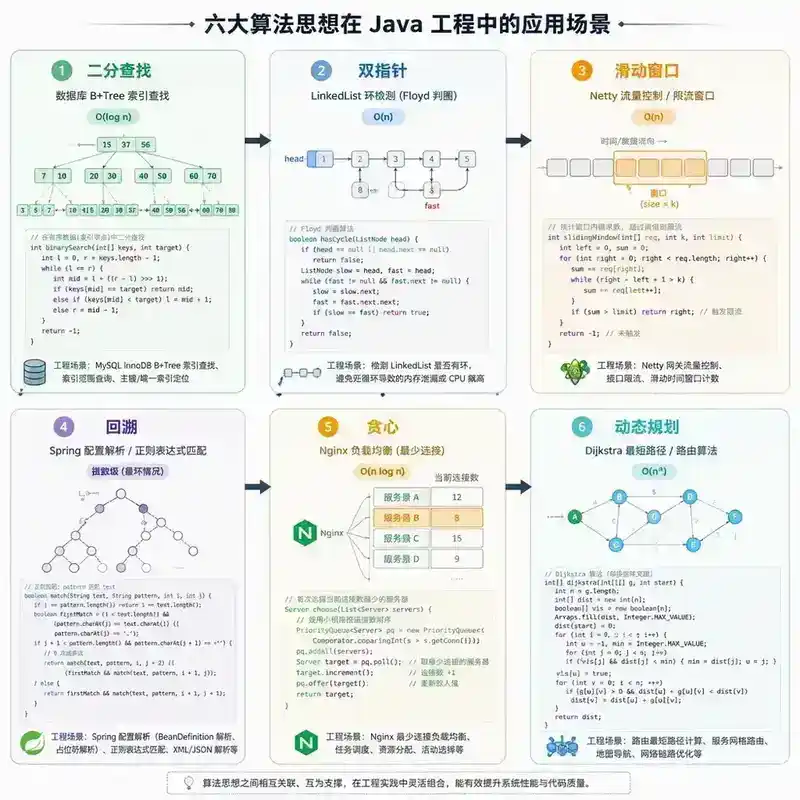
- 二分查找教你"缩小搜索空间"——从 O(n) 到 O(log n) 的质变
- 双指针教你"协同移动"——用两个游标消除嵌套循环
- 滑动窗口教你"动态维护区间"——毛毛虫式的伸缩策略
- 回溯教你"系统穷举+智能剪枝"——在指数空间中找可行解
- 贪心教你"局部最优的勇气"——前提是你能证明它全局最优
- 动态规划教你"记忆化与最优子结构"——用空间换时间的终极武器
面试中,思路比代码更重要。拿到一道题,不要急着写代码,先问自己三个问题:
- 这道题的数据特征是什么?(有序?连续?重叠?)
- 我要求的是最值、方案数、还是任意可行解?
- 有没有更简单的方法?(能用贪心就不用 DP,能用双指针就不用回溯)
刷题的本质不是刷题,而是刷思想。 每一道题都是对你"算法思想→问题映射"能力的一次训练。当你不需要想"这题怎么做",而是能直接判断"这该用滑动窗口解决"时,你就真正掌握了算法思想。
🔍 面试官视角:高频追问
Q1:二分查找中,为什么推荐用**left + (right - left) // 2**而不是**(left + right) // 2**?什么场景下这个问题会真实发生?
点击展开答案
在 Java 中,int 最大值是 2,147,483,647。当 left 和 right 都接近这个值时,left + right 会溢出变成负数,导致 // 2 后得到错误结果。left + (right - left) // 2 不会溢出因为 right - left 始终在 int 范围内。
这在处理超大规模数组(如文件偏移量、内存映射)时真实发生。虽然日常开发很少遇到,但这是面试中考察候选人"是否真正理解底层原理"的经典问题。
Q2:给你一个长度为 n 的未排序数组,请找出第 k 大的元素,要求 O(n) 平均时间复杂度。你会怎么做?这和二分思想有什么关系?
点击展开答案
使用快速选择算法(QuickSelect),基于快排的 partition 思想。每次 partition 后,pivot 的位置就确定了。如果 pivot 的最终位置正好是 n-k(第 k 大),则直接返回;如果 pivot 位置 < n-k,在右半部分继续找;否则在左半部分找。
这和二分思想的关系是:每次 partition 排除一半的搜索空间,本质上也是"通过一次操作排除一半候选"。区别在于二分要求数据有序,QuickSelect 通过 partition 等价地实现了"有序"——pivot 左边的都比它小,右边的都比它大。
Q3:滑动窗口和双指针有什么本质区别?什么时候滑动窗口退化成了普通双指针?
点击展开答案
滑动窗口是双指针的子集,但有一个关键区别:滑动窗口的 right 指针只向右移动(不回退),left 指针也只向右移动。而普通双指针(如对撞指针)的 left 和 right 可以朝相反方向移动。
滑动窗口退化为普通双指针的情况:当窗口条件不满足时,left 需要向右移动超过 right 的位置(即窗口无效),此时窗口的"连续性"约束被打破。这也解释了为什么滑动窗口只适用于"连续子数组/子串"问题——如果子序列可以不连续,窗口模型就不成立。
Q4:回溯和 DFS 是一回事吗?为什么很多人把回溯和 DFS 混为一谈?
点击展开答案
不是一回事,但 DFS 是回溯的实现方式。
- **DFS(深度优先搜索)**是一种图/树的遍历算法,关注的是"如何遍历所有节点"。
- 回溯是一种算法思想,关注的是"在搜索过程中如何通过剪枝避免无效搜索"。
回溯通常用 DFS 实现,但 DFS 不一定是回溯。例如,二叉树的先序遍历是 DFS,但不是回溯(因为没有"做选择→撤销选择"的过程)。
回溯的核心特征是选择→递归→撤销的范式,这是 DFS 不具备的。很多人混为一谈是因为大多数回溯问题确实用 DFS 递归实现,但二者在概念上是不同层面的东西——DFS 是工具,回溯是思想。
Q5:动态规划和贪心的本质区别是什么?能不能说"贪心是 DP 的一种特殊情况"?
点击展开答案
可以这么理解,但需要附加条件。 贪心是 DP 在所有选择中只保留"当前看起来最优"的那一个选择的情况。
从状态转移方程看:
- DP:
dp[i] = max(dp[i-1], dp[i-2] + v[i], ...)—— 枚举所有可能的选择 - 贪心:
dp[i] = greedy_choice(dp[i-1])—— 只保留一个选择
贪心成立的条件是"贪心选择性质":局部最优直接推出全局最优,不需要枚举。这需要数学证明,不是所有 DP 问题都能贪心。
反例:0-1 背包不能贪心(需要枚举选/不选),但分数背包可以贪心(按单位价值排序,每次都选最贵的)。
Q6:给你一个系统设计问题,而不是算法题——如何判断一个工程问题是否适合用动态规划解决?
点击展开答案
工程中判断是否适合 DP 的关键信号:
- 问题可以分解为阶段:例如,一个订单处理流程分为"下单→支付→发货→签收",每个阶段的状态只依赖于前一阶段
- 子问题会重复遇到:例如,在路由计算中,从 A 到 C 的最短路径可能被从 A 到 D 的路径计算中重复使用(Dijkstra 本质就是 DP)
- 状态空间可控:DP 的复杂度 = 状态数 × 每个状态的决策数。如果状态空间过大(如 NP-hard 问题),DP 不可行
- 工程 DP 的典型应用:
- 编辑距离(diff 工具、拼写检查)
- Viterbi 算法(HMM 解码、语音识别)
- 动态时间规整 DTW(时间序列匹配)
- 路由协议(OSPF 的 Dijkstra、BGP 的路径向量)
- 编译器中的寄存器分配(图着色 DP 近似)
- 工程中 DP 的代价:DP 通常需要 O(n²) 或 O(n*k) 的空间,在大数据场景下需要空间优化(如滚动数组),甚至降级为贪心+启发式。
下一篇预告:246|单元测试与可测试性设计——测试金字塔、Mock、契约和覆盖率质量