考点 242|Java 技术专家面试高频考点 阅读时间:约 45 分钟 关键词:链表、栈、队列、堆、时间复杂度、PriorityQueue、LinkedList、Deque
一、引言:为什么这四个数据结构是面试必考题
如果你去翻任何一家大厂的 Java 后端面试题库,链表、栈、队列、堆这四种数据结构几乎从不缺席。它们不是最复杂的数据结构——比起红黑树、B+Tree 或者跳表,它们甚至称得上"简单"。但正是这种"简单"让它们成为面试官最偏爱的考题:代码量不大,却能精准考察候选人对指针操作、边界条件、时间复杂度和工程场景的深度理解。
更关键的是,这四种结构构成了现代软件系统的"骨架":
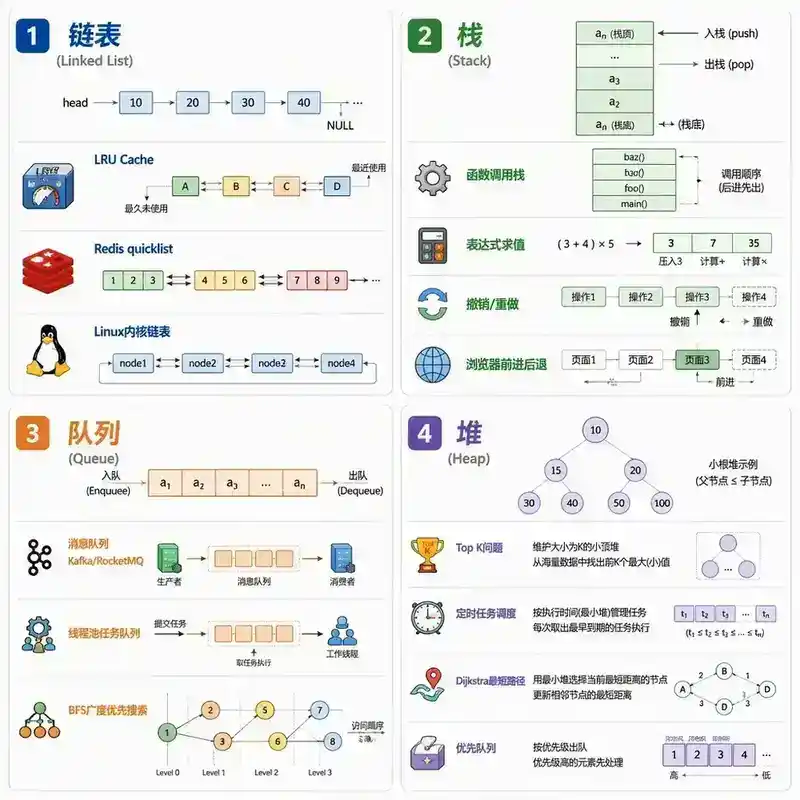
- 链表是 Redis 的
quicklist、Linux 内核的进程调度队列、JVM 的 free list 的底层 - 栈支撑了方法调用、表达式求值、浏览器的前进后退、编译器的语法解析
- 队列是消息中间件的核心模型、线程池的工作队列、BFS 算法的执行引擎
- 堆是优先队列的标配实现、Top K 问题的标准解法、定时任务调度器的底层
本文不会把每个数据结构的 API 重新列一遍——那些看文档就够了。我们聚焦于原理、复杂度、源码、工程实践和面试陷阱。
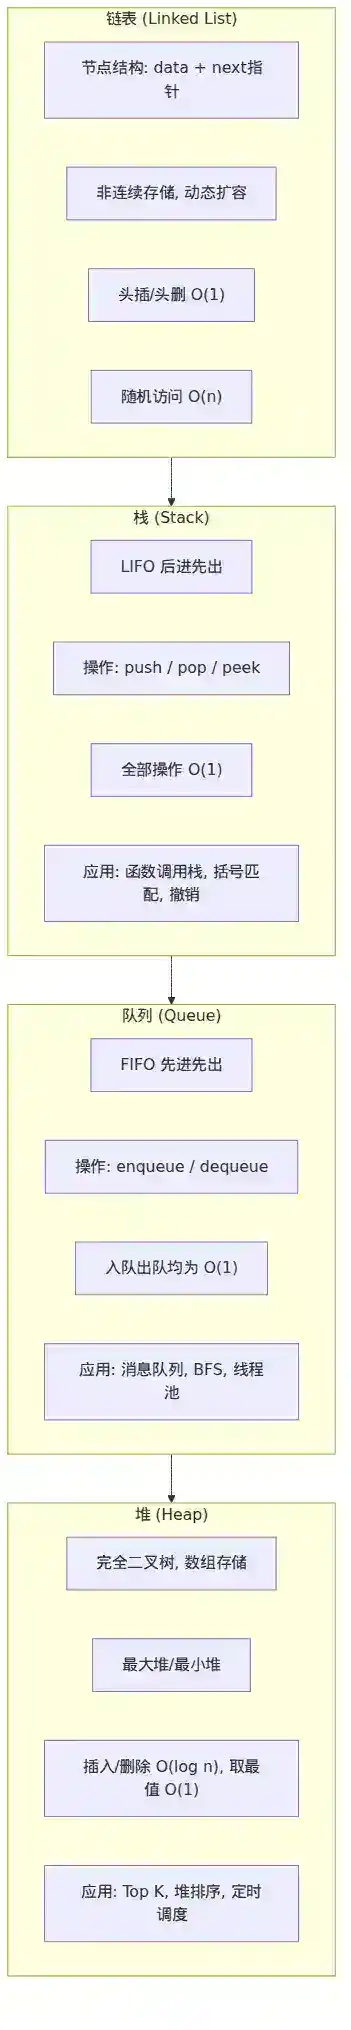
四种基础数据结构总览
二、链表(Linked List)
2.1 核心结构
链表由一系列节点(Node)组成,每个节点包含数据域和指向下一个节点的指针(引用)。
单向链表:[data|next] → [data|next] → [data|next] → null
双向链表:null ← [prev|data|next] ↔ [prev|data|next] ↔ [prev|data|next] → null
关键性质:
- 非连续存储:节点在内存中可以不连续,通过指针串联
- 动态扩容:不需要像数组那样预分配和扩容
- O(1) 头插/头删:只需修改头指针
- O(n) 随机访问:必须从头遍历
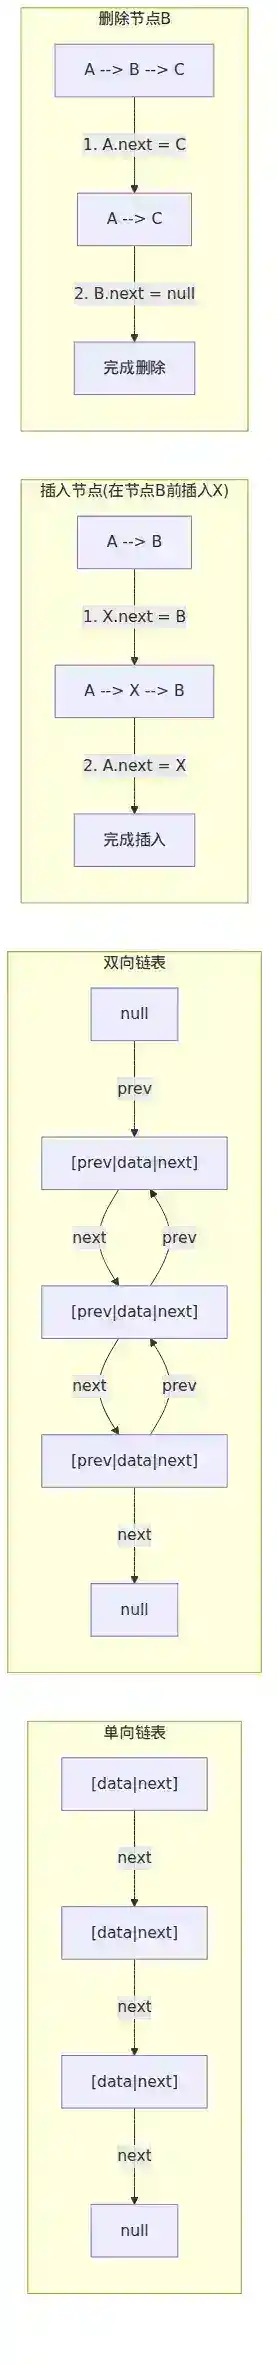
链表节点结构与插入删除操作
2.2 典型操作与复杂度
| 操作 | 单向链表 | 双向链表 | 说明 |
|---|---|---|---|
| 头插/头删 | O(1) | O(1) | 修改 head 指针 |
| 尾插(无尾指针) | O(n) | O(1) | 双向链表有 tail 指针 |
| 尾删 | O(n) | O(1) | 单向链表需找到前驱 |
| 按索引查找 | O(n) | O(n) | 必须遍历 |
| 按值查找 | O(n) | O(n) | 最坏情况扫描全部 |
| 指定位置插入 | O(n) | O(n) | 查找耗时 O(n),插入本身 O(1) |
| 指定位置删除 | O(n) | O(n) | 同上 |
重点:链表的插入/删除本身是 O(1),但前提是你已经拿到了目标位置的前驱节点。面试中常说的"链表插入 O(1)"指的是指针操作本身,不包括查找定位的时间。
2.3 Java 中的 LinkedList 源码要点
Java 的 LinkedList 是一个双向链表,同时实现了 List 和 Deque 接口。
// LinkedList 内部节点结构(简化)
private static class Node<E> {
    E item;
    Node<E> next;
    Node<E> prev;
    Node(Node<E> prev, E element, Node<E> next) {
        this.item = element;
        this.next = next;
        this.prev = prev;
    }
}
关键源码细节:
(1)头插——linkFirst
private void linkFirst(E e) {
    final Node<E> f = first;
    final Node<E> newNode = new Node<>(null, e, f);
    first = newNode;
    if (f == null)
        last = newNode;  // 链表原为空,头尾指向同一节点
    else
        f.prev = newNode;
    size++;
    modCount++;
}
(2)按索引访问——node(int index)
Node<E> node(int index) {
    // 折半遍历:判断 index 靠近头还是尾
    if (index < (size >> 1)) {
        Node<E> x = first;
        for (int i = 0; i < index; i++)
            x = x.next;
        return x;
    } else {
        Node<E> x = last;
        for (int i = size - 1; i > index; i--)
            x = x.prev;
        return x;
    }
}
这个优化很精妙:既然双向链表可以从两端遍历,那就根据 index 离哪端更近来决定遍历方向。虽然还是 O(n),但常数因子减半。
(3)为什么 LinkedList 的随机访问比 ArrayList 慢?
ArrayList 的 get(index) 是 O(1) 的数组下标访问。LinkedList 的 get(index) 是 O(n) 的遍历。在 10 万级别的列表中,性能差距可达 100 倍以上。面试高频考点:ArrayList 和 LinkedList 的选型依据。
2.4 经典面试题:链表反转
public ListNode reverseList(ListNode head) {
    ListNode prev = null;
    ListNode curr = head;
    while (curr != null) {
        ListNode nextTemp = curr.next; // 暂存后继
        curr.next = prev;              // 反转指针
        prev = curr;                   // prev 前进
        curr = nextTemp;               // curr 前进
    }
    return prev;
}
时间复杂度 O(n),空间复杂度 O(1)。这里的关键是三个指针的移动顺序——面试中编码时最容易出错的地方。
变体:
- 反转链表的前 N 个节点
- 反转链表的一部分(第 m 到第 n 个节点)
- K 个一组反转链表(LeetCode 25,Hard)
2.5 工程实践
(1)LRU Cache 的链表用法
LinkedHashMap 内部使用双向链表维护插入顺序或访问顺序。LRU 淘汰策略的核心就是:每次访问把节点移到链表尾部,淘汰时从头部移除。
(2)Redis 的 quicklist
Redis 3.2 之后使用 quicklist 替代了 ziplist + linkedlist 的组合。quicklist 是一个由 ziplist 组成的双向链表——每个链表节点是一个压缩列表,兼顾了链表的高效插入删除和压缩列表的内存紧凑性。
(3)Linux 内核链表
Linux 内核的 list_head 是一个精巧的设计:链表节点不包含数据,而是嵌入到数据结构中。通过 container_of 宏从链表节点反推出包含它的结构体地址。这种"侵入式链表"避免了额外的内存分配。
三、栈(Stack)
3.1 核心概念
栈是一种**后进先出(LIFO, Last In First Out)**的线性数据结构。操作被限制在栈顶:
- push:将元素压入栈顶
- pop:弹出栈顶元素
- peek/top:查看栈顶元素但不弹出
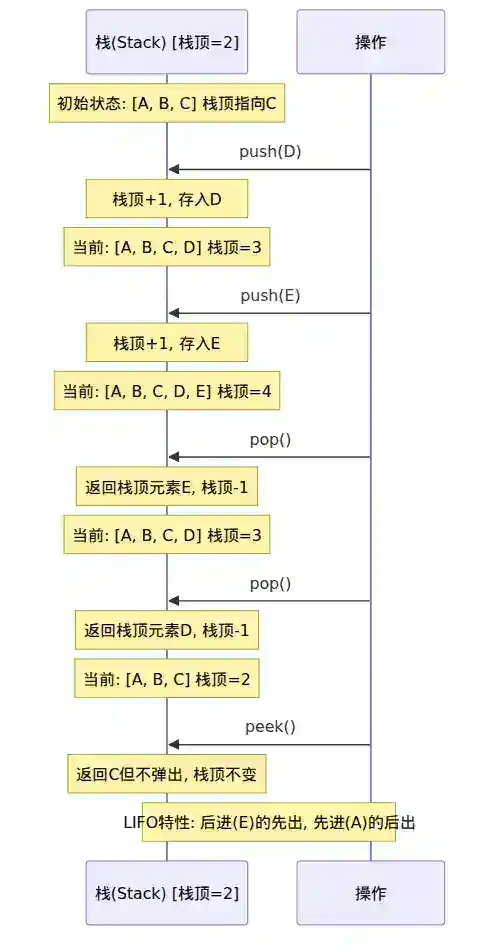
栈的压栈与弹栈操作流程
3.2 复杂度
| 操作 | 时间复杂度 | 说明 |
|---|---|---|
| push | O(1) | 均摊(数组实现需考虑扩容) |
| pop | O(1) | |
| peek | O(1) | |
| search | O(n) | 需要遍历查找 |
3.3 Java 中的栈实现
Java 提供了三种栈的实现方式:
(1)Stack 类(不推荐)
Stack<Integer> stack = new Stack<>(); // 继承自 Vector,线程安全但性能差
Stack 继承 Vector,所有方法都用 synchronized 修饰,性能差。Java 官方文档推荐使用 Deque 代替。
(2)ArrayDeque(推荐)
Deque<Integer> stack = new ArrayDeque<>();
stack.push(1);  // 压栈
stack.pop();    // 弹栈
stack.peek();   // 查看栈顶
ArrayDeque 基于循环数组实现,无容量限制(自动扩容),性能优于 Stack。
(3)LinkedList
Deque<Integer> stack = new LinkedList<>();
链表实现,没有扩容开销,但内存占用更大。
3.4 经典应用
(1)函数调用栈
JVM 为每个线程分配一个虚拟机栈,每个方法调用会创建一个栈帧(Stack Frame),包含局部变量表、操作数栈、动态链接和返回地址。方法调用时压栈,返回时弹栈。递归过深导致 StackOverflowError 就是因为栈帧超出了栈容量。
(2)表达式求值
中缀表达式 3 + 4 * 2 / (1 - 5) 的求值需要两个栈:
- 操作数栈:存放数字
- 运算符栈:存放运算符,按优先级处理
// 简化版:基本计算器
public int calculate(String s) {
    Deque<Integer> stack = new ArrayDeque<>();
    int num = 0;
    char sign = '+';
    for (int i = 0; i < s.length(); i++) {
        char c = s.charAt(i);
        if (Character.isDigit(c)) {
            num = num * 10 + (c - '0');
        }
        if ((!Character.isDigit(c) && c != ' ') || i == s.length() - 1) {
            if (sign == '+') stack.push(num);
            if (sign == '-') stack.push(-num);
            if (sign == '*') stack.push(stack.pop() * num);
            if (sign == '/') stack.push(stack.pop() / num);
            sign = c;
            num = 0;
        }
    }
    int result = 0;
    for (int n : stack) result += n;
    return result;
}
(3)括号匹配
public boolean isValid(String s) {
    Deque<Character> stack = new ArrayDeque<>();
    for (char c : s.toCharArray()) {
        if (c == '(') stack.push(')');
        else if (c == '[') stack.push(']');
        else if (c == '{') stack.push('}');
        else if (stack.isEmpty() || stack.pop() != c) return false;
    }
    return stack.isEmpty();
}
(4)单调栈
单调栈是栈的高级应用,栈内元素保持单调递增或递减。典型问题:
- 每日温度(LeetCode 739):找出下一个更高温度出现在几天后
- 柱状图中的最大矩形(LeetCode 84,Hard)
- 接雨水(LeetCode 42,Hard)
// 每日温度——单调递减栈

public int[ ] dailyTemperatures(int[ ] T) {


    int[ ] result = new int[T.length];

    Deque<Integer> stack = new ArrayDeque<>(); // 存下标,栈内温度递减
    for (int i = 0; i < T.length; i++) {
        while (!stack.isEmpty() && T[i] > T[stack.peek()]) {
            int prev = stack.pop();
            result[prev] = i - prev;
        }
        stack.push(i);
    }
    return result;
}
3.5 工程实践
- Undo/Redo:编辑器的撤销和重做用两个栈实现
- 浏览器的前进/后退:两个栈分别记录后退历史和前进历史
- JVM 操作数栈:字节码指令在操作数栈上执行,如
iload、iadd、istore - 递归转迭代:任何递归都可以用显式栈转化为迭代
四、队列(Queue)
4.1 核心概念
队列是一种**先进先出(FIFO, First In First Out)**的线性数据结构。元素从队尾(rear)入队,从队头(front)出队。
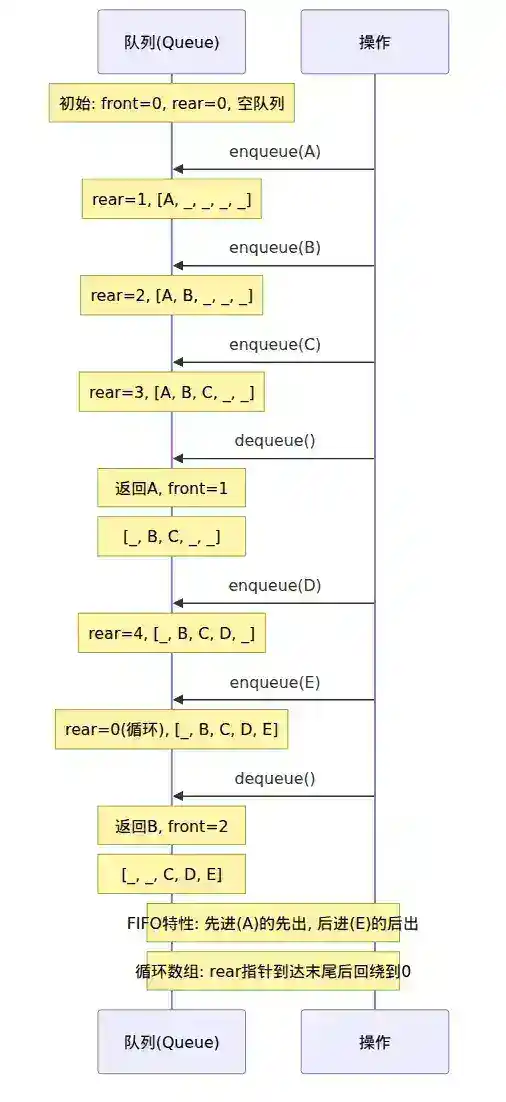
队列的入队与出队操作流程
4.2 复杂度
| 操作 | 数组实现 | 链表实现 |
|---|---|---|
| enqueue(入队) | O(1) 均摊 | O(1) |
| dequeue(出队) | O(1) | O(1) |
| peek(查看队头) | O(1) | O(1) |
| search | O(n) | O(n) |
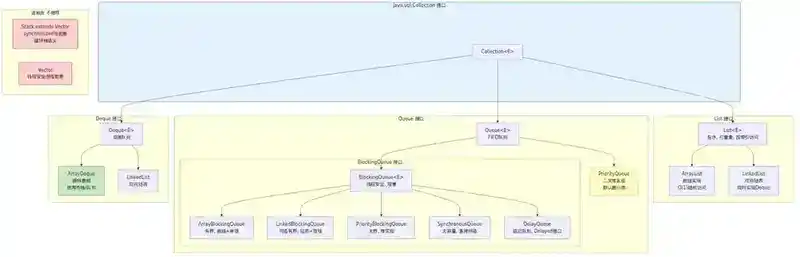
4.3 Java 中的队列体系
Java 的队列类型非常丰富:
Queue 接口
├── LinkedList(双向链表,同时实现 List 和 Deque)
├── ArrayDeque(循环数组,推荐)
├── PriorityQueue(二叉堆实现,非 FIFO)
└── BlockingQueue(阻塞队列,线程安全)
    ├── ArrayBlockingQueue(有界,数组 + 单锁)
    ├── LinkedBlockingQueue(可选有界,链表 + 双锁)
    ├── PriorityBlockingQueue(无界,堆实现)
    ├── SynchronousQueue(无容量,直接传递)
    └── DelayQueue(延迟队列,元素需实现 Delayed 接口)
Java集合框架中相关类体系图
4.4 循环队列与 ArrayDeque
ArrayDeque 是 Java 中最推荐的队列实现。它使用循环数组,头尾指针在数组中循环移动,避免了数组实现的"假溢出"问题。
// ArrayDeque 核心字段(简化)
public class ArrayDeque<E> {

    transient Object[ ] elements; // 底层数组,容量始终为 2 的幂

    transient int head;          // 头指针
    transient int tail;          // 尾指针(指向下一个可插入位置)

    // 入队到尾部
    public boolean offerLast(E e) {
        addLast(e);
        return true;
    }

    // 扩容:容量翻倍
    private void doubleCapacity() {
        int p = head;
        int n = elements.length;
        int r = n - p; // head 右侧元素数
        int newCapacity = n << 1;

        Object[ ] a = new Object[newCapacity];

        System.arraycopy(elements, p, a, 0, r);    // 复制 head 到末尾
        System.arraycopy(elements, 0, a, r, p);    // 复制 0 到 head-1
        elements = a;
        head = 0;
        tail = n;
    }
}
关键设计点:
- 容量始终为 2 的幂,用位运算
(tail + 1) & (elements.length - 1)代替取模 - 不允许 null 元素(用于区分空和已删除)
- 扩容时重新排列为连续存储
4.5 阻塞队列与线程池
Java 线程池的核心就是工作队列:
// ThreadPoolExecutor 构造函数
public ThreadPoolExecutor(
    int corePoolSize,
    int maximumPoolSize,
    long keepAliveTime,
    TimeUnit unit,
    BlockingQueue<Runnable> workQueue,  // ← 核心:任务队列
    ThreadFactory threadFactory,
    RejectedExecutionHandler handler
)
线程池的任务提交流程:
- 线程数 < corePoolSize → 创建新线程
- 线程数 ≥ corePoolSize → 任务入队
- 队列满 & 线程数 < maximumPoolSize → 创建新线程
- 队列满 & 线程数 = maximumPoolSize → 执行拒绝策略
关键面试题:为什么核心线程满了要先入队而不是直接创建新线程?
答:这是为了缓冲突发流量。如果核心线程满了就立即创建新线程,在流量洪峰中会瞬间创建大量线程导致系统资源耗尽。先入队是一种"削峰"策略,队列起到了流量整形的作用。
4.6 工程应用
- 消息队列:Kafka、RocketMQ、RabbitMQ 的核心模型都是队列
- BFS(广度优先搜索):树的层序遍历、图的最短路径
- Disruptor 环形队列:高性能无锁队列,LMAX 交易系统使用
- 滑动窗口:用队列维护窗口内的元素集合
五、堆(Heap)
5.1 核心概念
堆是一种特殊的完全二叉树,满足堆性质:
- 最大堆(Max-Heap):每个节点的值 ≥ 其子节点的值。根节点是最大值。
- 最小堆(Min-Heap):每个节点的值 ≤ 其子节点的值。根节点是最小值。
堆通常用数组实现,利用完全二叉树的性质简化索引计算:
对于索引 i 的节点:
- 父节点索引:(i - 1) / 2
- 左子节点索引:2 * i + 1
- 右子节点索引:2 * i + 2
5.2 核心操作与复杂度
| 操作 | 时间复杂度 | 说明 |
|---|---|---|
| peek(查看堆顶) | O(1) | 直接返回 array[0] |
| offer(插入) | O(log n) | 尾部插入 + 上浮(siftUp) |
| poll(删除堆顶) | O(log n) | 用尾部元素替换堆顶 + 下沉(siftDown) |
| heapify(建堆) | O(n) | 从最后一个非叶节点开始依次下沉 |
| remove(删除任意元素) | O(log n) | 需要先找到元素位置 |
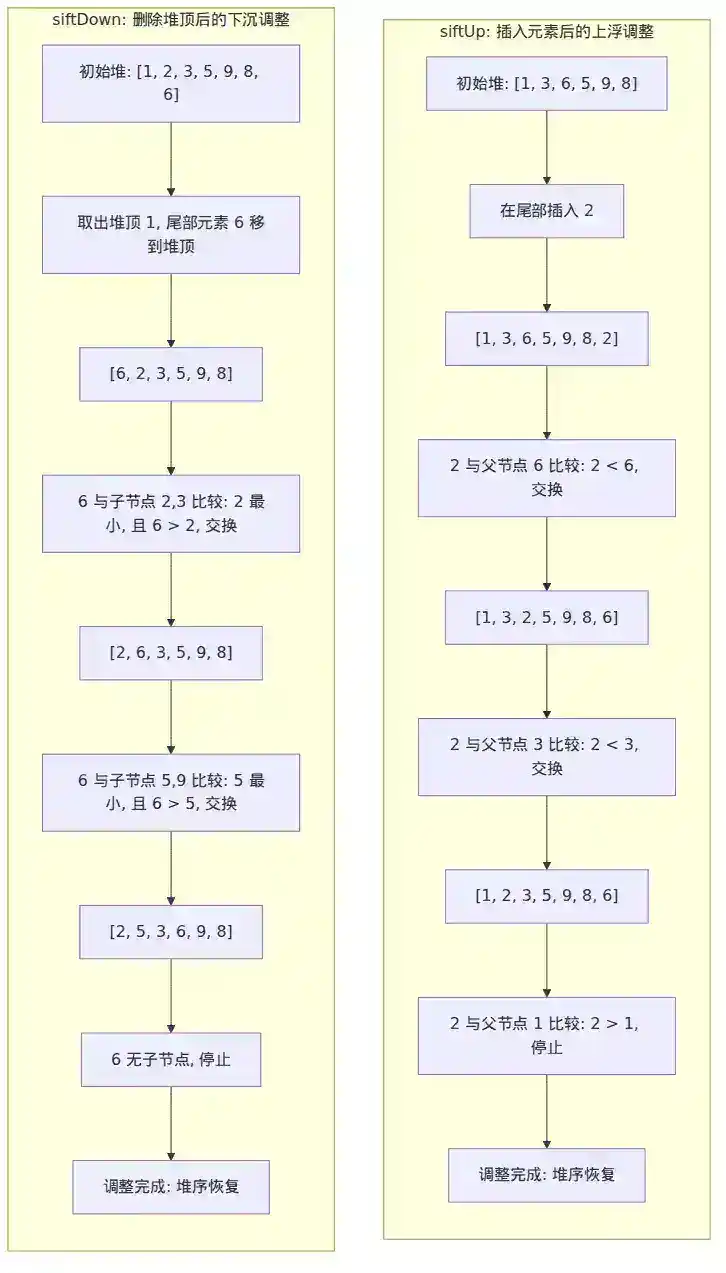
重点:建堆的时间复杂度是 O(n),不是 O(n log n)。
虽然直观上每个元素插入需要 O(log n),n 个元素就是 O(n log n),但自底向上的 heapify 算法更高效:
- 最后一层(n/2 个节点)不需要下沉
- 倒数第二层(n/4 个节点)最多下沉 1 层
- 倒数第三层(n/8 个节点)最多下沉 2 层
- ...
总操作次数:0 × n/2 + 1 × n/4 + 2 × n/8 + ... = n × Σ(i/2^(i+1)) < n
这是一个经典的面试考点:"堆排序的时间复杂度是多少?建堆 O(n) + n 次删除 O(n log n) = O(n log n)"。
二叉堆的上浮与下沉调整过程
5.3 Java 中的 PriorityQueue
PriorityQueue 是 Java 标准库的堆实现,默认是最小堆:
// 默认最小堆
PriorityQueue<Integer> minHeap = new PriorityQueue<>();

// 最大堆:传入比较器
PriorityQueue<Integer> maxHeap = new PriorityQueue<>(Collections.reverseOrder());
// 或者
PriorityQueue<Integer> maxHeap = new PriorityQueue<>((a, b) -> b - a);
源码要点——siftUp(上浮):
private void siftUpComparable(int k, E x) {
    Comparable<? super E> key = (Comparable<? super E>) x;
    while (k > 0) {
        int parent = (k - 1) >>> 1;  // 父节点索引
        Object e = queue[parent];
        if (key.compareTo((E) e) >= 0)  // 已满足堆序,停止
            break;
        queue[k] = e;   // 父节点下沉
        k = parent;
    }
    queue[k] = key;
}
源码要点——siftDown(下沉):
private void siftDownComparable(int k, E x) {
    Comparable<? super E> key = (Comparable<? super E>) x;
    int half = size >>> 1;  // 非叶节点范围
    while (k < half) {
        int child = (k << 1) + 1; // 左子节点
        Object c = queue[child];
        int right = child + 1;
        if (right < size &&
            ((Comparable<? super E>) c).compareTo((E) queue[right]) > 0)
            c = queue[child = right];  // 选较小的子节点
        if (key.compareTo((E) c) <= 0)  // 已满足堆序
            break;
        queue[k] = c;  // 子节点上浮
        k = child;
    }
    queue[k] = key;
}
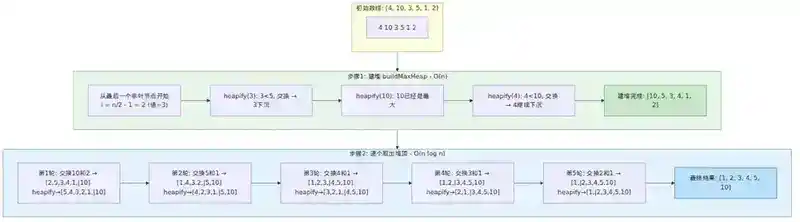
5.4 堆排序(HeapSort)
堆排序是不稳定排序,时间复杂度 O(n log n),空间复杂度 O(1)(原地排序)。
public void heapSort(int[ ] arr) {

    int n = arr.length;
    // 1. 建最大堆:O(n)
    for (int i = n / 2 - 1; i >= 0; i--)
        heapify(arr, n, i);
    // 2. 逐个取出堆顶(最大值)放到末尾:O(n log n)
    for (int i = n - 1; i > 0; i--) {
        swap(arr, 0, i);      // 堆顶(最大值)交换到末尾
        heapify(arr, i, 0);   // 调整剩余元素为堆
    }
}


private void heapify(int[ ] arr, int heapSize, int i) {

    int largest = i;
    int left = 2 * i + 1;
    int right = 2 * i + 2;
    if (left < heapSize && arr[left] > arr[largest]) largest = left;
    if (right < heapSize && arr[right] > arr[largest]) largest = right;
    if (largest != i) {
        swap(arr, i, largest);
        heapify(arr, heapSize, largest);
    }
}
堆排序完整过程演示
5.5 经典应用
(1)Top K 问题
这是堆最经典的面试应用。对于 Top K 问题,选最大堆还是最小堆取决于需求:
- Top K 最大:用大小为 K 的最小堆。遍历数组,维护堆中始终是当前最大的 K 个元素。堆顶(最小值)就是第 K 大的元素。时间复杂度 O(n log K)。
- Top K 最小:用大小为 K 的最大堆。
// 找数组中第 K 大的元素

public int findKthLargest(int[ ] nums, int k) {

    PriorityQueue<Integer> heap = new PriorityQueue<>(); // 最小堆
    for (int num : nums) {
        heap.offer(num);
        if (heap.size() > k) {
            heap.poll(); // 弹出最小的,保持堆大小为 K
        }
    }
    return heap.peek(); // 堆顶就是第 K 大
}
关键面试追问:为什么不用最大堆而用最小堆?
答:如果用最大堆存所有元素,空间 O(n),每次 poll 弹出最大值,需要弹出 K 次,总时间 O(n + K log n)。而最小堆只需维护 K 个元素,空间 O(K),时间 O(n log K)。当 K << n 时,后者优势明显。
(2)合并 K 个有序链表
public ListNode mergeKLists(ListNode[ ] lists) {

    PriorityQueue<ListNode> heap = new PriorityQueue<>((a, b) -> a.val - b.val);
    for (ListNode head : lists) {
        if (head != null) heap.offer(head);
    }
    ListNode dummy = new ListNode(0);
    ListNode curr = dummy;
    while (!heap.isEmpty()) {
        ListNode node = heap.poll();
        curr.next = node;
        curr = curr.next;
        if (node.next != null) heap.offer(node.next);
    }
    return dummy.next;
}
时间复杂度 O(N log K),N 为总节点数,K 为链表数。
(3)定时任务调度
Java 的 ScheduledThreadPoolExecutor 内部使用 DelayedWorkQueue,底层是一个基于堆的优先队列,按任务的下次执行时间排序。每次从堆顶取出最近要执行的任务。
(4)Dijkstra 最短路径
在 Dijkstra 算法中,使用最小堆(优先队列)维护"当前距离最小的未处理节点",每次从堆顶取出距离最小的节点进行松弛操作。
六、数据结构选型对比
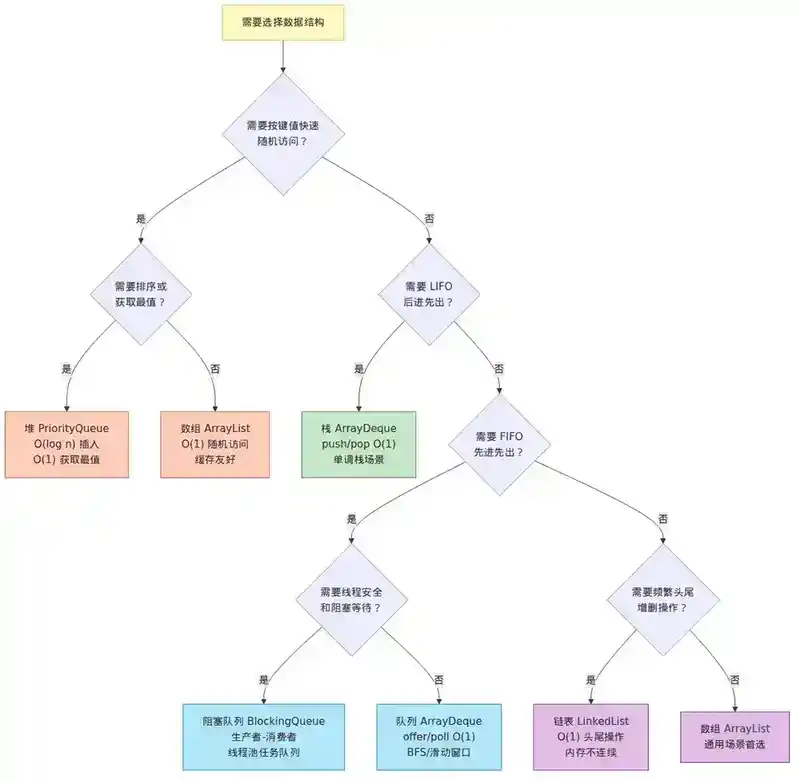
数据结构选型决策流程图
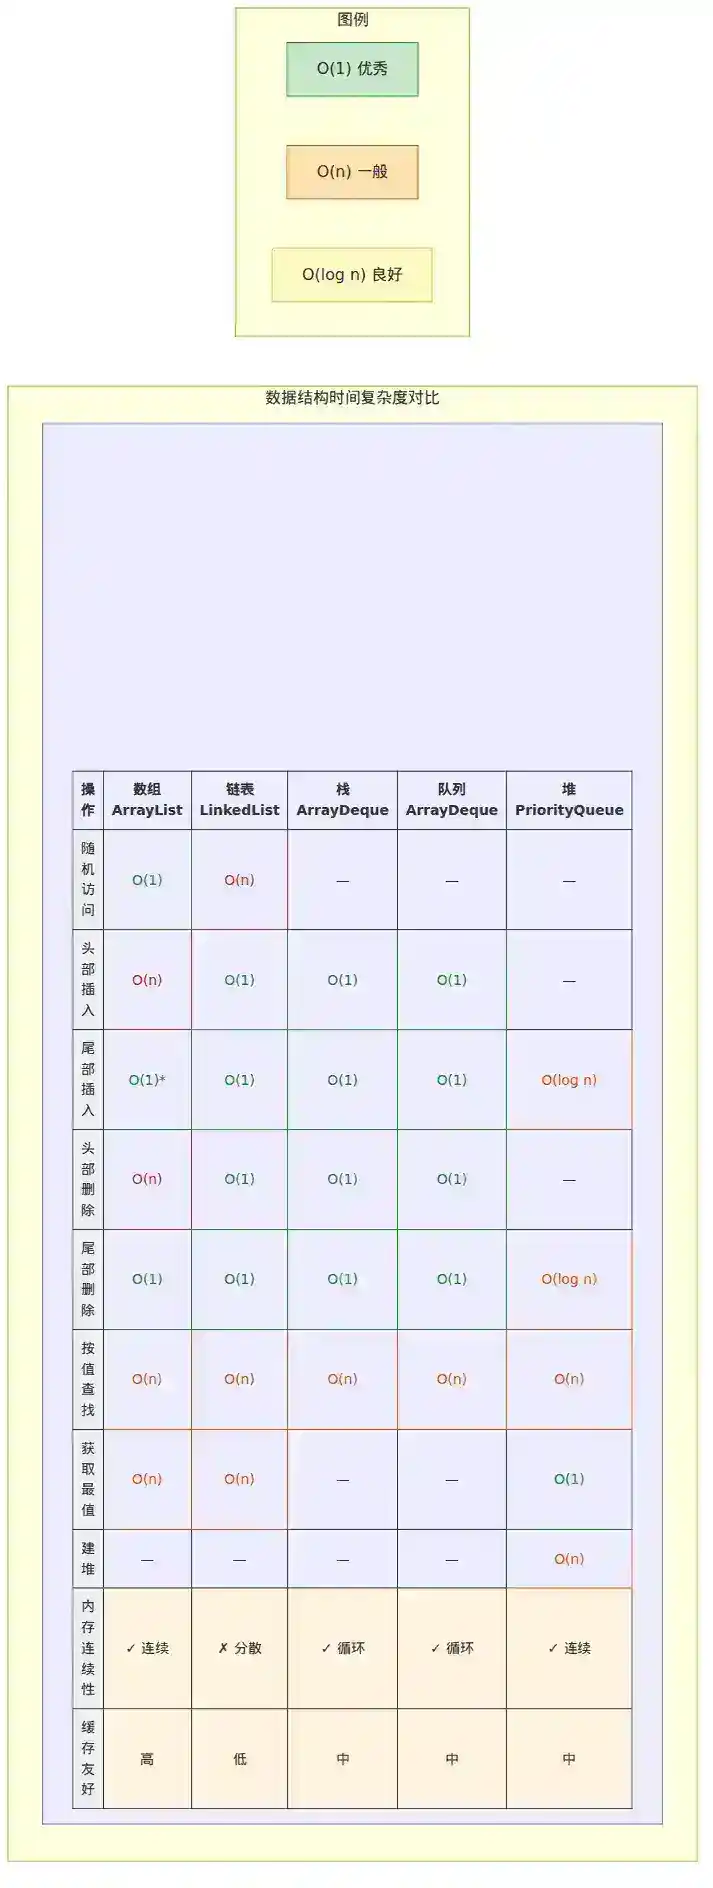
6.1 复杂度速查表
| 操作 | 数组 (ArrayList) | 链表 (LinkedList) | 栈 (ArrayDeque) | 队列 (ArrayDeque) | 堆 (PriorityQueue) |
|---|---|---|---|---|---|
| 随机访问 | O(1) | O(n) | — | — | — |
| 头插/头删 | O(n) | O(1) | O(1) | O(1) | — |
| 尾插/尾删 | O(1)* | O(1) | O(1) | O(1) | O(log n) |
| 查找 | O(n) | O(n) | O(n) | O(n) | O(n) |
| 获取最值 | O(n) | O(n) | — | — | O(1) |
| 内存连续性 | 是 | 否 | 是(循环) | 是(循环) | 是 |
| 缓存友好 | 高 | 低 | 中 | 中 | 中 |
* 数组尾插 O(1) 是均摊复杂度,扩容时单次为 O(n)
各数据结构时间复杂度对比表
6.2 选型建议
| 场景 | 推荐结构 | 理由 |
|---|---|---|
| 频繁随机访问 | ArrayList | O(1) 下标访问 |
| 频繁头尾增删 | LinkedList 或 ArrayDeque | O(1) 操作 |
| 需要 LIFO 语义 | ArrayDeque(作栈) | 比 Stack 快,无锁开销 |
| 需要 FIFO 语义 | ArrayDeque(作队列) | 比 LinkedList 内存效率高 |
| 需要获取最值 | PriorityQueue | O(1) 获取,O(log n) 插入 |
| 生产者-消费者 | BlockingQueue | 线程安全,支持阻塞等待 |
| 需要排序输出 | PriorityQueue | 按优先级出队 |
| 前缀/后缀处理 | ArrayDeque(作栈) | 单调栈等场景 |
七、常见面试陷阱与误区
7.1 链表陷阱
陷阱 1:空指针
// 错误:没有检查 head 是否为空
ListNode curr = head;
while (curr.next != null) { // 如果 head 为 null,NPE
    curr = curr.next;
}
陷阱 2:丢失引用
// 错误:先断了 next 再移动,丢失了后续节点
curr.next = prev;
curr = curr.next; // curr.next 已经被改了!
陷阱 3:头节点特殊处理 链表操作经常需要区分"头节点"和"其他节点",引入**哨兵节点(dummy node)**可以统一处理逻辑。
7.2 栈与队列陷阱
陷阱:Java 中 Stack 的继承问题
Stack<Integer> stack = new Stack<>();
stack.add(0, 1); // 合法!因为 Stack 继承 Vector,但破坏了栈的语义
永远用 Deque 代替 Stack。
7.3 堆陷阱
陷阱 1:PriorityQueue 的遍历顺序
PriorityQueue<Integer> pq = new PriorityQueue<>();
pq.offer(3); pq.offer(1); pq.offer(2);
for (int x : pq) System.out.print(x); // 输出:1 3 2(不是排序顺序!)
PriorityQueue 的迭代器不保证任何顺序。只有 poll() 才能按优先级出队。
陷阱 2:自定义对象的比较器一致性
// 错误:比较器与 equals 不一致
PriorityQueue<Item> pq = new PriorityQueue<>((a, b) -> a.priority - b.priority);
// 如果两个 Item 的 priority 相同但 equals 返回 false,行为不可预测
PriorityQueue 依赖 compareTo 或 Comparator 排序,与 equals 无关。但规范建议两者保持一致。
陷阱 3:堆中修改元素值 Java 的 PriorityQueue 不支持原地修改已入队元素的优先级。如果修改了会影响排序的字段,堆结构会被破坏。正确做法是先 remove 再 offer。
八、总结
链表、栈、队列、堆是数据结构的"四大基石"。它们看似简单,但深挖下去涉及:
- 链表:指针操作、哨兵节点、缓存不友好、与数组的选型权衡
- 栈:LIFO 语义、单调栈、递归转迭代、JVM 方法调用栈
- 队列:FIFO 语义、循环数组、阻塞队列、线程池的任务缓冲
- 堆:完全二叉树、上浮下沉、Top K、堆排序、优先队列
面试中,很少有面试官会直接问"什么是栈",而是通过一个具体的场景来考察你对这些结构的理解深度。比如"设计一个支持 O(1) 获取最小值的栈(Min Stack)"、"用两个栈实现队列"、"数据流中的中位数"——这些题的本质都是对基本数据结构的灵活组合。
真正的技术专家不只会用 API,而是理解每种结构背后的设计权衡,知道在什么场景下选择什么结构,以及为什么。
工程应用场景图示
面试官视角:10 个高频追问
以下问题超越本文内容,站在面试官角度考察你对这些数据结构的深层理解。
Q1:为什么 Java 的 LinkedList 同时实现了 List 和 Deque 接口?这带来了什么设计问题?
Q2:ArrayDeque 为什么不允许存储 null 元素?设计上有什么考量?
Q3:实现一个 O(1) 时间复杂度的 LRU Cache,get 和 put 都需要 O(1)。说说你的数据结构选型和实现思路。
Q4:堆排序为什么是不稳定排序?举一个具体的反例。
Q5:PriorityQueue 的迭代器不保证顺序,但它的 toArray() 方法返回的数组是否有顺序?为什么?
Q6:线程池中,如果核心线程数=0,最大线程数=10,使用 SynchronousQueue 作为工作队列,任务提交流程是怎样的?
Q7:用两个栈实现一个队列,push 和 pop 的均摊时间复杂度是多少?证明你的结论。
Q8:为什么 Redis 的 quicklist 选择用链表连接 ziplist,而不是直接用双向链表?从内存碎片和缓存角度分析。
Q9:给你一个无限长的数据流,设计一个数据结构,能在任意时刻返回当前已见数据的中位数。
Q10:在什么场景下你会选择用数组实现栈而不是链表?从性能、内存、GC 角度分析两种实现的优劣。
本文是 Java 技术专家面试 250 个高频考点系列的第 242 篇。下一篇:243|树结构:二叉树、BST、AVL、红黑树、B/B+Tree 和 Trie。
面试官视角:参考答案
以下是 10 个高频追问的详细参考答案,涵盖数据结构选型、源码分析、算法设计和工程权衡。
Q1:为什么 Java 的 LinkedList 同时实现了 List 和 Deque 接口?这带来了什么设计问题?
Java 的 LinkedList 同时实现 List 和 Deque 接口,这是历史演进和实用主义共同作用的结果。
历史原因: LinkedList 在 Java 1.2 就存在了,最初只实现了 List 接口。Java 6 引入了 Deque 接口(双端队列),而 LinkedList 作为双向链表天然具备双端操作的能力,同时实现 Deque 是顺理成章的——这样无需引入新的类就能获得双端队列的功能。
设计问题 1:接口爆炸与方法冗余。 LinkedList 同时实现 List、Deque、Queue、Collection、Iterable、Cloneable、Serializable 共计 7 个接口。大量方法功能重叠:add(E)(List)、addLast(E)(Deque)、offer(E)(Queue)、offerLast(E)(Deque)实际上做的是同一件事,增加了 API 的学习成本和误用风险。
设计问题 2:语义冲突。 List 接口通过索引(index)访问元素,get(int index) 是 O(n) 的操作。但 List 接口的约定暗示随机访问是高效的(否则 ArrayList 为什么叫 List?)。初学者容易写出 for (int i = 0; i < list.size(); i++) list.get(i) 的代码,在 LinkedList 上这是 O(n²) 的灾难。
设计问题 3:违反接口隔离原则(ISP)。 LinkedList 实现了很多它并不擅长的方法。比如 get(int index) 虽然能用,但 O(n) 的性能意味着它不应该被当作"随机访问列表"使用。
设计问题 4:迭代器行为差异。 LinkedList 的 listIterator(int index) 需要先遍历到 index 位置,构造函数是 O(n) 的。而 ArrayList 的相同操作是 O(1) 的。这种性能差异在接口层面是不可见的,违反了"最小惊讶原则"。
现代最佳实践: 用 List 接口声明变量时,实现选 ArrayList(除非明确需要频繁头插/头删);需要双端队列功能时,用 Deque 接口声明,实现选 ArrayDeque(性能更好)或 LinkedList(需要 null 元素时);避免直接用 LinkedList 类型声明变量。
Q2:ArrayDeque 为什么不允许存储 null 元素?设计上有什么考量?
ArrayDeque 不允许 null 元素,这是经过深思熟虑的设计选择:
1. 循环数组的哨兵语义。 ArrayDeque 使用 head 和 tail 两个指针在循环数组中标记队列的起止位置。如果允许 null 元素,就无法通过 elements[head] == null 来判断队列是否为空,需要额外的 size 字段或标记位。
2. poll/peek 的语义区分。deque.poll() 在队列为空时返回 null。如果允许存储 null,那么 poll() 返回 null 时,无法区分是"队列为空"还是"队列中确实有一个 null 元素"。
3. remove 操作的歧义。deque.remove(null) 无法区分是删除第一个 null 元素还是表示"队列为空"。
4. 一致性设计。 Java 集合框架中,大多数高性能集合都禁止 null:ArrayDeque、PriorityQueue(需要比较,null 无法比较)、ConcurrentHashMap(禁止 null key 和 value)、TreeMap/TreeSet(需要比较)。允许 null 的集合(ArrayList、LinkedList、HashMap)往往要付出额外的边界检查代价。
5. 性能考量。 禁止 null 可以消除很多 null 检查分支,简化内部实现逻辑,提高性能。在循环数组的扩容、元素移动等操作中,不需要处理 null 的特殊情况。
结论: 这是一个"用功能换性能和语义清晰性"的设计取舍。对于需要存储 null 元素的场景,可以使用 LinkedList 代替。
Q3:实现一个 O(1) 时间复杂度的 LRU Cache,get 和 put 都需要 O(1)。说说你的数据结构选型和实现思路。
实现 O(1) get 和 O(1) put 的 LRU Cache,需要组合使用双向链表 + 哈希表。
数据结构选型: 哈希表(HashMap)提供 O(1) 的 key→Node 查找;双向链表(Doubly Linked List)维护访问顺序,头尾操作 O(1)。为什么不用单向链表? 因为删除中间节点时,需要修改前驱节点的 next 指针。单向链表需要 O(n) 找到前驱,双向链表通过 prev 指针直接 O(1) 定位。
设计细节: 链表头部(head 侧)存放最近访问的元素,链表尾部(tail 侧)存放最久未访问的元素。使用哨兵节点(dummy head 和 dummy tail)简化边界处理,避免头尾节点的特殊判断。
核心操作:
- get(key):HashMap O(1) 查找节点 → 将该节点移到链表头部 → 返回值
- put(key, value):若 key 已存在,更新值并移到头部;若不存在,创建新节点插入头部。若容量超限,删除尾部节点(最久未使用)及 HashMap 中的映射
class LRUCache {
    class Node {
        int key, value;
        Node prev, next;
        Node(int k, int v) { key = k; value = v; }
    }

    private Map<Integer, Node> map = new HashMap<>();
    private Node head = new Node(0, 0), tail = new Node(0, 0);
    private int capacity;

    public LRUCache(int capacity) {
        this.capacity = capacity;
        head.next = tail;
        tail.prev = head;
    }

    public int get(int key) {
        Node node = map.get(key);
        if (node == null) return -1;
        moveToHead(node);
        return node.value;
    }

    public void put(int key, int value) {
        Node node = map.get(key);
        if (node != null) {
            node.value = value;
            moveToHead(node);
        } else {
            Node newNode = new Node(key, value);
            map.put(key, newNode);
            addToHead(newNode);
            if (map.size() > capacity) {
                Node removed = removeTail();
                map.remove(removed.key);
            }
        }
    }

    private void moveToHead(Node node) {
        removeNode(node);
        addToHead(node);
    }

    private void addToHead(Node node) {
        node.next = head.next;
        node.prev = head;
        head.next.prev = node;
        head.next = node;
    }

    private void removeNode(Node node) {
        node.prev.next = node.next;
        node.next.prev = node.prev;
    }

    private Node removeTail() {
        Node node = tail.prev;
        removeNode(node);
        return node;
    }
}
LinkedHashMap 的简化实现: Java 中可以直接用 LinkedHashMap 实现,accessOrder=true 使 LinkedHashMap 按访问顺序维护元素,removeEldestEntry 在 put 后自动淘汰最老元素。但面试官更希望看到你手写双向链表+哈希表的实现,因为那能真正体现你对数据结构的理解。
Q4:堆排序为什么是不稳定排序?举一个具体的反例。
堆排序是不稳定排序,因为堆的调整过程中,相等元素的相对顺序可能被破坏。
反例: 假设有一个数组 [3a, 2, 3b, 2](3a 和 3b 是两个值相同的元素,用下标区分先后顺序):
建最大堆:[3a, 2, 3b, 2] → 堆满足堆性质。然后堆排序取出过程:
- 交换堆顶 3a 和末尾元素 2:
[2, 2, 3b, 3a],3a 移到了末尾 - 调整堆:
[3b, 2, 2, 3a] - 交换堆顶 3b 和倒数第二个元素 2:
[2, 2, 3b, 3a] - 调整堆:
[2, 2, 3b, 3a] - 最终结果:
[2, 2, 3b, 3a]
在最终结果中,3b 在 3a 前面,但原始数组中 3a 在 3b 前面。相对顺序被颠倒了,因此堆排序是不稳定的。
根本原因: 堆的 siftDown 操作中,当父节点和子节点值相等时,siftDown 选择不交换(或交换),导致相等元素的相对位置无法保证。此外,堆排序第一步的"交换堆顶与末尾元素"操作,会将堆顶元素跨越整个数组放到末尾,这个过程天然会打乱相对顺序。
对比: 归并排序稳定(合并时,左右相等元素优先取左边的);快速排序不稳定(partition 过程中的交换会打乱顺序);堆排序不稳定;插入排序稳定;冒泡排序稳定。
Q5:PriorityQueue 的迭代器不保证顺序,但它的 toArray() 方法返回的数组是否有顺序?为什么?
PriorityQueue 的 toArray() 方法返回的数组也不保证顺序。
原因: PriorityQueue 的 toArray() 方法内部直接调用了 Arrays.copyOf(queue, size),返回的是底层数组的浅拷贝。而 PriorityQueue 的底层数组只是按堆的结构存储(二叉堆的数组表示),并非按优先级排序。
堆的数组存储特征: 以最小堆 [1, 3, 5, 7, 9, 11] 为例,底层数组是 [1, 3, 5, 7, 9, 11]。如果遍历数组,得到的顺序是 1, 3, 5, 7, 9, 11——看起来像是排好序的,但这是巧合。如果插入 2,堆变为 [1, 2, 5, 3, 9, 11, 7],遍历数组得到 1, 2, 5, 3, 9, 11, 7——显然不是排序顺序。
如何获取有序结果? 必须通过不断 poll() 获取,或者使用 Arrays.sort(pq.toArray()) 对拷贝排序。
这个设计是合理的: 堆的目标是高效获取最值(O(log n) 插入/删除,O(1) 查看最值),而不是全排序。如果每次 toArray() 都要排序,那开销是 O(n log n),违背了堆的设计初衷。
Q6:线程池中,如果核心线程数=0,最大线程数=10,使用 SynchronousQueue 作为工作队列,任务提交流程是怎样的?
SynchronousQueue 的特性: SynchronousQueue 是一个没有容量的阻塞队列。它的 put 操作必须等待另一个线程的 take 操作,反之亦然。可以理解为"手递手"传递——生产者直接把任务交给消费者,中间不经过任何缓冲。
任务提交流程(核心线程数=0,最大线程数=10):
- 第一个任务到达 → 当前线程数=0 < corePoolSize=0?不成立 → 尝试入队 → SynchronousQueue.offer() 失败(因为没有等待的消费者线程)→ 创建新线程(线程数→1),该线程执行任务
- 第二个任务到达 → 当前线程数=1 ≥ corePoolSize=0 → 尝试入队 → 失败 → 创建新线程(线程数→2)
- 后续任务同理,直到线程数达到 10(maximumPoolSize)
- 第 11 个任务到达 → 线程池已满 → 尝试入队 → 失败 → 执行拒绝策略(默认 AbortPolicy,抛出 RejectedExecutionException)
关键洞察: 这个配置等价于"每个任务都创建一个新线程,最多 10 个并发任务,超过则拒绝"。实际上等价于一个有界线程池,队列容量为 0。
为什么这样设计? 适合 CPU 密集型任务场景(不需要排队缓冲,CPU 密集型任务本身就会占满 CPU);适合对延迟敏感的场景(任务要么立即执行,要么立即拒绝,不会在队列中等待)。不适合 IO 密集型任务(IO 任务通常需要排队缓冲来削峰)。
vs LinkedBlockingQueue 的区别: LinkedBlockingQueue 下核心线程用完 → 任务入队(队列可能无限累积)→ 队列满才创建新线程到 max;SynchronousQueue 下核心线程用完 → 直接创建新线程到 max → 满了就拒绝,任务永远不会排队等待。
潜在陷阱: 核心线程数=0 时线程池空闲时没有线程存活,当新任务到达时需要创建线程,有冷启动开销。keepAliveTime 决定空闲线程的存活时间,如果任务间隔 > keepAliveTime,每个任务都会触发线程创建和销毁。
Q7:用两个栈实现一个队列,push 和 pop 的均摊时间复杂度是多少?证明你的结论。
用两个栈实现队列,push 的均摊复杂度是 O(1),pop 的均摊复杂度也是 O(1)。
设计思路: stackIn 专门用于 push 操作;stackOut 专门用于 pop 操作。当 stackOut 为空时,将 stackIn 中的所有元素依次弹出并压入 stackOut(反转顺序)。
class MyQueue {
    private Deque<Integer> stackIn = new ArrayDeque<>();
    private Deque<Integer> stackOut = new ArrayDeque<>();

    public void push(int x) {
        stackIn.push(x);  // O(1)
    }

    public int pop() {
        if (stackOut.isEmpty()) {
            while (!stackIn.isEmpty()) {
                stackOut.push(stackIn.pop());
            }
        }
        return stackOut.pop();
    }
}
均摊分析(会计方法): 每个元素入队(push)时,我们预存 2 个单位的"时间币":1 个用于本次 push,1 个预留给将来从 stackIn 转移到 stackOut 的操作。每个元素的一生经历 3 次操作:push 进 stackIn、从 stackIn pop 出、push 进 stackOut、从 stackOut pop 出——每次操作都是 O(1)。每个元素在 stackOut 为空时的那次批量转移中,参与一次 pop-in + push-out。批量转移操作的总代价 = 当前 stackIn 中元素个数 × 2,分摊到每个元素上 = O(1)。
结论: push 均摊 O(1);pop 均摊 O(1),最坏情况 O(n)(当 stackOut 为空且 stackIn 有 n 个元素时触发批量转移)。均摊 O(1) 不等于每次都是 O(1)。pop 偶尔会遇到 O(n) 的批量转移,但因为每个元素最多被转移一次,n 次 pop 的总代价是 O(n),平均每次 O(1)。这就是均摊分析的核心思想——"贵"的操作虽然偶尔发生,但频率足够低,不影响整体复杂度。
Q8:为什么 Redis 的 quicklist 选择用链表连接 ziplist,而不是直接用双向链表?从内存碎片和缓存角度分析。
Redis 的 quicklist 设计体现了"分层内存管理"的思想。
为什么要用链表连接 ziplist? ziplist(压缩列表)是一种紧凑的连续内存结构,将所有元素紧密排列在一起,无额外指针开销,内存利用率极高。但 ziplist 是连续内存,插入和删除可能触发连锁更新,当 ziplist 很长时性能退化严重。双向链表插入删除是 O(1),但每个节点有 prev/next 指针开销,且节点分散在内存中,碎片化严重。
quicklist 的折中方案: quicklist 将长链表拆成多个 ziplist 节点,每个节点是一个 ziplist,节点之间用双向链表连接。这样插入/删除时,只需在所在 ziplist 内部操作(小范围内存移动),不会影响整个列表;内存碎片控制在单个 ziplist 大小范围内(默认 8KB);相比纯链表,减少了大量指针开销。
从内存碎片角度: 纯双向链表每个元素一个独立节点,N 个元素 = N 次内存分配,碎片化严重。jemalloc 等现代分配器虽然能缓解,但无法完全消除。quicklist 每个 ziplist 节点是一次连续内存分配(8KB),N 个元素可能只需要几十个 ziplist 节点,分配次数减少 2-3 个数量级。
从缓存角度: 纯链表遍历时每个节点可能在不同的 cache line 上,每次访问都是 cache miss。quicklist 同一个 ziplist 内的元素在连续内存中,遍历时 CPU 预取机制能提前加载后续元素,cache 命中率大幅提升。但跨 ziplist 节点时仍然有指针跳转,所以 quicklist 的缓存性能介于纯数组和纯链表之间。
关键参数:list-max-ziplist-size 控制每个 ziplist 节点的最大字节数(默认 -2,即 8KB);list-compress-depth 控制 quicklist 两端不压缩的节点数(默认 0),LZF 压缩中间节点以进一步节省内存。
设计本质: 用空间换时间在链表维度(减少节点数),用时间换空间在 ziplist 维度(紧凑存储),最终在时间和空间之间达到帕累托最优。
Q9:给你一个无限长的数据流,设计一个数据结构,能在任意时刻返回当前已见数据的中位数。
使用两个堆(一个最大堆 + 一个最小堆)即可在数据流中动态维护中位数。
数据结构设计: 最大堆(maxHeap)存放较小的一半数据,堆顶是这一半的最大值;最小堆(minHeap)存放较大的一半数据,堆顶是这一半的最小值。维护约束:maxHeap.size() = minHeap.size() 或 maxHeap.size() = minHeap.size() + 1。
中位数获取: 如果两个堆大小相等,中位数 = (maxHeap.peek() + minHeap.peek()) / 2.0;如果 maxHeap 多一个元素,中位数 = maxHeap.peek()。
插入逻辑(addNum): 1) 新元素先插入 maxHeap;2) 将 maxHeap 堆顶(最大值)弹出并插入 minHeap(保证 maxHeap 中所有元素 ≤ minHeap 中所有元素);3) 如果 maxHeap.size() < minHeap.size(),从 minHeap 弹出堆顶插入 maxHeap(维护大小约束)。
class MedianFinder {
    private PriorityQueue<Integer> maxHeap = new PriorityQueue<>(Collections.reverseOrder());
    private PriorityQueue<Integer> minHeap = new PriorityQueue<>();

    public void addNum(int num) {
        maxHeap.offer(num);
        minHeap.offer(maxHeap.poll());
        if (maxHeap.size() < minHeap.size()) {
            maxHeap.offer(minHeap.poll());
        }
    }

    public double findMedian() {
        if (maxHeap.size() == minHeap.size()) {
            return (maxHeap.peek() + minHeap.peek()) / 2.0;
        }
        return maxHeap.peek();
    }
}
复杂度: addNum 为 O(log n)(两次堆插入 + 至多两次堆删除),findMedian 为 O(1)(只读堆顶)。这是 LeetCode 295(Hard)的经典解法。这个设计巧妙之处在于:用两个堆将一个全局有序问题转化为两个局部有序问题,从而将对数时间复杂度的插入与常数时间的查询结合起来。
Q10:在什么场景下你会选择用数组实现栈而不是链表?从性能、内存、GC 角度分析两种实现的优劣。
性能维度: 数组实现(ArrayDeque)的 push/pop 操作是 O(1) 均摊,但扩容时需要 O(n) 的数组拷贝。不过扩容触发频率随容量增长而降低(等比扩容),均摊下来仍是 O(1)。数组的缓存局部性极好——栈帧在连续内存中,CPU 缓存命中率高。链表实现(LinkedList)每次 push 都需要 new 一个 Node 对象,涉及内存分配和 GC 压力。链表节点的内存不连续,缓存命中率低,每次访问都可能触发 cache miss。
内存维度:
- [ ] 数组,每个元素仅占用一个引用(8 字节,压缩指针下 4 字节),没有额外的节点对象开销。LinkedList 每个节点除了存储元素引用外,还需要存储 prev 和 next 两个引用,外加对象头(Mark Word + Klass Pointer),额外开销约 24-32 字节/节点。存储 10 万个元素,链表比数组多消耗约 2.4-3.2 MB 内存。
GC 维度: 数组实现的整个数组是一个大对象,GC 扫描时一次性处理。如果栈长期存活,数组会晋升到老年代,对 GC 的影响可控。链表实现每个 Node 是独立的小对象,分散在堆中。GC 需要逐个扫描,增加 GC Roots 遍历时间。大量短生命周期的 Node 对象还会产生大量"垃圾",增加 Young GC 频率。
选型建议: 绝大多数场景用数组实现(ArrayDeque),性能更优;仅在需要频繁在栈中间插入/删除元素时考虑链表(但那已不是栈的标准用法);如果栈深度极大且无法预估(如深度优先搜索可能达到百万级),数组的扩容拷贝成本可能成为瓶颈,此时可考虑链表。
以上是 10 个高频追问的参考答案。真正的面试中,面试官不仅看你的答案是否正确,更看重你分析问题的思路、对底层原理的理解以及对工程 trade-off 的把握。