一、为什么需要树?
数组和链表已经能表示"顺序"关系,但现实世界的数据大多是层级化的:
- 文件系统是目录嵌套目录
- HTML DOM 是节点嵌套节点
- 数据库索引需要快速定位百万行数据中的某一行
- 路由表需要根据 IP 前缀匹配最长路径
这些场景的共同诉求是:以对数时间完成查找、插入、删除。这正是树结构诞生的原动力。
树将数据组织成"节点 + 边"的层级关系,比线性结构多了一个维度,但换来了 O(log n) 的时间复杂度。本文从最基础的二叉树出发,一路深入到让数据库索引跑起来的 B+Tree,帮你建立完整的树结构知识体系。
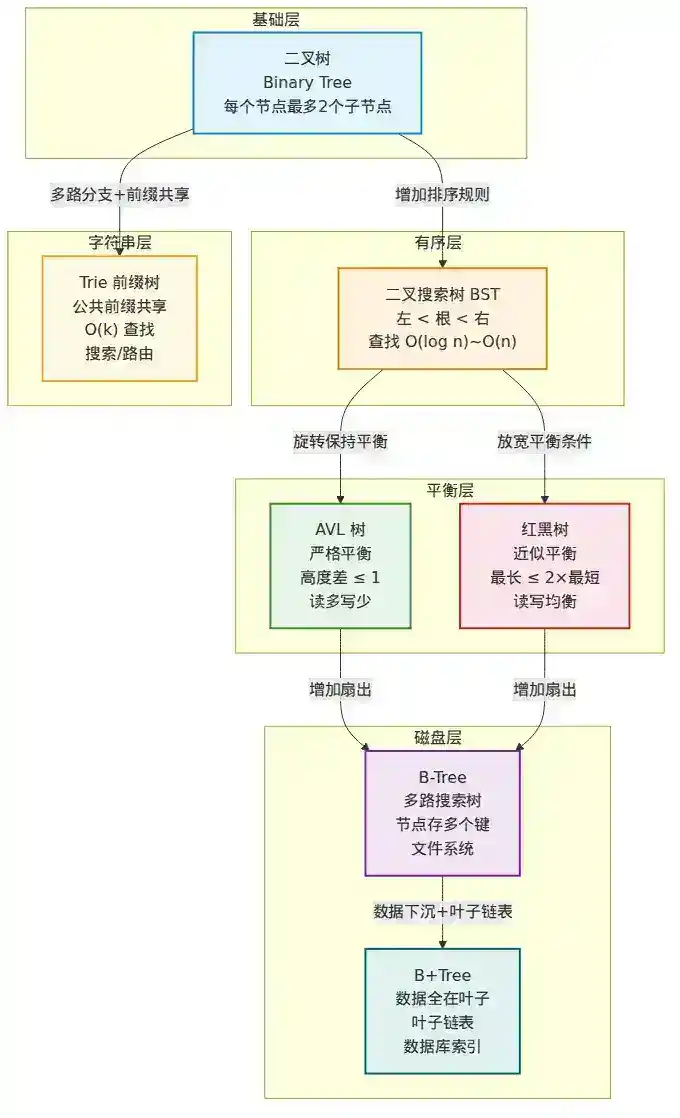
▲ 图1:树结构分类总览——从二叉树到B+Tree的演进关系全景图
二、二叉树基础:树的语言
2.1 术语速查
在进入具体树结构之前,先把术语说清楚:
| 术语 | 含义 |
|---|---|
| 根节点(Root) | 树的最顶层节点,没有父节点 |
| 叶子节点(Leaf) | 没有子节点的节点 |
| 深度(Depth) | 从根到该节点的边数 |
| 高度(Height) | 从该节点到最深叶子的边数 |
| 度(Degree) | 一个节点的子节点数量 |
| 满二叉树 | 每个节点都有 0 或 2 个子节点 |
| 完全二叉树 | 除最后一层外每层都填满,最后一层从左到右填充 |
| 平衡二叉树 | 任意节点的左右子树高度差不超过 1 |
2.2 二叉树的存储
链式存储(最常用):
class TreeNode {
    int val;
    TreeNode left;
    TreeNode right;
    TreeNode(int val) { this.val = val; }
}
顺序存储(数组,适合完全二叉树):
- 下标 i 的节点,左子在 2i+1,右子在 2i+2,父节点在 (i-1)/2
- 堆结构就是基于这种存储方式
2.3 遍历方式
遍历是二叉树最基础的操作,四种遍历各有用途:
前序遍历(Pre-order):根 → 左 → 右
- 用途:序列化、复制树
中序遍历(In-order):左 → 根 → 右
- 用途:BST 的中序遍历结果是有序的
后序遍历(Post-order):左 → 右 → 根
- 用途:删除树(先删子节点)、表达式树求值
层序遍历(Level-order):逐层从左到右
- 用途:BFS、求树的宽度
这四种遍历的时间复杂度都是 O(n),空间复杂度为 O(h)(递归栈深度)或 O(n)(层序遍历队列)。
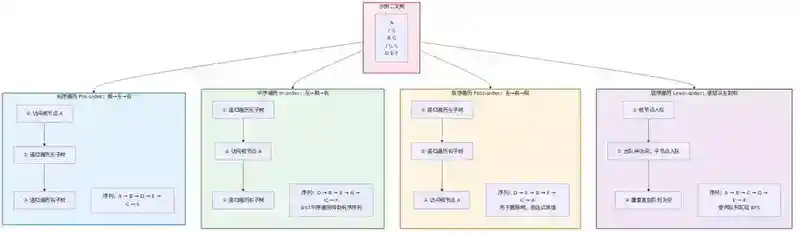
▲ 图2:二叉树四种遍历方式——前序、中序、后序、层序遍历路径对比
三、二叉搜索树(BST):有序的力量
3.1 核心性质
BST 在二叉树的基础上增加了一条排序规则:左子树所有节点 < 根 < 右子树所有节点。这条规则将查找从 O(n) 降到了 O(log n)。
查找过程:从根开始,比当前节点小就往左走,比当前节点大就往右走,等于就命中。每一步排除一半的子树,就是二分查找的树形实现。
3.2 插入与删除
插入:沿着查找路径走到空位,挂上去。简单且 O(log n)。
删除:分三种情况:
- 叶子节点:直接删
- 只有一个子节点:用子节点替换
- 有两个子节点:找后继节点(右子树的最小值),用后继的值替换当前节点,再删除后继节点
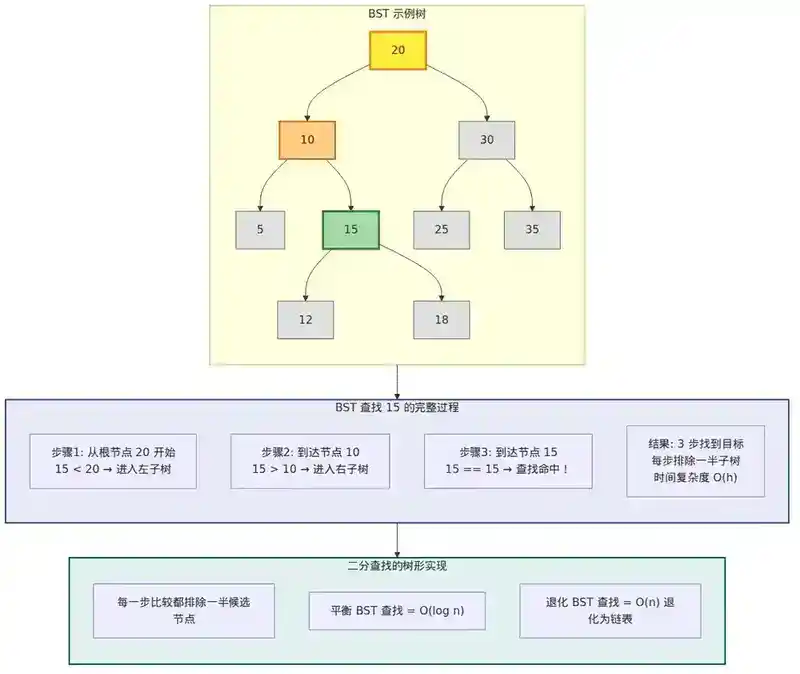
▲ 图3:BST查找过程——每一步排除一半子树的二分查找树形实现
3.3 BST 的致命缺陷
BST 的性能完全取决于树的形状。如果按 [1, 2, 3, 4, 5, 6] 的顺序插入,BST 会退化成一条链表——查找从 O(log n) 变成 O(n)。
这就是为什么我们需要平衡——接下来的 AVL 和红黑树就是为了解决这个问题。
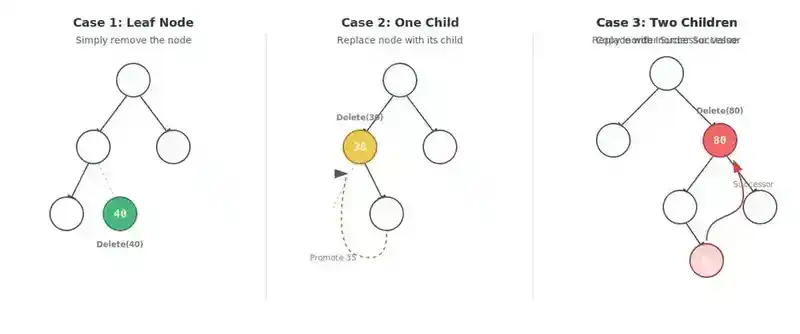
▲ 图4:BST删除三种情况对比——叶子节点、单子节点、双子节点(后继替换)
四、AVL 树:严格平衡
4.1 平衡因子
AVL 树是第一种自平衡二叉搜索树(1962 年,Adelson-Velsky 和 Landis 提出)。它的核心规则简单到只有一条:
任意节点的左右子树高度差(平衡因子)的绝对值不超过 1。
当插入或删除导致某个节点的平衡因子变成 +2 或 -2,就需要旋转来恢复平衡。
4.2 四种旋转
旋转的本质是改变树的结构,但不改变 BST 的有序性质。
LL(左左)——右旋
     A          B
    /          / \
   B    →     C   A
  /
 C
A 的平衡因子从 2 变成 0,一次右旋解决。
RR(右右)——左旋
 A              B
  \            / \
   B    →     A   C

     C
A 的平衡因子从 -2 变成 0,一次左旋解决。
LR(左右)——先左旋再右旋
   A           A          C
  /           /          / \
 B     →     C     →    B   A
  \         /
   C       B
先对 B 左旋变成 LL,再对 A 右旋。
RL(右左)——先右旋再左旋
 A            A            C
  \            \          / \
   B     →      C   →   A   B
  /              \
 C                B
先对 B 右旋变成 RR,再对 A 左旋。
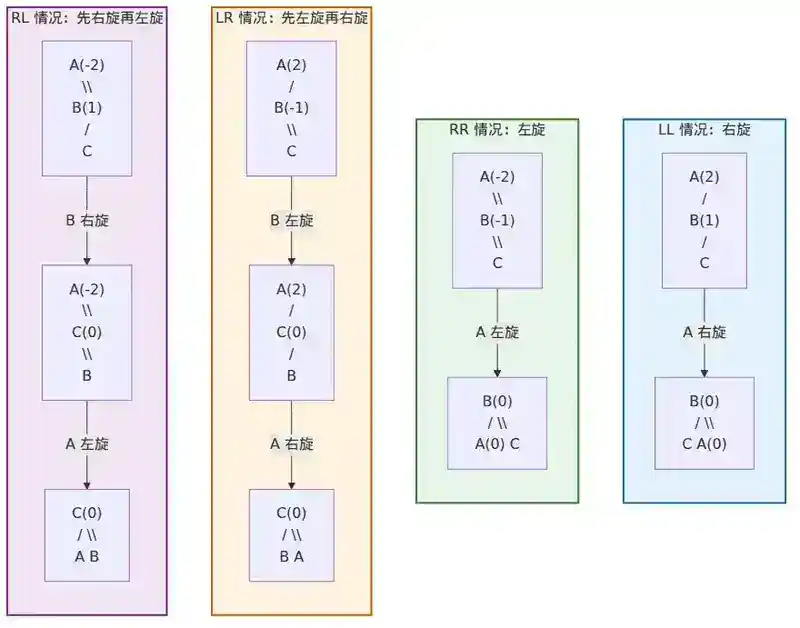
▲ 图5:AVL树四种旋转操作——LL右旋、RR左旋、LR先左后右、RL先右后左
4.3 AVL 的优缺点
优点:查找绝对快——因为树是严格平衡的,高度始终保持在 O(log n),最坏情况也不退化。
缺点:插入和删除可能触发多次旋转,写操作开销大。工程实践中,读多写少的场景适合 AVL。
五、红黑树:实用主义平衡
5.1 为什么需要红黑树
AVL 追求"绝对平衡",但代价是频繁旋转。红黑树的选择是:放宽平衡条件,换取更少的旋转次数。这使得红黑树在写操作较多的场景下更快。
Java 的 TreeMap、TreeSet、HashMap(链表转树时)、Linux 的 CFS 调度器、epoll 的事件管理,底层都是红黑树。
5.2 五条性质
红黑树的"平衡"由五条规则保证:
- 每个节点是红色或黑色
- 根节点是黑色
- 每个叶子(NIL)是黑色
- 红色节点的两个子节点必须是黑色(不能有两个连续的红节点)
- 从任意节点到其所有后代叶子的路径上,黑色节点数量相同
这五条规则共同保证:最长路径不超过最短路径的两倍。这就是红黑树"近似平衡"的含义——不是严格平衡,但有上界保证。
5.3 插入修复
新插入的节点默认是红色(这样不破坏规则 5)。插入后有几种情况:
Case 1:插入的是根节点 → 直接染黑
Case 2:父节点是黑色 → 无需调整
Case 3:父节点是红色,叔叔节点也是红色 → 父和叔染黑,祖父染红,以祖父为起点继续修复
Case 4:父节点是红色,叔叔是黑色(三角或直线结构)→ 旋转 + 变色
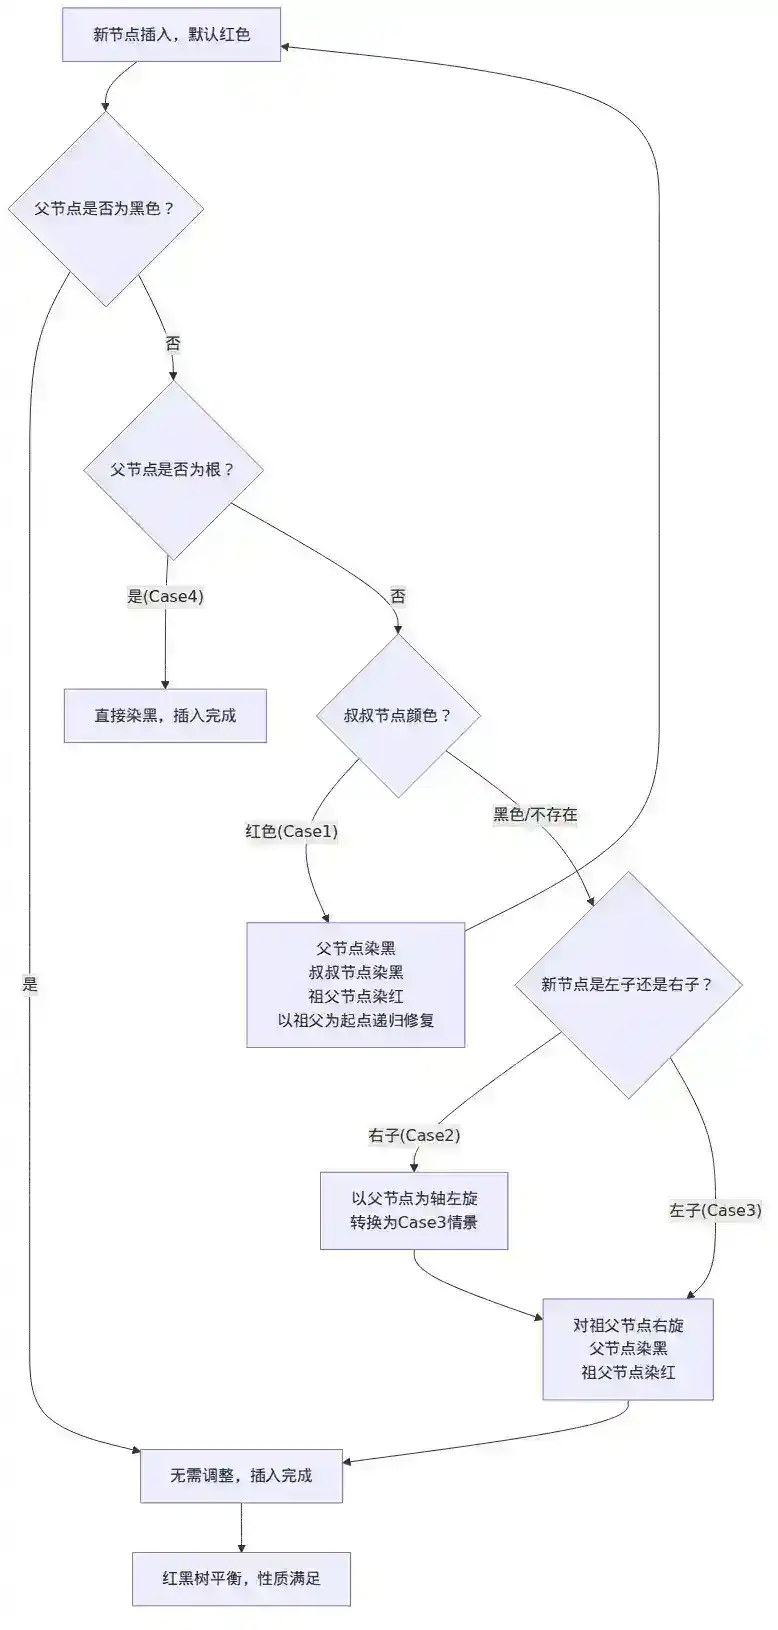
▲ 图6:红黑树插入修复流程——新节点为红色,四种case的处理路径
5.4 红黑树 vs AVL:选型
| 维度 | AVL | 红黑树 |
|---|---|---|
| 平衡条件 | 严格(高度差 ≤ 1) | 宽松(最长 ≤ 2×最短) |
| 查找 | 更快(树更矮) | 稍慢 |
| 插入 | 可能多次旋转 | 最多 2 次旋转 |
| 删除 | 可能多次旋转 | 最多 3 次旋转 |
| 适用场景 | 读多写少 | 读写均衡或写多 |
一句话总结:AVL 为查找而生,红黑树为工程而生。
六、B-Tree 与 B+Tree:磁盘友好的树
6.1 从内存到磁盘
前面的树结构都在内存中操作,每一步都是 O(1) 的指针访问。但数据库索引面对的是磁盘——一次磁盘 I/O 是毫秒级,而内存访问是纳秒级,差了 4-5 个数量级。
核心矛盾:二叉树的每个节点只有两个子节点,树的高度 = log₂(n)。当 n = 1,000,000 时,高度约 20。这意味着一次查找需要 20 次磁盘 I/O——太慢了。
B-Tree 的解决方案:把每个节点从"存一个键"变成"存多个键",让每个节点有 M 个子节点。这样树的高度降为 log_M(n),M 越大,I/O 次数越少。
6.2 B-Tree 的结构
一个 m 阶 B-Tree 的节点规则:
- 每个节点最多 m 个子节点,最多 m-1 个键
- 根节点至少 2 个子节点(除非是叶子)
- 内部节点至少 ⌈m/2⌉ 个子节点
- 所有叶子在同一层
查找:在节点内二分查找定位键的位置,然后进入对应的子节点。节点内的键是有序的。
插入:找到对应叶子节点插入。如果节点满了(键数 = m-1),则分裂:把中间键提升到父节点,左右各形成一个新节点。分裂可能一直传播到根。
删除:先找到键。如果是内部节点的键,用前驱或后继替换。删除后如果节点键数不足 ⌈m/2⌉-1,则借键(从兄弟节点借)或合并(和兄弟节点合并)。
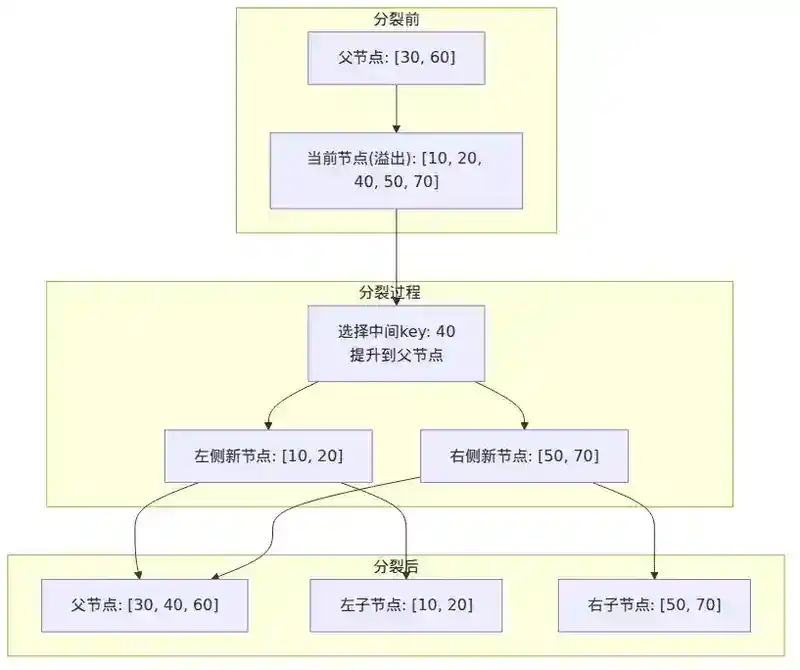
▲ 图7:B-Tree节点分裂过程——中间键提升到父节点,左右分裂
6.3 B+Tree:B-Tree 的数据库优化版
B+Tree 是 B-Tree 的变种,也是 MySQL InnoDB 的索引结构。它的关键变化:
差异一:所有数据只存叶子节点 内部节点只存键(索引),不存数据。这意味着每个内部节点可以容纳更多键,树的高度更低,I/O 更少。
差异二:叶子节点形成有序链表 每个叶子节点有指向下一个叶子节点的指针。这使得范围查询(SELECT * FROM t WHERE id BETWEEN 100 AND 200)极其高效——定位到起始位置后,沿着链表顺序扫描即可,不需要回退到内部节点。
差异三:叶子节点存储实际数据 在 InnoDB 中,主键索引的叶子节点存储的是完整的行数据(聚簇索引);二级索引的叶子节点存储的是主键值,需要回表查询。
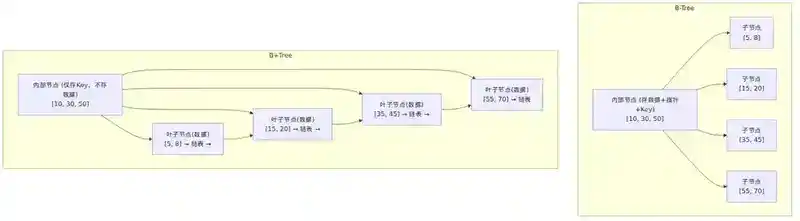
▲ 图8:B-Tree vs B+Tree结构对比——内部节点差异与叶子链表
6.4 为什么 B+Tree 适合数据库
| 需求 | B+Tree 如何满足 |
|---|---|
| 等值查询 | O(log n) 从根到叶子 |
| 范围查询 | 叶子链表 O(k) 扫描 |
| 磁盘 I/O 最小化 | 高扇出(一个节点几百个键),树高通常 3-4 层 |
| 数据有序 | 叶子链表天然有序,支持 ORDER BY |
| 空间局部性 | 一个节点 = 一个磁盘页(通常 16KB),一次 I/O 读取整页 |
七、Trie(前缀树):字符串的专用树
7.1 核心思想
Trie 不是二叉树,它的每个节点有多个子节点(通常 26 个,对应小写字母)。Trie 的核心思想是:用公共前缀共享路径。
插入 "cat", "car", "dog" 后:
        root
       /    \
      c      d
     /        \
    a          o
   / \          \
  t   r          g
查找 "cat":从根出发,c → a → t,每一步只消耗一个字符,O(k) 时间(k 是字符串长度),与存储了多少字符串无关。
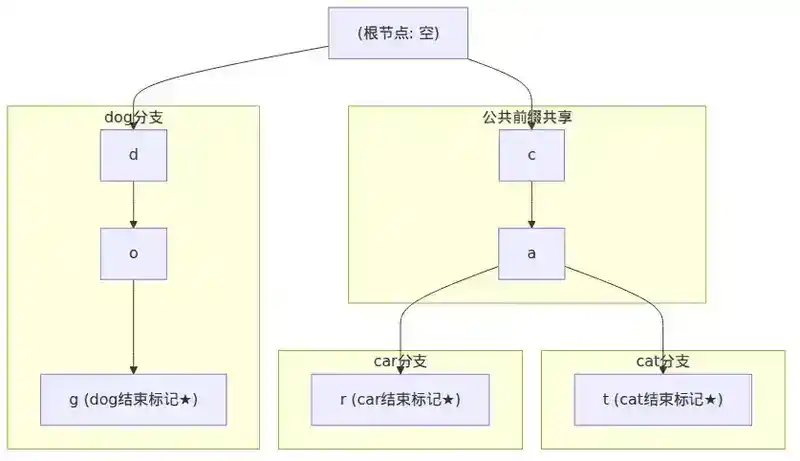
▲ 图9:Trie前缀树结构示例——cat/car/dog的插入与公共前缀共享
7.2 变种与优化
压缩 Trie(Radix Tree):把单分支路径压缩成一个节点。例如 "inter-" 后面跟 "net" 和 "nal",公共前缀合并成一个边。
Ternary Search Trie(TST):每个节点只有 3 个分支(小于、等于、大于),类似 BST + Trie 的混合体,空间效率更高。
7.3 工程应用
- 自动补全:输入 "ca" 时,从根走到 ca 节点,收集所有后代
- 拼写检查:模糊匹配最近的前缀路径
- IP 路由最长前缀匹配:路由表按前缀组织成 Trie,匹配时沿着最长可能路径走
- Elasticsearch 的 FST(有限状态转换器):倒排索引中的 Term Dictionary 本质上是一个压缩 Trie
八、总结:选型全景
| 数据结构 | 查找 | 插入 | 删除 | 核心特点 | 典型场景 |
|---|---|---|---|---|---|
| 普通二叉树 | O(n) | O(n) | O(n) | 无平衡保证 | 基础学习 |
| BST | O(log n)~O(n) | O(log n)~O(n) | O(log n)~O(n) | 有序,可能退化 | 简单有序数据 |
| AVL | O(log n) | O(log n) | O(log n) | 严格平衡 | 读多写少 |
| 红黑树 | O(log n) | O(log n) | O(log n) | 近似平衡,写快 | TreeMap, HashMap |
| B-Tree | O(log n) | O(log n) | O(log n) | 磁盘友好 | 文件系统 |
| B+Tree | O(log n) | O(log n) | O(log n) | 范围查询优化 | 数据库索引 |
| Trie | O(k) | O(k) | O(k) | 前缀匹配 | 搜索、路由 |
选择树结构的核心考量不是"哪种树最好",而是"数据和操作的特点是什么"。平衡是有代价的,扇出越大越磁盘友好,前缀结构适合字符串——没有银弹,只有合适的场景。
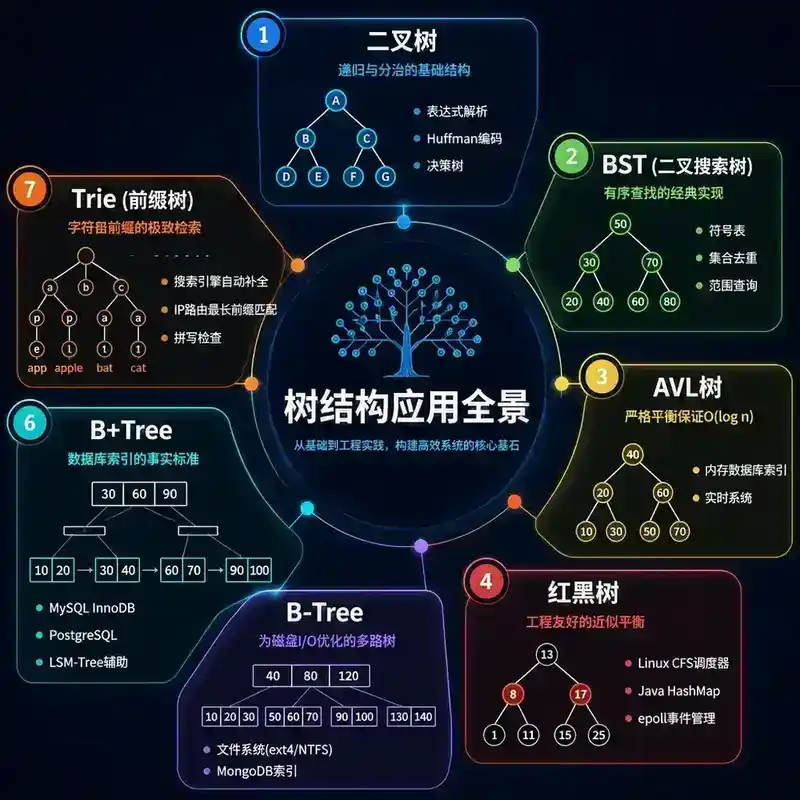
▲ 图10:七种树结构的工程应用场景全景图——从内存到磁盘到搜索
九、面试官视角:10 个提问
以下问题不局限于本文内容,而是从面试官视角考察对树结构的深度理解。
Q1:为什么 HashMap 的链表转红黑树阈值是 8?为什么不是 6 或 10?
Q2:红黑树插入时,为什么新节点默认是红色而不是黑色?
Q3:B+Tree 中,为什么内部节点不存数据?如果存了会怎样?
Q4:InnoDB 为什么使用 B+Tree 而不是 B-Tree 或红黑树?请从 I/O 和范围查询两个角度回答。
Q5:一棵有 1000 万个键的 B+Tree,假设每个节点 16KB,每个键 8 字节,每个指针 6 字节,树的高度大约是多少?
Q6:AVL 树和红黑树的旋转操作,在并发环境下分别有什么问题?
Q7:Trie 在空间上有什么缺点?如何优化?
Q8:如何判断一棵二叉树是否是 BST?写出代码思路。
Q9:二叉搜索树中,如何找到第 k 小的元素?
Q10:如果让你设计一个支持区间查询的缓存系统,你会选择什么树结构?为什么?
参考答案
A1:HashMap 链表转红黑树阈值为什么是 8?
这个数字来自泊松分布的概率计算。在负载因子为 0.75 的理想哈希条件下,一个 bin 中出现 k 个元素的概率服从参数 λ=0.5 的泊松分布:
| 链表长度 | 概率 |
|---|---|
| 0 | 0.606 |
| 1 | 0.303 |
| 2 | 0.076 |
| 3 | 0.013 |
| 4 | 0.0016 |
| 5 | 0.00016 |
| 6 | 0.000013 |
| 7 | 0.00000094 |
| 8 | 0.00000006 |
链表长度达到 8 的概率约为 6×10⁻⁸——几乎不可能发生。如果发生了,说明哈希函数设计有问题或遭遇了哈希碰撞攻击,此时 O(n) 的链表查找已成为性能瓶颈,转成红黑树(O(log n) 查找)是合理的防御策略。
为什么不设为 6?因为树化和退树化的阈值需要一个缓冲区间。如果两个阈值相同(比如都是 8),当链表长度在 8 附近波动时,会频繁触发树化→退树化→树化的循环,每次树化都是一次 O(n) 的遍历重建。设为 8 树化、6 退树化,这个 2 的差值避免了颠簸。
A2:红黑树插入时,新节点为什么默认是红色?
红黑树的五条规则中,规则 5(黑高一致)是全局性质——它约束的是从任意节点到叶子的所有路径。如果新节点插入为黑色,会立即破坏这条规则,而且修复需要全局调整——增加整棵子树所有路径上的黑色节点数,代价极高。
红色节点只可能违反规则 4(不能有两个连续红色)。这是一个局部性质,修复只需要在插入路径上向上调整,最多 O(log n) 次旋转,且大部分情况只需变色即可解决。
权衡逻辑:宁犯局部规则,不犯全局规则。这也是为什么红黑树的插入修复最多只需 2 次旋转,而如果新节点默认黑色,修复成本将无法控制。
A3:B+Tree 中,内部节点不存数据的原因是什么?
核心原因:最大化扇出(fan-out),最小化树高。
假设一个磁盘页 16KB,每个键 8 字节,每个指针 6 字节。如果内部节点存数据(比如每条数据 100 字节),那么一个内部节点只能放约 16384/(8+6+100) ≈ 143 个条目。如果不存数据,可以放 16384/(8+6) ≈ 1170 个条目。
扇出从 143 变成 1170,对 1000 万条记录来说:
- 存数据:log₁₄₃(10,000,000) ≈ 3.3 → 4 层,4 次 I/O
- 不存数据:log₁₁₇₀(10,000,000) ≈ 2.3 → 3 层,3 次 I/O
另外,内部节点存数据还会破坏叶子链表的连续性——范围查询时无法只扫描叶子节点,必须回到内部节点去取数据,失去了 B+Tree 最大的范围查询优势。
A4:InnoDB 为什么用 B+Tree 而不是 B-Tree 或红黑树?
I/O 角度:红黑树是二叉树,1000 万行数据树高约 23 层,一次查找需要 23 次随机 I/O,每次约 5-10ms,总共约 200ms——不可接受。B+Tree 的扇出可达 1000+,同样数据量只需 2-3 层,3 次 I/O 约 15-30ms。而且 B+Tree 的根节点通常缓存在内存中,实际只需 1-2 次 I/O。
范围查询角度:B-Tree 的数据散布在内部节点和叶子节点中,做 SELECT * FROM t WHERE id BETWEEN 100 AND 200 时,需要在树的不同层级之间跳转,无法顺序扫描。B+Tree 的叶子节点用链表串联,定位到起始位置后,沿着链表顺序读取即可,充分利用了磁盘的顺序读性能(顺序读比随机读快 10-100 倍)。
A5:1000 万个键的 B+Tree 高度计算
每个节点 16KB = 16384 字节。扣除页头开销(约 128 字节),可用约 16256 字节。
内部节点:每个条目 = 键(8B) + 指针(6B) = 14B,每个节点约 16256/14 ≈ 1161 个条目。
叶子节点:存储键+数据,假设每条记录 200 字节(含行数据),每个叶子约 16256/200 ≈ 81 条记录。
计算高度:
- 叶子层:10,000,000 / 81 ≈ 123,457 个叶子节点
- 中间层:123,457 / 1161 ≈ 107 个节点
- 根层:107 / 1161 ≈ 1 个节点
树高 = 3 层(根→中间→叶子),加上根节点常驻内存,实际磁盘 I/O 仅 2 次。
这解释了为什么 B+Tree 在亿级数据量下依然保持 3-4 层——扇出是 O(log n) 的底数,底数越大,树越矮。
A6:AVL 和红黑树的旋转在并发环境下有什么问题?
AVL 的问题:插入可能触发级联旋转——一次插入导致某节点失衡,旋转修复后,可能引起祖先节点也失衡,需要沿着路径一直旋转到根。在并发环境下,这意味着一把锁要覆盖从插入点到根节点的整条路径,锁粒度粗、持锁时间长,并发度极低。
红黑树的问题:虽然旋转次数少(插入最多 2 次),但变色操作可能一路传播到根。更关键的是,红黑树的旋转 + 变色组合会同时改变多个节点的颜色和指针,不是原子操作。如果并发读线程在旋转过程中遍历,可能看到中间状态——比如某个节点临时"丢失"或出现环路。
工业界的解决方案:并发 B+Tree(如 PostgreSQL 的 B-Link Tree)使用"兄弟指针 + 高键"实现无锁读;Java 的 ConcurrentSkipListMap 用跳表代替红黑树实现并发有序映射,因为跳表的插入只影响局部节点,天然适合无锁实现。
A7:Trie 的空间缺点及优化方案
缺点:最坏情况下,每个字符一个节点,每个节点有 26(或 256)个指针。对于 100 万个长度为 10 的字符串,如果前缀不共享,需要 1000 万个节点,每个节点 26×8=208 字节的指针数组,总计约 2GB——其中绝大多数指针为空。
优化方案:
- 压缩 Trie(Radix Tree):合并单分支路径,把 "inter-" 后面的 "net" 和 "nal" 用一条边表示,显著减少节点数。
- Ternary Search Trie(TST):每个节点只有 3 个指针(小于/等于/大于),空间从 O(26) 降到 O(3),但查找从 O(k) 变成 O(k log 26)。
- Double-Array Trie:用两个数组(base 和 check)紧凑存储,是日本学者 Aoe 提出的经典压缩方案,空间效率接近最优。
- 用 HashMap 代替固定数组:每个节点用
HashMap<Character, Node>存储子节点,按需分配,避免 26 个空指针。 - Bitwise Trie / Patricia Trie:按位而非按字符存储,适合 IP 路由等场景,节点只有 2 个子节点。
A8:判断二叉树是否是 BST
方法一:中序遍历法 二叉搜索树的中序遍历结果一定是严格递增的序列。对树做中序遍历,检查每个节点值是否大于前一个节点值。
Integer prev = null;
boolean isValidBST(TreeNode root) {
    if (root == null) return true;
    if (!isValidBST(root.left)) return false;
    if (prev != null && root.val <= prev) return false;
    prev = root.val;
    return isValidBST(root.right);
}
方法二:递归区间法 每个节点必须在一个合法区间内。左子树所有节点的合法区间是 (min, root.val),右子树是 (root.val, max)。
boolean isValidBST(TreeNode root, long min, long max) {
    if (root == null) return true;
    if (root.val <= min || root.val >= max) return false;
    return isValidBST(root.left, min, root.val)
        && isValidBST(root.right, root.val, max);
}
两种方法的时间复杂度都是 O(n),空间复杂度 O(h)。递归区间法更直观,不需要维护全局变量,且能提前终止(一旦发现违反区间立刻返回 false)。
陷阱:很多候选人只检查「左子 < 根 < 右子」,这不够——必须保证左子树所有节点 < 根 < 右子树所有节点。例如 [5,1,6,null,null,3,7],3 在右子树但小于 5,不是 BST。
A9:在二叉搜索树中找到第 k 小的元素
方法一:中序遍历计数(O(n))
int count = 0, result = 0;
void kthSmallest(TreeNode root, int k) {
    if (root == null) return;
    kthSmallest(root.left, k);
    if (++count == k) { result = root.val; return; }
    kthSmallest(root.right, k);
}
方法二:维护子树大小(O(h)) 如果树的节点额外存储 size(以该节点为根的子树节点总数),可以在 O(h) 时间内找到第 k 小:
TreeNode kthSmallest(TreeNode root, int k) {
    int leftSize = root.left == null ? 0 : root.left.size;
    if (k == leftSize + 1) return root;           // 根就是第 k 小
    if (k <= leftSize) return kthSmallest(root.left, k);  // 在左子树
    return kthSmallest(root.right, k - leftSize - 1);      // 在右子树
}
延伸:如果树频繁增删,维护 size 会增加插入/删除的复杂度。此时可以考虑用跳表或有序数组 + 二分。如果只需要第 k 小且 k 固定,可以用大小为 k 的大顶堆流式处理。
A10:设计支持区间查询的缓存系统,选什么树结构?
推荐:B+Tree(磁盘场景)或跳表(内存场景)
B+Tree 方案(适合持久化缓存,如 RocksDB 的 MemTable → SST):
- 叶子链表天然支持区间扫描
- 扇出大、树高矮,适合磁盘存储
- 示例:RocksDB 内部用 SkipList 做 MemTable,刷到磁盘后以 B+Tree(SST 文件)组织
跳表方案(适合纯内存缓存,如 Redis ZSet):
- 多层索引实现 O(log n) 查找
- 区间查询:先定位起点,沿最底层链表顺序扫描,O(log n + k)
- 无锁实现友好:插入只修改局部指针,CAS 即可实现
- 示例:Redis 的 ZSet 在元素较多时用跳表 + 哈希表实现
关键设计考量:
- 过期策略:区间查询的缓存不能简单用 LRU 链表(那会破坏区间有序性)。需要额外的过期索引(如时间轮 + 懒删除)。
- 一致性:缓存与数据库的一致性需要结合区间特征——如果更新了数据库中 [100, 200] 范围的数据,缓存中该范围也应失效。可以用范围标记法:将缓存键按区间分桶,批量失效。
- 内存控制:跳表每个节点有额外的层级指针开销(平均 1.33 倍),B+Tree 的节点更紧凑但需要整页加载。如果内存紧张,可以考虑压缩前缀 B+Tree 或自适应基数树(ART)。