考点 241|阅读时间约 45 分钟 适用岗位:高级 Java 工程师、技术专家、架构师
一、为什么复杂度分析是面试的"第一关"
一个算法写完能跑,和这个算法在 100 万数据下不崩,是两回事。复杂度分析就是帮你在写代码之前判断这个算法能不能上生产的工具。
面试官问复杂度,不是在考你背公式——他想看三件事:
- 你能不能估算一段代码的资源消耗
- 你能不能比较不同解法的优劣
- 你能不能识别隐藏的性能陷阱
这篇文章从最基础的 Big O 讲起,一路深入到均摊分析和工程中的性能边界。
二、时间复杂度:你的代码跑多快
2.1 Big O 是什么
Big O 描述的是数据规模 n 趋近无穷大时,算法执行时间的增长趋势。它关心的不是"跑多少毫秒",而是"n 翻倍后,时间翻几倍"。
核心思想:忽略常数系数、忽略低阶项、只看最高阶。
3n² + 100n + 500 → O(n²)
为什么可以这么干?因为 n 足够大时,n² 会完全碾压 100n 和 500。n=100 万时,n² 是 1 万亿,100n 只是 1 亿,差 4 个数量级。
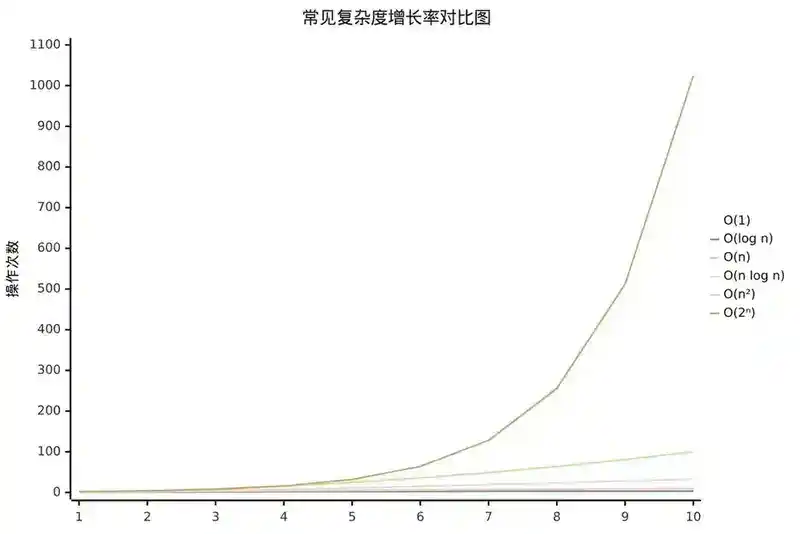
2.2 常见复杂度从快到慢
| 复杂度 | 名称 | n=100 时 | n=100 万时 | 典型算法 |
|---|---|---|---|---|
| O(1) | 常数 | 1 | 1 | 哈希查找 |
| O(log n) | 对数 | ~7 | ~20 | 二分查找 |
| O(n) | 线性 | 100 | 100 万 | 遍历数组 |
| O(n log n) | 线性对数 | ~700 | ~2000 万 | 归并排序 |
| O(n²) | 平方 | 1 万 | 1 万亿 | 冒泡排序 |
| O(2ⁿ) | 指数 | 1.27×10³⁰ | 宇宙级 | 暴力子集 |
| O(n!) | 阶乘 | 9.3×10¹⁵⁷ | 不可想象 | 旅行商暴力 |
面试直觉:O(n log n) 以下通常可接受,O(n²) 需要谨慎看数据规模,O(2ⁿ) 基本需要换思路。
2.3 时间复杂度的计算规则
规则一:顺序执行,取最大
void process(int[ ] arr) {

    // O(n)
    for (int x : arr) { f(x); }     // ①
    // O(n²)
    for (int i : arr) {              // ②
        for (int j : arr) { g(i,j); }
    }
}
// 总复杂度 = O(n) + O(n²) = O(n²)
规则二:嵌套循环,相乘
for (int i = 0; i < n; i++) {        // O(n)
    for (int j = 0; j < n; j++) {    // O(n)
        compute(i, j);               // O(1)
    }
}
// 总复杂度 = O(n × n) = O(n²)
规则三:条件分支,取最坏
if (condition) {
    quickSort(arr);    // O(n log n)
} else {
    bubbleSort(arr);   // O(n²)
}
// 复杂度 = max(O(n log n), O(n²)) = O(n²)
2.4 对数复杂度的直觉
对数复杂度是面试中最容易被误解的。核心直觉:每次操作把问题规模缩小一个比例。
// 二分查找:每次砍一半
int i = n;
while (i > 1) {
    i = i / 2;  // 约 log₂n 次
}

// 平衡树操作:每次排除一半子树
// 归并排序:每次把问题分成两半,共 log₂n 层
Java 中的对数复杂度:
TreeMap.put()/TreeSet.contains()→ O(log n)(红黑树高度)PriorityQueue.offer()/poll()→ O(log n)(堆的 siftUp/siftDown)Arrays.binarySearch()→ O(log n)HashMap.get()→ O(1) 平均,O(log n) 最坏(JDK 8+ 链表转红黑树)
2.5 递归的复杂度分析
方法一:递推公式法
// 归并排序

void mergeSort(int[ ] arr, int l, int r) {

    if (l >= r) return;
    int m = (l + r) / 2;
    mergeSort(arr, l, m);      // T(n/2)
    mergeSort(arr, m+1, r);    // T(n/2)
    merge(arr, l, m, r);       // O(n)
}
// T(n) = 2T(n/2) + O(n) → T(n) = O(n log n)
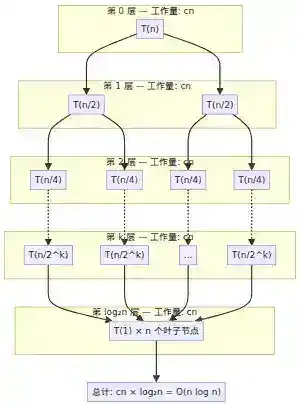
方法二:递归树法
把递归展开成树,每层的工作量加起来:
归并排序递归树:
第 0 层:n           ← 1 个节点,每个 n
第 1 层:n/2 + n/2   ← 2 个节点,每个 n/2
第 2 层:n/4 × 4    ← 4 个节点,每个 n/4
...
共 log₂n 层,每层总工作量 = n
总复杂度 = n × log₂n = O(n log n)
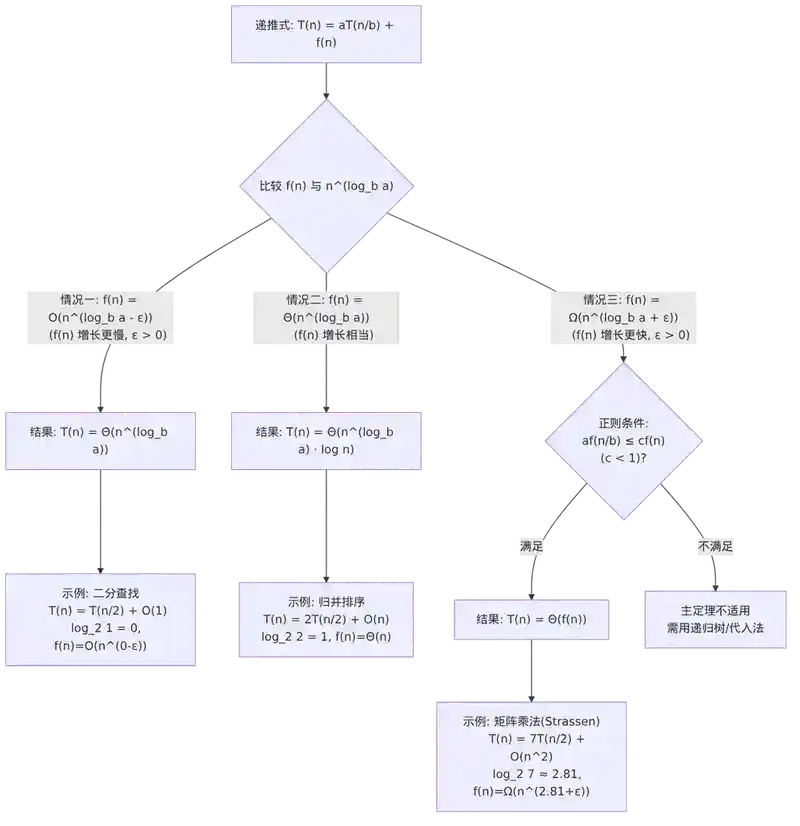
方法三:主定理(Master Theorem)
对于 T(n) = aT(n/b) + f(n):
| 情况 | 条件 | 结论 |
|---|---|---|
| 叶节点主导 | f(n) = O(n^(log_b a - ε)) | T(n) = Θ(n^(log_b a)) |
| 平衡 | f(n) = Θ(n^(log_b a)) | T(n) = Θ(n^(log_b a) × log n) |
| 根节点主导 | f(n) = Ω(n^(log_b a + ε)) | T(n) = Θ(f(n)) |
三个经典递归:
| 算法 | 递推式 | 复杂度 |
|---|---|---|
| 二分查找 | T(n) = T(n/2) + O(1) | O(log n) |
| 归并排序 | T(n) = 2T(n/2) + O(n) | O(n log n) |
| 快速排序(最坏) | T(n) = T(n-1) + O(n) | O(n²) |
三、空间复杂度:你的代码吃多少内存
3.1 定义
空间复杂度衡量的是算法运行过程中额外分配的内存空间,不包括输入数据本身占用的空间。
// 输入数组 arr 不算,只算额外分配

int sum(int[ ] arr) {

    int total = 0;          // 额外 O(1)
    for (int x : arr) {
        total += x;
    }
    return total;
}
// 空间复杂度 = O(1)
3.2 常见的空间复杂度来源
O(1) — 原地操作:只用了固定数量的变量。
void swap(int[ ] arr, int i, int j) {

    int tmp = arr[i]; arr[i] = arr[j]; arr[j] = tmp;
}
O(n) — 线性辅助空间:复制了一份等大的数据。
int[ ] copy(int[ ] arr) {


    int[ ] result = new int[arr.length];  // O(n)

    System.arraycopy(arr, 0, result, 0, arr.length);
    return result;
}
O(log n) — 递归调用栈:二分查找的递归深度。
int binarySearch(int[ ] arr, int l, int r, int target) {

    if (l > r) return -1;
    int m = (l + r) / 2;
    // 递归深度 = log₂n,每层栈帧 O(1) → O(log n)
    if (arr[m] == target) return m;
    return arr[m] > target
        ? binarySearch(arr, l, m-1, target)
        : binarySearch(arr, m+1, r, target);
}
O(n) 递归栈:退化的递归(如链表反转的递归写法)。
// 递归深度 = n,每层栈帧 O(1) → O(n) 空间
ListNode reverse(ListNode head) {
    if (head == null || head.next == null) return head;
    ListNode newHead = reverse(head.next);
    head.next.next = head;
    head.next = null;
    return newHead;
}
3.3 Java 中的空间开销
面试中一个容易被忽略的点:Java 对象的空间开销远超原始数据。
| 类型 | 实际占用 |
|---|---|
int |
4 字节 |
Integer |
16 字节(对象头 12 + int 4) |
| int[ ](长度 n) | 16 + 4n 字节(对象头 16 + 数组长度 4 + 数据) |
| String
- [ ] 引用 + hash + coder 等) |
| HashMap.Entry | ~32 字节(对象头 + key/value/next/hash 引用) |
压缩指针:堆内存 < 32GB 时,JVM 自动开启指针压缩,对象引用从 8 字节压缩到 4 字节。架构师在做容量规划时必须考虑这个边界。
四、均摊分析:不是每次操作都那么贵
4.1 什么是均摊分析
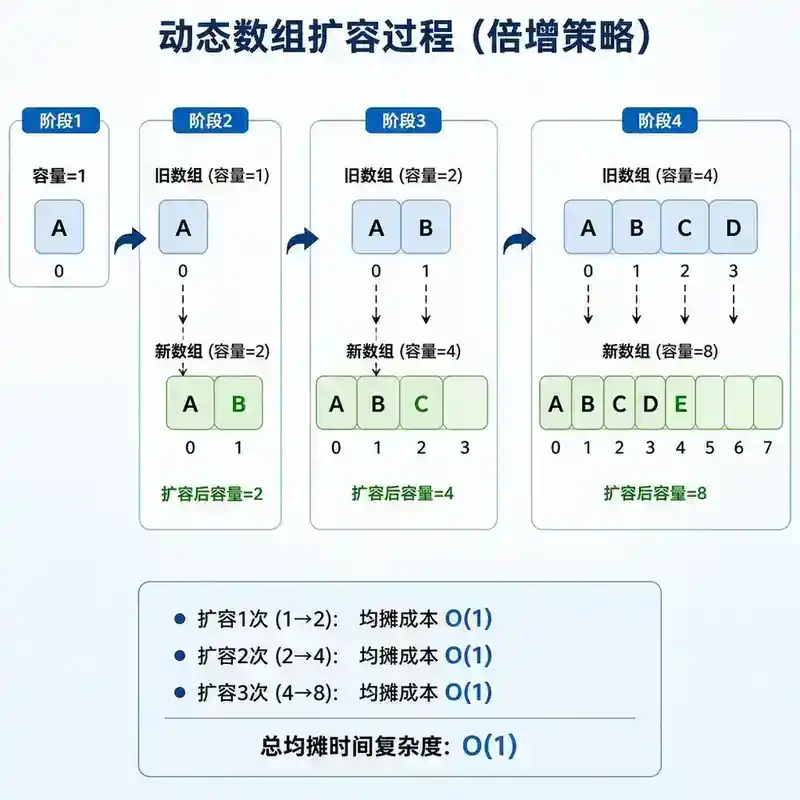
有些数据结构,单次操作的最坏情况很贵,但连续 N 次操作的总代价不高。均摊分析就是"把总代价平摊到每次操作上"。
最经典的例子:ArrayList 的 add 操作。
4.2 ArrayList 扩容的均摊分析
// ArrayList 的 add 实现(简化)
public boolean add(E e) {
    if (size == elementData.length)
        grow(size + 1);  // 扩容:O(n) 的数组拷贝
    elementData[size++] = e;  // 正常情况:O(1)
}
问题:grow() 是 O(n),那 add() 的复杂度是 O(n) 吗?
答案:不是。均摊下来是 O(1)。
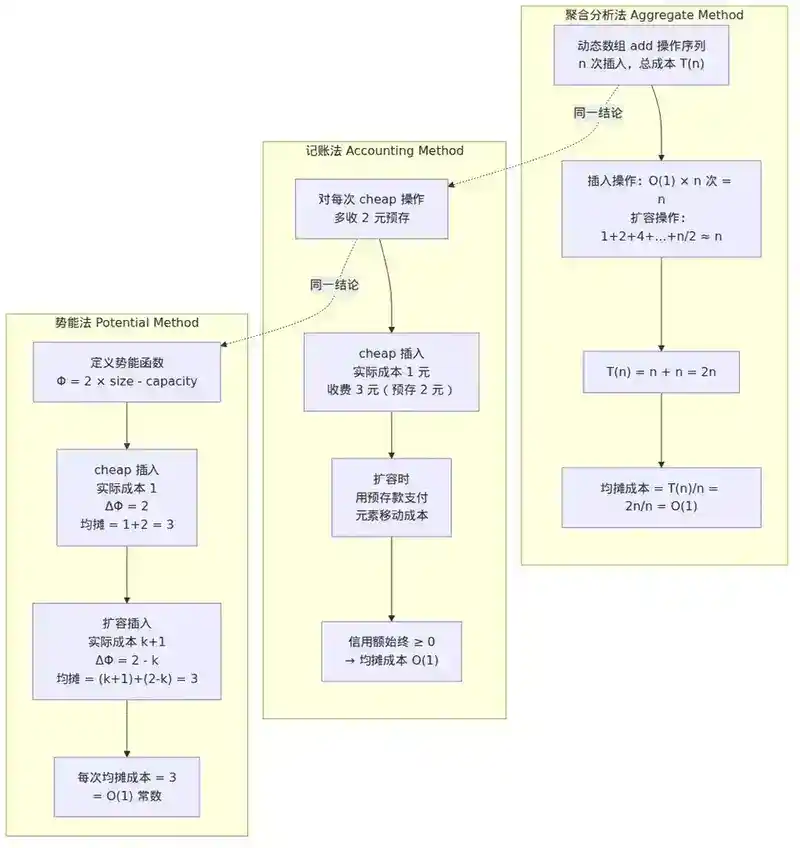
分析过程(聚合分析法):
JDK 中扩容策略是容量变为原来的 1.5 倍。从容量 1 开始,插入 n 个元素:
扩容时机:1 → 2 → 3 → 4 → 6 → 9 → 13 → 19 → 28 → ...
每次扩容拷贝的元素数:1 + 2 + 3 + 4 + 6 + 9 + 13 + 19 + ...

总拷贝次数 ≈ 1.5⁰ + 1.5¹ + 1.5² + ... + 1.5^(log₁.₅n)
           = (1.5^(log₁.₅ n + 1) - 1) / (1.5 - 1)
           ≈ 3n

总操作次数 = n 次插入 + 3n 次拷贝 = 4n
均摊每次 = 4n / n = 4 = O(1)
直觉:扩容次数随 n 增大而减少——n 越大,每次扩容间隔越长,拷贝的成本被摊薄了。
4.3 三种均摊分析方法
聚合分析(Aggregate Method): 直接算 N 次操作的总代价 T(N),然后每操作均摊为 T(N)/N。
记账法(Accounting Method): 每次便宜操作多收一点"费用",存起来,给昂贵的操作用。ArrayList 的 add:每次 O(1) 插入实际收费 3 单位,1 单位用于本次插入,2 单位存起来,等扩容时用。
势能法(Potential Method): 定义势能函数 Φ,操作代价 = 实际代价 + ΔΦ。势能变化"吸收"了昂贵操作的代价波动。
4.4 更多均摊分析案例
HashMap 的 rehash:
- 单次扩容:O(n)(重新哈希所有元素)
- 均摊:O(1)(和 ArrayList 一样的逻辑,扩容间隔指数增长)
StringBuilder 的 append:
- 扩容策略同 ArrayList,均摊 O(1)
并查集(Union-Find)的路径压缩:
- 单次 find:可能 O(log n) 甚至 O(n)
- 均摊:反阿克曼函数 α(n),实际中 ≤ 5,视为 O(1)
ForkJoinPool 的工作窃取:
- 单个任务窃取:O(log n)(双端队列操作)
- 均摊:接近 O(1),因为窃取是稀疏事件
五、性能边界:最好、最坏、平均、均摊
5.1 四种边界的定义
| 边界 | 符号 | 含义 | 面试关注度 |
|---|---|---|---|
| 最好情况 | Ω (Omega) | 最低可能时间 | 低 |
| 最坏情况 | O (Big O) | 最高可能时间 | 最高 |
| 平均情况 | Θ (Theta) | 随机输入的期望 | 中 |
| 均摊 | — | 连续操作的平均 | 中 |
5.2 经典案例:快速排序的边界
// 快速排序

void quickSort(int[ ] arr, int lo, int hi) {

    if (lo >= hi) return;
    int p = partition(arr, lo, hi);  // O(n) 的划分
    quickSort(arr, lo, p-1);
    quickSort(arr, p+1, hi);
}
| 情况 | 复杂度 | 条件 |
|---|---|---|
| 最好 | O(n log n) | 每次 pivot 恰好是中位数 |
| 平均 | O(n log n) | 随机 pivot |
| 最坏 | O(n²) | 每次 pivot 是最大/最小值(已排序数组) |
工程实践:JDK 的 Arrays.sort() 对基本类型用双轴快排(Dual-Pivot QuickSort),对对象类型用 TimSort(归并+插入的混合)。双轴快排虽然在理论上最坏仍是 O(n²),但通过随机化和双轴选择,实际中极难触发。
5.3 经典案例:HashMap 的边界
HashMap<String, Integer> map = new HashMap<>();
map.put("key", 1);  // 复杂度?
| 情况 | 复杂度 | 条件 |
|---|---|---|
| 最好/平均 | O(1) | 哈希分布均匀,无冲突 |
| 最坏 | O(log n) | JDK 8+,桶内形成红黑树(≥8 个冲突) |
| 最坏(JDK 7) | O(n) | 桶内是链表,冲突严重 |
均摊:put 操作均摊 O(1),因为扩容的 rehash 代价被摊薄。
5.4 为什么面试官关注最坏情况
- SLA 保障:你的 API 承诺 99 分位延迟 < 100ms,最坏情况 O(n²) 的算法在恶意输入下可能直接击穿这个承诺
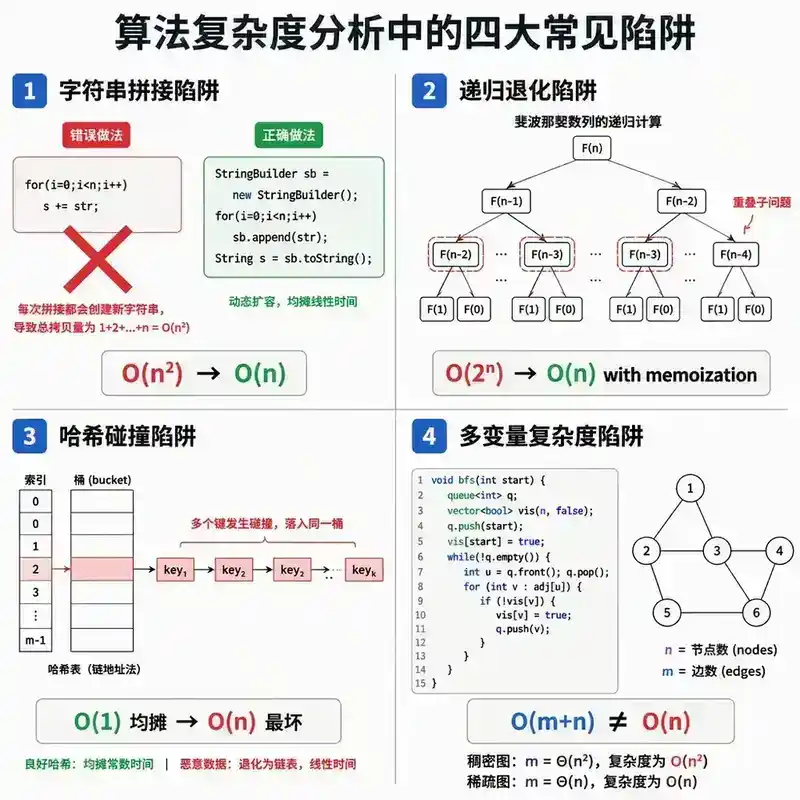
- 安全攻击:哈希碰撞攻击可以构造恶意输入让 HashMap 退化为 O(n),导致 CPU 打满(DoS 攻击)
- 用户体验:用户不会关心"平均很快",他们只记得"那一次转圈转了 10 秒"
六、复杂度分析的工程视角
6.1 理论 vs 工程的差距
算法课上教的复杂度,和实际生产环境的表现,存在一些关键差异:
常数系数很重要:
- 两个 O(n log n) 的排序算法,一个常数是 2,另一个是 20,在 n=100 万时差 10 倍
- 这也是为什么 JDK 会对小数组切到插入排序(O(n²) 但常数极小)
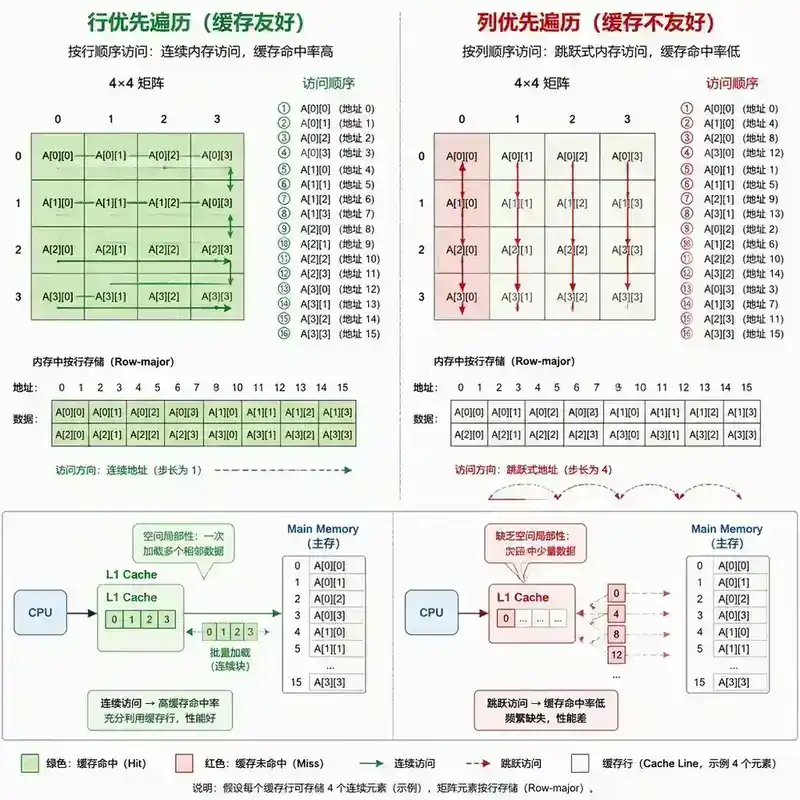
缓存友好性:
- 数组遍历 O(n) 快于链表遍历 O(n),因为 CPU 缓存行预取
- 顺序访问比随机访问快 10-100 倍
实际数据分布:
- 理论上的"平均情况"假设均匀随机分布
- 实际数据往往有倾斜、聚集、时序特征
6.2 常见复杂度陷阱
陷阱一:隐藏的 O(n)
// 你以为这是 O(1)?
String s = "hello";
for (int i = 0; i < n; i++) {
    s += "!";  // 每次 += 创建新 String,复制全部字符 → O(n²)
}
// 正确做法:用 StringBuilder,均摊 O(n)
陷阱二:嵌套循环不等于 O(n²)
// 这真的是 O(n²) 吗?
int i = 1;
while (i < n) {
    for (int j = 0; j < i; j++) {
        compute();  // 执行次数:1 + 2 + 4 + 8 + ... + n = 2n-1 = O(n)
    }
    i *= 2;
}
// 总复杂度 O(n)!因为 i 每次翻倍,内层循环执行次数是等比数列求和
陷阱三:递归中的重复计算
// 斐波那契的朴素递归
int fib(int n) {
    if (n <= 1) return n;
    return fib(n-1) + fib(n-2);  // O(2ⁿ)!大量重复计算
}
// 正确做法:DP 或记忆化搜索,O(n)
陷阱四:容器方法的时间复杂度
// ArrayList 的 contains → O(n)(线性查找)
// HashSet 的 contains → O(1)(哈希查找)
// TreeSet 的 contains → O(log n)(红黑树查找)

// 别在循环里用 ArrayList.contains 查重,会导致 O(n²)
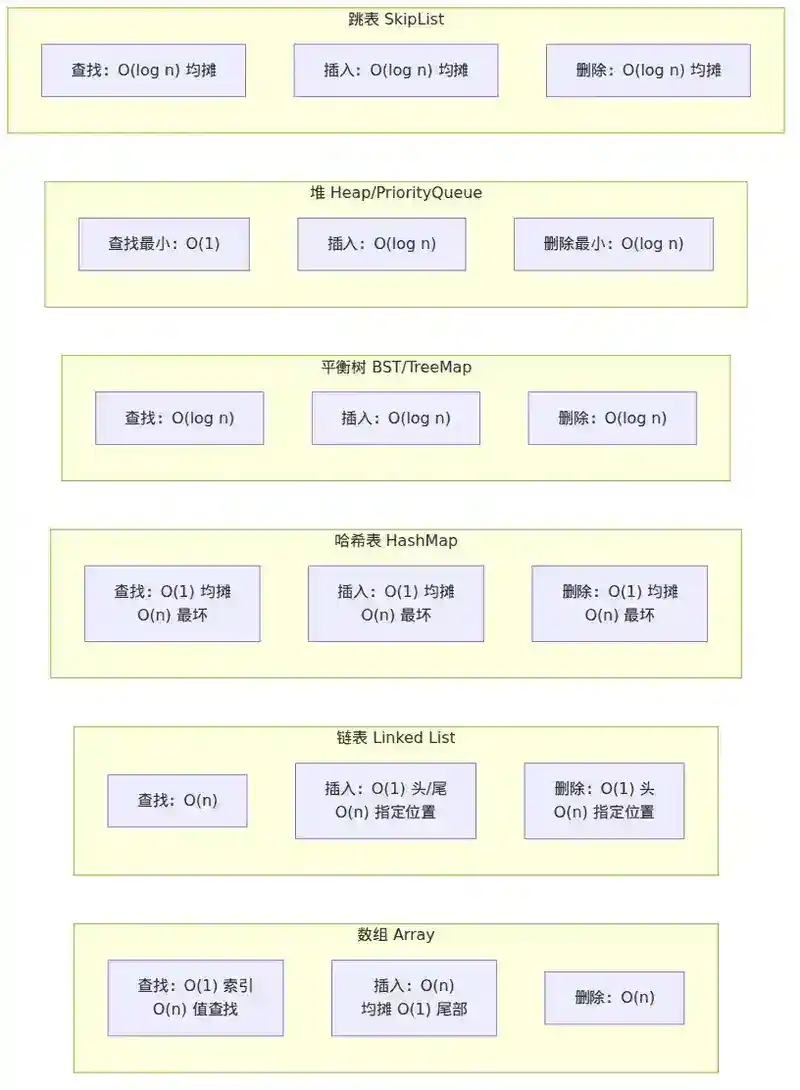
6.3 Java 集合框架复杂度速查表
| 操作 | ArrayList | LinkedList | HashSet | TreeSet | HashMap | TreeMap |
|---|---|---|---|---|---|---|
| 随机访问 | O(1) | O(n) | — | — | O(1) | O(log n) |
| 头插入 | O(n) | O(1) | O(1) | O(log n) | O(1) | O(log n) |
| 尾追加 | O(1)* | O(1) | O(1) | O(log n) | O(1) | O(log n) |
| 查找 | O(n) | O(n) | O(1) | O(log n) | O(1) | O(log n) |
| 删除 | O(n) | O(n) | O(1) | O(log n) | O(1) | O(log n) |
- 尾追加均摊 O(1),触发扩容时单次 O(n)
七、算法设计中的复杂度权衡
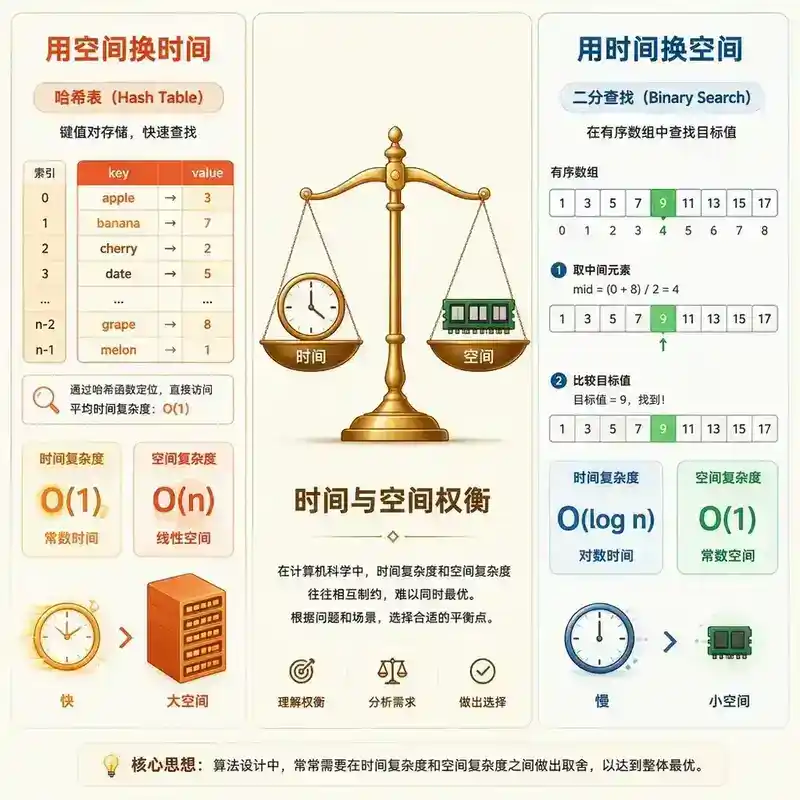
7.1 时间换空间 vs 空间换时间
| 策略 | 手段 | 案例 |
|---|---|---|
| 时间换空间 | 重复计算,不缓存 | 不存中间结果,每次重新算 |
| 空间换时间 | 缓存、预计算 | HashMap 做查找表、DP 数组、Memcached |
经典权衡:
- 动态规划:用 O(n) 空间把 O(2ⁿ) 降到 O(n) 时间
- 布隆过滤器:用少量空间 + 允许误判,换取 O(1) 的"可能存在"判断
- 数据库索引:用额外的存储空间,把 O(n) 的全表扫描降到 O(log n) 的索引查找
7.2 分布式系统中的复杂度
在分布式环境中,复杂度分析需要额外考虑:
网络通信次数:
- 两阶段提交(2PC):O(1) 轮通信,但阻塞
- Paxos 基本协议:O(n²) 消息,Multi-Paxos 优化到 O(n)
- Gossip 协议:O(log n) 轮收敛,每轮 O(1) 消息
数据分片后的复杂度:
- 单库单表的 O(n) 查询,分库分表后可能变成 O(n) × O(m) 的跨库聚合
- 排序在分片后不再是 O(n log n),因为需要额外合并
八、面试追问:你能答上来吗
以下问题从面试官视角设计,考察的是"理解"而非"背诵"。
Q1:为什么 JDK 8 中 HashMap 的链表转红黑树阈值是 8,而不是更早或更晚?
参考答案(点击展开)
这涉及概率和性能的权衡。在哈希分布均匀的前提下,一个桶中元素个数服从泊松分布,λ = 0.5(默认负载因子 0.75 时),出现 8 个元素的概率约为 0.00000006(千万分之六)。
如果阈值太小(如 3),红黑树化的代价(额外的内存和旋转操作)超过了链表遍历的代价——链表遍历 3 个元素只需 O(3),而红黑树需要维护树结构。如果阈值太大(如 20),链表遍历退化为 O(20),性能损失明显。
阈值 8 是平衡点:99.999994% 的情况下用链表(O(1) 遍历),极少数冲突严重时才转红黑树(O(log n) 查找)。此外,退化回链表的阈值是 6,留出 2 的缓冲区避免频繁转换。
Q2:你设计了一个 O(n log n) 的算法,同事设计了一个 O(n) 的算法,但实际压测你的反而更快,可能是什么原因?
参考答案(点击展开)
- 常数系数差异:O(n) 算法的常数可能是 1000,而 O(n log n) 的常数是 2,在 n < 2^500 时后者更快
- 缓存友好性:O(n log n) 的算法(如归并排序)可能顺序访问内存,而 O(n) 的算法(如基数排序)随机访问
- 内存分配:O(n) 算法可能有大量对象创建和 GC 开销
- 数据规模:n 不够大,对数项还未体现。n=100 时,log n ≈ 7,n log n=700,而 O(n) 的常数若为 20,则 n log n(700) > 20n(2000)?不对,700 < 2000,所以 n log n 更快
- 实际数据分布:O(n) 的算法假设均匀分布,但实际数据有倾斜,触发了退化路径
Q3:ArrayList 扩容为什么是 1.5 倍,而不是 2 倍?
参考答案(点击展开)
如果扩容因子是 2 倍,每次扩容后释放的旧内存空间 + 新分配的空间,永远无法复用之前释放的内存(因为新空间是旧空间的 2 倍,而之前所有的旧空间加起来 = 1 + 2 + 4 + ... + n/2 = n-1,小于 n)。这会导致内存碎片和无法复用。
1.5 倍(或黄金比例 1.618)的巧妙之处在于:经过几次扩容后,之前释放的内存碎片可以拼接起来复用。数学上,等比数列 k + k² + k³ + ... 要能覆盖 k⁴,需要 k² ≥ k + 1,即 k² - k - 1 ≥ 0,解得 k ≥ (1+√5)/2 ≈ 1.618。1.5 虽然略小于理想值,但实际效果已经很好,且整数运算更简单。
Q4:一个算法的时间复杂度是 O(n),但在生产环境中,输入规模 n 从 1 万涨到 2 万,RT 却从 10ms 涨到了 50ms,而不是预期的 20ms。为什么?
参考答案(点击展开)
- GC 参与:n 翻倍导致内存使用翻倍,可能触发了 GC 停顿,Minor GC 甚至 Full GC 都会增加 RT
- JIT 编译阈值:n=1 万时可能还未触发 C2 编译,n=2 万时刚好触发,编译本身的时间算在了 RT 里
- 缓存失效:n 翻倍后数据量超过了 L3 缓存大小,导致大量缓存未命中,内存访问延迟从纳秒级跳到百纳秒级
- 操作系统调度:n 翻倍导致 CPU 时间片用尽,触发了上下文切换
- 内存带宽瓶颈:数据量超过内存带宽,CPU 等待数据
这就是为什么复杂度分析需要在"微观"层面做验证——Big O 给你趋势,但拐点在哪里,需要结合系统参数。
Q5:设计一个能 O(1) 时间获取最小值、O(1) 均摊时间 push/pop 的栈(MinStack)。分析你的空间复杂度。
参考答案(点击展开)
思路:维护两个栈,一个存数据,一个存当前最小值。
class MinStack {
    Deque<Integer> stack = new ArrayDeque<>();
    Deque<Integer> minStack = new ArrayDeque<>();

    void push(int x) {
        stack.push(x);
        int min = minStack.isEmpty() ? x : Math.min(x, minStack.peek());
        minStack.push(min);
    }

    void pop() {
        stack.pop();
        minStack.pop();
    }

    int top() { return stack.peek(); }
    int getMin() { return minStack.peek(); }
}
时间复杂度:push/pop/getMin 都是 O(1)。 空间复杂度:O(n),两个栈各存 n 个元素。
优化空间:minStack 只在最小值变化时 push,节省空间但均摊复杂度不变。
void push(int x) {
    stack.push(x);
    if (minStack.isEmpty() || x <= minStack.peek())
        minStack.push(x);
}
void pop() {
    if (stack.pop().equals(minStack.peek()))
        minStack.pop();
}
优化后空间复杂度仍为 O(n)(最坏递减序列),但平均空间更优。
Q6:为什么说"在 32GB 堆内存以下,JVM 自动开启指针压缩",这跟复杂度分析有什么关系?
参考答案(点击展开)
32GB 对应 2³⁵ 字节。指针压缩将 8 字节引用压缩为 4 字节(32 位),4 字节可寻址 2³² = 4GB。但 Java 对象地址是 8 字节对齐的,低 3 位始终为 0,所以实际可寻址 2³² × 8 = 32GB。
与复杂度分析的关系:
- 空间复杂度:4 字节引用 vs 8 字节引用,在 O(n) 空间的数据结构中,n 个引用就差了 4n 字节。HashMap 有 n 个 Entry 对象,每个都有 3 个引用(key, value, next),差 12n 字节
- 容量规划:设计一个缓存系统,如果用 HashMap 存 1 亿个 KV,引用的 4 字节差距就是 1.2GB,这可能决定了是单机还是分布式
- 32GB 边界:堆内存超过 32GB 时,指针压缩失效,相同数据量内存暴涨约 20-30%,这是架构师评估系统容量时必须考虑的物理边界
总结
| 维度 | 核心要点 |
|---|---|
| 时间复杂度 | 增长趋势,忽略常数和低阶项,嵌套相乘、顺序取最大 |
| 空间复杂度 | 额外分配的内存,包括递归栈、辅助数组、容器开销 |
| 均摊分析 | 单次最坏 ≠ 总体最坏,扩容类操作摊到 O(1) |
| 性能边界 | 面试关注最坏情况,工程关注最坏+平均+实际数据分布 |
| 工程实践 | 常数系数、缓存友好性、JVM 内存模型都会影响实际表现 |
一条金句:复杂度分析不是让你算出精确的毫秒数,而是让你在写代码之前,就能判断这个方案在目标数据规模下能不能活下来。
下篇预告:考点 242|链表、栈、队列与堆:典型操作、复杂度和工程应用