引言:为什么 MyBatis 的动态 SQL 比拼接字符串更安全
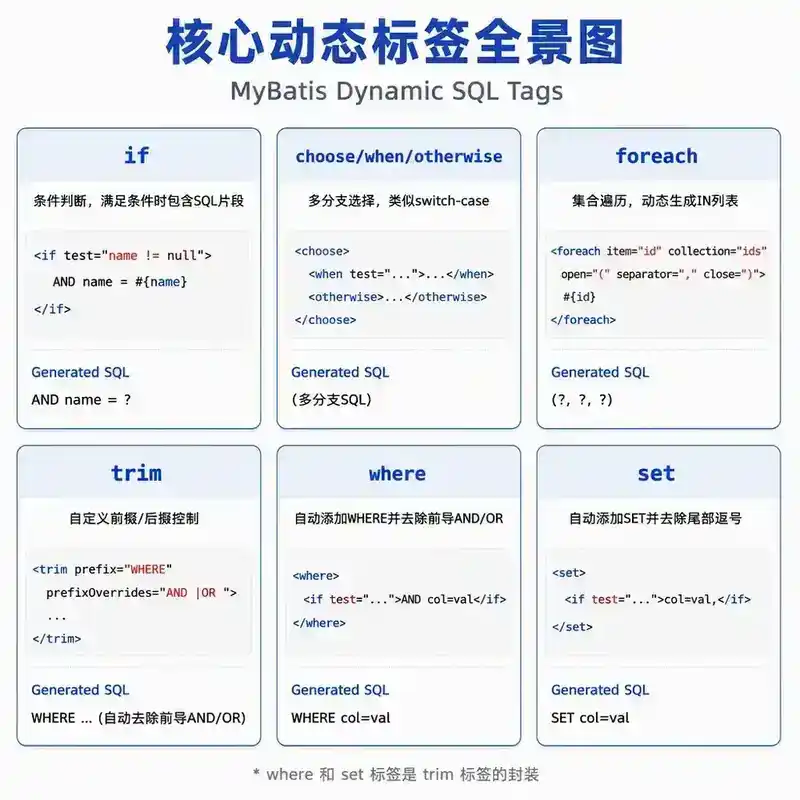
在 JDBC 时代,动态 SQL 是通过字符串拼接完成的:"SELECT * FROM user WHERE 1=1 " + (name != null ? "AND name = '" + name + "'" : "")。这种写法有三个问题:SQL 注入风险、代码可读性差、多条件组合时括号和空格极易出错。MyBatis 的动态 SQL 标签(<if>、<choose>、<foreach>、<trim>、<where>、<set>)解决的正是这三个问题——它用声明式标签代替字符串拼接,所有参数通过 #{} 预编译,最终生成的 SQL 由 MyBatis 的 SqlNode 解析器在运行时动态构建。这篇文章从 OGNL 表达式引擎到每个动态标签的实现原理,再到工程中常见的性能陷阱,把 MyBatis 动态 SQL 完整拆开。
一、动态 SQL 的底层引擎:OGNL 表达式与 SqlNode 解析树
OGNL 表达式
MyBatis 动态标签中的 test 属性(如 <if test="name != null">)使用的是 OGNL(Object-Graph Navigation Language)表达式。OGNL 是一种表达式语言,支持:属性访问(user.name)、方法调用(name.trim())、逻辑运算(&&、||、!)、比较运算(==、!=、>、<)、集合操作(list.size() > 0)。
OGNL 在 MyBatis 中的执行上下文是 DynamicContext,它持有当前 SQL 的参数对象(parameterObject)。当执行 <if test="name != null"> 时,OGNL 从 parameterObject 中解析 name 属性,判断其是否为 null。
SqlNode 解析树
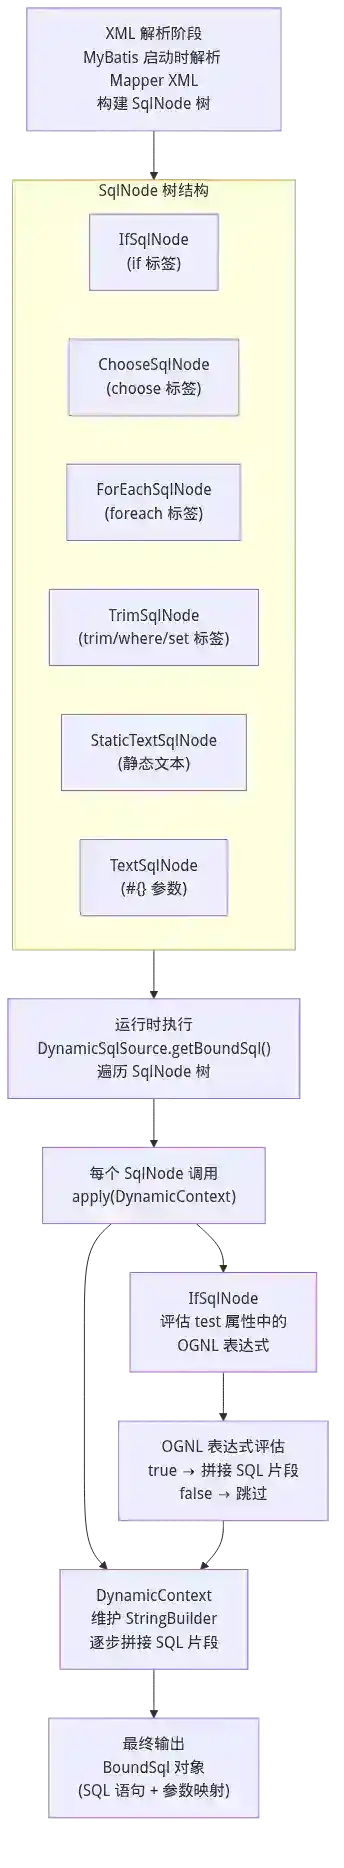
MyBatis 在启动时解析 XML 中的动态 SQL 标签,将其构建为一棵 SqlNode 树。每个动态标签对应一个 SqlNode 实现:
| 标签 | SqlNode 实现 |
|---|---|
&lt;if&gt; |
IfSqlNode |
&lt;choose&gt;/&lt;when&gt;/&lt;otherwise&gt; |
ChooseSqlNode |
&lt;foreach&gt; |
ForEachSqlNode |
&lt;trim&gt;/&lt;where&gt;/&lt;set&gt; |
TrimSqlNode |
| 静态文本 | StaticTextSqlNode |
#{} 参数 |
TextSqlNode |
运行时,DynamicSqlSource.getBoundSql() 遍历这棵 SqlNode 树,调用每个节点的 apply(DynamicContext) 方法。DynamicContext 内部维护了一个 StringBuilder,每个 SqlNode 将解析后的 SQL 片段追加进去。最终得到一个完整的 BoundSql 对象(包含 SQL 语句和参数映射)。
关键理解:动态 SQL 在运行时解析,不在编译期
MyBatis 的动态 SQL 是运行时解析的,不是编译期。这意味着每次执行动态 SQL 时,SqlNode 树都会被重新遍历。如果 SQL 模板非常复杂(嵌套多层 <if> 和 <foreach>),解析开销不可忽略。MyBatis 对 TextSqlNode 做了缓存(#{} 参数解析结果会被缓存),但 IfSqlNode 和 ForEachSqlNode 每次都需要重新评估 OGNL 表达式。
二、核心标签详解
:条件判断
<select id="findUsers" resultType="User">
  SELECT * FROM user
  WHERE 1=1
  <if test="name != null and name != ''">
    AND name = #{name}
  </if>
  <if test="age != null">
    AND age = #{age}
  </if>
</select>
test 属性中的表达式会被 OGNL 解析。WHERE 1=1 是一个常见的"占位符"写法——保证后续的 AND 条件在任何情况下都能正确拼接。但这个写法不够优雅,<where> 标签可以替代它。
:自动处理 AND/OR 前缀
<select id="findUsers" resultType="User">
  SELECT * FROM user
  <where>
    <if test="name != null">
      AND name = #{name}
    </if>
    <if test="age != null">
      AND age = #{age}
    </if>
  </where>
</select>
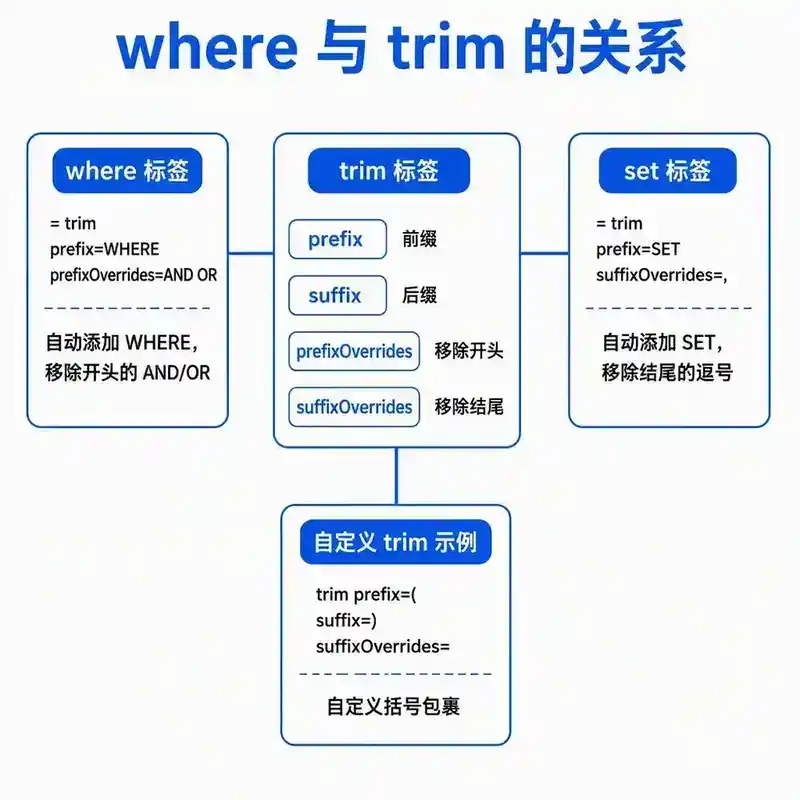
<where> 做了两件事:如果内部至少有一个条件成立,在开头插入 WHERE 关键字;自动移除内部第一个条件前的 AND 或 OR(但不移除中间的)。如果内部所有条件都不成立,<where> 不会输出任何内容(包括 WHERE 关键字),避免 SELECT * FROM user WHERE 这种语法错误。
:多分支选择
<select id="findUsers" resultType="User">
  SELECT * FROM user
  <where>
    <choose>
      <when test="name != null">
        AND name = #{name}
      </when>
      <when test="email != null">
        AND email = #{email}
      </when>
      <otherwise>
        AND status = 'ACTIVE'
      </otherwise>
    </choose>
  </where>
</select>
<choose> 类似于 Java 的 switch-case-default:按顺序评估每个 <when> 的 test 条件,第一个满足的 <when> 生效,其余跳过;如果所有 <when> 都不满足,执行 <otherwise>。
:集合遍历
<select id="findByIds" resultType="User">
  SELECT * FROM user
  WHERE id IN
  <foreach item="id" collection="ids" open="(" separator="," close=")">
    #{id}
  </foreach>
</select>
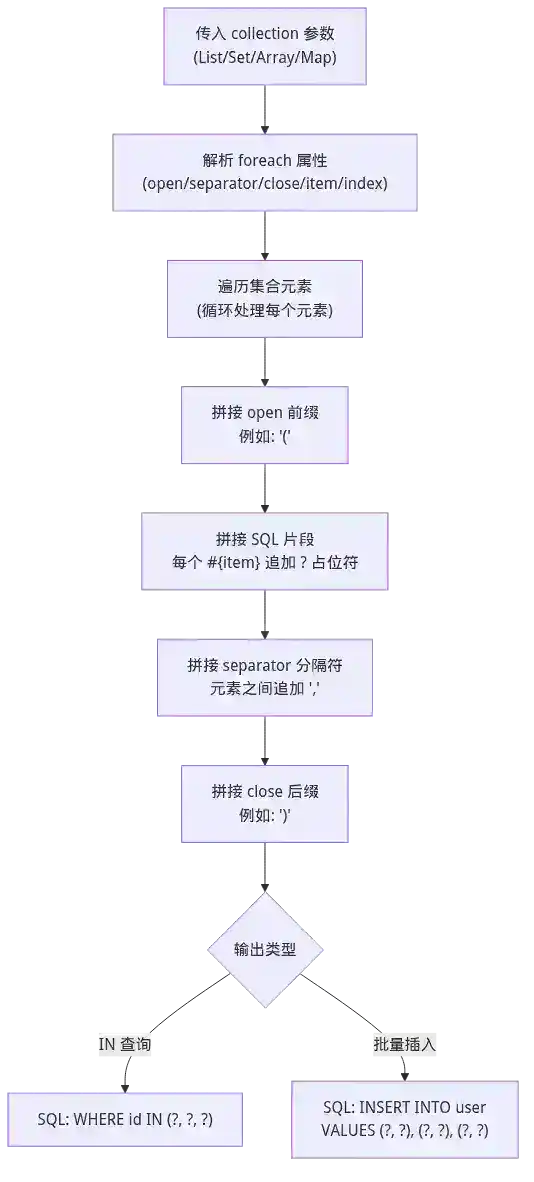
<foreach> 的参数:
| 属性 | 说明 |
|---|---|
collection |
要遍历的集合,支持 List、Set、数组、Map(遍历 Map 的 values) |
item |
当前元素的变量名 |
index |
当前索引的变量名(Map 时为 key) |
open |
遍历前追加的字符串 |
separator |
元素间的分隔符 |
close |
遍历后追加的字符串 |
生成的 SQL 类似:SELECT * FROM user WHERE id IN (?, ?, ?)。
的批量插入场景
<insert id="batchInsert">
  INSERT INTO user (name, age) VALUES
  <foreach collection="users" item="user" separator=",">
    (#{user.name}, #{user.age})
  </foreach>
</insert>
生成的 SQL 类似:INSERT INTO user (name, age) VALUES (?, ?), (?, ?), (?, ?)。
:自定义前缀/后缀移除
<trim> 是 <where> 和 <set> 的底层实现标签。它有四个属性:
| 属性 | 说明 |
|---|---|
prefix |
在内部内容前追加的字符串 |
suffix |
在内部内容后追加的字符串 |
prefixOverrides |
移除内部内容开头的指定字符串 |
suffixOverrides |
移除内部内容结尾的指定字符串 |
<where> 本质上就是 <trim prefix="WHERE" prefixOverrides="AND |OR ">。<set> 本质上就是 <trim prefix="SET" suffixOverrides=",">。
:动态 UPDATE
<update id="updateUser">
  UPDATE user
  <set>
    <if test="name != null">name = #{name},</if>
    <if test="age != null">age = #{age},</if>
  </set>
  WHERE id = #{id}
</update>
<set> 做了两件事:在内部内容前插入 SET 关键字;自动移除末尾的逗号。如果所有 <if> 都不满足,<set> 不会输出任何内容——但 WHERE id = #{id} 仍然存在,SQL 变成 UPDATE user WHERE id = ?,这会导致 SQL 语法错误。工程上通常在外层再加一个 <if> 判断确保至少有一个字段被更新。
三、 与 在动态 SQL 中的行为差异
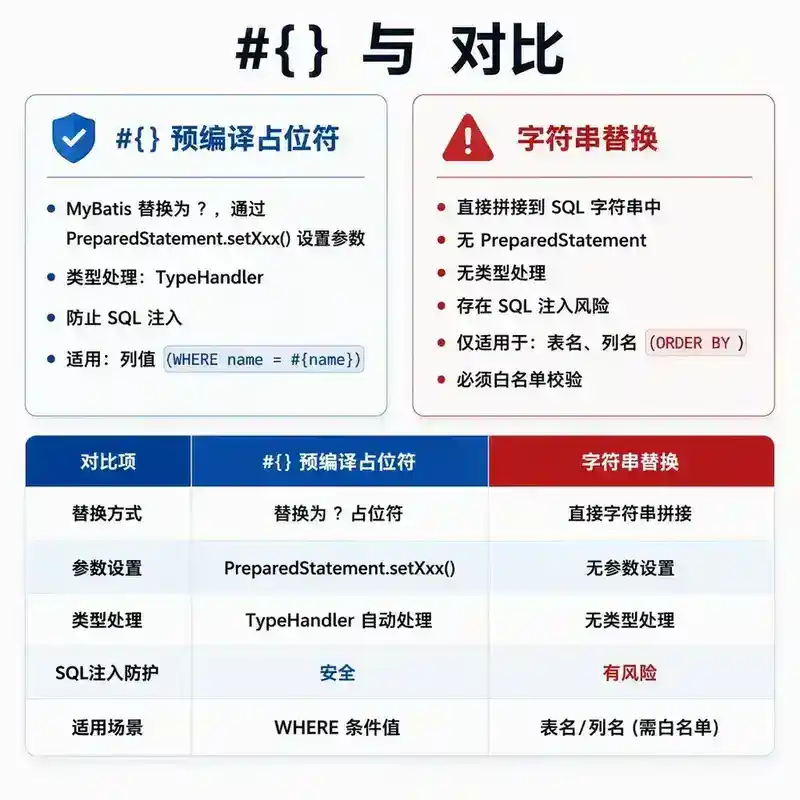
是预编译占位符
<select id="findByName" resultType="User">
  SELECT * FROM user WHERE name = #{name}
</select>
#{name} 被替换为 ?,参数通过 PreparedStatement.setString() 设置。MyBatis 在解析 #{} 时,通过 GenericTokenParser 提取占位符内容,替换为 ?,然后通过 ParameterMapping 对象记录参数的类型和属性名。
是字符串替换
<select id="findByOrder" resultType="User">
  SELECT * FROM user ORDER BY ${column}
</select>
${column} 被直接替换为参数值(如 name),不做预编译。${} 有 SQL 注入风险,只应在参数来自白名单校验时使用。
动态表名、列名必须用
<select id="findByTable" resultType="User">
  SELECT * FROM ${tableName} WHERE id = #{id}
</select>
SELECT * FROM ? WHERE id = ? 是语法错误——表名不能用 ? 占位符。这种场景下必须用 ${},但 tableName 必须来自白名单校验,不能直接来自用户输入。
四、 与 :SQL 片段复用
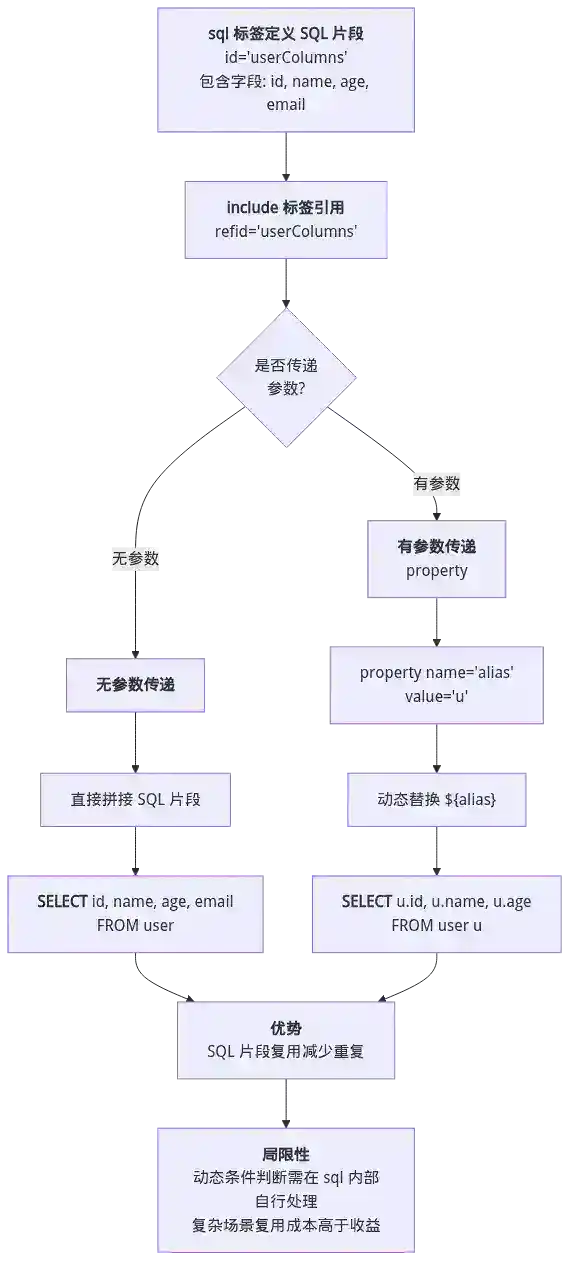
<sql id="userColumns">
  id, name, age, email, status
</sql>

<select id="findAll" resultType="User">
  SELECT <include refid="userColumns"/> FROM user
</select>
<include> 支持传参(通过 <property> 子标签),可以在引用的 SQL 片段中使用 ${} 动态替换:
<sql id="userColumns">
  ${alias}.id, ${alias}.name, ${alias}.age
</sql>

<select id="findAll" resultType="User">
  SELECT <include refid="userColumns"><property name="alias" value="u"/></include>
  FROM user u
</select>
五、动态 SQL 的性能陷阱
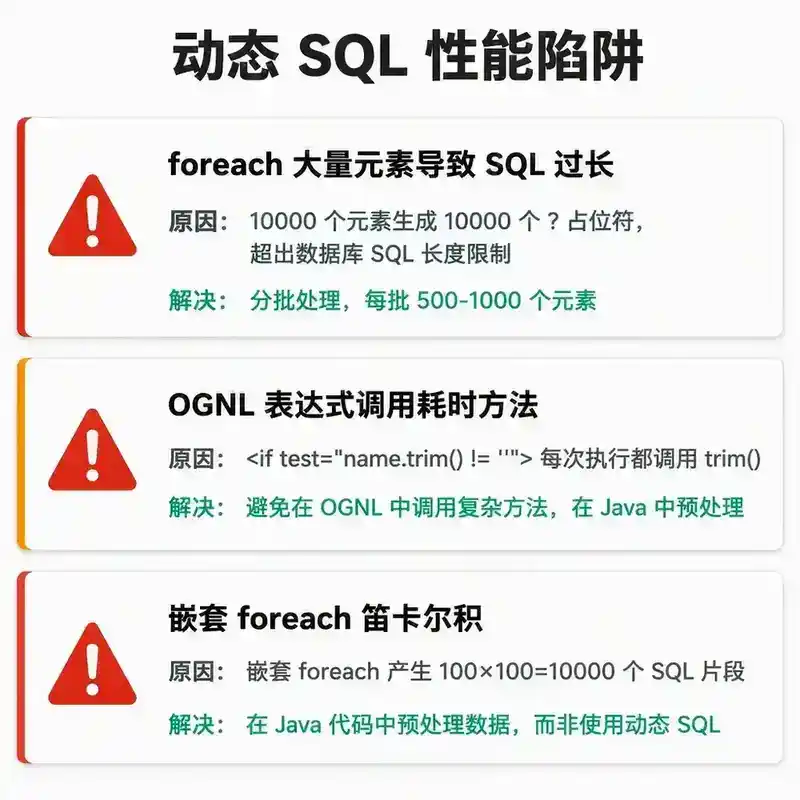
陷阱一: 中大量元素导致 SQL 过长
<foreach> 生成的 SQL 中,每个元素对应一个 ? 占位符。如果集合有 10000 个元素,生成的 SQL 会有 10000 个 ?,SQL 语句本身可能超过数据库的 SQL 长度限制(MySQL 默认 max_allowed_packet 为 4MB)。解决方案:分批处理,每批 500~1000 条。
陷阱二:OGNL 表达式中的方法调用
<if test="name != null and name.trim() != ''"> 中的 name.trim() 每次执行都会调用。如果这个方法有副作用或者耗时,会影响性能。OGNL 表达式中应避免调用复杂方法,只做简单的属性访问和逻辑判断。
陷阱三:嵌套 的笛卡尔积
两个嵌套的 <foreach> 会生成大量 SQL 片段。例如:
<foreach collection="list1" item="a">
  <foreach collection="list2" item="b">
    (#{a}, #{b})
  </foreach>
</foreach>
如果 list1 有 100 个元素,list2 有 100 个元素,会生成 10000 个 (?, ?) 占位符。这种场景应该用 Java 代码预处理数据,而不是用动态 SQL。
六、 标签:OGNL 表达式创建变量
<select id="findByName" resultType="User">
  <bind name="pattern" value="'%' + name + '%'"/>
  SELECT * FROM user WHERE name LIKE #{pattern}
</select>
<bind> 使用 OGNL 表达式创建一个新变量,可以在后续的 SQL 中使用 #{} 引用。这在需要字符串拼接(如 LIKE 模糊查询)时非常有用,可以避免在 Java 代码中手动拼接 %。
小结:动态 SQL 是声明式编程在数据库操作中的实践
动态 SQL 的本质是:用声明式标签描述"在什么条件下生成什么 SQL 片段",而不是用命令式代码拼接字符串。这种声明式设计的优势在于:SQL 的结构在 XML 中一目了然,不需要在 Java 代码中脑补拼接后的完整 SQL;参数通过 #{} 预编译,天然防止 SQL 注入;标签之间可以嵌套组合,表达能力不弱于代码拼接。理解动态 SQL 的关键,不是记住每个标签的用法,而是理解 SqlNode 解析树的构建和执行机制——这能帮你在遇到"生成的 SQL 不符合预期"时,快速定位是哪个标签的 OGNL 表达式评估结果不对。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:**<where>**标签会自动移除第一个**AND**,但如果我的 SQL 是**OR name = #{name} OR age = #{age}**,**<where>**会移除第一个**OR**吗?
答:会。<where> 的 prefixOverrides 默认值是 AND |OR ,所以它会移除内部内容开头的 AND、OR、AND (带空格)、OR (带空格)。但这个移除是机械的字符串匹配,不是语法分析——它只会移除开头的第一个匹配项。如果条件是 AND name = #{name} AND age = #{age},只移除第一个 AND,第二个 AND 保留。如果开头是 AND(name = #{name} OR age = #{age})(AND 后面紧跟括号),AND 不会被移除,因为 AND 后面没有空格——prefixOverrides 匹配的是 AND (带空格)这个完整字符串。
问 2:**<foreach>**标签的**collection**属性支持传入 Map 吗?如果传入 Map,**item**和**index**分别代表什么?
答:支持。当 collection 是 Map 时,index 是 Map 的 key,item 是 Map 的 value。例如:<foreach collection="map" item="value" index="key"> 中,#{key} 获取 Map 的 key,#{value} 获取 Map 的 value。如果传入的是 List,index 是当前元素的索引(从 0 开始),item 是当前元素。如果传入的是数组,行为和 List 相同。
问 3:如果**<if test="name != null">**中的**name**是**String**类型,**name != ''**和**name != null**有什么区别?MyBatis 内部怎么处理空字符串的?
答:OGNL 表达式 name != null 只判断是否为 null,name != '' 只判断是否为空字符串。两者是独立的:null 和 "" 在 OGNL 中是不同的值。工程上通常写 name != null and name != '' 来同时判断 null 和空字符串。MyBatis 内部没有自动将空字符串转换为 null 的机制——这是常见误解。如果你希望空字符串也被跳过,必须在 OGNL 表达式中显式写 name != null and name != '',或者在 Java 代码中将空字符串预处理为 null。
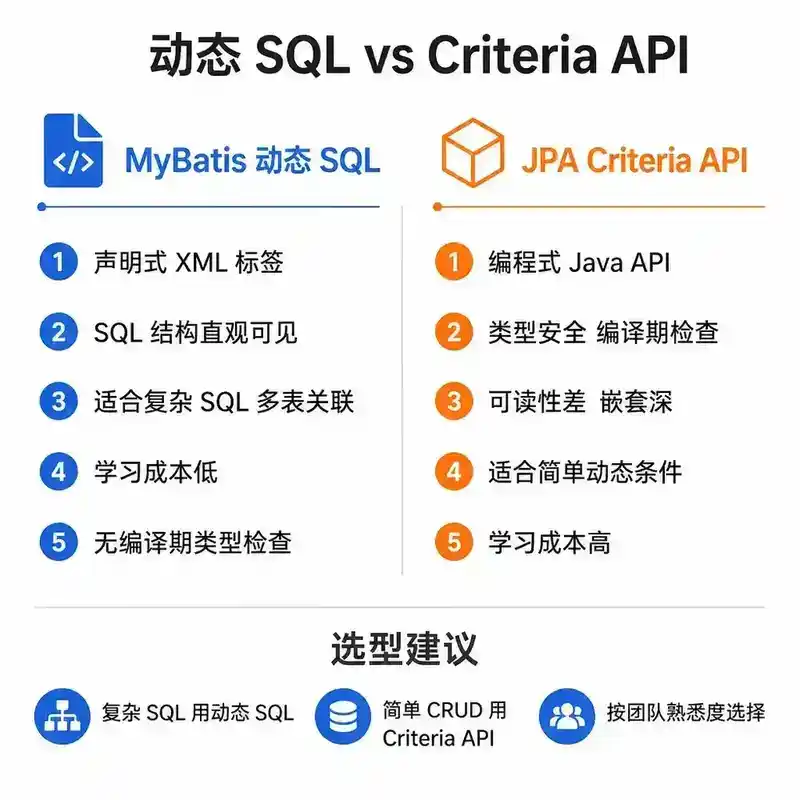
问 4:MyBatis 的动态 SQL 和 JPA 的 Criteria API 有什么区别?什么场景下你会选择动态 SQL 而不是 Criteria API?
答:MyBatis 的动态 SQL 是声明式标签,在 XML 中编写,SQL 结构直观可见,适合需要精确控制 SQL 的场景(如复杂报表查询、多表关联、特定数据库优化)。JPA Criteria API 是编程式 API,用 Java 代码构建查询,类型安全(编译期检查),但可读性差(嵌套很深)。动态 SQL 适合"SQL 本身就很复杂"的场景,Criteria API 适合"查询条件简单、需要类型安全"的场景。如果你在面试中能说出"动态 SQL 更适合写复杂 SQL,因为你可以直接在 XML 中看到完整的 SQL 结构,而 Criteria API 需要用代码脑补生成的 SQL",这比单纯说"动态 SQL 更好用"更有说服力。
问 5:**<sql>**和**<include>**的 SQL 片段复用,在复杂场景下有什么局限性?如果 SQL 片段中需要根据条件动态改变,怎么处理?
答:<sql> 和 <include> 的局限性在于:<sql> 片段中的 ${} 变量只能在 <include> 时通过 <property> 传入,不能在运行时根据 OGNL 表达式动态改变。如果 SQL 片段中需要条件判断,有几种方案:第一,在 <sql> 片段内部使用 <if> 标签,配合传入的参数做条件判断;第二,将 <sql> 片段设计为多个子片段,在不同场景下组合使用;第三,如果条件过于复杂,放弃 <sql> 复用,直接在每个查询中写完整的 SQL——复用的收益不是无限的,当复用导致理解和维护成本上升时,适度的冗余反而更清晰。