引言:为什么 默认是延迟加载而 默认是立即加载
JPA 的关联映射注解(@OneToOne、@OneToMany、@ManyToOne、@ManyToMany)定义了实体之间的关系。但真正让开发者困惑的不是注解本身,而是它们的默认行为:@OneToMany 默认 FetchType.LAZY(延迟加载),@ManyToOne 和 @OneToOne 默认 FetchType.EAGER(立即加载)。为什么这样设计?mappedBy 到底有什么用?级联操作 CascadeType.ALL 为什么危险?这篇文章从 JPA 关联映射的底层实现到 mappedBy 的拥有方/被拥有方关系,再到级联操作的陷阱和 N+1 问题的避免,完整拆解。
一、@ManyToOne:多对一(最常见)
基本用法
@Entity
public class Order {
    @Id @GeneratedValue
    private Long id;

    @ManyToOne(fetch = FetchType.EAGER)  // 默认 EAGER
    @JoinColumn(name = "user_id")        // 外键列名
    private User user;
}
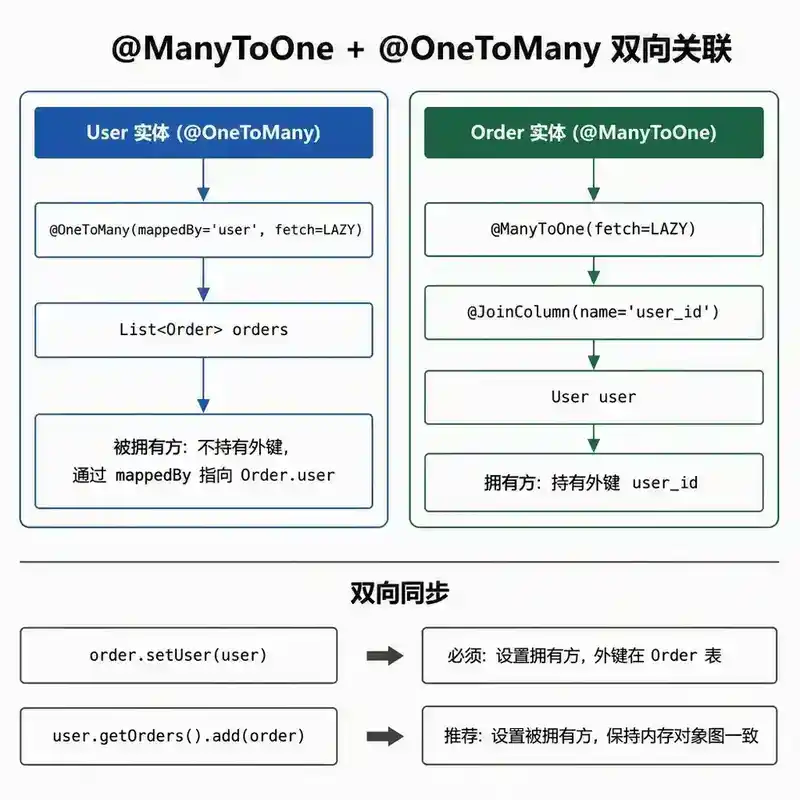
@ManyToOne 默认 FetchType.EAGER——JPA 认为"多对一"关联的对象通常需要在查询时一起加载。但如果你有 100 个 Order,每个 Order 关联了同一个 User,EAGER 加载会导致 JOIN 查询,数据冗余(User 被重复加载 100 次)。
数据库表结构
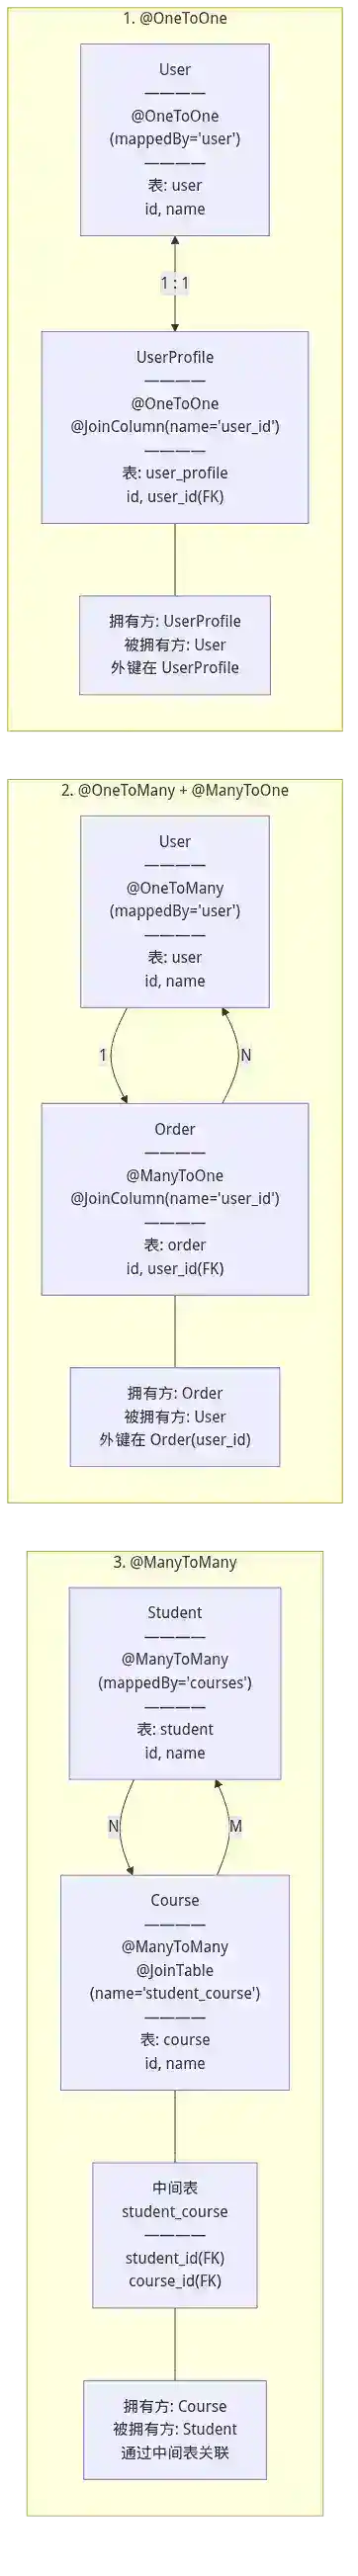
Order 表中有一个 user_id 外键列,指向 User 表的主键。@JoinColumn 指定了外键列的名称。如果不指定,默认列名为 user_id(属性名 + 下划线 + 主键列名)。
与 @OneToMany 的双向关联
@Entity
public class User {
    @OneToMany(mappedBy = "user", fetch = FetchType.LAZY)
    private List<Order> orders;
}

@Entity
public class Order {
    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "user_id")
    private User user;
}
二、@OneToMany:一对多(最易出错)
基本用法
@Entity
public class User {
    @OneToMany(mappedBy = "user", fetch = FetchType.LAZY,
               cascade = CascadeType.ALL, orphanRemoval = true)
    private List<Order> orders = new ArrayList<>();
}
@OneToMany 默认 FetchType.LAZY——JPA 认为"一对多"关联的集合可能很大,不应该默认加载。
mappedBy:拥有方与被拥有方
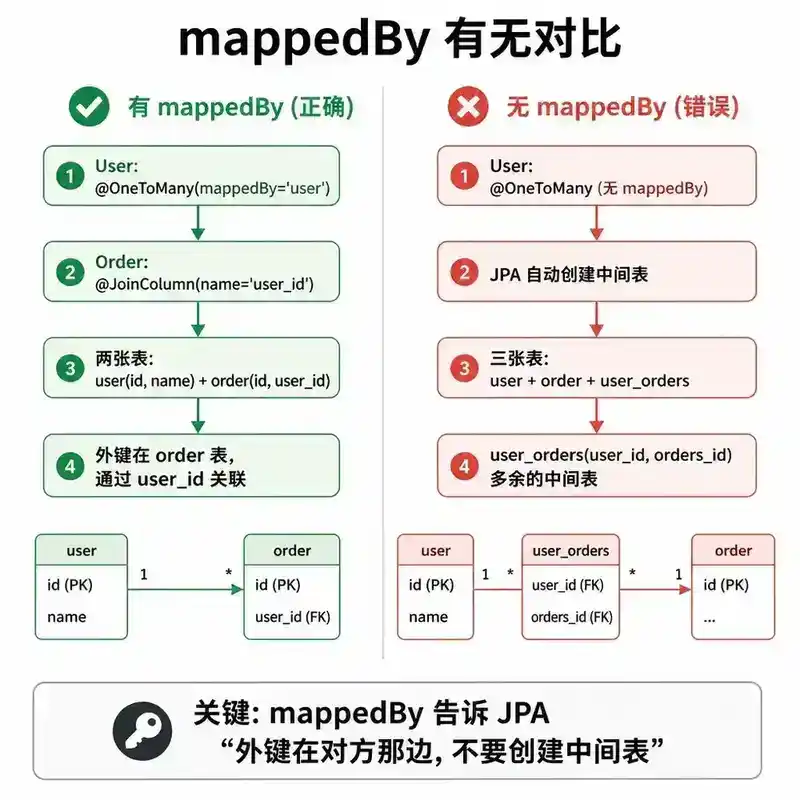
mappedBy = "user" 表示:User 不是关系的拥有方,Order 才是。关系的拥有方是持有外键的那一方(Order 表中的 user_id 列)。mappedBy 告诉 JPA:"不要在 User 表中创建外键列,外键在 Order 表的 user 属性对应的列中"。
如果不指定 mappedBy,JPA 会创建一个中间表(user_orders),这是你不想要的——因为 Order 表中已经有 user_id 外键了。
双向关联的同步问题
User user = new User();
Order order = new Order();
order.setUser(user);        // 设置拥有方
user.getOrders().add(order); // 设置被拥有方(可选,但推荐)
两个操作都需要:order.setUser(user) 是必须的(因为 Order 是拥有方,外键在 Order 表中),user.getOrders().add(order) 是可选的(但推荐,保持内存中的对象图一致性)。
orphanRemoval
orphanRemoval = true 表示:如果从 orders 集合中移除了一个 Order,并且这个 Order 没有其他 User 引用,这个 Order 会被自动删除(DELETE SQL)。这和 CascadeType.REMOVE 不同——CascadeType.REMOVE 在删除父实体时级联删除子实体,orphanRemoval 在父实体解除关联时删除子实体。
三、@OneToOne:一对一
基本用法
@Entity
public class User {
    @OneToOne(mappedBy = "user", cascade = CascadeType.ALL,
              fetch = FetchType.LAZY, optional = false)
    private UserProfile profile;
}

@Entity
public class UserProfile {
    @OneToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "user_id")  // UserProfile 表持有外键
    private User user;
}
@OneToOne 默认 FetchType.EAGER——这个默认值经常引起问题,因为一对一关联可能包含大字段(如头像、简历),不应该默认加载。建议显式设置 fetch = FetchType.LAZY。
延迟加载的限制
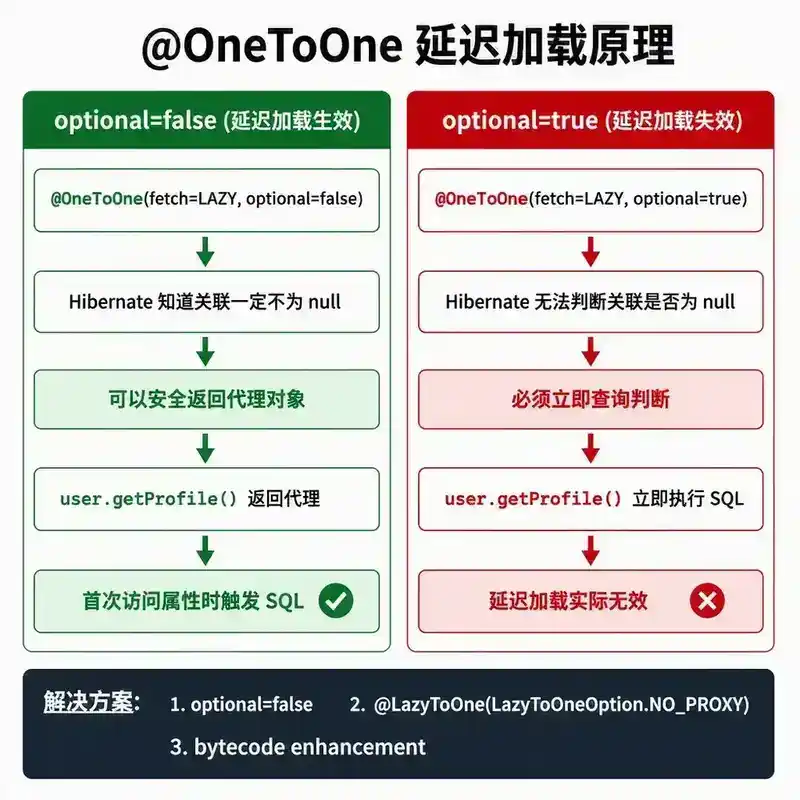
@OneToOne 的延迟加载有一个限制:如果 optional = false(关联不能为 null),Hibernate 可以使用代理对象实现延迟加载;如果 optional = true(默认),Hibernate 必须立即查询判断关联是否为 null,延迟加载失效。这个行为是 Hibernate 的实现细节,不是 JPA 规范要求的。
四、@ManyToMany:多对多
基本用法
@Entity
public class Student {
    @ManyToMany
    @JoinTable(
        name = "student_course",
        joinColumns = @JoinColumn(name = "student_id"),
        inverseJoinColumns = @JoinColumn(name = "course_id")
    )
    private Set<Course> courses = new HashSet<>();
}

@Entity
public class Course {
    @ManyToMany(mappedBy = "courses")
    private Set<Student> students = new HashSet<>();
}
@ManyToMany 通过中间表实现。@JoinTable 指定中间表的名称和列名。拥有方(Student)通过 @JoinTable 定义中间表,被拥有方(Course)通过 mappedBy 引用拥有方。
为什么用 Set 而不是 List
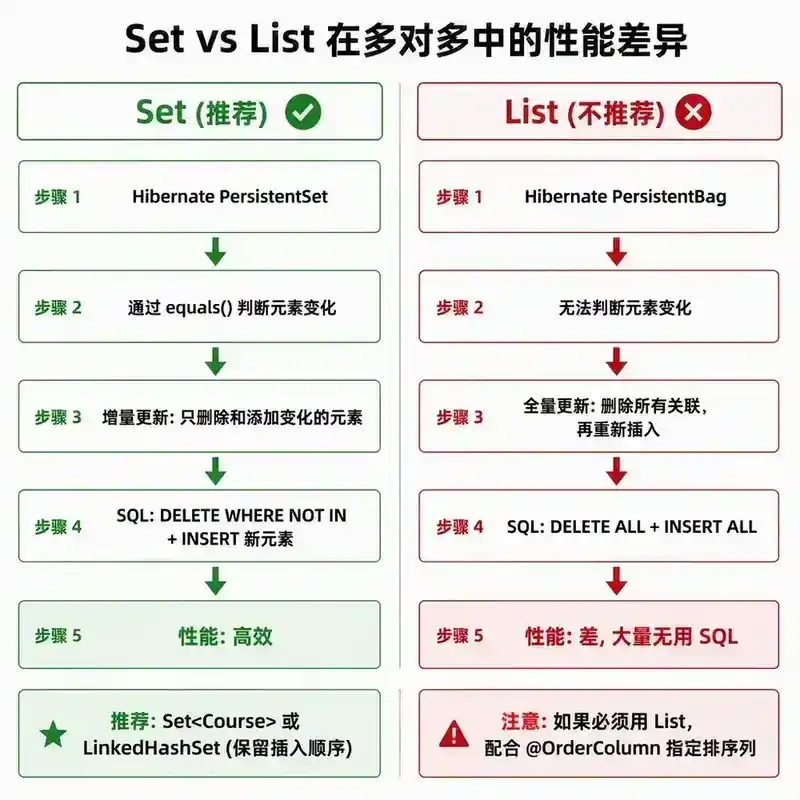
多对多关联推荐用 Set 而不是 List。原因:Hibernate 的 PersistentBag(List 的实现)在删除和重新添加元素时,会先删除所有关联再重新插入,导致不必要的 DELETE + INSERT 操作。PersistentSet 通过 equals() 和 hashCode() 判断元素是否变化,只删除和添加变化的元素。
五、级联操作(Cascade)
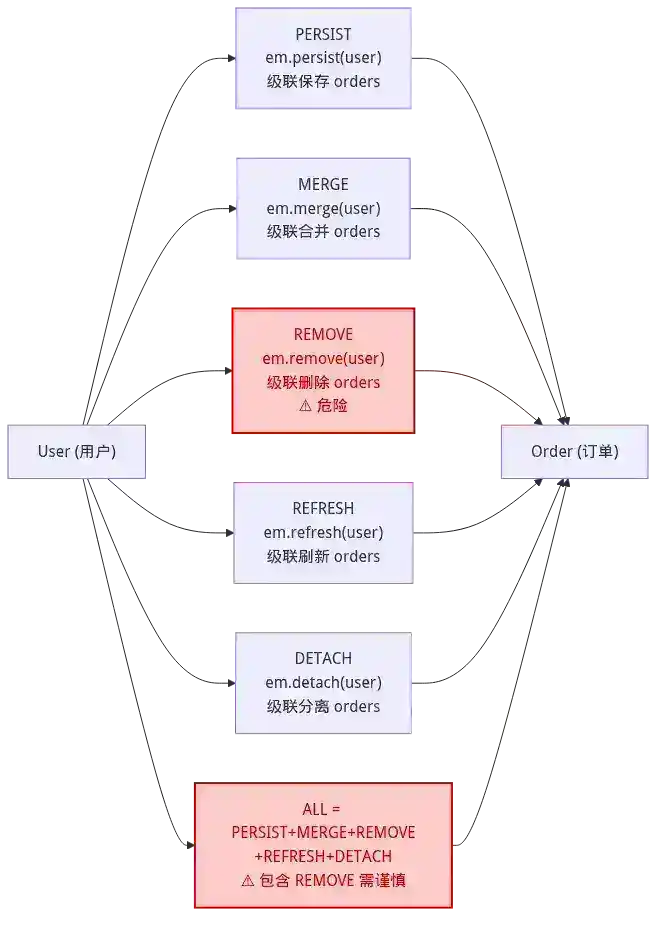
| 类型 | 说明 | 示例 |
|---|---|---|
PERSIST |
保存父实体时级联保存子实体 | em.persist(user) 自动保存 user.getOrders() |
MERGE |
合并父实体时级联合并子实体 | em.merge(user) 自动合并 user.getOrders() |
REMOVE |
删除父实体时级联删除子实体 | em.remove(user) 自动删除所有 Order |
REFRESH |
刷新父实体时级联刷新子实体 | em.refresh(user) 自动刷新 user.getOrders() |
DETACH |
分离父实体时级联分离子实体 | em.detach(user) 自动分离 user.getOrders() |
ALL |
以上全部 | 危险:em.remove(user) 会删除所有关联的 Order |
CascadeType.ALL 的危险
@OneToMany(mappedBy = "user", cascade = CascadeType.ALL)
private List<Order> orders;
如果 User 被 em.remove(),所有关联的 Order 也会被删除。如果 Order 是业务核心数据,这会导致灾难性的数据丢失。CascadeType.ALL 只应该用于"子实体生命周期完全依附于父实体"的场景(如 Order 和 OrderItem),而不是"父实体引用了子实体但子实体可以独立存在"的场景(如 User 和 Order)。
六、常见陷阱
陷阱一:mappedBy 忘记写导致中间表
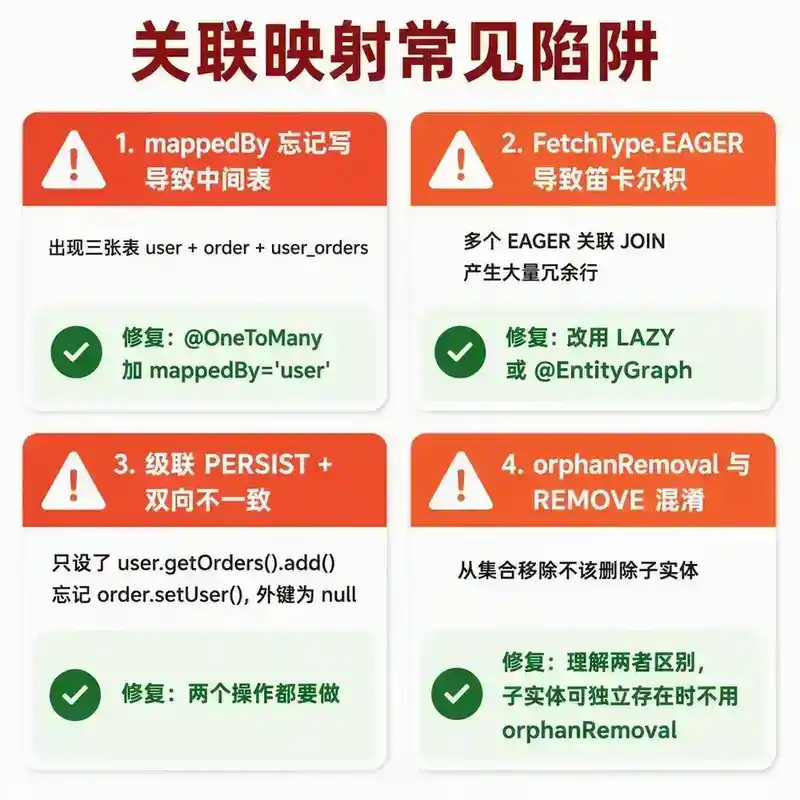
如果 @OneToMany 和 @ManyToOne 都没有写 mappedBy,JPA 会创建两张表之间多出一张中间表。排查方法:看数据库 Schema,如果出现了预期的三张表(User、Order、User_Order),说明 mappedBy 有问题。
陷阱二:FetchType.EAGER 导致笛卡尔积
如果 User 有多个 @OneToMany(fetch = EAGER) 关联,查询 User 时会产生多条 JOIN,结果集行数 = 各关联集合大小的乘积。两个 EAGER 关联集合各有 100 条数据,结果集就是 10000 行——数据冗余巨大。
陷阱三:PERSIST 级联 + 双向关联不一致
Order order = new Order();
user.getOrders().add(order);  // 设置了被拥有方
// 忘记设置 order.setUser(user);  // 拥有方没有设置!
em.persist(user);  // 级联 PERSIST 保存了 Order,但 Order 的 user_id 是 null
双向关联需要在内存中保持一致性:order.setUser(user) 和 user.getOrders().add(order) 两个操作都要做。
陷阱四:orphanRemoval 和 CascadeType.REMOVE 混淆
orphanRemoval:从集合中移除子实体 → 删除子实体。CascadeType.REMOVE:删除父实体 → 删除子实体。两者可以组合使用,但语义不同,不要混淆。
小结:关联映射的核心是"拥有方"和"级联边界"
JPA 关联映射的设计核心是两件事:关系的拥有方(谁持有外键,由 mappedBy 和 @JoinColumn 决定)和级联操作的边界(哪些操作应该从父实体传播到子实体)。理解这两件事后,你就能解释为什么 mappedBy 不能丢、为什么 CascadeType.ALL 危险、以及为什么多对多推荐用 Set。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:**@OneToMany**的**mappedBy**和**@JoinColumn**可以同时存在吗?为什么?
答:不能同时存在。mappedBy 表示"我不是关系的拥有方,外键在对方那边";@JoinColumn 表示"我是关系的拥有方,外键在我这边"。两者语义互斥。如果同时存在,Hibernate 会忽略 mappedBy 并以 @JoinColumn 为准——但这不是规范行为,不同 JPA 实现可能不同。正确做法:在"一"方(@OneToMany)用 mappedBy,在"多"方(@ManyToOne)用 @JoinColumn。
问 2:为什么 JPA 规范规定**@OneToMany**默认 LAZY 而**@ManyToOne**默认 EAGER?这个设计合理吗?
答:JPA 规范的设计考量是:@OneToMany 关联的集合可能很大(一个用户有 10000 个订单),默认 EAGER 加载会导致严重的性能问题。@ManyToOne 关联的是单个对象(一个订单只属于一个用户),默认 EAGER 加载的开销可控。但这个设计的合理性值得商榷:@ManyToOne 的 EAGER 加载在批量查询场景下会导致 N+1 问题,而且 @OneToOne 的 EAGER 默认值也经常引起问题。JPA 2.1+ 建议所有关联都显式指定 FetchType,不要依赖默认值。
问 3:**orphanRemoval = true**和**CascadeType.REMOVE**有什么区别?在什么场景下应该用**orphanRemoval**?
答:CascadeType.REMOVE:em.remove(parent) 时删除子实体。orphanRemoval = true:parent.getChildren().remove(child) 时删除子实体。orphanRemoval 的典型场景:Order 和 OrderItem——从订单中移除一个商品项,这个商品项应该被删除(因为它只属于这个订单,不存在于其他订单中)。CascadeType.REMOVE 的典型场景:删除 Order 时同时删除所有 OrderItem。两者通常组合使用:cascade = CascadeType.ALL, orphanRemoval = true。但如果子实体可以被多个父实体引用(如 Student 和 Course 的多对多关系),orphanRemoval 不应该使用——因为从 Student 的 courses 集合中移除 Course 不应该删除 Course 本身。
问 4:JPA 的**@ManyToMany**用**Set**和**List**有什么区别?为什么推荐用**Set**?
答:Set 不允许重复元素,List 允许重复。Hibernate 对 Set 使用 PersistentSet,对 List 使用 PersistentBag。PersistentBag 不支持"通过索引判断元素是否变化"——每次 merge() 时,Hibernate 会先删除所有中间表关联,再重新插入。这导致大量的 DELETE + INSERT 操作,而不是优化后的增量更新。PersistentSet 通过 equals() 和 hashCode() 判断元素变化,只删除和添加变化的元素。如果你需要保持元素的顺序,可以用 LinkedHashSet(保留插入顺序)或 @OrderBy 注解(按字段排序)。
问 5:**@OneToOne**的延迟加载为什么有时会失效?Hibernate 做了什么优化?
答:@OneToOne(fetch = LAZY) 的延迟加载在以下条件失效:关联可以为 null(optional = true,默认值)。原因:Hibernate 无法判断关联是否为 null 而不查询数据库——如果 Hibernate 返回一个代理对象,调用 user.getProfile() 时返回代理,但实际关联可能是 null,代理无法区分"null"和"未加载"。解决方案:设置 optional = false(告诉 Hibernate 关联一定不为 null),Hibernate 可以安全地返回代理对象,延迟加载生效。如果关联确实可能为 null,可以用 @LazyToOne(LazyToOneOption.NO_PROXY)(Hibernate 特有注解)或使用 bytecode enhancement 编译期织入。这是 Hibernate 的实现限制,EclipseLink 没有这个限制。