引言:逻辑分页和物理分页的根本区别
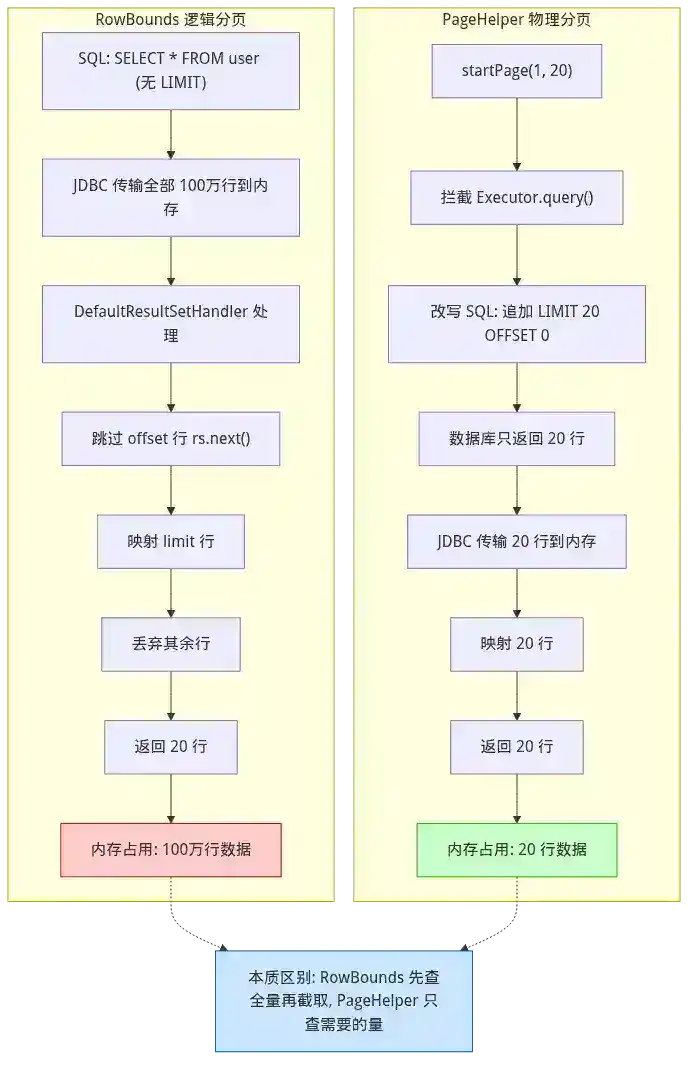
MyBatis 的 RowBounds 是逻辑分页——它把全部数据查出来,然后在内存中截取指定范围的行。如果你的表有 100 万行数据,RowBounds 会查出全部 100 万行,然后只返回第 10001-10020 行,其余 999980 行被丢弃。PageHelper 是物理分页——它改写你的 SQL,在 SQL 中追加 LIMIT 20 OFFSET 10000,只查出 20 行数据。这篇文章从 RowBounds 的实现原理到 PageHelper 的 SQL 改写机制,再到物理分页的性能边界和工程实践,完整拆解 MyBatis 分页的两种方式。
一、RowBounds:逻辑分页(内存分页)
核心原理
// RowBounds 默认值
public class RowBounds {
    public static final int NO_ROW_OFFSET = 0;
    public static final int NO_ROW_LIMIT = Integer.MAX_VALUE;

    private final int offset;   // 起始行(从 0 开始)
    private final int limit;    // 最大行数

    public RowBounds(int offset, int limit) {
        this.offset = offset;
        this.limit = limit;
    }
}

// 使用方式
RowBounds rowBounds = new RowBounds(10, 20);  // 跳过前 10 行,返回最多 20 行
List<User> users = sqlSession.selectList("selectAll", null, rowBounds);
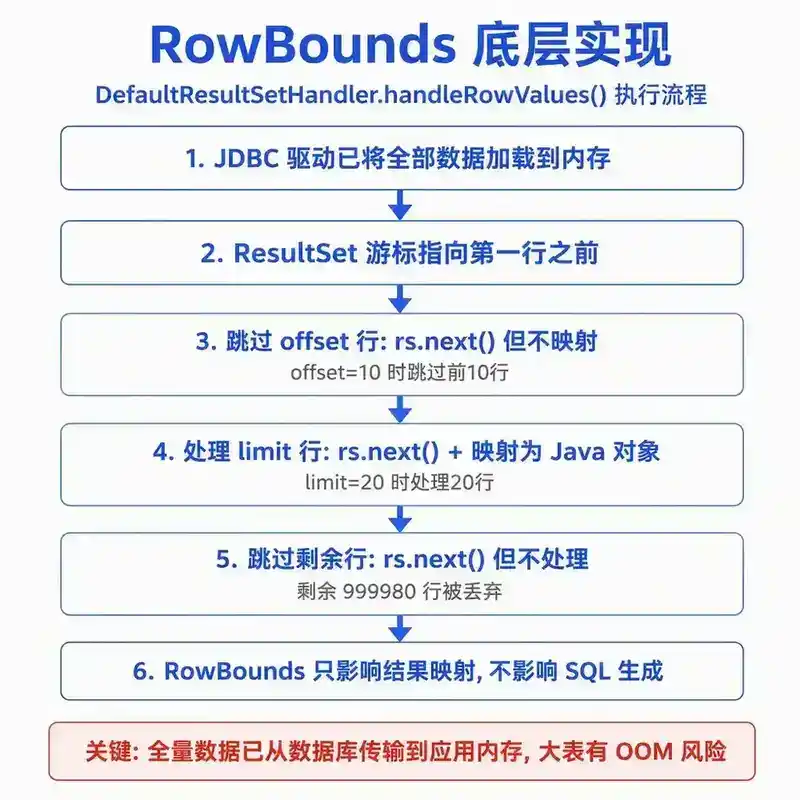
RowBounds 在 DefaultResultSetHandler.handleRowValues() 中生效:ResultSet 的前 offset 行被跳过(rs.next() 但不处理),然后处理 limit 行,之后的行全部跳过。关键点:**ResultSet**中的所有行都被 JDBC 驱动从数据库读取到了内存中,RowBounds 只是决定哪些行被映射为 Java 对象。
为什么 RowBounds 在大多数场景下是"安慰剂"
如果你在 selectList 中传了 RowBounds,但 SQL 中没有 LIMIT 子句,JDBC 驱动会把满足 WHERE 条件的所有行都从数据库传输到应用内存。对于大表,这会导致:内存溢出(OOM)、网络传输大量无用数据、数据库服务器 CPU 被无用查询消耗。RowBounds 只在数据量小(< 1000 行)的场景下有意义——比如下拉框选项、字典数据等。
RowBounds 的底层拦截
RowBounds 不被 MyBatis 的插件拦截——它只是 DefaultResultSetHandler 在结果映射阶段的参数,不影响 SQL 生成。如果你用 RowBounds 做分页,SQL 日志中看不到任何分页参数,只能看到全部数据被查询出来。
二、物理分页:SQL 层面的 LIMIT/OFFSET
物理分页的 SQL 实现
不同数据库的物理分页语法不同:
| 数据库 | 语法 |
|---|---|
| MySQL | SELECT ... LIMIT offset, limit 或 LIMIT limit OFFSET offset |
| PostgreSQL | SELECT ... LIMIT limit OFFSET offset |
| Oracle | SELECT &#42; FROM (SELECT ROWNUM rn, t.&#42; FROM (...) t WHERE ROWNUM &lt;= end) WHERE rn &gt; start |
| SQL Server | SELECT ... OFFSET offset ROWS FETCH NEXT limit ROWS ONLY |
物理分页需要两个参数
物理分页需要两个 SQL 参数:offset(偏移量)和 limit(每页大小)。offset 通常从 (pageNum - 1) * pageSize 计算得出。同时,物理分页通常需要执行一条 SELECT COUNT(*) 查询获取总记录数,用于计算总页数。
三、PageHelper:MyBatis 插件实现物理分页
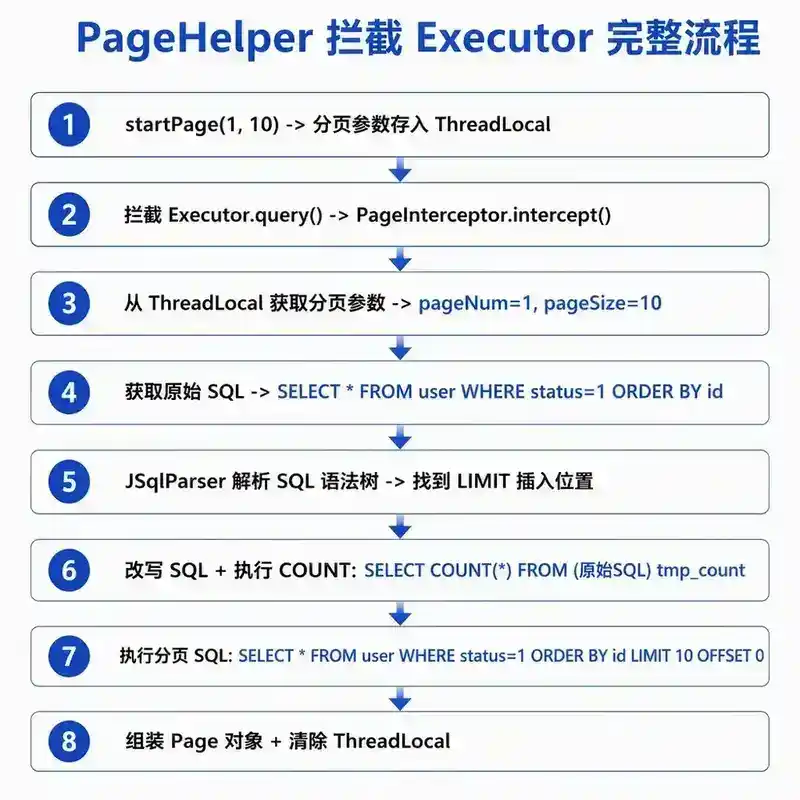
原理:拦截 Executor.query()
PageHelper 是一个 MyBatis Interceptor,拦截 Executor.query(MappedStatement, Object, RowBounds, ResultHandler) 方法。它的核心流程:
PageHelper.startPage(1, 10)将分页参数(页码、大小)存入ThreadLocal- 拦截
Executor.query(),从ThreadLocal获取分页参数 - 判断是否需要分页:如果
ThreadLocal中有分页参数,执行分页逻辑 - 获取原始 SQL:从
MappedStatement.getBoundSql()获取 - 改写 SQL:在原始 SQL 后追加
LIMIT ? OFFSET ?(MySQL 语法) - 执行 COUNT 查询:如果设置了
reasonable=true(默认),执行SELECT COUNT(*) FROM (原始SQL) tmp_count - 执行分页 SQL:执行改写后的 SQL 获取分页数据
- 组装 Page 对象:将分页数据和总数封装为
Page对象(实现了List接口) - 清除
ThreadLocal:防止线程池复用导致分页参数泄漏
关键代码(简化)
@Intercepts(@Signature(type = Executor.class, method = "query",
    args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class}))
public class PageInterceptor implements Interceptor {
    @Override
    public Object intercept(Invocation invocation) throws Throwable {
        // 1. 从 ThreadLocal 获取分页参数
        Page page = PageHelper.getLocalPage();
        if (page == null) return invocation.proceed();  // 没有分页参数,直接执行

        // 2. 获取原始 SQL
        MappedStatement ms = (MappedStatement) invocation.getArgs()[0];
        BoundSql boundSql = ms.getBoundSql(invocation.getArgs()[1]);
        String originalSql = boundSql.getSql();

        // 3. 执行 COUNT 查询
        String countSql = "SELECT COUNT(*) FROM (" + originalSql + ") tmp_count";
        // ... 执行 COUNT

        // 4. 改写 SQL,追加 LIMIT
        String pageSql = originalSql + " LIMIT ? OFFSET ?";
        // ... 替换 boundSql 中的 SQL,执行分页查询

        // 5. 组装 Page 对象
        page.setTotal(count);
        page.addAll(resultList);
        return page;
    }
}
PageHelper 的 SQL 改写难点
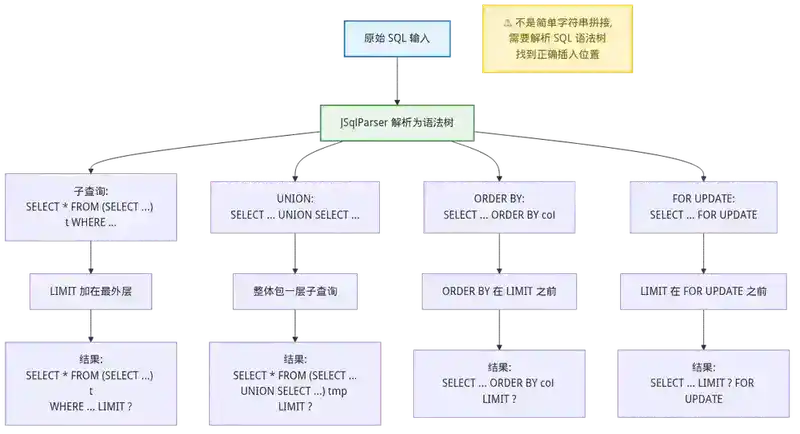
SQL 改写不是简单的字符串拼接 originalSql + " LIMIT ? OFFSET ?"。以下 SQL 结构需要特殊处理:
- 子查询:
SELECT * FROM (SELECT * FROM user WHERE ...) t WHERE ...——LIMIT 应该加在最外层 - UNION:
SELECT ... UNION SELECT ...——需要整体包一层SELECT * FROM (...) LIMIT ? - ORDER BY:
ORDER BY子句在LIMIT之前,改写时不能破坏顺序 - FOR UPDATE:
SELECT ... FOR UPDATE——LIMIT 应该在FOR UPDATE之前
PageHelper 使用 JSqlParser 解析 SQL 的语法树,找到正确的 LIMIT 插入位置,而不是简单的字符串匹配。
ThreadLocal 内存泄漏风险
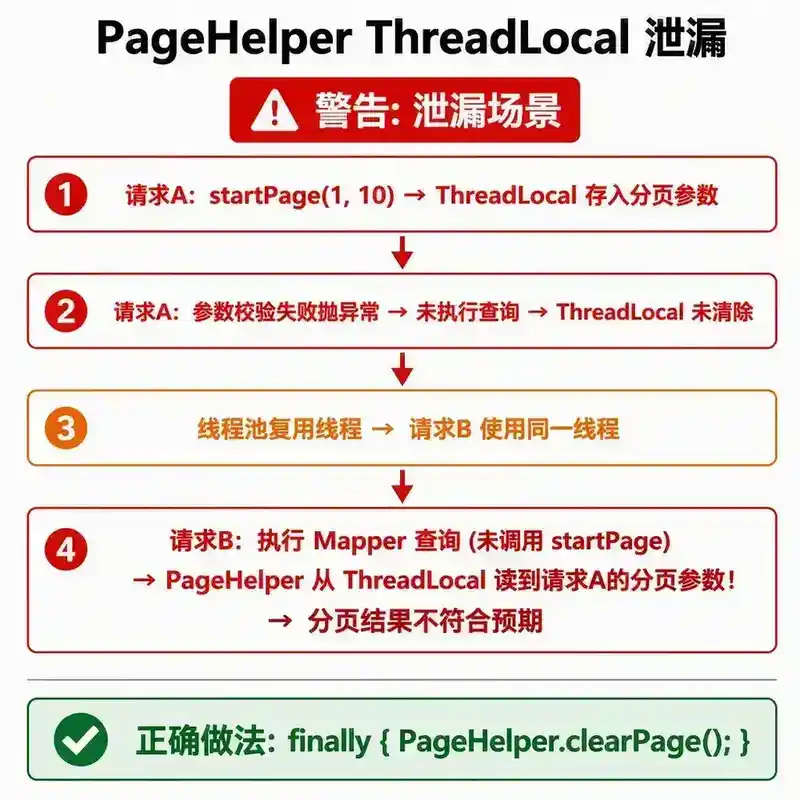
PageHelper 使用 ThreadLocal 传递分页参数。如果忘记调用 PageHelper.clearPage(),或者 ThreadLocal 中的 Page 对象没有被正确清除,线程池复用线程时会导致"分页参数泄漏"——下一个请求继承了上一个请求的分页参数,分页结果不符合预期。PageHelper 在 page() 方法执行后自动清除ThreadLocal,但如果你在分页后手动抛出了异常,清除可能不执行。最佳实践:在 finally 块中调用 PageHelper.clearPage()。
四、PageHelper 的常用配置
| 参数 | 默认值 | 说明 |
|---|---|---|
reasonable |
false |
分页合理化:pageNum &lt;= 0 时查询第一页,pageNum &gt; totalPage 时查询最后一页 |
supportMethodsArguments |
false |
支持通过 Mapper 方法参数传递分页参数 |
pageSizeZero |
false |
pageSize=0 时查询全部结果 |
params |
pageNum=pageNum;pageSize=pageSize |
映射 Mapper 方法参数中的分页字段名 |
autoRuntimeDialect |
false |
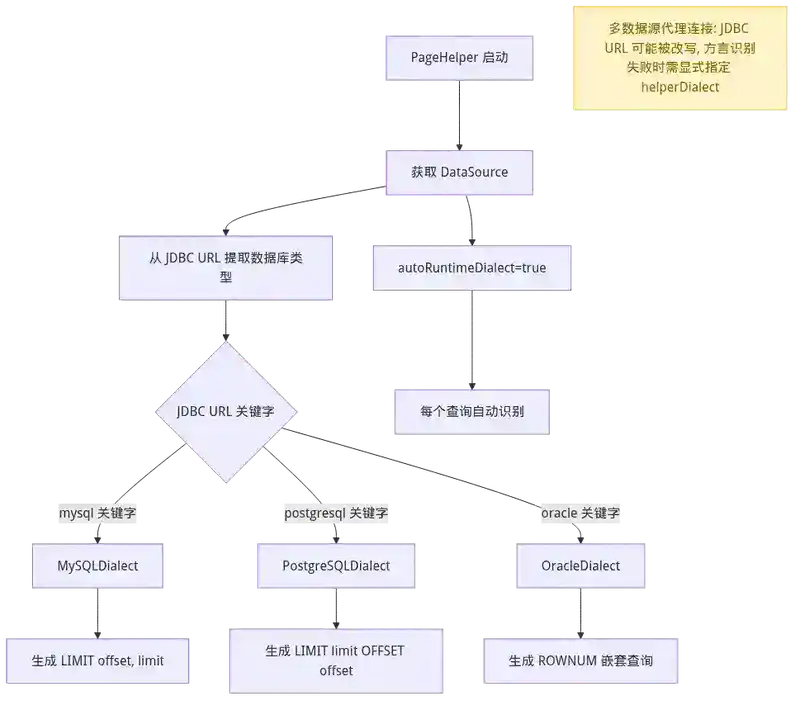
自动识别数据库方言(多数据源时有用) |
安全模式:防止全表查询
当 pageSize=0 时,默认行为是查询全部结果。如果你的表有 1000 万行数据,pageSize=0 会导致全表扫描。设置 pageSizeZero=false 可以禁止这种行为。
五、常见陷阱
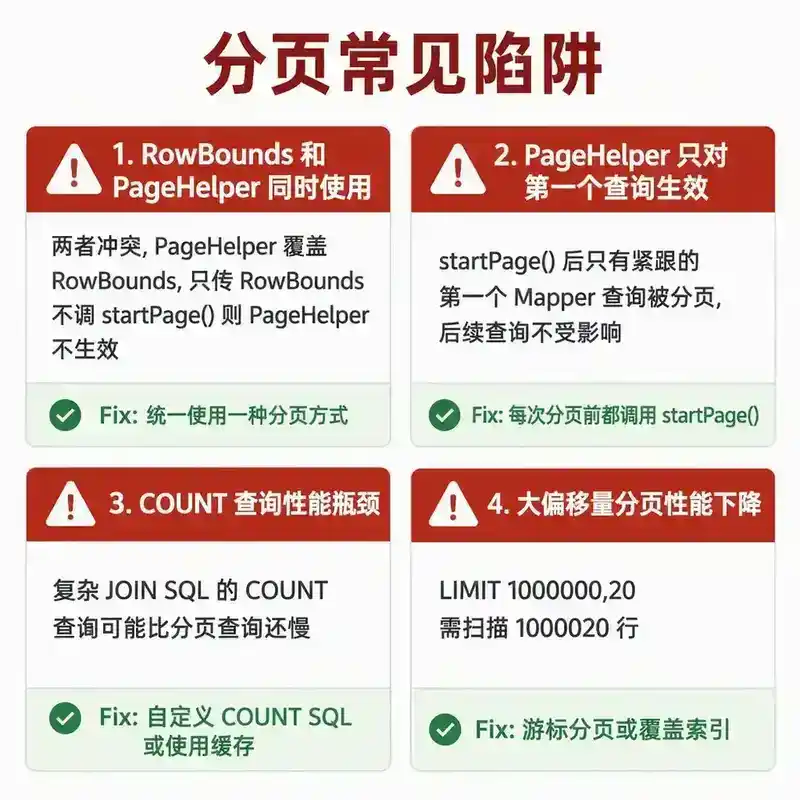
陷阱一:RowBounds 和 PageHelper 同时使用
如果你同时使用了 RowBounds 和 PageHelper.startPage(),PageHelper 会覆盖 RowBounds 的行为——因为 PageHelper 拦截了 Executor.query(),在 SQL 改写后传入的 RowBounds 被忽略。但如果你只传了 RowBounds 没有调用 PageHelper.startPage(),PageHelper 不会生效,RowBounds 的逻辑分页生效。
陷阱二:PageHelper 在多层嵌套查询中失效
PageHelper 只对紧跟在 startPage() 后的第一个 Mapper 查询生效。如果你在 Service 方法中调用了 startPage(),然后执行了多个 Mapper 查询,只有第一个 Mapper 查询会被分页。这是设计意图——防止分页参数意外泄漏到后续查询。如果需要在同一个方法中多次分页,每次分页前都需要调用 startPage()。
陷阱三:COUNT 查询性能问题
PageHelper 的 COUNT 查询是 SELECT COUNT(*) FROM (原始SQL) tmp_count。如果原始 SQL 非常复杂(多表 JOIN、子查询嵌套),COUNT 查询的执行时间可能和分页查询本身一样长,甚至更长。解决方案:自定义 COUNT 查询——在 Mapper XML 中额外定义一个 selectCount 方法,PageHelper 会优先使用它。
陷阱四:大偏移量分页性能下降
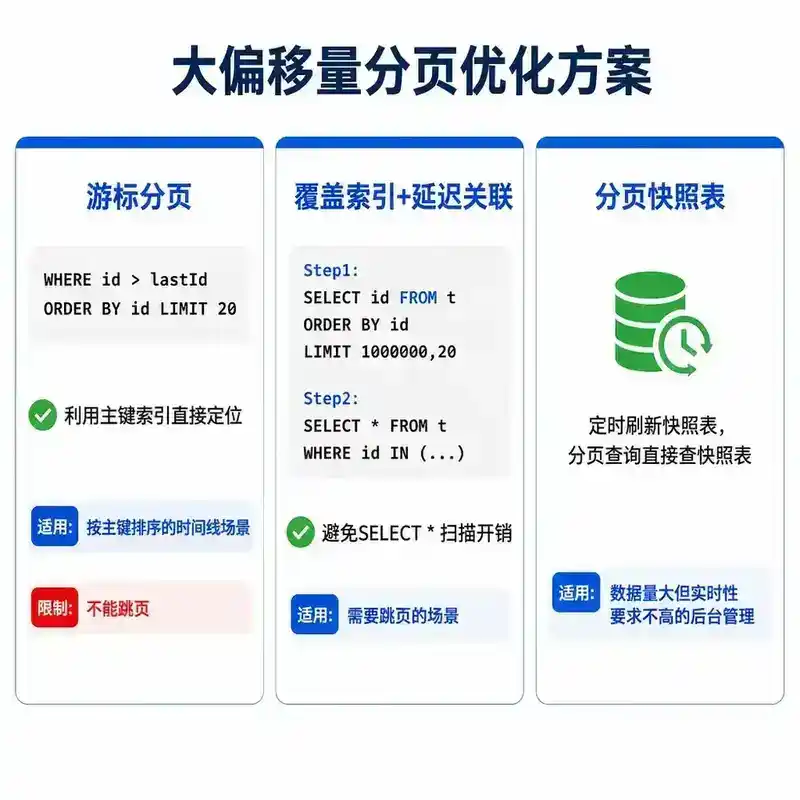
MySQL 的 LIMIT 1000000, 20 需要扫描 1000020 行数据,然后丢弃前 1000000 行——偏移量越大,性能越差。解决方案:使用"游标分页"(WHERE id > lastId ORDER BY id LIMIT 20)代替"偏移量分页",利用主键索引直接定位起始位置。
小结:分页选择的两条路径
MyBatis 分页只有两条路径:逻辑分页(RowBounds)适合小数据量(< 1000 行),物理分页(PageHelper)适合大数据量。PageHelper 的原理是拦截 Executor 改写 SQL 追加 LIMIT——理解这个原理后,你就能解释为什么 PageHelper 只对第一个查询生效、为什么 COUNT 查询可能成为瓶颈、以及为什么 ThreadLocal 需要正确清理。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:**RowBounds**和 PageHelper 的物理分页在底层实现上有什么本质区别?为什么说**RowBounds**是"安慰剂"?
答:RowBounds 在 DefaultResultSetHandler 层面工作——JDBC 驱动已经把全部数据从数据库传输到应用内存,RowBounds 只是决定跳过哪些行、映射哪些行。PageHelper 在 Executor 层面工作——它改写 SQL,在 SQL 中追加 LIMIT,数据库只返回分页范围内的数据。RowBounds 是"先查全量再截取",PageHelper 是"只查需要的量"。RowBounds 被称为"安慰剂"是因为它看起来像分页(返回了分页范围内的数据),但底层传输了全部数据——就像你点了 20 个菜但后厨做了 100 个,服务员只端了 20 个上来,其余 80 个做完了但被扔掉了。
问 2:PageHelper 的**ThreadLocal**在什么情况下会导致分页参数泄漏?你怎么保证线程池环境下分页参数的正确性?
答:分页参数泄漏发生在两个场景:第一,调用了 startPage() 但后续没有执行查询(比如参数校验失败抛异常),ThreadLocal 中的分页参数没有被清除,线程池中的下一个请求继承了这些参数;第二,在同一个线程中调用了多次 startPage(),但中间某次查询被 try-catch 捕获后没有清除。保证正确性的方案:在 finally 块中调用 PageHelper.clearPage(),或者使用 PageHelper.startPage() 的返回值 Page 对象,在 try-finally 中确保清理。更可靠的方式是使用 AOP 切面,在方法退出时自动清除 ThreadLocal。
问 3:如果你的项目切换了数据库(比如从 MySQL 迁移到 PostgreSQL),PageHelper 的分页 SQL 能自动适配吗?如果不能,需要怎么配置?
答:PageHelper 通过 Dialect 接口支持多种数据库的 SQL 方言。设置 helperDialect=mysql 或 autoRuntimeDialect=true 可以让 PageHelper 自动识别数据库类型。autoRuntimeDialect=true 时,PageHelper 从 DataSource 获取 JDBC URL,根据 URL 中的关键字(如 mysql、postgresql、oracle)自动选择对应的 Dialect。多数据源场景下,每个数据源可能使用不同的数据库,autoRuntimeDialect 能自动适配。但如果你的数据源代理了 JDBC 连接(如 Druid 的 WallFilter 或 ShardingSphere 的 ShardingDataSource),JDBC URL 可能被改写,导致方言识别失败——这种场景下需要显式指定 helperDialect。
问 4:PageHelper 的 COUNT 查询性能差,除了自定义 COUNT SQL,还有什么优化方案?
答:除了自定义 COUNT SQL,还有几种方案:第一,使用缓存——如果数据变更不频繁,可以缓存 COUNT 结果(如 Redis 缓存 5 分钟),避免每次查询都执行 COUNT;第二,使用近似计数——对于不需要精确总数的场景(如搜索引擎的分页),可以使用 EXPLAIN SELECT ... 的 rows 估算值作为近似总数;第三,使用"加载更多"代替"分页"——移动端常见的"下滑加载更多"不需要展示总页数,用 WHERE id > lastId LIMIT 20 配合"是否有下一页"判断,完全避免 COUNT 查询。
问 5:大偏移量分页的性能问题,除了游标分页,还有没有其他方案?它们的适用场景分别是什么?
答:除了游标分页(WHERE id > lastId),还有两种方案:第一,覆盖索引 + 延迟关联——先用 SELECT id FROM table ORDER BY id LIMIT 1000000, 20 查出 20 个 id,再用 SELECT * FROM table WHERE id IN (...) 查出完整数据。避免 SELECT * 的扫描开销,因为 id 列在索引中直接可用。第二,分页表——对高频分页查询建立一张"分页快照表",定时刷新,分页查询直接查快照表而不是原表。游标分页适用于"按主键排序"的场景(如时间线),覆盖索引适用于"需要跳页"的场景,分页表适用于"数据量大但实时性要求不高"的场景(如后台管理列表)。