引言:JPA 和 Hibernate 是什么关系
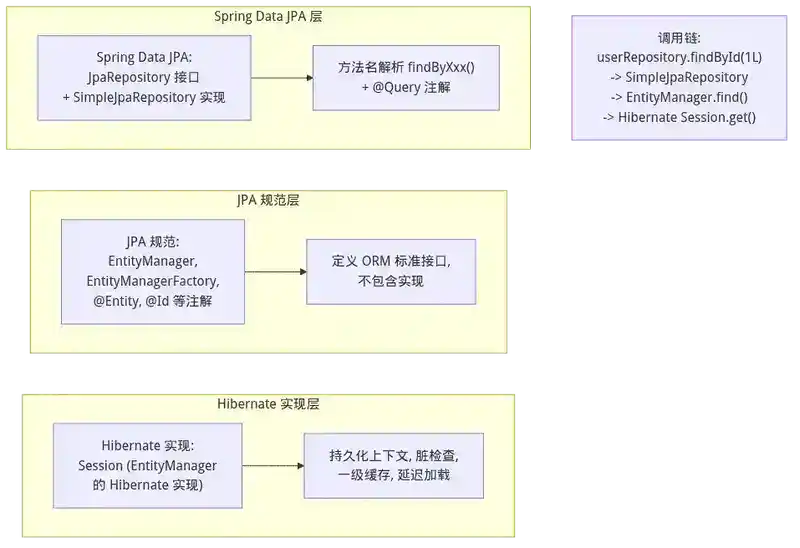
JPA(Java Persistence API)是一套 ORM 规范,定义了 EntityManager、EntityManagerFactory、@Entity、@Id 等 API 和注解。Hibernate 是 JPA 规范的一个实现(和 MyBatis 不同,MyBatis 不是 JPA 实现)。Spring Data JPA 是在 JPA 之上的一层封装,提供了 JpaRepository 等便捷接口。理解这三层关系后,你就能解释为什么 @Autowired EntityManager 注入的是 Hibernate 的实现,以及为什么 Spring Data JPA 的 findById() 最终调用的是 Hibernate 的 Session.get()。
这篇文章从 JPA 的核心概念——EntityManager、持久化上下文(Persistence Context)、实体对象的四种状态——出发,到 Hibernate 的 Session 实现和脏检查机制,再到 Spring Data JPA 的代理原理,完整拆解 JPA/Hibernate 的核心机制。
一、EntityManager 与 EntityManagerFactory
EntityManagerFactory:重量级,应用级别单例
EntityManagerFactory emf = Persistence.createEntityManagerFactory("myPU");
EntityManagerFactory 是线程安全的,通常在应用启动时创建一次,应用关闭时销毁。它内部持有:数据库连接池配置、实体类元数据(@Entity 扫描结果)、缓存配置(二级缓存)、JPA 提供者实现(Hibernate)。
EntityManager:轻量级,线程绑定
EntityManager em = emf.createEntityManager();
EntityManager 不是线程安全的,每个线程(或每个事务)应该使用独立的 EntityManager。在 Spring 中,EntityManager 通过 @PersistenceContext 注入,Spring 自动为每个事务创建独立的 EntityManager 代理。
EntityManager 的核心方法
public interface EntityManager {
    void persist(Object entity);        // 将瞬时态对象变为持久态
    <T> T merge(T entity);              // 将脱管态对象合并回持久化上下文
    void remove(Object entity);         // 删除持久态对象
    <T> T find(Class<T> clazz, Object id);  // 按主键查询(立即查询)
    <T> T getReference(Class<T> clazz, Object id);  // 返回代理对象(延迟加载)
    Query createQuery(String jpql);     // JPQL 查询
    void flush();                       // 强制同步持久化上下文到数据库
    void clear();                       // 清空持久化上下文(所有对象变为脱管态)
    boolean contains(Object entity);    // 判断对象是否在持久化上下文中
}
二、持久化上下文(Persistence Context)
持久化上下文是什么
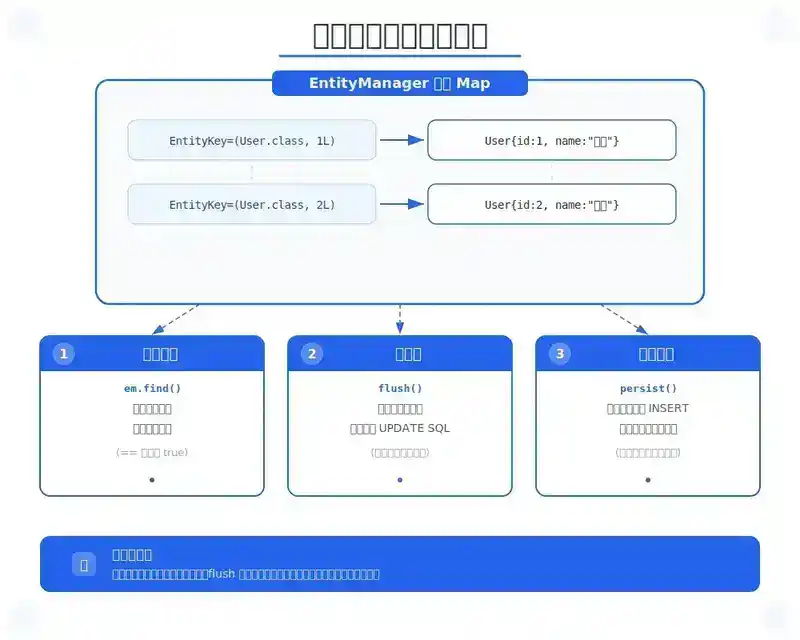
持久化上下文是一个"对象缓存",它管理着当前 EntityManager 中所有持久态对象。它的核心数据结构是 Map<EntityKey, Object>,key 是实体类型 + 主键的复合键,value 是实体对象本身。
持久化上下文的三个核心职责:
- 身份保证:同一个
EntityManager中,同一个主键的实体只有一个实例(em.find(User.class, 1L)两次调用返回同一个对象引用) - 脏检查:在事务提交时,比较持久化上下文中对象的当前状态和快照(snapshot),自动生成 UPDATE SQL
- 写后缓存:
persist()操作不立即生成 SQL,而是在事务提交时统一生成 INSERT SQL
持久化上下文的作用域
JPA 支持两种持久化上下文作用域:
- 事务范围(Transaction-scoped):
EntityManager的生命周期和事务一致。Spring 默认使用此模式——每个事务创建独立的EntityManager,事务提交后EntityManager关闭,持久化上下文清空。 - 扩展范围(Extended-scoped):
EntityManager的生命周期跨越多个事务。适合"长对话"场景(如向导式表单),但需要手动管理EntityManager的创建和销毁。
三、实体对象的四种状态
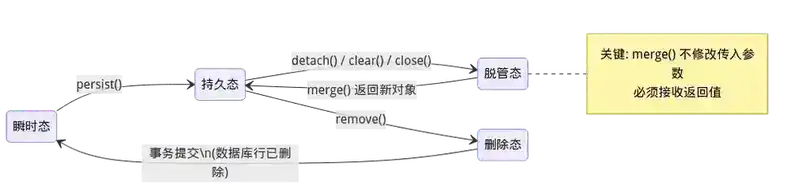
| 状态 | 有主键? | 在持久化上下文中? | 对应数据库行? | 典型场景 |
|---|---|---|---|---|
| 瞬时态(Transient) | 无 | 否 | 无 | new User() 刚创建 |
| 持久态(Managed) | 有 | 是 | 有 | em.find() 或 em.persist() 后 |
| 脱管态(Detached) | 有 | 否 | 有 | em.close() 后,或 em.clear() 后 |
| 删除态(Removed) | 有 | 是 | 即将删除 | em.remove() 后,事务提交前 |
状态转换
new User()  →  瞬时态
em.persist()  →  持久态(INSERT SQL 在 flush 时生成)
em.find()  →  持久态
em.merge()  →  脱管态 → 持久态(先查后更新)
em.remove()  →  持久态 → 删除态(DELETE SQL 在 flush 时生成)
em.detach() / em.clear() / em.close()  →  持久态 → 脱管态
关键理解:merge() 和 persist() 的区别
persist() 用于瞬时态对象——它把对象纳入持久化上下文,在 flush 时生成 INSERT。merge() 用于脱管态对象——它先根据主键查找持久化上下文中的对应对象(或从数据库加载),然后将脱管态对象的属性复制到持久态对象上,返回持久态对象。merge() 不会修改传入的参数对象——传入的脱管态对象仍然是脱管态,返回值才是持久态对象。
User user = new User(); user.setName("张三");
user = em.merge(user);  // 必须接收返回值,否则 user 是脱管态
user.setName("李四");    // 这个修改会被脏检查检测到
四、Hibernate 的脏检查机制
脏检查的实现原理
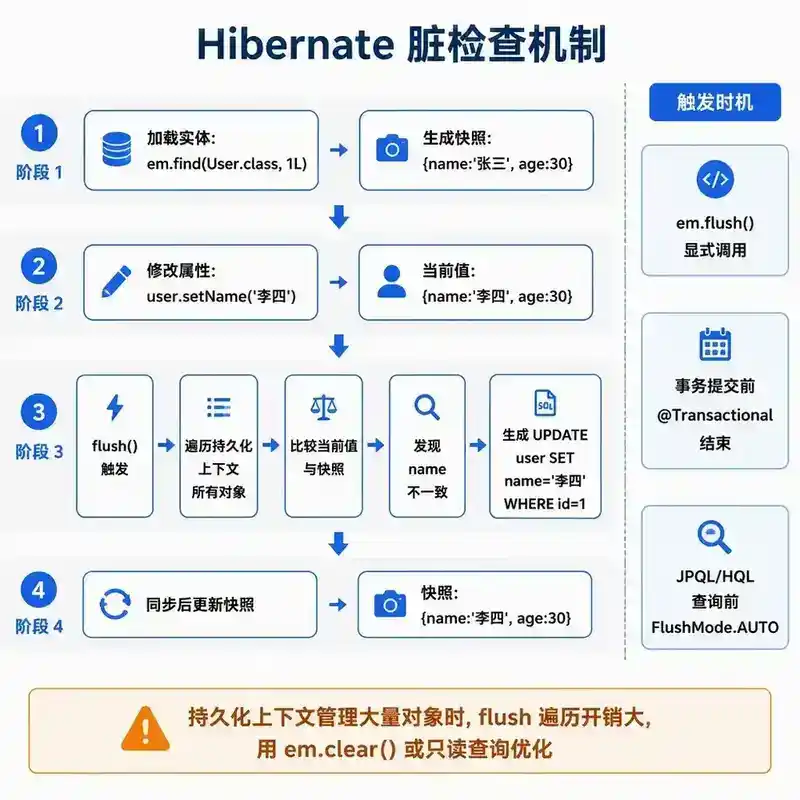
Hibernate 在加载实体时,会保存一份"快照"(snapshot)——实体加载时的原始属性值。在 flush() 时,Hibernate 遍历持久化上下文中的所有对象,将当前属性值与快照对比,如果发现不一致,生成 UPDATE SQL。
User user = em.find(User.class, 1L);  // 加载,生成快照 {name: "张三", age: 30}
user.setName("李四");                  // 修改属性
// flush() 时:比较快照和当前值,发现 name 不一致,生成 UPDATE user SET name='李四' WHERE id=1
脏检查的触发时机
脏检查在以下时机触发:
em.flush()显式调用- 事务提交前(
@Transactional方法结束时) - 执行 JPQL/HQL 查询前(Hibernate 默认
FlushMode.AUTO,会先 flush 再查询,确保查询结果包含当前事务中的修改)
脏检查的性能影响
如果持久化上下文中管理了大量对象(如 10000 个),每次 flush 都需要遍历所有对象做脏检查,即使只有 1 个对象被修改。解决方案:及时清理持久化上下文(em.clear()),使用只读查询(@QueryHints(@QueryHint(name = "org.hibernate.readOnly", value = "true"))),或使用 StatelessSession(无持久化上下文,不脏检查)。
五、Spring Data JPA 的代理原理
JpaRepository 的代理
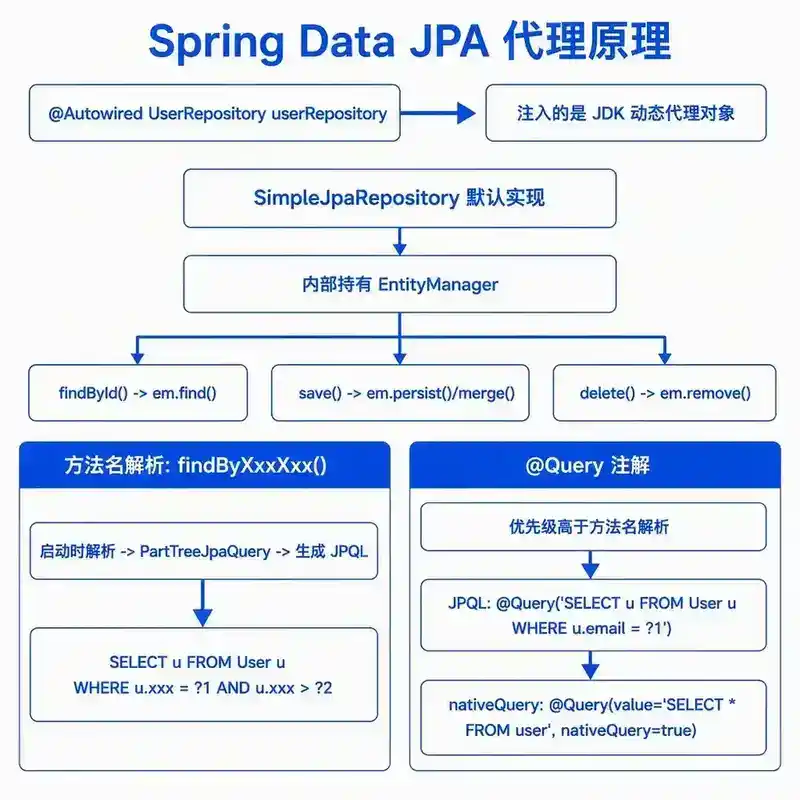
@Autowired UserRepository userRepository 注入的是一个 JDK 动态代理对象。SimpleJpaRepository 是默认实现,它内部持有 EntityManager,将 findById()、save() 等方法委托给 EntityManager。
自定义查询方法的解析
Spring Data JPA 通过方法名解析生成 JPQL:
List<User> findByNameAndAgeGreaterThan(String name, int age);
// 解析为: SELECT u FROM User u WHERE u.name = ?1 AND u.age > ?2
解析规则:findBy + 属性名 + 条件关键字(And、Or、GreaterThan、LessThan、Between、Like、In、OrderBy、NotNull 等)。Spring Data JPA 在启动时解析这些方法名,生成 PartTreeJpaQuery 对象,运行时执行 JPQL。
@Query 注解
@Query("SELECT u FROM User u WHERE u.email = ?1")
User findByEmail(String email);

@Query(value = "SELECT * FROM user WHERE email = ?1", nativeQuery = true)
User findByEmailNative(String email);
@Query 注解优先于方法名解析。如果方法上有 @Query,Spring Data JPA 直接使用注解中的 JPQL 或原生 SQL,不解析方法名。
六、常见陷阱
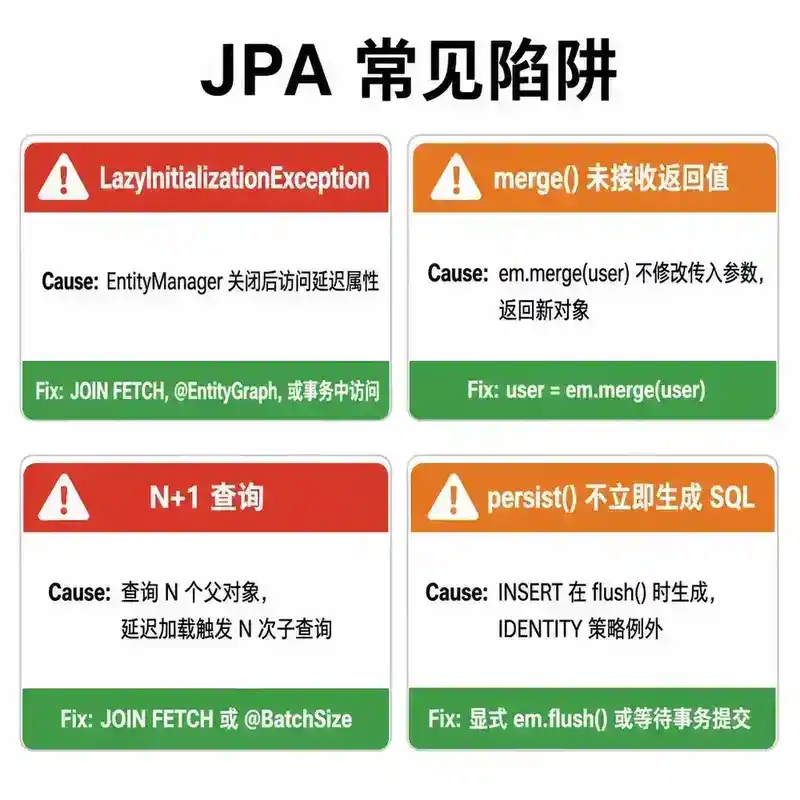
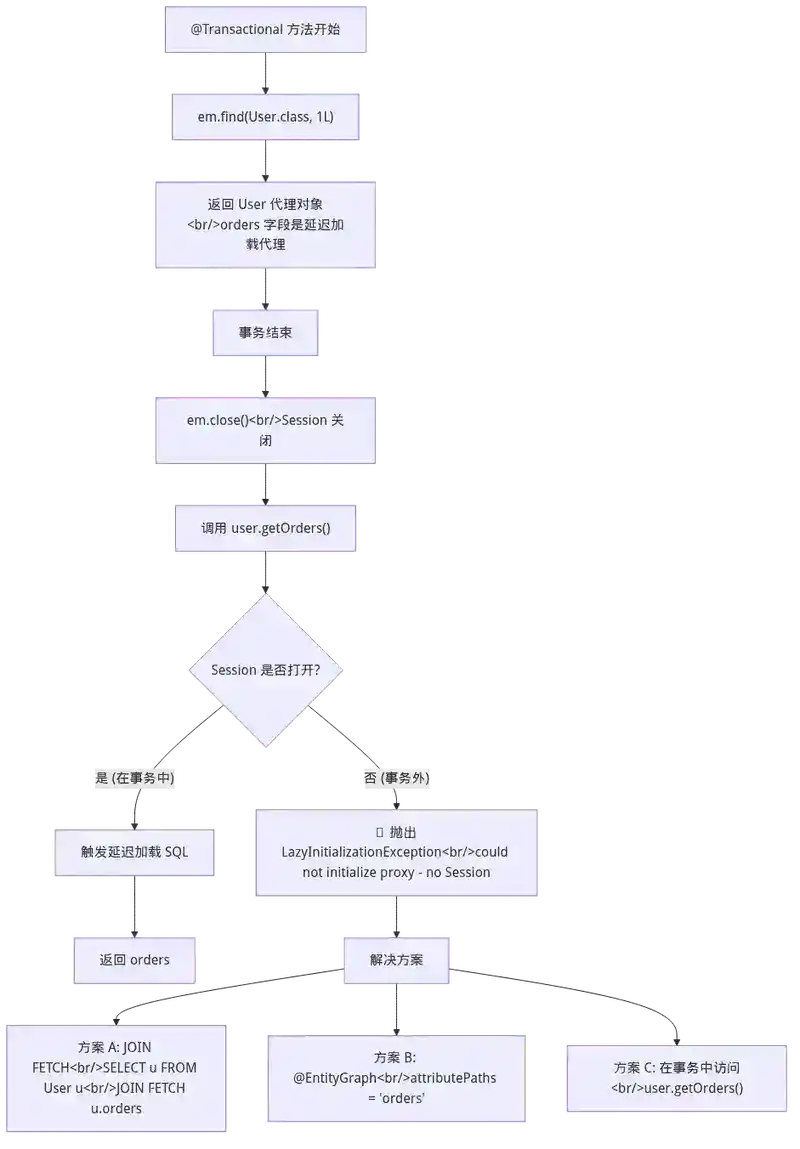
陷阱一:LazyInitializationException
User user = userRepository.findById(1L);  // 事务结束,EntityManager 关闭
List<Order> orders = user.getOrders();     // 抛出 LazyInitializationException
延迟加载的关联属性在 EntityManager 关闭后无法加载。解决方案:在事务中访问关联属性,使用 JOIN FETCH 一次性加载,或使用 @EntityGraph 指定加载策略。
陷阱二:merge() 的返回值
User user = new User(); user.setId(1L); user.setName("张三");
em.merge(user);  // 错误:没有接收返回值
user.setName("李四");  // user 是脱管态,修改不会被脏检查检测到
正确的写法:user = em.merge(user);。
陷阱三:N+1 查询
List<User> users = userRepository.findAll();  // 1 条 SQL
for (User user : users) {
    user.getOrders().size();  // N 条 SQL(延迟加载触发)
}
解决方案:JOIN FETCH、@EntityGraph、或 @BatchSize 批量加载。
陷阱四:persist() 后不立即生成 SQL
em.persist(user) 不会立即生成 INSERT SQL——SQL 在 flush() 时(事务提交前)才生成。如果 persist 后执行 JPQL 查询,Hibernate 会在查询前自动 flush,确保查询结果包含新对象。但如果主键是 IDENTITY 策略,persist() 会立即生成 INSERT(因为需要从数据库获取自增 ID)。
小结:JPA 的核心是"持久化上下文"
JPA/Hibernate 的设计哲学和 MyBatis 完全不同:MyBatis 是"SQL 映射"框架,你写的 SQL 决定了数据库操作;JPA 是"对象状态管理"框架,持久化上下文通过脏检查自动生成 SQL。理解这个差异后,你就能解释为什么 JPA 的 save() 不需要显式写 UPDATE SQL、为什么延迟加载会抛出 LazyInitializationException、以及为什么脏检查在大量对象场景下可能成为性能瓶颈。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:JPA 的**persist()**和 Hibernate 的**save()**有什么区别?Spring Data JPA 的**save()**又是怎么实现的?
答:JPA 的 persist() 只接受瞬时态对象,返回 void,不保证立即生成 INSERT。Hibernate 的 save() 返回生成的主键(Serializable),persist() 和 save() 在 Hibernate 内部实现几乎相同,主要区别是返回值。Spring Data JPA 的 save() 是 SimpleJpaRepository 中的方法,逻辑是:如果实体主键为 null(瞬时态),调用 em.persist();如果主键不为 null(脱管态),调用 em.merge()。所以 Spring Data JPA 的 save() 是 persist() 和 merge() 的统一封装——它根据主键是否存在自动选择。
问 2:为什么 Hibernate 的脏检查需要"快照"?快照在什么时候生成?如果直接修改了持久态对象的属性,快照会更新吗?
答:快照在实体加载到持久化上下文时生成——em.find() 或查询返回时,Hibernate 复制一份实体的初始属性值作为快照。快照不会在属性修改时自动更新——否则脏检查就无法检测到修改了。快照在 flush() 后更新:flush() 将修改同步到数据库后,快照被更新为当前的属性值,因为当前状态已经"干净"了。如果使用 StatelessSession,没有持久化上下文,也没有快照,所以也没有脏检查——修改需要手动调用 update()。
问 3:**@PersistenceContext**注入的**EntityManager**在 Spring 中是如何保证线程安全的?为什么多个线程可以同时使用同一个**@Autowired EntityManager**?
答:Spring 注入的 EntityManager 不是真正的 Hibernate Session,而是一个代理对象(SharedEntityManagerCreator 创建的代理)。每次调用代理的方法时,代理从 TransactionSynchronizationManager 获取当前线程绑定的 EntityManager(如果有事务),或者创建一个新的 EntityManager(如果没有事务)。所以多个线程可以同时使用同一个 @Autowired EntityManager 字段,因为每个线程实际调用的是不同的 EntityManager 实例。这个设计类似于 MyBatis 的 SqlSessionTemplate——都是通过代理实现线程安全。
问 4:JPA 的**IDENTITY**主键生成策略和**SEQUENCE**策略有什么区别?为什么**IDENTITY**策略会破坏 JDBC 的批量插入?
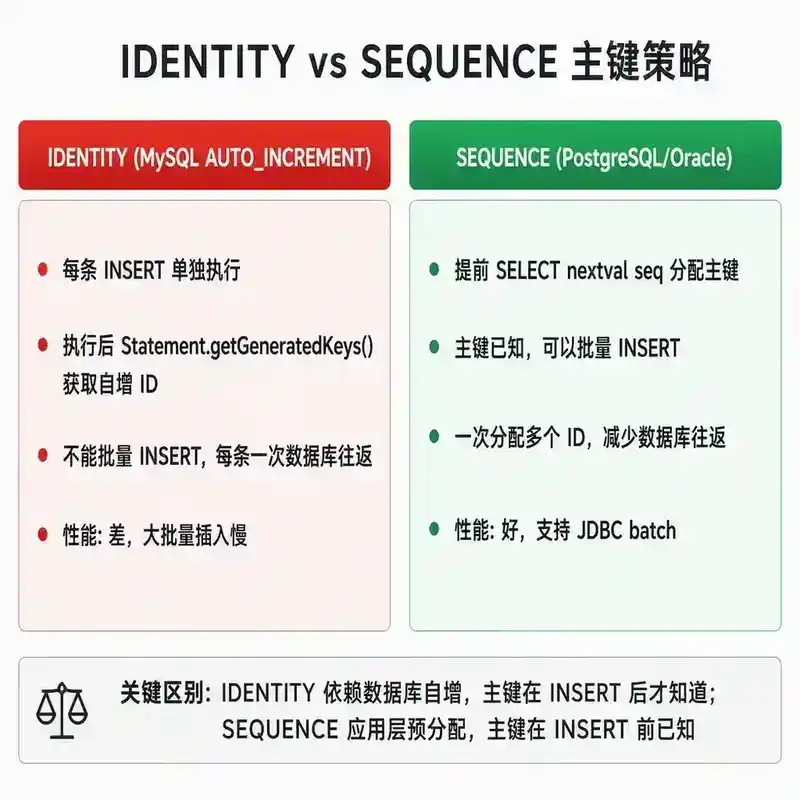
答:IDENTITY 策略依赖数据库的自增列(如 MySQL 的 AUTO_INCREMENT)。插入时,JDBC 必须执行 INSERT 语句后立即获取生成的主键(Statement.getGeneratedKeys()),因此每条 INSERT 必须单独执行,不能批量提交。SEQUENCE 策略通过数据库序列提前分配主键值(SELECT nextval('seq')),插入时主键已知,可以批量执行多条 INSERT。这就是为什么 IDENTITY 策略在大批量插入时性能远不如 SEQUENCE——IDENTITY 每次 INSERT 都需要一次数据库往返,SEQUENCE 可以一次分配多个 ID 后批量插入。
问 5:Hibernate 的**FlushMode.AUTO**和**FlushMode.COMMIT**有什么区别?在什么场景下需要改为**FlushMode.COMMIT**?
答:FlushMode.AUTO(默认)在以下时机触发 flush:事务提交前、执行 JPQL/HQL 查询前、显式调用 flush()。FlushMode.COMMIT 只在事务提交前和显式调用 flush() 时触发,不会在查询前自动 flush。改为 FlushMode.COMMIT 的场景:你的查询不需要感知当前事务中的修改(比如只读报表查询),或者你想避免查询前的 flush 开销。但 FlushMode.COMMIT 有风险:如果你在事务中 persist 了一个对象,然后执行 JPQL 查询,查询结果不会包含这个新对象——因为 flush 没有在查询前执行,新对象还在持久化上下文中,没有写入数据库。这可能导致"同一个事务中写入后查询不到"的困惑。