引言:读写分离和数据源切换的底层实现
在一个典型的读写分离架构中,写操作走主库(Master),读操作走从库(Slave)。如果让你实现这个路由逻辑,你会怎么做?最简单的方案是用 AOP 切面:拦截 @Transactional 或自定义注解,根据方法名(insert/update/delete → Master,select/get/find → Slave)切换数据源。这个方案的底层依赖是 Spring 的 AbstractRoutingDataSource——它是一个"路由数据源",内部维护了一个 Map<Object, DataSource> 的映射,通过 determineCurrentLookupKey() 方法返回当前的 key,getConnection() 方法根据 key 获取对应的 DataSource 并返回 Connection。这篇文章从 AbstractRoutingDataSource 的原理到多数据源配置的完整方案,再到分布式事务的挑战,完整拆解 MyBatis 多数据源的实现。
一、AbstractRoutingDataSource 原理
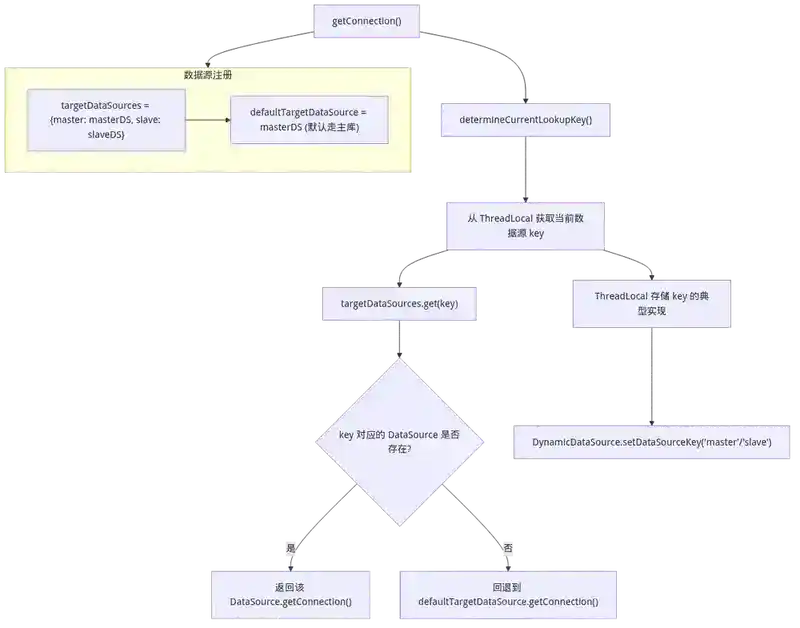
核心结构
public abstract class AbstractRoutingDataSource extends AbstractDataSource {
    @Nullable
    private Map<Object, DataSource> targetDataSources;  // key → DataSource 映射
    @Nullable
    private DataSource defaultTargetDataSource;          // 默认数据源

    @Override
    public Connection getConnection() throws SQLException {
        return determineTargetDataSource().getConnection();
    }

    protected DataSource determineTargetDataSource() {
        Object lookupKey = determineCurrentLookupKey();  // 子类实现:返回当前 key
        DataSource dataSource = this.targetDataSources.get(lookupKey);
        if (dataSource == null) {
            dataSource = this.defaultTargetDataSource;   // 找不到时回退到默认数据源
        }
        return dataSource;
    }

    @Nullable
    protected abstract Object determineCurrentLookupKey();  // 子类必须实现
}
AbstractRoutingDataSource 的核心理念是:数据源的选择逻辑和实际的**Connection**获取逻辑分离。determineCurrentLookupKey() 负责"决定用哪个数据源",getConnection() 负责"从选中的数据源获取连接"。子类只需要实现 determineCurrentLookupKey(),提供当前线程应该使用的数据源 key。
一个典型的实现:使用 ThreadLocal 存储数据源 key
public class DynamicDataSource extends AbstractRoutingDataSource {
    private static final ThreadLocal<String> CONTEXT_HOLDER = new ThreadLocal<>();

    public static void setDataSourceKey(String key) {
        CONTEXT_HOLDER.set(key);
    }

    public static String getDataSourceKey() {
        return CONTEXT_HOLDER.get();
    }

    public static void clearDataSourceKey() {
        CONTEXT_HOLDER.remove();
    }

    @Override
    protected Object determineCurrentLookupKey() {
        return CONTEXT_HOLDER.get();
    }
}
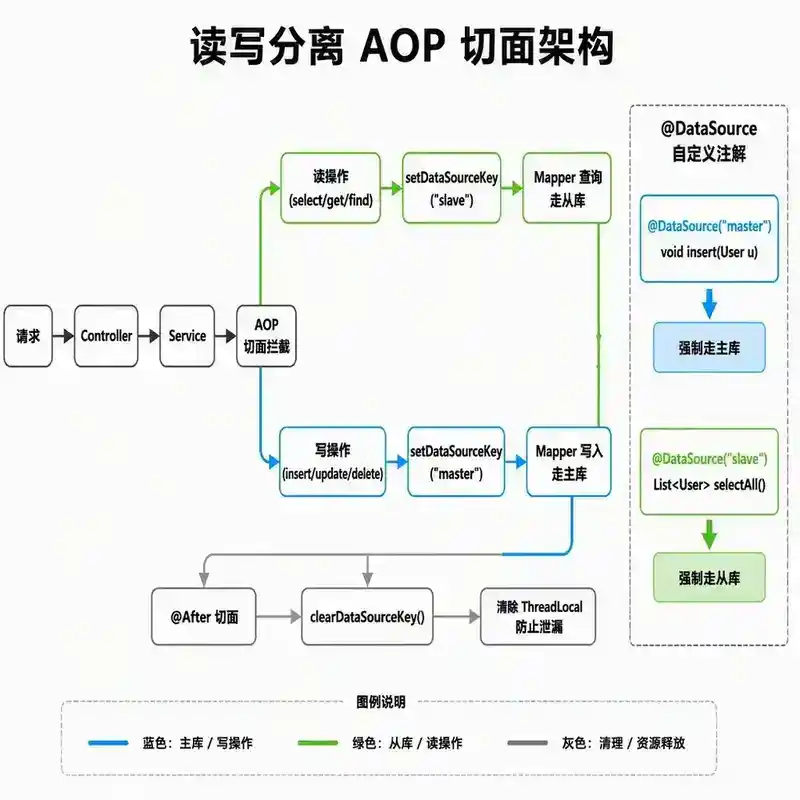
ThreadLocal 确保每个线程拥有独立的数据源 key,不会相互干扰。setDataSourceKey() 在 AOP 切面中调用,clearDataSourceKey() 在切面退出时调用(防止 ThreadLocal 泄漏)。
二、多数据源配置的完整方案
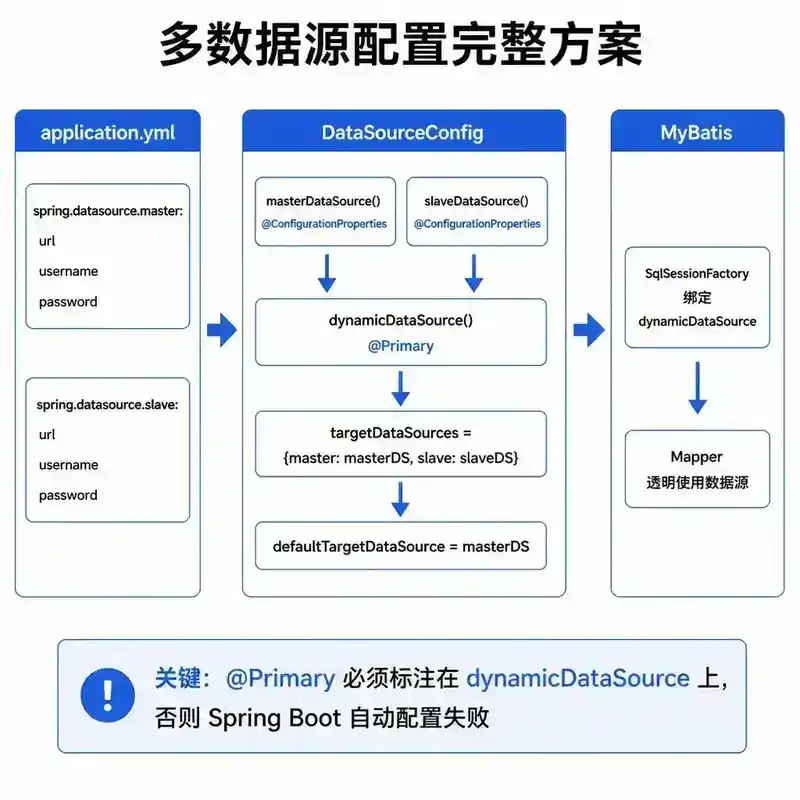
第一步:配置多个数据源
spring:
  datasource:
    master:
      url: jdbc:mysql://master:3306/db
      username: root
      password: xxx
    slave:
      url: jdbc:mysql://slave:3306/db
      username: root
      password: xxx
第二步:创建 DynamicDataSource Bean
@Configuration
public class DataSourceConfig {
    @Bean
    @ConfigurationProperties("spring.datasource.master")
    public DataSource masterDataSource() {
        return DataSourceBuilder.create().build();
    }

    @Bean
    @ConfigurationProperties("spring.datasource.slave")
    public DataSource slaveDataSource() {
        return DataSourceBuilder.create().build();
    }

    @Bean
    @Primary  // 必须标注 @Primary,否则 Spring Boot 自动配置会失败
    public DataSource dynamicDataSource() {
        DynamicDataSource ds = new DynamicDataSource();
        Map<Object, Object> targetDataSources = new HashMap<>();
        targetDataSources.put("master", masterDataSource());
        targetDataSources.put("slave", slaveDataSource());
        ds.setTargetDataSources(targetDataSources);
        ds.setDefaultTargetDataSource(masterDataSource());  // 默认走主库
        return ds;
    }
}
第三步:AOP 切面实现读写分离
@Aspect
@Component
public class DataSourceAspect {
    @Before("@annotation(transactional)")  // 拦截 @Transactional 注解
    public void before(JoinPoint point) {
        MethodSignature signature = (MethodSignature) point.getSignature();
        String methodName = signature.getMethod().getName();
        if (methodName.startsWith("select") || methodName.startsWith("get")
            || methodName.startsWith("find") || methodName.startsWith("query")) {
            DynamicDataSource.setDataSourceKey("slave");  // 读操作走从库
        } else {
            DynamicDataSource.setDataSourceKey("master");  // 写操作走主库
        }
    }
}
第四步:自定义注解(更灵活的方式)
@Target({ElementType.METHOD, ElementType.TYPE})
@Retention(RetentionPolicy.RUNTIME)
public @interface DataSource {
    String value() default "master";  // 数据源名称
}

// 使用
@DataSource("slave")
public List<User> selectAll() { ... }

@DataSource("master")
public void insert(User user) { ... }
自定义注解比"根据方法名判断"更灵活——你可以强制某个读方法走主库(比如需要实时读取刚写入的数据),也可以让某个写方法走从库(如果从库承担了部分写入任务)。
三、MyBatis 多数据源配置
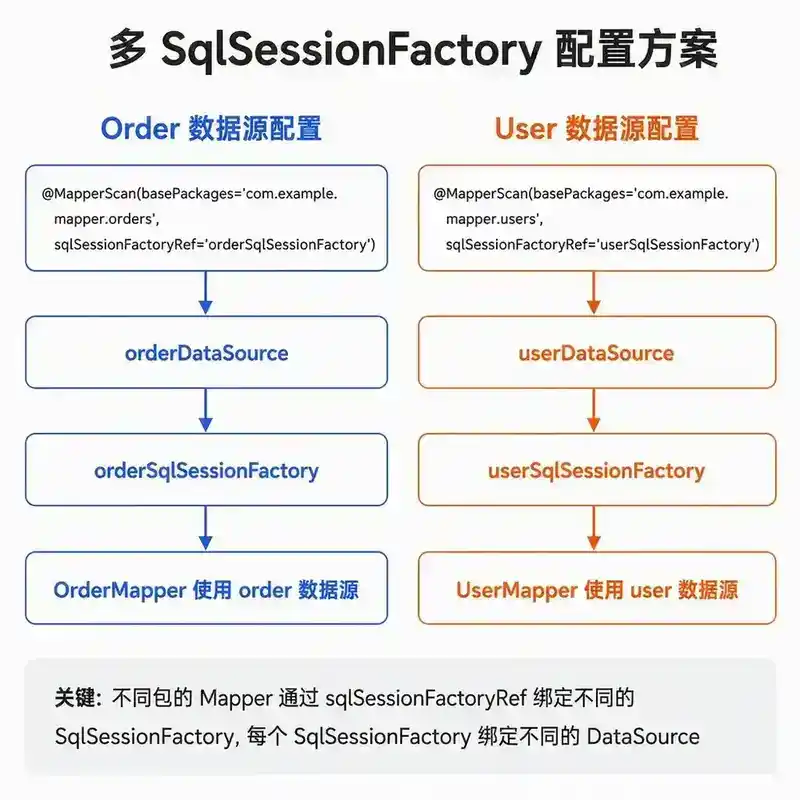
多 SqlSessionFactory 方案
当不同的 Mapper 需要使用不同的数据源时(而不仅仅是读写分离),需要配置多个 SqlSessionFactory:
@Configuration
@MapperScan(basePackages = "com.example.mapper.orders",
            sqlSessionFactoryRef = "orderSqlSessionFactory")
public class OrderDataSourceConfig {
    @Bean
    public DataSource orderDataSource() { ... }

    @Bean
    public SqlSessionFactory orderSqlSessionFactory() throws Exception {
        SqlSessionFactoryBean factory = new SqlSessionFactoryBean();
        factory.setDataSource(orderDataSource());
        return factory.getObject();
    }
}

@Configuration
@MapperScan(basePackages = "com.example.mapper.users",
            sqlSessionFactoryRef = "userSqlSessionFactory")
public class UserDataSourceConfig {
    @Bean
    public DataSource userDataSource() { ... }

    @Bean
    public SqlSessionFactory userSqlSessionFactory() throws Exception {
        SqlSessionFactoryBean factory = new SqlSessionFactoryBean();
        factory.setDataSource(userDataSource());
        return factory.getObject();
    }
}
关键点:@MapperScan 的 sqlSessionFactoryRef 属性指定不同包的 Mapper 使用不同的 SqlSessionFactory。
动态数据源 + 多 SqlSessionFactory 的组合
读写分离用 AbstractRoutingDataSource(数据源层面切换),多租户用多 SqlSessionFactory(Mapper 层面切换)。两者可以组合使用:AbstractRoutingDataSource 作为数据源层面的路由,SqlSessionFactory 绑定到不同的 AbstractRoutingDataSource 实例。
四、事务管理
单数据源事务
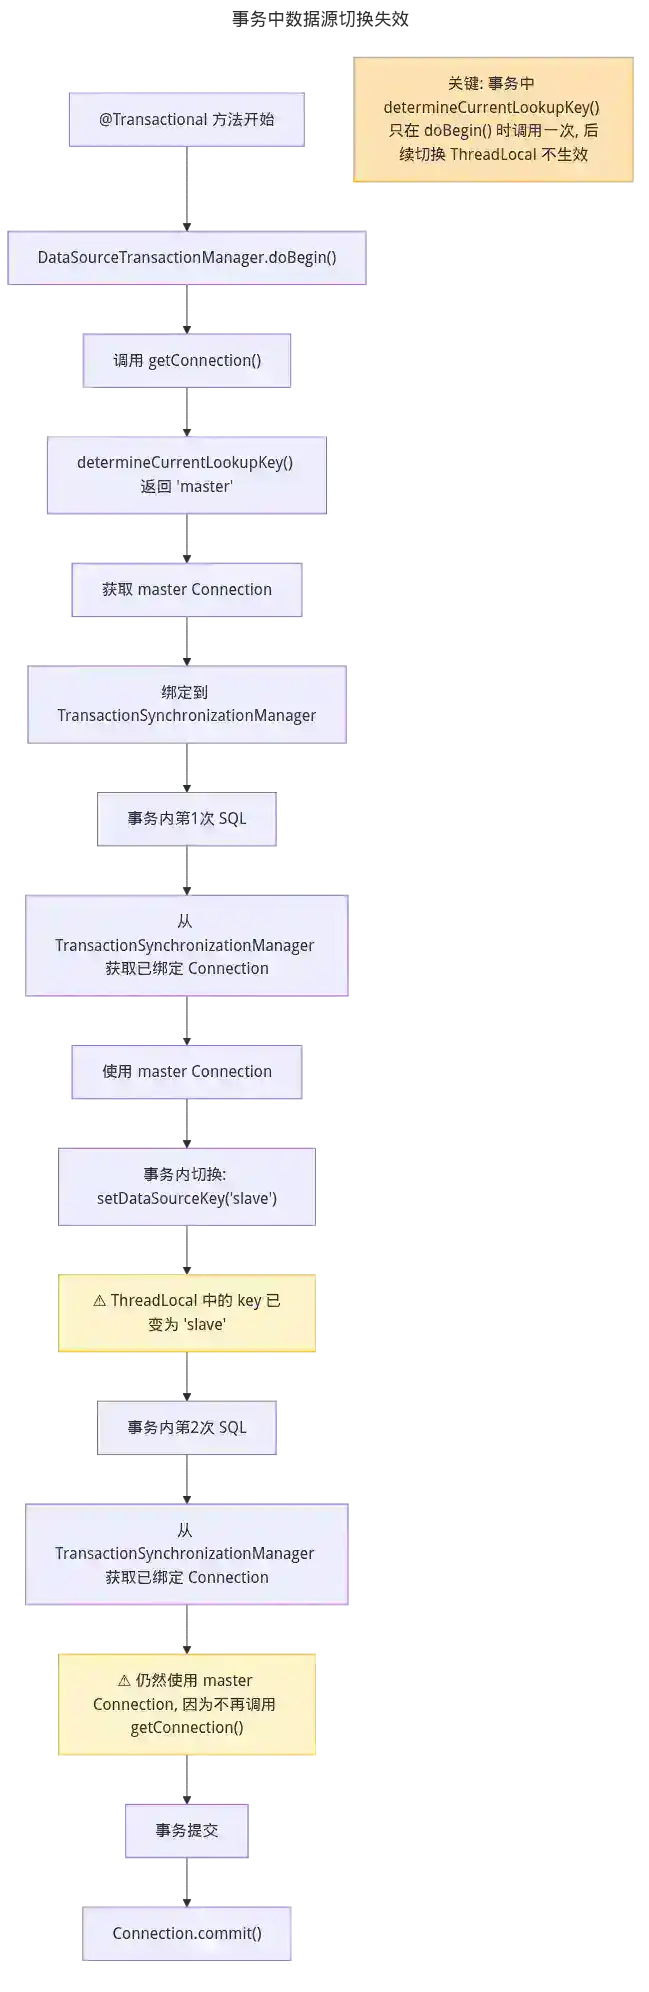
AbstractRoutingDataSource 在事务开启时获取 Connection,事务期间 determineCurrentLookupKey() 只调用一次——事务内的所有操作使用同一个 Connection,数据源不会在事务中间切换。这意味着:如果你在事务中先写后读,读操作也会走主库(因为 Connection 已经绑定到主库)。
跨数据源事务
AbstractRoutingDataSource 不支持跨数据源事务——它本质上是一个"代理数据源",每次 getConnection() 返回的是被代理数据源的 Connection。跨数据源的事务需要分布式事务管理器(如 JTA、Atomikos、Seata)。Spring 的 DataSourceTransactionManager 只管理单个数据源的事务。
五、常见陷阱
陷阱一:ThreadLocal 泄漏
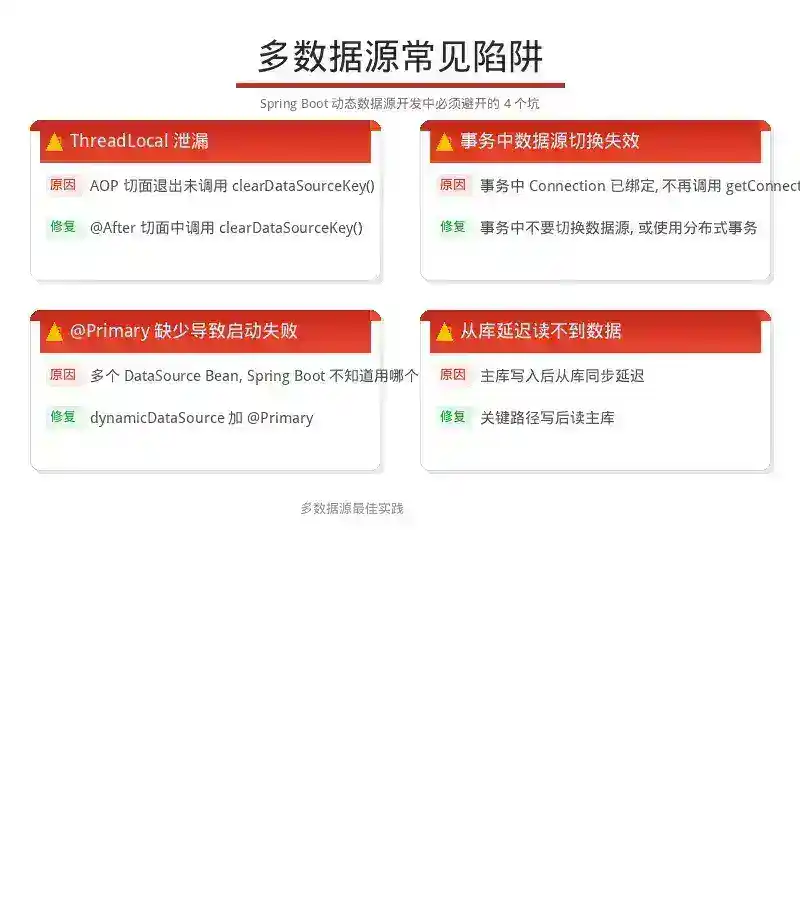
DynamicDataSource.setDataSourceKey() 在 AOP 切面中调用,如果切面退出时没有调用 clearDataSourceKey(),ThreadLocal 会持有上一次的数据源 key,导致后续请求使用了错误的数据源。解决方案:在 @After 切面中调用 clearDataSourceKey(),或使用 try-finally 确保清理。
陷阱二:事务中数据源切换失效
@Transactional 方法内,DataSourceTransactionManager 在 doBegin() 中获取 Connection 并绑定到 TransactionSynchronizationManager。事务内的后续操作直接使用这个已绑定的 Connection,不再调用 AbstractRoutingDataSource.getConnection()——这意味着事务内的 determineCurrentLookupKey() 不会被再次调用,数据源切换失效。如果你在事务中切换了 ThreadLocal 中的 key,实际使用的仍然是事务开始时选择的 Connection。
陷阱三:@Primary 数据源冲突
AbstractRoutingDataSource 必须标注 @Primary,否则 Spring Boot 的自动配置(如 DataSourceAutoConfiguration)会因为有多个 DataSource Bean 而启动失败。如果你使用了多个 AbstractRoutingDataSource,只能有一个标注 @Primary,其他的需要通过 @Qualifier 注入。
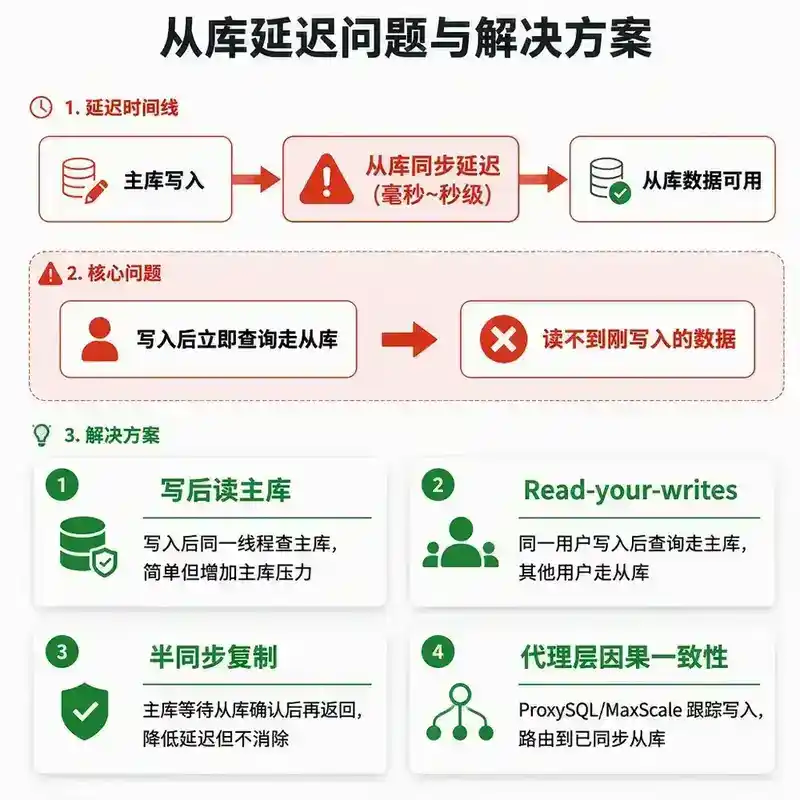
陷阱四:从库延迟导致的读不到刚写入的数据
主库写入后,从库同步有延迟(通常毫秒级,但高负载时可能达到秒级)。如果写入后立即查询,查询走从库,可能读不到刚写入的数据。解决方案:关键路径上的查询强制走主库(使用 @DataSource("master") 注解),或者使用"写后读主库"策略(写入后的一段时间内,同一线程的读操作都走主库)。
小结:动态数据源的本质是"路由",不是"切换"
AbstractRoutingDataSource 的本质是"路由"——每次 getConnection() 时根据 determineCurrentLookupKey() 返回的 key 选择对应的数据源。它不是"切换"——不会在事务中间改变 Connection。理解这个区别后,你就能解释为什么事务中数据源切换失效、为什么需要 @Primary、以及为什么跨数据源事务需要分布式事务管理器。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:**AbstractRoutingDataSource**和直接创建多个**DataSource**Bean 有什么区别?为什么不用后者?
答:多个 DataSource Bean 的问题是:Spring 容器中的 DataSource 是单例的,@Autowired DataSource 只能注入一个。如果你需要根据运行时条件(如请求上下文)动态选择数据源,多个 DataSource Bean 需要配合 @Qualifier 手动选择,而 AbstractRoutingDataSource 封装了选择逻辑——getConnection() 方法自动根据 determineCurrentLookupKey() 返回的 key 选择数据源,对上层透明。如果不同 Mapper 需要使用不同的数据源(且数据源固定不变),多 SqlSessionFactory 方案更合适;如果同一 Mapper 在运行时需要动态切换数据源(如读写分离),AbstractRoutingDataSource 更合适。
问 2:**AbstractRoutingDataSource**的**determineCurrentLookupKey()**在每次 SQL 执行时都会调用吗?在事务中呢?
答:determineCurrentLookupKey() 在 getConnection() 时调用。在非事务场景下,每次 SQL 执行都会调用 getConnection()(取决于连接池的实现),所以每次都会调用 determineCurrentLookupKey()。在事务场景下,DataSourceTransactionManager.doBegin() 调用 getConnection() 获取连接并绑定到 TransactionSynchronizationManager,事务内的后续 SQL 执行直接从 TransactionSynchronizationManager 获取已绑定的连接,不再调用 getConnection()——所以 determineCurrentLookupKey() 只在事务开始时调用一次。
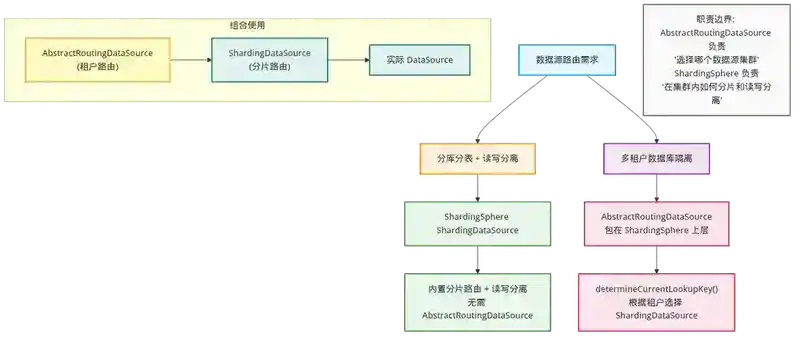
问 3:如果你的项目使用了 ShardingSphere 来实现分库分表,还需要**AbstractRoutingDataSource**吗?两者是什么关系?
答:ShardingSphere 的分库分表功能已经内置了数据源路由逻辑——它自己的 ShardingDataSource 可以配置多个数据源,并根据分片规则自动路由。读写分离也是 ShardingSphere 的内置功能(通过 read-write-splitting 配置)。使用 ShardingSphere 后,不需要再手动实现 AbstractRoutingDataSource——因为 ShardingSphere 已经在数据源层面做了路由。但如果你在 ShardingSphere 之外还有额外的数据源路由需求(如多租户的数据库隔离),可以在 ShardingSphere 的上层再包一层 AbstractRoutingDataSource。
问 4:从库同步延迟是读写分离的经典问题。除了"写后读主库",还有哪些方案可以解决这个问题?
答:还有几种方案:第一,通过 MySQL 的 SHOW SLAVE STATUS 获取从库的同步偏移量,写入后等待从库同步到指定偏移量再查询(需要应用层支持);第二,使用"读自己的写"(Read-your-writes)策略——用户写入后,同一用户的后续查询都走主库,其他用户的查询走从库;第三,使用半同步复制(Semi-synchronous Replication)——主库等待至少一个从库确认收到 binlog 后才返回写入成功,降低从库延迟;第四,使用数据库中间件(如 ProxySQL、MaxScale)在代理层实现"因果一致性"——代理层跟踪写入操作,确保后续查询路由到已同步的从库。
问 5:**AbstractRoutingDataSource**的**targetDataSources**是**Map<Object, DataSource>**,key 是 Object 类型而不是 String。为什么设计为 Object?这有什么实际用途?
答:Object 类型的 key 提供了更大的灵活性——你可以用 Enum 作为 key(类型安全),也可以用 DataSourceType 枚举类。Spring 专门说明了这一点:Map<Object, Object> 的 key 在内部会被转换为 String 进行比较(通过 resolveSpecifiedLookupKey()),所以 Enum 类型和 String 类型都可以作为 key。设计为 Object 而不是 String 的原因:允许框架在将来的版本中支持更复杂的 key 类型(如复合 key),而不破坏向后兼容。实际工程中,用 Enum 作为 key 更推荐——因为 IDE 能自动补全,不会出现拼写错误;用 String 作为 key 更灵活,但容易出现 "mater" 这样的拼写错误。