引言:为什么 和 不能混用
MyBatis 的结果映射是连接"数据库行"和"Java 对象"的桥梁。最简单的映射是 resultType="User",MyBatis 通过反射自动将列名映射到同名的 Java 属性。但一旦涉及关联查询(一对多、多对一)、嵌套对象、或者列名和属性名不一致,就必须用 resultMap。这篇文章从 ResultMap 的底层构造到关联查询的 association/collection,再到延迟加载的代理机制和 N+1 问题的根因,完整拆解 MyBatis 的结果映射体系。
一、ResultMap 的底层构造:ResultSetHandler 如何将 ResultSet 映射为 Java 对象
自动映射(Auto-Mapping)
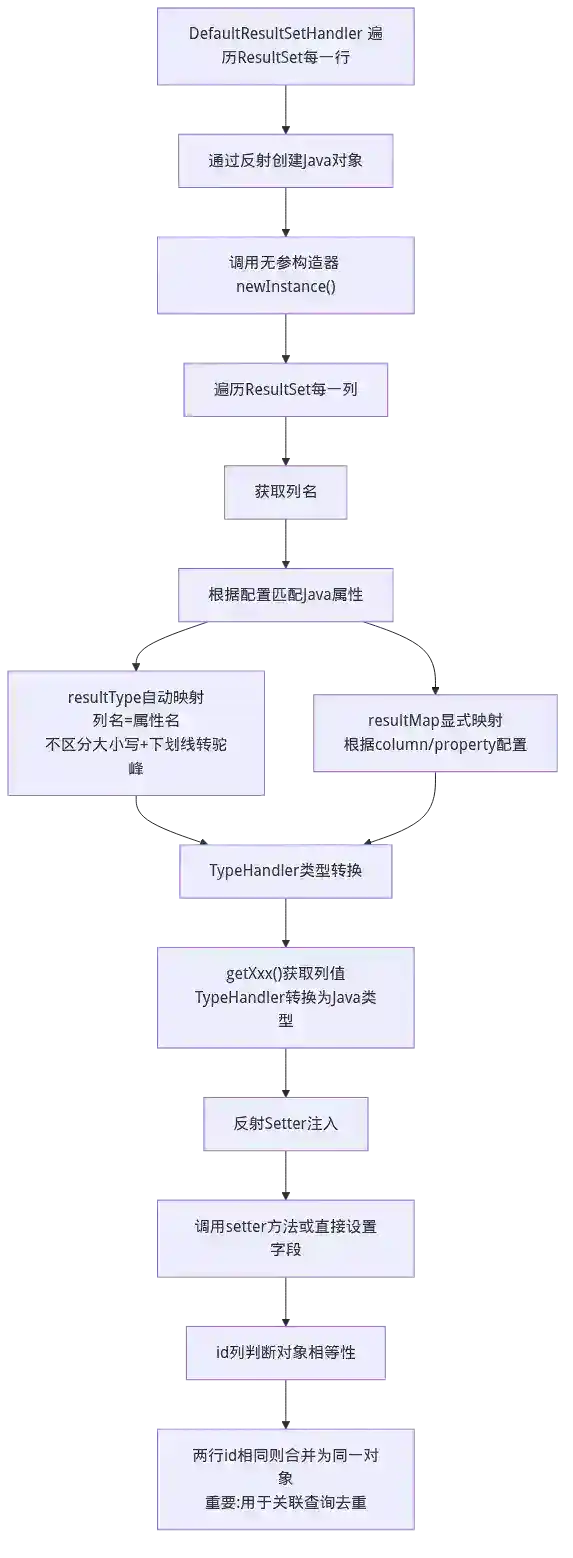
当使用 resultType="User" 时,MyBatis 的 DefaultResultSetHandler 执行以下步骤:
- 遍历
ResultSet的每一行 - 通过反射创建
User对象(调用无参构造器) - 遍历
ResultSet的每一列,根据列名查找对应的 Java 属性 - 通过
TypeHandler将列值转换为 Java 类型 - 通过反射调用
setter方法或直接设置字段值
自动映射的规则:列名 → 属性名的转换支持"不区分大小写"和"下划线转驼峰"(CREATE_TIME → createTime,需要 mapUnderscoreToCamelCase=true)。
resultMap 显式映射
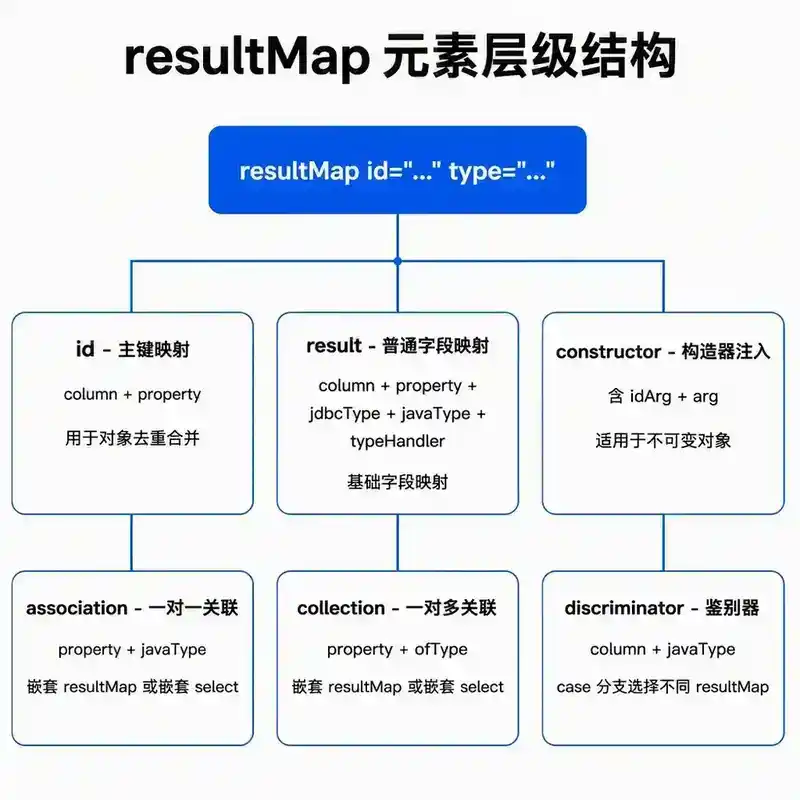
<resultMap id="userMap" type="User">
    <id column="id" property="id"/>
    <result column="user_name" property="userName"/>
    <result column="create_time" property="createTime"/>
</resultMap>
<id> 和 <result> 的区别:<id> 标记主键字段,MyBatis 用它来比较两行是否代表同一个对象(在某些场景下用于缓存去重和关联查询优化)。<result> 标记普通字段。
构造器映射
<resultMap id="userMap" type="User">
    <constructor>
        <idArg column="id" javaType="Long"/>
        <arg column="user_name" javaType="String"/>
    </constructor>
</resultMap>
<constructor> 通过构造器参数注入(而非 setter),适用于不可变对象(immutable object)。<idArg> 对应主键参数,<arg> 对应普通参数。
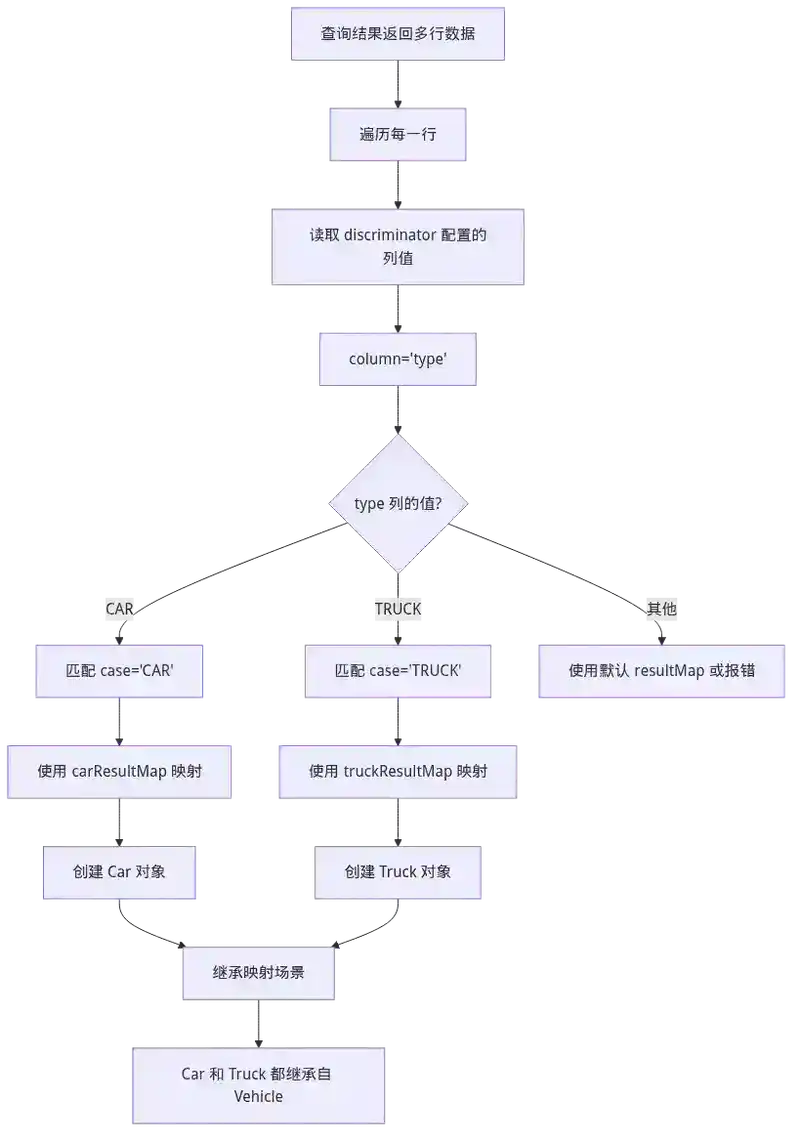
鉴别器(Discriminator)
<resultMap id="vehicleMap" type="Vehicle">
    <id column="id" property="id"/>
    <discriminator javaType="String" column="type">
        <case value="CAR" resultMap="carResultMap"/>
        <case value="TRUCK" resultMap="truckResultMap"/>
    </discriminator>
</resultMap>
鉴别器根据某一列的值,动态选择不同的 resultMap。这在继承映射场景中非常有用——比如 Vehicle 是父类,Car 和 Truck 是子类,根据 type 列的值决定映射到哪个子类。
二、关联查询:association 与 collection
一对一关联:association
<resultMap id="orderMap" type="Order">
    <id column="id" property="id"/>
    <result column="order_no" property="orderNo"/>
    <association property="user" javaType="User">
        <id column="user_id" property="id"/>
        <result column="user_name" property="userName"/>
    </association>
</resultMap>
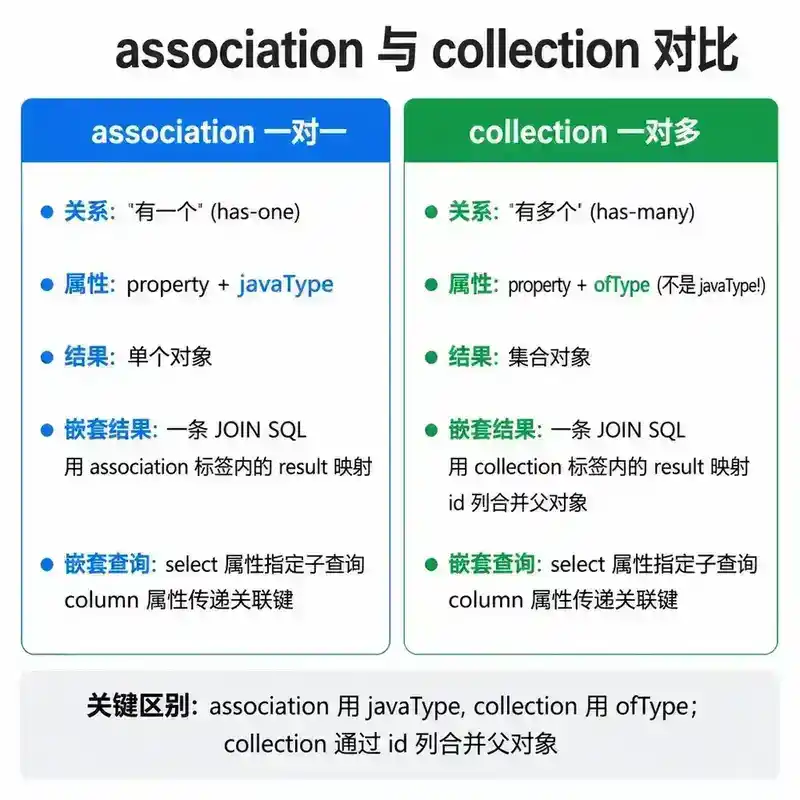
<association> 映射"有一个"关系(一对一)。它可以用嵌套 resultMap 的方式,也可以引用外部的 resultMap:
<association property="user" resultMap="userMap"/>
一对多关联:collection
<resultMap id="userMap" type="User">
    <id column="id" property="id"/>
    <result column="name" property="name"/>
    <collection property="orders" ofType="Order">
        <id column="order_id" property="id"/>
        <result column="order_no" property="orderNo"/>
    </collection>
</resultMap>
<collection> 映射"有多个"关系(一对多)。ofType 指定集合中元素的类型。MyBatis 内部使用 id 列来判断两行是否属于同一个父对象——如果多行具有相同的 id 值,它们会被合并为同一个父对象的多个子对象。
嵌套查询(Nested Select)
<resultMap id="userMap" type="User">
    <id column="id" property="id"/>
    <collection property="orders" column="id"
        select="com.example.OrderMapper.selectByUserId"/>
</resultMap>
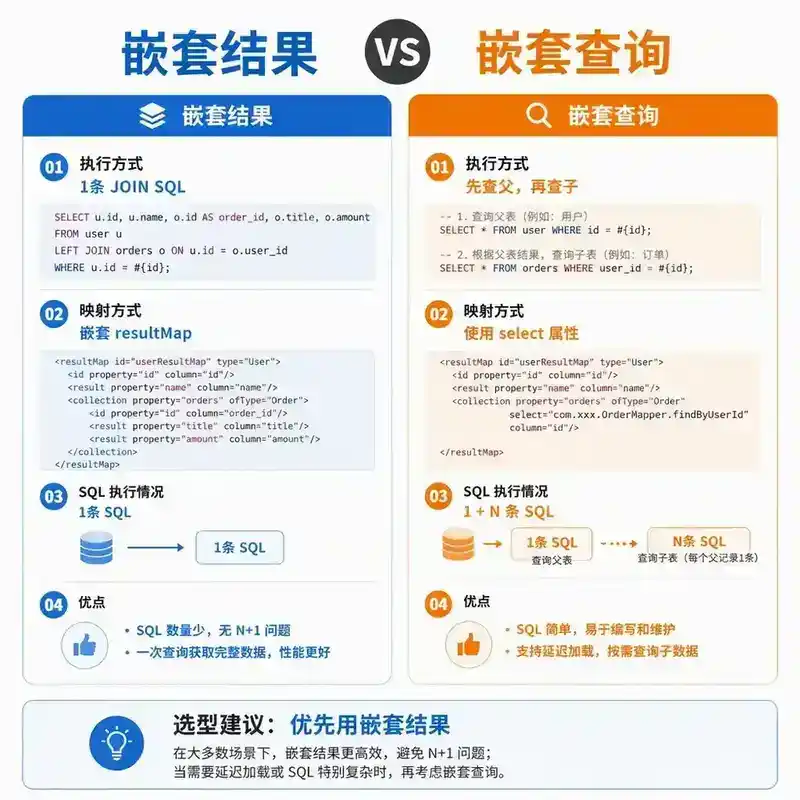
嵌套查询与嵌套结果的区别:嵌套结果(上一节)是用一条 JOIN SQL 查出所有数据,嵌套查询是先用一条 SQL 查出父对象,再对每个父对象执行一条子 SQL 查出子对象。嵌套查询的优点是 SQL 简单,缺点是会导致 N+1 问题——查 N 个父对象,需要执行 N+1 条 SQL。
三、延迟加载(Lazy Loading)
原理:CGLIB 代理
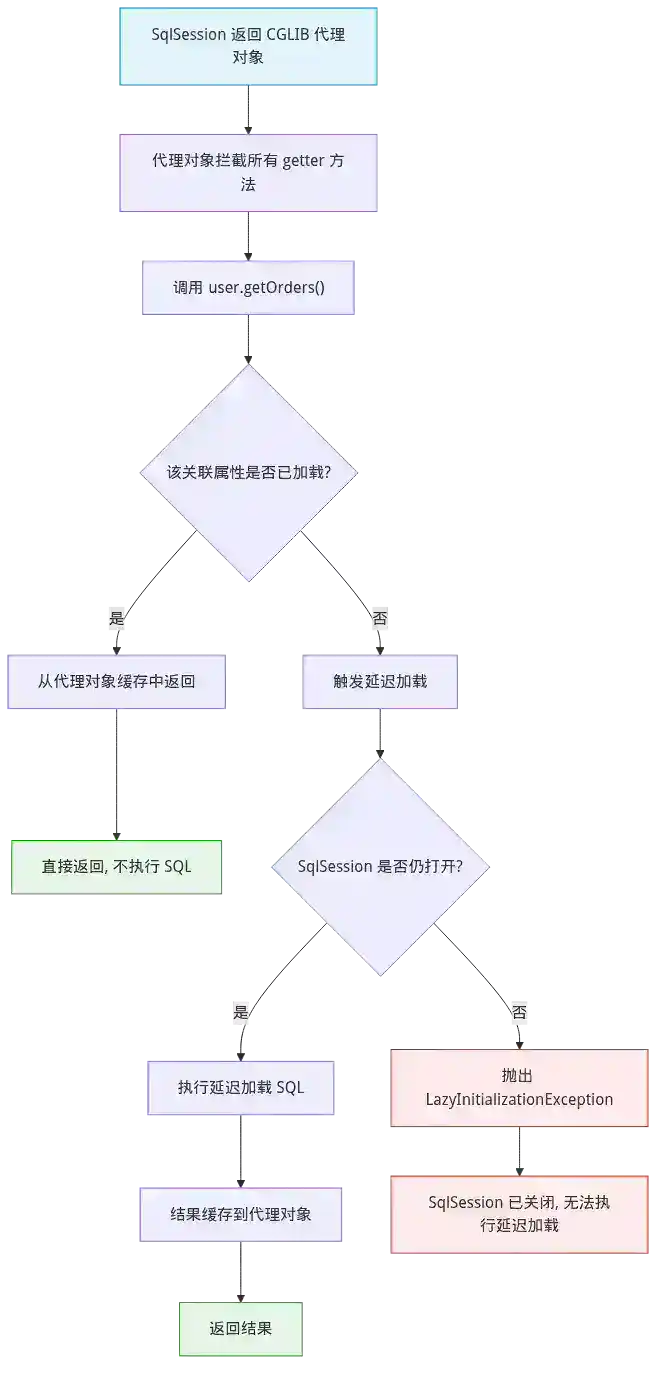
MyBatis 的延迟加载通过 CGLIB 代理实现。当 resultMap 中配置了 fetchType="lazy" 时,MyBatis 返回的不是实际的对象,而是 CGLIB 代理对象。代理对象拦截所有 getter 方法的调用,在第一次访问关联属性时执行延迟加载 SQL。
<collection property="orders" column="id"
    select="com.example.OrderMapper.selectByUserId"
    fetchType="lazy"/>
延迟加载的触发条件
延迟加载在以下条件同时满足时触发:
- 关联属性配置了
fetchType="lazy"(或全局lazyLoadingEnabled=true) - 当前
SqlSession仍然打开(SqlSession关闭后无法执行延迟加载,会抛异常) - 第一次访问该关联属性的
getter方法
延迟加载的陷阱
**SqlSession**关闭后延迟加载失败:在 Spring 集成中,非事务场景下SqlSession在 Mapper 方法返回后自动关闭。如果此时访问延迟加载的关联属性,会抛出LazyInitializationException。解决方案:在事务中访问关联属性,或者禁用延迟加载。- 序列化问题:CGLIB 代理对象不能直接序列化。需要关闭延迟加载或使用支持序列化的代理实现。
**aggressiveLazyLoading**陷阱:MyBatis 3.4.1 之前默认aggressiveLazyLoading=true,意味着访问对象的任意方法都会触发所有延迟加载——这完全违背了"延迟"的语义。3.4.1+ 默认false,只有访问关联属性时才触发加载。
四、N+1 问题:根因与解决方案
N+1 问题的典型场景
List<User> users = userMapper.selectAll();  // 1 条 SQL
for (User user : users) {
    List<Order> orders = user.getOrders();   // N 条 SQL(延迟加载触发)
}
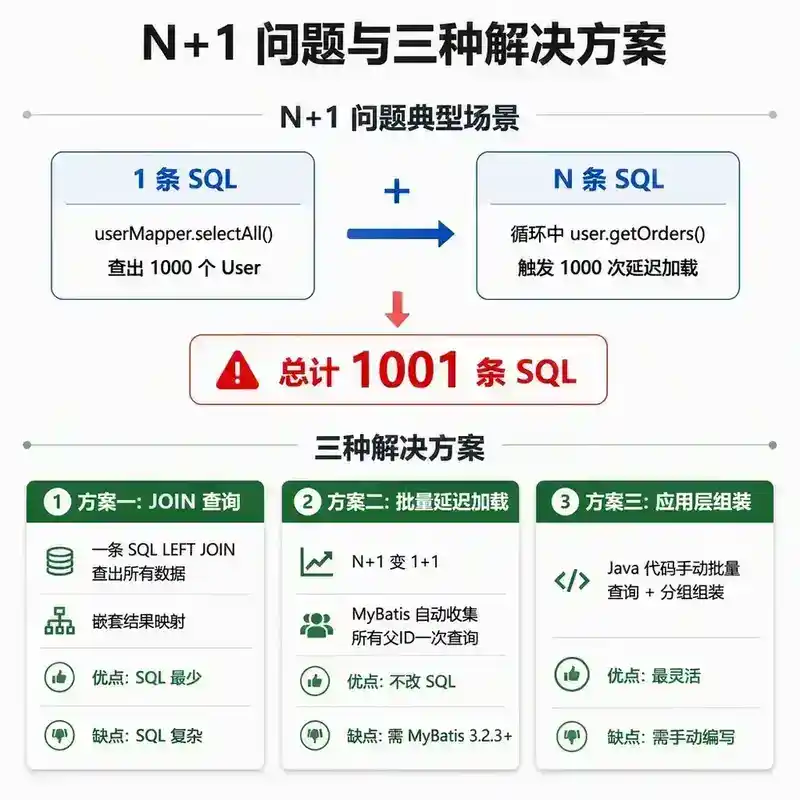
总共执行了 1 + N 条 SQL。如果 N=1000,就是 1001 条 SQL——这是典型的 N+1 问题。
解决方案一:JOIN 查询 + 嵌套结果
<select id="selectAllWithOrders" resultMap="userWithOrdersMap">
  SELECT u.*, o.id as order_id, o.order_no
  FROM user u LEFT JOIN orders o ON u.id = o.user_id
</select>
一条 SQL 查出所有数据,MyBatis 通过 <id> 列自动合并重复的父对象。这是解决 N+1 问题最直接的方式。
解决方案二:批量查询(Batch Lazy Loading)
MyBatis 3.2.3+ 支持"激进延迟加载"的优化:当第一个 user.getOrders() 被调用时,MyBatis 一次性查询所有 user 的 orders(而不是一个一个查),然后按 user_id 分组,后续 user.getOrders() 直接从缓存中返回。
<!-- 开启批量懒加载 -->
<setting name="lazyLoadTriggerMethods" value="equals,clone,hashCode,toString"/>
解决方案三:应用层组装
在 Java 代码中,先查出所有 user,再根据 user_id 列表一次查出所有 order,然后在内存中按 user_id 分组组装。这是最灵活的方式,但需要手动编写组装逻辑。
List<User> users = userMapper.selectAll();
List<Long> userIds = users.stream().map(User::getId).collect(Collectors.toList());
List<Order> orders = orderMapper.selectByUserIds(userIds);
Map<Long, List<Order>> orderMap = orders.stream()
    .collect(Collectors.groupingBy(Order::getUserId));
users.forEach(u -> u.setOrders(orderMap.getOrDefault(u.getId(), Collections.emptyList())));
五、常见陷阱
陷阱一:column 属性名写错不报错
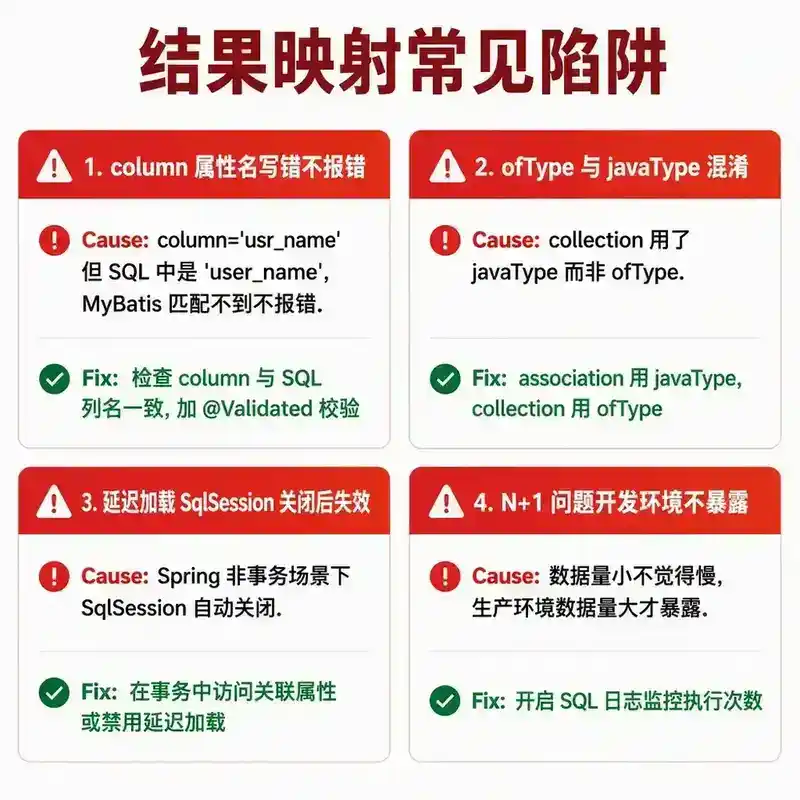
<result column="user_name" property="userName"/> 如果 column 写成了 "usr_name",MyBatis 不会报错——它只是匹配不到这一列,userName 保持默认值(null)。排查时检查 column 是否与 SQL 中的列名一致。
陷阱二:ofType 与 javaType 混淆
<collection> 用 ofType 指定集合元素类型,<association> 用 javaType 指定关联对象类型。如果 <collection> 用了 javaType,MyBatis 不会报错,但映射结果可能不符合预期。
陷阱三:延迟加载与序列化
如果启用了延迟加载,返回的 CGLIB 代理对象不能直接序列化。在需要序列化的场景(如 Redis 缓存、RPC 传输),需要关闭延迟加载或在序列化前触发所有延迟加载。
陷阱四:N+1 问题的隐蔽性
N+1 问题在开发环境(数据量小)不会暴露,到生产环境(数据量大)才表现为 SQL 执行次数暴增。排查方法:开启 MyBatis SQL 日志(logging.level.com.example.mapper=DEBUG),观察 SQL 执行次数与预期是否一致。
小结:映射的本质是"数据库行"到"Java 对象图"的转换
MyBatis 的结果映射不是简单的"列到属性"的复制——它是"关系型数据"到"对象图"的转换。association 和 collection 分别对应对象图中的"引用"和"集合"关系,ResultSetHandler 通过 <id> 列判断对象相等性,延迟加载通过 CGLIB 代理实现按需加载。理解这套映射体系后,你就能在面试中清楚地解释:为什么多表关联查询用 JOIN 还是子查询(N+1 问题),为什么延迟加载在 Spring 中会失效(SqlSession 生命周期),以及鉴别器在继承映射场景中的应用。
(以上正文阅读时长约 40-50 分钟,以下问答部分不计入正文阅读时长)
文末答疑:面试官会怎么问
问 1:MyBatis 的自动映射和**resultMap**显式映射,在性能上有什么区别?什么时候应该用自动映射,什么时候必须用**resultMap**?
答:性能上,自动映射和 resultMap 的差异很小——两者都通过反射设置属性值,resultMap 多了一步"按映射配置查找列名"的开销,但可以忽略不计。选型更关注的是"列名与属性名是否一致"和"是否有嵌套对象"。自动映射适合"列名与属性名一致"的简单场景,resultMap 适合三种场景:列名与属性名不一致(如 user_name → userName)、有嵌套对象(association/collection)、需要构造器注入或鉴别器。工程上建议:即使列名和属性名一致,也尽量用 resultMap——因为数据库列的命名可能变化,而 resultMap 把映射关系集中管理,修改时只需改一处。
问 2:**<id>**和**<result>**在 MyBatis 内部有什么区别?为什么**<id>**在关联查询中很重要?
答:<id> 标记的列用于判断"两行是否代表同一个对象"。在关联查询中,MyBatis 用 <id> 列的值来合并多行数据——如果多行具有相同的 <id> 值,它们被合并为同一个父对象(<collection> 中的子对象被追加到同一个父对象的集合中)。如果 <id> 配置错误(比如把非主键列标记为 <id>),会导致错误的合并结果——原本应该分开的两个对象被合并成一个。如果完全没有 <id>,MyBatis 会比较所有列的值来判断对象相等性,性能下降且结果可能不正确。
问 3:延迟加载的 CGLIB 代理对象和 MyBatis 的 Mapper 代理对象,都是 JDK/CGLIB 代理。它们有什么区别?为什么延迟加载用 CGLIB 而不是 JDK 动态代理?
答:Mapper 代理对象是 JDK 动态代理(因为 Mapper 是接口),代理的是接口方法调用,拦截后将调用转发给 SqlSession。延迟加载代理对象是 CGLIB 代理(因为结果对象是具体类,不是接口),代理的是 getter 方法调用,拦截后在第一次访问关联属性时触发延迟加载 SQL。延迟加载用 CGLIB 而不是 JDK 动态代理的原因是:JDK 动态代理只能代理接口,而结果对象(如 User)是具体类,没有实现特定接口。如果结果对象实现了某个接口,也可以用 JDK 动态代理——但 MyBatis 默认使用 CGLIB 以保证通用性。
问 4:N+1 问题除了用 JOIN 解决,还有什么不修改 SQL 的解决方案?批量延迟加载(Batch Lazy Loading)是怎么工作的?
答:批量延迟加载的原理是:当第一个 user.getOrders() 被调用时,MyBatis 不是只查这个 user 的 orders,而是收集所有已加载的 user 的 id,用一条 WHERE user_id IN (?, ?, ...) SQL 一次性查出所有 orders,然后按 user_id 分组缓存。后续其他 user 的 getOrders() 直接从缓存中返回,不再执行 SQL。关键配置:<setting name="lazyLoadTriggerMethods" value="equals,clone,hashCode,toString"/> 确保只有真正访问关联属性时才触发延迟加载。这个方案的优势是:SQL 不改变(仍然是嵌套查询),但 N+1 变成了 1+1(1 条查 user + 1 条查 orders)。
问 5:如果 MyBatis 的结果映射中,**collection**里的子对象有重复,MyBatis 怎么去重?如果不去重,会有什么问题?
答:MyBatis 不会自动去重。如果 JOIN 查询结果中,同一个父对象关联了多个子对象,且子对象中有重复的行(比如 order_items 表中有两行完全相同的记录),MyBatis 会忠实地将这两行都映射为子对象并添加到集合中——导致集合中出现重复元素。MyBatis 只通过 <id> 列合并父对象,不会对子对象去重。如果需要对子对象去重,有两种方案:在 SQL 中用 DISTINCT 或在 Java 代码中用 Set 代替 List 接收结果(<collection property="items" ofType="Item" javaType="java.util.LinkedHashSet"/>)。