阅读时间:约 45 分钟 难度:中级 前置知识:Java 基础语法、至少完整写过一个小型项目 分类:Java 语言基础与面向对象
大纲
- 引言:OOP 不是银弹,但你必须先理解它
- 封装:信息隐藏的层次——从字段到模块
- 继承:IS-A 关系的正确使用与滥用
- 多态:运行时行为替换的机制与设计
- 抽象:从具体到一般的认知建模
- 四大特性的协作与冲突
- 常见误区与面试翻车现场
- 总结:如何真正理解 OOP
- 面试提问(文末)
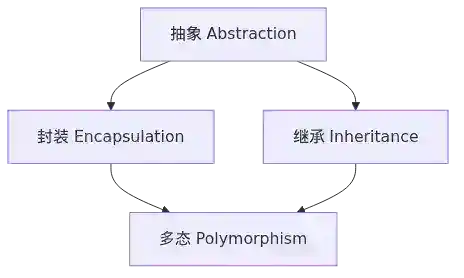
1. 引言:OOP 不是银弹,但你必须先理解它
"封装、继承、多态、抽象"——如果你在简历上写了"精通 Java",面试官几乎必然会让你说说面向对象的四大特性。这个问题的危险之处在于:人人都能说出这四个词,但能讲清楚边界和取舍的人不足两成。
大部分人的回答停留在教科书层面:封装是 private 字段 + getter/setter,继承是 extends,多态是父类引用指向子类对象,抽象是 abstract class。这些回答在初级面试中也许够用,但面对技术专家岗位的追问——"什么时候不该用继承?""封装到什么粒度?""多态的性能代价?"——就会瞬间暴露理解深度。
本文的目标不是再重复一遍教科书,而是带你穿过这四个概念的表面,看清它们在真实工程中的边界、代价与取舍。
在开始之前,我们先把结论放在前面:
封装是关于"知道什么"——限制可见性;继承是关于"是什么"——建立层次关系;多态是关于"做什么"——行为可替换;抽象是关于"忽略什么"——提取本质而忽略细节。这四个特性不是孤立的,它们彼此交织:没有封装,多态就暴露了实现细节;没有抽象,继承就变成了代码复制;没有多态,继承就失去了最大的价值。
2. 封装:信息隐藏的层次——从字段到模块
2.1 封装不是"private + getter/setter"
这是最常见也最肤浅的理解。如果你把每个字段都加上 getter/setter,那不叫封装——那叫用 getter/setter 把字段暴露了一遍,信息隐藏为零。
// ❌ 这不是封装,这只是语法糖包装
public class BankAccount {
    private BigDecimal balance;  // 字段是 private 的

    public BigDecimal getBalance() { return balance; }  // 但我原样暴露了
    public void setBalance(BigDecimal b) { this.balance = b; }  // 外部可以任意修改
}
// 外部代码可以 balance.setBalance(balance.getBalance().subtract(amount))
// 这跟把 balance 设成 public 有区别吗?几乎没有。
// ✅ 这才是封装:隐藏内部状态,暴露有意义的行为
public class BankAccount {
    private BigDecimal balance;       // 内部状态不可见
    private List<Transaction> history; // 同样是内部状态

    public void deposit(BigDecimal amount) {
        if (amount.compareTo(BigDecimal.ZERO) <= 0)
            throw new IllegalArgumentException("存款金额必须大于0");
        balance = balance.add(amount);
        history.add(new Transaction("DEPOSIT", amount));
    }

    public void withdraw(BigDecimal amount) {
        if (amount.compareTo(balance) > 0)
            throw new InsufficientFundsException("余额不足");
        balance = balance.subtract(amount);
        history.add(new Transaction("WITHDRAW", amount));
    }

    public BigDecimal getBalance() { return balance; }  // 只读暴露是合理的
    // 注意:没有 setBalance!外部不能直接修改余额
}
这两个例子的区别体现了封装的本质:不是"把数据藏起来",而是"控制哪些操作是合法的"。
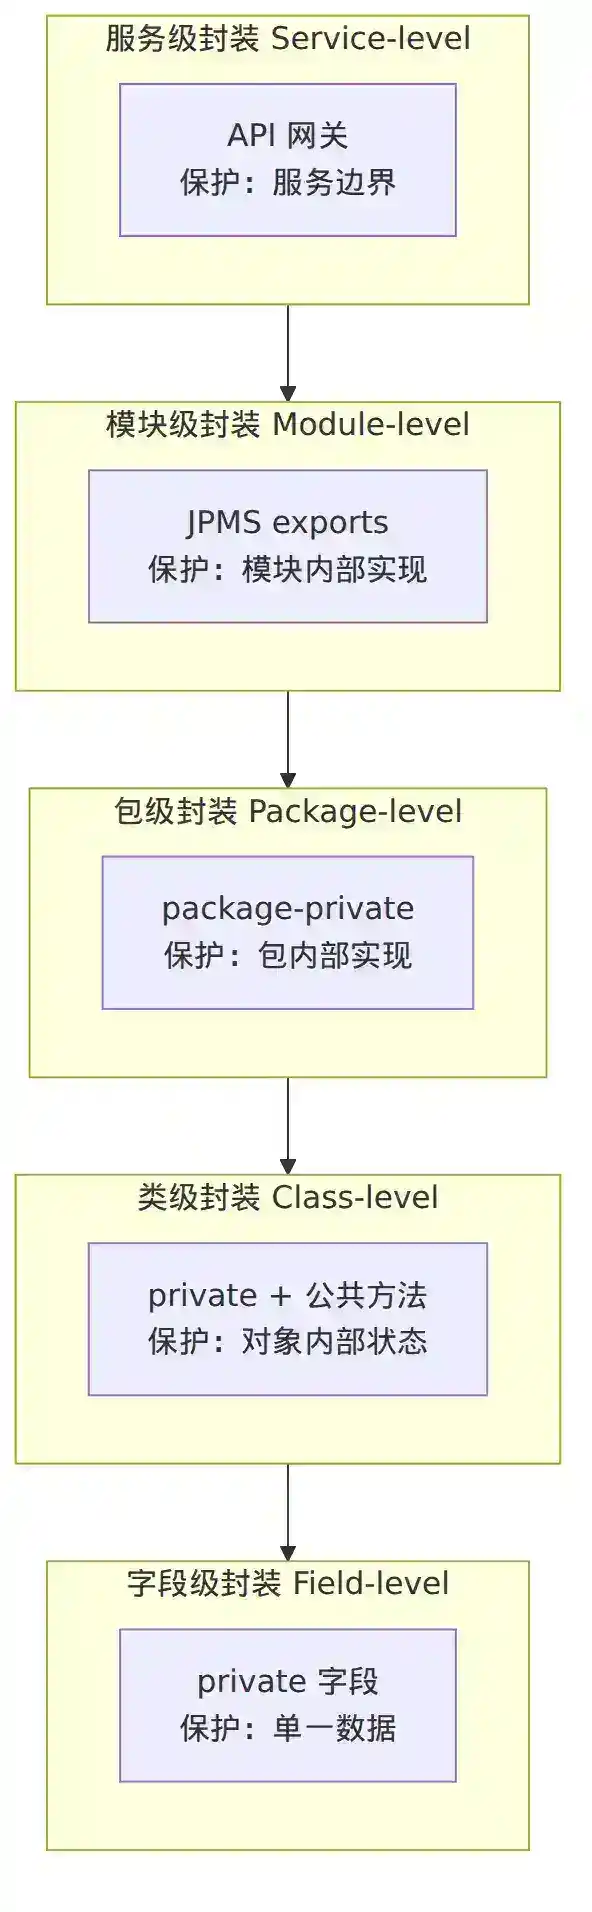
2.2 封装的四个层次
封装在任何稍大的系统中都是分层实施的:
| 层次 | 机制(Java) | 保护什么 | 典型错误 |
|---|---|---|---|
| 字段级 | private |
单个字段的直接访问 | 不假思索地生成所有 getter/setter |
| 类级 | private + 公共方法 |
类的内部数据结构 | 返回可变内部对象的引用(防御性复制缺失) |
| 包级 | package-private + internal(Kotlin) |
包内实现细节 | 把同一包当作"内部"来用,实际被外部依赖 |
| 模块级 | JPMS exports、ArchUnit 规则 |
模块间的依赖方向 | 模块间出现循环依赖 |
| 服务级 | API 网关、接口契约 | 服务的内部架构 | 把数据库表结构直接暴露给调用方 |
字段级封装只是起点。真正重要的是类级和模块级封装。一个经典的反面案例:
// ❌ 返回了可变内部对象的引用,封装被破坏
public class Order {
    private List<OrderItem> items = new ArrayList<>();

    public List<OrderItem> getItems() {
        return items;  // 外部可以直接 items.clear()!封装形同虚设
    }
}
// 外部代码:
order.getItems().clear();  // 绕过了 Order 的所有业务规则
正确的做法是返回不可变视图或防御性复制:
public List<OrderItem> getItems() {
    return Collections.unmodifiableList(items);  // 只读视图
}
// 或者如果外部需要的是独立副本:
public List<OrderItem> getItems() {
    return items.stream().map(OrderItem::copy).toList();
}
2.3 封装与可测试性:一种健康的张力
封装和可测试性之间确实存在张力——为了测试你可能需要暴露一些内部状态。解决方式不是放弃封装,而是设计时就考虑可测试性:
- 包级访问:把测试放在同一个包下,用 package-private 暴露必要的内部方法
- 构造函数注入:把可变部分(如依赖、配置)通过构造函数传入,而不是内部 new
- 提取策略对象:把需要单独测试的复杂逻辑提取为独立的策略类,用组合替代继承
// 测试友好的封装设计
public class PricingEngine {
    private final DiscountStrategy discountStrategy;  // 通过构造注入

    public PricingEngine(DiscountStrategy strategy) {
        this.discountStrategy = strategy;
    }

    BigDecimal calculate(Order order) {  // 包级可见,测试可访问
        BigDecimal subtotal = order.getSubtotal();
        return discountStrategy.apply(subtotal);
    }
}
3. 继承:IS-A 关系的正确使用与滥用
3.1 继承解决什么问题
继承的核心价值是实现代码复用和建立类型层次。当你有一组类的行为几乎相同,只是某些方法有差异时,可以用继承提取公共部分:
abstract class PaymentProcessor {
    public PaymentResult process(PaymentRequest request) {
        validateRequest(request);           // 所有子类共用
        Transaction tx = createTransaction(request);
        PaymentResult result = doPay(tx);   // 子类各自实现
        notifyUser(result);                 // 所有子类共用
        return result;
    }

    private void validateRequest(PaymentRequest req) { /* 通用校验 */ }
    private void notifyUser(PaymentResult result) { /* 通用通知 */ }
    protected abstract PaymentResult doPay(Transaction tx); // 留给子类
}

class AlipayProcessor extends PaymentProcessor { /* 实现 doPay */ }
class WechatPayProcessor extends PaymentProcessor { /* 实现 doPay */ }
这个例子中,process 方法定义了模板(模板方法模式),doPay 是留给子类的钩子。继承在这里用得合理——AlipayProcessor IS-A PaymentProcessor 在语义上成立。
3.2 继承的三大陷阱
陷阱一:为复用代码而继承
// ❌ Stack 不是 Vector,它不应该暴露 insertElementAt()
public class Stack<E> extends Vector<E> {
    public E push(E item) { addElement(item); return item; }
    public E pop() { /* ... */ }
}
// 你可以这样用 Stack:stack.insertElementAt(x, 0)
// 这彻底破坏了栈的 LIFO 语义!
Java 标准库中的 Stack extends Vector 是一个公认的设计失误。Stack 不应该是一个 Vector——它的语义是后进先出,而 Vector 允许任意位置的插入删除。这就是为复用而继承的代价:你继承了不该暴露的方法,破坏了子类的语义约束。
如果只是为了复用代码,用组合。
// ✅ 组合:Stack 持有一个 List,只暴露栈操作
public class Stack<E> {
    private final List<E> elements = new ArrayList<>();

    public void push(E item) { elements.add(item); }
    public E pop() {
        if (elements.isEmpty()) throw new EmptyStackException();
        return elements.remove(elements.size() - 1);
    }
    // 没有 insert、remove(index) 等方法暴露
}
陷阱二:继承层次过深
超过 3 层的继承链就开始变得难以理解。每多一层,理解一个方法的行为就需要追溯更多父类。Spring 框架内部有很深的继承层次(如 AnnotationConfigApplicationContext 的继承链有 5 层以上),但这是框架设计——框架需要极致的灵活性和扩展点。业务代码不应该模仿框架代码的设计。
陷阱三:继承破坏了封装
这是 Effective Java 中 Joshua Bloch 的核心论点之一:
public class InstrumentedHashSet<E> extends HashSet<E> {
    private int addCount = 0;

    @Override
    public boolean add(E e) {
        addCount++;
        return super.add(e);
    }

    @Override
    public boolean addAll(Collection<? extends E> c) {
        addCount += c.size();
        return super.addAll(c);  // HashSet.addAll 内部调用 this.add()!
    }

    public int getAddCount() { return addCount; }
}
// addAll(Arrays.asList("a", "b", "c")) → addCount = 6 而不是 3
因为 HashSet.addAll 的实现细节是在内部循环调用 add(),而你的子类覆盖了这两个方法,导致 addCount 被重复计数。子类依赖了父类的实现细节,而父类的实现细节不受任何契约保护。
3.3 何时用继承、何时用组合
| 场景 | 使用 | 理由 |
|---|---|---|
| 真正的 IS-A 关系 | 继承 | 语义正确,类型系统能表达 |
| 仅为复用代码 | 组合 | 避免破坏封装,更灵活 |
| 需要多态替换 | 继承或接口 | 接口优先,继承作为实现辅助 |
| 父类是你自己控制的 | 继承 | 你能同步修改父类,不怕实现细节泄露 |
| 父类是第三方库的 | 组合 + 包装 | 你不知道第三方什么时候改实现 |
| 层次可能演变成多个维度 | 组合 | 单继承无法表达多维变化 |
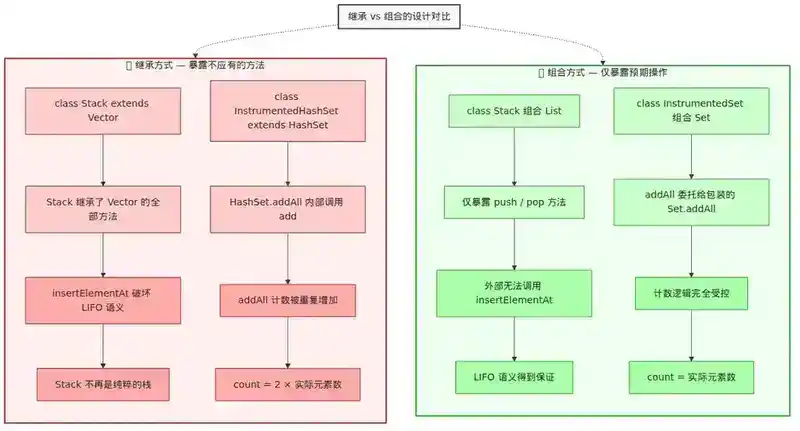
一个判断铁律:如果你不能自信地说"A IS-A B"——比如你能说"正方形 IS-A 矩形"但所有边长必须相等(这其实有争议)——那就不要用继承。
4. 多态:运行时行为替换的机制与设计
4.1 多态的两种形式
Java 中的多态有两种基本形式:
编译期多态(静态分派):
// 重载 — 根据参数的编译期类型选择方法
public class Printer {
    public void print(String s)  { System.out.println("String: " + s); }
    public void print(Integer i) { System.out.println("Integer: " + i); }
    public void print(Object o)  { System.out.println("Object: " + o); }
}

Object obj = "hello";
printer.print(obj);  // 输出 "Object: hello" — 而不是 "String: hello"
// 因为重载方法的绑定发生在编译期,依据参数的声明类型(Object)而非实际类型(String)
运行期多态(动态分派):
// 重写 — 根据对象的实际运行时类型选择方法
interface Animal { void speak(); }
class Dog implements Animal { public void speak() { System.out.println("Woof"); } }
class Cat implements Animal { public void speak() { System.out.println("Meow"); } }

Animal a = new Dog();
a.speak();  // 输出 "Woof" — 运行时根据实际类型分派

a = new Cat();
a.speak();  // 输出 "Meow"
静态分派和动态分派的区别是面试中的高频追问点。一个容易混淆的场景:
public class Dispatcher {
    void handle(Animal a) { System.out.println("Animal handler"); }
    void handle(Dog d)    { System.out.println("Dog handler"); }

    public static void main(String[ ] args) {

        Dispatcher d = new Dispatcher();
        Animal dog = new Dog();
        d.handle(dog);  // 输出什么?
    }
}
// 输出:"Animal handler"
// handle() 是重载(静态分派),编译期 dog 的类型是 Animal,绑定到 handle(Animal)
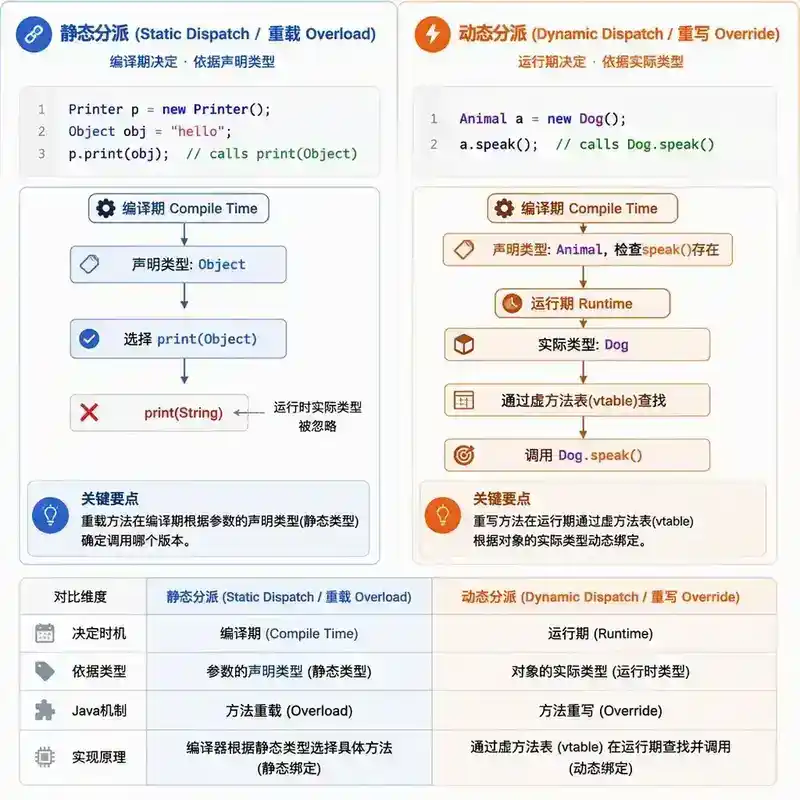
4.2 多态的底层机制
JVM 实现动态分派的两种方式:
- 虚方法表(vtable):每个类在方法区有一张虚方法表,记录了该类每个虚方法对应的实际入口地址。调用
obj.method()时,JVM 根据obj的实际类型找到对应的虚方法表,查表跳转。这是一次间接寻址,开销极小。 - 内联缓存(Inline Cache):现代 JVM 的 JIT 编译器会进一步优化。如果某个调用点
animal.speak()在运行时绝大多数时候(比如 95%)调用的都是Dog.speak,JIT 会将该调用编译为:
if (animal.getClass() == Dog.class)
    // 直接内联 Dog.speak 的代码(或直接跳转)
else
    // 走虚方法表
这使得绝大多数情况下多态调用的性能几乎等同于直接调用——这就是为什么"多态有性能代价"在实际生产系统中通常不是问题。
4.3 多态不在于语法,而在于设计
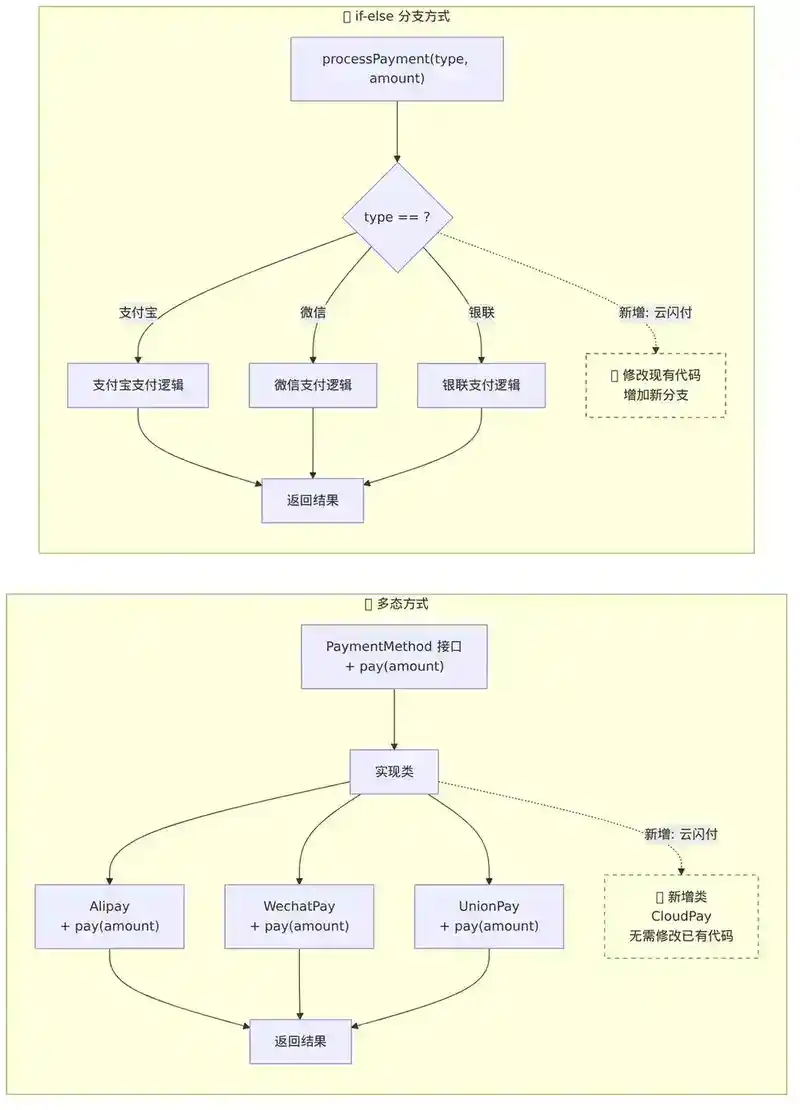
语法上的多态很简单——Animal a = new Dog()。真正的多态体现在开闭原则(OCP) 的设计中:
// ❌ 没有利用多态——每增加一种支付方式就要修改 process 方法
public void process(String paymentType) {
    if ("alipay".equals(paymentType)) {
        // 支付宝逻辑
    } else if ("wechat".equals(paymentType)) {
        // 微信支付逻辑
    } else if ("unionpay".equals(paymentType)) {
        // 银联逻辑(新增:必须修改这个类)
    }
}
// ✅ 多态设计——增加新支付方式只需新增类,process 方法不用改
interface PaymentMethod { void pay(Order order); }
class Alipay implements PaymentMethod { /* ... */ }
class WechatPay implements PaymentMethod { /* ... */ }
class UnionPay implements PaymentMethod { /* ... */ }

public void process(PaymentMethod method, Order order) {
    method.pay(order);  // 一行替代了所有 if-else
}
这就是多态在工程中的真正价值——不是你会写**extends**和**implements**,而是你会用它们构建可扩展的系统。
5. 抽象:从具体到一般的认知建模
5.1 抽象的本质
在四大特性中,抽象是最根本的——它是其他三个特性的认知前提。没有抽象,你不会想到把 Dog、Cat、Bird 的共同部分提取为 Animal;没有 Animal 这个抽象概念,也就没有基于它的继承和多态。
抽象有两层含义:
- 认知层面的抽象:从具体事物中识别本质特征、忽略无关细节。这是一种思维方式,不依赖于任何编程语言。
- 语言层面的抽象:用编程语言提供的机制(接口、抽象类、泛型)来表达你的认知抽象。
// 认知抽象:从"狗"、"猫"、"鸟"中提取出"动物"这个概念
// 语言抽象:用 interface 表达这个概念
interface Animal {
    void move();   // 所有动物都会移动,但方式不同
    void eat();    // 所有动物都需要进食
    // 我们"忽略"了具体的移动方式和食谱——这就是抽象
}
5.2 接口 vs 抽象类:选择取决于"关系"而非"语法"
这是面试中的经典题目。大多数回答是:"接口定义行为契约,抽象类可以包含状态和部分实现。"——这没错,但只是语法层面的区别。从设计角度看:
| 维度 | 接口 | 抽象类 |
|---|---|---|
| 语义关系 | CAN-DO(能做某事) | IS-A(是什么) |
| 可组合性 | 多实现,灵活组合 | 单继承,受限制 |
| 演化能力 | 加默认方法需兼容 | 加具体方法不影响子类 |
| 状态承载 | 不能有实例字段 | 可以有字段 |
| 构造函数 | 无 | 有(供子类调用) |
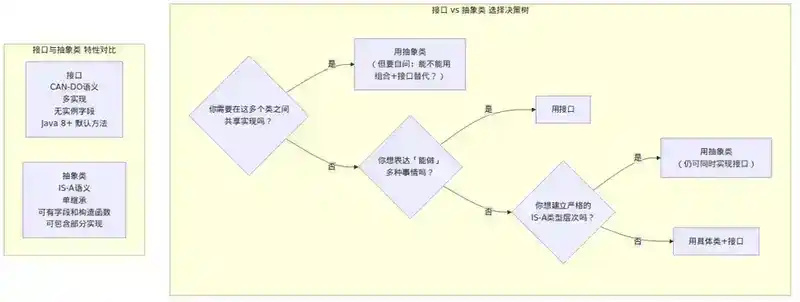
选择接口的典型场景:你想表达一个对象"能做"多种互不相关的事情。
class User implements Serializable, Comparable<User>, Cloneable {
    // User IS NOT A Serializable → User CAN BE serialized
    // User IS NOT A Comparable → User CAN BE compared
    // User IS NOT A Cloneable → User CAN BE cloned
}
选择抽象类的典型场景:有一组类共享了大量实现代码,但存在几个"留白"方法。
abstract class BaseController {
    // 公共实现
    protected <T> Result<T> executeWithAudit(Supplier<T> action) {
        long start = System.currentTimeMillis();
        try {
            T result = action.get();
            auditLog("SUCCESS", System.currentTimeMillis() - start);
            return Result.ok(result);
        } catch (BusinessException e) {
            auditLog("BIZ_ERROR", System.currentTimeMillis() - start);
            return Result.fail(e.getCode(), e.getMessage());
        }
    }
    // 留给子类:不同业务需要不同的校验逻辑
    protected abstract void validate(Request req);
}
一个实用的选择算法:
你需要在多个类之间共享实现吗?
├── 是 → 用抽象类(但要自问:能不能用组合 + 接口替代?)
└── 否 → 你想表达"能做"多种事情吗?
    ├── 是 → 用接口
    └── 否 → 你想建立严格的 IS-A 类型层次吗?
        ├── 是 → 用抽象类(仍可同时实现接口)
        └── 否 → 用具体类 + 接口
5.3 抽象的层次:不能太高也不能太低
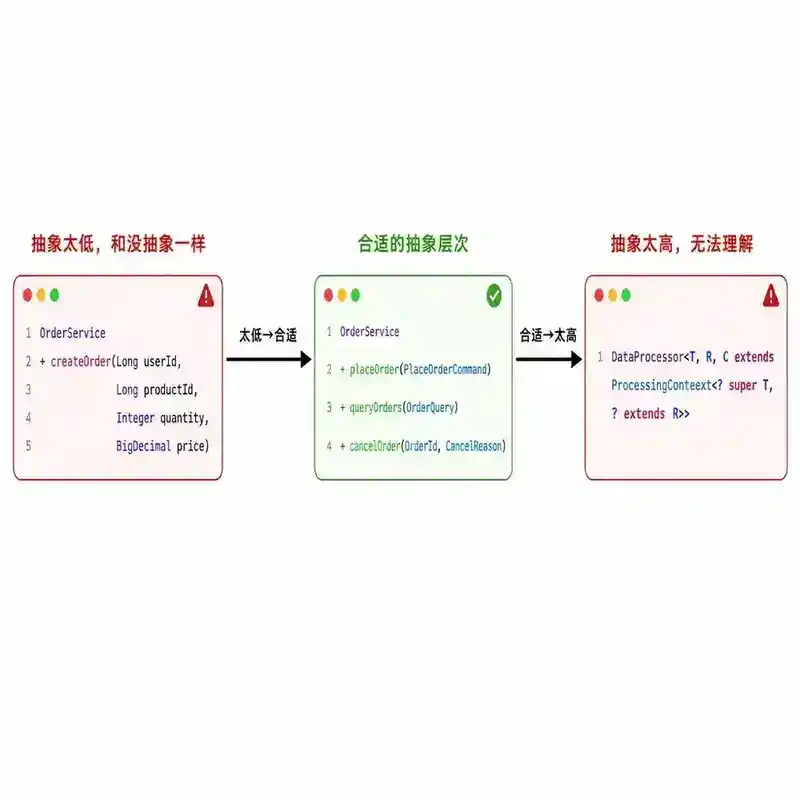
抽象的层次是一个持续困扰工程师的问题。来看看两种极端:
// ❌ 抽象层次太低:跟没抽象一样
interface OrderService {
    Order createOrder(Long userId, Long productId, Integer quantity, BigDecimal price);
    // 参数列表跟数据库字段一一对应,接口只是 DAO 的薄封装
}

// ❌ 抽象层次太高:完全不可用
interface DataProcessor<T, R, C extends ProcessingContext<? super T, ? extends R>> {
    ProcessingResult<R, C> process(DataRequest<T, C> request, ProcessingStrategy<T, R, C> strategy);
    // 谁能一眼看懂这个接口是干什么的?
}
好的抽象应该让使用者不需要读实现就能理解接口的意图:
// ✅ 合适的抽象层次
interface OrderService {
    OrderResult placeOrder(PlaceOrderCommand command);  // 意图明确:下单
    OrderQueryResult queryOrders(OrderQuery query);     // 意图明确:查单
    void cancelOrder(OrderId orderId, CancelReason reason);  // 意图明确:取消
}
衡量抽象质量的标准:一个新的团队成员能多快理解这个接口的意图?如果一个接口需要看实现才能理解,那这个抽象就是失败的。
6. 四大特性的协作与冲突
6.1 协作
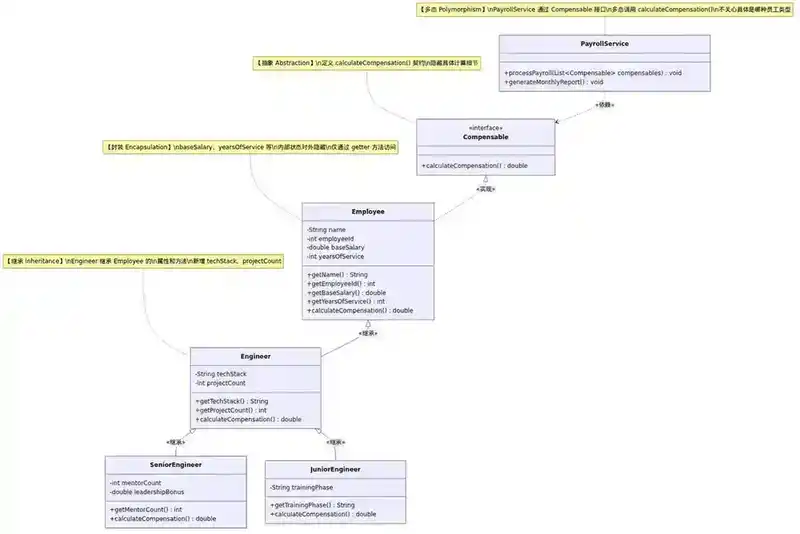
四个特性不是四个独立的概念,它们在真实代码中总是协同工作。来看一个完整的例子:
// 1. 抽象:定义"可计算报酬"的概念
interface Compensable {
    BigDecimal calculateCompensation();  // 忽略具体计算公式
}

// 2. 封装:隐藏内部状态
class Employee {
    private final String id;
    private final BigDecimal baseSalary;
    private final int yearsOfService;

    // constructor, getters...
    // 注意:没有无意义的 setter
}

// 3. 继承:IS-A 关系成立
abstract class Engineer extends Employee implements Compensable {
    protected final List<Project> projects;

    // 4. 多态:子类各自实现报酬计算
}

class SeniorEngineer extends Engineer {
    private static final BigDecimal BONUS_RATE = new BigDecimal("0.2");

    @Override
    public BigDecimal calculateCompensation() {
        return baseSalary.add(baseSalary.multiply(BONUS_RATE))
                .add(projectBonus());
    }
}

class JuniorEngineer extends Engineer {
    @Override
    public BigDecimal calculateCompensation() {
        return baseSalary;  // 初级工程师暂时没有项目分成
    }
}

// 使用方只需要知道 Compensable 这个抽象
class PayrollService {
    BigDecimal computeTotalPayroll(List<Compensable> staff) {
        return staff.stream()
                .map(Compensable::calculateCompensation)  // 多态!
                .reduce(BigDecimal.ZERO, BigDecimal::add);
    }
}
6.2 冲突
这四个特性并非永远和谐共处。以下是真实工程中常见的冲突和取舍:
| 冲突对 | 场景 | 建议 |
|---|---|---|
| 继承 vs 封装 | 子类依赖父类实现细节 → 父类改动破坏子类 | 父类的非公开方法不要被子类依赖;或改用组合 |
| 多态 vs 封装 | 为了多态需要把方法设为 protected → 暴露了内部细节 |
用接口限定公共 API,protected 方法加文档标注"不稳定" |
| 抽象 vs 继承 | 过度抽象导致继承层次过深 | 接口隔离原则:不要把不相干的方法放在同一个接口 |
| 封装 vs 抽象 | 过度封装让抽象难以理解 | 不要因为"将来可能变化"而提前封装——YAGNI |
7. 常见误区与面试翻车现场
误区一:"Java 中一切皆对象"
不对。Java 中有原始类型(int、long、double 等),它们不是对象。从 Java 5 的自动装箱开始,原始类型和包装类之间有了隐式转换,但它们在内存布局、性能语义、空值处理上完全不同。
Integer a = 1000;
Integer b = 1000;
System.out.println(a == b);        // false — 不同对象,== 比较引用
System.out.println(a.equals(b));   // true  — equals 比较值

Integer c = 100;
Integer d = 100;
System.out.println(c == d);        // true  — 缓存池!Integer 缓存了 -128~127
误区二:"getter/setter = 封装"
前面已经详细讨论过,这里再强调一次:getter/setter 的多少和封装质量成反比。一个设计良好的类通常只有少量的 getter,几乎没有 setter。对象的状态应该通过有意义的行为方法改变,而不是通过外部直接 set。
误区三:"接口里可以写任何默认方法"
Java 8 引入的默认方法是一个实用的特性,但它有明确的语义边界:
interface Repository {
    // ✅ 合理的默认方法:基于接口已有的抽象方法实现便捷逻辑
    default Optional<Entity> findByIdOrEmpty(Long id) {
        return Optional.ofNullable(findById(id));
    }

    // ❌ 不合理的默认方法:把实现逻辑塞进接口,破坏了接口的契约语义
    default Entity findByIdOrThrow(Long id) {
        Entity e = findById(id);
        if (e == null) throw new NotFoundException("Entity not found: " + id);
        return e;
        // 问题:这个异常应该是什么类型?应该用哪个日志器?接口不应该做这些决定。
    }

    Entity findById(Long id);  // 真正的抽象方法
}
误区四:"继承是 OOP 最强大的特性"
恰恰相反。在 GoF 设计模式的 23 种模式中,绝大多数推荐的是组合而非继承。Gamma 等人在设计模式一书的开篇就写道:"优先使用对象组合而不是类继承。"
继承的强大之处(代码复用)恰恰也是它的危险之处(紧耦合)。现代 OOP 的最佳实践是:用接口定义契约,用组合实现复用,只在语义上真正的 IS-A 关系中使用继承。
8. 总结:如何真正理解 OOP
回到开头的问题:面试官问"说说面向对象的四大特性"时,他们在期待什么?
初级回答:背出四个词并各给一个简单例子 → 过了简历筛选但不会有加分。
中级回答:讲清楚每个特性的本质和边界 → "这个人真的理解,不只是背过。"
高级回答:讲出特性之间的协作与冲突,给出工程中的取舍理由 → "这个人能设计系统。"
本文希望你达到第三个层次。下面是一张速查表:
| 特性 | 一句话本质 | 设计阶段做什么 | 最重要的禁令 |
|---|---|---|---|
| 封装 | 控制"谁知道什么" | 划定类的公共 API 边界 | 不要为每个字段生成 getter/setter |
| 继承 | 表达"是什么"的层次 | 识别真正的 IS-A 关系 | 不要为了复用代码而继承 |
| 多态 | 行为可替换 | 找出变化点,设计扩展接口 | 不要用 if-else 替代多态分派 |
| 抽象 | 忽略细节,提取本质 | 从具体场景中提炼通用概念 | 不要过度抽象(层次不要太深) |
9. 面试提问与深度解析
以下每个问题均附参考答案和面试官可能的深度追问。阅读时建议先自行思考回答,再看参考解析。
Q1:封装和信息隐藏是同一个概念吗?如果不是,区别在哪里?
参考答案:
不是同一个概念,虽然它们高度相关。信息隐藏(Information Hiding) 是大卫·帕纳斯(David Parnas)在 1972 年提出的设计原则,核心思想是:将系统中可能发生变化的设计决策隔离在单个模块内部,对外只暴露稳定的接口。 而封装(Encapsulation) 是信息隐藏在编程语言层面的实现机制——通过访问控制(private、protected、public)将数据和操作绑定在一起,并限制外部访问。
关键的层次关系是:
信息隐藏(设计原则)
    └── 封装(语言机制实现)
    └── 接口抽象(另一种实现方式)
一个典型的例子:你对一个模块隐藏了"数据存储在 MySQL 还是 Redis 中"这个决策——这是信息隐藏。你给这个模块的 DAO 类加 private 字段——这是封装。信息隐藏回答"藏什么",封装回答"怎么藏"。
面试官追问链:
追问 1:如果我把所有字段用
private修饰,然后生成全部 getter/setter,这算不算实现了信息隐藏?
不算。信息隐藏的核心不是语法上的不可访问,而是外部不需要知道的信息就不应该暴露。getter/setter 只是换了一种方式暴露内部状态,外部代码仍然知道"这个对象有个叫 balance 的 BigDecimal 字段"。真正的信息隐藏是:外部只看到 deposit() 和 withdraw() 两个行为,余额这个状态本身对外部是不可见的。至于内部是不是用 BigDecimal 存、是不是存在 Redis 里——外部完全不知道,也不应该知道。
追问 2:你能举一个信息隐藏做得好但封装"看起来"很弱的例子吗?
C 语言中的 FILE* 就是一个经典例子。FILE 结构体的内部字段在大多数实现中根本不暴露给使用者,你只能通过 fopen/fread/fwrite/fclose 操作——这意味着信息隐藏在 C 语言中通过不透明指针(opaque pointer)实现,完全不需要语言层面的 **private** 关键字。 这恰好说明信息隐藏是设计思想,封装只是特定语言提供的机制。
Q2:为什么 Effective Java 建议"优先使用组合而不是继承"?请举一个继承失败的例子。
参考答案:
核心原因有三:
- 继承破坏封装:子类依赖父类的实现细节,而父类的实现细节不受任何契约保护。Effective Java 中
InstrumentedHashSet的例子(本文 3.2 节讨论过)就是典型——HashSet.addAll内部调用了this.add(),子类如果不了解这个实现细节,计数就会出错。 - 继承是白盒复用,组合是黑盒复用:继承让你能看到父类的内部实现,这听起来是好事,但实际上意味着你的子类和父类之间形成了强耦合。父类任何一个内部改动都可能破坏子类。组合只依赖对方的公共 API,耦合度低得多。
- 继承是编译期确定的,组合是运行时可变的:
Dog extends Animal这个关系在编译后就固定了。但class GuardDog { private Dog delegate; }可以在运行时替换delegate的实现。
补充一个现实中的反面案例——**Properties extends Hashtable**:
// JDK 的设计失误
public class Properties extends Hashtable<Object, Object> {
    // Properties 的语义是 String → String 的配置映射
    public String getProperty(String key) {
        return (String) get(key);
    }
    // 但因为继承了 Hashtable...
}

Properties props = new Properties();
props.put("port", 8080);            // 存入的是 Integer 8080,不是 String!
String port = props.getProperty("port");  // ClassCastException! getProperty 强转 String
因为 Properties 继承了 Hashtable,所以它暴露了 put(Object, Object) 方法,允许存入非 String 类型的值。如果 Properties 使用组合(内部持有一个 Map<String, String>),就不会有这个问题。
面试官追问链:
追问 1:那什么时候用继承是合适的?给我三个明确的标准。
- 子类和父类之间是真正的 IS-A 关系,并且这个关系在系统的整个生命周期内都成立。
- 父类和子类在同一个包/模块内,由同一个团队维护——你能控制父类的演化。
- 父类是为继承而设计的——文档明确说明了哪些方法可以被覆盖、覆盖后的契约是什么。例如
AbstractList就明确标注了子类需要实现get(int)和size()。
追问 2:如果我发现一个已有的类层次结构不适合继承,但重构成本很高,你会怎么渐进式地改造?
可以采用"就地包装"策略:不改动现有继承层次,而是在调用方和使用方之间插入一个适配层,用组合包装原继承体系,新代码只依赖适配层暴露的接口。原继承体系的类逐步标记为 @Deprecated,在后续迭代中迁移掉。
Q3:Java 中重载(overload)是静态多态还是动态多态?JVM 是如何决定调用哪个重载方法的?
参考答案:
重载是编译期多态(静态分派)。方法调用在编译期间就根据参数的声明类型(编译期类型) 确定了要调用哪个方法,而不是在运行时根据对象的实际类型决定。
JVM 的方法选择规则(在 .class 文件中由 invokevirtual/invokestatic 等指令的符号引用指定):
- 根据方法的名称 + 参数描述符(参数类型列表) 唯一确定一个方法——这就是方法的"签名"。
- 编译时,编译器根据传入参数的静态类型进行重载决议。
- 如果找不到精确匹配,编译器会尝试自动类型提升(如
byte → short → int → long → float → double)和自动装箱/拆箱。
关键陷阱——重载决议的优先级:
public class OverloadPriority {
    void foo(int x)        { System.out.println("int"); }
    void foo(Integer x)    { System.out.println("Integer"); }
    void foo(Object x)     { System.out.println("Object"); }
    void foo(int... x)     { System.out.println("varargs"); }


    public static void main(String[ ] args) {

        OverloadPriority op = new OverloadPriority();
        op.foo(1);  // 输出 "int" — 精确匹配优先
        // 如果没有 foo(int), 会依次尝试:
        // 1. 自动装箱 → foo(Integer)
        // 2. 父类 → foo(Object)
        // 3. 可变参数 → foo(int...)
    }
}
JVM 层面的机制:JVM 规范中,方法调用指令分为 5 种:
| 指令 | 分派类型 | 说明 |
|---|---|---|
invokestatic |
静态分派 | 静态方法 |
invokespecial |
静态分派 | 构造器、私有方法、父类方法 |
invokevirtual |
动态分派 | 普通虚方法(重写) |
invokeinterface |
动态分派 | 接口方法 |
invokedynamic |
动态分派 | lambda、字符串拼接等 |
重载方法和静态方法绑定在编译期生成 invokestatic/invokespecial 指令时就已经确定;重写方法在运行期通过 invokevirtual/invokeinterface 才决定实际调用目标。
面试官追问链:
追问 1:下面这段代码为什么会输出 "Animal handler"?
class Animal {}
class Dog extends Animal {}
class Handler {
    void handle(Animal a) { System.out.println("Animal handler"); }
    void handle(Dog d)   { System.out.println("Dog handler"); }
}
Handler h = new Handler();
Animal dog = new Dog();
h.handle(dog);  // ?
因为 handle 是重载(不是重写),方法选择发生在编译期。编译期变量 dog 的声明类型是 Animal,编译器将其绑定到 handle(Animal)。如果 handle 是实例方法的重写——即 Animal 上有一个 handle() 方法、Dog 覆盖了它——那才会走动态分派。
追问 2:泛型方法的重载会遇到什么问题?
// 编译错误!类型擦除后签名相同
void process(List<String> list) {}
void process(List<Integer> list) {} // 编译失败: both methods have same erasure
泛型方法经过类型擦除后,两个 process(List) 的签名完全一样,Java 编译器不允许这种重载。这是理解 Java 泛型实现(类型擦除)和重载机制之间交互的关键点。
Q4:接口的默认方法(default method)解决了什么问题?又引入了什么问题?
参考答案:
解决了什么问题:
Java 8 引入默认方法的直接动因是在不破坏已有实现的前提下,为既有接口添加新方法。最典型的场景是 java.util.Collection 接口新增了 stream() 方法——如果没有默认方法,所有自定义 Collection 实现类都需要强行实现 stream(),这会破坏海量的已有代码。
更深层的价值是提供了接口演化能力:以前接口一旦发布就不能再安全地添加方法,默认方法打破了这一限制。
此外,默认方法还能减少样板代码——把一些公共的便捷方法(如 Iterator.forEachRemaining)直接在接口中实现,避免每个实现类重复编写。
引入了什么问题:
- 菱形继承(Diamond Problem)冲突:
interface A { default void greet() { System.out.println("A"); } }
interface B { default void greet() { System.out.println("B"); } }
class C implements A, B { }
// 编译错误!greet() 被 A 和 B 同时定义,C 必须覆盖
// class C implements A, B { public void greet() { A.super.greet(); } }
- 接口 vs 抽象类的边界模糊化:以前一个清晰的设计铁律——"接口定义行为契约,抽象类包含部分实现"——被默认方法模糊了。接口开始承载实现逻辑,使得开发者在接口和抽象类之间更加困惑。
- 将实现逻辑拖入接口的风险:接口不应该知道实现细节,但默认方法却可以包含业务逻辑。如果默认方法中使用了特定的异常类型、依赖了某日志框架——这破坏了接口的"实现无关性"。
- 优先级规则复杂化:出现冲突时,"类优先于接口、子接口优先于父接口"的规则并不直观。
面试官追问链:
追问 1:如果让你设计一个接口,你会放默认方法吗?放的边界是什么?
会,但遵循三条边界:
- 默认方法必须完全基于该接口已有的(抽象)方法实现,不引入任何外部依赖。
- 默认方法应当是便捷方法(convenience method),而不是核心业务逻辑。
- 如果某个默认方法需要在 2 个以上实现类中被覆盖,说明它可能不该是默认方法——它会成为实际上的"半抽象方法"。
追问 2:你觉得默认方法应该用
synchronized吗?为什么?
不应该。synchronized 是实现细节——锁的是哪个对象、锁的粒度如何、会不会死锁,这些决策应该留给实现类。接口层面的默认方法不应该做这些假设。如果一个默认方法真的需要同步,它应当委托给一个不包含同步语义的 protected 辅助方法。
Q5:如果说"抽象是所有特性的基础",你同意吗?为什么?
参考答案:
同意,但需要精确地解释"基础"的含义。
抽象是认知基础,不是语法基础。 在你能写出 interface Animal 之前,你的大脑里必须先有"动物"这个抽象概念——你从 Dog、Cat、Bird 中识别出共同的"会移动、会进食"的特征,忽略掉"汪汪叫"和"喵喵叫"的差异。这个认知过程就是抽象。
没有抽象,其他三个特性就失去了操作对象:
- 封装封装什么?封装的是抽象之后的稳定接口和易变实现之间的边界。
- 继承继承什么?继承的是抽象出来的共性(共性的反面就是差异,留给子类实现)。
- 多态替换什么?替换的是同一抽象的不同具体实现。
可以用一句话概括:抽象定义了"做什么"(what),封装、继承、多态定义了"怎么做"(how)。
但要注意另一种声音:有人认为封装才是最基础的——因为封装实现了模块化,而模块化是一切大规模软件工程的前提。这个观点也有道理,但"模块化"本身就是一种抽象的产物——你模块的边界是基于你对业务的抽象画出来的。
面试官追问链:
追问 1:你能设计一个场景,证明"抽象是基础"这一判断吗?我的意思是——能不能构造一个"有封装、继承、多态但没有抽象"的实际代码?
// 这是一个"有封装、继承、多态但没有有效抽象"的代码
abstract class Animal {
    private String name;  // 封装 ✓
    abstract void makeSound();  // 多态的基础 ✓
}
class Dog extends Animal {  // 继承 ✓
    void makeSound() { System.out.println("Woof"); }
}

// 但这个层次结构只支持 Dog 和 Cat——
// 加一个 Robot(会移动但不是动物)时,就会犹豫要不要继承 Animal。
// 这说明最初的抽象(Animal)没有抓住真正的本质(Movable? SoundMaking?)。
// 这里的"抽象"只是语法上的,不是设计上的——这是一个失败的抽象。
真正的抽象质量体现在:当新需求出现时,你的抽象层次不需要剧烈改变。 如果加一个 Fish 要改造整个类层次,说明当初的抽象跑偏了。
Q6:你在实际项目中遇到过的因为过度继承导致的问题是什么?后来怎么解决的?
参考答案(以典型的电商订单处理系统为例):
问题背景:一个电商系统的订单处理模块,最初的类设计是:
AbstractOrderProcessor
    ├── PhysicalGoodsOrderProcessor
    │   ├── DomesticPhysicalOrderProcessor
    │   └── InternationalPhysicalOrderProcessor
    ├── DigitalGoodsOrderProcessor
    └── ServiceOrderProcessor
看起来合理,但随着业务发展出现了三个问题:
- 组合爆炸:后来需要支持"货到付款"和"在线支付"两种支付方式、需要支持"企业订单"和"个人订单"——这些维度是正交的,但被塞进了单根继承树。每增加一个维度,子类数量翻倍。
- Base 类越来越重:
AbstractOrderProcessor承载了太多的"公共逻辑"——从地址校验到发票处理到通知发送。后来发现ServiceOrderProcessor根本不需要地址校验,但为了"能用继承",很多子类只能覆盖方法并留空,留下了大量// Not applicable for this type的空方法。 - 测试噩梦:要测试
DomesticPhysicalOrderProcessor,必须先构造一个完整的AbstractOrderProcessor上下文——包括数据库连接、消息队列、文件存储等,而这个类依赖了大半个 Spring 容器。
解决方案——策略模式 + 组合重构:
// 1. 将正交维度拆分为独立的策略接口
interface OrderValidator { ValidationResult validate(Order order); }
interface PaymentProcessor { PaymentResult pay(Order order); }
interface ShippingStrategy { ShippingInfo ship(Order order); }
interface Notifier { void notify(Order order, OrderEvent event); }

// 2. 订单处理器变成薄薄的编排层
class OrderProcessor {
    private final OrderValidator validator;
    private final PaymentProcessor payment;
    private final ShippingStrategy shipping;
    private final Notifier notifier;

    // 构造注入,运行时组合
    public OrderResult process(Order order) {
        ValidationResult vr = validator.validate(order);
        if (!vr.isValid()) return Result.invalid(vr);

        PaymentResult pr = payment.pay(order);
        if (!pr.isSuccess()) return Result.paymentFailed(pr);

        ShippingInfo si = shipping.ship(order);
        notifier.notify(order, OrderEvent.SHIPPED);
        return Result.ok(si);
    }
}

// 3. 不同的订单类型 = 不同的策略组合,而不是不同的子类
OrderProcessor physicalOrderProcessor = new OrderProcessor(
    new PhysicalGoodsValidator(),
    new OnlinePaymentProcessor(),
    new ExpressShipping(),
    new SmsAndEmailNotifier()
);

OrderProcessor digitalOrderProcessor = new OrderProcessor(
    new NoOpValidator(),         // 数字商品不需要地址校验
    new OnlinePaymentProcessor(),
    new NoOpShipping(),          // 数字商品不需要物流
    new EmailOnlyNotifier()
);
重构后的核心收益:每个维度独立演化和测试;新增一种订单类型不需要写新类,只需要组合已有策略;每个策略类都是单一职责的。
面试官追问链:
追问 1:重构过程中最难的是什么?技术难点还是非技术难点?
最难的是确定拆分的粒度。几个具体的陷阱:
- 拆得太细:一个订单处理被拆成了 15 个策略对象,配置代码比业务逻辑还长。
- 拆得不彻底:
OrderValidator里还藏着隐式的继承——PhysicalGoodsValidator extends AbstractValidator,问题从一处移到了另一处。 - 非技术难点:说服团队"要改这么多代码"——需要通过具体的故障案例(如"上次加货到付款引入的 bug 是因为继承层次里漏覆盖了一个方法")来建立共识。
追问 2:重构后有没有失去什么?组合有没有引入新的问题?
失去了"类型安全的多态替换"——以前 InternationalPhysicalOrderProcessor 是一个具体的类型,你可以在编译期强制方法参数只接受这类订单。重构后 OrderProcessor 是一个具体的类,不同类型的订单处理器在类型系统上没有差别。如果需要编译期约束,可以考虑用范型 + 标记接口补救。
组合引入的新问题:策略对象之间的交互——PaymentProcessor 可能需要知道 ShippingStrategy 的结果才能决定扣款时机。这需要额外的心智模型(如责任链、Pipeline 模式)来管理。
Q7:请设计一个"支付系统"的类层次结构,要求支持支付宝、微信、银联支付,并且每种支付支持"扫码付"和"H5 付"两种方式。你会怎么设计?为什么?
参考答案:
这道题的核心陷阱在于:支付渠道(支付宝/微信/银联)和支付方式(扫码付/H5付)是两个正交的维度。如果只用一个继承树,子类数量 = 3 × 2 = 6,而且每增加一个维度就翻倍。这是一个典型的"组合优于继承"的场景。
设计方案——桥接模式(Bridge Pattern):
// ====== 维度一:支付方式(变化的维度) ======
interface PayMode {
    void invoke(PayRequest request);  // 发起支付的具体交互方式
    PayResult query(String orderNo);  // 查询支付结果
    String getModeName();             // "扫码付" / "H5付"
}

class QrCodePay implements PayMode {
    public void invoke(PayRequest req) {
        // 生成二维码,返回给客户端展示
    }
    public PayResult query(String orderNo) {
        // 轮询或等待回调
    }
    public String getModeName() { return "扫码付"; }
}

class H5Pay implements PayMode {
    public void invoke(PayRequest req) {
        // 构造支付URL,跳转H5页面
    }
    public PayResult query(String orderNo) {
        // 通过redirect_url回调或主动查询
    }
    public String getModeName() { return "H5付"; }
}

// ====== 维度二:支付渠道(稳定的抽象) ======
abstract class PaymentChannel {
    private static final Map<String, PaymentChannel> REGISTRY = new ConcurrentHashMap<>();

    protected String channelId;   // "alipay" / "wechat" / "unionpay"
    protected PayMode payMode;    // 桥接:渠道不关心具体方式

    public PaymentChannel(String channelId, PayMode payMode) {
        this.channelId = channelId;
        this.payMode = payMode;
        REGISTRY.put(channelId + "_" + payMode.getModeName(), this);
    }

    // 模板方法:渠道定义流程骨架,支付方式填充交互细节
    public final PayResponse pay(PayRequest request) {
        // 1. 渠道通用:参数校验(子类可扩展)
        validateRequest(request);
        // 2. 渠道通用:创建订单
        String orderNo = createOrder(request);
        // 3. 委托给支付方式:H5 就跳转,扫码就生成二维码
        payMode.invoke(request.withOrderNo(orderNo));
        // 4. 返回渠道响应
        return buildResponse(orderNo);
    }

    protected abstract void validateRequest(PayRequest request);
    protected abstract String createOrder(PayRequest request);
    protected abstract PayResponse buildResponse(String orderNo);

    public static PaymentChannel of(String channelId, PayMode mode) {
        return REGISTRY.get(channelId + "_" + mode.getModeName());
    }
}

// ====== 具体渠道实现 ======
class AlipayChannel extends PaymentChannel {
    public AlipayChannel(PayMode mode) { super("alipay", mode); }

    protected void validateRequest(PayRequest req) {
        // 支付宝特有的参数校验:pid、签名方式等
    }
    protected String createOrder(PayRequest req) {
        // 调用支付宝统一下单 API(alipay.trade.create / alipay.trade.precreate)
    }
    protected PayResponse buildResponse(String orderNo) {
        // 封装支付宝的响应
    }
}

class WechatChannel extends PaymentChannel {
    public WechatChannel(PayMode mode) { super("wechat", mode); }

    protected void validateRequest(PayRequest req) {
        // 微信特有校验:appid、mch_id、签名等
    }
    protected String createOrder(PayRequest req) {
        // 调用微信统一下单 API
    }
    protected PayResponse buildResponse(String orderNo) {
        // 封装微信的响应
    }
}

// ====== 使用示例 ======
// 只需 3+2=5 个类,覆盖 3×2 种组合,新增维度 O(n) 而非 O(n×m)
PaymentChannel alipayQrPay = new AlipayChannel(new QrCodePay());
PaymentChannel alipayH5Pay  = new AlipayChannel(new H5Pay());
PaymentChannel wechatQrPay  = new WechatChannel(new QrCodePay());
// ... 银联同理

// 运行时组合:
PaymentChannel channel = PaymentChannel.of("alipay", new H5Pay());
channel.pay(request);
为什么这样设计的核心理由:
- 两个正交维度被独立建模:支付渠道(支付宝/微信/银联)不变的部分写在
PaymentChannel子类中,支付方式(扫码/H5)的变化部分写在PayMode实现中。两者通过桥接组合。 - 扩展复杂度从 O(n×m) 降到 O(n+m):加一种支付方式(如"刷脸付")只需要新增一个
FacePay implements PayMode,所有渠道自动获得这个能力。加一种渠道只需要新增一个PaymentChannel子类。 - 模板方法保证了流程一致性:无论怎么组合,
pay()的流程(校验→下单→支付→响应)是不变的——模板方法在抽象类中定义,具体步骤留给子类。
面试官追问链:
追问 1:你的设计里,扫码付需要后端轮询支付结果,H5 付是通过回调通知。这两种完全不同的通知机制,怎么在
PayMode接口下统一?
这是设计中的隐藏复杂度。PayMode 的 query() 方法只是一个简单的查询接口,但实际的异步通知机制应该抽到另一个维度:
interface PayNotificationHandler {
    void onCallback(CallbackData data);       // H5 付回调
    PayResult pollUntilComplete(String orderNo, Duration timeout); // 扫码付轮询
}

class QrCodePay implements PayMode {
    private final PayNotificationHandler handler;
    // handler.pollUntilComplete() 封装了定时轮询逻辑
}
class H5Pay implements PayMode {
    private final PayNotificationHandler handler;
    // handler.onCallback() 由框架层的回调接口触发
}
核心思路:如果两个维度的概念在同一个接口下开始产生"不自然"的差异,说明还有第三个维度需要拆出来。
追问 2:如果现在要加一个"组合支付"——一笔订单同时用支付宝和微信各付一半——你的设计能应对吗?
当前设计不能直接应对,因为它是单渠道单次支付模型。组合支付需要在 PaymentChannel 之上再引入一个支付编排层(PaymentOrchestrator):
class CombinedPaymentOrchestrator {
    List<PaymentChannel> channels;  // 多个渠道

    PayResponse pay(PayRequest request) {
        // 将 totalAmount 按比例拆分到各渠道
        // 使用分布式事务(TCC 或 Saga)保证多个渠道的一致性
        // 任一渠道失败需要补偿
    }
}
这个问题考察的是设计边界意识——一个好的设计者不光要知道"怎么设计",还要知道"这个设计在什么情况下会失效"。
追问 3:如果 3 年后的某天,你要在第 8 个支付方式(比如"分期付")接入时发现桥接模式开始吃力了,你会怎么调整?
这说明支付方式的类型分化已经超出了桥接模式能优雅支持的范畴。此时应该用策略工厂 + SPI 扩展点替代:
// 每个渠道声明自己支持哪些支付方式
interface PayModeSupport {
    Set<String> supportedModes(); // {"qr_code", "h5", "installment"}
}

// 渠道不再在构造时绑定支付方式,而是在运行时通过 SPI 发现
// ServiceLoader<PayModeFactory> 加载所有可用的支付方式
// 每个渠道的 supportedModes() 声明能力,运行时分派
这体现了设计的演进性——最初的方案不是永久的方案,好的设计知道什么时候该演化。