覆盖考点:010|反射机制:Class 元数据、动态调用、性能代价和框架应用
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:35–40 分钟(文末问答不计入)
普通代码是"编译时决定一切":调用哪个类、哪个方法,在写代码那一刻就定死了。反射把这件事推迟到运行时——程序可以在跑起来之后,拿着一个字符串找到类,查看它有哪些字段和方法,再创建对象、修改字段、调用方法。换句话说:反射让程序把"自己"当成数据来读和改。
面试官问反射,很少停留在"会不会用"。追问链通常是:Class 对象从哪来 → invoke 底层怎么执行 → 为什么慢、怎么优化 → Spring/MyBatis 在哪些环节靠它。本文按这条链展开。
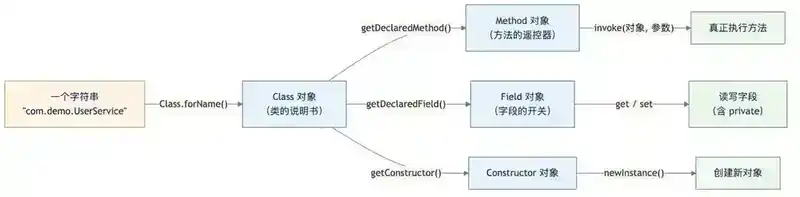
一、Class 元数据:反射的数据从哪里来
1. 字节码里本来就带着"说明书"
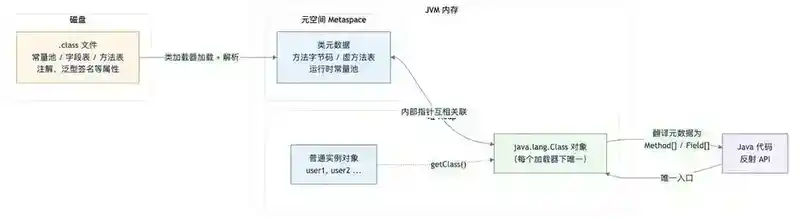
反射不是 JVM 额外附赠的魔法。.class 文件本身就是一份结构化的自描述档案:常量池记录了所有类名、方法名、字段名的字符串;字段表、方法表记录了每个成员的修饰符、类型签名;属性表里甚至有注解、泛型签名、方法参数名。javap -v 看到的所有东西,就是反射能拿到的所有东西。
类加载器把 .class 读进 JVM 后,这份档案被解析成两部分:
- 元空间(Metaspace)里的类元数据:方法字节码、常量池、虚方法表等,JVM 内部使用,Java 代码摸不到;
- 堆里的一个 `java.lang.Class` 对象:作为元数据暴露给 Java 代码的唯一入口。
每个类在同一个类加载器下只有一个 Class 对象,由 JVM 保证。你调用 getDeclaredMethods() 时,JVM 就是拿着 Class 对象去元空间把方法表翻译成 Method[] 返回给你。
2. 拿到 Class 对象的四种方式,差别在"初始化"
Class<?> c1 = User.class; // 编译期字面量,不触发类初始化
Class<?> c2 = user.getClass(); // 从实例反查,类必然已初始化
Class<?> c3 = Class.forName("com.demo.User"); // 按名查找,默认触发初始化
Class<?> c4 = loader.loadClass("com.demo.User"); // 只加载,不初始化
区别的核心是是否执行类初始化(静态变量赋值和 static 块)。Class.forName 默认会走完"加载→链接→初始化"全过程,这正是 JDBC 时代 Class.forName("com.mysql.jdbc.Driver") 能注册驱动的原因——驱动类的 static 块里写了 DriverManager.registerDriver(...)。而 loadClass 只加载不初始化,适合"先拿到类,稍后再用"的框架场景。
3. 容易踩的坑:Class 对象的唯一性是"类加载器 + 类名"
同一份 .class 文件被两个不同的类加载器加载,会得到两个不同的 Class 对象。这两个类之间 instanceof 为 false,强转直接抛 ClassCastException。Tomcat 多应用隔离、各种插件机制、热部署框架都建立在这个规则上;排查"明明是同一个类却转型失败"的线上问题,第一件事就是打印两边的 getClassLoader()。
二、动态调用:invoke 的三层内幕
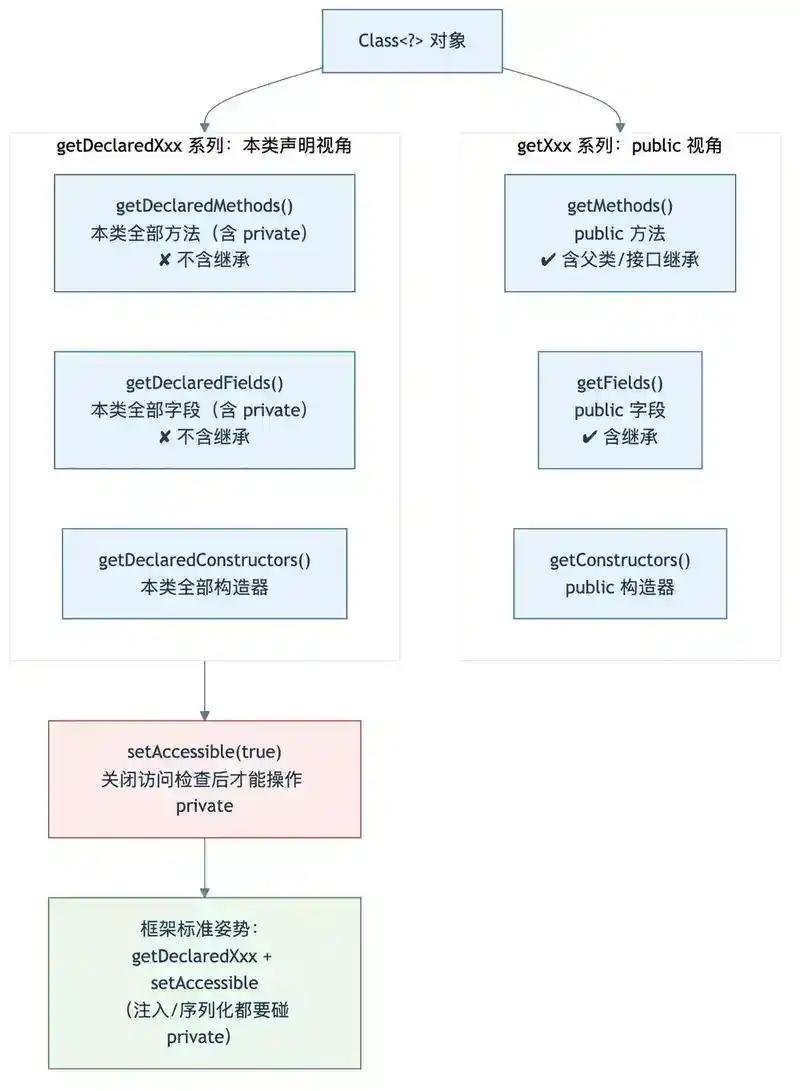
1. API 层:getMethod 和 getDeclaredMethod 不是一回事
Class<?> clazz = userService.getClass();
// getMethod: 只返回 public 方法,但包含从父类/接口继承来的
Method m1 = clazz.getMethod("save", User.class);
// getDeclaredMethod: 返回本类声明的所有方法(含 private),但不含继承的
Method m2 = clazz.getDeclaredMethod("validate", User.class);
m2.setAccessible(true); // 关掉访问检查,才能调 private
Object result = m2.invoke(userService, user);
Field 和 Constructor 的 API 是同样的对称设计:getXxx 走 public + 继承视角,getDeclaredXxx 走本类声明视角。框架代码几乎全用 getDeclaredXxx + setAccessible(true),因为依赖注入、序列化要处理的恰恰是 private 字段。
还有一个所有人都踩过的坑:被反射调用的方法内部抛了异常,你捕获到的不是原始异常,而是 InvocationTargetException。原始异常被包在里面,必须 getCause() 解包,否则日志里全是无意义的包装层:
try {
method.invoke(target, args);
} catch (InvocationTargetException e) {
throw e.getCause(); // 真正的业务异常在这里
}
2. 实现层:invoke 是怎么执行到目标方法的
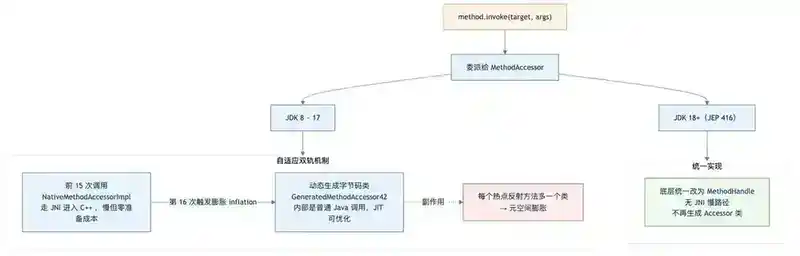
Method.invoke 并不直接执行方法,而是委派给内部的 MethodAccessor。JDK 8 到 17 的实现是一套"先慢后快"的自适应策略:
- 前 15 次调用:走 NativeMethodAccessorImpl,通过 JNI 进入 C++ 代码执行。启动快(不需要额外准备),但每次调用都要跨越 Java/Native 边界,很慢;
- 第 16 次开始(膨胀,inflation):JVM 用字节码生成器动态造出一个类 GeneratedMethodAccessor42,里面是一句普通的 Java 直接调用 target.save(user)。之后的 invoke 就是纯 Java 调用,JIT 可以正常优化。
为什么不一开始就生成字节码?因为生成+加载一个类的成本远高于几次 JNI 调用。大量反射调用只发生一两次(比如读一次配置),为它们生成类纯属浪费。15 次是"这个方法会被反复调用"的经验阈值(-Dsun.reflect.inflationThreshold 可调)。
这个设计有一个著名的副作用:每个被膨胀的方法都会多出一个 GeneratedMethodAccessor 类。反射方法数量巨大的系统(如大量动态 SQL、表达式引擎)会因此撑大元空间,甚至触发反复的类加载/卸载。老运维口中的"GeneratedMethodAccessor 刷屏"就是它。
JDK 18 起(JEP 416),这套双轨机制被整体替换为基于 MethodHandle 的统一实现,去掉了 JNI 慢路径和动态生成访问器类的开销,行为更可预测。面试时能说出"18 前是 native+inflation,18 后统一走 MethodHandle",就已经超过大多数候选人。
3. 权限层:setAccessible 与模块系统的攻防
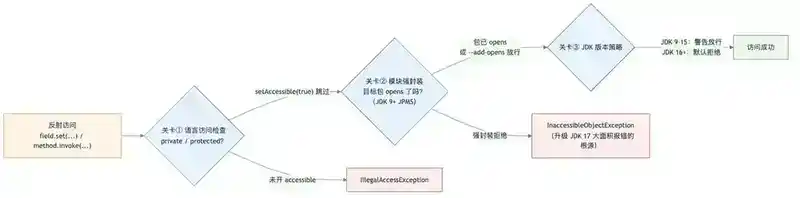
setAccessible(true) 的本义是跳过访问修饰符检查——这是反射"破坏封装"的能力来源。但从 JDK 9 模块化(JPMS)开始,这个口子被逐步收紧:
- 模块内的包默认对外强封装,反射访问未开放的包会失败;
- JDK 9–15:非法访问只打 WARNING(--illegal-access=permit 的过渡期);
- JDK 16 起默认拒绝:反射访问 JDK 内部 API(如 java.lang 的私有字段)直接抛 InaccessibleObjectException。
这就是很多老框架升级 JDK 17 时大面积报错的根源。解决方式只有两类:升级到适配新版本的框架,或者显式开门:
java --add-opens java.base/java.lang=ALL-UNNAMED -jar app.jar
--add-opens 把指定包对指定模块开放深度反射。它是运维手里的应急工具,但每一个 add-opens 都意味着你依赖了别人的内部实现——升级随时可能再炸。
三、性能代价:慢在哪,怎么救
1. 反射调用慢的四个来源
| 开销来源 | 说明 |
|---|---|
| 查找成本 | getDeclaredMethod 要遍历方法表做字符串匹配,比 invoke 本身贵一个数量级 |
| 访问检查 | 每次 invoke 都要校验调用方权限(setAccessible(true) 可跳过) |
| 参数装箱 | 参数打包成 Object[],基本类型全部装箱,返回值再拆箱 |
| 阻断 JIT 优化 | 调用目标运行时才知道,JIT 无法内联,损失后续所有优化机会 |
量级感受(JMH,仅示意相对关系):直接调用约 1–2ns;缓存 Method + setAccessible 后的 invoke 约 10–20ns;每次现查 Method 再 invoke 可到几百 ns。慢 10 倍,但 10ns 级别的慢——单次配置解析用反射毫无问题;每秒百万次的序列化热路径用裸反射就是事故。
2. 优化阶梯:从缓存到"消灭反射"
第一阶:缓存反射对象。 最便宜、收益最大的一步,消除查找成本:
private static final Map<String, Method> CACHE = new ConcurrentHashMap<>();
Method m = CACHE.computeIfAbsent(key, k -> {
Method method = clazz.getDeclaredMethod(name, paramTypes);
method.setAccessible(true);
return method;
});
注意缓存 key 里要含 Class 信息,且在需要类卸载的场景(热部署容器)不要用静态 Map 强引用 Method——Method 持有 Class,Class 持有类加载器,会造成整条链无法卸载的泄漏。
第二阶:MethodHandle。 JDK 7 引入的"现代反射",签名检查在 lookup 阶段做一次,之后调用可被 JIT 内联:
MethodHandle mh = MethodHandles.lookup()
.findVirtual(UserService.class, "save",
MethodType.methodType(boolean.class, User.class));
boolean ok = (boolean) mh.invokeExact(service, user); // 签名精确匹配,可内联
invokeExact 要求调用点签名与方法完全一致(不允许装箱、不允许用 Object 接收),换来的是接近直接调用的性能。签名不匹配就退回 invoke,性能介于两者之间。
第三阶:LambdaMetafactory / 代码生成。 把反射彻底变成正常调用:LambdaMetafactory 在运行时生成一个实现函数式接口的类,之后的调用就是普通接口调用(这正是 lambda 表达式的底层机制);更重的方案是 ASM/Javassist 直接生成字节码,cglib 的 FastClass、早年的 ReflectASM 都是这条路。
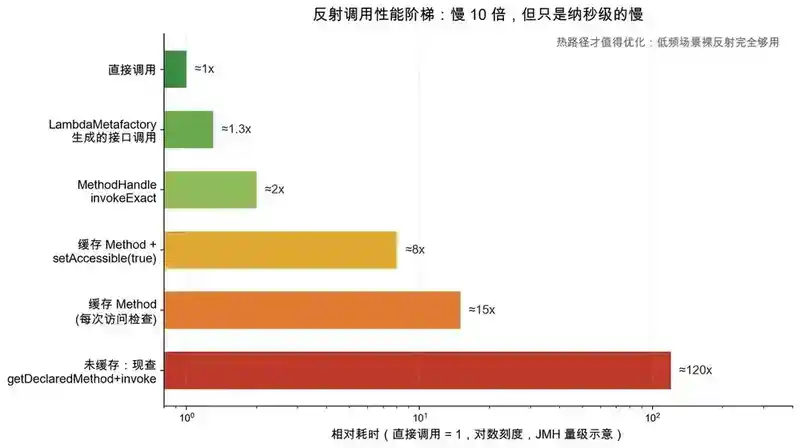
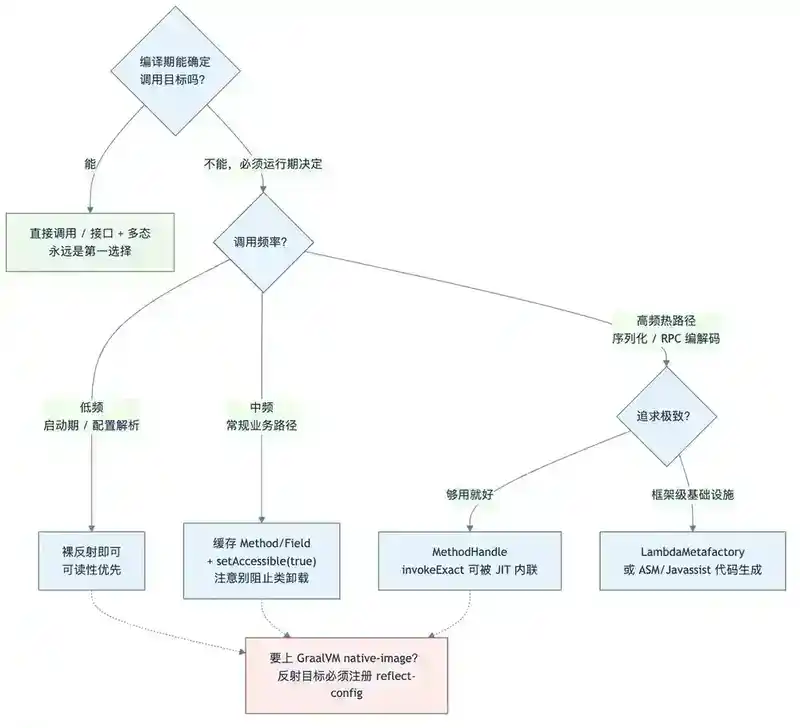
一条实用的决策规则:低频调用(配置、启动期)→ 裸反射就够;中频 → 缓存 Method;高频热路径 → MethodHandle 或 LambdaMetafactory;框架级基础设施 → 考虑代码生成。
四、框架应用:没有反射就没有现代 Java 框架
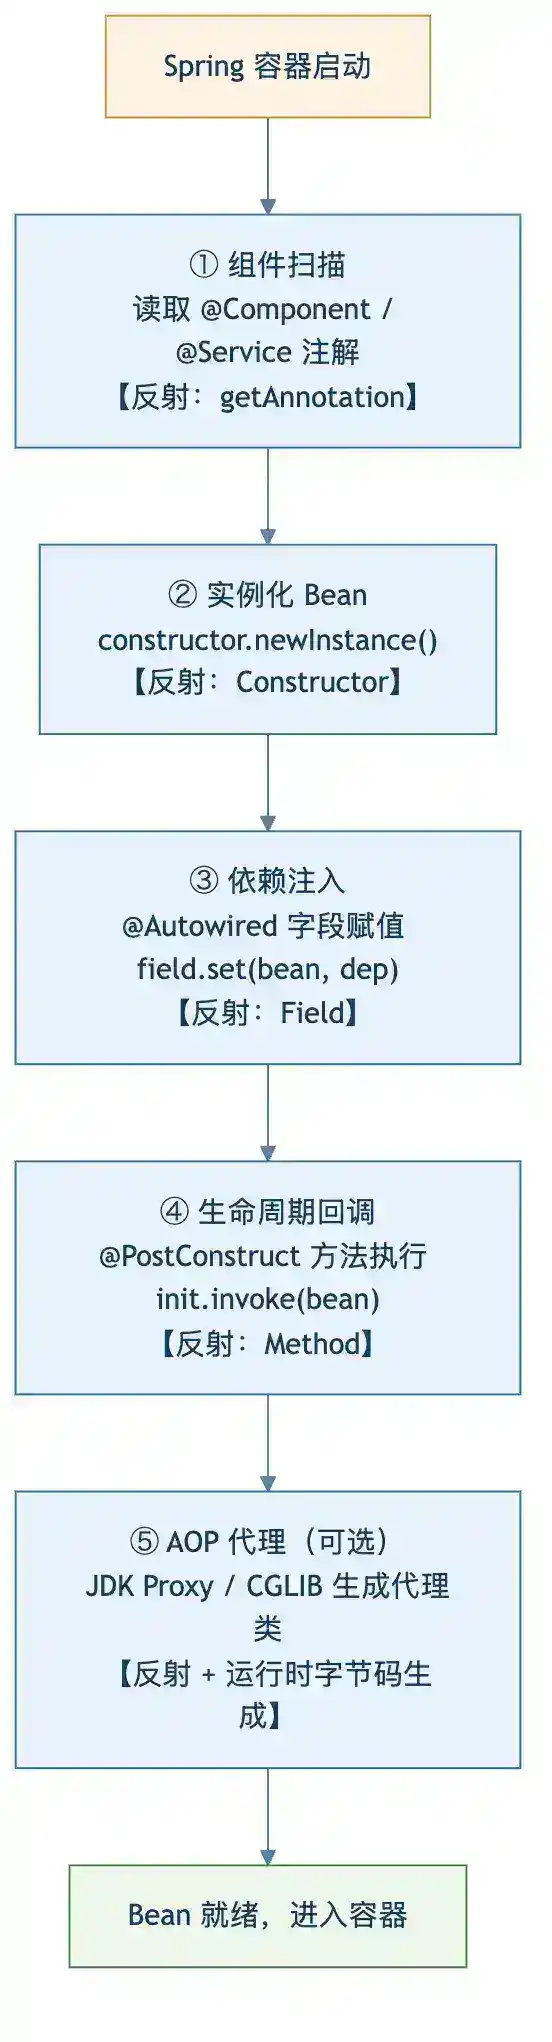
1. Spring:从建 Bean 到注入,全程反射
Spring 容器启动时做的事,翻译成反射 API 就是三步:
// ① 实例化:BeanUtils.instantiateClass 底层
Constructor<?> ctor = clazz.getDeclaredConstructor();
ctor.setAccessible(true);
Object bean = ctor.newInstance();
// ② 依赖注入:@Autowired 字段注入底层
Field field = clazz.getDeclaredField("userRepository");
field.setAccessible(true);
field.set(bean, container.getBean(field.getType()));
// ③ 生命周期回调:@PostConstruct 底层
Method init = clazz.getDeclaredMethod("init");
init.setAccessible(true);
init.invoke(bean);
组件扫描阶段同样离不开反射:Spring 扫描 classpath 拿到候选类后,靠读取 Class 上的注解元数据(@Component、@Service)决定谁进容器。注解本身只是被动的元数据,是反射在运行期读它,才让注解"生效"——这句话适用于几乎所有注解驱动框架。
2. MyBatis:接口没有实现类,也能被调用
MyBatis 的 Mapper 只有接口没有实现,可执行的秘密是 JDK 动态代理:
UserMapper mapper = (UserMapper) Proxy.newProxyInstance(
loader,
new Class[]{UserMapper.class},
(proxy, method, args) -> {
// method 是反射 Method 对象:拿方法名找到对应 SQL,执行并映射结果
return sqlSession.execute(resolveSql(method), args);
});
Proxy.newProxyInstance 在运行时生成代理类($Proxy0),把所有方法调用转发给 InvocationHandler——handler 收到的正是反射的 Method 对象。动态代理是"反射 + 运行时字节码生成"的组合产物,也是 Spring AOP(JDK 代理模式)的根基。
3. 序列化与测试框架
Jackson 把 JSON 写进对象靠的是反射遍历字段/getter 并 field.set;JUnit 找出所有 @Test 方法并逐个 invoke;Mockito 生成子类并用反射改写行为。可以说:任何"框架不认识你的类,却能操作你的类"的场景,底下都是反射。
4. 新趋势:AOT 时代反射成了负担
GraalVM native-image 做的是封闭世界假设的提前编译:编译期不可达的代码直接裁掉。而反射的调用目标恰恰在编译期不可知——所以所有被反射访问的类、方法、字段必须在 reflect-config.json 里显式注册,否则运行时直接 ClassNotFoundException。Spring 6 的 AOT 引擎干的就是这件事:启动期用反射做的决策提前到构建期执行,生成注册信息甚至直接生成 Java 代码替代反射。理解"反射与 AOT 天然冲突",是这个考点在 2025 年之后的新深度。
五、动手:60 行写一个注解驱动的小工具
框架用反射的套路可以浓缩成一个例子:自定义 @JsonField 注解 + 反射序列化器,把对象转成 JSON。麻雀虽小,Spring/Jackson 的核心流程俱全:
@Retention(RetentionPolicy.RUNTIME) // 必须 RUNTIME,否则反射读不到
@Target(ElementType.FIELD)
public @interface JsonField {
String value() default ""; // 自定义输出的字段名
}
public final class TinyJson {
// 框架必备:按类缓存反射结果,只反射一次
private static final Map<Class<?>, List<Field>> CACHE = new ConcurrentHashMap<>();
public static String toJson(Object obj) throws IllegalAccessException {
List<Field> fields = CACHE.computeIfAbsent(obj.getClass(), clazz -> {
List<Field> list = new ArrayList<>();
for (Field f : clazz.getDeclaredFields()) {
if (f.isAnnotationPresent(JsonField.class)) {
f.setAccessible(true); // 打开私有字段访问
list.add(f);
}
}
return list;
});
StringJoiner json = new StringJoiner(",", "{", "}");
for (Field f : fields) {
String name = f.getAnnotation(JsonField.class).value();
if (name.isEmpty()) name = f.getName();
json.add("\"" + name + "\":\"" + f.get(obj) + "\"");
}
return json.toString();
}
}
public class User {
@JsonField("user_name") private String name = "shifeng";
@JsonField private int age = 30;
private String password = "secret"; // 未标注,不会被输出
}
// TinyJson.toJson(new User()) → {"user_name":"shifeng","age":"30"}
这 60 行覆盖了本考点的全部要素:运行期读注解(Class 元数据)、setAccessible + field.get(动态访问)、按类缓存(性能治理)、注解驱动(框架套路)。面试写得出这个例子,"框架应用"这一问基本就过了。
六、小结
反射的知识骨架可以压缩成四句话:
- 数据来源:.class 文件自带完整元数据,类加载后存进元空间,堆上的 Class 对象是唯一访问入口;
- 执行机制:invoke 走 MethodAccessor,JDK 17 前是"JNI 慢路径 + 15 次后膨胀生成字节码",JDK 18 起统一为 MethodHandle;
- 性能观:慢在查找、检查、装箱、无法内联,治理阶梯是缓存 → MethodHandle → LambdaMetafactory/代码生成;
- 框架观:注解只是元数据,反射让它生效;DI、ORM、序列化、Mock 全靠它,但在 AOT/native-image 时代它从资产变成了需要登记管理的负债。
提问与回答(面试追问模拟,不计入阅读时长)
Q1:Class.forName 和 ClassLoader.loadClass 有什么区别?
A:前者默认执行类初始化(静态块、静态字段赋值),后者只做加载不初始化。JDBC 用 Class.forName 注册驱动正是利用了初始化时执行 static 块的特性。另外 forName 用调用者的类加载器,loadClass 用你指定的加载器,这在插件/容器隔离场景是本质区别。
Q2:Method.invoke 的底层实现是什么?
A:JDK 17 及以前:invoke 委派给 MethodAccessor,前 15 次走 NativeMethodAccessorImpl(JNI 调用),第 16 次触发 inflation,动态生成 GeneratedMethodAccessor 字节码类改走纯 Java 调用,让 JIT 能优化。JDK 18 起(JEP 416)统一重构为 MethodHandle 实现,去掉了双轨机制。
Q3:反射为什么慢?慢多少?
A:四个来源——方法查找的字符串匹配、每次调用的访问检查、参数 Object[] 装箱拆箱、JIT 无法内联。量级上:缓存好 Method 且 setAccessible(true) 后约比直接调用慢一个数量级(纳秒级差距),未缓存现查会再慢一到两个数量级。是否需要优化取决于调用频率,热路径才值得上 MethodHandle 或代码生成。
Q4:setAccessible(true) 做了什么?JDK 17 下为什么可能失败?
A:它关闭反射对象上的语言级访问检查开关(override 标志),使 private 成员可访问。JDK 9 模块化后包默认强封装,JDK 16 起非法反射访问默认拒绝,访问未 opens 的包会抛 InaccessibleObjectException,需要目标模块声明 opens 或启动时加 --add-opens。
Q5:MethodHandle 和反射 Method 有什么本质区别?
A:Method.invoke 每次调用都做访问检查且参数经 Object[] 传递;MethodHandle 的权限检查在 lookup 时一次性完成,invokeExact 携带精确类型签名,JVM 可将其视为普通调用点做内联。可以理解为:反射是"每次都递材料的窗口办事",MethodHandle 是"办过授权卡之后直接刷卡进门"。
Q6:JDK 动态代理和 CGLIB 的区别?和反射什么关系?
A:JDK 代理基于接口,运行时生成实现该接口的代理类,方法调用转发给 InvocationHandler(参数就是反射 Method);CGLIB 基于继承,用 ASM 生成目标类的子类覆写方法,无需接口,且可用 FastClass 机制避开反射调用。Spring AOP 默认有接口用 JDK 代理,无接口用 CGLIB。
Q7:Spring 在哪些环节用了反射?如果让你去掉反射该怎么做?
A:组件扫描读注解、Constructor 实例化 Bean、字段/方法注入、@PostConstruct 等生命周期回调、AOP 代理内部调用目标方法,全程反射。去反射的路线就是 Spring AOT/GraalVM 的做法:把运行期决策前移到构建期,生成 reflection hints 或直接生成调用代码(如 Spring 6 为构造器生成 instance supplier),运行期不再需要动态查找。
Q8:大量使用反射会带来什么隐性风险?
A:一是元空间压力——JDK 17 前 inflation 生成的 GeneratedMethodAccessor 类可能大量堆积;二是内存泄漏——缓存 Method/Class 的静态 Map 会阻止类加载器卸载,热部署场景尤其致命;三是可维护性——反射调用对 IDE 的引用分析、重构工具不可见,改个方法名编译不报错,线上才炸;四是与 AOT/native-image 不兼容,需要维护注册配置。
Q9:注解和反射是什么关系?
A:注解本身只是编译进 class 文件的静态元数据,不产生任何行为。RUNTIME 级别的注解在运行期被反射 API(isAnnotationPresent/getAnnotation)读取后,由框架代码决定做什么——所以"注解生效"的本质是"有一段反射代码在处理它"。SOURCE/CLASS 级别的注解反射读不到,走的是编译期处理器(如 Lombok)。