阅读时间:约 45 分钟 | 难度:★★★☆☆ | 适用方向:所有 Java 开发者
目录
- 引子:一个看似简单却年年都有人踩的坑
- 为什么需要 equals 和 hashCode?从"相等"的定义说起
- Object.equals 的默认行为:== 的身份相等性
- equals 方法的五条铁律
- hashCode 的契约规范
- equals 与 hashCode 的绑定关系:一条不可分割的契约
- HashMap 内部原理:为什么 hashCode 和 equals 缺一不可
- 实现 equals 的标准范式
- 实现 hashCode 的工程方法
- 继承关系下的 equals:一个没有完美解的问题
- 现代 Java 的解法:record、Lombok 与 IDE 生成
- 生产环境真实故障案例
- 总结:一张图记住 equals/hashCode
- 面试官视角:10 道高频追问
1. 引子:一个看似简单却年年都有人踩的坑
先看一段代码,判断输出结果:
import java.util.*;

public class EqualsHashCodeDemo {
    static class Person {
        String name;
        int age;

        Person(String name, int age) {
            this.name = name;
            this.age = age;
        }

        @Override
        public boolean equals(Object obj) {
            if (this == obj) return true;
            if (!(obj instanceof Person)) return false;
            Person other = (Person) obj;
            return this.age == other.age && Objects.equals(this.name, other.name);
        }
        // 注意:没有重写 hashCode!
    }


    public static void main(String[ ] args) {

        Person p1 = new Person("张三", 25);
        Person p2 = new Person("张三", 25);

        // 问题一
        System.out.println("p1.equals(p2) = " + p1.equals(p2));  // ?

        // 问题二
        Map<Person, String> map = new HashMap<>();
        map.put(p1, "工程师");
        System.out.println("map.get(p1)  = " + map.get(p1));     // ?
        System.out.println("map.get(p2)  = " + map.get(p2));     // ?

        // 问题三
        Set<Person> set = new HashSet<>();
        set.add(p1);
        set.add(p2);
        System.out.println("set.size()   = " + set.size());      // ?

        // 问题四
        System.out.println("set.contains(p1) = " + set.contains(p1)); // ?
        System.out.println("set.contains(p2) = " + set.contains(p2)); // ?
    }
}
先自己想一想答案,再看下文。
点击查看答案
p1.equals(p2) = true          // equals 按 name 和 age 判断,返回 true
map.get(p1)  = 工程师          // p1 的 hashCode 能找到
map.get(p2)  = null            // ❌ p2 的 hashCode 不同,定位到不同 bucket!
set.size()   = 2               // ❌ HashSet 认为 p1 和 p2 是不同的对象!
set.contains(p1) = true
set.contains(p2) = false       // ❌ 逻辑相等但容器找不到!
核心问题:只重写了 equals 而没重写 hashCode,违反了 equals/hashCode 契约,导致基于哈希的容器(HashMap、HashSet、Hashtable)行为异常。
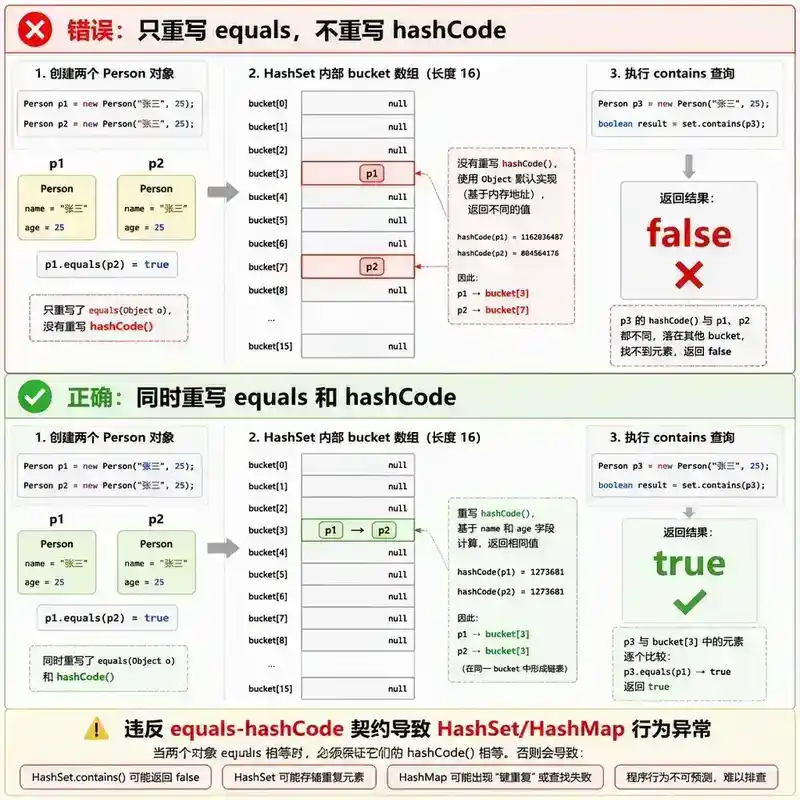
这就是本文要彻底解决的问题。equals 和 hashCode 看似简单,但它们共同构成了 Java 对象相等性判断的基础设施——这个基础设施直接决定了 HashMap 等容器的正确性。任何一个 Java 开发者,只要重写了 equals,就必须理解并与 hashCode 协同工作。
2. 为什么需要 equals 和 hashCode?从"相等"的定义说起
在编程中,"相等"有两种完全不同的含义:
- 身份相等(Reference Equality):两个引用指向堆上同一个对象。Java 中用
==判断。 - 逻辑相等(Logical Equality):两个对象代表同一个业务实体,即使它们是堆上不同的实例。Java 中用
equals()判断。
String a = new String("hello");
String b = new String("hello");

System.out.println(a == b);       // false — 两个不同的堆对象
System.out.println(a.equals(b));  // true  — 内容相同,逻辑相等
在现实业务中,我们几乎总是关心逻辑相等。两个 User 对象,只要 userId 相同,就应该被视为同一个用户——哪怕它们是不同时刻从不同数据源构造出来的。
这正是 equals 和 hashCode 存在的根本原因:让我们能自定义"什么是相等",并且让依赖于这种相等性的数据结构(哈希表)正常工作。
3. Object.equals 的默认行为:== 的身份相等性
翻开 JDK 源码,java.lang.Object 中的默认实现出奇地简单:
// java.lang.Object
public boolean equals(Object obj) {
    return (this == obj);  // 就是 == 比较
}

public native int hashCode();  // 由 JVM 根据对象内存地址生成
这意味着,如果你不重写这两个方法:
equals()等价于==,只判断两个引用是否指向同一块内存hashCode()返回的值通常转化为对象的内存地址,每个新new出来的对象都不一样
什么时候必须重写? 当你的类有逻辑相等的需求时——换句话说,当你希望两个不同实例在某些条件下被视为"同一个东西"。
常见的必须重写场景:
- 值对象(Value Object):Money、Address、Point
- 实体(Entity)按业务主键比较:User(id)、Order(orderId)
- 需要放入 HashSet 做去重或作为 HashMap 的 key
4. equals 方法的五条铁律
Java 规范(Java Language Specification 和 Object.equals() 的 javadoc)对 equals 方法提出了五条必须遵守的约定。违反任何一条,你的代码可能在特定场景下出现难以排查的 bug。
4.1 自反性(Reflexive)
对任何非 null 引用
x,x.equals(x)必须返回true。
这条通常不会违反。但有一个危险的边缘场景:如果你在 equals 中使用浮点数比较,而浮点数为 NaN:
double d = Double.NaN;
System.out.println(d == d);  // false!NaN != NaN
如果你的 equals 通过 == 比较 double 字段,自反性就会崩溃。解决方案:使用 Double.compare() 或 Objects.equals()。
4.2 对称性(Symmetric)
对任何非 null 引用
x和y,x.equals(y)和y.equals(x)必须一致。
这是最容易违反的一条,尤其是在继承场景中。考虑经典的 Point/ColorPoint 例子:
class Point {
    int x, y;
    @Override
    public boolean equals(Object obj) {
        if (!(obj instanceof Point)) return false;
        Point p = (Point) obj;
        return x == p.x && y == p.y;
    }
}

class ColorPoint extends Point {
    Color color;
    @Override
    public boolean equals(Object obj) {
        if (!(obj instanceof ColorPoint)) return false;  // ⚠️ 问题在这
        ColorPoint cp = (ColorPoint) obj;
        return super.equals(cp) && color.equals(cp.color);
    }
}
测试一下:
Point p = new Point(1, 2);
ColorPoint cp = new ColorPoint(1, 2, Color.RED);

System.out.println(p.equals(cp));   // true — Point 只看 x 和 y
System.out.println(cp.equals(p));   // false — ColorPoint 要求也是 ColorPoint
// 对称性被打破!
这个问题的解决方案我们在第 10 节详细讨论。
4.3 传递性(Transitive)
对任何非 null 引用
x、y、z,如果x.equals(y) == true且y.equals(z) == true,则x.equals(z)也必须为true。
传递性在多层继承时尤其容易被破坏。如果 Point 和 ColorPoint 都用了 instanceof,你可能得到:
ColorPoint cp1 = new ColorPoint(1, 2, Color.RED);
Point      p   = new Point(1, 2);
ColorPoint cp2 = new ColorPoint(1, 2, Color.BLUE);

cp1.equals(p)   // true — ColorPoint 中的 instanceof Point 通过
p.equals(cp2)   // true — Point 只看 x 和 y
cp1.equals(cp2) // false — 都是 ColorPoint,颜色不同
// 传递性被打破:cp1==p && p==cp2 但 cp1!=cp2
Joshua Bloch 在《Effective Java》中的结论:无法在扩展可实例化类的同时,既增加值组件又保留 equals 契约。 解决方案通常是:用组合代替继承,或使用 getClass() 而非 instanceof。
4.4 一致性(Consistent)
多次调用
x.equals(y),只要对象上用于比较的信息没变,结果必须一致。
这条意味着 equals 不应该依赖不可靠的资源。不要依赖网络调用、随机数或任何可变的外部状态。
4.5 非空性(Non-nullity)
对任何非 null 引用
x,x.equals(null)必须返回false,不能抛出 NPE。
标准写法中 instanceof 操作符天然保证了这一点——null instanceof AnyClass 总是返回 false。
@Override
public boolean equals(Object obj) {
    if (!(obj instanceof MyClass)) return false;  // null 在这里被过滤
    // ...
}
5. hashCode 的契约规范
hashCode 的契约相对简单,但同样重要:
- 一致性:在同一个 Java 进程内,只要 equals 用到的字段不变,多次调用
hashCode()必须返回相同整数。 - equals 相等则 hashCode 必须相等:如果
a.equals(b) == true,那么a.hashCode() == b.hashCode()必须成立。 - equals 不相等不要求 hashCode 不相等:
a.equals(b) == false时,a.hashCode() == b.hashCode()是允许的(哈希冲突),但最好让它们不同——这关系到 HashMap 的性能。
第 2 条是最关键的:如果违反,基于哈希的容器将出现不可预测的行为。 这是本文开篇 Bug 的根因。
6. equals 与 hashCode 的绑定关系:一条不可分割的契约
本节是全文的核心。把 equals 和 hashCode 的关系用一句话总结:
equals 相等的两个对象,hashCode 必须相等。反之不要求。
这条规则不是"最佳实践",而是硬性契约。HashMap、HashSet、Hashtable、ConcurrentHashMap 等所有基于哈希的数据结构都依赖于它。
为什么?让我们深入到 HashMap 的实现逻辑——你不需要看过源码,理解下面的伪代码就足够了:
// HashMap 的 put 逻辑(伪代码)
put(key, value):
    int hash = key.hashCode()           // 步骤一:算哈希值
    int bucketIndex = hash % capacity   // 步骤二:定位桶
    for (entry in buckets[bucketIndex]) // 步骤三:在桶内遍历
        if (key.equals(entry.key))      // 步骤四:用 equals 找匹配
            entry.value = value         // 找到了,覆盖
            return
    // 没找到,追加新条目
    buckets[bucketIndex].add(new Entry(key, value))
关键观察:
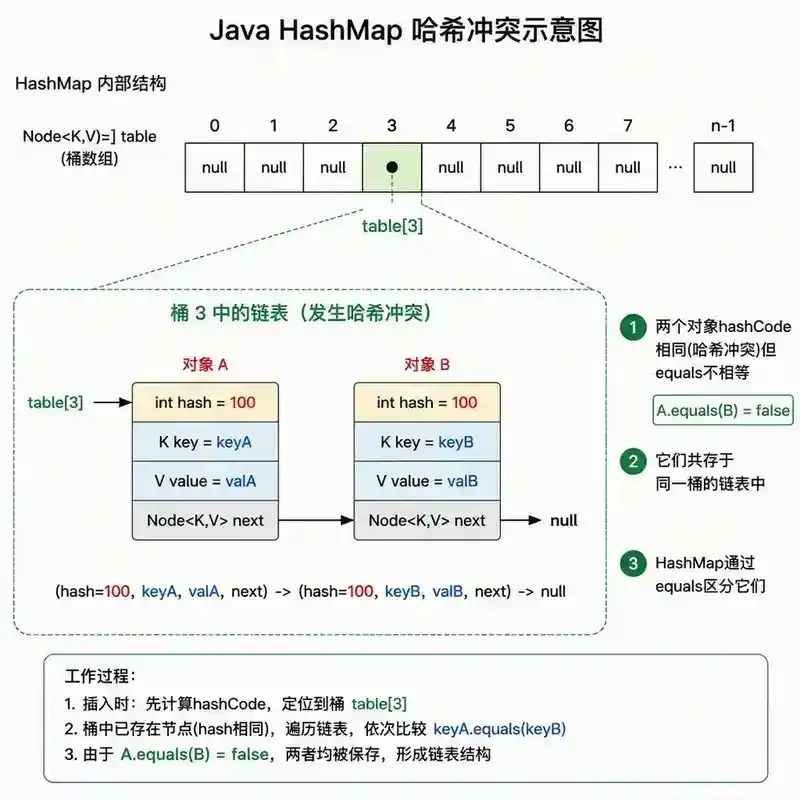
- 先调 hashCode 定位桶,再调 equals 在桶内精确查找。
- 如果两个对象
equals相等但hashCode不同,它们会落到不同的桶,HashMap 永远找不到对方。 - 如果
hashCode相同但equals不相等,只是性能差一点(桶内链表变长),逻辑仍然正确。
所以 equals 和 hashCode 的本质分工是:hashCode 做初筛(O(1) 定位),equals 做精确匹配。
7. HashMap 内部原理:为什么 hashCode 和 equals 缺一不可
现在我们从 JDK 源码角度,精确理解 HashMap 如何使用这两个方法。
7.1 HashMap 的数据结构
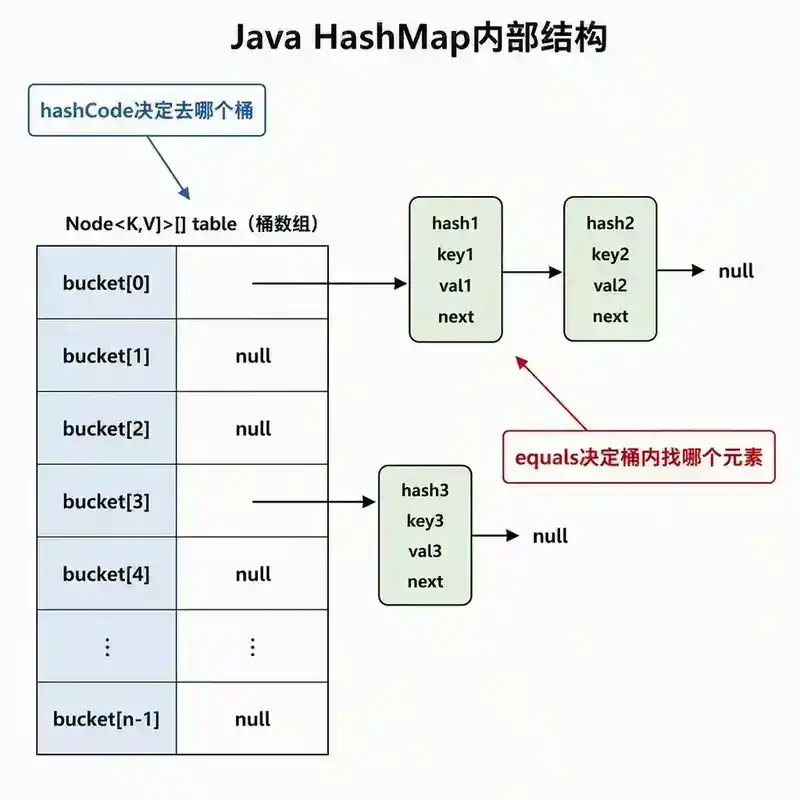
HashMap 在 JDK 8+ 的核心结构是:数组 + 链表 + 红黑树。
bucket[0]  →  (hash1, key1, val1, next) → (hash2, key2, val2, next) → null
bucket[1]  →  null
bucket[2]  →  (hash3, key3, val3, next) → null
...
bucket[n]  →  (hash4, key4, val4, next) → [红黑树节点]
每个桶(bucket)可以是一个单链表,当链表长度超过 8 且数组长度 ≥ 64 时,链表会树化为红黑树以优化查找性能。
7.2 JDK 源码中的扰动函数
HashMap 不只是直接用 key.hashCode(),而是做了一次额外的扰动:
// JDK 8 HashMap.hash()
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
这个扰动函数把 hashCode 的高 16 位和低 16 位做异或,目的是让高位也参与索引计算。为什么需要这样做?因为 (n - 1) & hash 做定位时,如果 n 较小(如默认容量 16),只有低 4 位参与运算;如果 hashCode 的低位分布不均匀,扰动函数可以显著减少冲突。
7.3 get 方法的完整调用链
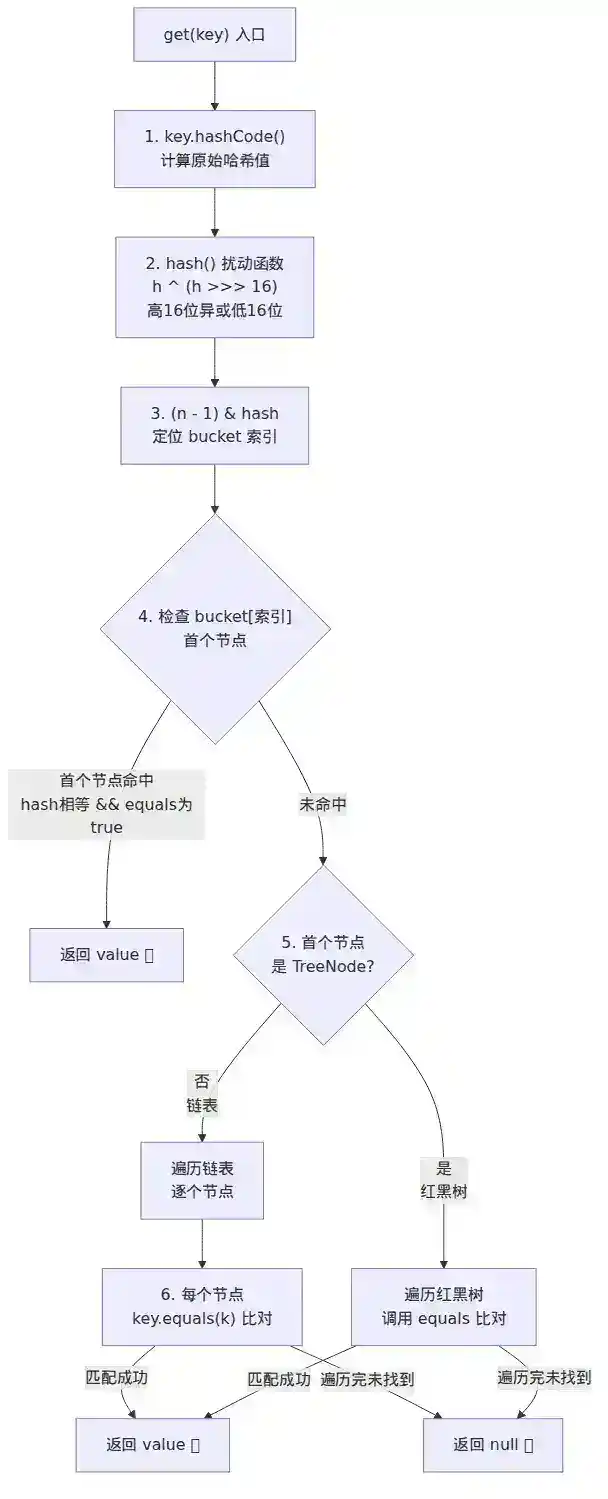
源码中 HashMap.get() 的关键路径(简化):
public V get(Object key) {
    Node<K,V> e;
    return (e = getNode(hash(key), key)) == null ? null : e.value;
}

final Node<K,V> getNode(int hash, Object key) {

    Node<K,V>[ ] tab; Node<K,V> first, e; int n; K k;

    if ((tab = table) != null && (n = tab.length) > 0 &&
        (first = tab[(n - 1) & hash]) != null) {         // ① 定位桶
        if (first.hash == hash &&
            ((k = first.key) == key || (key != null && key.equals(k))))  // ② 检查第一个节点
            return first;
        if ((e = first.next) != null) {
            if (first instanceof TreeNode)                 // ③ 红黑树查找
                return ((TreeNode<K,V>)first).getTreeNode(hash, key);
            do {                                           // ④ 链表遍历
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    return e;
            } while ((e = e.next) != null);
        }
    }
    return null;
}
注意源码中的关键优化:先比较 hash 值(**e.hash == hash**),hash 不同直接跳过,不调用 equals。这从另一角度说明了:hashCode 不同导致直接找不到;hashCode 相同但 equals 不同,只是多了一次比较。
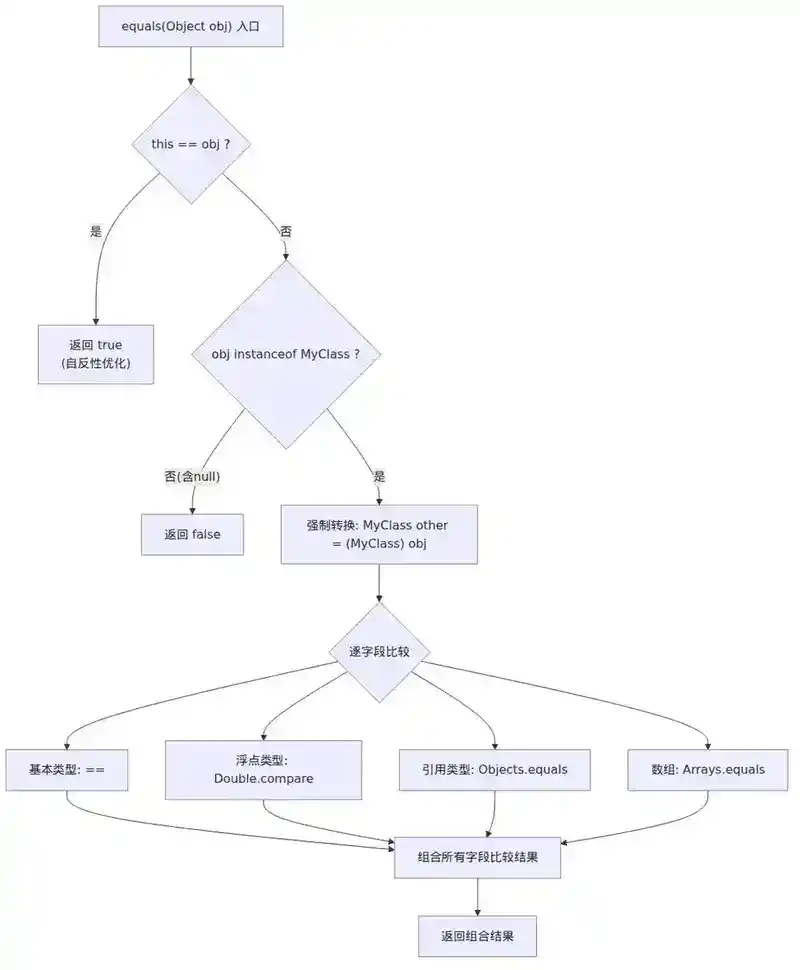
8. 实现 equals 的标准范式
8.1 推荐的 equals 实现模板
@Override
public boolean equals(Object obj) {
    // 1. 自反性优化:同一个引用直接返回 true
    if (this == obj) return true;

    // 2. null 检查和类型检查一体:instanceof 自动过滤 null
    if (!(obj instanceof MyClass)) return false;

    // 3. 类型转换
    MyClass other = (MyClass) obj;

    // 4. 逐字段比较:基本类型用 ==,对象用 Objects.equals,浮点数用 compare
    return this.id == other.id
        && Objects.equals(this.name, other.name)
        && Double.compare(this.price, other.price) == 0;
}
8.2 字段比较的注意事项
| 字段类型 | 推荐比较方式 | 原因 |
|---|---|---|
int, long, boolean |
== |
直接比较 |
float, double |
Float.compare() / Double.compare() |
处理 NaN 和 -0.0 |
| 引用类型 | Objects.equals(a, b) |
自动处理 null |
| 数组 | Arrays.equals() / Arrays.deepEquals() |
逐元素比较 |
8.3 instanceof vs getClass
这是 equals 实现中最有争议的决策点:
| 方式 | 优点 | 缺点 |
|---|---|---|
instanceof |
支持子类比较,符合里氏替换原则 | 容易破坏对称性(见第 4.2 节) |
getClass() |
不会破坏对称性 | 子类对象和父类对象永远不相等,且违反里氏替换原则,会打破代理/装饰器等模式 |
推荐策略:
- 如果你的类设计为可继承且子类不增加影响相等性的字段 → 用
instanceof并标记 equals 为final - 如果你的类是值对象,通常应标记为
final→ 用instanceof(因为类已经是 final) - 如果确实需要子类扩展相等判断 → 用组合代替继承
9. 实现 hashCode 的工程方法
9.1 经典实现:31 进制累加
这是 Joshua Bloch 在《Effective Java》中推荐的算法:
@Override
public int hashCode() {
    int result = Integer.hashCode(id);
    result = 31 * result + (name != null ? name.hashCode() : 0);
    result = 31 * result + Double.hashCode(price);
    return result;
}
为什么用 31? 31 是奇素数,乘法可以优化为位移和减法:31 * i == (i << 5) - i,比一般乘法快。素数特性使哈希值的分布更均匀。
9.2 JDK 7+ 的便捷方法
@Override
public int hashCode() {
    return Objects.hash(id, name, price);  // JDK 7+
}
一行搞定。但需注意:Objects.hash() 内部用了 varargs,每次调用会创建 Object[ ] 数组,有一定性能开销。在高频调用的热点类中,建议手写。
9.3 哈希函数质量对性能的影响
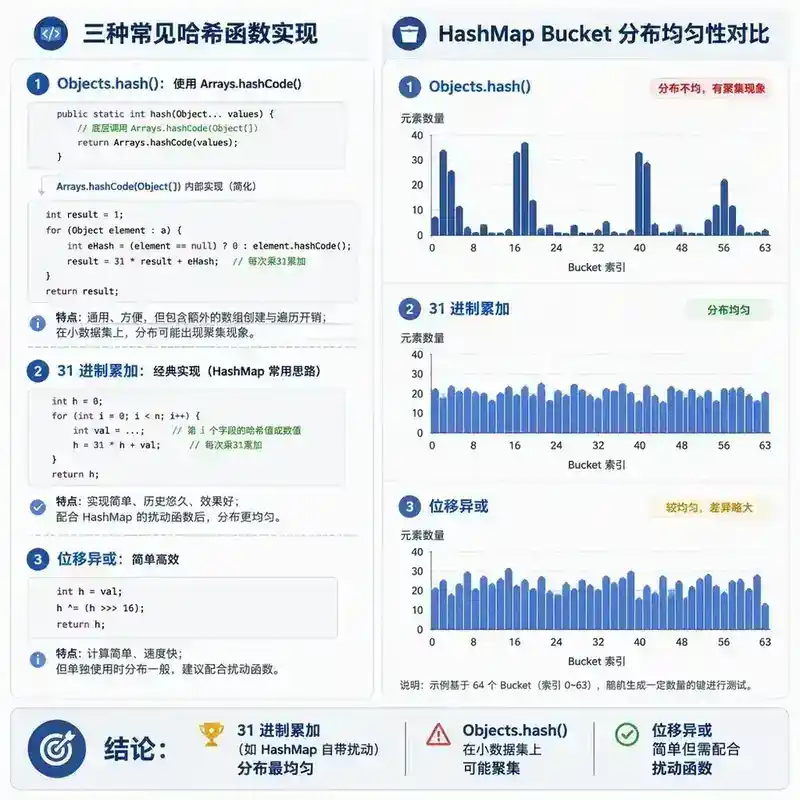
哈希函数的目标是 "均匀分布":让不同的对象尽量落到不同的桶中,减少冲突。
坏哈希函数的例子:
// 坏例子:总是返回常量
@Override
public int hashCode() { return 42; }
这完全合法——equals 相等的两个对象 hashCode 确实相等。但所有对象都在同一个桶里,HashMap 退化为链表,get/put 从 O(1) 退化到 O(n)。
好哈希函数的设计原则:
- 尽量让所有参与 equals 的字段也参与 hashCode
- 使用素数作为乘数(31 是常用值)
- 确保分布均匀——不同字段组合应产生不同的哈希值
9.4 hashCode 的缓存策略
如果对象是不可变的,且 hashCode 计算成本较高,可以缓存结果:
public final class ImmutableUser {
    private final long id;
    private final String name;
    private int hashCode;  // 0 表示未计算

    @Override
    public int hashCode() {
        int h = hashCode;
        if (h == 0) {
            h = Long.hashCode(id);
            h = 31 * h + (name != null ? name.hashCode() : 0);
            hashCode = h;
        }
        return h;
    }
}
注意:String 类用的就是这个策略——它内部维护了 private int hash 字段做缓存。
10. 继承关系下的 equals:一个没有完美解的问题
这是 equals 实现中最棘手的部分。如前文 4.2 和 4.3 节所示,继承很容易破坏对称性和传递性。
10.1 三种策略及权衡
策略一:instanceof + final equals(推荐优先考虑)
public class Point {
    @Override
    public final boolean equals(Object obj) {
        if (!(obj instanceof Point)) return false;
        Point p = (Point) obj;
        return x == p.x && y == p.y;
    }
}
// 子类不能再覆盖 equals,对称性自然保证
策略二:getClass 严格比较
@Override
public boolean equals(Object obj) {
    if (this == obj) return true;
    if (obj == null || obj.getClass() != this.getClass()) return false;
    // ...
}
优点:对称性自然满足。缺点:子类实例和父类实例永远不相等——即使它们在父类的意义上完全相同。这会打破里氏替换原则:一个使用 Point 的方法传入 ColorPoint(1,2,RED),按 equals 语义它不等于任何 Point。
策略三:组合代替继承(最推荐的工程实践)
public class ColorPoint {
    private final Point point;    // 组合
    private final Color color;

    public Point asPoint() { return point; }

    @Override
    public boolean equals(Object obj) {
        if (!(obj instanceof ColorPoint)) return false;
        ColorPoint cp = (ColorPoint) obj;
        return point.equals(cp.point) && color.equals(cp.color);
    }
}
组合彻底规避了继承带来的对称性问题。ColorPoint 的 equals 只比较 ColorPoint,而 Point 的 equals 只比较 Point,两个不相干的类型不会产生交集。
10.2 关键结论
Joshua Bloch 的总结:没有一种方式可以在扩展可实例化类的同时,既增加值组件(字段)又完全遵守 equals 契约。 推荐的解决方案是:
- 如果可以,标记类为
final,用instanceof - 如果必须继承,优先用组合代替继承
- 如果继承不可避免,标记 equals 为
final或用getClass()并接受里氏替换原则的部分牺牲
11. 现代 Java 的解法:record、Lombok 与 IDE 生成
11.1 Java Record(Java 14+)
从 Java 14 开始,record 类型自动生成正确的 equals、hashCode 和 toString:
public record Person(String name, int age) { }
编译器自动生成的实现:
- equals 比较所有组件(name 和 age)
- hashCode 基于所有组件计算
- record 是隐式 final 的,不存在继承问题
这是实现值对象的最佳方式。 如果你用的是 Java 14+,record 应成为默认选择。
11.2 Lombok @EqualsAndHashCode
@EqualsAndHashCode
public class Person {
    private String name;
    private int age;
}
Lombok 用 getClass() 比较(除非指定 callSuper = true),避免了继承的对称性问题。
11.3 IDE 生成
IntelliJ IDEA 和 Eclipse 都可以自动生成 equals/hashCode:
- IntelliJ:
Alt + Insert→equals() and hashCode() - 可选择使用
instanceof或getClass() - 可选择要参与比较的字段
IDE 生成的代码质量很高,但需要理解背后选择的含义(特别是 instanceof vs getClass 的决策)。
12. 生产环境真实故障案例
案例一:HashSet 去重失效导致重复入库
现象:订单批量处理系统偶发性地创建了重复订单。
根因:Order 类重写了 equals 按 orderId 比较,但没重写 hashCode。当订单对象被放入 HashSet 做去重时,HashSet.add() 内部先调 hashCode(返回的是 Object 默认的地址哈希),两个"相同"订单的 hashCode 不同,落到了不同的桶,去重完全失效。
修复:为 Order 类添加正确的 hashCode 实现。
@Override
public int hashCode() {
    return Objects.hash(orderId);
}
案例二:HashMap 缓存击穿
现象:用户信息缓存用 HashMap<CacheKey, User> 实现,但缓存命中率几乎为 0,每次都查数据库。
根因:CacheKey 类重写了 equals,但 hashCode 使用了 Object.hash()(varargs),而其中一个参与 equals 的字段在构造后可变——该字段被业务代码修改后,hashCode() 返回值变了,但对象还在原来的桶里。后续用新的 hashCode 去查找,定位到不同的桶,永远找不到。
教训:
- 作为 HashMap key 的对象应该是不可变的
- 或者确保参与 equals/hashCode 的字段在放入容器后不再变化
案例三:HashSet.contains 返回 false 导致重复扣款
现象:支付系统中用 HashSet 追踪已处理的交易 ID,偶发重复扣款。
根因:交易记录类 Transaction 的 equals 按交易 ID 比较,但 hashCode 包含了时间戳字段。同一笔交易两次获取时,时间戳毫秒级不同导致 hashCode 也变了。set.contains() 返回 false,系统认为这笔交易没处理过,再次扣款。
修复:hashCode 只应包含参与 equals 比较的字段——时间戳不应参与。
13. 总结:一张图记住 equals/hashCode
如果你只能记住三件事,记住这些:
- 重写 equals 必须重写 hashCode。 两条必须一起。
- equals 相等的两个对象,hashCode 必须相等。 这是契约,不是建议。
- 参与 equals 的字段,必须参与 hashCode;参与 hashCode 的字段不一定要参与 equals。
实现清单:
- [ ] equals 检查自反性
- [ ] equals 使用
- [ ] equals 中基本类型用
- [ ] hashCode 中所有参与 equals 的字段都参与计算
- [ ] 优先使用
- [ ] 作为 HashMap key 的对象保持不可变
- [ ] 考虑用组合代替继承解决 equals 的对称性问题
14. 面试官视角:10 道高频追问
以下问题来自真实面试场景,考察你对 equals/hashCode 契约的深层理解,而非死记硬背。
Q1: 你重写了 equals,但没重写 hashCode。把对象放进 HashSet 后,用另一个逻辑相等的对象调用 contains,返回什么?为什么?
参考答案
返回 false。HashSet 底层是 HashMap,contains 时先调用 hashCode() 定位桶。未重写 hashCode 的两个不同实例,默认 hashCode 值(基于内存地址)通常不同,会定位到不同桶,根本走不到 equals 比较那一步。
Q2: HashMap 在 JDK 8 中做了什么优化来缓解糟糕的 hashCode 实现?这个优化的触发条件是什么?
参考答案
JDK 8 引入了红黑树:当同一个桶中的链表长度超过 8 且哈希表容量 ≥ 64 时,链表会树化为红黑树,将最坏情况下的查找复杂度从 O(n) 降到 O(log n)。这是对极端情况的兜底——比如有人恶意构造大量 hashCode 相同的对象发起哈希碰撞攻击。
Q3: **getClass()** 和 **instanceof** 在 equals 实现中各有什么问题?在实际项目中你会怎么选?
参考答案
getClass() 违反里氏替换原则——子类实例和父类实例永远不相等,即使子类没有新增影响相等性的字段。还会打破代理模式:Collections.unmodifiableList() 和 Hibernate 代理对象都会失败。
instanceof 则可以破坏对称性——如果子类扩展了 equals。
实际选择:能标记类为 final 就用 instanceof;需要继承时优先用组合代替继承;如果必须继承且子类增加了影响相等性的字段,用 getClass() 并清楚认知其代价。
Q4: 为什么推荐用 31 来计算 hashCode?换一个数比如 32 有什么问题?
参考答案
两个原因:① 31 是奇素数,素数的特性让哈希分布更均匀;② 31 * i 可以被 JVM 优化为 (i << 5) - i,比普通乘法快。32 不是素数,性能上虽然可以用位移,但分布均匀性不如 31。更重要的是 32 = 2^5,与 2 的幂做乘法本质上是在低位补 0,可能导致哈希分布向低位集中的 bias。
Q5: 一个不可变的 Person 类被用作 HashMap 的 key,但你后来修改了 Person 的字段。hashCode 变了吗?对象还能在 Map 里找到吗?这个问题的本质是什么?
参考答案
如果 Person 是不可变的,你无法修改字段。但如果类设计允许字段被修改(可变的 key),修改后 hashCode 值改变,但对象仍在原来 hashCode 对应的桶里。之后用新的 hashCode 去查找会定位到不同桶,找不到对象。这会导致内存泄漏(对象在 Map 里但永远无法被访问到)和逻辑错误。本质教训:用作 HashMap key 的对象应当是不可变的。
Q6: 两个对象 **equals** 返回 **true**,它们能放在同一个 HashSet 里吗?
参考答案
不能。HashSet 的 add 先用 hashCode 定位桶,再用 equals 判断是否已存在。如果 equals 返回 true(且 hashCode 也相同——这是契约要求),HashSet 会认为元素已存在,add 返回 false,不会放入第二个。反过来,如果两个对象 equals 不相等但 hashCode 相等(哈希冲突),它们可以放在同一个桶的不同位置,size 会增加。
Q7: Lombok 的 **@EqualsAndHashCode** 在继承场景中要注意什么问题?
参考答案
Lombok 默认使用 getClass() 比较,不使用 instanceof。如果父类和子类都标注了 @EqualsAndHashCode,子类不设置 callSuper = true,则子类的 equals 不会调用父类的比较逻辑——父类中定义的字段被忽略了。正确做法是子类加上 @EqualsAndHashCode(callSuper = true)。另外 Lombok 的 getClass() 策略会和 Hibernate 懒加载代理冲突——代理对象的 class 不是实体类本身,导致 equals 永远返回 false。
Q8: JPA/Hibernate 实体类的 equals/hashCode 应该基于什么实现?为什么不能简单用数据库自增 ID?
参考答案
不能简单用数据库自增 ID 的原因:新创建的实体在 persist 之前 ID 是 null,多个未持久化的新实体用 equals 比较时 hashCode 都返回相同值(null 的哈希),全都落在同一个桶里,性能退化。ID 在 persist 后还会变化——如果实体已经放入 Set,ID 变了 hashCode 也变,对象就"丢失"了。
推荐方案:使用业务键(business key)——一个不随持久化状态改变的自然标识符。如果没有业务键,在 persist 前用 ==(Object 默认实现)作为 equals 逻辑,在 Hash 容器中避免混合使用持久化和非持久化实体。
Q9: Java record 自动生成的 equals 和 hashCode,与你自己手写有什么不同?有哪些场景不适合用 record?
参考答案
record 生成的实现比较所有组件字段,且使用 instanceof + getClass() 的混合——它会先检查 instanceof,确保类型匹配后按各字段比较。record 是隐式 final 的,所以没有继承问题。
不适合 record 的场景:① 需要按业务主键比较而非所有字段比较的实体(如 User 只按 userId 比较,不等价于所有字段相同);② JPA 实体(JPA 要求无参构造器且字段可变);③ 需要维护不变量(invariant)且字段之间有约束关系的类——record 的紧凑构造器能力有限。
Q10: 设计一个 LRU 缓存,key 是一个复合对象 **CacheKey(tenantId, userId, resourceType)**。equals 和 hashCode 应该怎么实现?如果后续需求要求 **CacheKey** 增加一个 **region** 字段,但不希望破坏已有缓存键的行为,怎么办?
参考答案
实现:equals 比较三个字段,hashCode 用 Objects.hash(tenantId, userId, resourceType) 或手写 31 进制累加。注意字段顺序要和 equals 一致。
如果增加 region 字段但不希望影响已有行为:① 可以让 region 默认值为 null 或特定值,equals 中不比较 null region(即 region 为 null 时视为匹配任意 region);② 使用向后兼容的比较器——新旧 key 互操作时,用 Objects.equals(a.region, b.region) || a.region == null || b.region == null 的方式。但这本质上是把 equals 变成了"不严格相等"的判断,会破坏传递性。更好的做法是不要修改已有的 CacheKey,而是创建新的 CacheKeyV2 并做迁移。
下一篇预告:006|String 不可变性:字符串常量池、intern、拼接优化与安全价值