覆盖考点:011|注解机制:元注解、运行期解析、编译期处理器与典型场景
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:38 分钟(文末问答不计入)
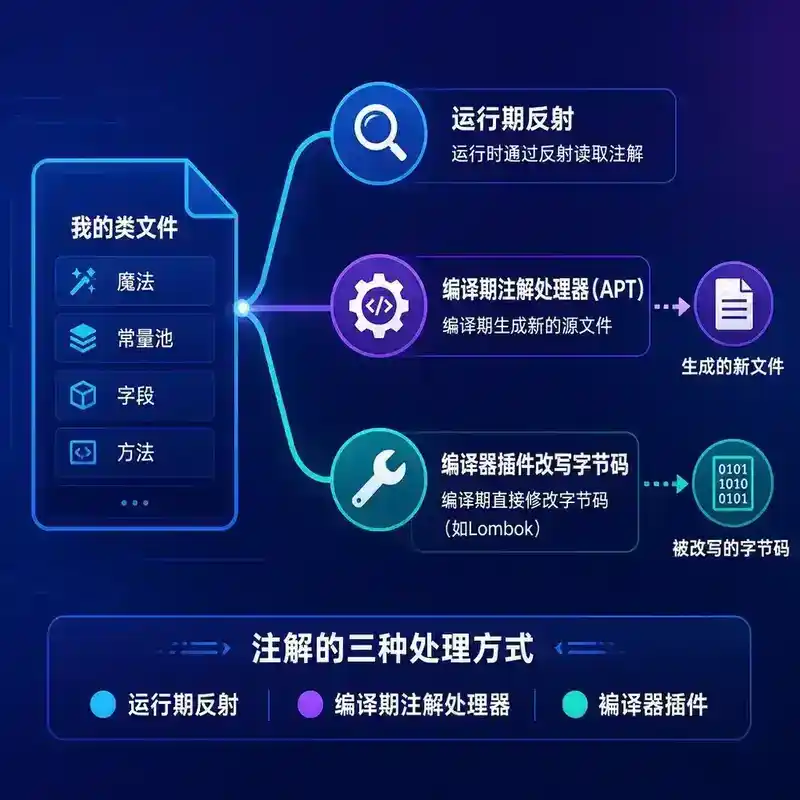
上一篇讲反射时留了一个尾巴:注解本身不产生任何行为,是运行期的反射代码在处理它,注解才"生效"。这句话只说对了三分之一——现代 Java 生态里,读懂一个注解至少有三种完全不同的方式:Spring 靠反射在运行期现场读;MapStruct、Dagger 靠编译期的注解处理器(APT)提前生成代码;Lombok 更激进,直接在编译期改写你写的类。三条路线殊途同归,但代价、时机、能力边界完全不同。
面试官问注解,追问链通常是:元注解怎么限定注解的使用范围 → 注解在字节码里到底存不存在 → 运行期拿到的注解对象是什么东西 → 除了反射还有别的处理方式吗 → Lombok 到底是怎么做到反射做不到的事的。本文按这条链展开。
一、元注解:注解界的"语法规则"
1. 四个基本元注解,管住注解怎么用
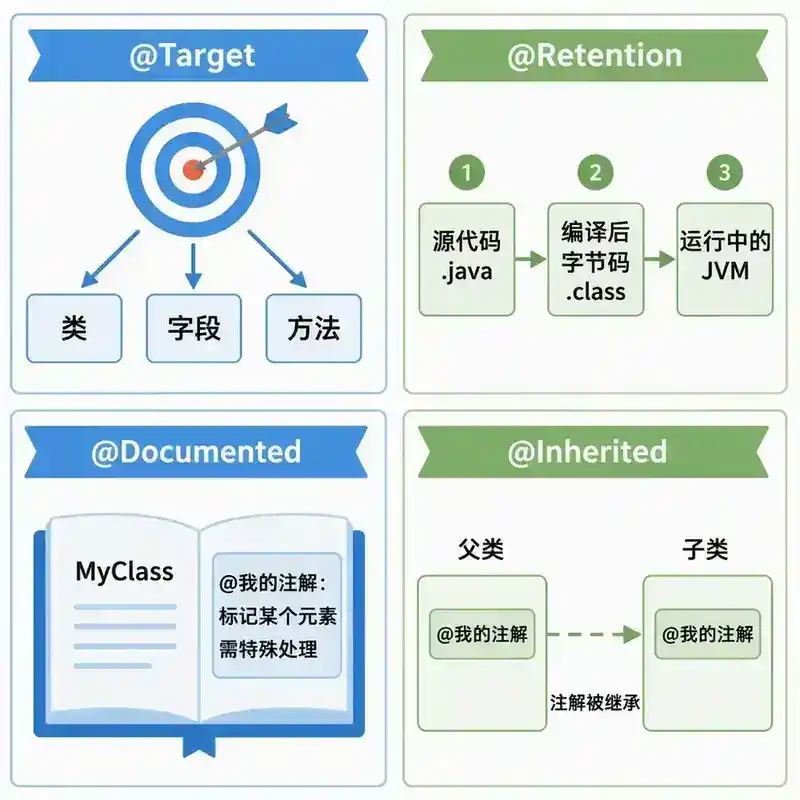
注解本身也是被 @Target、@Retention、@Documented、@Inherited 这四个"元注解"约束的——它们是描述注解的注解:
- @Target:限定这个注解能标在哪,取值来自
ElementType:TYPE(类/接口/枚举)、FIELD、METHOD、PARAMETER、CONSTRUCTOR、LOCAL_VARIABLE、ANNOTATION_TYPE、PACKAGE、TYPE_PARAMETER(JDK 8 新增,泛型参数)、TYPE_USE(JDK 8 新增,任意用到类型的地方)。不写 @Target 等于不限制,能标在任何地方。 - @Retention:决定这个注解活多久,取值是
RetentionPolicy的三档,下一节详细展开。不写默认是 CLASS——这是个常见的坑,很多人以为默认是 RUNTIME,结果自定义注解反射读不出来。 - @Documented:让这个注解出现在 javadoc 生成的文档里。纯粹影响文档工具,不影响任何运行时行为。
- @Inherited:让注解具有"继承性"——但坑点很多,下面单独讲。
@Retention(RetentionPolicy.RUNTIME)
@Target({ElementType.METHOD, ElementType.TYPE})
@Documented
public @interface AuditLog {
    String action();
    boolean sensitive() default false;
}
2. @Inherited 的三个隐藏限制
@Inherited 看起来是"子类自动拥有父类的注解",但实际限制比想象中窄得多:
- 只对类级注解生效,标在方法、字段、接口上的 @Inherited 完全不起作用——方法覆写不会继承父类方法上的注解,这是很多人踩过的坑;
- 只影响
**getAnnotation**/**getAnnotations**,不影响**getDeclaredAnnotation**——后者只看当前类自己声明的注解,不会往父类查; - 接口上的注解永远不会被实现类继承,即使标了 @Inherited 也没用,规范里明确排除了接口这条链路。
框架里常见的"@Transactional 能不能被子类继承"之类的问题,答案就藏在这三条规则里。
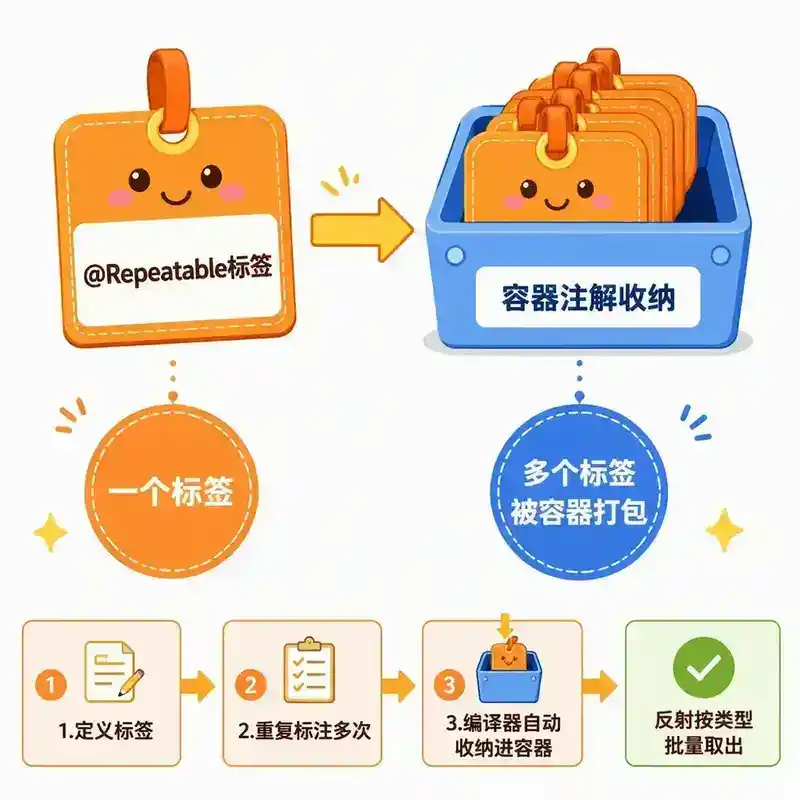
3. @Repeatable:让同一个注解标多次
JDK 8 之前,同一个位置只能标一次同名注解。@Repeatable 解决了这个问题,但底层实现是"糖"——编译器悄悄造了一个容器注解把重复的注解包起来:
@Repeatable(Schedules.class)
public @interface Schedule { String cron(); }

@Retention(RetentionPolicy.RUNTIME)

public @interface Schedules { Schedule[ ] value(); }


@Schedule(cron = "0 0 * * *")
@Schedule(cron = "0 30 12 * * ?")
public class ReportJob { }
写两个 @Schedule,编译器实际生成的字节码里只有一个 @Schedules,里面装着两个 Schedule。反射读取时要用 getAnnotationsByType(Schedule.class)(自动拆包)而不是 getAnnotation(Schedule.class)(只认容器注解,拿到 null)——这是 @Repeatable 最容易踩的一个 API 选型坑。
二、生命周期:注解到底活到哪一步
1. RetentionPolicy 三档,决定字节码里有没有它
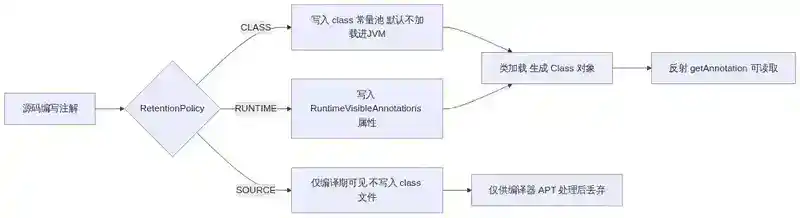
一个注解在源码里写下之后,会经过三个可能的检查点,RetentionPolicy 决定它能走到哪一步:
- SOURCE:编译成 .class 后彻底消失,只存在于源码。典型代表:
@Override、@SuppressWarnings——它们只是给编译器/IDE 做静态检查用的标记,运行期毫无意义,留着反而浪费常量池空间。 - CLASS:写进 .class 文件的
RuntimeInvisibleAnnotations属性,但类加载后 JVM 不会把它暴露给反射 API。这是默认值,也是最容易被忽略的一档——很多人自定义注解忘了显式标 RUNTIME,反射代码永远读不到。 - RUNTIME:写进 .class 文件的
RuntimeVisibleAnnotations属性,类加载后反射 API(isAnnotationPresent、getAnnotation等)才能读到。Spring 的 @Component、@Autowired、JPA 的 @Entity 全部是这一档。
2. 三档策略分别服务于谁
这三档不是随意设计的,而是精确对应三种不同的"读者":
| 档位 | 谁在读 | 典型场景 |
|---|---|---|
| SOURCE | 编译器、IDE、注解处理器 | @Override 静态检查、Lombok 的触发标记 |
| CLASS | 字节码分析工具、极少数框架自定义处理 | ASM/Javassist 静态扫描字节码做增强 |
| RUNTIME | JVM 反射 API | Spring、JPA、JUnit、Jackson 几乎所有注解驱动框架 |
选错档位是自定义注解最常见的事故源:把该用 RUNTIME 的注解写成默认的 CLASS,框架启动时"注解好像没生效",排查半天发现是漏了 @Retention(RetentionPolicy.RUNTIME)。
三、运行期解析:注解实例的真实身份是动态代理
1. Annotation 是接口,那实例从哪来
@interface 定义的其实是一个继承自 java.lang.annotation.Annotation 的特殊接口。你调用 field.getAnnotation(AuditLog.class) 拿到的对象,并不是某个具体类的实例——它是 JDK 用**Proxy.newProxyInstance**在运行期动态生成的代理对象,背后统一挂着一个内部类 AnnotationInvocationHandler。
这个 handler 内部就是一个 Map<String, Object>,key 是注解的属性名(比如 action、sensitive),value 是编译时写进 class 文件常量池的具体值。你调用 auditLog.action() 这个"看起来像方法调用"的操作,实际触发的是代理对象的 invoke,逻辑就是查一次 Map 再返回——注解方法调用的本质是查表,不是真正的方法执行。
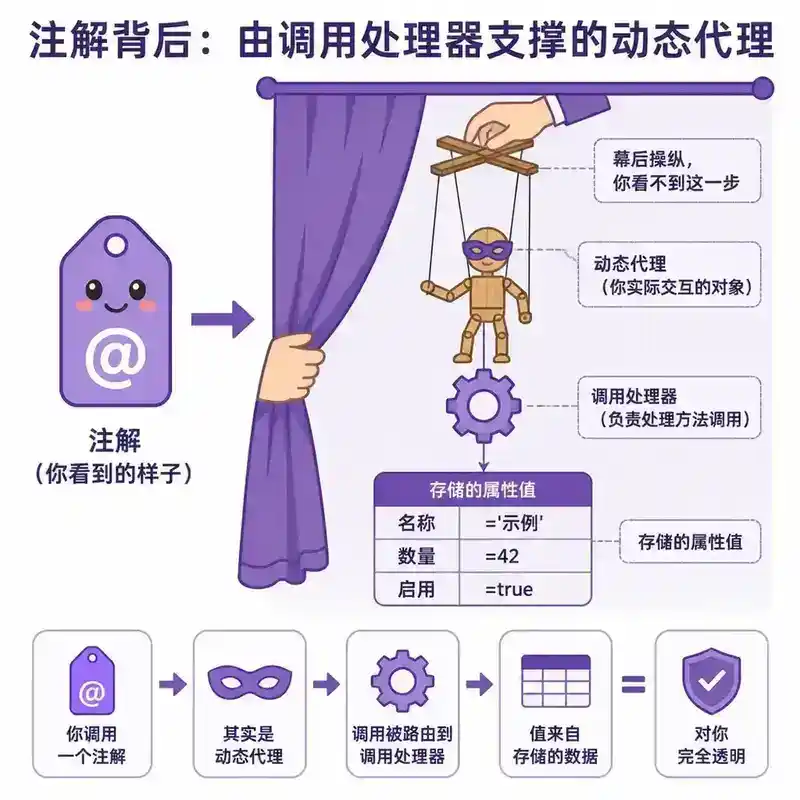
这解释了几个常见疑惑:
- 为什么注解的属性方法不能有方法体、不能抛异常(除了默认值的隐式行为)——它本来就不是"方法",是给编译器生成常量池条目、给代理对象生成取值键的元数据描述符;
- 为什么两个不同 Class 对象上拿到的同一个注解
equals判定看属性值而不看对象引用——因为 Annotation 接口规范强制要求 equals/hashCode 基于成员值计算,代理对象的 invoke 里已经实现好了这套逻辑; - 为什么注解不能被继承(不能写
@interface A extends B)——它是特殊接口,Java 单继承限制在这里被编译器直接锁死。
2. 读注解的四个 API,语义差异不能记混
clazz.isAnnotationPresent(Component.class);      // 是否存在(含 @Inherited 继承来的)
clazz.getAnnotation(Component.class);             // 取单个(含继承),没有返回 null
clazz.getDeclaredAnnotation(Component.class);      // 取单个(仅本类声明,不含继承)
clazz.getAnnotationsByType(Schedule.class);        // 取多个(自动拆 @Repeatable 容器)
框架代码的典型模式:先 isAnnotationPresent 判断存在性再 getAnnotation 取值,两次反射调用能合并成一次——getAnnotation 返回 null 就是不存在,没必要先判断再取。这是审查框架源码时能看出来的一个小优化点。
3. 元素级注解:TYPE_USE 打开的新战场
JDK 8 之前,注解只能标在"声明"上(类、方法、字段);ElementType.TYPE_USE 让注解可以标在类型使用的任意位置,包括泛型参数、类型转换、方法返回类型里:
List<@NonNull String> names;              // 泛型参数上
@Nullable String find(@NonNull Long id);  // 参数和返回类型上
这类注解本身不改变程序行为,但给静态分析工具(Checker Framework、IntelliJ 的空值检查)提供了细粒度的类型信息,是"用注解做类型系统扩展"的典型代表——比常规的 null 检查更早在编译期拦截问题。
四、编译期处理器:APT 怎么在你写代码时就把活干了
1. JSR 269:一套标准化的"编译期插件"接口
反射是运行期读注解,但还有一类注解从设计上就不打算活到运行期——它们的价值全部体现在编译阶段。JSR 269 定义的注解处理器(Annotation Processing Tool,APT)就是干这件事的标准机制:实现 javax.annotation.processing.Processor 接口(通常继承 AbstractProcessor),通过 @SupportedAnnotationTypes 声明关心哪些注解,编译器在编译过程中会主动把匹配的代码元素喂给你。
处理器拿到的三个核心工具:
- RoundEnvironment:本轮编译中所有被目标注解标记的元素集合;
- Filer:唯一合法的产出渠道,用来生成全新的 .java 源文件(不能修改已有文件,这是标准 APT 的能力边界);
- Messager:向编译器输出 ERROR/WARNING 级别的诊断信息,能让不合规的用法直接编译失败,比运行期抛异常提前发现问题一整个阶段。
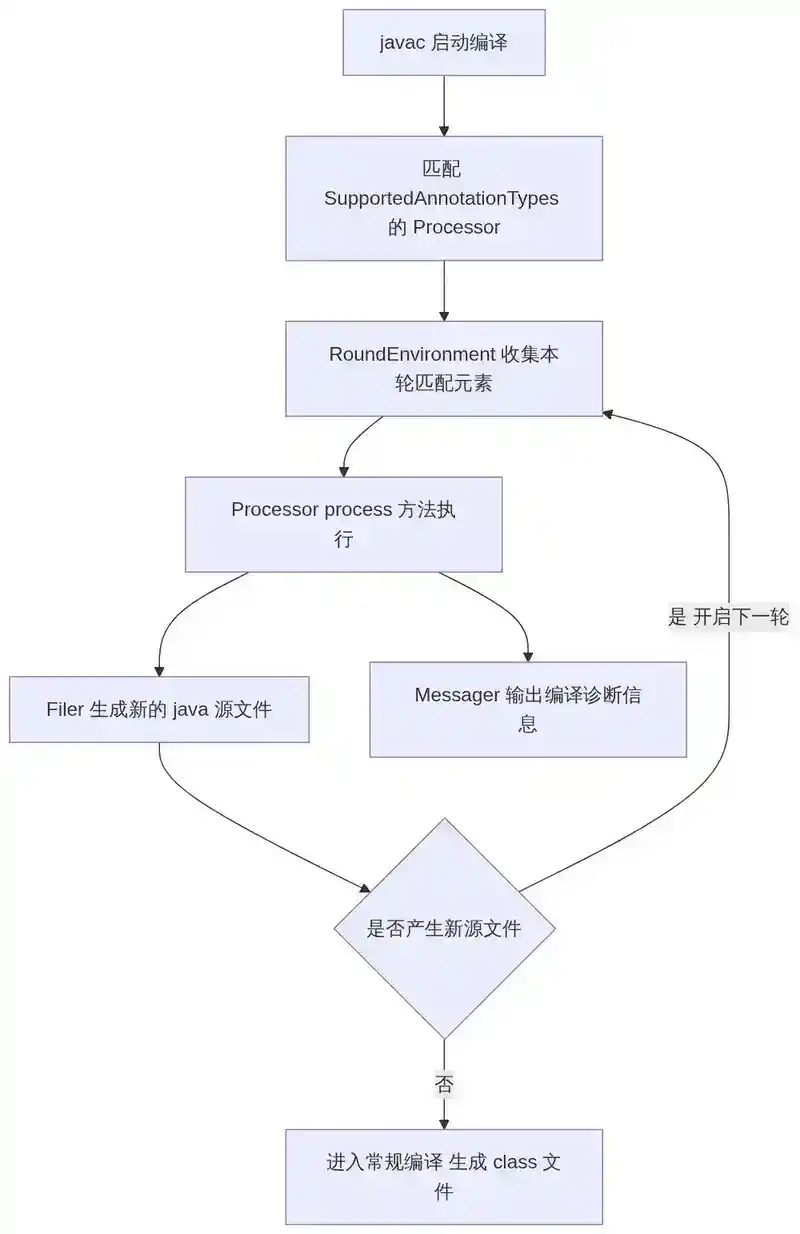
2. 编译是"轮次制"的,不是一次性的
一个容易被忽略的细节:APT 不是编译一次就完事。如果某一轮 Filer 生成了新的源文件,编译器会开启新一轮处理,把新文件也纳入扫描范围,直到没有新文件产生为止,才进入常规的字节码生成阶段。这个机制让处理器可以链式生成代码(A 处理器生成的代码里又带着 B 处理器关心的注解),但也意味着处理器逻辑必须是幂等和收敛的,否则会导致编译轮次爆炸甚至死循环。
3. AutoService:一个 60 秒能看懂的标准 APT 例子
Google Auto 库的 @AutoService 是理解标准 APT 最好的入门样本:标注一个类实现了某接口,编译期自动生成 META-INF/services/xxx 文件——本来需要手写的 SPI 配置文件,靠一个注解在编译期自动产出,ServiceLoader 加载时直接生效:
@AutoService(PaymentChannel.class)
public class AlipayChannel implements PaymentChannel { ... }

// 编译期自动生成 META-INF/services/com.demo.PaymentChannel
// 内容:com.demo.AlipayChannel
这正是"编译期把运行期该做的事提前做完"的价值:没有反射扫描、没有运行时开销,SPI 配置文件在打包前就已经写好。
五、当处理器不够用:Lombok 为什么是"作弊"
1. 标准 APT 的能力边界卡死了一类需求
标准 APT 只能新增文件,不能修改已有类——这条规则堵死了 Lombok 想做的事:@Getter、@Setter、@Data、@Builder 都要求"在你写的这个类里直接加方法",而不是生成一个新的辅助类。如果 Lombok 遵循标准 APT 规则,它只能生成一个 UserGetters.java 之类的外部类,那就完全不是 Lombok 好用的样子了。
2. Lombok 的真实做法:钻进编译器内部改 AST
Lombok 表面上注册成一个标准 Processor(挂在 javax.annotation.processing.Processor 的 SPI 机制上),但 process() 方法里干的事完全不标准:它反射拿到 javac 编译器内部的 AST(抽象语法树)实现类 com.sun.tools.javac.tree.JCTree,直接在树上插入新的方法节点,再触发编译器重新分析这棵被动过手的树。这不是标准 API 允许的操作,是绕过公开接口、依赖编译器内部实现细节的"寄生"。
代价也很明显:
- 每次 javac 内部 AST 结构调整(如 JDK 9 模块化、JDK 16+ 强封装收紧),Lombok 都要跟着适配,历史上多次出现"升级 JDK 后 Lombok 编译失败";
- IDE 要单独装插件才能"理解"这些凭空出现的方法,否则会显示一堆红色报错;
- 它是编译器实现细节的强耦合者,而不是标准生态的公民。
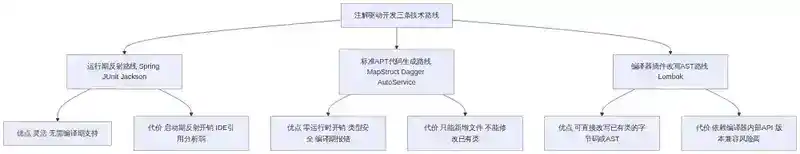
3. 三条路线怎么选,一张表说清楚
| 路线 | 代表 | 运行时开销 | 能否改已有类 | 生态兼容性 |
|---|---|---|---|---|
| 运行期反射 | Spring、JUnit、Jackson | 有(查找+调用) | 不涉及(运行期决策) | 最好,跟编译器版本弱耦合 |
| 标准 APT 生成新文件 | MapStruct、Dagger、AutoService | 无 | 不能 | 好,遵循公开 SPI 机制 |
| 编译器插件改 AST | Lombok | 无 | 能 | 差,绑定编译器内部实现 |
决策上的经验规则:只是要框架在启动期做点动态装配 → 反射;要类型安全、零运行时开销、能接受"生成额外文件"→ 标准 APT;非要精简已有类的样板代码不可 → 认清 Lombok 的耦合代价再用。
六、动手:写一个标准 APT 处理器,生成 Builder 代码
用一个精简例子把"元注解定义 → APT 扫描 → Filer 生成新文件"串起来。自定义 @GenBuilder 标在类上,编译期自动生成一个链式 Builder 类:
// 1. 定义注解,SOURCE 即可——只给编译器用,运行期没有意义
@Retention(RetentionPolicy.SOURCE)
@Target(ElementType.TYPE)
public @interface GenBuilder { }

// 2. 处理器:继承 AbstractProcessor
@SupportedAnnotationTypes("com.demo.GenBuilder")
@SupportedSourceVersion(SourceVersion.RELEASE_17)
public class BuilderProcessor extends AbstractProcessor {

    @Override
    public boolean process(Set<? extends TypeElement> annotations, RoundEnvironment env) {
        for (Element el : env.getElementsAnnotatedWith(GenBuilder.class)) {
            TypeElement type = (TypeElement) el;
            String className = type.getSimpleName() + "Builder";
            try {
                // Filer 是标准 APT 唯一合法的产出渠道
                JavaFileObject file = processingEnv.getFiler()
                    .createSourceFile(type.getQualifiedName() + "Builder");
                try (Writer w = file.openWriter()) {
                    w.write("public class " + className + " {\n");
                    w.write("    // 按字段生成 withXxx 方法,此处省略字段遍历细节\n");
                    w.write("}\n");
                }
            } catch (IOException e) {
                // Messager 把问题提前到编译期报出来,而不是等运行时炸
                processingEnv.getMessager().printMessage(Diagnostic.Kind.ERROR,
                    "生成 Builder 失败: " + e.getMessage(), el);
            }
        }
        return true; // true 表示这些注解已被本处理器"认领",不再交给其他处理器
    }
}

// 3. 通过 SPI 注册处理器,编译器才会调用它
// META-INF/services/javax.annotation.processing.Processor
// 内容:com.demo.BuilderProcessor
这 30 行覆盖了标准 APT 的全部要素:@SupportedAnnotationTypes 声明关心什么、RoundEnvironment 拿到匹配元素、Filer 产出新文件、Messager 做编译期诊断、SPI 文件完成注册。真实项目中 MapStruct、Dagger 的核心骨架就是这个模式的复杂化版本——多的是对类型信息、依赖图的分析,而不是流程本身。
七、串回 Spring:注解怎么和上一篇的反射接上
回到 010 反射篇留下的那句话:注解只是元数据,反射让它生效。放进 Spring 的实际链路看会更具体:

- 组件扫描:Spring 用 ASM 或反射批量读取 classpath 下类的
RuntimeVisibleAnnotations属性,找出标了 @Component(及其派生的 @Service、@Repository、@Controller)的类,注册成 BeanDefinition; - 实例化:反射调用构造器
newInstance,如果有多个构造器则靠 @Autowired 标在构造器上决定用哪个; - 依赖注入:反射遍历字段/方法,找到标了 @Autowired 的成员,从容器取到依赖后用
field.set硬塞进去(哪怕是 private 字段,setAccessible(true)已经开了口子); - 生命周期回调:反射调用标了 @PostConstruct 的方法,完成初始化。
四步全是反射在执行,注解在每一步只回答一个问题——"这个类/字段/方法要不要被特殊处理"。这也是为什么 Spring 6 的 AOT 引擎要在构建期把这套决策提前算好、生成等价的普通 Java 代码:不是注解不重要了,是"运行期用反射读注解再决策"这件事本身,在启动速度敏感的场景(如 native image)里变成了负担——这条思路和 010 篇讲的 AOT/反射矛盾完全一致,只是这次矛头指向了"读注解的方式",而不是反射本身。
八、小结
注解机制的知识骨架压缩成四句话:
- 规则层:@Target/@Retention/@Documented/@Inherited 四个元注解决定一个自定义注解能标在哪、活多久、进不进文档、能不能被子类继承,@Repeatable 靠编译器悄悄生成容器注解实现"重复标注";
- 存在形式:RetentionPolicy 决定注解能走到哪一步——SOURCE 编译后消失,CLASS 进字节码但反射读不到,RUNTIME 才能被反射 API 看见,默认值是最容易踩的坑(CLASS,不是 RUNTIME);
- 运行期身份:反射拿到的注解实例本质是 JDK 动态生成的代理对象,背后是一个存值用的 Map,调用属性方法等价于查表,不是真正的方法执行;
- 处理路线:除了运行期反射,还有标准 APT(编译期生成新文件,零运行时开销,如 MapStruct/AutoService)和编译器插件(直接改写已有类的 AST,如 Lombok,能力更强但深度耦合编译器内部实现)——三条路线没有绝对的优劣,只有代价和收益的不同分配方式。
提问与回答(面试追问模拟,不计入阅读时长)
Q1:自定义注解不写 @Retention 会怎样?
A:默认是 RetentionPolicy.CLASS——会写进 .class 文件的常量池,但类加载后 JVM 不会把它暴露给反射 API,getAnnotation 永远拿到 null。很多人误以为默认是 RUNTIME,这是自定义注解"反射读不到"最常见的原因,必须显式写 @Retention(RetentionPolicy.RUNTIME) 才能被反射读取。
Q2:反射拿到的注解对象到底是什么?
A:是 JDK 用 Proxy.newProxyInstance 在运行期动态生成的代理对象,背后统一挂着内部类 AnnotationInvocationHandler,本质是一个存属性值的 Map<String, Object>。调用注解的属性方法(如 auditLog.action())触发的是代理的 invoke,逻辑是查表返回,不是真正执行了一段方法体。
Q3:@Inherited 为什么"看起来生效了却没生效"?
A:三个限制最容易被忽略:只对类级注解生效(方法、字段上无效);只影响 getAnnotation,不影响 getDeclaredAnnotation;接口上的注解永远不会被实现类继承。排查时先确认注解是标在类上还是方法/字段上,再确认调用的是哪个 API。
Q4:@Repeatable 的底层实现是什么?
A:编译器悄悄生成一个容器注解,把多次标注的同名注解打包成数组塞进容器里,字节码层面实际只有一个容器注解实例。反射读取要用 getAnnotationsByType(自动拆包),如果用 getAnnotation 只会拿到容器注解本身或者 null,这是最容易踩的 API 选型坑。
Q5:注解处理器(APT)和反射处理注解,本质区别是什么?
A:反射是运行期决策——程序跑起来之后才去读注解、决定行为,有查找和调用的开销;APT 是编译期决策——Filer 在编译阶段直接生成新的 .java 源文件,运行时该做的判断在编译时就已经落地成普通代码,零运行时开销,但只能新增文件,不能修改已有类。
Q6:Lombok 是标准的注解处理器吗?
A:表面上遵循 Processor 接口的 SPI 注册机制,但 process() 内部反射拿到 javac 编译器内部的 AST 实现类(com.sun.tools.javac.tree.JCTree),直接在语法树上插入新方法节点——这不是标准 APT 允许的操作,是绕过公开接口、依赖编译器内部实现细节的做法,所以每次 javac 内部结构调整(模块化、强封装收紧)都可能导致 Lombok 需要跟着适配。
Q7:APT 处理是一次性的还是多轮的?
A:多轮。如果某一轮 Filer 生成了新源文件,编译器会把新文件也纳入扫描范围开启下一轮处理,直到没有新文件产生才进入常规字节码生成阶段。这让处理器可以链式生成代码,但也要求处理器逻辑收敛,否则会导致编译轮次异常增多。
Q8:ElementType.TYPE_USE 解决了什么问题?
A:JDK 8 之前注解只能标在类、方法、字段等"声明"位置;TYPE_USE 让注解可以标在类型被使用的任意地方(泛型参数、方法参数类型、返回类型、类型转换),配合 Checker Framework 之类的静态分析工具做更细粒度的类型系统扩展(比如编译期空值检查),本身不改变程序运行行为。
Q9:Spring 用注解读到的信息,最终是怎么落地成一个可用 Bean 的?
A:组件扫描阶段用反射/ASM 读取类的 RuntimeVisibleAnnotations 找到 @Component 类并注册 BeanDefinition;实例化阶段反射调用构造器;依赖注入阶段反射遍历 @Autowired 标注的成员并 field.set 注入;生命周期阶段反射调用 @PostConstruct 方法。四步全靠反射执行,注解只在每一步回答"要不要特殊处理"。
Q10:三条注解处理路线(反射、标准 APT、Lombok 式编译器插件),该怎么选?
A:只是要框架在启动期做动态装配,直接用反射,生态兼容性最好;要类型安全、零运行时开销、能接受生成额外辅助类,用标准 APT(如 MapStruct);非要精简已有类本身的样板代码不可,才考虑 Lombok 式方案,但要清楚它绑定的是编译器内部实现,需要承担版本升级时的适配风险。