覆盖考点:015|Java 新版本特性:record、sealed class、模式匹配、文本块与虚拟线程概览
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:35–40 分钟(文末问答不计入)
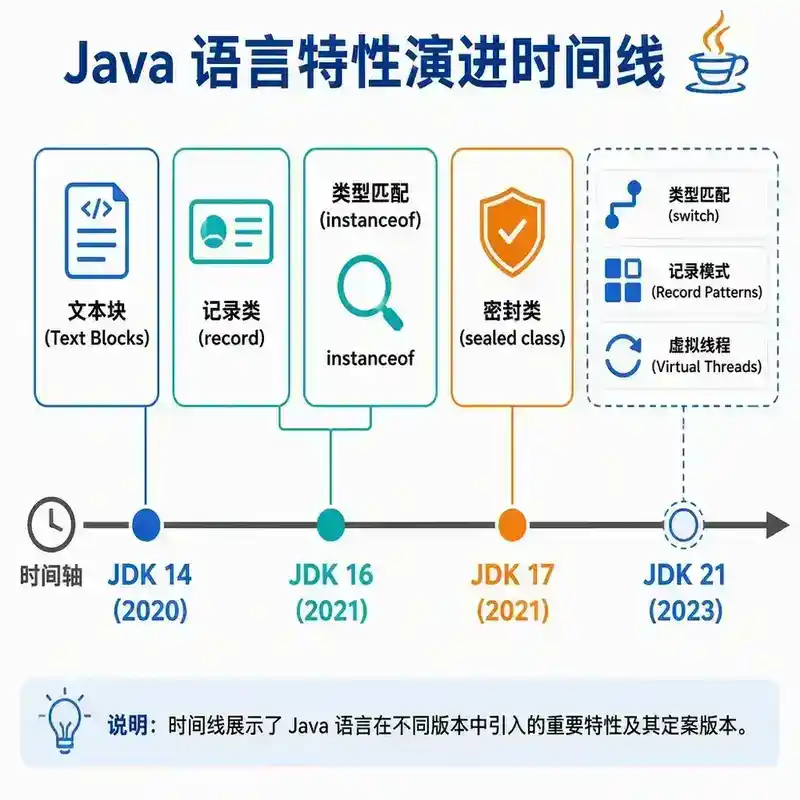
Java 8 之后有很长一段时间,语言层面的存在感主要靠 Stream 和 Lambda 撑着。但从 JDK 14 到 21,语言组连续交出了五份关联很强的答卷:record 消灭数据类的样板代码,sealed class 把"这个类型可能是谁"从文档约定变成编译器可验证的事实,模式匹配把"判断类型再强转"这套固定动作变成一条声明式表达式,文本块解决了多行字符串写起来像转义符地狱的老问题,虚拟线程则从根子上改变了"一个请求占一个线程"的经济学。这五个特性表面上分散在不同 JEP 里,实际上都在回答同一个问题:怎么让代码更直接地表达意图,把"怎么做"的重复劳动交还给编译器和运行时。
面试官问到这一考点,通常不是要你背 JEP 编号,而是想确认三件事:你是否真的在生产代码里用过这些特性、你是否理解它们解决的具体痛点、你是否知道它们彼此之间如何配合(尤其是 sealed + 模式匹配 + record pattern 这条组合)。本文按这个顺序展开,虚拟线程作为并发模型的概览收尾,为后续单独展开的考点(050)打个基础。
一、record:数据类的样板代码终结者
1. 问题:一个 DTO 要写多少行没有信息量的代码
在 record 出现之前,一个"只是装数据"的类,字段、构造器、getter、equals/hashCode/toString 全部要手写或靠 IDE 生成。这些代码有一个共同特点:看一眼字段声明就能百分百猜出剩下几十行长什么样——但 Java 编译器不会替你省略它们,你得自己写、自己维护、每加一个字段就要记得同步改五个地方。这不是设计缺陷,而是 Java 早期"什么都要显式声明"的哲学在数据建模场景里逐渐显得笨重。
2. record 生成了什么:编译器的隐式契约
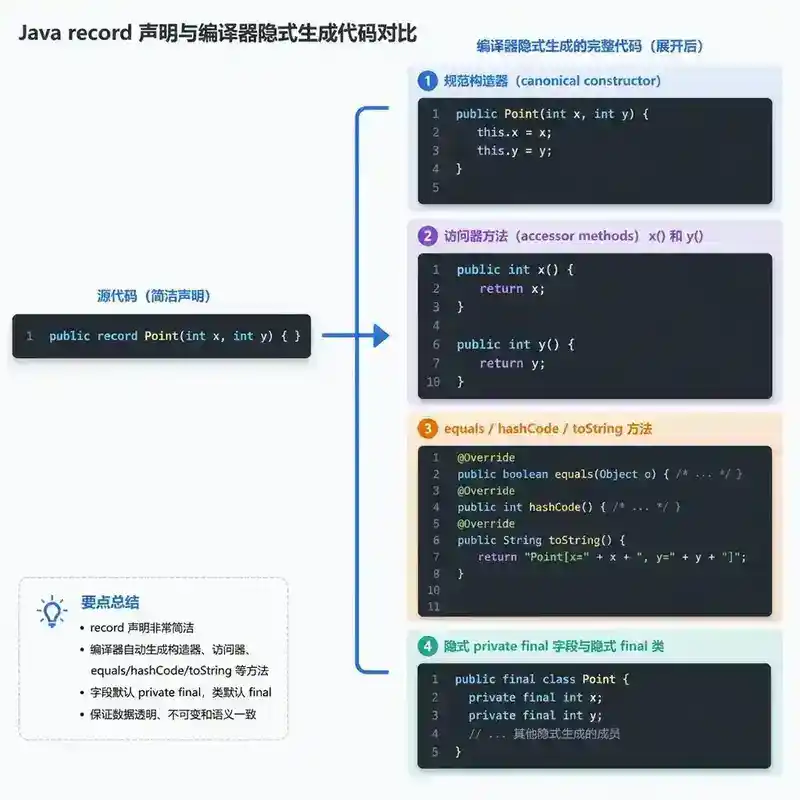
public record Point(int x, int y) { }
这一行背后,编译器自动生成:
- 一个规范构造器(canonical constructor),参数顺序与声明顺序一致;
- 每个字段一个访问器方法,方法名直接是字段名(
x()、y()),不是getX(); - 基于全部字段实现的
equals()、hashCode()、toString(); - 字段隐式
private final,record 本身隐式final,不能被继承。
record 不是新的关键字糖衣那么简单,它在类文件里带有真正的语言级标记:Class.isRecord() 为 true,getRecordComponents() 能拿到组件信息——这也是它后面能被模式匹配"解构"的基础,普通类做不到这一点。
3. 深入:record 不是"没有行为"的贫血对象
record 只是限制了状态的表示方式(不可变、由声明的组件决定 equals/hashCode),并不限制行为。你可以加普通方法、静态方法、静态字段,还可以用紧凑构造器(compact constructor)在不重复参数列表的前提下插入校验逻辑:
public record Range(int min, int max) {
    public Range {                       // 紧凑构造器:不写参数列表
        if (min > max) {
            throw new IllegalArgumentException("min > max");
        }
    }
    public int length() { return max - min; }
}
几个容易被面试问到的边界:
- record 可以实现接口,但不能继承其他类(它已经隐式继承了
Record); - 如果自定义了非规范构造器,必须显式委托给规范构造器(
this(...)),不能绕过; - 局部 record(方法内部定义)在 JDK 16 随普通 record 一起定案,常用于在 Stream 管道里临时组装多字段的中间结果,替代过去用
Map.Entry或匿名类硬凑的写法; - record 天生适合做不可变值对象,但如果字段本身是可变类型(如数组、
List),record 的"不可变"只是浅层的——这是生产代码里最容易踩的坑,需要在紧凑构造器里做防御性拷贝。
二、sealed class:把继承关系数量化
1. 问题:接口的实现者你数不过来
一个 interface Shape 可以被任意代码、任意模块实现。这在写库的时候是优点(开放扩展),但在建模"业务上封闭的一组可能性"时是缺点:你写 if (shape instanceof Circle) ... else if (shape instanceof Square) ...,永远不知道有没有漏掉第三种实现——因为语言层面根本不知道"总共有几种"。
2. sealed 语法与三种子类型状态
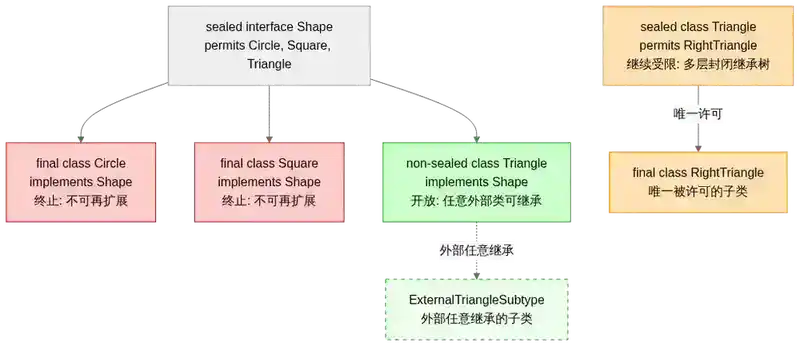
public sealed interface Shape permits Circle, Square, Triangle { }

public final class Circle implements Shape { double radius; }
public final class Square implements Shape { double side; }
public non-sealed class Triangle implements Shape { double base, height; }
sealed 类/接口必须用 permits 显式列出全部直接子类型(如果子类型与父类型在同一个文件里,permits 可省略,编译器自动推断)。每个直接子类型必须明确声明自己是以下三种状态之一:
| 子类型修饰符 | 含义 |
|---|---|
final |
继承链到此终止,不能再被扩展 |
sealed |
继续限制自己的子类型,形成多层受限继承树 |
non-sealed |
主动打开这个分支,允许任意外部代码继承 |
这个"必须表态"的设计很关键:它逼着你在每一层继承上做出明确的开放/封闭决策,而不是靠隐式的默认行为。
3. 深入:sealed + 模式匹配的联动价值——穷尽性检查
sealed 单独用只是"更严格的继承声明",真正的收益要和模式匹配一起看:
double area(Shape shape) {
    return switch (shape) {
        case Circle c   -> Math.PI * c.radius() * c.radius();
        case Square s   -> s.side() * s.side();
        case Triangle t -> 0.5 * t.base() * t.height();
        // 没有 default,编译器仍然通过——因为它知道 Shape 只有这三种可能
    };
}
因为编译器知道 Shape 封闭在三个子类型内,switch 表达式不需要**default**分支就能通过穷尽性检查(exhaustiveness check)。这对长期维护的价值是:如果后续给 Shape 加了第四种实现 Rectangle,这段代码会编译失败,而不是在运行时悄悄走到一个被遗漏的分支。这是 sealed 相对于普通接口 + instanceof 链最大的工程价值——把"新增子类型时忘记同步分支"从运行时 bug 提前到编译错误。
三、模式匹配:从"手动拆箱"到"声明式匹配"
模式匹配不是一次性交付的,而是分三个 JEP、跨越 JDK 16 到 21 逐步落地的,理解这条演进链比记住某一个语法更重要。
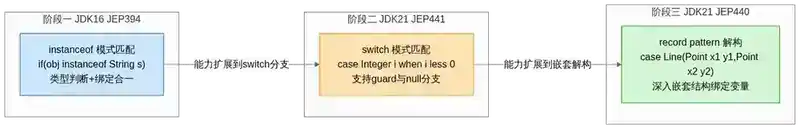
1. instanceof 模式匹配(JEP 394,JDK 16 定案)
以前:
if (obj instanceof String) {
    String s = (String) obj;   // 手动强转,样板代码
    ...
}
之后:
if (obj instanceof String s) {   // 匹配成功后,s 在作用域内直接可用
    ...
}
instanceof 在判断类型的同一时刻完成绑定,s 的作用域受编译器的流敏感分析(flow scoping)控制——例如 if (!(obj instanceof String s)) return; // 这里往后 s 可用,编译器能推断出走到后面时 obj 一定是 String。
2. switch 模式匹配(JEP 441,JDK 21 定案)
在 switch 里可以直接用类型模式,还能加 when 子句做守卫条件(guarded pattern),并且原生支持 null 分支:
String describe(Object obj) {
    return switch (obj) {
        case null              -> "null 值";
        case Integer i when i < 0 -> "负数";
        case Integer i             -> "非负整数";
        case String s when s.isBlank() -> "空字符串";
        case String s               -> "字符串: " + s;
        default -> "其他类型";
    };
}
case null 是一个重要的语义变化:老式 switch 遇到 null 会直接抛 NullPointerException,新语法要求你显式处理 null(或者接受运行时仍然抛异常,如果你没写 case null 且值恰好是 null)。when 守卫条件的匹配顺序是从上到下,一旦某个 case 的类型匹配且守卫条件为真就命中,因此模式的排列顺序本身就是业务逻辑的一部分,写反顺序是常见 bug 源。
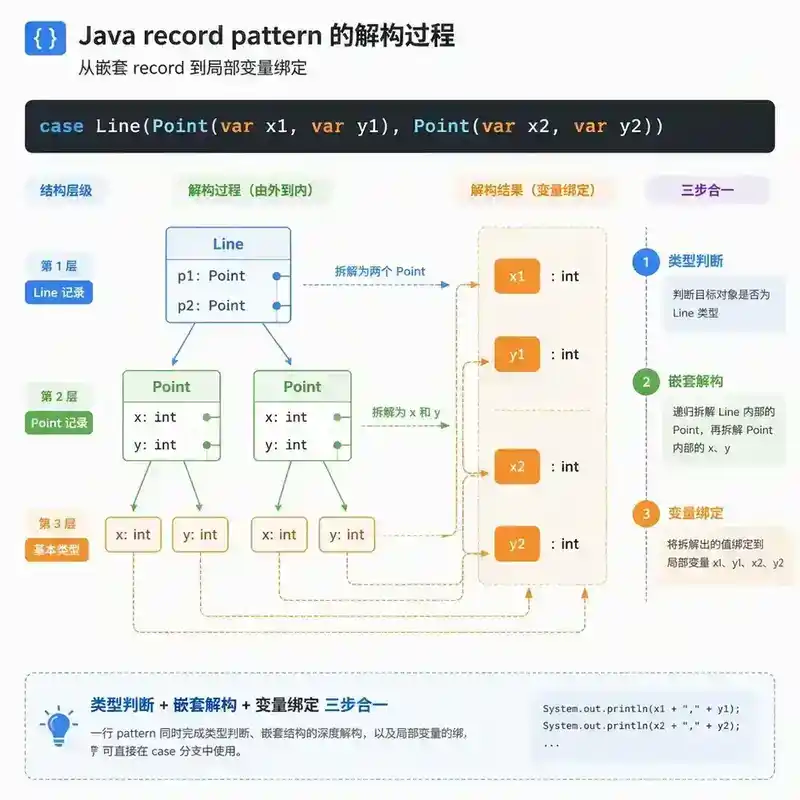
3. record pattern(JEP 440,JDK 21 定案):解构嵌套结构
这是与 record 组件信息直接挂钩的能力——模式匹配可以深入 record 内部,把字段"解构"到局部变量:
record Point(int x, int y) { }
record Line(Point start, Point end) { }

String classify(Object obj) {
    return switch (obj) {
        case Line(Point(var x1, var y1), Point(var x2, var y2)) when x1 == x2 ->
            "垂直线,x=" + x1;
        case Line(Point p1, Point p2) ->
            "普通线段: " + p1 + " -> " + p2;
        default -> "不是线段";
    };
}
一行 case Line(Point(var x1, var y1), Point(var x2, var y2)) 同时完成了:类型判断(是不是 Line)、嵌套解构(内部两个 Point 各自的 x、y)、变量绑定。这在处理树形/嵌套数据结构(AST、协议报文、领域对象)时能显著减少手动 getXxx().getYyy() 的链式调用。
四、文本块:多行字符串的书写方式变了
1. 语法与增量空白剥离规则
String json = """
    {
      "name": "Alice",
      "age": 30
    }
    """;
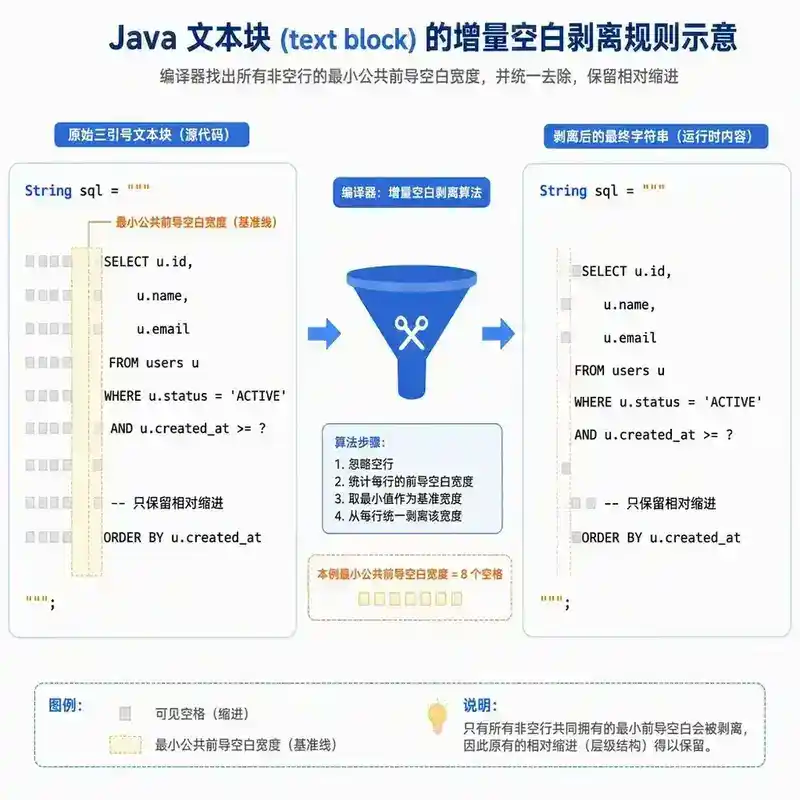
三个双引号开启的文本块,内容里不需要 \n 拼接、不需要为每行加 \" 转义。但它不是简单地把三引号之间原样保留——编译器会执行一套增量空白剥离(incidental whitespace stripping)算法:找出所有非空行(以及结尾分隔符所在行)里最小的公共前导空白宽度,把它从每一行中统一去掉,只保留"相对缩进"。这就是为什么你可以按代码块的缩进习惯去写文本块,而不用担心左侧多出一截无意义的空白被带进字符串里。
2. 转义序列:续行符、显式空格与普通转义
- 行末加反斜杠
\:表示不换行,把下一行拼接到当前行(常用于把逾期过长的一行拆成多行写但语义上不产生换行符); \s:表示一个显式的空格,专门用来对抗编辑器/格式化工具自动清除行尾空白的问题——你想要的尾部空格如果直接打空格容易被工具吃掉,用\s更保险;- 普通转义序列(
\n、\"、\\等)在文本块里依然有效,但三个双引号本身不需要转义。
文本块的实际价值不止是"少打转义符",它让SQL 语句、JSON 样例、正则表达式这类本身就是多行结构化文本的内容,在代码里保持自己原本的排版,Review 的时候更容易一眼看出格式对不对。
五、虚拟线程:并发模型的底层转变(概览)
虚拟线程(JEP 444,JDK 21 定案,来自 Project Loom)和前面四个特性不是一类东西——它不是语法糖,而是并发编程模型的底层调整。这里先建立整体认识,实现细节、pinning 排查、结构化并发放在专门的考点(050)里展开。
1. 问题:平台线程为什么"贵"
JDK 里传统的 Thread 是平台线程(platform thread),和操作系统线程 1:1 绑定。每个平台线程要占用固定的栈内存(默认通常是 512KB–1MB),创建和上下文切换要经过内核调度。当你的服务模型是"一个请求占一个线程、线程阻塞在 IO 上等结果"(thread-per-request),并发请求数一旦冲到几千甚至上万,光是线程本身的内存和调度开销就先把机器压垮了——这也是为什么过去大规模高并发场景往往要转向 Reactor/异步回调模型,用少量线程处理海量连接,但代价是代码变成回调地狱,调试栈也变得支离破碎。
2. M:N 调度模型:虚拟线程如何"挂载"到平台线程上
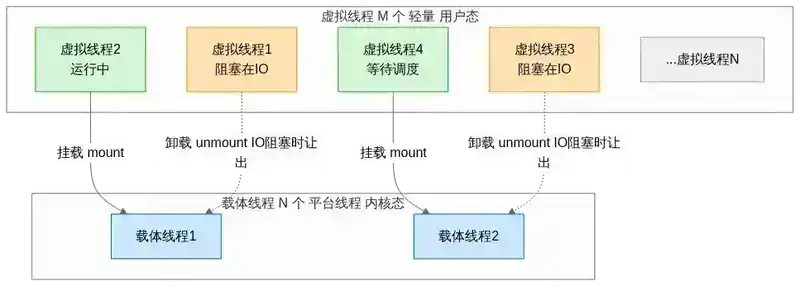
虚拟线程是 JVM 层面实现的用户态线程,本身极轻量(初始栈几百字节量级,按需增长),由 JVM 的调度器把大量虚拟线程映射到少量平台线程(称为载体线程,carrier thread)上执行,这是经典的 M:N 调度:M 个虚拟线程复用 N 个平台线程。
关键机制是挂载/卸载(mount/unmount):虚拟线程执行到阻塞式 IO 调用(如 Socket.read())时,JVM 会把它从载体线程上卸载下来,载体线程立刻可以去执行别的虚拟线程;等 IO 就绪,虚拟线程再被挂载到某个空闲的载体线程上继续执行。这一切对写代码的人是透明的——你依然写同步阻塞风格的代码(InputStream.read()、ReentrantLock.lock() 这种看起来"卡住线程"的调用),JVM 在背后偷偷做了协作式调度,不需要你改写成异步回调。
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    for (int i = 0; i < 100_000; i++) {
        executor.submit(() -> {
            // 依然是同步阻塞写法,JVM 负责挂载/卸载
            String result = callRemoteService();
            process(result);
        });
    }
}
十万个任务,十万个虚拟线程,代码写法和写平台线程池几乎一样,但内存和调度开销完全不是一个量级。
3. pinning:虚拟线程"卸载不下来"的场景
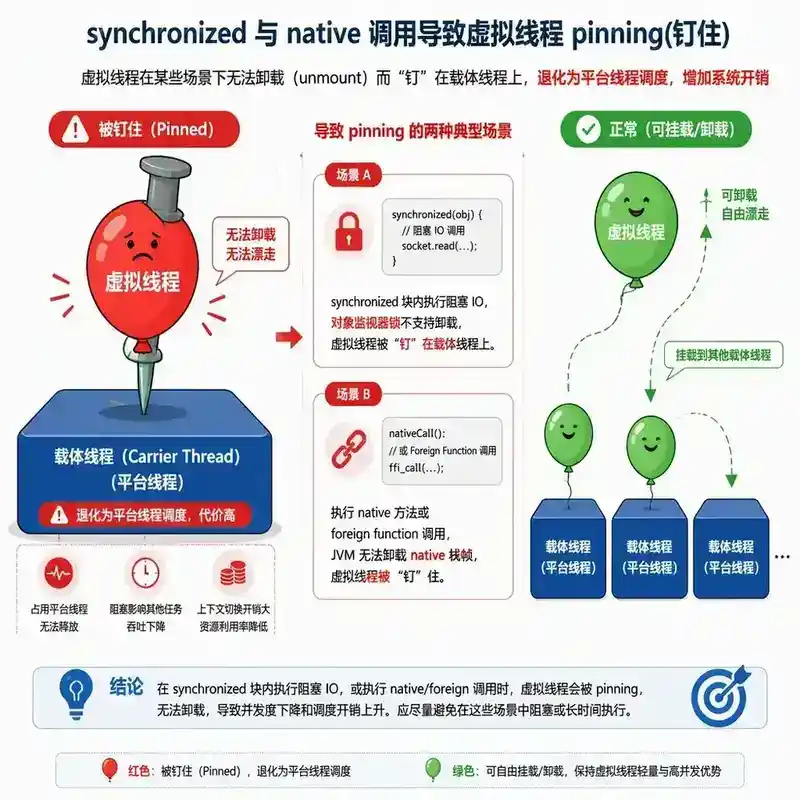
M:N 调度依赖"能随时把虚拟线程从载体线程上摘下来",但有两种情况会导致虚拟线程被钉住(pinned)在载体线程上,此时它退化成和平台线程一样的调度代价:
- 在
synchronized块/方法内部执行阻塞操作——synchronized是基于对象监视器的锁,JVM 目前无法在持锁期间安全地卸载虚拟线程(ReentrantLock等基于java.util.concurrent的锁没有这个问题,它们是虚拟线程感知的); - 执行native 方法或foreign function调用期间——JVM 无法卸载正在执行 native 栈帧的虚拟线程。
生产上的直接影响:如果代码里大量使用 synchronized 包裹阻塞 IO(老代码库很常见),换成虚拟线程池未必能拿到预期的吞吐提升,反而可能因为载体线程被大量钉住而出现新的瓶颈。排查思路是用 jcmd <pid> Thread.dump_to_file 看虚拟线程的挂载状态,或者直接把热点路径的 synchronized 替换成 ReentrantLock。
4. 适用边界:虚拟线程解决的是哪类问题
虚拟线程的目标场景很明确:IO 密集、高并发、thread-per-request 的服务端应用——每个任务大部分时间在等 IO,很少占用 CPU。它不是用来加速 CPU 密集型计算的,对于矩阵运算、压缩、加密这类持续吃 CPU 的任务,虚拟线程和平台线程没有本质区别(甚至因为调度层多了一层,可能还有轻微额外开销),这类场景该用的仍然是 ForkJoinPool 的工作窃取模型去做并行计算。一句话记忆:虚拟线程扩展的是"能同时挂起等待的任务数",不是"CPU 能同时算的任务数"。
六、面试追问链
| 追问角度 | 典型问题 |
|---|---|
| 原理 | record 的 equals/hashCode 是基于哪些字段生成的?能不能覆盖? |
| 边界 | sealed 的子类型必须在同一个模块/包里吗? |
| 组合使用 | 为什么 sealed + switch 模式匹配能去掉 default 分支还编译通过? |
| 细节陷阱 | 文本块里如果我确实想在行尾保留空格,应该怎么写? |
| 并发本质 | 虚拟线程为什么不能提升 CPU 密集型任务的吞吐? |
| 故障排查 | 什么情况会导致虚拟线程被 pinning,怎么发现? |
延伸阅读
- JEP 395:Record
- JEP 409:Sealed Classes
- JEP 394:Pattern Matching for instanceof
- JEP 441:Pattern Matching for switch
- JEP 440:Record Patterns
- JEP 378:Text Blocks
- JEP 444:Virtual Threads
问答(不计入阅读时长)
Q1:record 的 equals/hashCode 是基于哪些字段生成的?能不能覆盖?
A:基于全部声明的组件字段生成——equals() 按声明顺序逐个比较每个字段(引用类型用 Objects.equals 语义,基本类型直接比较值),hashCode() 是全部字段哈希值的组合。这两个方法都可以显式覆盖:record 允许你在类体里重写 equals、hashCode、toString,写了就用你自己的实现,编译器不会强制用默认生成版本。覆盖时最容易踩的坑是只重写了 equals 却没同步重写 hashCode,破坏了"相等的对象必须有相同 hashCode"的基本契约,导致这个 record 放进 HashSet/HashMap 后出现查不到、去不重的怪问题。
Q2:sealed 的子类型必须在同一个模块/包里吗?
A:分两种情况。如果 sealed 类型和它的 permits 子类型都在同一个具名模块内,子类型可以分布在该模块下的任意包;如果代码跑在未命名模块(没有 module-info.java 的普通项目,大多数教学示例和不少实际项目都是这种),子类型就必须和 sealed 类型在同一个包下。这条限制不是随意加的:它保证了 sealed 类型声明的"总共有哪几种可能"在编译期是完全可核实的——如果子类型能跑到任意模块任意包,编译器就无法保证 permits 列表之外真的没有别的实现,穷尽性检查也就失去了意义。
Q3:为什么 sealed + switch 模式匹配能去掉 default 分支还编译通过?
A:因为编译器手里握着 sealed 类型完整且封闭的继承清单。做穷尽性检查时,编译器会拿 switch 里所有 case 分支的类型集合,去对比 permits 列表里的全部直接子类型——如果某个子类型本身又是 sealed,编译器会递归展开检查它自己的子类型是否也被覆盖完。只要能在编译期证明"所有可能出现的运行时类型都有对应分支",就不需要 default 兜底。普通 interface 做不到这一点:没有 permits 清单,任何外部代码随时可能新增一个实现类,编译器无法排除"漏了一种没写"的可能,所以普通接口的 switch 必须靠 default 或抛异常收尾。
Q4:文本块里如果我确实想在行尾保留空格,应该怎么写?
A:用 \s 转义序列,而不是直接敲空格。原因是很多 IDE、代码格式化工具、Git 的行尾清理规则会自动删掉"看起来毫无意义"的行尾空格——如果你直接打空格,存盘或提交时很可能被工具悄悄吃掉。\s 在编译期会被解析成一个真正的空格字符,但因为它是一个显式的转义写法,不是"看不出意图"的裸空格,格式化工具不会把它误判为可清理的尾随空白,所以能可靠地保留下来。
Q5:虚拟线程为什么不能提升 CPU 密集型任务的吞吐?
A:虚拟线程解决的是"线程数量太多、内存和调度开销太大"的问题,它扩展的是"能同时挂起等待的任务数",不是"CPU 能同时算的任务数"。CPU 密集型任务的瓶颈根本不在"能开多少线程去等",而在"有几个物理核心能同时执行指令"。载体线程的数量通常和 CPU 核心数挂钩(默认接近 Runtime.availableProcessors());如果任务本身几乎不阻塞(纯计算),虚拟线程几乎没有机会被卸载,大量虚拟线程最终还是要排队抢为数不多的载体线程和 CPU 核心,和直接用平台线程池提交同样多任务相比没有本质差别——甚至因为多了一层挂载/卸载调度逻辑,可能还有轻微的额外开销。这类场景该用的是 ForkJoinPool 的工作窃取模型做并行计算,虚拟线程不是对症的药。
Q6:什么情况会导致虚拟线程被 pinning,怎么发现?
A:两种场景会导致 pinning:一是在 synchronized 块/方法内部执行阻塞操作——synchronized 基于对象监视器锁,JVM 目前的实现无法在持锁期间安全地把虚拟线程从载体线程上卸载;二是执行 native 方法或 foreign function 调用期间,JVM 无法卸载正在执行 native 栈帧的虚拟线程。排查手段:用 jcmd <pid> Thread.dump_to_file 生成的线程 dump 里能看到虚拟线程是否处于 pinned 状态;JDK 21 起也可以打开 JFR 的 jdk.VirtualThreadPinned 事件,持续采集生产环境里 pinning 实际发生的频率和位置,不需要每次靠人工 dump 去撞。规避思路是把热点路径上的 synchronized 替换成 java.util.concurrent.locks.ReentrantLock 等虚拟线程感知的同步工具。
Q7:record 可以被继承吗?为什么不能像普通类一样 extends?
A:不能。record 隐式继承了 java.lang.Record 这个抽象类,Java 不支持多继承,所以 record 不能再 extends 别的类;record 本身也隐式是 final 的,不能被其他类继承。这个限制是设计上有意为之,不是实现疏漏——record 被定位为"透明的数据载体",它的语义契约(equals/hashCode/toString 完全由声明的组件决定)一旦允许被继承或继承别的类,这个契约就很容易被子类打破,"看一眼组件就知道整个对象长什么样"的保证也就不成立了。record 仍然可以 implements 接口——接口不携带状态,不会破坏这份契约。
Q8:用了模式匹配之后,原来判断类型用的 instanceof 还有必要保留吗?
A:有必要,两者是场景互补,不是替代关系。instanceof 模式匹配(if (obj instanceof String s))适合"只有一到两种类型需要处理,不需要走完整分支结构"的简单判断,写法更轻量、上下文切换成本低;switch 模式匹配和 record pattern 适合"类型分支较多、需要编译器帮你做穷尽性检查、或者需要解构嵌套结构"的场景。日常代码里这两种写法会长期混用,选哪个取决于当前判断逻辑的复杂度,不存在谁淘汰谁的问题。