覆盖考点:012|Java SPI:ServiceLoader 原理、类加载上下文与扩展机制设计
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:38–40 分钟(文末问答不计入)
写代码最朴素的做法是"要用谁就 new 谁"——调用方的代码里直接依赖某个具体实现类。这样写没问题,直到某天要换一个实现:也许是把本地文件存储换成对象存储,也许是把 MySQL 驱动换成 PostgreSQL 驱动,也许是给一个开源框架加一种新的协议支持。如果调用方到处硬编码着某个具体类,换实现就变成一次牵一发动全身的代码手术。
SPI(Service Provider Interface)要解决的正是这件事:让"接口在哪"和"实现是谁"变成两个可以独立变化的东西,中间用一份配置文件搭桥,程序运行时才决定真正装的是哪个"插头"。JDBC 换数据库驱动不用改一行代码、日志框架换成哪家实现全看 classpath 里放了谁的 jar、Dubbo 和 Spring Boot 能被无数第三方组件扩展却不用改一行核心代码——背后都是这套机制在工作。
面试官问 SPI,追问链条通常是:基本用法要熟 → ServiceLoader 内部怎么找到实现类 → 为什么 JDBC 场景要靠"线程上下文类加载器" → 生产级框架在这基础上做了什么增强 → 踩过什么坑。本文按这条链展开。
一、SPI 解决的问题:接口和实现,谁该依赖谁
1. 面向接口编程还不够
"面向接口编程"只解决了调用方"不关心具体类型"的问题——调用方拿到的是接口类型的变量,只调接口方法。但对象总要被创建出来,某个模块里写下 new UserServiceImpl() 这行代码,这个模块就被绑死了具体实现类,编译期就要依赖实现类所在的 jar。
这在框架、中间件、插件化系统里是致命的:框架作者写接口的时候,根本不可能知道未来会有哪些第三方要实现这个接口——数据库驱动厂商、云存储厂商、下游业务团队,谁都可能是潜在的实现提供者。框架不可能为每一种潜在实现都写一段 if-else。
2. SPI 的思路:配置文件驱动的反向查找
SPI 换了个方向:接口的定义方(比如 JDK、Dubbo、Spring)只管发布契约,不关心谁来实现;实现的提供方(比如数据库驱动厂商)按约定把自己的实现类打进 jar 包,并在一个约定路径的文本文件里"登记"一下自己的全限定类名;调用方运行时,由一段通用的查找逻辑扫描 classpath,把所有登记过的实现都找出来。
一句话概括:API 是"我主动调用你",SPI 是"我定义规则,你来注册,我在运行时找到你"。国标电源插座就是活的例子——插座规格(接口)定死了,任何厂家的电器(实现)只要插头符合规格,插进去就能用,插座本身完全不需要认识这个电器。
二、基本用法:META-INF/services 与 ServiceLoader
1. 三步走
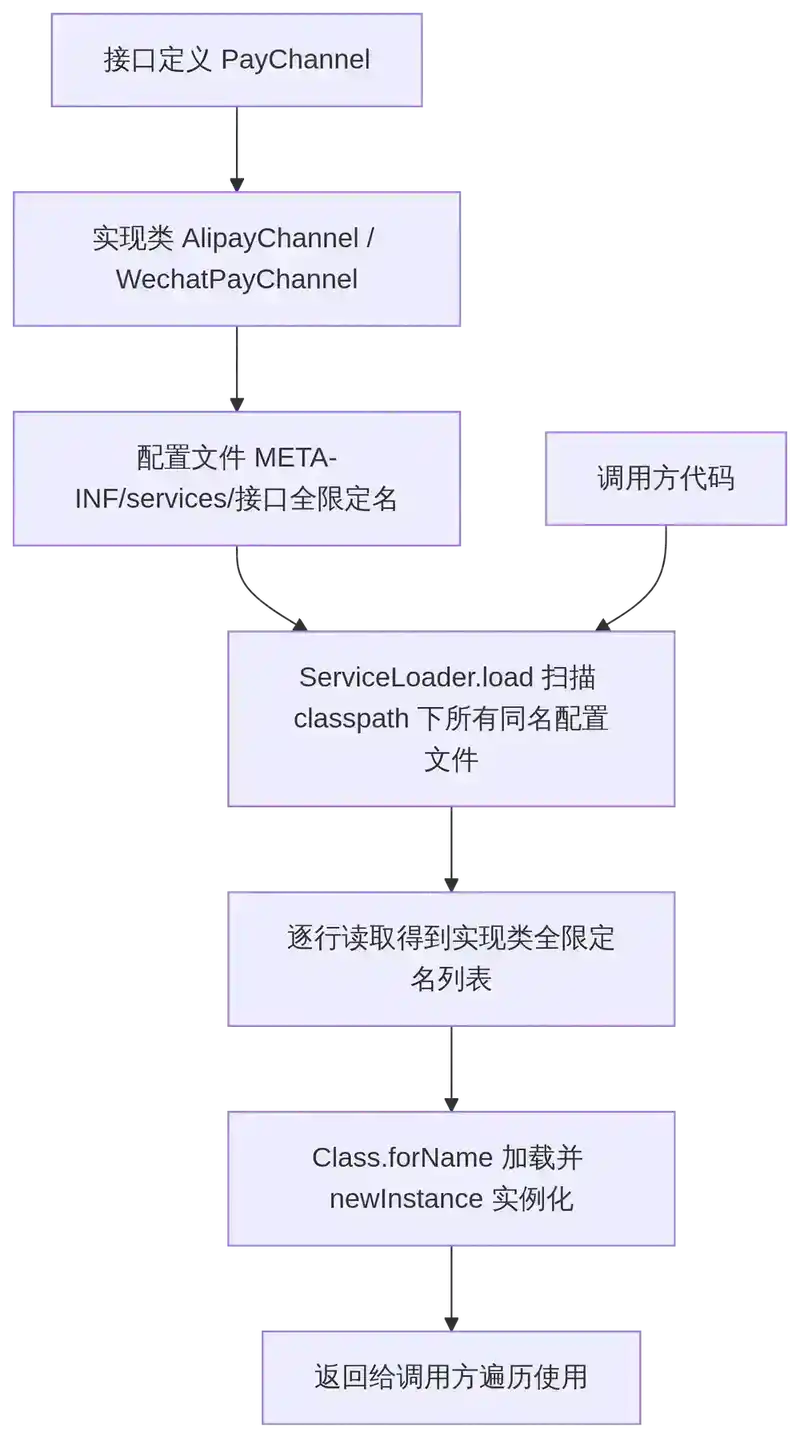
JDK 原生 SPI 的用法固定成三步:定义接口 → 写实现类 → 在 classpath 的 META-INF/services/ 目录下放一个以接口全限定名命名的文件,里面每行写一个实现类的全限定名。
以一个简化的支付渠道场景为例:
public interface PayChannel {
String pay(BigDecimal amount);
}
两个实现分别打在不同的 jar 里:
public class AlipayChannel implements PayChannel
public class WechatPayChannel implements PayChannel
在各自 jar 的 META-INF/services/com.demo.PayChannel 文件里,各自登记一行:
com.demo.impl.AlipayChannel
调用方完全不 import 任何实现类,只面向接口编程:
ServiceLoader<PayChannel> loader = ServiceLoader.load(PayChannel.class);
for (PayChannel channel : loader) {
channel.pay(amount);
}
2. 拿到的是"所有"实现,不是"某一个"
这是 JDK 原生 SPI 最容易被忽略的特点:ServiceLoader 遍历到的是 classpath 上所有 jar 里登记过的实现,全部会被找到、全部会被实例化。这天然适合"多个实现都要生效"的场景——日志框架的多个 Appender、JSON 库的多套编解码器扩展、Dubbo 的多个 Filter。如果业务场景其实只想要"其中一个",就需要调用方自己在遍历结果里挑选(比如按优先级排序、按某个标记字段过滤),JDK 原生 SPI 本身不提供"按名字精确获取一个"的能力——这也是后面 Dubbo SPI 要增强的第一个点。
三、ServiceLoader 内部原理:懒加载迭代器
1. load() 不扫描,遍历才扫描
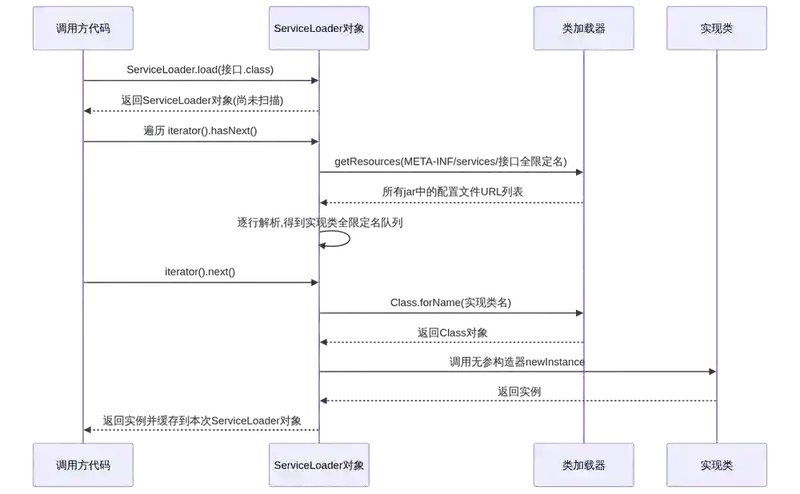
ServiceLoader.load(接口.class) 这一句调用,内部什么都没做,只是创建了一个 ServiceLoader 对象并记好了要找哪个接口、用哪个类加载器。真正的扫描动作,发生在你开始遍历(调用 iterator().hasNext() 或用 for-each 语法)的那一刻——这是典型的懒加载设计:如果调用方拿到 ServiceLoader 对象后一次都没遍历,扫描 classpath 的开销一次都不会发生。
2. 扫描逻辑:把所有同名配置文件拼起来
真正扫描时,底层用 classLoader.getResources("META-INF/services/接口全限定名") 去要资源——注意这里用的是 getResources(复数),不是 getResource。一个 classpath 上可能有好几个 jar 都放了同名的 services 文件(比如两个第三方库都实现了同一个日志接口),getResources 会把它们全部找出来,逐个打开文件、逐行读取(跳过 # 开头的注释行和空行),拼成一份完整的实现类全限定名队列。这一步就是"多 jar 天然聚合"的来源,也是后面要讲的"多 jar 冲突"问题的来源。
3. 实例化:反射 + 缓存
拿到类名后,走的是标准反射三部曲:Class.forName(实现类名, false, classLoader) 加载类 → 调用无参构造器 newInstance → 结果缓存进这次 ServiceLoader 对象内部的一个集合里。下次再遍历同一个 ServiceLoader 对象,直接返回缓存结果,不会重新扫描;但每次调用 ServiceLoader.load() 都会创建一个全新对象,新对象不会复用旧对象的缓存——如果要强制重新扫描(比如运行时新增了插件 jar),要调用 reload() 方法清空缓存重新来一遍。
4. Java 9 以后:模块化世界的另一条路
JDK 9 引入模块系统(JPMS)后,ServiceLoader 多了一条不依赖 classpath 文本文件的路径:如果一个模块在 module-info.java 里用 provides 接口 with 实现类 声明自己是某个服务的提供者,ServiceLoader 也能通过模块 Layer 直接找到它,不再需要 META-INF/services 文件。传统 classpath 方式和模块化 provides 声明方式可以共存,ServiceLoader 会把两边找到的实现合并在一起返回。
四、类加载上下文:为什么 JDBC 需要"线程上下文类加载器"
这是这个考点里最容易被问懵的一块,也是理解 SPI 必须跨过的一道坎。
1. 问题场景:DriverManager 和驱动实现,分别住在哪
JDBC 4.0 之后,写代码不再需要 Class.forName("com.mysql.cj.jdbc.Driver") 手动注册驱动——java.sql.DriverManager 内部自己用 SPI 发现所有可用的 Driver 实现。但这里有一个类加载器层面的错位:DriverManager 是 JDK 核心类,由 Bootstrap ClassLoader 加载;MySQL 驱动的实现类躺在业务应用的 classpath 里,由 Application ClassLoader(或者 Web 容器里更深一层的类加载器)加载。
2. 双亲委派把这条路堵死了
类加载遵循双亲委派:子加载器能看到父加载器已经加载过的类,反过来不行——父加载器对"儿子加载了什么"是一无所知的。如果 ServiceLoader 老老实实地用"DriverManager 所在类的类加载器"(也就是 Bootstrap ClassLoader)去扫描 META-INF/services/java.sql.Driver,那必然什么都找不到,因为 Bootstrap ClassLoader 压根看不到 Application ClassLoader 加载路径下的任何东西。
3. 解法:线程上下文类加载器(TCCL)搭桥
JDK 给这类问题准备的标准出口是线程上下文类加载器(Thread Context ClassLoader,简称 TCCL):每个线程都携带一个可以单独设置的类加载器引用,默认继承自创建该线程时的调用者的类加载器——应用主线程的 TCCL 默认就是 Application ClassLoader。ServiceLoader.load(Class) 这个最常用的重载方法,内部默认取的正是 Thread.currentThread().getContextClassLoader(),而不是"调用者这个类自己的类加载器"。DriverManager 借用当前线程的 TCCL 去扫描,就相当于借道看到了原本被 Bootstrap ClassLoader 隔绝在外的驱动实现类。
这不是 JDBC 一家的技巧,而是所有"核心库定义接口、业务方提供实现"场景的通用解法——JNDI、JAXP(XML 解析器工厂)、老版本 JAXB 底层都是同一个套路。可以记住一句话:SPI 只有把"扫描配置文件"这件事交给能看到实现类的类加载器去做,才能真正跨越模块边界找到实现,TCCL 就是 JDK 官方指定的那个"能看到"的加载器。
4. 副作用:线程池里的 SPI 突然失效
TCCL 是线程级的属性,不是全局唯一的。如果 SPI 查找发生在另一个线程里——最典型的是线程池的工作线程——而这个工作线程创建时的 TCCL 没有被正确设置(默认会继承创建它的线程,可能是一个不含业务 classpath 的系统线程或第三方框架的调度线程),SPI 扫描就会两手空空,轻则返回空迭代器,重则直接抛 ServiceConfigurationError。"业务代码本地跑正常,扔进线程池里就找不到实现类",十有八九就是这个根因,排查时第一步是打印当前线程的 getContextClassLoader()。
五、生产级增强:JDK SPI 的短板与框架的补强
1. JDK 原生 SPI 的三个短板
把前面的原理串起来看,JDK 原生 SPI 有三个明显的短板:一是一次性全量加载,遍历时会把配置文件里登记的所有实现都实例化一遍,哪怕业务只想用其中一个;二是不支持按名字精确获取,只能拿到一个迭代器,自己写循环去挑;三是没有 IOC/AOP 能力,实现类内部想依赖别的组件、想被统一包装一层横切逻辑,SPI 本身什么都不管。生产级框架都是在这三点上做了增强。
2. Dubbo SPI:按名字取、自适应、IOC 与 Wrapper 链
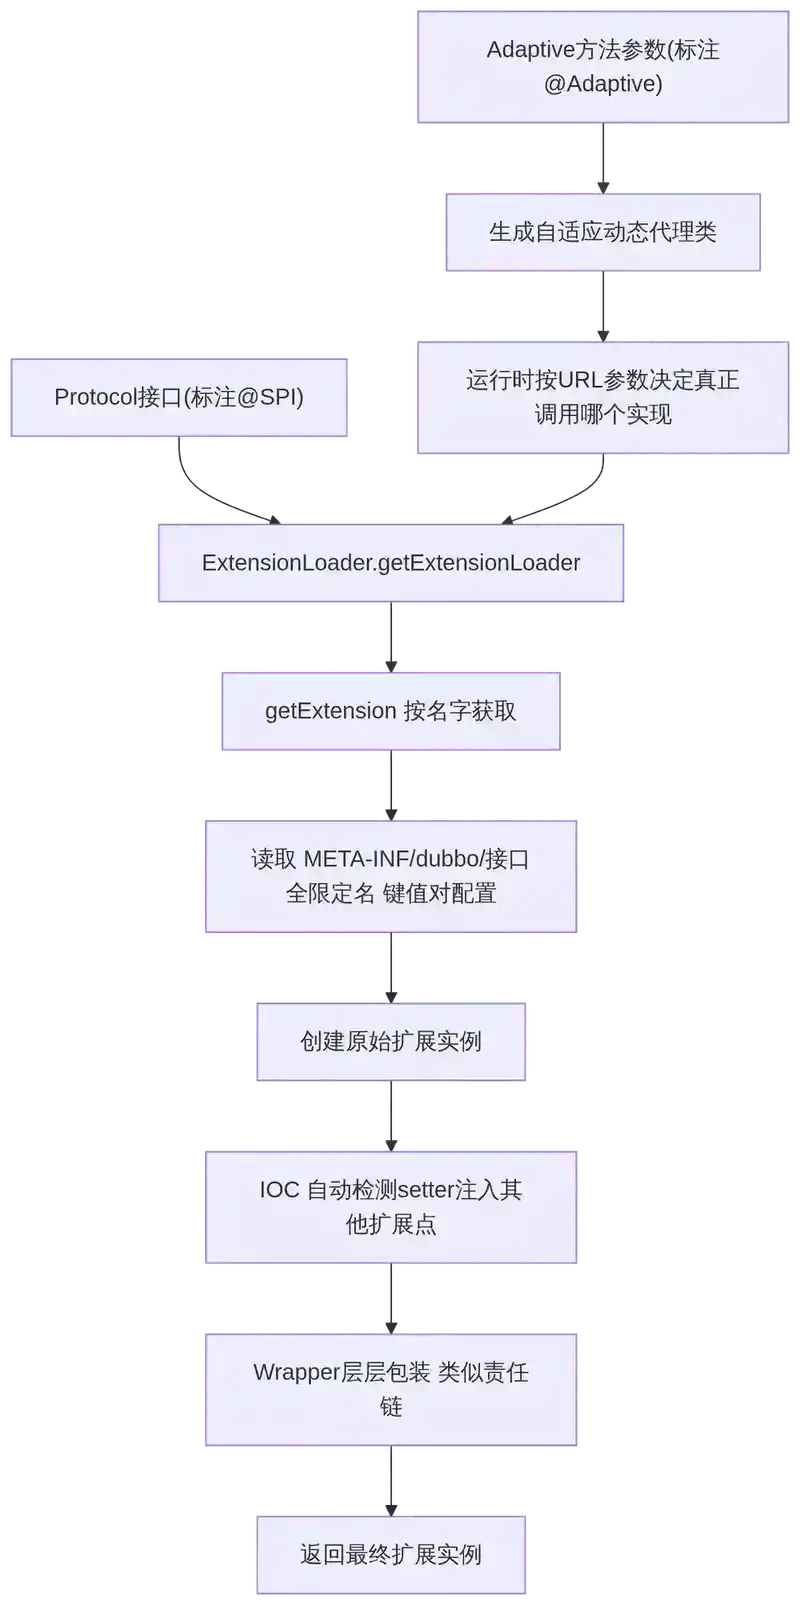
Dubbo 的扩展点机制形式上像 SPI(接口标注 @SPI,配置文件放在 META-INF/dubbo/ 目录),但增强了不少能力:
配置文件格式从"一行一个类名"换成了键值对:dubboProtocol=com.demo.DubboProtocol,这样调用方可以通过 ExtensionLoader.getExtensionLoader(Protocol.class).getExtension("dubbo") 精确拿到某一个实现,不用再遍历挑选。
@Adaptive 解决"运行时才知道该用哪个实现"的问题:被标注的方法参数,框架会在编译期生成一个自适应的动态代理类,代理类内部并不硬编码某个具体实现,而是在方法真正被调用时,读取传入的 URL 参数决定该转发给哪个真实扩展——把"选择实现"这件事从"启动时固定"推迟到了"调用时动态决定"。
Wrapper 机制是一种自动识别的装饰链:如果某个类实现了目标接口,且构造器只接收该接口类型的一个参数,ExtensionLoader 就会把它当作 Wrapper,按发现顺序把真正的目标实例一层层包起来——这本质上是一条自动装配的责任链,Dubbo 协议扩展点上的过滤器、监听器就是这样被无侵入地接入进来的。
IOC 能力:ExtensionLoader 创建出扩展实例后,会自动扫描它的 setter 方法,按参数类型去找到并注入其他扩展点的实例——一个专门为扩展点服务的轻量级依赖注入容器,让扩展实现之间也能互相协作,而不是各自为政。
3. Spring Boot 自动配置:思路同源,但把实例化交还给容器
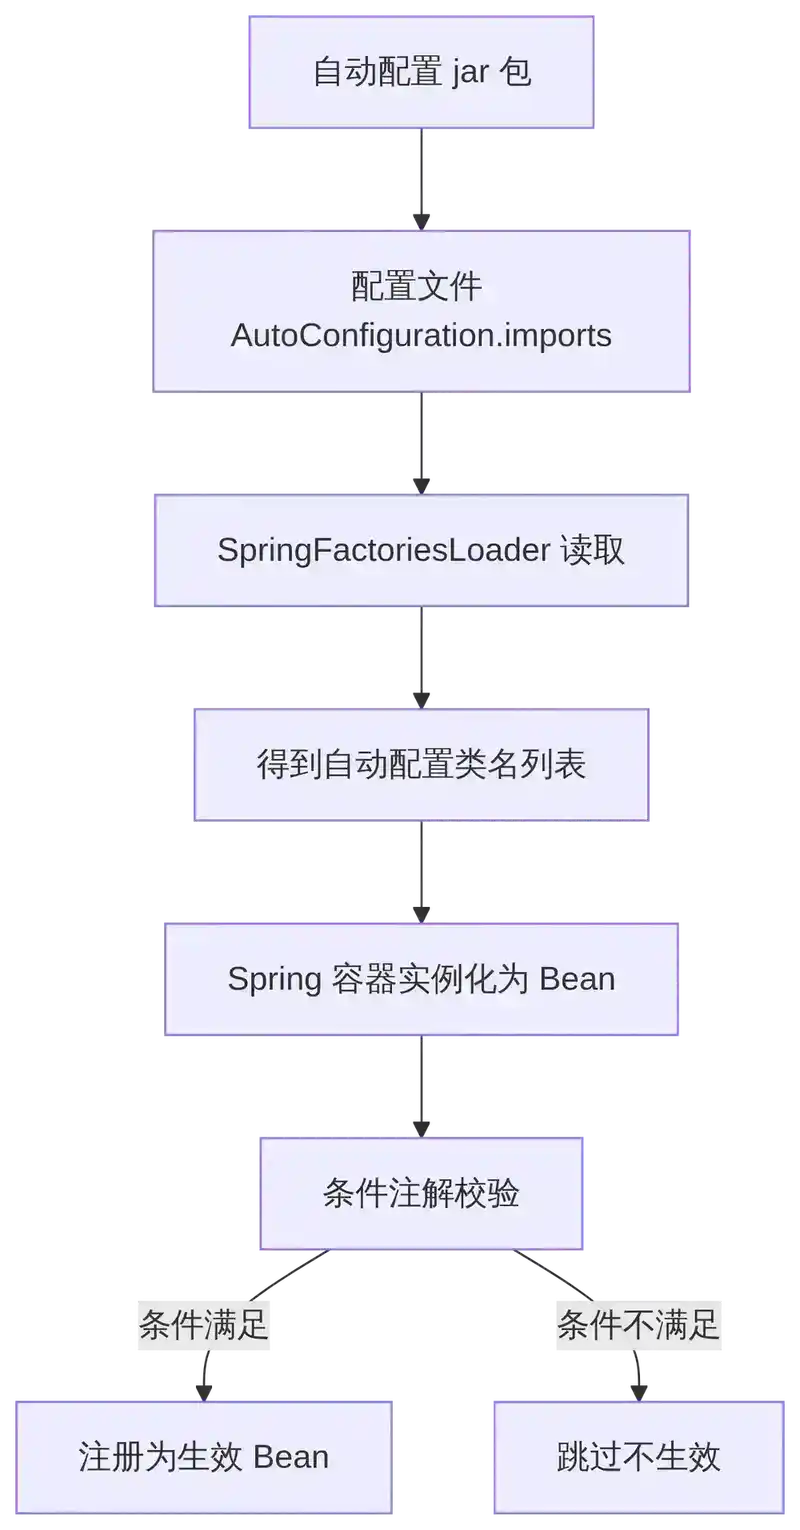
Spring 没有直接沿用 JDK SPI 的 API,但 SpringFactoriesLoader 的设计思路和 SPI 一脉相承:早期版本靠 META-INF/spring.factories 文件,Spring Boot 2.7 起新增了更轻量的 META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports 文件——本质都是"按接口/注解类型登记一批候选类全限定名"的配置文件。
关键区别在于Spring 只负责"发现类名列表",不负责实例化:SpringFactoriesLoader 读出候选类名后,把创建工作交还给 Spring 容器,走完整的 Bean 生命周期——这意味着自动配置类可以享受依赖注入、可以被 @ConditionalOnClass、@ConditionalOnMissingBean 等条件注解拦截,"满足条件才生效、不满足就悄悄跳过",这是 JDK 原生 ServiceLoader(拿到类名就直接反射实例化)做不到的。理解了这一层,才能明白 Spring Boot 为什么能把"自动"和"可控"同时做到。
六、常见坑与工程实践
1. 多 jar 冲突:以为只有一个实现,其实来了好几个
前面提到 getResources 会把 classpath 上所有同名配置文件都聚合起来。如果两个不相关的第三方 jar 恰好都在自己的 META-INF/services/同一个接口 里登记了实现,ServiceLoader 遍历时会把两者都找出来、都实例化。如果业务代码假设"这个接口只有一种实现",直接拿 iterator() 的第一个用,就会遇到"到底谁排在前面"这种依赖遍历顺序、完全不可控的行为。工程上的正确做法是:需要精确控制的场景用 Dubbo 式"按名字取"而不是裸遍历,或者自己在配置里加一个优先级/权重字段来排序。
2. 无参构造器是硬性要求,报错却在运行时才炸
ServiceLoader 反射实例化时只会调用无参构造器,如果实现类没有提供(比如只写了带参构造器),会抛 ServiceConfigurationError。更麻烦的是,这个错误只有在真正遍历时才会暴露——如果没人调用过 ServiceLoader.load().iterator(),配置文件写错、类名写错、缺无参构造器,这些问题都不会在启动阶段被发现,一直潜伏到某次真正触发遍历才炸出来。
3. 一个实现类初始化失败,会连带炸掉整条遍历
这是最容易被忽视的坑:迭代器遍历过程中,如果某一个实现类实例化失败(比如它的静态初始化块抛了异常),ServiceConfigurationError 会直接从 next() 抛给调用方,遍历到此为止——即使后面还有其他能正常工作的实现,也不会再被访问到。"新加了一个依赖之后,SPI 机制的其他功能全部失效",根因往往是新依赖里某个实现类初始化失败,把整条遍历链弄断了。稳妥的做法是逐个 try-catch 隔离单个 provider 的失败,不要假设遍历一定能顺利走完。
4. 模块化项目里,忘记声明 uses/provides
升级到 JDK 9+ 的模块化(JPMS)项目后,SPI 失效还有一个新根因:如果消费方模块没有用 uses 接口全限定名; 声明"我要用这个服务",或者提供方模块没有用 provides 接口 with 实现类; 声明"我提供这个服务",运行时即使 classpath/模块路径上类都在,ServiceLoader 也可能找不到对应实现。这是很多老项目迁移到模块化时排查许久才发现的隐性依赖声明缺失。
七、动手:给支付渠道写一个可扩展的 SPI
把前面讲的原理串成一个能跑起来的小例子:定义支付渠道接口,两个实现各自登记进配置文件,调用方按优先级挑出一个可用的渠道——五十行左右,覆盖"定义契约、注册实现、遍历查找、按规则选择"这条完整链路。
接口定义(打包在核心 jar 里,不依赖任何实现):
public interface PayChannel {
int priority();
boolean isAvailable();
String pay(BigDecimal amount);
}
实现类(打包在各自独立的 jar 里):
public class AlipayChannel implements PayChannel {
public int priority()
{
return 10;
}
public boolean isAvailable()
{
return true;
}
public String pay(BigDecimal amount)
{
return "alipay:" + amount;
}
}
配置文件 META-INF/services/com.demo.PayChannel 里登记一行:
com.demo.impl.AlipayChannel
调用方遍历全部实现,过滤掉不可用的,按优先级挑最高的一个:
PayChannel selected = null;
for (PayChannel channel : ServiceLoader.load(PayChannel.class)) {
if (!channel.isAvailable()) continue;
if (selected == null || channel.priority() > selected.priority()) {
selected = channel;
}
}
if (selected == null) throw new IllegalStateException("无可用支付渠道");
selected.pay(amount);
这段代码把本考点的核心要素全部覆盖了一遍:接口和实现分属不同 jar、配置文件驱动查找、遍历得到的是全部实现、业务自己按规则(优先级 + 可用性)从中选择——这正是 JDK 原生 SPI"不提供按名字精确获取"短板下,业务代码通常要补的那一段逻辑。
八、小结
SPI 的知识骨架可以压缩成四句话:
- 本质:SPI 是配置文件驱动的反向查找——接口和实现分属不同模块,运行时靠 classpath 上一份文本配置搭桥,而不是靠代码里的硬编码依赖;
- 原理:ServiceLoader 懒加载、按需扫描所有同名 services 文件,天然聚合多个 jar 的实现,但只要开始遍历就会尝试实例化配置里的每一项;
- 类加载:跨模块边界找实现,必须让"扫描配置文件"这个动作发生在能看到实现类的类加载器上——线程上下文类加载器(TCCL)是 JDK 给这个问题的标准答案,JDBC、JNDI、JAXP 都靠它跨越双亲委派的限制;
- 框架增强:Dubbo、Spring 在 JDK 原生 SPI 的基础上叠加了按名字精确获取、自适应选择、IOC 依赖注入、条件装配等能力——理解了原始 SPI 的三个短板(全量加载、不能精确取、没有容器能力),才能看懂它们为什么要这样设计。
提问与回答(面试追问模拟,不计入阅读时长)
Q1:SPI 和 API 的区别是什么?
A:API 是"你主动调用我"——调用方知道要用哪个具体类,直接依赖它、调用它的方法。SPI 是"我定义规则,你来注册"——接口的定义方不知道也不关心具体是谁实现的,实现方按约定把自己登记进配置文件,运行时由一段通用逻辑(比如 ServiceLoader)找出所有登记过的实现。简单说:API 面向调用,SPI 面向扩展。
Q2:ServiceLoader.load() 调用之后是不是立刻就实例化了所有实现类?
A:不是。load() 只创建一个 ServiceLoader 对象,记录要找的接口类型和使用的类加载器,什么扫描和实例化都还没发生。真正的扫描 classpath、读取配置文件、反射实例化,发生在你开始遍历(调用 iterator().hasNext()/next() 或用 for-each)的那一刻,是懒加载设计。
Q3:为什么 JDBC 4 之后不需要 Class.forName 就能自动注册驱动?
A:因为 java.sql.DriverManager 内部自己用 ServiceLoader 扫描了 META-INF/services/java.sql.Driver,把 classpath 上所有登记过的驱动实现都加载并实例化了一遍,驱动类在静态块或构造过程中会调用 DriverManager.registerDriver 完成注册。整个过程在 DriverManager 类初始化时自动完成,不再需要业务代码手动 Class.forName。
Q4:什么是线程上下文类加载器,SPI 为什么需要它?
A:线程上下文类加载器(TCCL)是每个线程携带的一个可设置的类加载器引用,默认继承自创建该线程的调用者的类加载器。JDK 核心类(比如 DriverManager)由 Bootstrap ClassLoader 加载,受双亲委派限制看不到业务 classpath 下由 Application ClassLoader 加载的实现类;ServiceLoader.load(Class) 默认使用当前线程的 TCCL 而不是接口所在类的类加载器去扫描,从而借道看到了原本被隔绝在外的实现,这是跨越类加载器边界查找实现的标准解法。
Q5:如果一个 SPI 实现类的静态初始化块抛异常,会发生什么?
A:ServiceLoader 遍历到这个实现类时,实例化会失败并抛出 ServiceConfigurationError,直接从 next() 方法抛给调用方,遍历到此中断——即使配置文件里后面还登记了其他能正常工作的实现,也不会再被访问到。生产代码应该在遍历时对每个 provider 做 try-catch 隔离,避免一个坏实现拖垒整条链路。
Q6:JDK 原生 SPI 和 Dubbo SPI 最大的区别是什么?
A:JDK 原生 SPI 只能拿到一个迭代器,一次性把配置文件里的所有实现都实例化,不支持按名字精确获取某一个。Dubbo SPI 把配置文件从"一行一个类名"改成"键值对",支持 getExtension(name) 按名字精确获取;还额外提供了 @Adaptive 自适应代理(运行时按参数动态决定用哪个实现)、Wrapper 自动装饰链、以及面向扩展点的轻量 IOC 能力,这些都是 JDK 原生 SPI 不具备的。
Q7:Spring Boot 自动配置底层用的是 JDK 原生 SPI 吗?
A:不是同一套 API,但设计思路同源。Spring 用 SpringFactoriesLoader 读取 META-INF/spring.factories 或新版 AutoConfiguration.imports 文件,按接口/注解类型拿到候选类名列表——这一步和 SPI 的"配置文件驱动查找"思路一致。区别在于 Spring 只负责发现类名,不直接反射实例化,而是把创建工作交还给 Spring 容器,这样自动配置类才能享受依赖注入和 @ConditionalOnClass 等条件注解的拦截。
Q8:多个 jar 包对同一个接口都提供了 SPI 实现,会发生什么?
A:ServiceLoader 底层用 getResources(复数)扫描,会把 classpath 上所有 jar 里同名的 META-INF/services 配置文件都找出来并逐个解析,最终遍历结果是所有 jar 登记的实现的合集,不会自动去重或只取一个。如果业务只期望一个实现生效,需要自己在遍历结果里按优先级/名字挑选,不能假设遍历顺序稳定可控。
Q9:JPMS 模块化下,SPI 的提供方和消费方分别要做什么声明?
A:提供方模块要在 module-info.java 里写 provides 接口全限定名 with 实现类全限定名,声明"我提供这个服务";消费方模块要写 uses 接口全限定名,声明"我要使用这个服务"。两边都需要显式声明,即使类文件本身都在模块路径上,缺了任一声明,ServiceLoader 都可能找不到对应实现——这是老项目迁移模块化时排查 SPI 失效的常见根因,同时传统的 classpath + META-INF/services 方式在模块化下依然可以并存工作。