阅读时间:约 40-50 分钟 | 标签:DevOps、IaC、Terraform、Pulumi、云原生
一、为什么 IaC 是云原生的"操作系统"
2006 年 AWS 发布 EC2 时,运维人员的第一反应是兴奋——终于不用去机房插网线了。但很快他们就发现了一个更头疼的问题:以前管的是几十台物理机,现在要管的是几百个"虚拟"资源——EC2 实例、安全组、VPC、ELB、RDS、S3 Bucket、IAM Role……每个资源都要在控制台里点来点去,配置散落在不同人的脑子里,环境不一致是家常便饭。
**基础设施即代码(Infrastructure as Code, IaC)**正是为了解决这个问题的。它的核心思想极其朴素:像管理应用代码一样管理基础设施——用版本化的声明式配置文件描述你想要的资源状态,由工具自动将实际环境调整到目标状态。
┌─────────────────────────────────────────────────────┐
│                    传统运维模式                       │
│  人 → 控制台/CLI → 手动操作 → 基础设施(谁知道改了啥)  │
└─────────────────────────────────────────────────────┘

┌─────────────────────────────────────────────────────┐
│                      IaC 模式                        │
│  人 → 声明式代码(.tf) → Git → CI/CD → 工具引擎 → 基础设施 │
│       ↑ 版本化  ↑ 可审查  ↑ 可复现  ↑ 可审计          │
└─────────────────────────────────────────────────────┘
IaC 解决的不是"如何创建资源"的问题——CLI 和 API 早就能创建资源了。IaC 解决的是**"如何可靠地、可重复地、可审查地管理大量资源"**的问题。两者之间的差距,就像手写汇编和用高级语言写程序的差距。 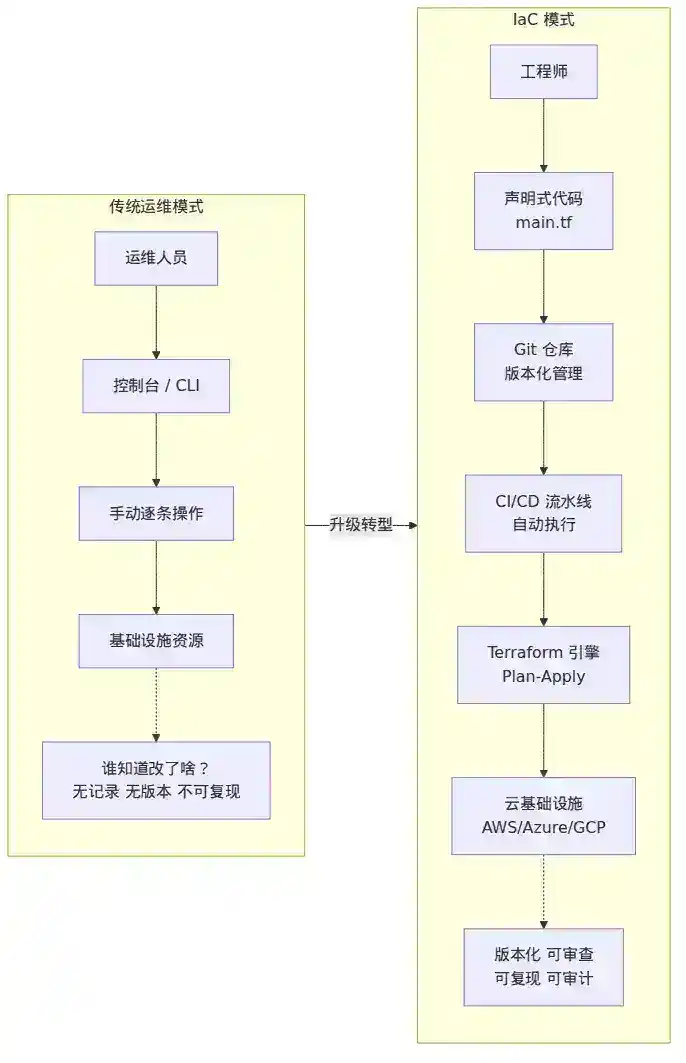
图1:IaC 模式 vs 传统运维模式对比流程图——传统运维(人→控制台→手动操作→基础设施)与 IaC 模式(人→声明式代码→Git→CI/CD→工具引擎→基础设施)的完整链路差异
二、声明式 vs 命令式:两种范式的本质分野
理解 IaC 的第一道门槛,是区分两种配置范式。
2.1 命令式(Imperative):告诉计算机"怎么做"
命令式配置描述的是达到目标状态的步骤序列。你写的是"先创建 VPC,然后创建子网,再创建安全组,最后创建 EC2 实例"。
# 命令式:一步一步执行
aws ec2 create-vpc --cidr-block 10.0.0.0/16
aws ec2 create-subnet --vpc-id vpc-xxx --cidr-block 10.0.1.0/24
aws ec2 create-security-group --group-name my-sg --vpc-id vpc-xxx
aws ec2 run-instances --image-id ami-xxx --subnet-id subnet-xxx --security-group-ids sg-xxx
问题在哪? 如果你跑了前两步,第三步失败了,你处于一个"中间状态"——VPC 和子网已创建但安全组没有。要恢复?你得知道当前到底创建了什么、删掉什么、重试什么。幂等性完全靠你自己保证。
Ansible 在配置管理层面是典型的命令式工具(虽然其 playbook 中用 YAML 描述,但每个 task 本质上是"执行这个模块")。
2.2 声明式(Declarative):告诉计算机"我想要什么"
声明式配置描述的是最终期望状态。你写的是"我想要一个 VPC、两个子网、一个安全组、三台 EC2 实例",至于怎么创建、以什么顺序创建、失败了怎么重试——全交给工具。
# 声明式:描述期望状态
resource "aws_vpc" "main" {
  cidr_block = "10.0.0.0/16"
}

resource "aws_subnet" "public" {
  vpc_id     = aws_vpc.main.id
  cidr_block = "10.0.1.0/24"
}

resource "aws_security_group" "web" {
  vpc_id = aws_vpc.main.id
  # ...
}

resource "aws_instance" "web" {
  count         = 3
  ami           = "ami-xxx"
  subnet_id     = aws_subnet.public.id
  vpc_security_group_ids = [aws_security_group.web.id]
}
Terraform 执行这段配置时,内部做的是:
- 解析配置 → 构建资源依赖图(DAG)
- 刷新状态 → 查询云平台,获取当前实际资源
- 计算差异 → 对比期望状态 vs 实际状态,生成执行计划
- 按序执行 → 根据依赖关系,并行创建无依赖的资源,串行处理有依赖的资源
声明式的核心优势:
| 维度 | 命令式 | 声明式 |
|---|---|---|
| 幂等性 | 需要自己处理 | 框架自动保证 |
| 差异检测 | 无(需手动对比) | 内置 Plan/Diff |
| 回滚 | 需要写回滚脚本 | 可回退到旧版本配置 apply |
| 可读性 | 过程散落,难以理解全局 | "什么是最终状态"一目了然 |
| 并发安全 | 需要自己加锁 | 状态锁机制内置 |
2.3 声明式的代价
声明式并非银弹。它的代价是:
- 抽象泄漏:遇到工具不支持的操作,你需要绕回命令式(Terraform 的
local-execprovisioner 就是典型的"逃生舱") - 调试困难:当 Plan 报错说"资源将被替换"时,你需要理解为什么——这通常意味着你要深入 Provider 的实现细节
- 状态管理复杂性:声明式依赖状态文件来追踪资源,状态文件本身就是一个新的运维对象
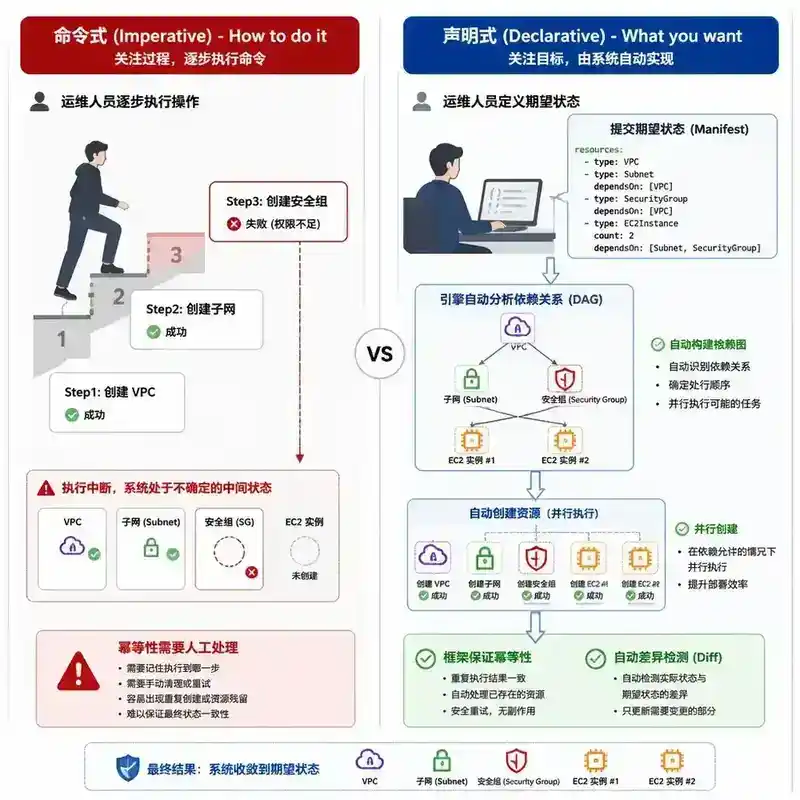
图3:声明式 vs 命令式范式对比——左侧命令式(一步步执行CLI命令,中间状态不可控),右侧声明式(描述期望状态,工具自动计算差异并执行),对比幂等性、差异检测、可读性
三、核心工具生态:谁在定义 IaC 的标准
3.1 Terraform / OpenTofu:声明式 IaC 的事实标准
HashiCorp 的 Terraform 定义了声明式 IaC 的范式。2023 年 HashiCorp 将 License 从 MPL 改为 BSL 后,社区 fork 出了 OpenTofu,两者在核心功能上保持兼容。
核心架构:
┌──────────────────────────────────────────────────┐
│                  Terraform Core                   │
│  ┌──────────┐  ┌──────────┐  ┌───────────────┐  │
│  │ 配置解析  │  │ 状态管理  │  │ 资源图引擎    │  │
│  │ (HCL)    │  │ (State)  │  │ (Graph/Walk)  │  │
│  └──────────┘  └──────────┘  └───────────────┘  │
│                      │                            │
│              ┌───────┴───────┐                    │
│              │  gRPC Plugin  │                    │
│              └───────┬───────┘                    │
└──────────────────────┼────────────────────────────┘
                       │
    ┌──────────────────┼──────────────────┐
    │                  │                  │
┌───┴───┐        ┌────┴────┐       ┌─────┴─────┐
│  AWS  │        │  Azure  │       │  Kubernetes│
│Provider│       │Provider  │       │  Provider  │
└───────┘        └─────────┘       └───────────┘
Provider 机制是 Terraform 最具扩展性的设计。每个 Provider 封装了对应平台(AWS、Azure、GCP、K8s、GitHub、Datadog……)的 API 调用,Terraform Core 只负责"声明式引擎"的通用逻辑。
**HCL(HashiCorp Configuration Language)**的设计哲学:
- 不是通用编程语言,而是"配置 DSL"
- 变量、表达式、函数、循环(
count/for_each)——恰好够用,多了反而危险 - 明确拒绝图灵完备(尽管实践中
dynamic块和for表达式已经相当强大)
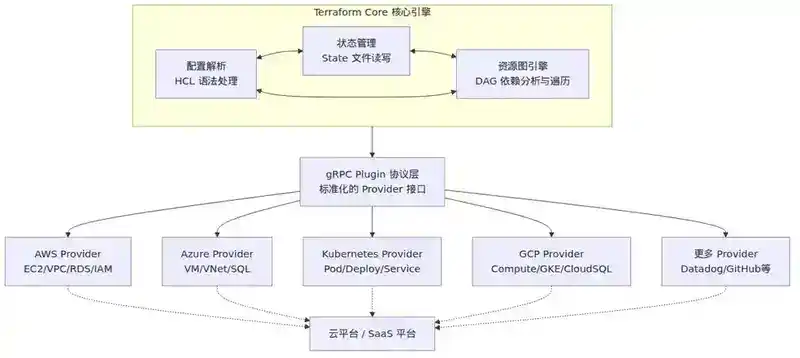
图2:Terraform Core 架构图——配置解析(HCL)、状态管理(State)、资源图引擎(Graph/Walk)三个核心模块,通过 gRPC Plugin 协议连接多云 Provider
3.2 Pulumi:用真正的编程语言写 IaC
Pulumi 走了一条不同的路:用通用编程语言(TypeScript、Python、Go、C#、Java)写基础设施配置。
// Pulumi: TypeScript 声明基础设施
import * as aws from "@pulumi/aws";

const vpc = new aws.ec2.Vpc("main", {
    cidrBlock: "10.0.0.0/16",
});

const subnet = new aws.ec2.Subnet("public", {
    vpcId: vpc.id,
    cidrBlock: "10.0.1.0/24",
});

const sg = new aws.ec2.SecurityGroup("web", {
    vpcId: vpc.id,
});

for (let i = 0; i < 3; i++) {
    new aws.ec2.Instance(`web-${i}`, {
        ami: "ami-xxx",
        instanceType: "t3.micro",
        subnetId: subnet.id,
        vpcSecurityGroupIds: [sg.id],
    });
}
Pulumi 的核心优势:
- 循环、条件、函数、类——全部原生支持,不需要学 DSL 的"取巧写法"
- 可以复用现有代码库、类型系统、IDE 支持
- 测试更自然(可以用标准测试框架写单元测试)
Pulumi 的代价:
- 图灵完备的语言意味着配置本身可能引入 bug(死循环、空指针、复杂逻辑)
- 团队需要统一编程语言选择
- 声明式"纯度"下降——你可以在配置里写任意逻辑,这让 Plan 的确定性降低
3.3 其他重要玩家
| 工具 | 范式 | 定位 | 关键特点 |
|---|---|---|---|
| Ansible | 命令式(YAML 描述) | 配置管理 + 编排 | Agentless、SSH 推送、幂等模块 |
| CloudFormation | 声明式 | AWS 原生 IaC | 与 AWS 深度集成、StackSets 跨账号 |
| Crossplane | 声明式 | K8s 原生 IaC | 用 K8s CRD 管理云资源,Control Plane 模式 |
| CDK (AWS/CDKTF/CDK8s) | 命令式生成声明式 | IaC 开发框架 | 用编程语言生成 CloudFormation/Terraform/K8s YAML |
| Chef/Puppet | 命令式(DSL) | 配置管理 | Agent 模式、Pull 机制 |
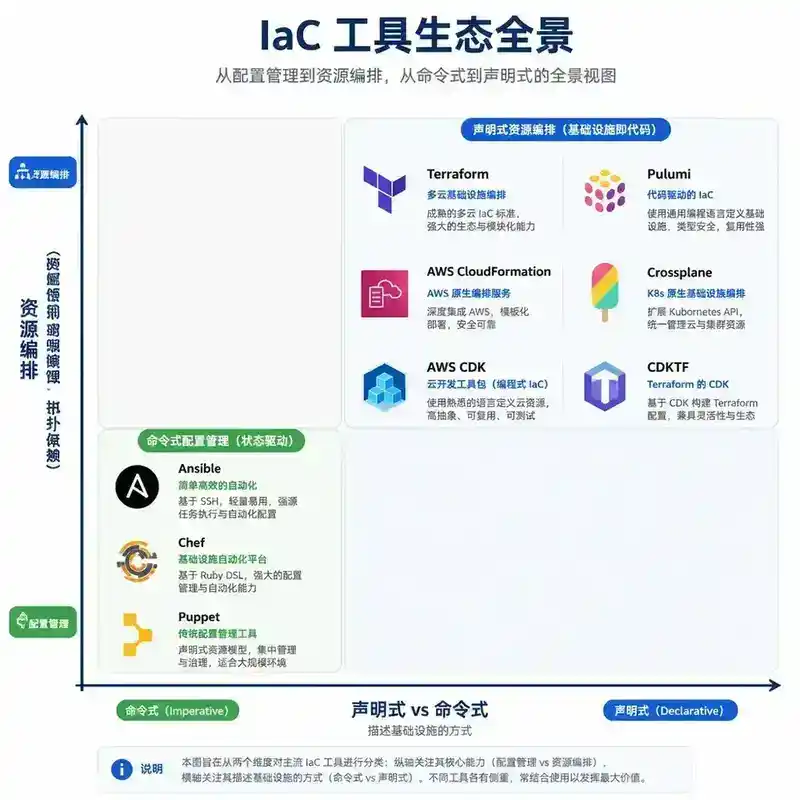
图8:IaC 工具生态全景对比图——按声明式/命令式维度和配置管理/资源编排维度,将Terraform、Pulumi、Ansible、CloudFormation、Crossplane、CDK等工具分类展示,标注核心特点和适用场景
四、状态管理:IaC 最容易被低估的复杂性
如果你只能记住 IaC 的一个核心概念,那一定是状态(State)。
4.1 为什么需要状态文件
声明式 IaC 引擎需要回答一个关键问题:我上次创建了什么? 没有状态文件,工具就无法区分"需要创建的资源"和"已经存在的资源"。
Terraform 的状态文件(terraform.tfstate)记录的是实际基础设施到配置资源的映射:
{
  "version": 4,
  "terraform_version": "1.5.0",
  "serial": 37,
  "resources": [
    {
      "mode": "managed",
      "type": "aws_instance",
      "name": "web",
      "provider": "provider[\"registry.terraform.io/hashicorp/aws\"]",
      "instances": [
        {
          "schema_version": 1,
          "attributes": {
            "id": "i-0abcd1234efgh5678",
            "ami": "ami-0c55b159cbfafe1f0",
            "instance_type": "t3.micro",
            "private_ip": "10.0.1.42",
            "tags": { "Name": "web-server" }
          }
        }
      ]
    }
  ]
}
关键的映射关系:aws_instance.web → i-0abcd1234efgh5678。这个映射让 Terraform 在执行 plan 时能够:查询 AWS API 获取 i-0abcd1234efgh5678 的实际状态,与配置文件中 aws_instance.web 的期望状态对比,生成精确的变更计划。
4.2 远程状态后端
本地状态文件有一系列致命问题:
- 多人协作时状态冲突
- CI/CD 环境中状态不持久
- 状态包含敏感信息(数据库密码、API Key 等)——不适合提交到 Git
远程状态后端解决了这些问题:
┌──────────┐    ┌──────────┐    ┌──────────┐
│ 工程师 A  │    │ 工程师 B  │    │ CI/CD    │
│terraform │    │terraform │    │terraform │
└────┬─────┘    └────┬─────┘    └────┬─────┘
     │               │               │
     └───────────────┼───────────────┘
                     │
              ┌──────┴──────┐
              │  状态后端     │
              │ S3/GCS/      │
              │ Terraform    │
              │ Cloud        │
              └──────┬──────┘
                     │
              ┌──────┴──────┐
              │  状态锁      │
              │ DynamoDB/    │
              │ etcd/Consul  │
              └─────────────┘
**状态锁(State Locking)**是远程后端的核心功能。当用户 A 在执行 terraform apply 时,后端对状态文件加锁,用户 B 的 apply 会阻塞等待。这防止了并发修改导致的状态损坏。
典型的 AWS 后端配置:
terraform {
  backend "s3" {
    bucket         = "my-terraform-state"
    key            = "prod/network/terraform.tfstate"
    region         = "us-east-1"
    dynamodb_table = "terraform-locks"   # 状态锁
    encrypt        = true                 # 服务端加密
  }
}
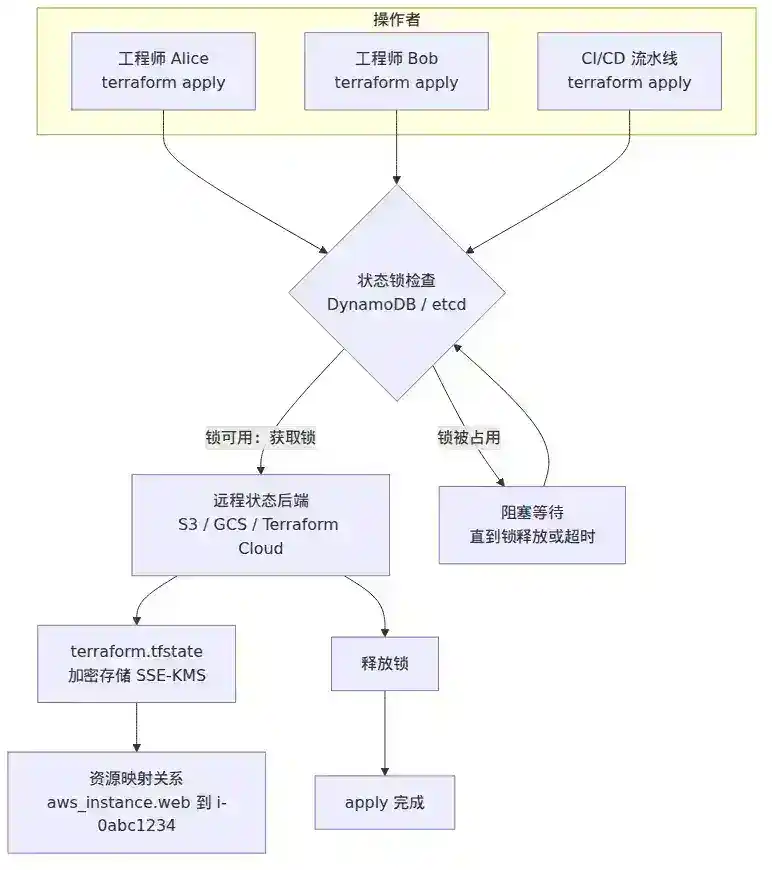
图4:远程状态后端与状态锁架构图——工程师A/B和CI/CD通过远程状态后端共享状态,DynamoDB/etcd 状态锁机制防止并发写入
4.3 状态操作:你需要掌握的四个命令
# 1. 导入现有资源到状态(无需重建)
terraform import aws_instance.web i-0abcd1234efgh5678

# 2. 从状态中移除资源(不删除实际资源)
terraform state rm aws_instance.web

# 3. 移动资源在状态中的地址(重构时用)
terraform state mv aws_instance.old_name aws_instance.new_name

# 4. 列出状态中的所有资源
terraform state list
状态迁移是团队成长过程中必经的痛。当你将一个单体 Terraform 配置拆分为多个模块时,需要精确地将资源从一个 state 迁移到另一个 state。terraform state mv 配合 -state 和 -state-out 参数可以实现跨状态文件的资源迁移。
4.4 状态文件的安全红线
状态文件是 IaC 安全中最容易被忽视的环节:
- 明文存储敏感数据:数据库密码、TLS 私钥、API Token 全部以明文存储在 state 中
- 访问控制:谁能读 S3 bucket 中的 state 文件,谁就能看到所有敏感信息
- 加密:至少启用服务端加密(SSE-S3/SSE-KMS),传输中使用 TLS
最佳实践:对所有敏感资源使用 sensitive = true 标记,防止在 Plan 输出中打印;对 state 文件所在的 S3 bucket 启用严格 IAM 策略和访问日志。
五、变更审查:从"谁改了"到"改之前就知道会怎样"
IaC 的第二个核心价值是让基础设施变更加上审查流程,就像代码需要 Code Review 一样。
5.1 Plan/Apply 生命周期
git commit → git push → CI 触发 → terraform init → terraform plan
                                                          │
                                                    ┌─────┴──────┐
                                                    │  Plan 输出  │
                                                    │  + 创建 3   │
                                                    │  ~ 修改 1   │
                                                    │  - 删除 0   │
                                                    └─────┬──────┘
                                                          │
                                                    人工审查 Plan
                                                          │
                                                          ▼
                                                    terraform apply
Plan 输出的价值:
- 在变更执行前就能看到"将要发生什么"
- 若 Plan 显示"资源将被销毁重建"(force replacement),可以在 apply 前阻止
- 作为变更审计记录留存
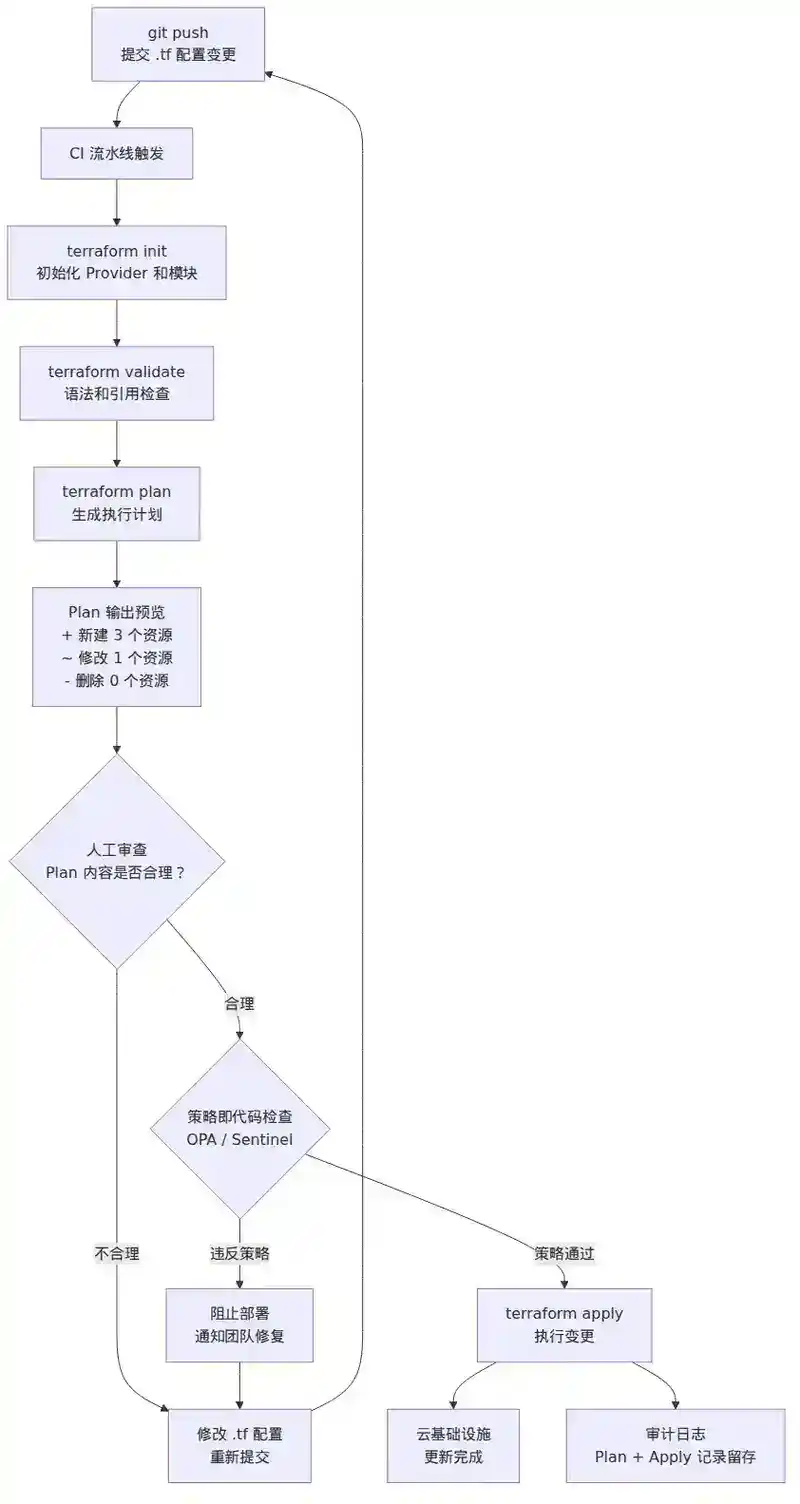
图5:Plan/Apply 变更审查生命周期流程图——从 git commit→push→CI触发→terraform init→plan→人工审查→OPA策略检查→apply 的完整变更审查流水线
5.2 策略即代码(Policy as Code)
Plan 审查的问题在于:依赖人工判断。随着团队规模增长,你需要自动化的合规检查。
Open Policy Agent(OPA)/ Sentinel 在 Terraform 生态中扮演"变更守门人"的角色:
terraform plan → 生成 Plan JSON → OPA/Sentinel 策略引擎
                                        │
                              ┌─────────┴─────────┐
                              │  PASS: 允许 apply  │
                              │  FAIL: 阻止 apply  │
                              │  WARN: 允许但告警  │
                              └───────────────────┘
典型策略示例:
# OPA 策略:禁止安全组对 0.0.0.0/0 开放 22 端口
package terraform

deny[msg] {
    r := input.resource_changes[_]
    r.type == "aws_security_group_rule"
    r.change.after.cidr_blocks[_] == "0.0.0.0/0"
    r.change.after.from_port == 22
    msg = sprintf("安全组 %v 不允许对 0.0.0.0/0 开放 SSH", [r.address])
}
5.3 GitOps:让 Git 成为唯一的真理之源
GitOps 将 IaC 的变更审查推到了极致:Git 仓库中的配置就是基础设施的期望状态,任何变更都必须通过 Git PR 进行。
工程师 → 修改 .tf 文件 → 创建 PR
                              │
                     ┌────────┴────────┐
                     │  Code Review    │
                     │  Plan 预览      │
                     │  策略检查       │
                     └────────┬────────┘
                              │
                         Merge to main
                              │
                              ▼
                    GitOps Operator
                    (Flux/ArgoCD)
                              │
                    自动 apply 到集群
GitOps 带来的核心收益:
- 完整的审计日志:谁、什么时候、改了什么、谁批准的——全在 Git 历史中
- 一键回滚:
git revert+ 自动 apply - 自愈能力:Operator 持续监控实际状态与 Git 声明的差异,自动修复漂移
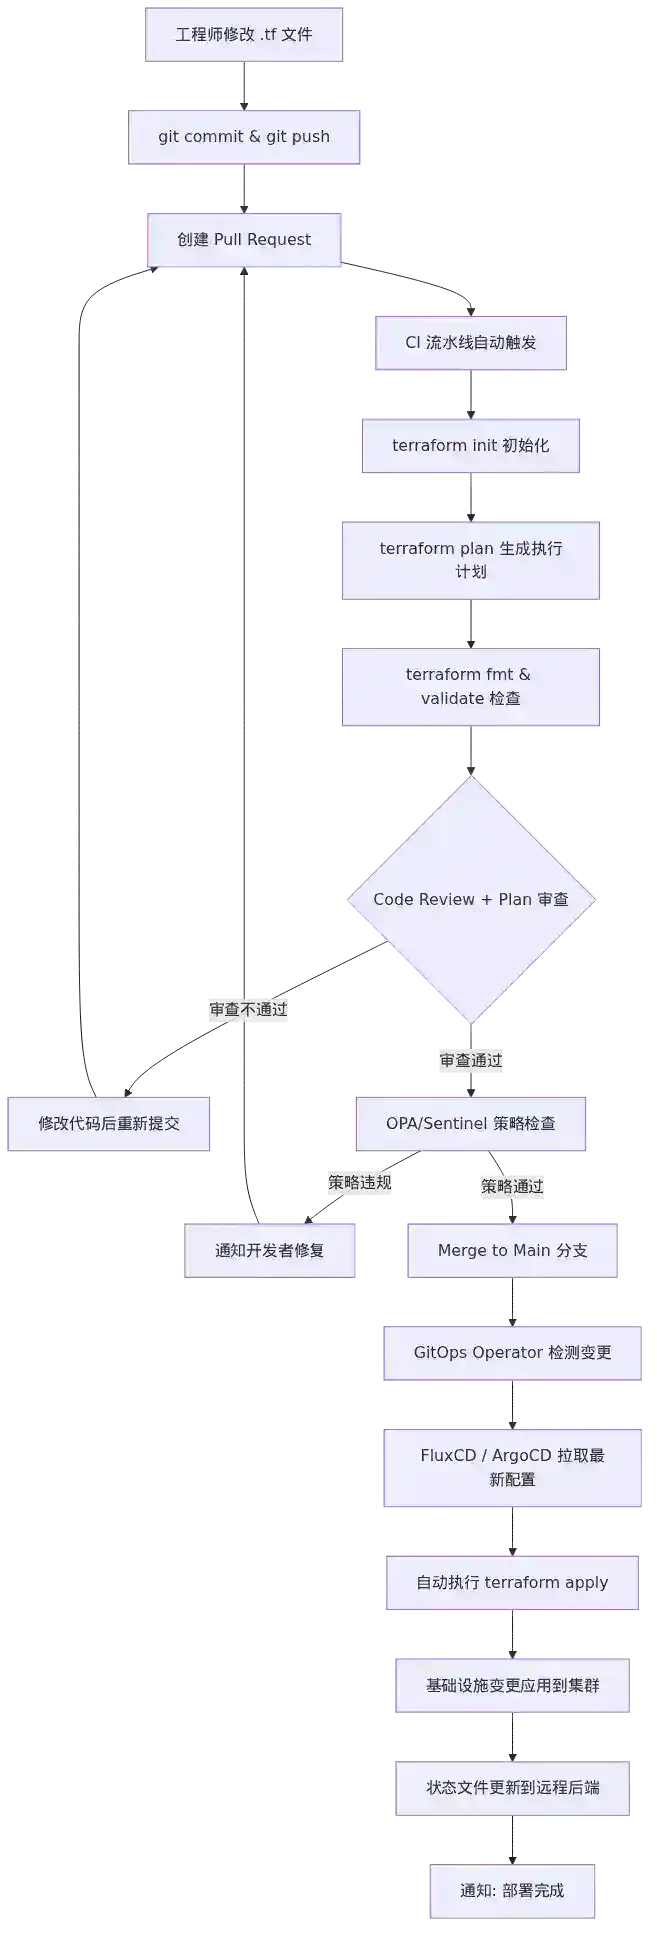
图6:GitOps 工作流完整流程图——从工程师修改.tf文件→创建PR→Code Review+Plan预览+策略检查→Merge to main→GitOps Operator(Flux/ArgoCD)→自动apply到集群的完整链路
六、漂移检测:基础设施的"熵增"问题
6.1 什么是配置漂移
**配置漂移(Configuration Drift)**是指基础设施的实际状态偏离了 IaC 代码定义的期望状态。这是 IaC 实践中最大的敌人之一。
漂移的来源:
| 来源 | 场景 | 严重程度 |
|---|---|---|
| 手动变更 | 有人直接登控制台改了一个安全组规则 | 🔴 高 |
| 外部系统 | 自动伸缩组因为负载增加而扩容 | 🟡 中 |
| 云平台变更 | AWS 弃用一个 AMI,实例被自动替换 | 🟡 中 |
| 部分 apply 失败 | terraform apply 中途失败,部分资源已创建 |
🔴 高 |
| 并发操作 | 两个人同时操作同一组资源 | 🔴 高 |
6.2 漂移检测的工作方式
┌─────────────┐     ┌─────────────┐
│ 状态文件     │     │ 云平台 API   │
│ (期望状态)   │     │ (实际状态)   │
└──────┬──────┘     └──────┬──────┘
       │                   │
       └─────────┬─────────┘
                 │
          ┌──────┴──────┐
          │  对比差异    │
          │terraform plan│
          │  -refresh    │
          └──────┬──────┘
                 │
          ┌──────┴──────┐
          │ 漂移检测结果  │
          │  ~ 已偏离    │
          │  + 多余资源  │
          │  - 缺失资源  │
          └─────────────┘
Terraform 的 plan 命令天然就是漂移检测工具——它刷新状态(重新查询云平台 API),然后将实际状态与配置文件对比。terraform plan -detailed-exitcode 返回码的设计就是为了漂移检测:
0:无变更,无漂移1:执行错误2:存在变更(漂移或有意变更)
6.3 漂移修复策略
发现漂移后,有三种处理方式:
策略一:调和(Reconcile)—— 将实际状态拉回配置状态
terraform apply -auto-approve
# 将实际基础设施恢复到代码定义的期望状态
策略二:吸收(Absorb)—— 将实际变更写入配置
# 手动修改 .tf 代码,使配置匹配实际状态
# 然后 terraform apply -refresh-only 更新状态文件
策略三:导入(Import)—— 将未管理的资源纳入管理
terraform import aws_security_group.extra sg-0abcd1234
# 将手动创建的资源纳入 IaC 管理
选择哪种策略取决于漂移的性质:
- 如果是未授权的变更 → 调和(恢复期望状态)
- 如果是必要的紧急修复 → 吸收(先记录再规范化)
- 如果是未管理的存量资源 → 导入(纳入 IaC 管理)
自动化漂移检测的典型实现:在 CI/CD 中定时运行 terraform plan -detailed-exitcode,退出码为 2 时发送告警。
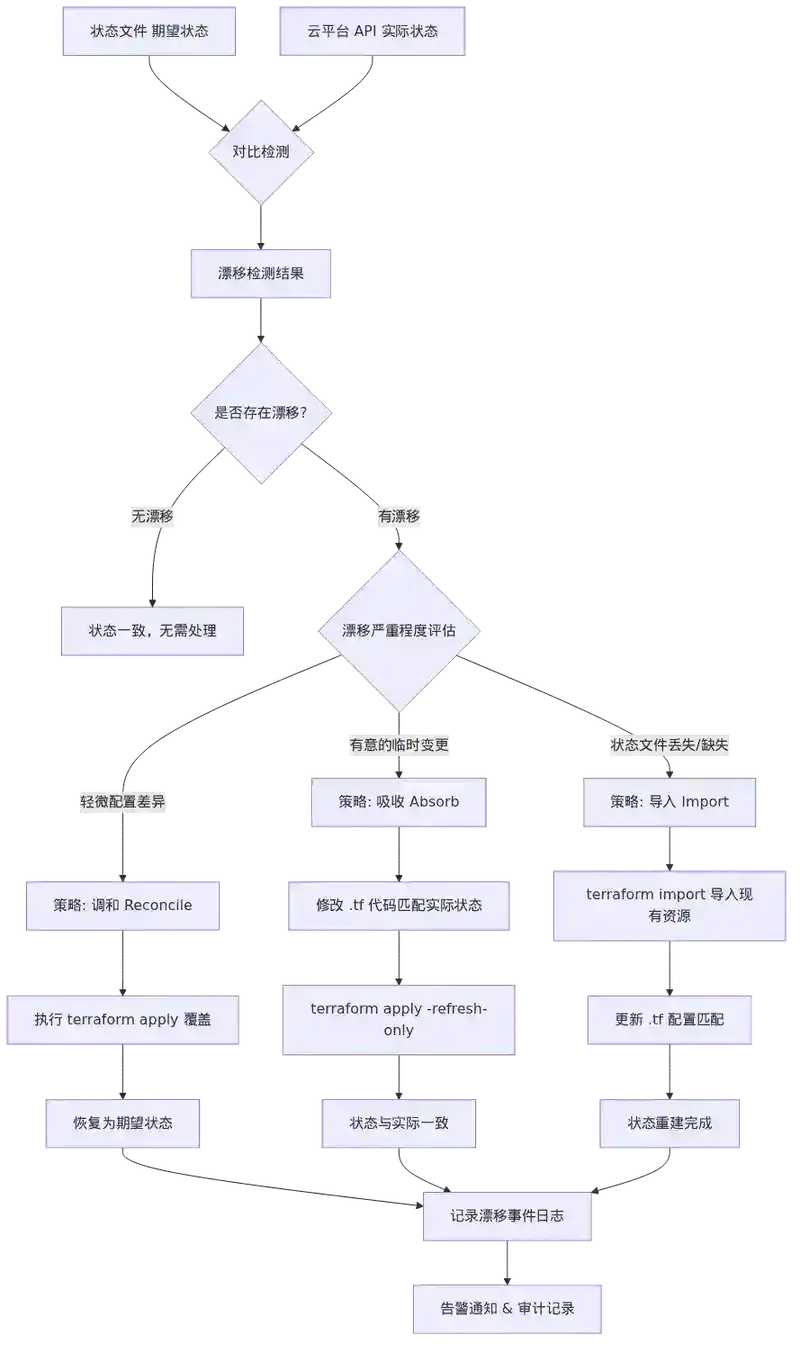
图7:配置漂移检测与修复流程图——状态文件(期望状态)与云平台API(实际状态)对比→漂移检测结果→三种修复策略(调和/吸收/导入)的决策流程
七、生产实践:从"能用"到"好用"
7.1 目录结构与环境隔离
IaC 仓库的目录结构决定了团队协作效率。推荐的结构:
terraform/
├── environments/
│   ├── dev/
│   │   ├── main.tf
│   │   ├── variables.tf
│   │   └── terraform.tfvars
│   ├── staging/
│   │   └── ...
│   └── prod/
│       └── ...
├── modules/
│   ├── networking/
│   │   ├── main.tf
│   │   ├── variables.tf
│   │   └── outputs.tf
│   ├── compute/
│   │   └── ...
│   └── database/
│       └── ...
└── global/
    └── iam/
        └── ...
关键原则:
- 每个环境使用独立的 state 文件(不同 S3 key 或不同 backend config)
- 模块封装可复用的基础设施模式
- 全局资源(IAM、Route53)与环境无关,独立管理
7.2 敏感信息管理
# ❌ 错误:硬编码密码
resource "aws_db_instance" "main" {
  password = "MyP@ssw0rd123!"  # 绝不能这样做
}

# ✅ 正确:从外部获取
variable "db_password" {
  type      = string
  sensitive = true
}

resource "aws_db_instance" "main" {
  password = var.db_password  # 从 CI 环境变量或 Vault 注入
}
敏感信息管理最佳实践:
- 使用
sensitive = true标记变量,防止在输出中打印 - 通过 CI 环境变量注入(GitHub Actions Secrets、GitLab CI Variables)
- 集成 Secret Manager(HashiCorp Vault、AWS Secrets Manager、Azure Key Vault)
- 使用
terraform_data或externaldata source 动态获取短期凭证
7.3 CI/CD 集成
# GitHub Actions 示例
name: Terraform CI/CD
on:
  pull_request:
    paths: ['terraform/**']

jobs:
  terraform:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: hashicorp/setup-terraform@v3

      - name: Terraform Fmt
        run: terraform fmt -check -recursive

      - name: Terraform Init
        run: terraform init

      - name: Terraform Validate
        run: terraform validate

      - name: Terraform Plan
        run: terraform plan -no-color -out=plan.tfplan
        # PR 中自动展示 Plan 输出

      - name: Terraform Apply
        if: github.ref == 'refs/heads/main'
        run: terraform apply -auto-approve plan.tfplan
7.4 模块版本管理
Terraform 模块应像应用库一样管理版本:
module "vpc" {
  source  = "app.terraform.io/my-org/vpc/aws"
  version = "~> 2.1.0"  # 锁定版本,允许补丁升级

  cidr_block = "10.0.0.0/16"
  region     = "us-east-1"
}
版本策略:
- 使用语义化版本(SemVer)
- 在环境配置中锁定模块版本,避免意外升级
- 使用 Renovate/Dependabot 自动管理模块版本更新
八、常见陷阱与故障案例
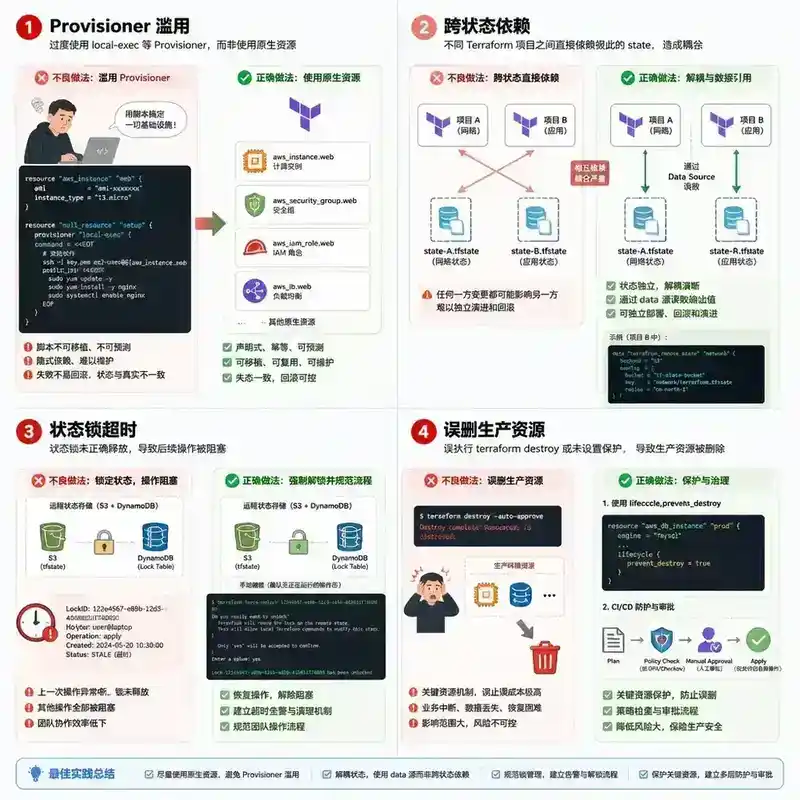
图9:IaC 常见陷阱与反模式视觉指南——四个典型陷阱(provisioner滥用、跨状态依赖、状态锁超时、误删生产资源)的场景图解和正确做法对比
陷阱一:把 Terraform 当 Shell 脚本用
# ❌ 反模式:用 provisioner 做所有事情
resource "aws_instance" "web" {
  ami = "ami-xxx"
  instance_type = "t3.micro"

  provisioner "remote-exec" {
    inline = [
      "sudo apt-get update",
      "curl -fsSL https://get.docker.com | sh",
      "docker run -d nginx",
      "aws s3 cp s3://my-bucket/config.yml /etc/app/config.yml",
      # ... 几十行 shell 命令
    ]
  }
}
问题:provisioner 破坏了声明式的幂等性。provisioner 只在资源创建时执行一次,后续修改配置不会触发重新执行。而且 provisioner 失败时 Terraform 将其标记为 tainted,下次 apply 会销毁并重建资源。
正确做法:用 Packer 预构建镜像,或用 cloud-init/userdata 在启动时配置,用 Ansible/Chef 做配置管理,用 Terraform 只管基础设施创建。
陷阱二:状态文件之间引入依赖
# ❌ 反模式:跨状态文件引用
data "terraform_remote_state" "networking" {
  backend = "s3"
  config = {
    bucket = "my-state"
    key    = "prod/networking/terraform.tfstate"
  }
}

resource "aws_instance" "web" {
  subnet_id = data.terraform_remote_state.networking.outputs.subnet_id
}
问题:创建了状态文件之间的硬依赖,导致:
- networking 的 state 变更可能影响所有依赖它的配置
- 无法独立销毁/重建某个环境的某一部分
- Plan 时必须能访问远程状态,增加 CI/CD 复杂度
正确做法:用数据源直接查询云平台获取信息(如 aws_subnet data source),或通过 SSM Parameter Store / Consul KV 共享输出。
故障案例一:状态锁超时导致生产中断
场景:某团队在 CI 中并行运行多个 Terraform apply,使用了 DynamoDB 状态锁。某次 apply 执行到一半时 CI runner 被 kill,DynamoDB 中的锁没有被释放。后续所有 apply 全部阻塞,持续 45 分钟,直到有人手动从 DynamoDB 中删除锁记录。
教训:
- 使用
terraform force-unlock命令手动释放锁(需要 Lock ID) - 设置合理的 CI 超时时间
- 监控状态锁的持有时间,超过阈值自动告警
故障案例二: 误删生产数据库
场景:工程师在本地开发时,错误地切换到了生产 workspace,执行了 terraform destroy。因为生产环境的 RDS 配置了 prevent_destroy = false(默认值),导致生产数据库被删除。
教训:
- 对关键资源使用
prevent_destroy = true生命周期钩子 - 启用
deletion_protection(RDS 原生功能) - 远程状态后端强制使用不同的 AWS 凭证(Assume Role),本地开发默认无生产权限
- 使用
terraform plan先预览,确认无误再 apply
九、总结
IaC 的核心价值不在于"自动化创建资源"——CLI 和 API 早就做到了。IaC 的价值在于:
- 声明式配置:描述"想要什么"而非"怎么做",让意图清晰、结果可预测
- 状态管理:精确追踪资源映射,使增量变更更可靠
- 变更审查:Plan 预览 + 策略即代码 + GitOps,让基础设施变更像代码一样安全
- 漂移检测:持续监控实际环境与配置的偏差,防止"熵增"失控
掌握 IaC 不仅是掌握一个工具,而是掌握一种思维方式——用软件工程的严谨方法管理基础设施的不确定性。
面试提问模块
以下问题从面试官视角出发,模拟真实面试场景。建议在阅读完正文后尝试回答,再对照参考要点。
Q1:Terraform 的**plan**命令输出了"资源将被替换"(forces replacement),但你在配置文件中只改了一个 tag。为什么一个 tag 的修改会导致资源重建?从 Terraform 的 Provider 实现机制角度解释。
Q2:你的团队有 15 个微服务,每个微服务都有自己的 Terraform 配置。有一个共享的 VPC 模块被所有服务引用。现在你需要升级 VPC 模块的版本,如何安全地完成这个升级而不影响所有服务?
Q3:一家公司使用 Terraform 管理 AWS 基础设施,但最近发现 S3 bucket 上多了几个手动创建的安全组规则。你如何设计一套漂移检测和自动修复机制?
Q4:Terraform 的状态文件中存储了数据库密码。一位工程师提议把状态文件提交到 Git 仓库以便于 Code Review 时查看 Plan 输出。你如何回应?
Q5:比较 Terraform 和 Pulumi 在 IaC 中的设计哲学差异。在什么场景下你会选择 Pulumi 而不是 Terraform?
Q6:你的团队正在从手动管理基础设施转向 IaC。有 200+ 个存量资源需要纳入 Terraform 管理。你会如何设计这个迁移方案?
Q7:一个 CI Pipeline 在执行**terraform apply**时因为网络超时失败,状态文件被部分更新(serial 增加了但部分资源未创建)。此时你执行**terraform plan**会看到什么?如何修复?
Q8:GitOps 要求 Git 仓库是唯一的真理之源。如果有人在生产环境中手动修改了 Kubernetes Deployment 的副本数(从 3 改为 5),ArgoCD 会如何处理?如果这个手动修改是紧急扩容的需要呢?
参考答案
Q1:Terraform 的**plan**命令输出了"资源将被替换"(forces replacement),但你在配置文件中只改了一个 tag。为什么一个 tag 的修改会导致资源重建?从 Terraform 的 Provider 实现机制角度解释。
参考答案:
Terraform Provider 中每个 resource schema 都定义了属性的 ForceNew 标记。当 ForceNew: true 时,该属性的任何变更都会触发资源重建(先销毁再创建),而不是原地更新。这是因为某些云平台 API 不支持对特定属性进行原地修改。
具体到 tag 场景,有三类典型情况:
- 看似是 tag,实则不是:修改
aws_launch_template的tag_specifications(而非tags),或者修改aws_autoscaling_group中launch_template的关联 tag——ASG 的 launch template 变更会触发实例刷新,表现为"资源重建"。 - 嵌套资源的 tag:修改
aws_instance的volume_tags而非tags——volume_tags会触发 EBS 卷的替换,进而导致实例重建。 - Provider 版本差异:某些 Provider 的早期版本将 tag 标记为
ForceNew: true(出于安全考虑),升级 Provider 版本后可能改为原地更新。
从 Provider 实现角度:Provider 在 plan 阶段对比新旧属性值(Diff),如果任何一个 ForceNew: true 的属性发生变化,就在 Plan 中标记该资源为 -/+ destroy then create。这个决策发生在 Provider 的 Schema 层,与 CRUD 函数无关——Provider 在调用 Create/Update API 之前就已经决定了"替换"策略。
延伸思考:面试官可能进一步追问"如何避免资源被意外重建?"——答案是使用 lifecycle { ignore_changes = [tags] } 忽略特定属性的变更,或使用 terraform state mv 迁移资源地址。
Q2:你的团队有 15 个微服务,每个微服务都有自己的 Terraform 配置。有一个共享的 VPC 模块被所有服务引用。现在你需要升级 VPC 模块的版本,如何安全地完成这个升级而不影响所有服务?
参考答案:
核心策略是渐进式升级 + 向后兼容。具体步骤:
1. 确保向后兼容(最重要)
新版本 VPC 模块的 output 必须与旧版本完全兼容——不删除、不重命名任何 output。如果新增了资源,通过 count 或 for_each 条件创建,默认值为 0(不创建),确保现有服务的 plan 输出为 No changes。
2. 金丝雀升级
选择一个非关键服务(如 dev 环境的某个低流量服务)先升级 VPC 模块版本,运行 terraform plan 确认无 destructive changes,然后 apply。观察 24-48 小时后再推广。
3. 使用**moved**块处理资源地址变更
如果 VPC 模块内部重构了资源命名,使用 moved 块声明旧地址到新地址的映射,避免 Plan 中出现 destroy + create:
moved {
  from = module.vpc.aws_subnet.public[0]
  to   = module.vpc.aws_subnet.public_a
}
4. 逐环境逐服务推进
升级顺序:dev → staging → prod,每个环境内按服务逐个升级。在 CI 中为每个服务运行 terraform plan,如果 plan 输出为空,则该服务升级安全。
5. 版本锁定与回滚
在模块仓库中使用 Git tags 和语义化版本。每个服务的 source 锁定到具体版本(如 version = "~> 2.1.0")。如果升级出现问题,回退到旧版本并 terraform apply。
延伸思考:面试官可能追问"如果 VPC 模块的破坏性变更无法避免(如 CIDR 变更)怎么办?"——回答是:创建新的 VPC 模块(v2),在新 VPC 中创建资源,通过 DNS 或负载均衡器逐步切换流量,最后销毁旧 VPC。这是蓝绿部署在基础设施层面的应用。
Q3:一家公司使用 Terraform 管理 AWS 基础设施,但最近发现安全组中多了几个手动创建的规则。你如何设计一套漂移检测和自动修复机制?
参考答案:
首先纠正一个常见误区:S3 bucket 的安全控制是通过 Bucket Policy 和 ACL 实现的,安全组(Security Group)是 EC2/VPC 层面的资源。如果问题是"安全组中多了手动添加的规则",机制如下:
1. 漂移检测
在 CI/CD 中配置定时任务(建议每小时),执行:
terraform plan -detailed-exitcode
# 退出码 0 = 无变更,1 = 错误,2 = 存在漂移
退出码为 2 时将 Plan 输出发送到监控告警渠道(Slack/钉钉/PagerDuty)。
2. 自动修复
- 方案 A(Terraform Cloud/Enterprise):开启 "Auto Apply" 和 "Drift Detection",检测到漂移后自动执行
terraform apply恢复。 - 方案 B(开源):使用 Atlantis + webhook 或自定义 CronJob,检测到漂移后自动执行
terraform apply -auto-approve。 - 方案 C(GitOps):使用 Crossplane 或 Flux Terraform Controller,通过 reconciliation loop 持续修复漂移。
3. 根因追踪
- 启用 AWS CloudTrail 记录所有 API 调用(特别是
AuthorizeSecurityGroupIngress事件) - 当检测到漂移时,通过 CloudTrail 日志追溯:谁、什么时间、从哪个 IP、做了什么修改
- 结合 IAM 策略限制手动修改安全组的权限
4. 预防措施
- 通过 SCP (Service Control Policy) 或 IAM Permission Boundary 限制生产环境安全组修改权限
- 只允许 Terraform 使用的 IAM Role 修改安全组,回收所有人类的
ec2:AuthorizeSecurityGroupIngress权限 - 对安全组资源添加
prevent_destroy生命周期钩子,防止误删
延伸思考:面试官可能追问"如果你发现漂移是因为有人通过 AWS Console 添加了一条合法的紧急规则,但你的自动修复却把它删掉了,怎么办?"——答案是:自动修复应该配合告警,先告警再人工确认。或者在自动修复前记录 CloudTrail 事件,如果发现是特定 on-call 工程师的操作,则暂停自动修复并升级通知。
Q4:Terraform 的状态文件中存储了数据库密码。一位工程师提议把状态文件提交到 Git 仓库以便于 Code Review 时查看 Plan 输出。你如何回应?
参考答案:
坚决反对,这是安全红线。原因:
- 明文敏感信息泄露:状态文件包含所有资源的完整属性(数据库密码、API 密钥、TLS 私钥等),全部以明文存储。提交到 Git 意味着这些信息永久存储在 Git 历史中,即使后续删除也难以彻底清除(
git filter-branch/BFG Repo-Cleaner操作复杂且有风险)。 - 访问控制粒度不足:Git 仓库的访问控制(通常以 repo 为单位)远不如远程状态后端精细。S3 + IAM 可以做到"只有 Terraform CI Role 能读写状态文件",而 Git 仓库通常有更多协作者有读取权限。
- Plan 输出不需要状态文件:Plan 的输出可以通过 CI 自动生成并作为 PR Comment 展示。使用
terraform plan的 stdout 输出或terraform show -json plan.tfplan即可获得完整的变更预览,无需访问状态文件本身。
正确做法:
- 使用远程状态后端(S3 + DynamoDB),启用 SSE-KMS 服务端加密
- 通过 IAM 策略严格控制状态文件的读写权限(CI Role 可读写,人类只读或不可读)
- 在 CI 中通过 OIDC + Assume Role 获取临时凭证
- 使用
sensitive = true标记包含敏感信息的变量,防止在 Plan 输出中打印 - 敏感数据(密码、密钥)通过 HashiCorp Vault/AWS Secrets Manager 动态获取,而非写入状态文件
延伸思考:面试官可能追问"如果状态文件已经在 Git 中了怎么办?"——回答:立即轮换所有泄露的密码和密钥;使用 git filter-branch 或 BFG Repo-Cleaner 清除 Git 历史中的敏感信息;强制推送并通知所有协作者重新 clone;配置远程状态后端并迁移。
Q5:比较 Terraform 和 Pulumi 在 IaC 中的设计哲学差异。在什么场景下你会选择 Pulumi 而不是 Terraform?
参考答案:
设计哲学差异:
| 维度 | Terraform | Pulumi |
|---|---|---|
| 配置语言 | 声明式 DSL(HCL) | 通用编程语言(TS/Python/Go/C#/Java) |
| 核心理念 | "配置即数据"——配置描述期望状态,引擎负责计算差异 | "基础设施即软件"——用熟悉的语言、工具、抽象管理基础设施 |
| 语言能力 | 刻意限制(变量、表达式、count/for&#95;each),拒绝图灵完备 |
完全图灵完备(循环、条件、函数、类、继承) |
| 可读性 | 对非开发者友好(PM/SRE 也能看懂) | 需要编程能力,但 IDE 支持更好 |
| 测试 | 有限(terraform test 是较新的功能) |
天然支持(用标准测试框架写单元测试) |
| 抽象能力 | 模块(Module) | 类、接口、依赖注入、包管理 |
选择 Pulumi 的场景:
- 团队已深度使用 TypeScript/Python/Go,不想学 HCL
- 基础设施逻辑复杂——需要大量条件判断、循环、动态生成,HCL 的
count/for_each/dynamic无法优雅表达 - 基础设施和应用代码紧密耦合——比如在同一个项目里定义 Lambda 函数代码和它的基础设施配置
- 需要写自动化测试——用 Mocha/Jest/pytest 测试基础设施代码
- 需要复用已有的编程抽象(类、接口、策略模式)来组织基础设施代码
选择 Terraform 的场景:
- 团队需要声明式配置的纯粹性和确定性——配置应该只描述"是什么",不应包含任意逻辑
- 多人协作——HCL 可读性高,非开发者也能参与 Code Review
- Provider 生态更成熟,社区模块更丰富
- 组织已有 Terraform 技术积累,迁移成本高
延伸思考:面试官可能追问"Pulumi 的图灵完备性引入什么风险?"——回答:配置中可能引入 bug(死循环、空指针、复杂的条件逻辑),使 Plan 的确定性降低;不同工程师写的 TypeScript 代码风格差异大,增加 Code Review 难度。
Q6:你的团队正在从手动管理基础设施转向 IaC。有 200+ 个存量资源需要纳入 Terraform 管理。你会如何设计这个迁移方案?
参考答案:
阶段一:资源盘点(1-2 天)
使用 terraformer 或 former2 扫描现有云账号,生成完整的资源清单(资源类型、ID、依赖关系、所属环境)。按服务/环境分组,绘制资源依赖图。
阶段二:风险分级(半天)
| 级别 | 标准 | 示例 | 策略 |
|---|---|---|---|
| 🟢 低风险 | 独立资源,无状态或可重建 | S3 bucket(非生产数据)、IAM Role | 可先行导入,快速验证流程 |
| 🟡 中风险 | 有依赖但可短暂停机 | 非关键 EC2 实例、开发环境 RDS | 在维护窗口导入 |
| 🔴 高风险 | 核心数据库、生产网络组件 | 生产 RDS、VPC、NAT Gateway | 最后导入,需要详细验证 |
阶段三:逐层导入(1-2 周)
从底层向上层导入(遵循依赖拓扑排序):
- 网络层:VPC → 子网 → 路由表 → Internet/NAT Gateway → VPC Endpoint
- 安全层:安全组 → NACL → IAM Role/Policy
- 计算层:EC2 → Auto Scaling Group → Load Balancer → ECS/EKS
- 数据层:RDS → ElastiCache → S3 → DynamoDB
阶段四:验证闭环(每个资源导入后)
# 1. 导入资源
terraform import aws_vpc.main vpc-0abcd1234

# 2. 验证:Plan 输出应为 No changes
terraform plan
# 如果 Plan 显示变更,说明 .tf 配置与实际资源不一致,修正配置

# 3. 导入后立即在 .tf 中添加 lifecycle 防止误删
lifecycle {
  prevent_destroy = true  # 关键资源
}
阶段五:分环境切换
导入顺序:dev → staging → prod。每个环境导入完成后,运行完整的 terraform plan 验证。
阶段六:双轨运行 + 冻结手动变更
- 导入后保持 1-2 周的观察期,监控是否有意外变更
- 冻结对应资源的手动变更权限,要求所有变更必须通过 Terraform
- 在 CloudTrail 中监控手动操作,发现后告警
关键风险点:
terraform import只导入资源到状态文件,不会自动生成.tf配置——需要手动编写或使用terraformer生成- 导入 RDS 等关键资源前,确保
prevent_destroy = true和deletion_protection = true - 资源之间的隐式依赖(如安全组引用)需要在
.tf中显式声明
延伸思考:面试官可能追问"如果迁移过程中发现一个资源同时被两个 Terraform workspace 引用怎么办?"——回答:评估是否可以拆分为独立 state;如果不能,使用 terraform_remote_state data source 或 SSM Parameter Store 共享资源信息。
Q7:一个 CI Pipeline 在执行**terraform apply**时因为网络超时失败,状态文件被部分更新(serial 增加了但部分资源未创建)。此时你执行**terraform plan**会看到什么?如何修复?
参考答案:
Plan 会看到什么:
Terraform 的 apply 过程是:更新状态文件 serial → 调用 Provider API 创建/修改资源 → 成功后更新状态文件中的资源属性。如果网络在 Provider API 调用中途超时:
- 状态文件中的资源属性可能是旧的(未被更新)或不完整的
- 但云平台上资源可能已经部分创建或修改成功
执行 terraform plan 时,Terraform 会先 refresh(查询云平台 API 获取实际状态),然后对比。三种可能的结果:
| 场景 | 云平台状态 | 状态文件 | Plan 表现 |
|---|---|---|---|
| API 调用成功,状态更新失败 | 资源已创建 | 资源未记录 | "资源已存在但不在状态中"(报错)或显示需要创建(但创建会报 AlreadyExists) |
| API 调用失败,资源未创建 | 资源不存在 | 资源未记录 | 正常显示"需要创建" |
| API 调用部分成功 | 资源部分创建 | 部分记录 | 状态不一致,Plan 可能报错或显示需要 update |
修复步骤:
# 步骤 1:强制刷新状态(从云平台同步实际状态)
terraform refresh

# 步骤 2:运行 Plan 查看差异
terraform plan
# 分析 Plan 输出,判断哪些资源已创建、哪些未创建

# 步骤 3:根据 Plan 结果处理
# 场景 A:资源已创建但状态未记录 → 导入
terraform import aws_instance.web i-0abcd1234

# 场景 B:资源未创建 → 正常 apply
terraform apply

# 场景 C:状态文件损坏 → 从远程后端恢复
# S3 后端:从 S3 版本历史中恢复上一个版本的 state 文件
# 然后重新 terraform refresh + plan
如果状态文件损坏严重:
- 从远程状态后端的版本历史中恢复上一个版本
terraform refresh强制同步terraform plan查看剩余差异- 手动
import或apply修复
预防措施:
- 使用远程状态后端(S3 + DynamoDB),利用 S3 版本管理
- 在 CI 中设置合理的超时时间(Terraform apply 的
-lock-timeout参数) - 对关键资源的 apply 添加
-parallelism=1减少并发风险
延伸思考:面试官可能追问"如果 terraform refresh 也超时怎么办?"——回答:使用 terraform plan -refresh=false 跳过刷新,直接对比状态文件与配置;或使用 terraform state list 检查状态文件中有哪些资源,手动通过云平台 Console/CLI 验证每个资源是否存在。
Q8:GitOps 要求 Git 仓库是唯一的真理之源。如果有人在生产环境中手动修改了 Kubernetes Deployment 的副本数(从 3 改为 5),ArgoCD 会如何处理?如果这个手动修改是紧急扩容的需要呢?
参考答案:
正常情况下的处理:
ArgoCD 默认每 3 分钟执行一次自愈循环(reconciliation loop)。它对比 Git 仓库中的期望状态与集群中的实际状态,发现差异后自动将集群状态恢复到 Git 声明的状态。所以手动修改的副本数(5)会在 3 分钟内被自动改回 3。
这个过程的详细步骤:
- ArgoCD 检测到集群中 Deployment 的
spec.replicas=5与 Git 中spec.replicas=3不一致 - ArgoCD 将 Application 状态标记为
OutOfSync - 如果开启了 Auto Sync,ArgoCD 自动执行
kubectl apply,将 replicas 改回 3 - 如果未开启 Auto Sync,ArgoCD 只标记状态,不自动修复
紧急扩容的正确处理:
方案 A(推荐):通过 Git 变更
# 1. 修改 Git 中 Deployment YAML 的 replicas: 3 → 5
# 2. 创建 PR(紧急时可跳过 Code Review,使用 Admin Merge)
# 3. Merge 后 ArgoCD 自动同步到集群
# 整个过程耗时约 1-2 分钟(取决于 CI + ArgoCD sync interval)
方案 B(紧急临时方案):
# 1. 手动扩容
kubectl scale deployment/my-app --replicas=5

# 2. 同时立即创建 PR 将变更写入 Git
# 3. ArgoCD 下次同步时发现 Git 中也是 replicas=5,不会回滚
方案 C:暂停 ArgoCD 自动同步
# 临时关闭自动同步
argocd app set my-app --sync-policy none

# 手动扩容
kubectl scale deployment/my-app --replicas=5

# 更新 Git 配置
# 恢复自动同步
argocd app set my-app --sync-policy automated
设计层面的最佳实践:
对于需要动态调整的资源(如副本数),不应该依赖 Git 中的静态值:
# ✅ 推荐:GitOps 管理 HPA 配置,实际副本数由 HPA 动态调整
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
spec:
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 70
这样 GitOps 管理的是"自动伸缩策略"(min/max replicas),实际副本数由 HPA 根据负载动态调整,无需手动干预。
延伸思考:面试官可能追问"如果 ArgoCD 本身因为网络问题无法连接到 Git 仓库,但集群中的 HPA 需要扩容,会发生什么?"——回答:ArgoCD 的 reconciliation loop 会失败,Application 状态变为 Unknown,但已部署的 HPA 仍然在集群中独立运行,不受 ArgoCD 影响。HPA 会继续根据 CPU 指标扩容,只是这个状态变更不会被 ArgoCD 感知到。当 Git 连接恢复后,ArgoCD 会重新同步。