一、零拷贝不是"不拷贝",而是"减少不必要的拷贝"
零拷贝(Zero-Copy)是 I/O 性能优化中最重要的技术之一。它的名字容易让人误解——不是真的零次拷贝,而是消除 CPU 参与的数据拷贝,让数据直接在 DMA 控制器和内核缓冲区之间传输,让 CPU 去做更有价值的事情。
在传统的文件传输场景中(比如 Web 服务器读取磁盘文件发送给客户端),数据需要经过多次拷贝和上下文切换。零拷贝技术通过 mmap、sendfile 等机制,将拷贝次数从 4 次降到 2 次甚至 0 次(CPU 视角),将上下文切换次数从 4 次降到 2 次。
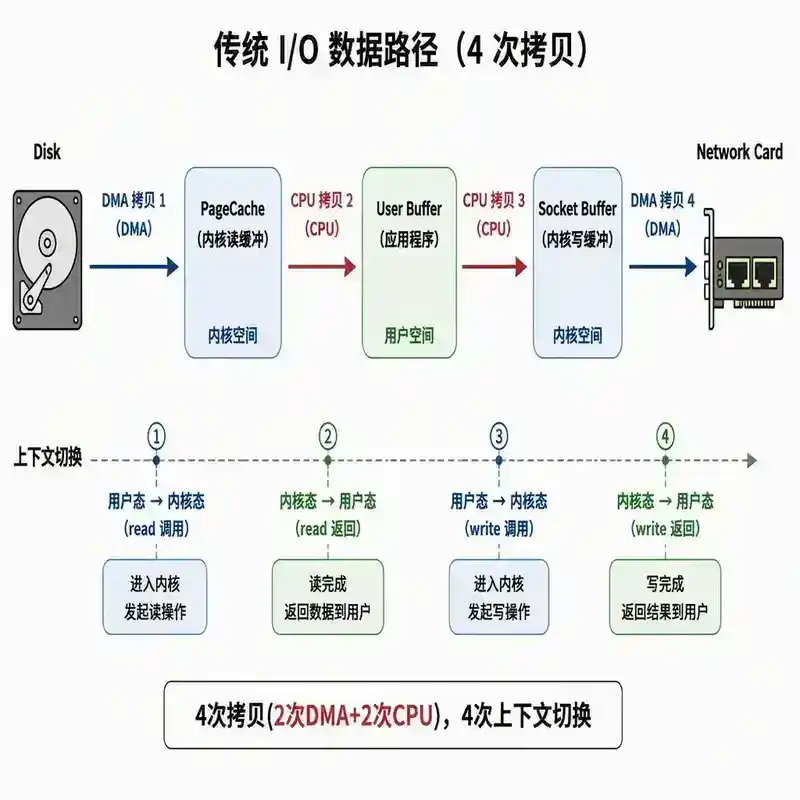
二、传统 I/O 的数据路径:4 次拷贝,4 次上下文切换
以 Web 服务器读取磁盘文件并发送给客户端为例,传统 I/O 的完整数据路径:
read(file, buf, len);
write(socket, buf, len);

数据路径:
1. DMA 拷贝:磁盘 -> 内核读缓冲区(PageCache)
2. CPU 拷贝:内核读缓冲区 -> 用户态 buf(应用程序缓冲区)
3. CPU 拷贝:用户态 buf -> 内核写缓冲区(Socket Buffer)
4. DMA 拷贝:内核写缓冲区 -> 网卡

上下文切换:
1. 用户态 -> 内核态(read 系统调用)
2. 内核态 -> 用户态(read 返回)
3. 用户态 -> 内核态(write 系统调用)
4. 内核态 -> 用户态(write 返回)
问题分析:第 2 步和第 3 步的 CPU 拷贝是多余的——应用程序只是把数据从文件传递到 Socket,并没有修改数据。CPU 不应该参与这种"搬运工"的工作。
[图1:传统I/O数据路径图——四次拷贝(DMA+CPU),四次上下文切换]
三、mmap + write:减少一次 CPU 拷贝
mmap(Memory Mapped File)将文件映射到进程的虚拟地址空间,使得应用程序可以像访问内存一样访问文件。读操作不再需要将数据从 PageCache 拷贝到用户态 buf——用户态 buf 直接映射到 PageCache。
buf = mmap(file, len);
write(socket, buf, len);

数据路径:
1. DMA 拷贝:磁盘 -> PageCache
2. CPU 拷贝:PageCache -> Socket Buffer(通过 write 系统调用)
3. DMA 拷贝:Socket Buffer -> 网卡
mmap 减少了 1 次 CPU 拷贝,但上下文切换仍然是 4 次。mmap 的局限:文件被截断时可能引发 SIGBUS 信号,不适合频繁修改的小文件。
四、sendfile:真正的零拷贝(CPU 视角)
sendfile 是 Linux 2.1 引入的系统调用,专门为"文件到 Socket"的数据传输场景设计:
sendfile(socket, file, offset, len);
sendfile 2.1(2 次拷贝,2 次上下文切换):1. DMA 拷贝:磁盘 -> PageCache。2. CPU 拷贝:PageCache -> Socket Buffer。3. DMA 拷贝:Socket Buffer -> 网卡。
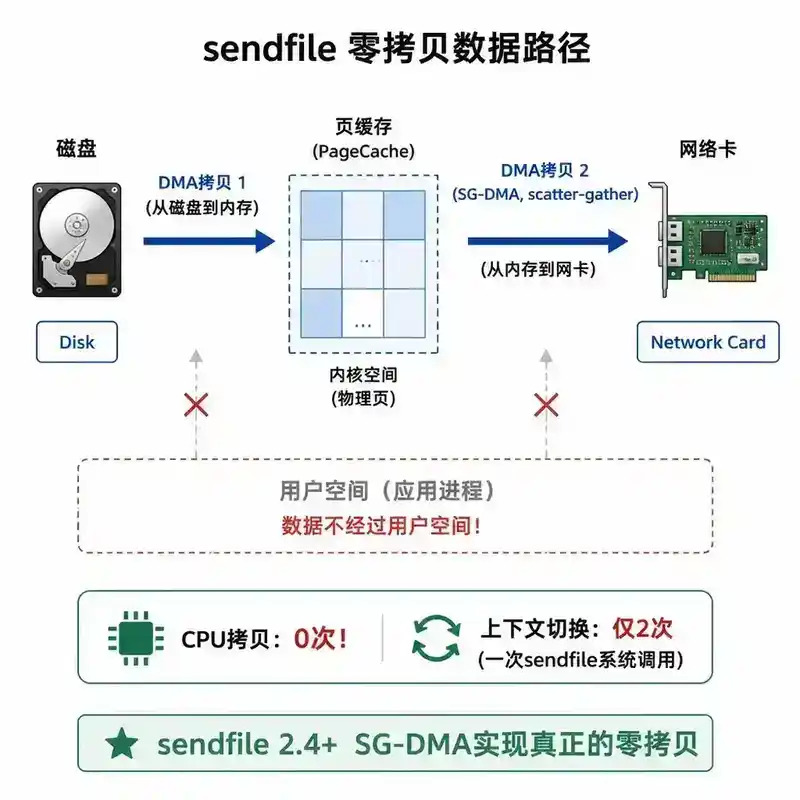
sendfile 2.4+(SG-DMA,0 次 CPU 拷贝):Linux 2.4 内核引入了 SG-DMA(Scatter-Gather DMA),Socket Buffer 不再需要存储完整的数据副本,只需存储指向 PageCache 中数据的描述符。DMA 引擎直接从 PageCache 收集数据发送到网卡。CPU 拷贝:0 次!这就是真正的"零拷贝"。
sendfile 的局限:只能从文件到 Socket,不能修改数据,不支持加密。
[图2:sendfile零拷贝数据路径图——SG-DMA实现0次CPU拷贝,2次上下文切换]
五、DirectByteBuffer:Java 层面的零拷贝
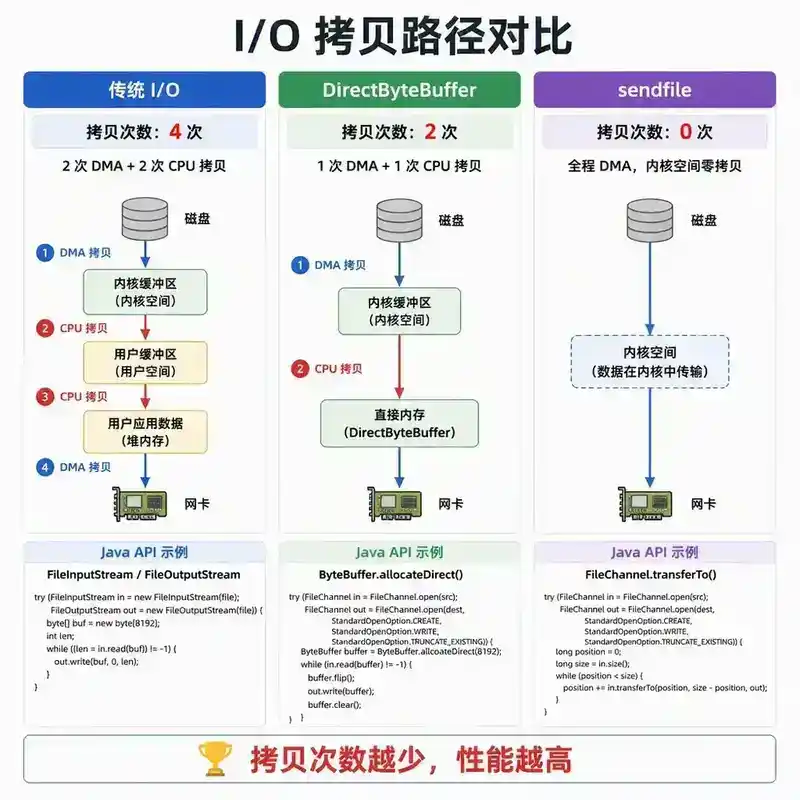
Java 的 DirectByteBuffer 不经过 JVM 堆内存,I/O 操作时数据直接在堆外内存和内核之间传输。
// 堆内存 Buffer:3 次拷贝
FileChannel.read(heapBuffer);  // 内核 -> 堆外临时缓冲区 -> 堆内存
SocketChannel.write(heapBuffer);  // 堆内存 -> 堆外临时缓冲区 -> 内核

// 直接内存 Buffer:2 次拷贝
FileChannel.read(directBuffer);  // 内核 -> 堆外直接内存
SocketChannel.write(directBuffer);  // 堆外直接内存 -> 内核
DirectByteBuffer 减少了一次从堆内存到堆外内存的拷贝,但数据仍然经过用户空间(堆外内存),不是 sendfile 那种真正的零拷贝。FileChannel.transferTo/transferFrom 是 Java 对 sendfile 的封装——在支持 sendfile 的平台上,这是真正的零拷贝。
[图3:三种I/O拷贝路径对比——传统I/O(4次) vs DirectByteBuffer(2次) vs sendfile(0次CPU拷贝)]
六、Netty 的零拷贝策略
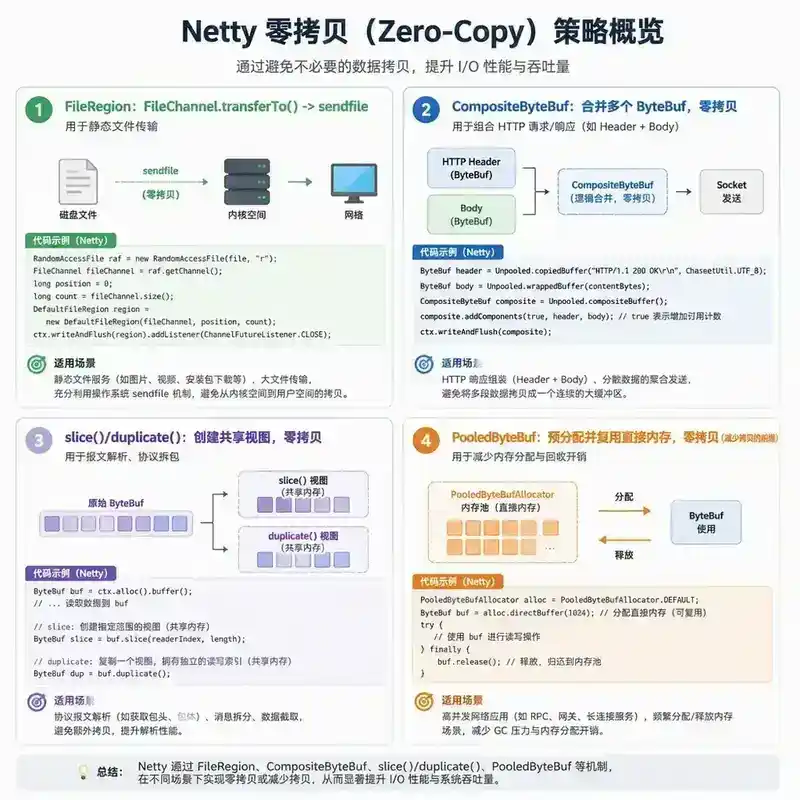
Netty 在多个层面使用了零拷贝技术:
- FileRegion:封装 FileChannel.transferTo,用于文件到网络的零拷贝传输。
- CompositeByteBuf:将多个 ByteBuf 合并为一个逻辑 ByteBuf,不实际拷贝数据。HTTP 响应由 Header 和 Body 组成,CompositeByteBuf 合并它们不需要拷贝。
- ByteBuf.slice() 和 duplicate():创建已有 ByteBuf 的视图,共享底层数据,不拷贝。适合分包解析。
- 池化内存:PooledByteBufAllocator 预分配和复用直接内存,减少分配/释放开销。
[图4:Netty零拷贝技术全景图——FileRegion/CompositeByteBuf/slice/PooledByteBuf四种策略]
七、Kafka 的零拷贝实现
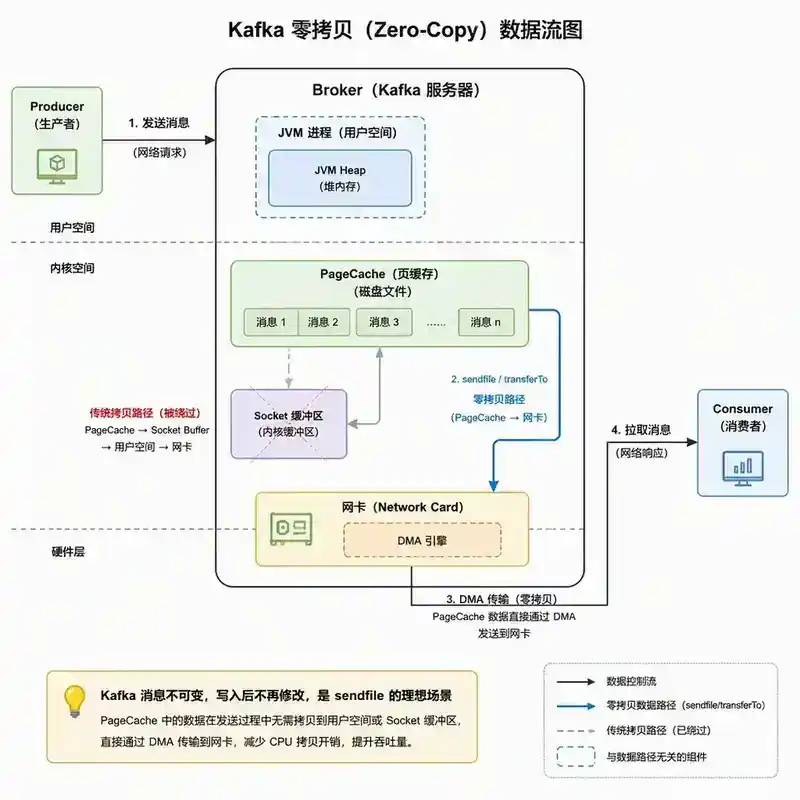
Kafka 的零拷贝是其高性能的核心技术之一。生产者发送的消息写入磁盘(PageCache),Kafka 依赖操作系统的 PageCache 而非 JVM 堆内存。消费者拉取时,Kafka 调用 FileChannel.transferTo()(底层 sendfile),数据从 PageCache 直接 DMA 传输到网卡,不经过用户空间,零 CPU 拷贝。
为什么 Kafka 能这样做:Kafka 的消息是"不可变"的——写入后不再修改,消费者拉取的是原始数据,不需要在应用层做任何修改。这恰好是 sendfile 的理想场景。
[图5:Kafka零拷贝数据流图——Producer→Broker PageCache→Consumer的sendfile路径]
八、mmap vs sendfile 的选择
| 维度 | mmap + write | sendfile |
|---|---|---|
| CPU 拷贝次数 | 1 次 | 0 次(2.4+) |
| 上下文切换 | 4 次 | 2 次 |
| 数据修改 | 支持 | 不支持 |
| 适用场景 | 需要修改数据 | 纯转发(文件到 Socket) |
| 小文件 | 映射开销大 | 适合 |
选择原则:纯转发场景(静态文件服务器、Kafka Consumer)用 sendfile;需要修改数据(添加 HTTP 头、加密)用 mmap 或传统 I/O。
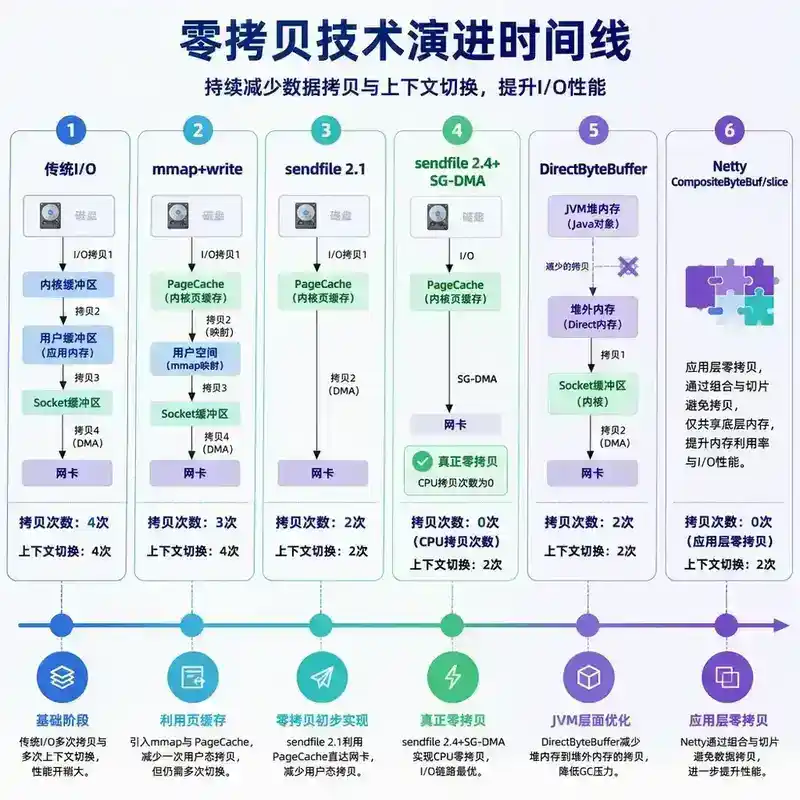
[图6:零拷贝技术演进路线图——传统I/O→mmap→sendfile→DirectByteBuffer→Netty应用层零拷贝]
九、面试常见误区
- "零拷贝就是零次拷贝" —— 不准确。零拷贝是零次 CPU 拷贝,DMA 拷贝仍然存在。
- "DirectByteBuffer 就是零拷贝" —— 不准确。DirectByteBuffer 减少了一次拷贝,但不是 sendfile 那种真正的零拷贝。
- "sendfile 可以用于所有场景" —— 不对。sendfile 只能用于文件到 Socket,且不能修改数据。
- "mmap 一定比传统 I/O 快" —— 对于小文件,传统 I/O 的一次拷贝开销可能小于 mmap 的缺页中断和 TLB 刷新开销。
十、总结
零拷贝技术的演进体现了"让数据走最短路径"的设计哲学:
- 传统 I/O:4 次拷贝,4 次上下文切换。CPU 做了太多"搬运工"的工作。
- mmap + write:3 次拷贝,4 次上下文切换。减少了一次 CPU 拷贝。
- sendfile 2.1:2 次拷贝,2 次上下文切换。合并了 read 和 write 为一次系统调用。
- sendfile 2.4+(SG-DMA):0 次 CPU 拷贝,2 次上下文切换。真正的零拷贝。
- DirectByteBuffer:在 Java 层面减少堆内存到堆外内存的拷贝。
- Netty CompositeByteBuf/slice:在应用层面减少 ByteBuf 之间的拷贝。
选择原则:能不改数据的场景用 sendfile(Kafka、静态文件服务器),需要修改数据的场景用 DirectByteBuffer(Netty 网络通信),需要合并多个缓冲区的场景用 CompositeByteBuf。
延伸阅读
- Linux man page:sendfile(2)、mmap(2)
- Netty 源码:FileRegion、CompositeByteBuf
- Kafka 文档:zero-copy 数据传输
- 本系列相关篇目:072(NIO 核心组件)、073(多路复用机制)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对零拷贝技术的深度理解和实战应用。
Q1:sendfile 在 Linux 2.4+ 实现了真正的零拷贝(0 次 CPU 拷贝),但你在 HTTPS 场景下发现 sendfile 无法使用。为什么?有什么替代方案?
sendfile 不能用于 HTTPS 的原因:TLS/SSL 加密必须在应用层完成——数据需要经过 CPU 加密后再发送。sendfile 的数据直接从 PageCache 到网卡,不经过用户空间,CPU 无法在中途对数据加密。如果强行使用 sendfile,发送的是明文数据。替代方案:1)使用 kernel TLS(kTLS)——Linux 4.13+ 支持内核态 TLS 加密,可以将加密操作卸载到内核,与 sendfile 配合使用。2)使用 TLS 硬件加速卡(如 Intel QAT),将加密操作卸载到专用硬件。3)如果无法使用 kTLS,退回到 mmap + write 方案——mmap 将数据映射到用户空间后加密,然后通过 write 发送。4)使用 sendmsg + MSG_ZEROCOPY(Linux 4.14+)——虽然不是 sendfile,但也能减少拷贝次数。
Q2:Kafka 使用 sendfile 实现零拷贝,但如果 Kafka 开启了消息压缩(如 gzip),sendfile 还能用吗?为什么?
不能。Kafka 的零拷贝依赖于消息的"不可变性"——消息从 Producer 写入后不再修改,Consumer 直接读取原始数据。但如果 Kafka 开启了消息压缩,压缩逻辑在 Broker 上可能需要对消息进行解压和重新压缩(比如不同 Producer 的消息需要合并压缩),这需要 CPU 修改数据,sendfile 就无法使用了。Kafka 的解决方案:使用"端到端压缩"(Producer 压缩后发送,Broker 不解压直接存储,Consumer 解压),这样 Broker 仍然可以透明地使用 sendfile。这就是为什么 Kafka 推荐使用 Producer 端压缩而非 Broker 端压缩——既保证了压缩比,又保留了零拷贝的能力。
Q3:你在一个高并发 Web 服务器上使用 FileChannel.transferTo 发送静态文件,但发现传输大文件(> 2GB)时 transferTo 返回的值小于文件大小,只传输了一部分。为什么?怎么处理?
FileChannel.transferTo 在 Linux 上底层调用 sendfile,sendfile 单次传输的最大值是 2GB(INT_MAX 的限制)。对于超过 2GB 的文件,需要分多次传输。标准做法是在循环中调用 transferTo,每次传输返回值指定的字节数,直到传输完成:
long position = 0;
long count = fileChannel.size();
while (position < count) {
    long transferred = fileChannel.transferTo(position, count - position, socketChannel);
    if (transferred <= 0) break;
    position += transferred;
}
Netty 的 FileRegion 已经封装了这种循环逻辑,直接使用 FileRegion 即可。另外,如果使用非阻塞 SocketChannel,transferTo 可能返回 0(Socket 写缓冲区满),需要注册 OP_WRITE 等待可写事件后再继续传输。
Q4:mmap 映射了一个 10GB 的大文件,但你的 JVM 只有 4GB 的堆内存。mmap 会占用堆内存吗?如果不会,为什么能访问 10GB 的数据?
mmap 不占用堆内存。mmap 将文件映射到进程的虚拟地址空间,物理内存的使用由操作系统的 PageCache 管理。当访问映射区域中尚未加载的页时,触发缺页中断,内核将文件数据从磁盘加载到 PageCache 中的物理页,然后更新页表映射。当内存紧张时,这些物理页可以被回收(如果页是干净的,直接丢弃;如果被修改过,写回磁盘)。所以 10GB 的 mmap 映射只占用虚拟地址空间(在 64 位系统上绰绰有余),物理内存占用取决于实际访问的数据量和操作系统的 PageCache 管理策略。这也是 Kafka 能高效处理 TB 级数据的原因——它不需要把所有数据加载到堆内存中,而是依赖 PageCache。
Q5:你使用 Netty 的 CompositeByteBuf 合并了两个 ByteBuf(Header + Body),然后调用 writeAndFlush 发送。这个过程是否实现了零拷贝?如果不是,数据在哪里被拷贝了?
CompositeByteBuf 本身实现了零拷贝——它只是持有两个 ByteBuf 的引用,不拷贝数据。但 writeAndFlush 发送数据时,底层 SocketChannel.write() 需要一个连续的 ByteBuffer 作为参数(Java NIO 的 API 限制)。这就产生了一个问题:CompositeByteBuf 由多个内部 ByteBuf 组成,数据不是连续的,无法直接传给 SocketChannel.write()。Netty 的解决方案:如果 CompositeByteBuf 的组件数量是 1(只有一个 ByteBuf),直接使用该组件。如果组件数量 > 1,且总共包含的 ByteBuffer 数量 <= IOV_MAX(Linux 默认 1024),使用 GatheringByteChannel.write() 进行聚集写(scatter-gather I/O),也是零拷贝。如果组件数量太多,Netty 会将其合并(拷贝)到一个连续的 ByteBuf 中。所以在大多数场景下(2-3 个组件),CompositeByteBuf 确实实现了零拷贝。