一、TCP 如何在不可靠的 IP 层之上构建可靠传输
IP 协议是"尽力而为"的——数据包可能丢失、重复、乱序。TCP 在 IP 之上构建了一套完整的可靠性机制,核心包括:
- 连接管理:三次握手建立连接,四次挥手优雅关闭
- 确认与重传:ACK 确认机制 + 超时重传 + 快速重传
- 流量控制:滑动窗口,防止发送方淹没接收方
- 拥塞控制:慢启动、拥塞避免、快速恢复,防止发送方淹没网络
理解这些机制不只是为了面试,更是为了排查线上问题——TIME_WAIT 过多、重传率高、窗口满导致的阻塞。
二、三次握手:为什么是三次,不是两次或四次
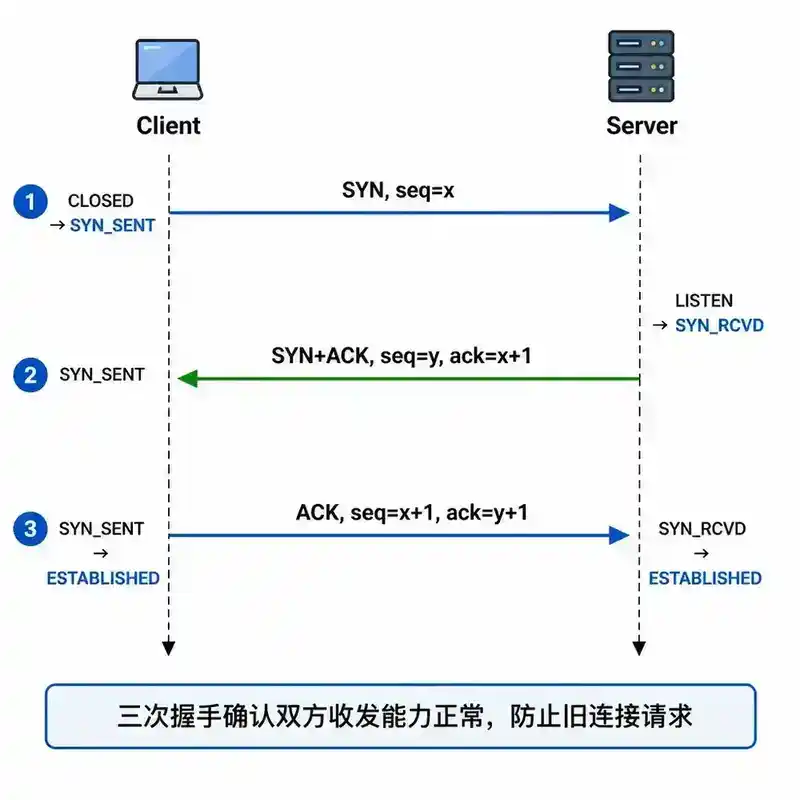
客户端                                    服务端
  |                                         |
  |--- SYN, seq=x ------------------------->|  (1) 客户端发送 SYN
  |                                         |
  |<-- SYN+ACK, seq=y, ack=x+1 ------------|  (2) 服务端回复 SYN+ACK
  |                                         |
  |--- ACK, seq=x+1, ack=y+1 ------------->|  (3) 客户端发送 ACK
  |                                         |
  连接建立                                  连接建立
状态转换:客户端 CLOSED -> SYN_SENT -> ESTABLISHED,服务端 LISTEN -> SYN_RCVD -> ESTABLISHED。
三次握手的核心目标是确认双方的发送和接收能力都正常,同时防止已失效的连接请求到达服务端导致错误。如果只有两次握手:客户端的第一个 SYN 在网络中滞留,超时后重发 SYN 建立连接,数据传输完毕关闭。之后滞留的 SYN 到达服务端,服务端回复 SYN+ACK 进入 ESTABLISHED——但客户端已关闭,服务端将一直等待。三次握手通过客户端的第三次 ACK 避免了这个问题。为什么不是四次:服务端的 SYN 和 ACK 可以合并在一个包中(SYN+ACK),不需要拆成两次。
[图1:TCP三次握手时序图——SYN/SYN+ACK/ACK报文交互,seq/ack值,状态转换]
三、四次挥手:为什么比握手多一次
客户端                                    服务端
  |                                         |
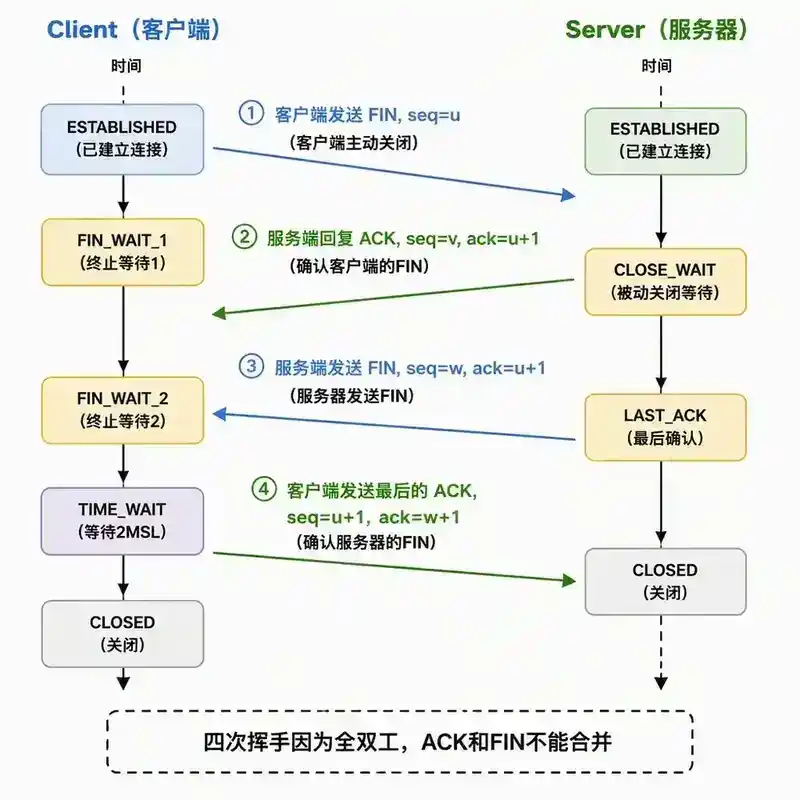
  |--- FIN, seq=u ------------------------->|  (1) 客户端:我要关闭了
  |                                         |
  |<-- ACK, seq=v, ack=u+1 ----------------|  (2) 服务端:知道了
  |                                         |
  |<-- FIN, seq=w, ack=u+1 ----------------|  (3) 服务端:我也要关闭了
  |                                         |
  |--- ACK, seq=u+1, ack=w+1 ------------->|  (4) 客户端:知道了
  |                                         |
  TIME_WAIT (2MSL)                         CLOSED
TCP 是全双工的——每个方向都需要独立关闭。四次挥手的原因是服务端收到客户端的 FIN 后,可能还有数据要发送。ACK(第 2 步)和 FIN(第 3 步)不能合并——ACK 表示"收到你的关闭请求",FIN 表示"我也要关闭了"。如果服务端还有数据没发完,需要先把数据发完,再发送 FIN。
客户端在发送最后一个 ACK 后进入 TIME_WAIT 状态,持续 2MSL(通常 60 秒)。目的:确保最后一个 ACK 能到达服务端,让旧连接的所有报文在网络中消失。TIME_WAIT 过多的处理:开启 tcp_tw_reuse、调整 tcp_fin_timeout、使用长连接代替短连接。
[图2:TCP四次挥手时序图——FIN/ACK/FIN/ACK报文交互,TIME_WAIT状态和2MSL]
四、确认与重传机制
TCP 使用累积确认机制:ACK 号为 N 表示"已收到字节 N-1 及之前的所有数据"。如果收到了 1-1000 和 2001-3000,但缺少 1001-2000,ACK 号仍然是 1001。
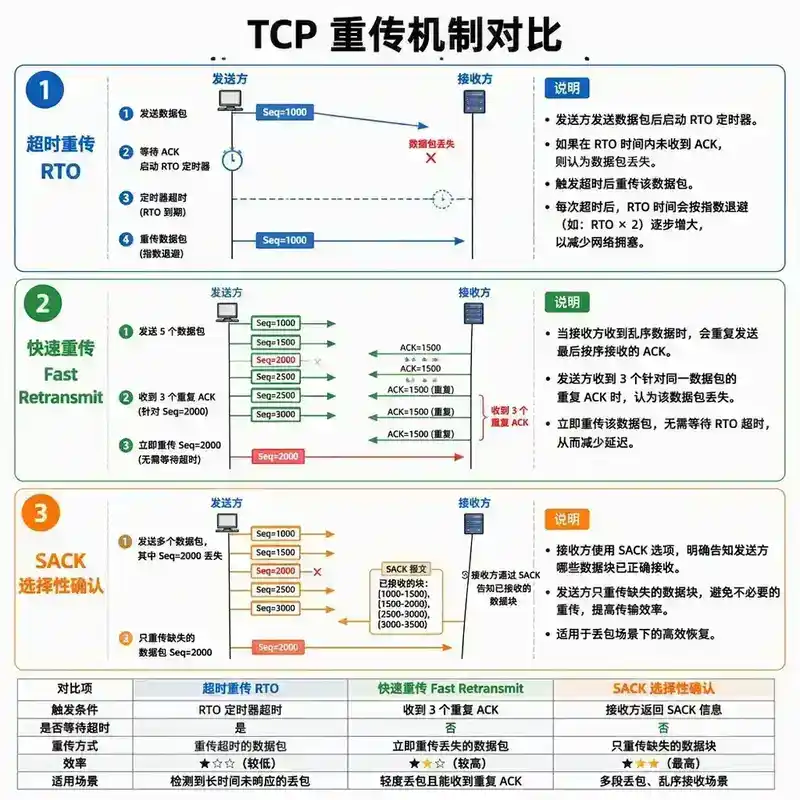
超时重传(RTO):每个报文段设置重传定时器,RTO 基于 RTT 动态计算。每次重传后 RTO 翻倍(指数退避)。
快速重传:当发送方连续收到 3 个相同的 ACK 时,立即重传丢失的报文段,不等待超时。发送方发送 seq=1000-5000,接收方缺 2000,三次 dup ACK 后立即重传 2000。
SACK(Selective ACK):允许接收方告诉发送方"哪些数据已经收到了",精确告知丢失的报文段范围,避免不必要的重传。
[图3:TCP重传机制对比图——超时重传RTO vs 快速重传3 dup ACK vs SACK]
五、滑动窗口:流量控制
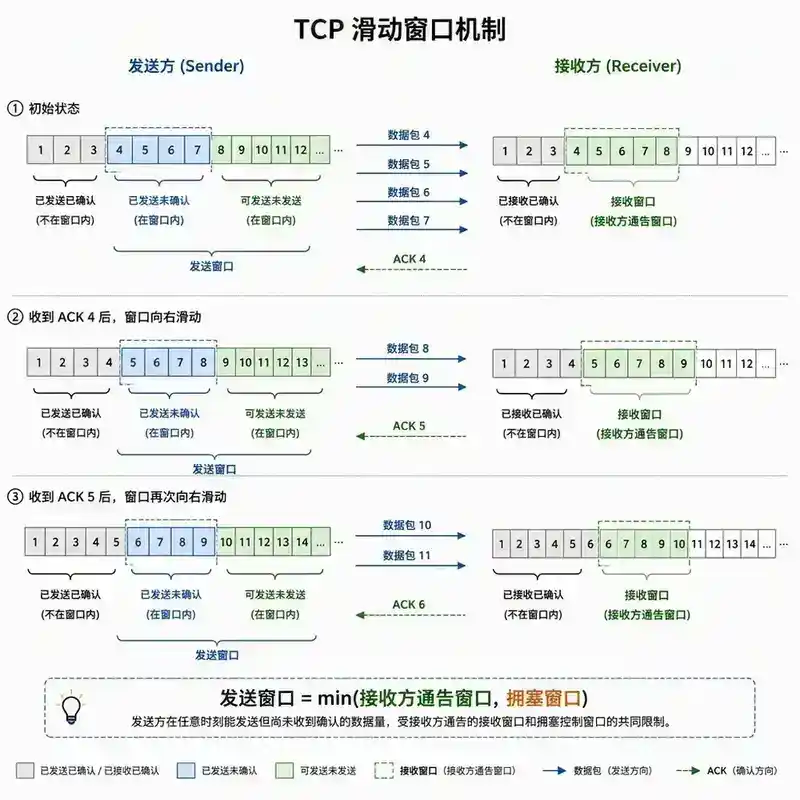
如果发送方无限制地发送数据,接收方的缓冲区可能溢出。滑动窗口机制让接收方告诉发送方"我还能接收多少数据"。TCP 头部 Window 字段(16 位,最大 65535,可通过窗口缩放选项扩展)表示接收方还能接收的字节数。
发送方窗口 = min(接收方通告窗口, 拥塞窗口)。当接收方窗口为 0 时,发送方启动持续定时器,定期发送窗口探测报文。糊涂窗口综合征:接收方每次只消费少量数据就通告很小的窗口,导致网络利用率极低。解决方案:Clark 方案(接收方在窗口足够大时才通告)和 Nagle 算法(发送方在可以发送完整 MSS 时才发送)。
[图4:TCP滑动窗口示意图——发送方和接收方窗口变化,标注已确认/未确认/可发送区域]
六、拥塞控制:防止网络过载
流量控制防止发送方淹没接收方(点对点),拥塞控制防止发送方淹没网络(全局)。
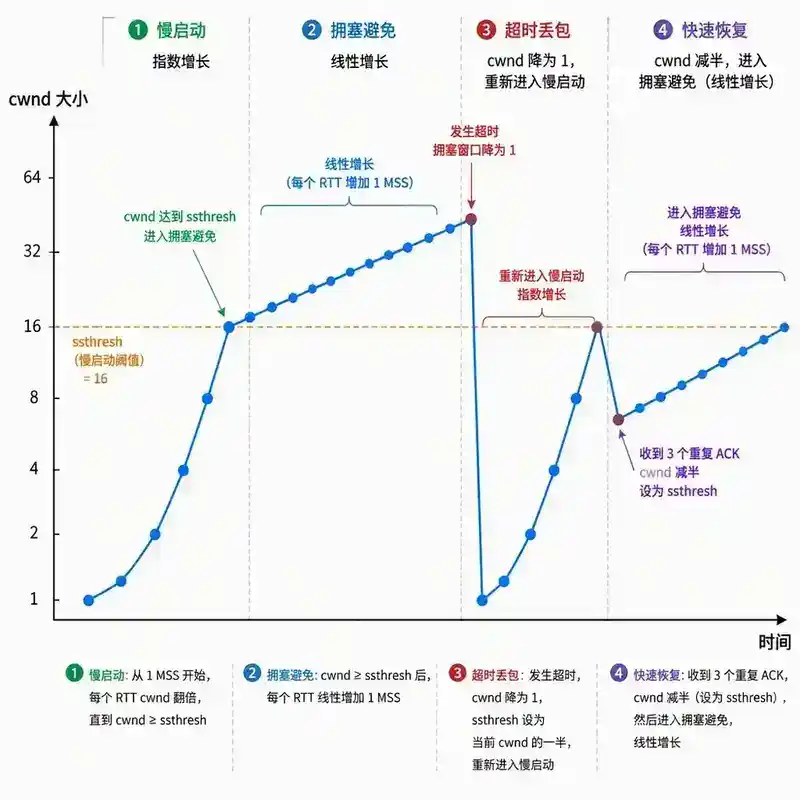
慢启动:cwnd 初始为 1-10 个 MSS,每收到一个 ACK 增加 1 个 MSS——指数增长。达到 ssthresh 时进入拥塞避免。
拥塞避免:cwnd 线性增长——每 RTT 增加 1 个 MSS。发生超时:ssthresh = cwnd/2,cwnd = 1,重新慢启动(Tahoe)。收到 3 个 dup ACK:快速重传 + 快速恢复(Reno)。
快速恢复:收到 3 个 dup ACK 后不进入慢启动,而是 ssthresh = cwnd/2,cwnd = ssthresh + 3*MSS,每收到一个 dup ACK 加 1 MSS,收到新 ACK 后 cwnd = ssthresh 进入拥塞避免。快速恢复避免了"单次丢包就需要重新慢启动"的问题。
[图5:TCP拥塞控制算法曲线图——cwnd随时间变化,标注慢启动/拥塞避免/快速恢复四个阶段]
七、Nagle 算法与延迟确认
Nagle 算法:当有未确认的数据时,不能发送小报文段,必须等待 ACK 或数据积累到 MSS 大小。适合大块数据传输,延迟敏感场景(在线游戏、SSH)需禁用(setTcpNoDelay(true))。
延迟确认:TCP 允许接收方延迟发送 ACK(最多 500ms),以便将 ACK 与数据一起发送。但如果延迟确认与 Nagle 算法同时使用,可能导致"确认延迟"死锁。
八、面试常见误区
- "三次握手是因为 TCP 是双工的" —— 不准确。三次握手是为了确认双方收发能力正常,同时防止旧连接请求。
- "TIME_WAIT 是 bug 应该消除" —— 错误。TIME_WAIT 是 TCP 协议的必要设计。
- "拥塞控制就是流量控制" —— 不对。拥塞控制是全局的,流量控制是局部的。
- "快速重传可以替代超时重传" —— 快速重传是补充,dup ACK 不足 3 个时仍需超时重传兜底。
九、总结
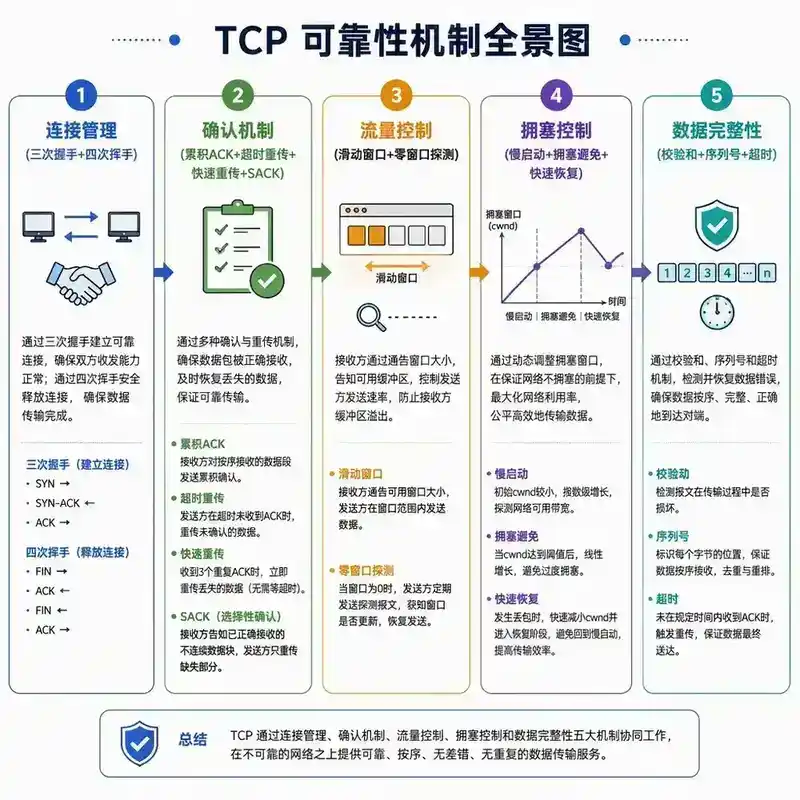
TCP 的可靠传输建立在五个核心机制之上:
- 三次握手:确认双方收发能力,防止旧连接请求。
- 四次挥手:全双工关闭,TIME_WAIT 确保旧报文消失。
- 确认与重传:累积 ACK + 超时重传 + 快速重传 + SACK。
- 滑动窗口:流量控制,防止发送方淹没接收方。
- 拥塞控制:慢启动 + 拥塞避免 + 快速恢复,防止发送方淹没网络。
[图6:TCP可靠性机制全景图——五大机制的概览关系图]
延伸阅读
- RFC 793(TCP 协议规范)、RFC 2001(TCP 拥塞控制)
- 《TCP/IP 详解》卷一,第 17-24 章
- 本系列相关篇目:076(TCP 常见问题:粘包拆包、TIME_WAIT、CLOSE_WAIT)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 TCP 可靠传输的深度理解和实战经验。
Q1:三次握手时,如果服务端收到了客户端的 SYN,回复了 SYN+ACK,但 SYN+ACK 在网络中丢失了。客户端会怎样?服务端会怎样?
客户端:发送 SYN 后进入 SYN_SENT 状态,启动重传定时器。如果 SYN+ACK 丢失,客户端在超时后会重传 SYN(通常重传 5-6 次,每次间隔翻倍,总时间约 1-3 分钟)。服务端:收到 SYN 后进入 SYN_RCVD 状态,发送 SYN+ACK 后也启动重传定时器。如果客户端的 ACK 一直不到(因为 SYN+ACK 丢失,客户端根本不会发 ACK),服务端会重传 SYN+ACK。如果重传多次后仍然失败,服务端关闭这个半连接。这引出了 SYN Flood 攻击——攻击者发送大量 SYN 但不回复 ACK,服务端维护大量 SYN_RCVD 状态连接,耗尽资源。防御手段:SYN Cookie(不分配资源,在 ACK 到达时才建立连接)、增大 SYN 队列(tcp_max_syn_backlog)、缩短 SYN+ACK 重传次数。
Q2:你在线上看到大量 CLOSE_WAIT 状态的连接,但服务看起来正常。这意味着什么?需要怎么排查?
CLOSE_WAIT 表示服务端收到了客户端的 FIN,但还没有发送自己的 FIN。这意味着服务端的应用程序没有调用 close() 或 shutdown() 关闭连接。原因通常是代码 bug:1)连接池中的连接没有被正确归还和关闭。2)异常处理中没有关闭连接(如 try-catch 中缺少 finally 里的 close())。3)数据库连接、HTTP 连接等资源泄漏。排查方法:1)用 ss -tanp 或 netstat 查看 CLOSE_WAIT 连接的 pid 和 fd。2)用 lsof -p 查看该进程打开了哪些连接。3)用 jstack 查看线程栈,看哪些线程持有这些连接。4)检查代码中 Socket/Connection 的关闭逻辑,确保在所有路径(包括异常路径)都调用了 close()。CLOSE_WAIT 不会自动消失——如果不修复代码,连接会一直积累直到耗尽 fd 资源。
Q3:TCP 的快速重传在收到 3 个 dup ACK 时触发,而不是 1 个或 2 个。为什么是 3?
1 个 dup ACK 可能只是报文乱序——网络中后发的包先到了,导致接收方对缺失的包立即发送 ACK,但缺失的包可能随后就到。2 个 dup ACK 也可能是乱序的范围更大。3 个 dup ACK 意味着在缺失包之后至少收到了 3 个后续包,缺失包大概率已经丢失(而非乱序)。如果只有 1 个 dup ACK 就重传,在网络乱序频繁的场景下会导致大量不必要的重传——"虚假重传"会浪费带宽并导致拥塞窗口不必要地缩小。3 是经验值,在被确认前经过了大量实验验证。
Q4:TCP 的拥塞控制中,为什么慢启动是"指数增长"而不是"线性增长"?为什么不直接从较大的 cwnd 开始?
慢启动的"慢"是历史名称——实际上它是指数增长,一点不慢。名字由来是因为它比原来的 TCP 实现(没有拥塞控制,直接发整个窗口)要"慢"。指数增长的原因:网络带宽未知,需要快速探测可用带宽。如果线性增长,达到带宽上限需要很长时间。不能直接从大 cwnd 开始的原因:如果网络路径上的瓶颈带宽很小(比如 100Kbps),直接发送 1MB 数据会导致大量丢包和重传,反而更慢。慢启动的指数增长是"快速探测 + 避免灾难性拥塞"的折中——在不知道带宽的情况下,指数增长是最快的安全探测方式。
Q5:你在一个跨机房的服务中发现 TCP 重传率很高(5%),但 ping 延迟只有 50ms。延迟正常为什么重传率这么高?怎么排查?
Ping 延迟正常不代表没有丢包——ping 使用的是 ICMP 协议,可能走了不同的网络路径。TCP 重传率高的原因:1)MTU 问题——路径上的某个路由器的 MTU 小于发送方的 MSS,导致 IP 分片,分片丢失后整个 TCP 报文段都要重传。用 tracepath 或 ping -M do -s 探测路径 MTU。2)交换机/路由器端口缓冲区溢出——突发流量导致瞬时丢包,但 ping 的间隔太长捕捉不到。用 iperf 做 TCP 吞吐量测试,观察是否有周期性丢包。3)网卡 Ring Buffer 太小——高吞吐场景下网卡缓冲区溢出导致丢包。用 ethtool -g 查看,用 ethtool -G 调大。4)TCP 卸载引擎(TSO/GRO/LRO)的 bug——某些网卡的硬件卸载有 bug。可以尝试关闭硬件卸载(ethtool -K)来排查。5)中间网络设备的限速策略——运营商的限速可能只在 TCP 层面生效(DDoS 防护),ICMP 不受影响。