一、I/O 模型是网络编程的基石
Java 的网络编程能力经历了三次重大演进:从 JDK 1.0 的 BIO(Blocking I/O),到 JDK 1.4 的 NIO(Non-blocking I/O),再到 JDK 1.7 的 AIO(Asynchronous I/O)。理解这三种模型的核心差异,是理解 Netty、Tomcat、Kafka 等几乎所有 Java 网络框架工作原理的前提。
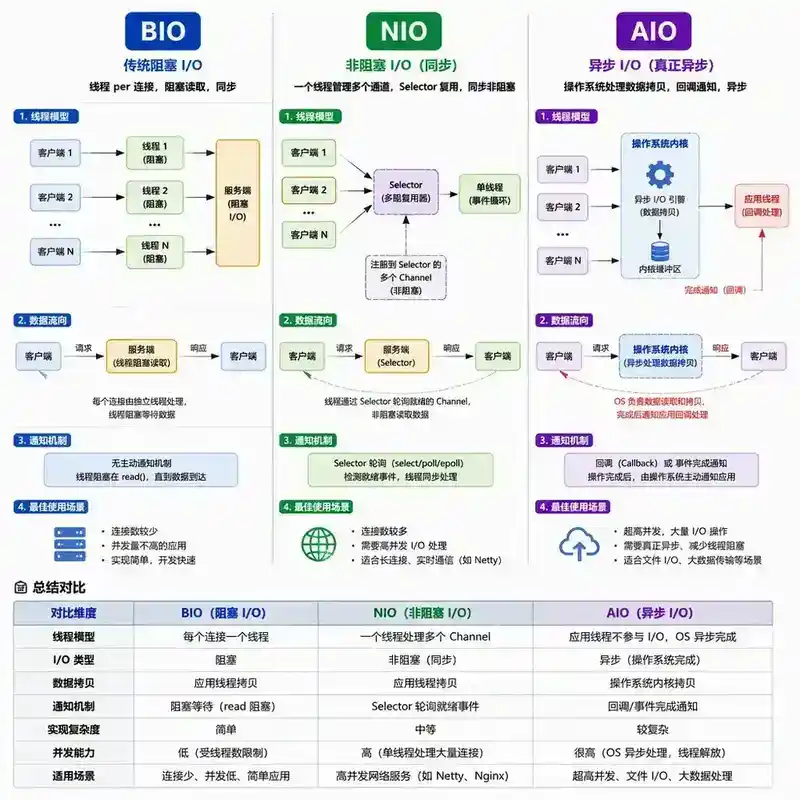
三种模型的核心差异在于"谁来负责等待数据就绪"和"谁来负责从内核拷贝数据":
| 模型 | 发起 I/O 后 | 数据就绪通知 | 数据拷贝 | 线程模型 |
|---|---|---|---|---|
| BIO | 线程阻塞等待 | 无通知(阻塞到就绪) | 线程自己拷贝 | 一个连接一个线程 |
| NIO | 线程立即返回 | Selector 轮询通知 | 线程自己拷贝 | 一个线程管理多个连接 |
| AIO | 线程立即返回 | 操作系统回调通知 | 操作系统拷贝 | 回调或 Future |
二、BIO:最直观也是最受限的模型
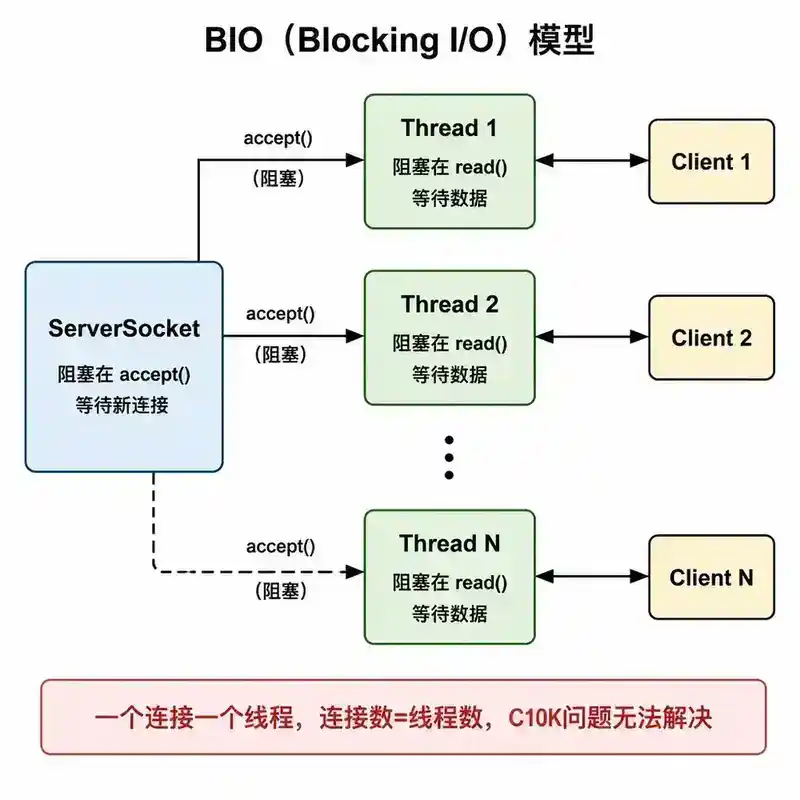
BIO 的核心特征是一个连接一个线程。当 ServerSocket 调用 accept() 时,线程阻塞等待客户端连接。连接建立后,为每个连接分配一个线程,该线程在 read() 上阻塞等待客户端发送数据。
ServerSocket server = new ServerSocket(8080);
while (true) {
    Socket client = server.accept();  // 阻塞等待连接
    new Thread(() -> {

        byte[ ] buf = new byte[1024];

        int len = client.getInputStream().read(buf);  // 阻塞等待数据
    }).start();
}
BIO 的致命问题:线程数爆炸——1000 个连接需要 1000 个线程,每个线程 1MB 栈空间,内存占用 1GB。线程利用率低——大多数连接在大部分时间处于空闲状态。C10K 问题——无法支撑 10000+ 并发连接。BIO 适用场景:连接数少且稳定(< 100)的场景,每个连接需要大量计算的长连接通信。
[图1:BIO模型示意图——一个线程一个连接,线程阻塞在read()上,连接数=线程数]
三、NIO:一个线程管理多个连接
Java NIO 的三个核心组件:
Channel(通道):与 BIO 的 Stream 不同,Channel 是双向的(可读可写),支持非阻塞模式。主要实现:ServerSocketChannel、SocketChannel、FileChannel、DatagramChannel。
Buffer(缓冲区):NIO 的所有数据读写都通过 Buffer。Channel 从 Buffer 读数据,写入数据到 Buffer。
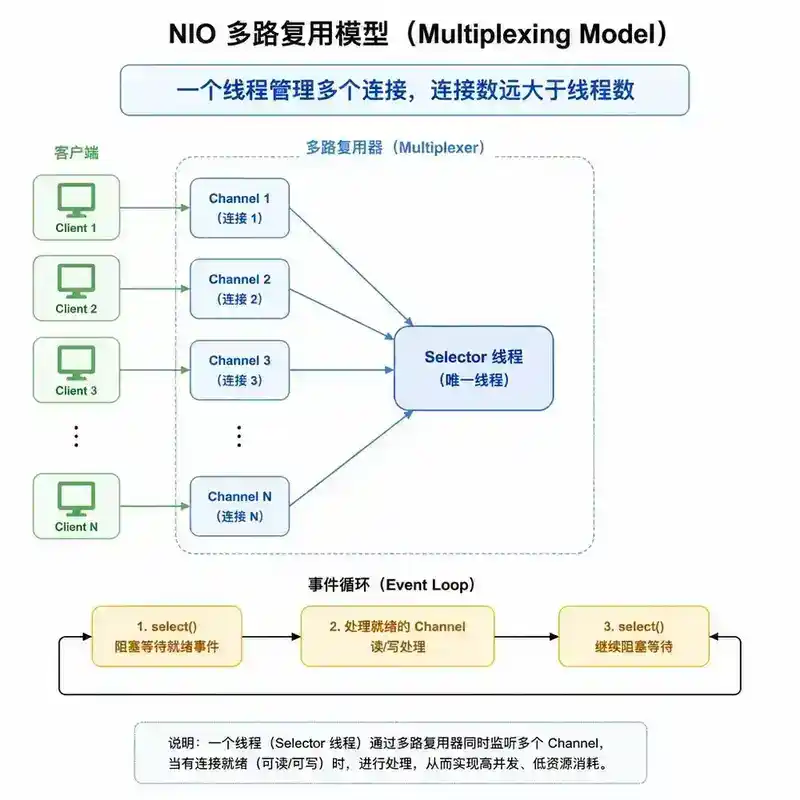
Selector(选择器):多路复用的核心。一个 Selector 可以注册多个 Channel,监听它们的事件(connect、accept、read、write)。
Selector selector = Selector.open();
ServerSocketChannel server = ServerSocketChannel.open();
server.configureBlocking(false);
server.register(selector, SelectionKey.OP_ACCEPT);

while (true) {
    selector.select();  // 阻塞等待任意 Channel 有事件就绪
    Iterator<SelectionKey> keys = selector.selectedKeys().iterator();
    while (keys.hasNext()) {
        SelectionKey key = keys.next();
        if (key.isAcceptable()) { /* 处理新连接 */ }
        else if (key.isReadable()) { /* 处理读事件 */ }
        keys.remove();
    }
}
核心思路:一个线程通过 Selector 同时监听多个 Channel,哪个 Channel 有数据就处理哪个。NIO 真正的价值在于多路复用模式——Selector 底层使用操作系统的 epoll/kqueue 机制,告诉内核"帮我监听这 1000 个 socket,有数据就通知我"。一个线程可以处理成千上万个连接。
NIO 的局限性:编程模型复杂,仍然是同步 I/O(Selector 通知数据就绪,但数据拷贝仍由线程自己完成),业务处理不能阻塞整个 Selector 线程。
[图2:NIO多路复用模型示意图——一个Selector线程通过多路复用器同时监听多个Channel]
四、AIO:真正的异步 I/O
AIO 与 NIO 的本质区别:NIO 是"同步非阻塞"——I/O 操作由线程发起,数据就绪后线程需要自己调用 read() 完成数据拷贝。AIO 是"异步非阻塞"——I/O 操作由线程发起后立即返回,操作系统在后台完成数据拷贝,拷贝完成后通过回调或 Future 通知线程。
BIO: 线程发起read() -> 阻塞等待数据就绪 -> 线程拷贝数据 -> 返回
NIO: 线程发起read() -> 立即返回 -> Selector通知数据就绪 -> 线程拷贝数据 -> 返回
AIO: 线程发起read() -> 立即返回 -> 操作系统拷贝数据 -> 回调通知线程
AIO 在 Java 生态中并未成为主流,原因:Linux 实现基于 epoll 模拟而非真正异步 I/O(真正的异步需要 io_uring),Netty 选择了 NIO 且经过多年优化性能已非常接近理论极限,回调模式容易形成"回调地狱"。
[图3:BIO/NIO/AIO三种模型对比图——三列并排展示线程模型、数据流、通知机制]
五、操作系统层面的 I/O 模型
Java 的 I/O 模型最终映射到操作系统的 I/O 模型。理解 Linux 内核的 I/O 机制,才能真正理解 Java I/O 的性能特征。
| 层级 | 模型 | 描述 | Java 对应 |
|---|---|---|---|
| 1 | 阻塞 I/O | 线程阻塞直到数据就绪并拷贝完成 | BIO |
| 2 | 非阻塞 I/O | 轮询检查数据是否就绪 | NIO 非阻塞模式 |
| 3 | I/O 多路复用 | 一个线程监听多个 fd | NIO Selector |
| 4 | 信号驱动 I/O | 内核通过信号通知数据就绪 | Java 不支持 |
| 5 | 异步 I/O | 内核完成全部操作后通知 | AIO(不完全) |
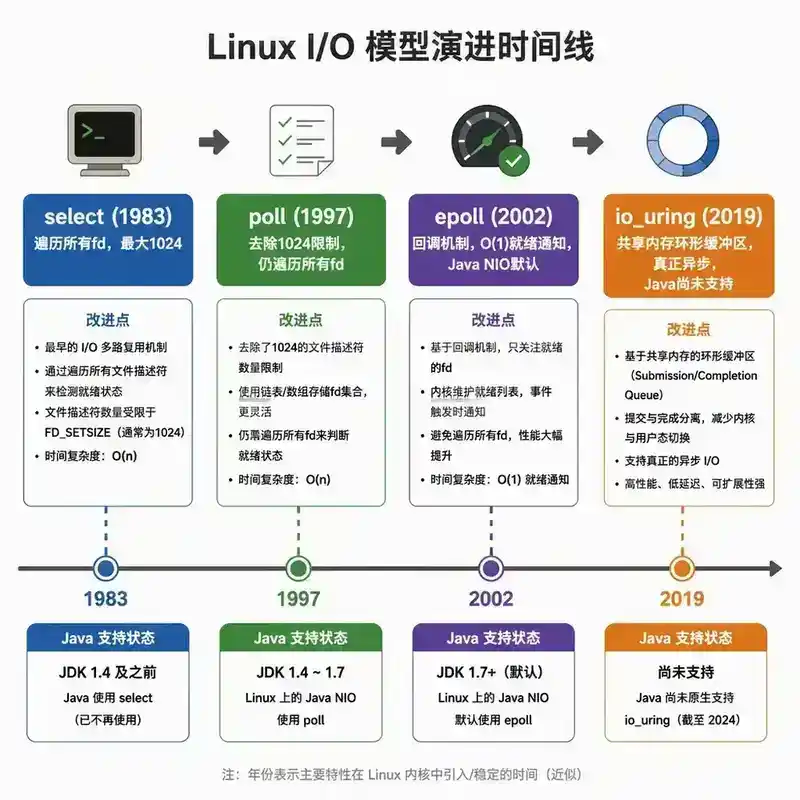
select:最早实现,遍历所有 fd,最大 1024 个。poll:去除 1024 限制,仍遍历所有 fd。epoll(Linux 2.6+):使用红黑树存储 fd,回调机制在 fd 就绪时加入就绪队列,O(1) 效率。JDK NIO 在 Linux 上默认使用 epoll。epoll 有两种触发模式:水平触发(LT,默认)和边缘触发(ET,高性能但编程复杂)。io_uring(Linux 5.1+):真正的异步 I/O,通过共享内存环形缓冲区传递 I/O 请求,JDK 尚未原生支持。
[图4:Linux I/O模型演进图——select→poll→epoll→io_uring时间线,标注Java支持情况]
六、Netty 的选择:为什么是 NIO 而不是 AIO
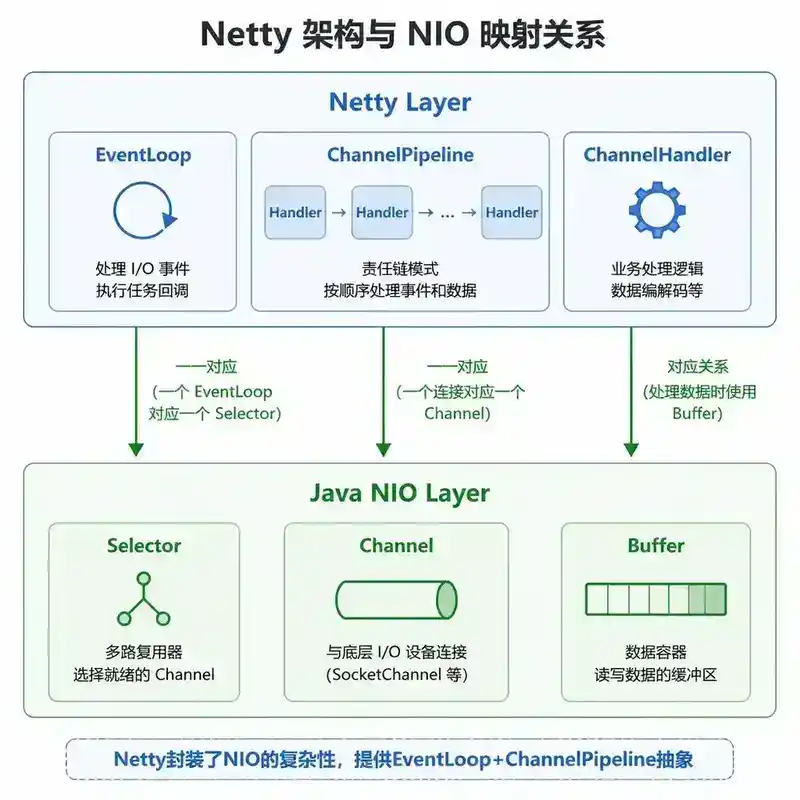
Netty 是 Java 网络编程的事实标准,它选择了 NIO 作为核心。原因:NIO 的 epoll 实现已经足够高效,Netty 的线程模型(EventLoop + ChannelPipeline)已经解决了 NIO 的编程复杂度,AIO 在 Linux 上基于 epoll 模拟与 NIO 底层实现差别不大,跨平台一致性更好。
[图5:Netty架构与NIO映射图——EventLoop→Selector→Channel→Pipeline的映射关系]
七、I/O 模型选型决策树
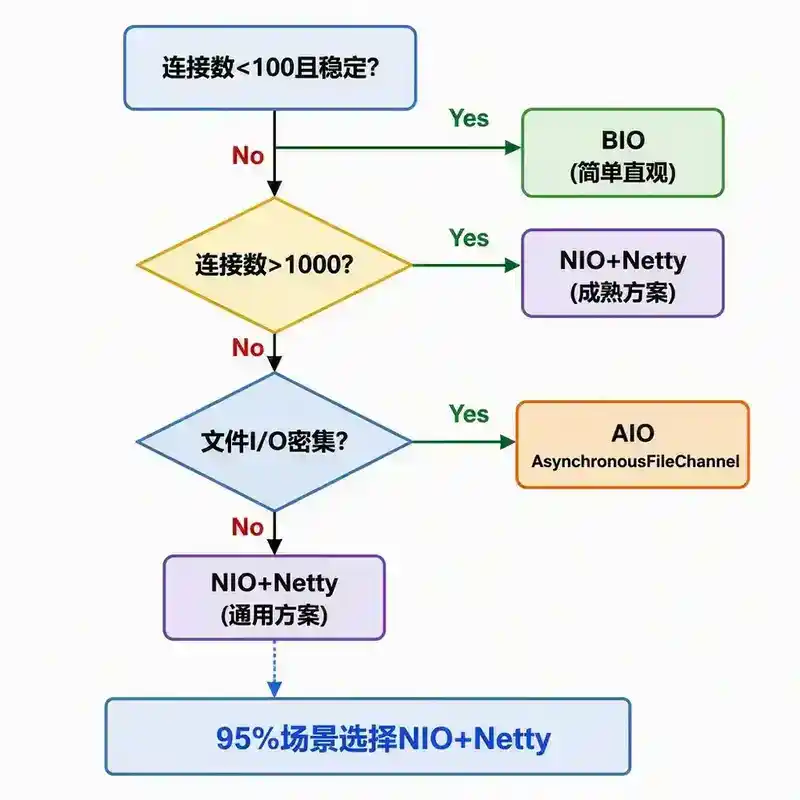
连接数 < 100 且稳定?-> BIO(简单直观,维护成本低)。连接数 > 1000 且需要高并发?-> NIO + Netty(成熟方案,生态完善)。文件 I/O 密集?-> AIO AsynchronousFileChannel。通用场景 -> NIO + Netty。实际上,95% 的 Java 网络应用应该选择 NIO + Netty。
[图6:I/O模型选型决策树——从连接数和并发需求出发,引导到BIO/NIO+Netty/AIO的选择]
八、面试常见误区
- "NIO 的 N 是 Non-blocking 的缩写" —— 对,但更准确的理解是 New I/O。NIO 的核心价值是多路复用,而非单纯的非阻塞。
- "AIO 比 NIO 更快" —— 在 Linux 上不一定。AIO 在 Linux 上基于 epoll 模拟,性能与 NIO 相当甚至更差。
- "BIO 已过时,不应该使用" —— 不准确。BIO 在连接数少、逻辑简单的场景下仍然是最优选择。
- "Selector 可以监听无限个 Channel" —— 有限制。单个 Selector 注册的 Channel 数量受操作系统限制。
九、总结
三种 I/O 模型的核心差异:
- BIO:一个连接一个线程,适合低并发场景。
- NIO:一个线程通过 Selector 管理多个连接,底层依赖 epoll/kqueue 多路复用,适合高并发场景,是 Java 网络编程的主流选择。
- AIO:操作系统异步完成数据拷贝后通知线程。理论上最优,但 Linux 实现不理想,Java 生态中未成为主流。
理解这三种模型,更重要的是理解它们的适用边界——没有银弹,只有最适合当前场景的模型。
延伸阅读
- 《Netty 实战》第 1-3 章,Java NIO 与 Netty 基础
- Linux man page:epoll(7)、io_uring(7)
- 本系列相关篇目:072(NIO 核心组件)、073(多路复用机制)、074(零拷贝)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 I/O 模型的深度理解和实战经验。
Q1:你说 NIO 的 Selector 一个线程可以管理成千上万个连接,但如果其中某个连接的业务处理耗时很长(比如需要查询数据库),会影响其他连接吗?Netty 是怎么解决这个问题的?
会严重影响。NIO 的 Selector 线程是单线程处理所有就绪 Channel 的——如果处理某个 Channel 的业务逻辑耗时 100ms,这 100ms 内其他 9999 个 Channel 的事件都无法被处理。Netty 的解决方案是"业务线程池隔离":EventLoop(相当于 Selector 线程)只负责 I/O 事件的读写,将读取到的数据交给业务线程池(EventExecutorGroup)异步处理,EventLoop 立即返回继续处理下一个 Channel。这样即使某个连接的数据库查询耗时 3 秒,也不会阻塞其他连接的 I/O 读写。但代价是增加了线程切换和数据传递的开销,需要在"隔离"和"性能"之间做权衡。
Q2:epoll 的边缘触发(ET)和水平触发(LT)有什么区别?为什么 Netty 默认使用水平触发?
水平触发(LT):只要 fd 还有数据可读,每次 epoll_wait 都会返回该 fd。编程简单——不需要一次性读完,可以分多次读。边缘触发(ET):fd 状态从未就绪变为就绪时只通知一次。必须一次性读完数据(循环 read 直到返回 EAGAIN),否则剩余数据永远不会被通知。Netty 选择 LT 的原因:1)编程模型更简单,不容易出错。2)Netty 的 I/O 读取已经有自适应缓冲区机制,不需要 ET 的"一次性读完"保证。3)ET 在高吞吐场景下理论上性能更好,但 Netty 的 LT 实现经过优化后差距很小。只有在极端追求性能的场景下才考虑 ET。
Q3:你在 Linux 上使用 Java AIO(AsynchronousServerSocketChannel)做网络服务,发现性能不如 NIO。为什么?怎么验证你的判断?
Linux 上 Java AIO 基于 epoll 模拟实现,本质上是在 epoll 之上封装了一层异步回调 API,并未使用真正的异步 I/O(io_uring)。验证方法:1)用 strace 跟踪系统调用,NIO 的 Selector 会看到 epoll_create/epoll_ctl/epoll_wait,AIO 也会看到类似的 epoll 调用,说明底层是同一套机制。2)用 perf 或火焰图对比两种实现的 CPU 开销——AIO 多了回调管理和线程池调度的开销。3)用 JMH 基准测试对比吞吐量和延迟。实际上,Java AIO 在 Linux 上的性能瓶颈来自"伪异步"——它并没有减少系统调用次数,反而增加了回调管理的开销。这也是为什么 Netty 选择了 NIO 而非 AIO。
Q4:你设计一个 IoT 平台,需要同时维护 50 万个 TCP 长连接。每个连接的数据量很小(平均每秒几十字节),但需要保持连接活跃。你会选择 NIO 还是 AIO?为什么?
我会选择 NIO + Netty。原因:1)50 万个连接下,NIO 的 epoll 机制已经足够高效——一个 EventLoop 可以管理数万个连接,50 万个连接只需要几十个 EventLoop 线程。2)AIO 在 Linux 上基于 epoll 模拟,并没有性能优势。3)Netty 的 ChannelPipeline 可以方便地处理心跳、超时、断线重连等长连接场景的通用需求。4)Netty 的 ByteBuf 内存池化可以显著减少 GC 压力。5)如果未来需要升级到 io_uring(Linux 5.1+),Netty 已经提供了 io_uring 的传输实现,可以平滑迁移。关键设计点:每个 EventLoop 管理 1-2 万个连接,使用 EpollEventLoopGroup,配置合理的 SO_TIMEOUT 和心跳间隔,使用池化的直接内存 ByteBuf 减少 GC 压力。
Q5:Tomcat 从 BIO 模式切换到 NIO 模式后,为什么线程数从几千降到了几十个,但单次请求的响应时间反而可能略有增加?这不是违背了 NIO 的设计目标吗?
不违背。NIO 的设计目标是"高并发连接下的吞吐量",而非"单次请求的响应时间"。BIO 模式下,每个连接独占一个线程,当数据到达时线程立即被唤醒处理,响应延迟极低。NIO 模式下,Selector 线程需要轮询处理多个 Channel,一个 Channel 的数据就绪后可能需要等待 Selector 线程处理完其他 Channel 的事件才能被处理,引入了额外的调度延迟。这就是"吞吐量 vs 延迟"的经典权衡:BIO 在低并发下响应更快,NIO 在高并发下吞吐更高。在实际应用中,NIO 引入的额外延迟通常在微秒级,对绝大多数业务场景无感知,而线程数和内存的节省是数量级的提升。