一、Netty 的线程模型是一套精密的协作体系
Netty 是 Java 网络编程的事实标准,它的核心设计——线程模型——决定了它的高并发能力、低延迟特性以及编程模型。本文从 Reactor 模式出发,逐一拆解 EventLoop、Channel、ChannelPipeline、ChannelHandler 的设计原理和协作方式。
二、Reactor 模式:Netty 线程模型的理论基础
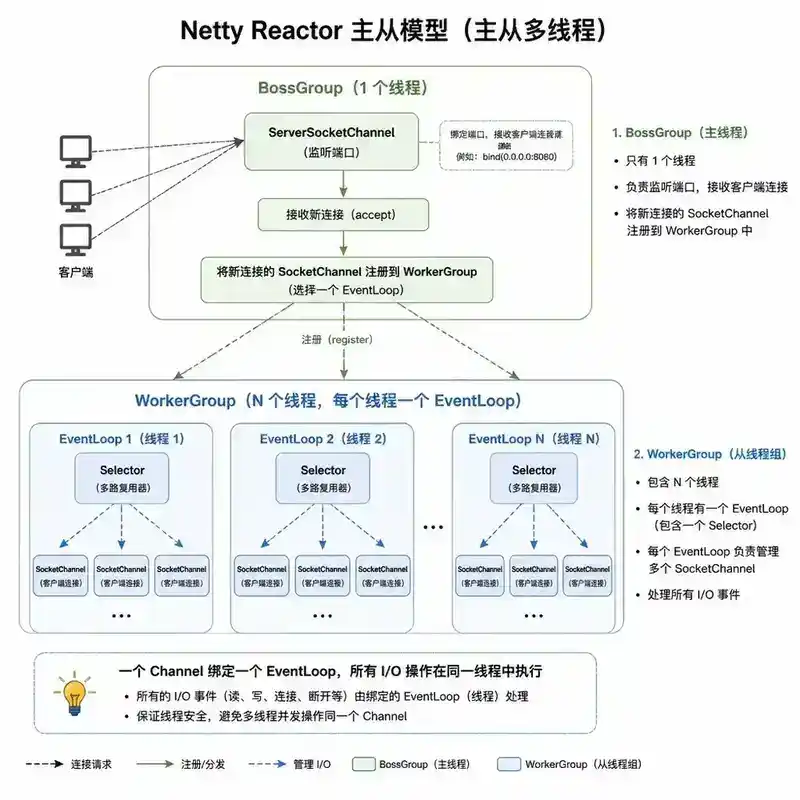
Netty 支持 Reactor 的三种变体:单线程 Reactor(一个线程负责所有)、多线程 Reactor(一个 accept 线程 + 多个 I/O 线程)、主从 Reactor(BossGroup + WorkerGroup)。这是 Netty 最常用的模式,也是服务端推荐的配置。
EventLoopGroup bossGroup = new NioEventLoopGroup(1);
EventLoopGroup workerGroup = new NioEventLoopGroup();
ServerBootstrap b = new ServerBootstrap();
b.group(bossGroup, workerGroup)
 .channel(NioServerSocketChannel.class)
 .childHandler(new ChannelInitializer<SocketChannel>() {
     public void initChannel(SocketChannel ch) {
         ch.pipeline().addLast(new MyHandler());
     }
 });
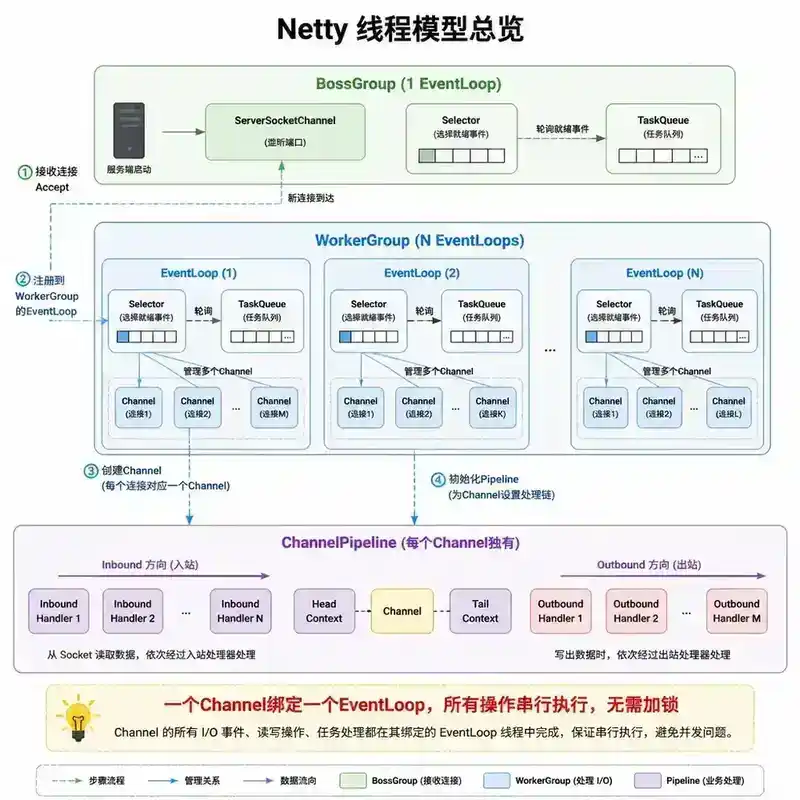
BossGroup(通常 1 个线程)负责监听端口、接收新连接,将连接注册到 WorkerGroup 的某个 EventLoop。WorkerGroup(通常 CPU 核心数 × 2 个线程)每个 EventLoop 绑定一个 Selector,负责所分配连接的所有 I/O 事件和 Handler 执行。
关键设计:一个 Channel 一旦注册到某个 EventLoop,整个生命周期中所有 I/O 操作都在同一个线程中执行。这意味着同一个 Channel 的 Handler 不需要同步——它们在同一个线程中串行执行。
[图1:Reactor主从模式示意图——BossGroup接收连接→注册到WorkerGroup的EventLoop→每个EventLoop绑定Selector]
三、EventLoop:事件循环的"引擎"
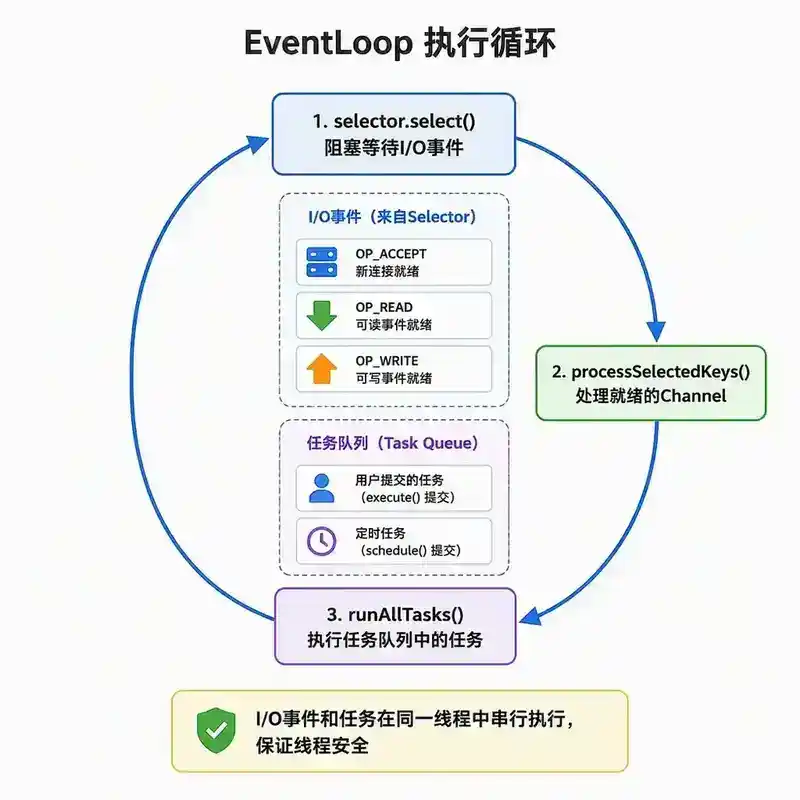
EventLoop = Selector + 任务队列 + 线程。执行循环:selector.select() 阻塞等待 I/O 事件 -> processSelectedKeys() 处理就绪的 Channel -> runAllTasks() 执行任务队列中的任务 -> 循环。
同一个 Channel 的所有操作都在同一个 EventLoop 线程中执行,这意味着同一个 Channel 的 ChannelHandler 不需要加锁。跨 Channel 的操作需要手动保证线程安全。
[图2:EventLoop执行循环图——selector.select()→processSelectedKeys()→runAllTasks()→循环]
四、ChannelPipeline:责任链模式
ChannelPipeline 是 Netty 的责任链实现,用于处理 Channel 的入站(Inbound)和出站(Outbound)事件。每个 Channel 有自己独立的 Pipeline。
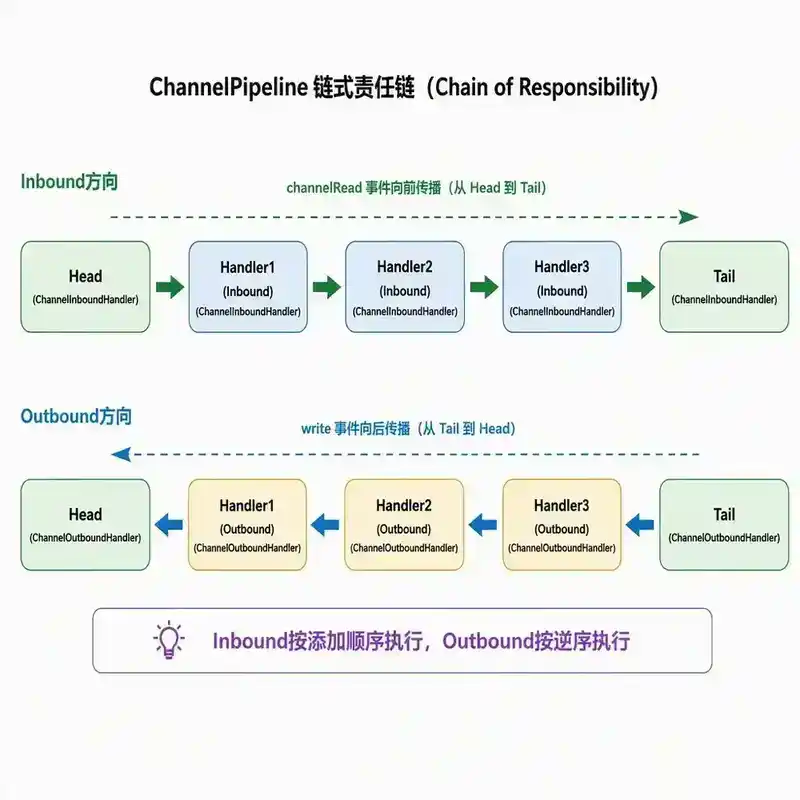
Inbound 事件流向:Head -> Handler1 -> Handler2 -> Handler3 -> Tail。Outbound 事件流向:Tail -> Handler3 -> Handler2 -> Handler1 -> Head。
Inbound 事件(channelRead、channelActive、exceptionCaught)从网络读取数据。Outbound 事件(write、flush、close)向网络写入数据。一个 Handler 可以同时实现两种接口(ChannelDuplexHandler)。
事件传播:调用 ctx.fireChannelRead(msg) 传递给下一个 Inbound Handler,调用 ctx.write(msg) 传递给前一个 Outbound Handler。如果不调用 fireXxx 方法,事件不会继续传播。
[图3:ChannelPipeline责任链示意图——Inbound和Outbound事件在Pipeline中的双向传播方向]
五、ChannelHandler:业务逻辑的"容器"
常用 Handler:LengthFieldBasedFrameDecoder(粘包拆包)、StringDecoder/Encoder(字节与字符串转换)、IdleStateHandler(空闲检测)、ReadTimeoutHandler(读超时)。
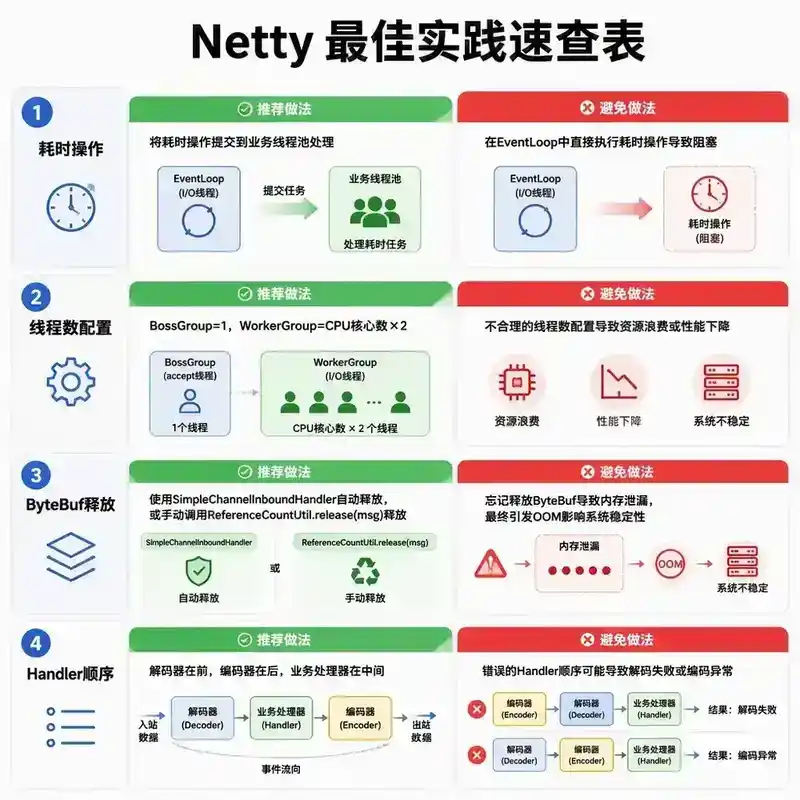
Handler 执行顺序:解码器在前,编码器在后,业务 Handler 在中间。Inbound 按添加顺序执行,Outbound 按逆序执行。
ch.pipeline()
  .addLast(new LengthFieldBasedFrameDecoder(...)) // 1. 拆包
  .addLast(new StringDecoder())                   // 2. 字节→字符串
  .addLast(new MyBusinessHandler())               // 3. 业务处理
  .addLast(new StringEncoder())                   // 4. 字符串→字节
  .addLast(new LengthFieldPrepender(4));          // 5. 添加长度头
六、Channel:连接的生命周期管理
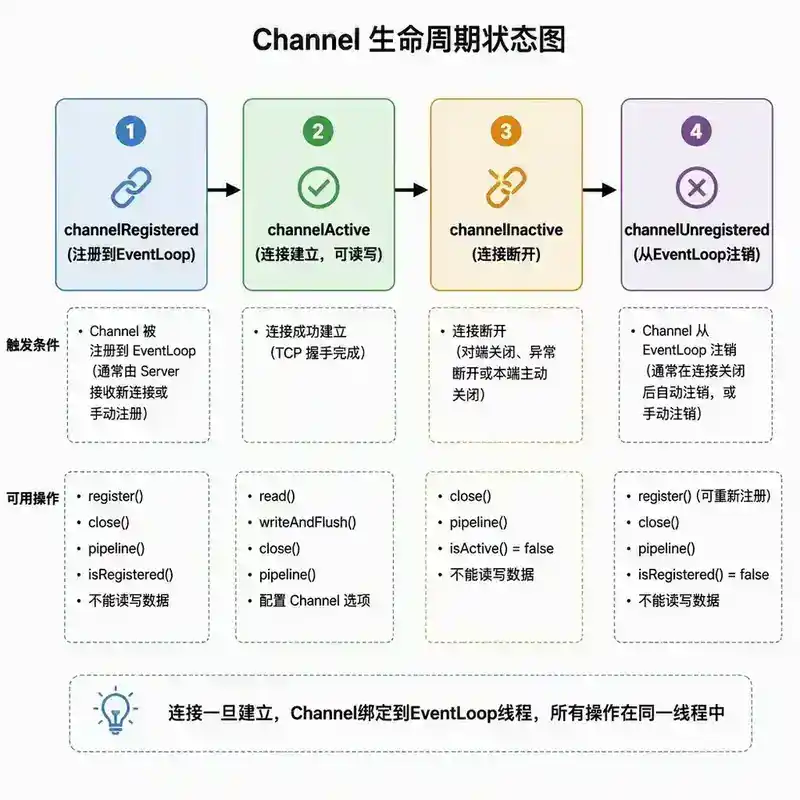
Channel 生命周期:channelRegistered(注册到 EventLoop)-> channelActive(连接建立,可读写)-> channelInactive(连接断开)-> channelUnregistered(从 EventLoop 注销)。
写操作:write() 不立即发送,数据被写入出站缓冲区,需要调用 flush() 才会真正发送。这是 Netty 的"攒批"优化——多次 write() 后一次 flush(),减少系统调用。
[图4:Channel生命周期图——registered→active→inactive→unregistered的状态转换]
[图5:Netty线程模型全景图——BossGroup/WorkerGroup/EventLoop/ChannelPipeline/Handler的完整协作关系]
七、Netty 线程模型的最佳实践
不要在 EventLoop 中做耗时操作——如果某个 Handler 的 channelRead 中执行了耗时操作(如数据库查询),整个 EventLoop 管理的所有 Channel 都会被阻塞。解决方案:将耗时操作提交到业务线程池,结果通过 channel.eventLoop().execute() 回到 EventLoop 线程写回。
BossGroup 通常 1 个线程足够,WorkerGroup 默认 CPU 核心数 × 2。ByteBuf 使用引用计数——Handler 处理完消息后需要释放。使用 SimpleChannelInboundHandler 会自动释放,不需要手动调用 release。
[图6:Netty最佳实践速查图——耗时操作/线程数/ByteBuf释放/Handler顺序的注意事项]
八、面试常见误区
- "Netty 的 BossGroup 线程数越多越好" —— 不对。BossGroup 只负责 accept,一个端口只需要一个线程。
- "ChannelPipeline 中的 Handler 执行顺序就是添加顺序" —— Inbound 和 Outbound 执行顺序相反。
- "EventLoop 的线程数等于 WorkerGroup 的线程数" —— 每个 EventLoop 绑定一个线程。
- "Netty 的 Channel 是线程安全的" —— 写操作线程安全,但数据读取和处理需要在正确的线程中操作。
九、总结
Netty 的线程模型:Reactor 主从模式(BossGroup 接收,WorkerGroup 处理)-> EventLoop(Selector + 任务队列)-> ChannelPipeline(责任链)-> ChannelHandler(业务逻辑)。理解这些组件是为了在遇到性能问题或设计问题时,能快速定位到正确的组件和解决方案。
延伸阅读
- Netty 官方文档:User Guide
- 《Netty 实战》第 2-7 章
- 本系列相关篇目:080(Netty 内存与性能)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 Netty 线程模型的深度理解和实战经验。
Q1:你在 Netty 的 ChannelHandler 中(channelRead 方法)直接执行了一个耗时 3 秒的数据库查询。这对整个服务有什么影响?如果一个 EventLoop 管理了 1000 个连接,这 1000 个连接都会被阻塞吗?
是的,所有 1000 个连接都会被阻塞。因为同一个 EventLoop 线程负责该 EventLoop 管理的所有 Channel 的 I/O 操作和 Handler 执行。如果 channelRead 中执行了 3 秒的数据库查询,这 3 秒内:该 EventLoop 无法处理其他 Channel 的读事件(数据到达但无法被读取)、写事件(写缓冲区满但无法 flush)、以及 Selector 上的新事件。所有 1000 个连接在这 3 秒内完全停滞。解决方案:将耗时操作提交到业务线程池,获取结果后通过 channel.eventLoop().execute() 回到 EventLoop 线程写回。Netty 提供了 EventExecutorGroup 来简化这个过程——在 Pipeline 中添加 Handler 时指定 EventExecutorGroup,Netty 自动将 Handler 的执行切换到业务线程池。
Q2:Netty 的 BossGroup 默认只用一个线程。如果服务端需要监听 10 个端口,一个线程够吗?如果不够,怎么配置?
一个线程处理 10 个端口的 accept 完全够用——accept 操作本身非常快(只是从全连接队列中取走一个连接),一个线程处理成千上万个端口也不会有瓶颈。真正需要增加 BossGroup 线程的场景是:1)不同端口需要隔离——比如一个端口是面向外网的,另一个是内部管理端口,使用不同的 BossGroup 线程可以避免外网问题影响管理端口。2)acceptor 线程本身成为瓶颈——当 accept 速率极高(每秒数十万连接)时,单个线程可能来不及处理。配置多个 BossGroup 线程:new NioEventLoopGroup(N) 并配合 SO_REUSEPORT 让多个线程同时监听同一个端口。注意:不开启 SO_REUSEPORT 时,多个线程监听同一个端口会导致端口绑定冲突。
Q3:ChannelPipeline 中 Inbound 和 Outbound 的执行顺序为什么是相反的?设计上有什么考虑?
Inbound 和 Outbound 的执行顺序相反是因为它们处理的是"正反两个方向"的数据流。Inbound 是从网络中读取数据并解码——数据从原始字节 -> 帧 -> 对象 -> 业务消息,处理方向是"从外到内"。Outbound 是将业务消息编码并写入网络——数据从业务消息 -> 对象 -> 帧 -> 原始字节,处理方向是"从内到外"。在 Pipeline 中,解码器(入站)和编码器(出站)是成对出现的——如 LengthFieldBasedFrameDecoder(入站)和 LengthFieldPrepender(出站)。入站时先拆包再解码,出站时先编码再添加长度头,它们的执行顺序在物理上就是相反的。如果执行顺序相同,两个方向的数据流会互相干扰。
Q4:你使用 Netty 开发了一个 WebSocket 服务,压测时发现 CPU 使用率不高(30%),但 QPS 上不去,且响应时间 P99 很高。可能是什么原因?怎么排查?
CPU 不高但 QPS 上不去,说明瓶颈不在 CPU 计算,可能是 I/O 或线程模型的问题。排查方向:1)检查 EventLoop 线程数——如果 WorkerGroup 线程数太少(如只有 2 个),而连接数很大,EventLoop 线程可能成为瓶颈。用 jstack 查看 EventLoop 线程是否一直在运行(RUNNABLE)还是频繁阻塞。2)检查是否有 Handler 在 EventLoop 中执行了耗时操作——用 Arthas 的 trace 命令查看 Handler 方法的执行耗时。3)检查是否有频繁的 GC——用 jstat 查看 GC 频率和暂停时间。4)检查网络层——用 netstat -s 查看重传统计,可能网络丢包严重。5)检查 Netty 的内存分配——是否使用了池化内存(PooledByteBufAllocator),默认是非池化的。6)检查操作系统的文件描述符限制——ulimit -n 是否足够大。
Q5:Netty 的 writeAndFlush 是线程安全的——你可以从任何线程调用它。但 Netty 内部是如何保证这个线程安全性的?如果从 100 个线程同时调用同一个 Channel 的 writeAndFlush,会发生什么?
Netty 的 writeAndFlush 线程安全机制:当从非 EventLoop 线程调用 writeAndFlush 时,Netty 不会直接执行写操作,而是将写操作封装为一个任务(Runnable),提交到该 Channel 绑定的 EventLoop 的任务队列中。EventLoop 线程在下次循环中从任务队列中取出任务并执行。如果 100 个线程同时调用同一个 Channel 的 writeAndFlush,这 100 个写操作会被封装为 100 个任务,放入 EventLoop 的任务队列。EventLoop 线程按 FIFO 顺序逐个执行这些任务——每个任务执行 writeAndFlush 时,实际上是在 EventLoop 线程中直接操作 Channel 的写缓冲区,没有线程安全问题。但需要注意:如果任务队列积压过多(比如这 100 个任务每个都写大量数据),可能导致内存占用过高和延迟增加。这就是为什么高并发场景下建议使用高低水位线(WRITE_BUFFER_WATER_MARK)来限制写缓冲区的最大大小。