一、TCP 不是"问题制造者",而是"问题放大器"
TCP 协议本身是可靠的,但在生产环境中各种问题层出不穷。本文逐一拆解四种最常见的 TCP 问题:粘包拆包、TIME_WAIT 堆积、CLOSE_WAIT 泄漏、半连接/全连接队列溢出。
二、粘包与拆包:TCP 没有消息边界
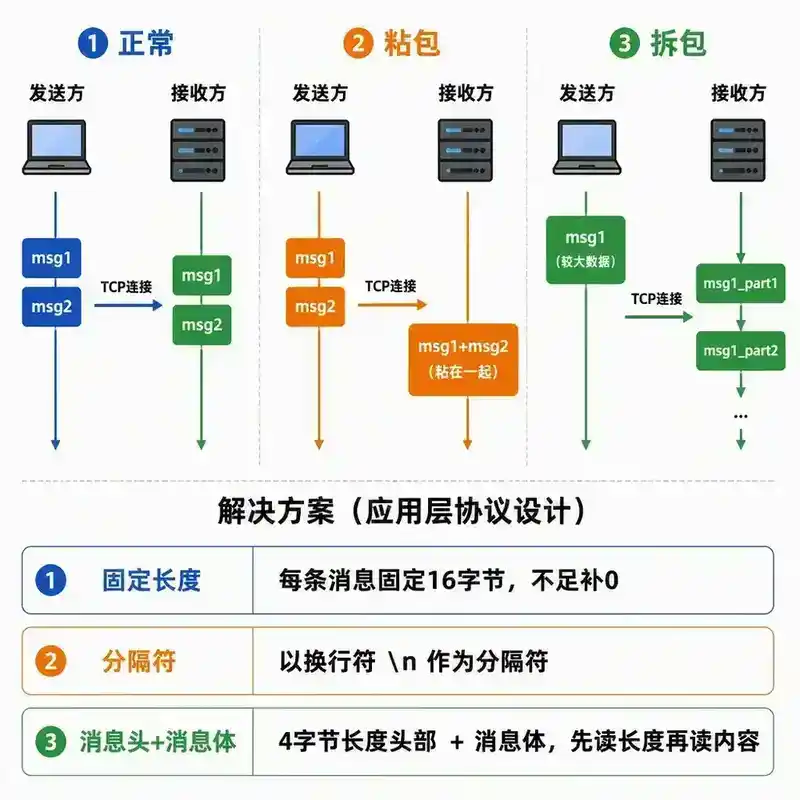
TCP 是面向字节流的协议,不是面向消息的协议。应用层调用 write() 发送数据,TCP 只是将数据放入发送缓冲区,协议栈自己决定如何分包发送。调用 read() 接收数据时,收到的是一段字节流,没有任何"消息边界"标记。
- 粘包:发送方多次小数据写入,TCP 合并为一个报文发送,接收方一次读取多个消息。
- 拆包:发送方一次大数据写入,TCP 拆分为多个报文发送,接收方一次读取不到完整消息。
原因:Nagle 算法合并小包、MSS 限制拆分大包、接收方缓冲区大小不固定、网络延迟和拥塞控制影响发送时机。
三种解决方案:
- 固定长度消息:每个消息固定 N 字节,不足补零。简单但浪费空间。
- 分隔符:用特殊字符(如 \n)分隔。HTTP 用空行分隔头部和正文。需处理转义。
- 消息头 + 消息体(最常用):消息头包含消息体长度,接收方先读固定长度头部,解析出长度,再读对应长度内容。Netty 的 LengthFieldBasedFrameDecoder 就是这种实现。
// 消息格式:[4字节长度][N字节消息体]
out.writeInt(body.length); out.write(body);  // 发送
int length = in.readInt(); in.readFully(body);  // 接收
Netty 提供开箱即用的解码器:FixedLengthFrameDecoder、DelimiterBasedFrameDecoder、LengthFieldBasedFrameDecoder、LineBasedFrameDecoder。
[图1:TCP粘包拆包示意图——正常/粘包/拆包三种场景,以及三种解决方案]
三、TIME_WAIT:不是 bug,是机制
TIME_WAIT 是主动关闭方在发送最后一个 ACK 后进入的状态,持续 2MSL(通常 60 秒)。目的:确保最后一个 ACK 到达服务端,让旧连接的所有报文在网络中消失。
TIME_WAIT 过多的危害:端口耗尽(每个 TIME_WAIT 占用一个本地端口,可用约 28000 个)、内存占用(每个约 2KB)、连接建立变慢。
解决方案:
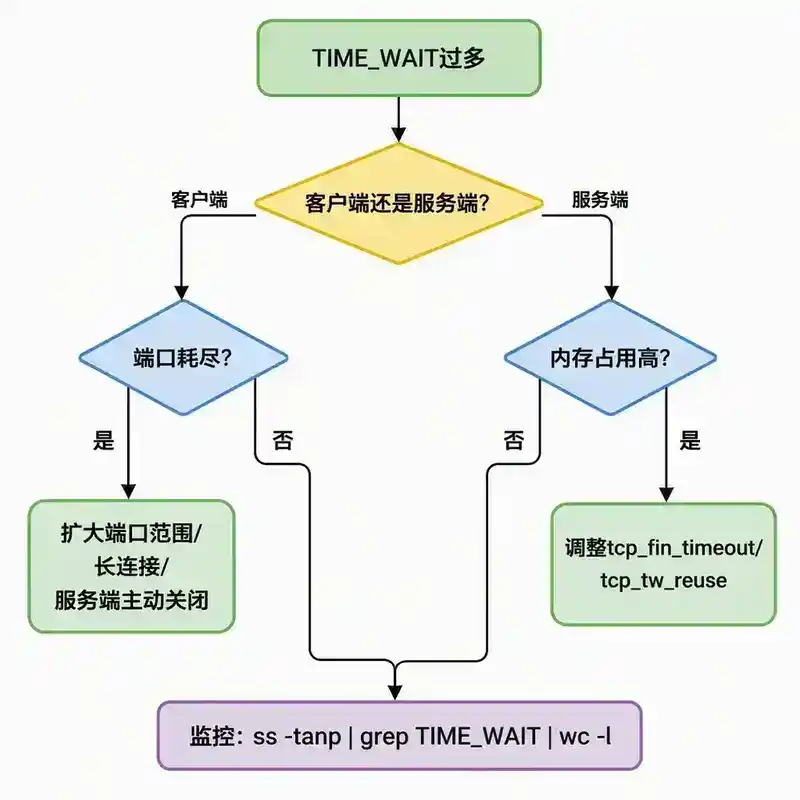
- 内核参数调优:tcp_tw_reuse = 1(允许 TIME_WAIT 连接用于新 SYN)、tcp_fin_timeout = 30(减少持续时间)。
- 扩大端口范围:ip_local_port_range = 1024 65535。
- 使用长连接:HTTP Keep-Alive 或连接池复用连接。
- 让服务端主动关闭:TIME_WAIT 出现在服务端,而服务端端口固定,不存在端口耗尽。
[图2:TIME_WAIT问题排查流程图——区分客户端/服务端,分支到不同解决方案]
四、CLOSE_WAIT:代码 bug 的典型信号
CLOSE_WAIT 是被动关闭方在收到 FIN 后进入的状态。收到 FIN 表示对方已关闭连接,但本地应用程序还没调用 close() 或 shutdown()。CLOSE_WAIT 不是 TCP 协议层面的问题,而是应用程序代码的 bug。
常见原因:连接池未正确归还和关闭、异常处理中缺少 finally 块的 close()、数据库连接/HTTP 连接泄漏、线程阻塞导致无法执行 close()。
排查方法:
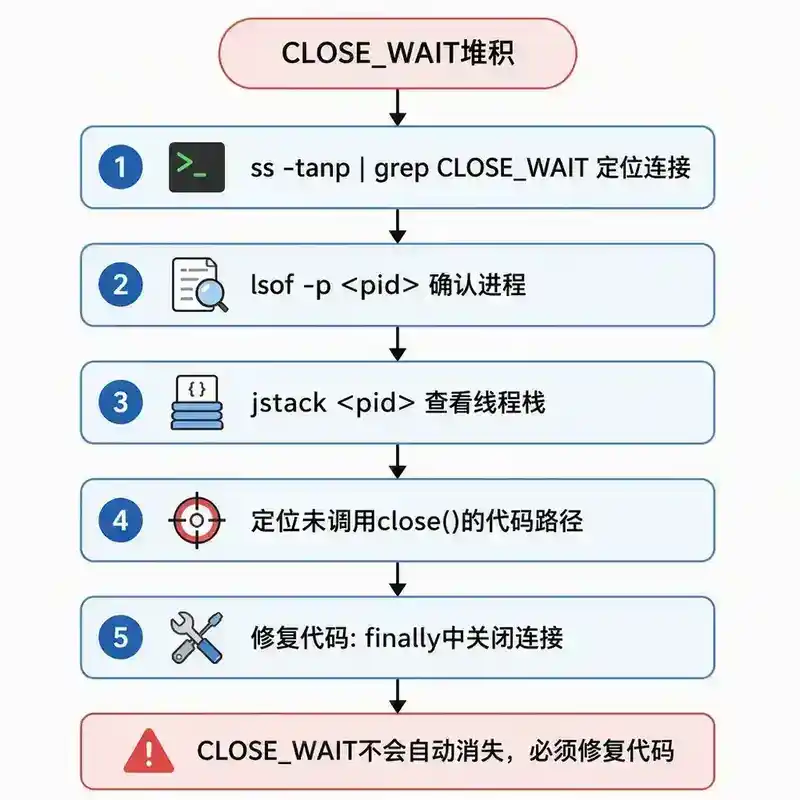
ss -tanp | grep CLOSE_WAIT | wc -l    # 查看数量
ss -tanp | grep CLOSE_WAIT             # 查看具体连接
ss -tanp | grep CLOSE_WAIT | awk '{print $NF}' | sort | uniq -c | sort -rn  # 按进程统计
lsof -p <pid> | grep TCP               # 查看进程打开的连接
CLOSE_WAIT 不会自动消失——必须修复代码。关键检查点:所有 Socket/Connection 的创建和关闭是否成对、异常处理中是否在 finally 块中关闭了连接、使用 try-with-resources 自动关闭资源。
[图3:CLOSE_WAIT排查流程图——ss→lsof→jstack→定位代码→修复]
五、半连接队列与全连接队列
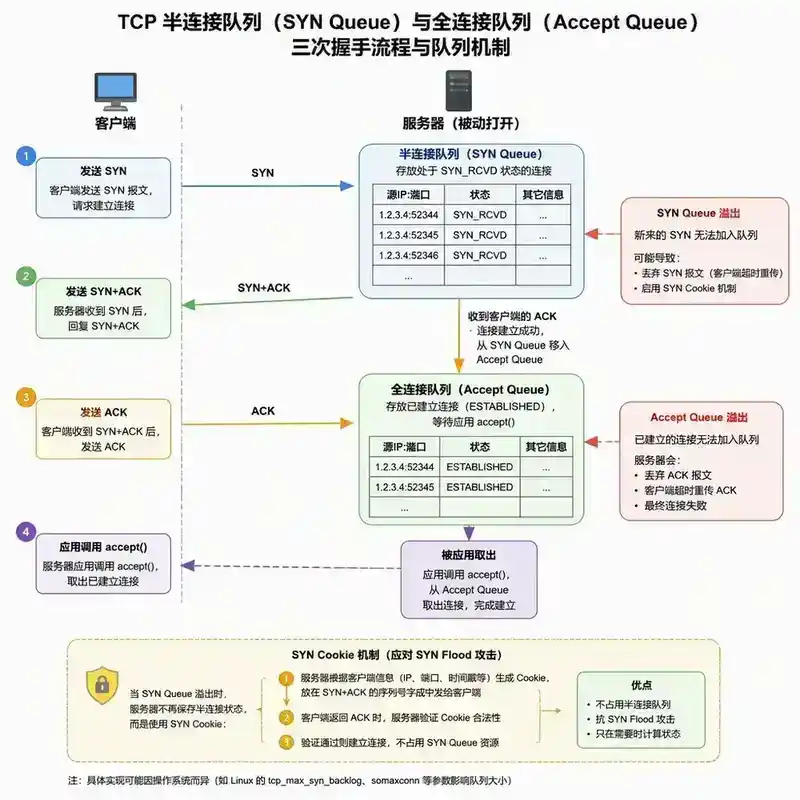
三次握手中,内核维护两个队列:
- 半连接队列(SYN Queue):收到 SYN 后放入,处于 SYN_RCVD 状态,等待客户端 ACK。
- 全连接队列(Accept Queue):收到 ACK 后从半连接队列移到全连接队列,处于 ESTABLISHED 状态,等待 accept() 取走。
半连接队列溢出:通常由 SYN Flood 攻击导致。防御:SYN Cookie(编码连接信息到 SYN+ACK 的序列号中,不占用队列空间)、增大 tcp_max_syn_backlog。
全连接队列溢出:通常由 accept() 速度不够快导致。排查:netstat -s | grep "overflowed" 查看溢出次数,ss -lnt 查看当前队列使用情况。解决:增大 backlog 和 net.core.somaxconn,优化应用程序处理速度。
全连接队列大小 = min(backlog, net.core.somaxconn)。应用程序的 backlog 参数和内核的 somaxconn 都需要调整。
[图4:半连接队列与全连接队列示意图——三次握手中两个队列的状态变化和溢出条件]
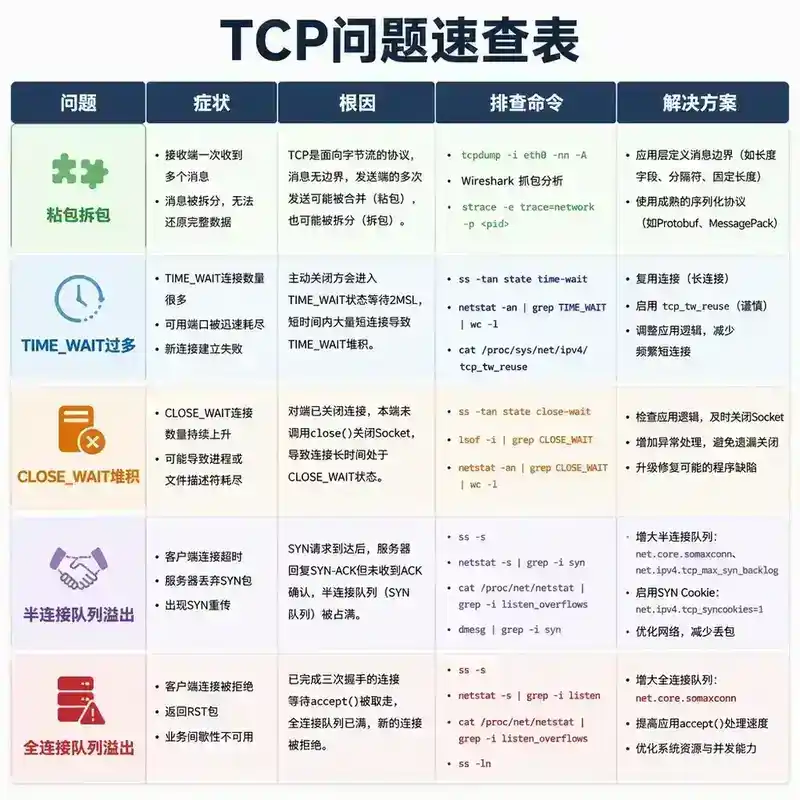
六、TCP 问题速查表
| 问题 | 症状 | 根因 | 解决方案 |
|---|---|---|---|
| 粘包拆包 | 消息解析错误 | TCP 无消息边界 | 消息头+消息体/分隔符 |
| TIME_WAIT 过多 | 端口耗尽 | 大量短连接主动关闭 | 长连接/服务端主动关闭 |
| CLOSE_WAIT 堆积 | 连接泄漏/fd 耗尽 | 未调用 close() | 修复代码/finally 关闭 |
| 半连接队列溢出 | 连接建立缓慢 | SYN 攻击 | SYNCookie/增大 backlog |
| 全连接队列溢出 | 连接后无响应 | accept() 速度不够 | 增大 backlog+somaxconn |
[图5:TCP问题速查表——五列展示问题/症状/根因/排查命令/解决方案]
七、面试常见误区
- "粘包是 TCP 的 bug" —— 不是。TCP 是字节流协议,没有消息边界,应用层需要自己处理。
- "TIME_WAIT 应该尽快消除" —— 不应该。TIME_WAIT 是 TCP 协议的必要设计,强行消除可能导致数据错乱。
- "CLOSE_WAIT 会自动消失" —— 不会。CLOSE_WAIT 只有在应用程序调用 close() 后才会消失。
- "全连接队列溢出就是 backlog 不够大" —— 不完全是。也可能是 accept() 线程被阻塞,增大 backlog 只是延缓。
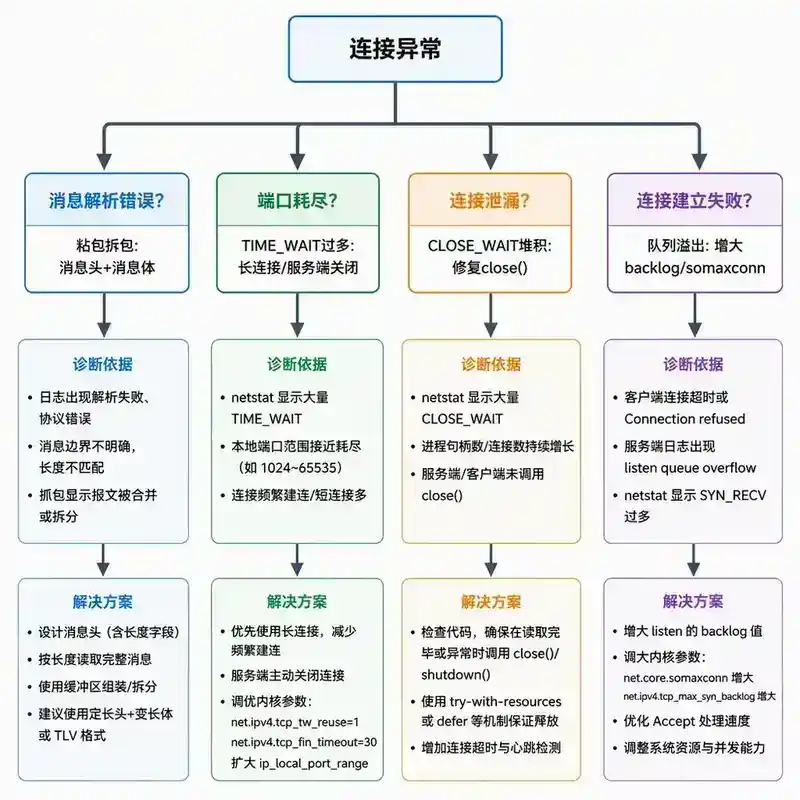
[图6:TCP问题排查决策树——从连接异常出发,区分四种问题类型,分支到不同排查路径]
八、总结
TCP 四种常见问题分为两类:应用层问题(粘包拆包需代码处理、CLOSE_WAIT 需修复代码)和运维层问题(TIME_WAIT 需调优内核参数、队列溢出需调整 backlog)。排查思路:先用 ss -tanp 查看连接状态,定位问题类型,再选择对应的排查和修复方案。
延伸阅读
- Linux man page:tcp(7)
- Netty 官方文档:FrameDecoder
- 本系列相关篇目:075(TCP 可靠传输)、073(多路复用机制)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 TCP 常见问题的深度理解和实战经验。
Q1:你使用 Netty 的 LengthFieldBasedFrameDecoder 处理粘包拆包,但线上偶尔出现 "too long frame" 异常。你如何排查是真正的畸形数据包,还是 LengthFieldBasedFrameDecoder 的参数配置错误?
LengthFieldBasedFrameDecoder 的四个核心参数:lengthFieldOffset(长度字段偏移量)、lengthFieldLength(长度字段字节数)、lengthAdjustment(长度调整值)、initialBytesToStrip(跳过字节数)。排查步骤:1)先用 Wireshark 或 tcpdump 抓包,查看原始 TCP 数据,确认发送方的消息格式是否与解码器配置一致。2)用 Netty 的 LoggingHandler 在解码器之前打印原始字节流,确认字节流是否被截断或乱序。3)检查 lengthFieldOffset 是否正确地指向了长度字段——如果发送方用的是 4 字节长度 + 4 字节类型 + 消息体,lengthFieldOffset 应该是 0 而非 4。4)检查 lengthAdjustment——如果长度字段的值只包含消息体长度,lengthAdjustment 应该为 0;如果长度字段的值包含了消息头长度,lengthAdjustment 应该为负值。5)如果确认参数正确,检查是否有其他异常导致 TCP 连接乱序了数据。
Q2:你在线上看到 Nginx 的 TIME_WAIT 有 2 万个,运维说需要调优。但你发现 Nginx 是作为反向代理连接后端的,活跃连接只有 500 个。为什么 TIME_WAIT 这么多?是正常的吗?
Nginx 反向代理到后端时,每个客户端请求可能需要建立一个新的到后端的 TCP 连接。如果客户端请求量是 500 QPS,而每个连接的生命周期是 60 秒(TIME_WAIT 持续时间),那么 TIME_WAIT 连接数 = 500 * 60 = 30000 个。2 万个 TIME_WAIT 完全在正常范围内。判断是否正常的关键不是 TIME_WAIT 的绝对数量,而是:1)TIME_WAIT 是否在持续增长还是不增长(稳定在 2 万是正常的)。2)是否有端口耗尽的症状(新连接建立失败)。3)可用端口范围是否足够(ip_local_port_range)。如果端口没有耗尽,这 2 万个 TIME_WAIT 不需要处理——它们是 TCP 协议正常运行的产物。如果担心端口耗尽,解决方案是使用 Nginx 到后端的 keepalive 长连接池,或者调整 ip_local_port_range 扩大可用端口。
Q3:CLOSE_WAIT 和 TIME_WAIT 都出现在连接关闭时,它们有什么本质区别?为什么 CLOSE_WAIT 是 bug 而 TIME_WAIT 是正常设计?
本质区别:CLOSE_WAIT 是被动关闭方在收到 FIN 后、调用 close() 前的状态——它表示应用程序"知道对方关闭了,但还没关闭自己"。TIME_WAIT 是主动关闭方在发送最后一个 ACK 后进入的状态——它表示"我已经完成了关闭流程,但需要等 2MSL 确保旧报文消失"。CLOSE_WAIT 是 bug 信号的原因:TCP 协议栈已经帮你把 FIN 事件通知给应用程序了,应用程序应该立即关闭连接。如果一直不关闭,说明应用程序代码有问题——要么是连接泄漏,要么是逻辑 bug。TIME_WAIT 是正常设计的原因:2MSL 的等待是 TCP 协议规范要求的,目的是确保旧报文消失和最后一个 ACK 可靠送达。两者都是"等待"状态,但 CLOSE_WAIT 是"等待应用程序行动",TIME_WAIT 是"等待时间流逝"。
Q4:你在压测时发现服务端 accept() 返回新连接的速度变慢,但 CPU 和内存都很低。用 ss 查看发现全连接队列(Recv-Q)接近满。增大 backlog 和 somaxconn 后改善不明显。为什么?
全连接队列溢出但增大 backlog 改善不明显,说明根因不是 backlog 太小,而是 accept() 的速度跟不上。可能原因:1)accept() 和业务处理在同一个线程中——如果业务处理耗时,accept() 就无法及时取走新连接。解决方案:将 accept() 和业务处理分离,accept() 线程只负责快速取走连接,交给业务线程池处理。2)Netty 的 BossGroup 线程数太少——如果只有一个 Boss 线程负责 accept(),在高并发下可能成为瓶颈。适当增加 BossGroup 线程数。3)JDK 的 accept() 实现本身有锁竞争——在低版本 JDK 中,ServerSocketChannel 的 accept() 有全局锁。升级到 JDK 11+ 可以改善。4)SO_REUSEPORT 可以让多个线程同时监听同一个端口,分散 accept() 的负载。
Q5:你发现线上服务有大量 CLOSE_WAIT,但代码中所有的 Socket 都用了 try-with-resources。为什么还会出现 CLOSE_WAIT?
try-with-resources 只保证在 try 块结束时自动关闭资源,但有几个边界情况:1)如果 Socket 被传递给另一个线程或方法,且该线程持有 Socket 的引用,try-with-resources 关闭了 Socket 但另一个线程可能还在使用它——这会导致异常,但不会产生 CLOSE_WAIT。2)更常见的情况是连接池——连接池中的连接不会被 try-with-resources 关闭,因为它们需要被复用。如果连接池没有正确配置空闲连接的回收策略,或者归还连接时发生了异常,连接可能一直处于 ESTABLISHED 状态,直到对方关闭。3)数据库连接池(如 HikariCP)的连接如果长时间未使用,数据库端可能已经关闭了连接(wait_timeout),但客户端连接池不知道,连接处于 CLOSE_WAIT。解决:配置连接池的 idleTimeout 和 maxLifetime,并开启连接池的 keepalive 检测。