一、多路复用解决了什么问题
在 C10K 问题出现之前,网络服务器的主流模型是"一个连接一个进程/线程"。每个连接独占一个线程,线程在 read() 上阻塞等待数据。当连接数超过几百个时,线程数爆炸——上万线程的上下文切换开销让系统无法承受。
多路复用(Multiplexing)的核心思想是:将"等待数据就绪"这个操作从每个线程中剥离出来,交给内核统一管理。一个线程可以同时监听成千上万个连接,内核告诉它"哪些连接有数据就绪了",线程只处理就绪的连接。
Linux 内核提供了三种多路复用机制:select、poll、epoll。它们解决的是同一个问题,但实现方式和性能特征天差地别。
二、select:最早的实现,也是最受限的
select 的核心 API:int select(int nfds, fd_set *readfds, fd_set *writefds, fd_set *exceptfds, struct timeval *timeout)。
调用流程:1)用户态构造 fd_set(位图,每个 bit 代表一个 fd)。2)调用 select(),内核将 fd_set 拷贝到内核空间。3)内核遍历 fd_set 中的每个 bit,检查对应 fd 是否有事件就绪。4)如果有事件就绪,将 fd_set 中对应 bit 保留,其他 bit 清零。5)返回到用户态,用户态再次遍历 fd_set。
三大缺陷:fd_set 是固定大小的位图,默认最多 1024 个 fd(FD_SETSIZE)。每次调用都需要将整个 fd_set 从用户态拷贝到内核态。O(n) 遍历复杂度——即使只有 1 个 fd 就绪,也需要遍历全部。
三、poll:去掉 1024 限制,但本质未变
poll 的核心 API:int poll(struct pollfd *fds, nfds_t nfds, int timeout)。pollfd 结构体包含 fd、关注的事件(events)和返回的就绪事件(revents)。
poll 相比 select 的改进:去掉了 1024 限制,理论上可以监听任意数量的 fd。pollfd 结构体将"fd"和"事件"绑定在一起,不需要每次重新设置。events 和 revents 分离——不需要每次清零。
poll 与 select 的共同缺陷:仍然是 O(n) 遍历,每次调用都需要将整个 pollfd 数组拷贝到内核态。当连接数增长时,性能线性下降。
四、epoll:解决 C10K 问题的关键技术
epoll 的核心改进是将"注册 fd"和"等待事件"分离,通过在内核中维护一个事件表来避免每次重复传递 fd 列表。
三个核心 API:epoll_create(创建 epoll 实例)、epoll_ctl(注册/修改/删除 fd)、epoll_wait(等待事件)。
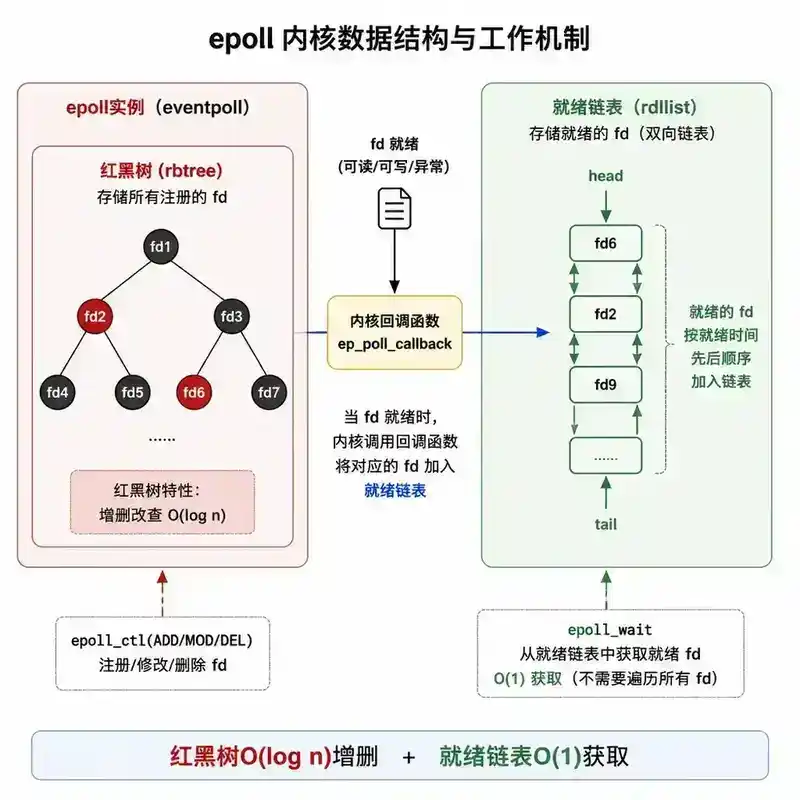
工作流程:epoll_create() 创建 eventpoll 结构体(包含红黑树和就绪链表)。epoll_ctl(EPOLL_CTL_ADD) 将 fd 添加到红黑树,同时注册回调——当 fd 有事件就绪时,回调将 fd 加入就绪链表。epoll_wait() 直接检查就绪链表,不需要遍历所有 fd。
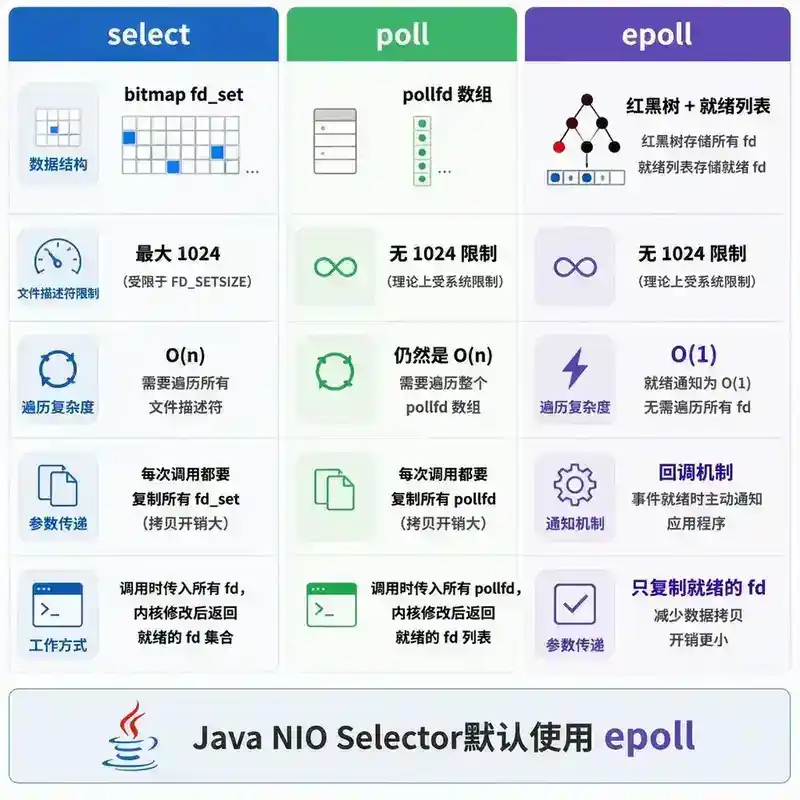
epoll 为什么比 select/poll 快:红黑树 O(log n) 增删 + 就绪链表 O(1) 获取 + 回调机制(事件驱动而非轮询)+ 只拷贝就绪的 fd 到用户态。
[图1:select/poll/epoll三种机制对比图——数据结构、工作流程、时间复杂度、优缺点]
[图2:epoll内核数据结构示意图——红黑树存储注册fd、就绪链表存储就绪fd、回调机制]
五、水平触发(LT)vs 边缘触发(ET)
这是 epoll 的两种工作模式,也是面试中的高频考点。
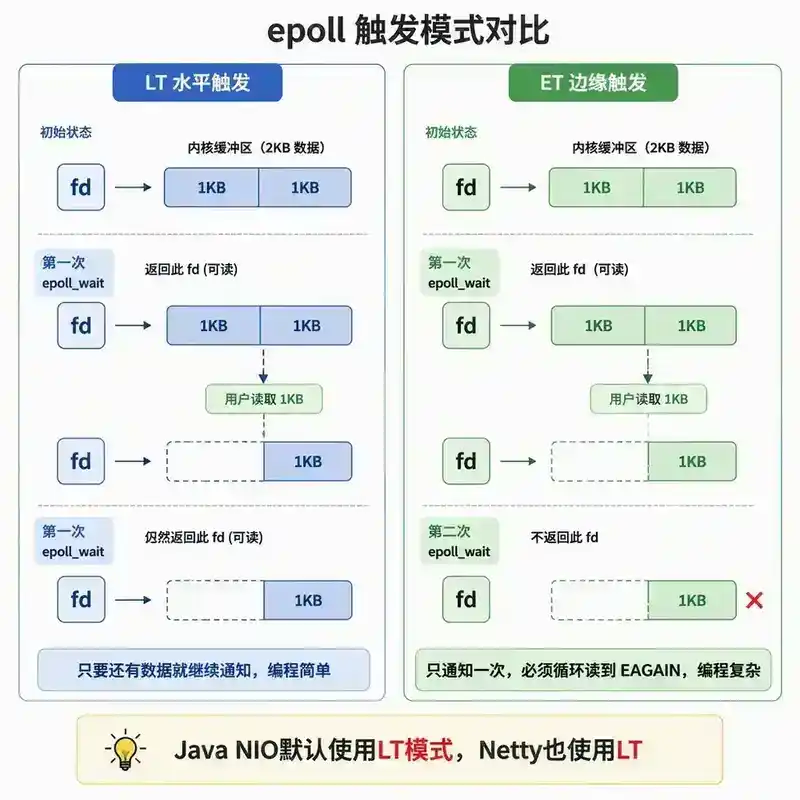
水平触发(LT,默认):只要 fd 还有数据可读,每次 epoll_wait 都会返回该 fd。行为与 select/poll 一致——"没读完就继续通知"。编程简单,但可能产生多余的 epoll_wait 调用。
边缘触发(ET):只在 fd 状态从未就绪变为就绪时通知一次。必须一次性把数据读完(循环 read 直到返回 EAGAIN),否则剩余数据永远不会被通知。编程复杂,但可以减少 epoll_wait 调用次数。
ET 模式必须配合非阻塞 I/O 使用——如果使用阻塞 I/O,read() 会在没有数据时阻塞,而 ET 模式只通知一次,可能导致线程永久阻塞。
// 边缘触发模式下的正确读法
while (1) {
    n = read(fd, buf, sizeof(buf));
    if (n > 0) { /* 处理数据 */ }
    else if (n == 0) { break; /* 连接关闭 */ }
    else if (n == -1 && errno == EAGAIN) { break; /* 数据读完 */ }
    else { break; /* 真正的错误 */ }
}
[图4:水平触发LT vs 边缘触发ET对比图——两种模式的触发时机差异和正确编程范式]
六、Java NIO Selector 与 epoll 的映射
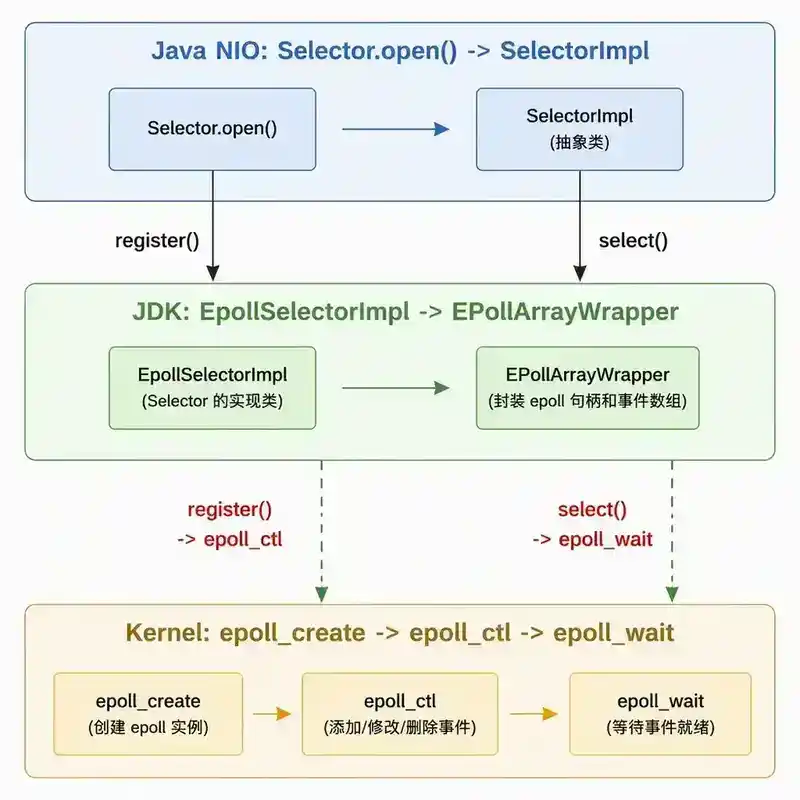
Java NIO 的 Selector 在 Linux 上默认使用 epoll 实现:Selector.open() -> EpollSelectorImpl -> epoll_create/ctl/wait。Java NIO 默认使用水平触发(LT)模式,因为 LT 编程更简单且 NIO 的 Buffer 机制天然支持"读多少算多少"。
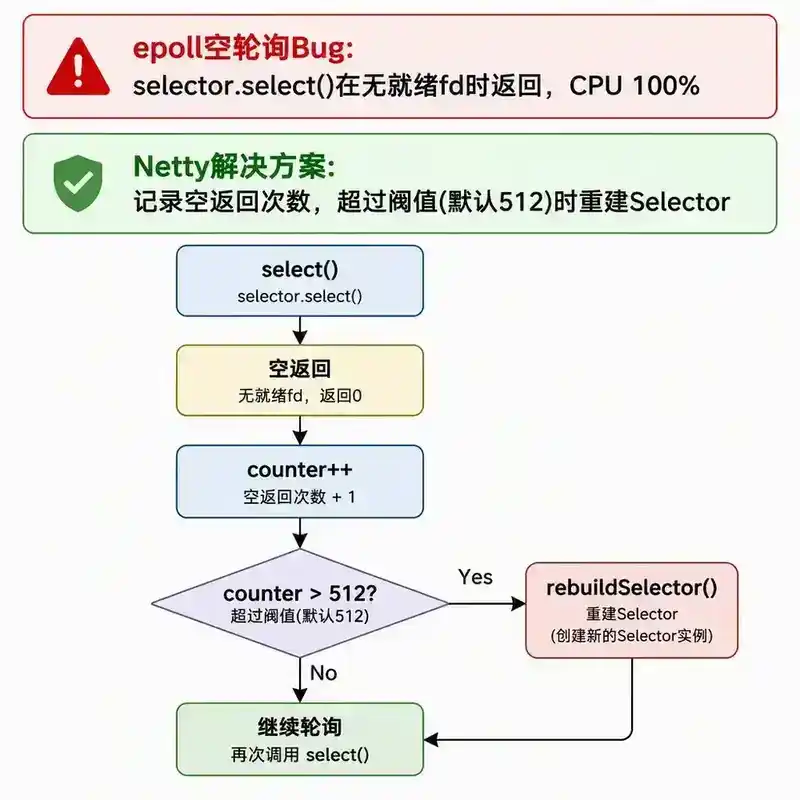
epoll 空轮询 Bug:epoll_wait() 在没有任何 fd 就绪时返回,导致 selector.select() 立即返回、线程死循环、CPU 100%。Netty 的解决方案:记录 select() 空返回次数,超过阈值(默认 512)后重建 Selector。
[图3:Java NIO Selector与epoll映射关系图]
[图5:epoll空轮询Bug与Netty重建Selector解决方案]
七、多路复用的性能对比
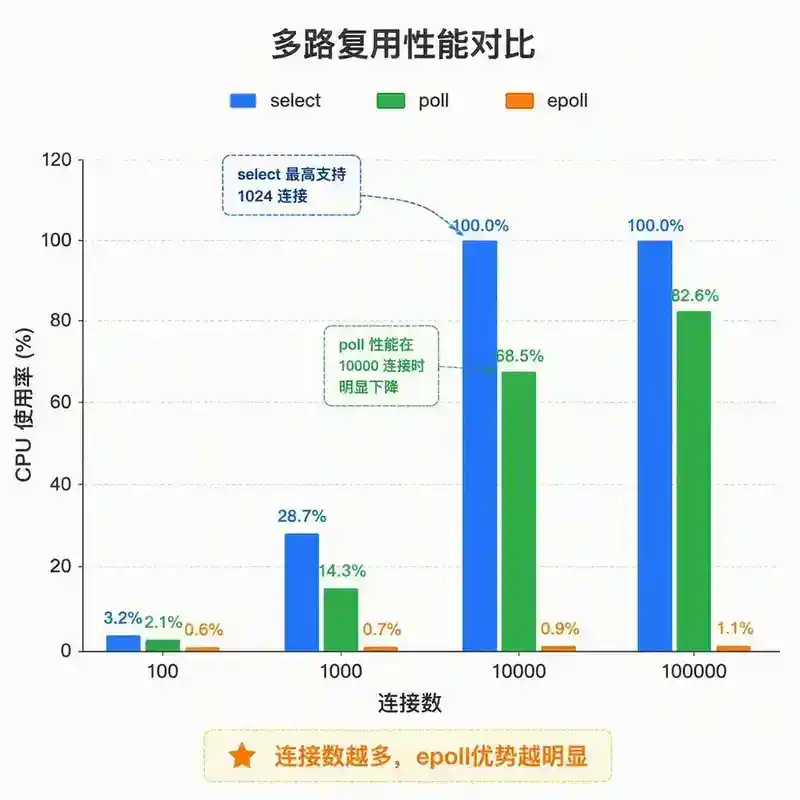
| 连接数 | select CPU | poll CPU | epoll CPU |
|---|---|---|---|
| 100 | 1% | 1% | 1% |
| 1000 | 5% | 3% | 1% |
| 10000 | 50% | 30% | 2% |
| 100000 | 不可用 | 不可用 | 5% |
连接数越多,epoll 的优势越明显。1000 个连接以下,select/poll 也可以用;10000 个连接以上,必须用 epoll。
[图6:多路复用性能对比柱状图——不同连接数下select/poll/epoll的CPU占用]
八、面试常见误区
- "poll 比 select 快" —— 不一定。poll 只是去掉了 1024 限制,本质仍然是 O(n) 遍历。
- "epoll 一定比 select 快" —— 在 fd < 10 的极简场景下,select 的简单实现可能更快。
- "ET 模式一定比 LT 模式快" —— ET 减少了系统调用但增加了编程复杂度。Netty 使用 LT 性能已经足够好。
- "Java NIO 默认使用 epoll,所以不需要关心底层" —— 不对。epoll 空轮询 bug 需要了解底层才能理解和规避。
九、总结
select/poll/epoll 的演进是 Linux 内核为应对"连接数增长"而不断优化的结果:
- select:最早的实现,fd_set 位图,最大 1024,O(n) 遍历。
- poll:去掉了 1024 限制,但仍 O(n) 遍历。
- epoll:红黑树 + 回调机制,O(1) 获取就绪 fd,解决 C10K 问题。
理解这些差异,不只是为了面试,更是为了理解 Netty 等框架的底层行为——为什么选择 epoll、为什么需要处理 epoll bug、为什么默认使用水平触发。
延伸阅读
- Linux man page:select(2)、poll(2)、epoll(7)
- Netty 源码:EpollEventLoop、NioEventLoop
- 本系列相关篇目:071(BIO/NIO/AIO)、072(NIO 核心组件)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对多路复用机制的深度理解和实战经验。
Q1:你在 epoll 的 ET 模式下,第一次 read() 读了 1KB,第二次 read() 返回了 EAGAIN,你以为读完了。但实际上客户端在两次 read() 之间又发送了 500 字节。这 500 字节会丢失吗?为什么?
不会丢失。ET 模式的"只通知一次"是指 fd 状态从"未就绪"变为"就绪"时通知一次。如果客户端在两次 read() 之间又发送了 500 字节,fd 会再次从"数据被读完(未就绪)"变为"有新数据(就绪)",epoll 会再次触发通知。但如果第二次 read() 返回 EAGAIN 时客户端的数据还没到达,epoll 会在数据到达时再次触发通知。ET 模式的关键约束是"在收到通知后必须读到 EAGAIN 才停止",而不是"通知只发生一次"。如果严格按照这个范式编程,ET 模式不会丢数据。
Q2:你在 epoll 中注册了 10000 个 fd,但只有 50 个是活跃的(有数据频繁到达)。epoll_wait 返回时,你会拿到 50 个就绪 fd 还是全部 10000 个?如果使用 select 呢?
epoll_wait 只返回 50 个就绪的 fd——因为 epoll 使用就绪链表,只有状态发生变化的 fd 才会被加入链表。select 的行为完全不同:select 返回时,fd_set 中只有就绪的 fd 的 bit 被保留,其他被清零,所以你也只需要处理就绪的 fd。但 select 在返回前,内核需要遍历全部 10000 个 fd 来检查哪些就绪了——这就是 O(n) 的来源。epoll 不需要遍历,因为回调机制已经将就绪的 fd 加入了就绪链表。所以两者的"处理成本"相同(都是 50 个),但"通知成本"天差地别(epoll O(1) vs select O(n))。
Q3:你在 Docker 容器中运行 Java 服务,发现 epoll_create 返回了 EMFILE(Too many open files)。但你的服务只有 500 个连接,远低于 1024。为什么?怎么解决?
Docker 容器的文件描述符限制是独立的——即使宿主机限制是 65535,容器默认可能只有 1024。500 个连接意味着 500 个 socket fd + epoll fd + 日志文件 fd + jar 文件 fd + 其他 fd,很容易超过 1024。解决:1)docker run --ulimit nofile=65535:65535 或者在 docker-compose 中配置 ulimits。2)在容器内确认 ulimit -n 的值。3)检查是否有 fd 泄漏——用 lsof -p 查看实际打开的 fd 数量,如果远超连接数说明有泄漏。epoll 本身的 epoll_create 需要分配一个 fd,如果 fd 已经用完就会报 EMFILE。
Q4:epoll 的 epoll_ctl 操作(ADD/MOD/DEL)是线程安全的吗?如果两个线程同时调用 epoll_ctl 修改同一个 epoll 实例,会发生什么?
epoll_ctl 在内核中是线程安全的——内核使用自旋锁(ep->mtx)保护 eventpoll 结构体。多个线程同时调用 epoll_ctl 操作同一个 epoll 实例,内核会串行化处理,不会导致数据损坏。但这里有并发语义问题:线程 A 调用 epoll_ctl(DEL) 删除 fd,线程 B 同时调用 epoll_ctl(MOD) 修改同一个 fd,执行顺序不确定——可能是 DEL 先执行然后 MOD 失败(fd 不存在),也可能是 MOD 先执行然后 DEL 覆盖。在实际应用中(如 Netty),通常由同一个 EventLoop 线程负责同一个 Channel 的所有注册/修改/删除操作,从根本上避免了多线程并发问题。
Q5:你在 Linux 上写了一个 epoll 服务端,但发现即使没有客户端连接,CPU 使用率也有 5%。排查后发现是 epoll_wait 的 timeout 设置不当。你会怎么设置 timeout?为什么?
epoll_wait 的 timeout 参数有几种设置方式:1)timeout = -1:永久阻塞,直到有事件就绪。CPU 使用率最低,适合纯事件驱动场景。2)timeout = 0:立即返回(非阻塞)。CPU 100% 空转,除非有特殊需求否则不要用。3)timeout = N ms:阻塞 N 毫秒后返回。适合需要定期执行定时任务的场景。CPU 5% 说明 timeout 设置太短(可能是 1ms),导致 epoll_wait 频繁返回。解决方案:如果不需要定时任务,设 timeout = -1;如果需要定时任务,根据定时精度合理设置 timeout(如 50ms 或 100ms),或者使用 timerfd 将定时任务也纳入 epoll 的事件驱动体系。Netty 的 NioEventLoop 使用 timeout = 计算最近定时任务的延迟时间,既避免了空转又能准时执行定时任务。