一、Netty 的性能不只是"线程模型",内存管理同样关键
Netty 的线程模型(079)解决了"怎么高效处理连接"的问题,但如果没有高效的内存管理,百万连接会因为内存分配和 GC 而崩溃。本文覆盖 ByteBuf 设计、池化内存、引用计数、拆包器和背压机制。
二、ByteBuf:Netty 重新发明的"缓冲区"
Java NIO 的 ByteBuffer 有四个经典问题:读写切换需要 flip()、容量固定不可变、API 不直观、不支持池化。Netty 的 ByteBuf 核心改进:读写指针分离(readerIndex/writerIndex 独立,不需要 flip())、容量自动扩展、池化支持、引用计数、丰富操作。
三种内存类型:Heap Buffer(JVM 堆,分配快,I/O 多一次拷贝)、Direct Buffer(堆外,不受 GC 管,I/O 零拷贝)、Composite Buffer(逻辑组合多个 Buffer,不拷贝数据)。
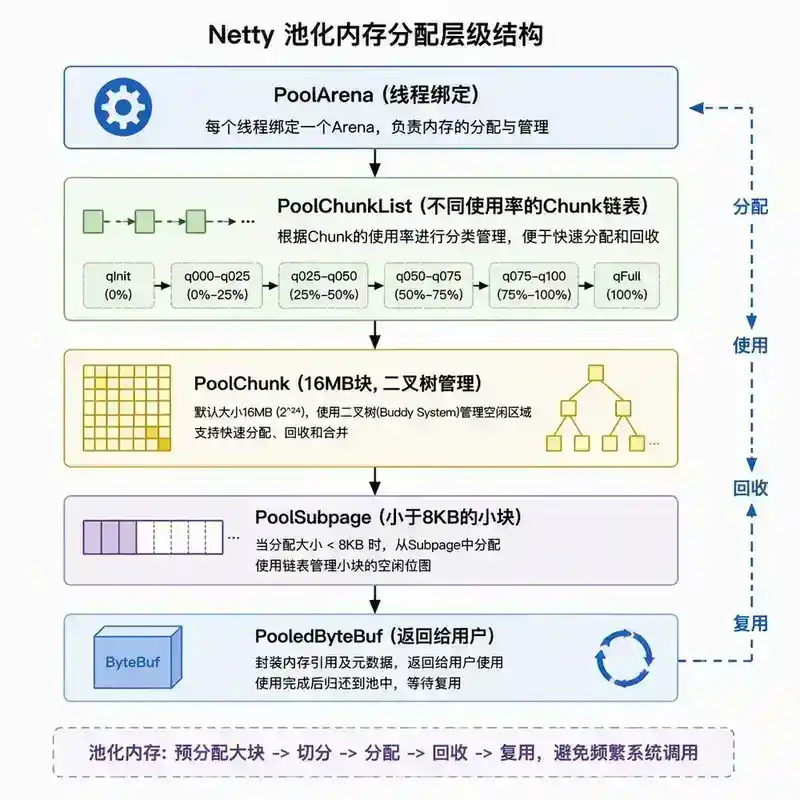
池化内存(PooledByteBufAllocator):预分配大块直接内存,切分为 PoolChunk 和 PoolSubpage,ByteBuf 释放时归还到池中复用。避免频繁系统调用(malloc/free),大幅降低直接内存分配开销。生产环境推荐启用。
[图1:池化内存分配层级图——PoolArena→PoolChunkList→PoolChunk→PoolSubpage→PooledByteBuf]
三、引用计数:ByteBuf 的生命周期管理
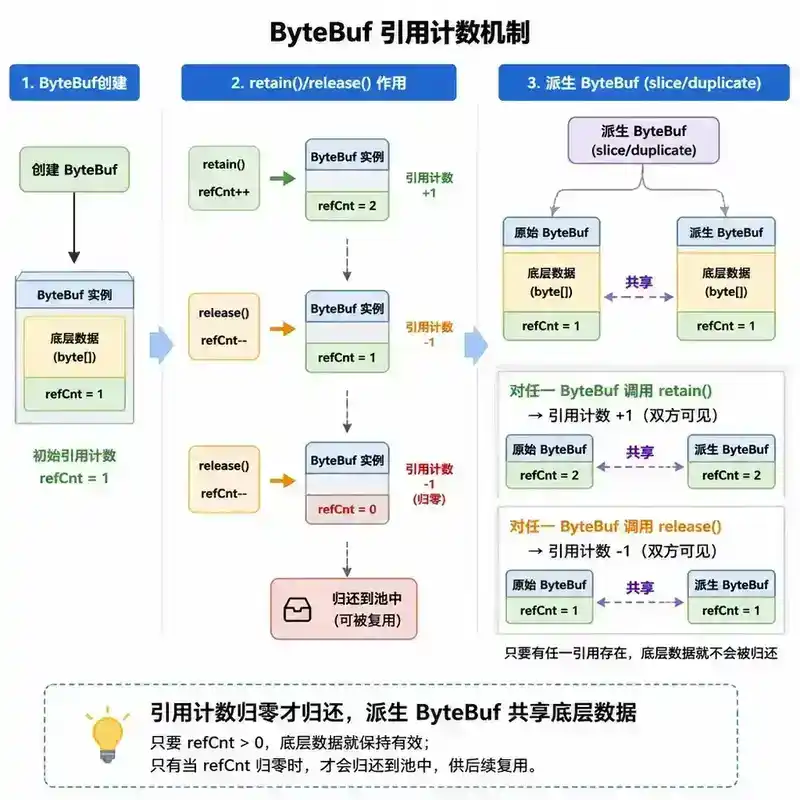
Netty 的 ByteBuf 支持零拷贝派生——slice()、duplicate() 等方法创建的 ByteBuf 与原始 ByteBuf 共享底层数据。引用计数确保只有当引用计数降到 0 时,ByteBuf 才真正归还到池中。
ByteBuf buf = PooledByteBufAllocator.DEFAULT.buffer();
buf.retain();  // refCnt +1
buf.release(); // refCnt -1 (still 1)
buf.release(); // refCnt 0 -> 归还到池中
谁创建谁释放:Inbound 消息由 Netty 分配,处理完需要释放。使用 SimpleChannelInboundHandler 自动释放,或手动调用 ReferenceCountUtil.release()。Netty 提供内存泄漏检测:-Dio.netty.leakDetection.level=PARANOID。
[图2:ByteBuf引用计数机制图——retain()/release()流程,派生ByteBuf共享底层数据,引用计数归零归还池中]
四、拆包器:处理 TCP 粘包拆包
TCP 是字节流协议,没有消息边界。Netty 提供多种拆包器:FixedLengthFrameDecoder(固定长度)、LineBasedFrameDecoder(换行符)、DelimiterBasedFrameDecoder(自定义分隔符)、LengthFieldBasedFrameDecoder(消息头+消息体,最常用)。
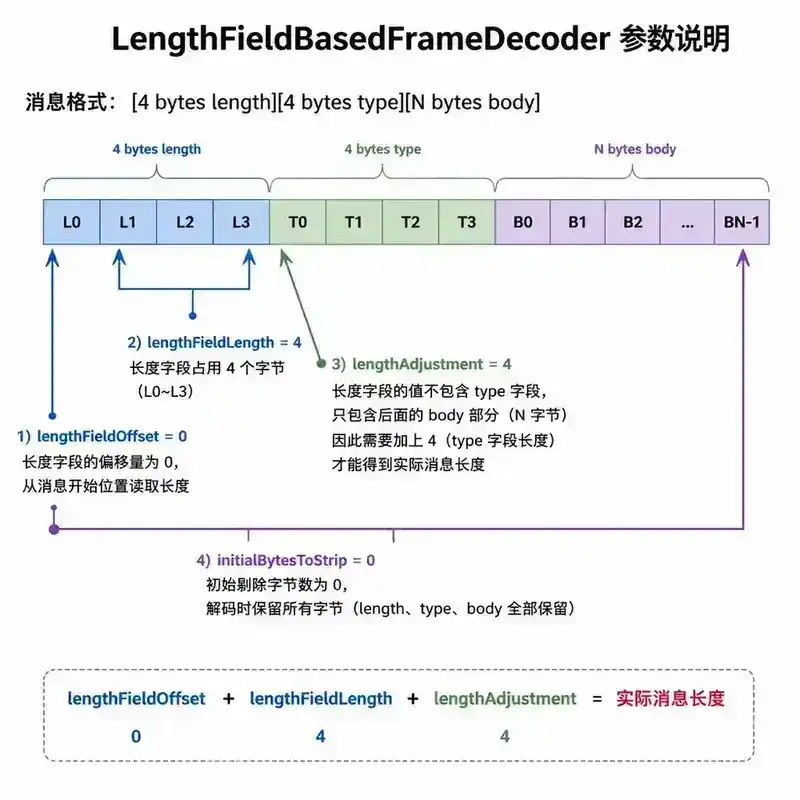
LengthFieldBasedFrameDecoder 五个参数:maxFrameLength(最大帧长)、lengthFieldOffset(长度字段偏移量)、lengthFieldLength(长度字段字节数)、lengthAdjustment(长度调整值)、initialBytesToStrip(跳过字节数)。消息格式为 [4字节长度][4字节类型][N字节消息体] 时,lengthFieldOffset=0, lengthFieldLength=4, lengthAdjustment=4, initialBytesToStrip=0。
[图3:LengthFieldBasedFrameDecoder参数解析图——消息格式与五个参数对应关系]
五、背压(Backpressure):防止内存溢出
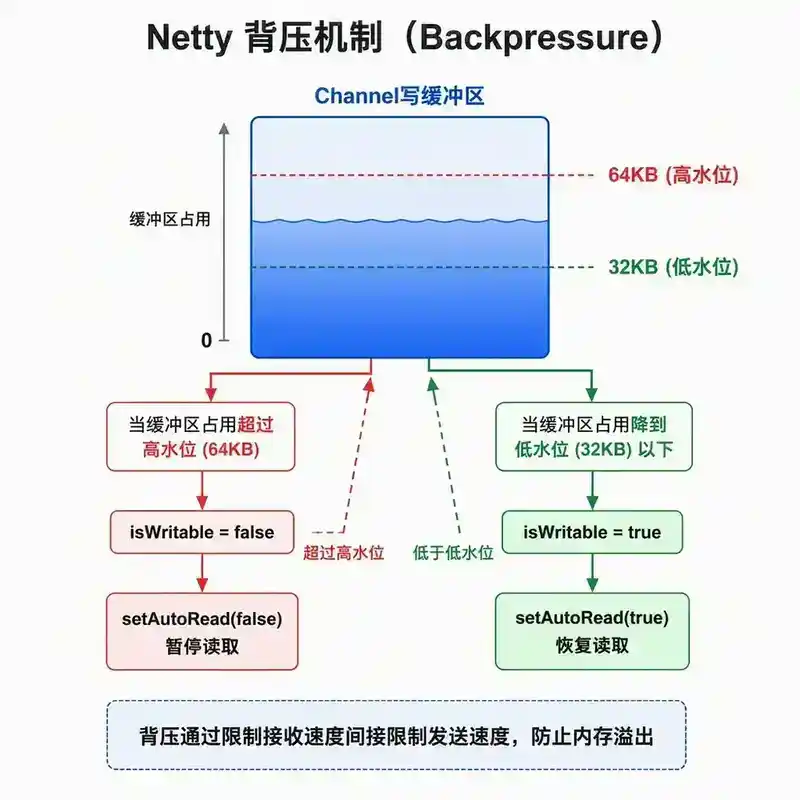
Netty 的背压机制基于高低水位线(WRITE_BUFFER_WATER_MARK)。当写缓冲区超过高水位(如 64KB)时,Channel 变为不可写状态(isWritable=false),Netty 自动暂停该 Channel 的读取操作(setAutoRead(false)),从而让发送方减慢发送速度。当缓冲区降到低水位(如 32KB)以下时,恢复为可写状态,恢复读取。
childOption(ChannelOption.WRITE_BUFFER_WATER_MARK,
    new WriteBufferWaterMark(32 * 1024, 64 * 1024));
[图4:Netty背压机制示意图——写缓冲区→超水位→暂停读取→降水位→恢复读取]
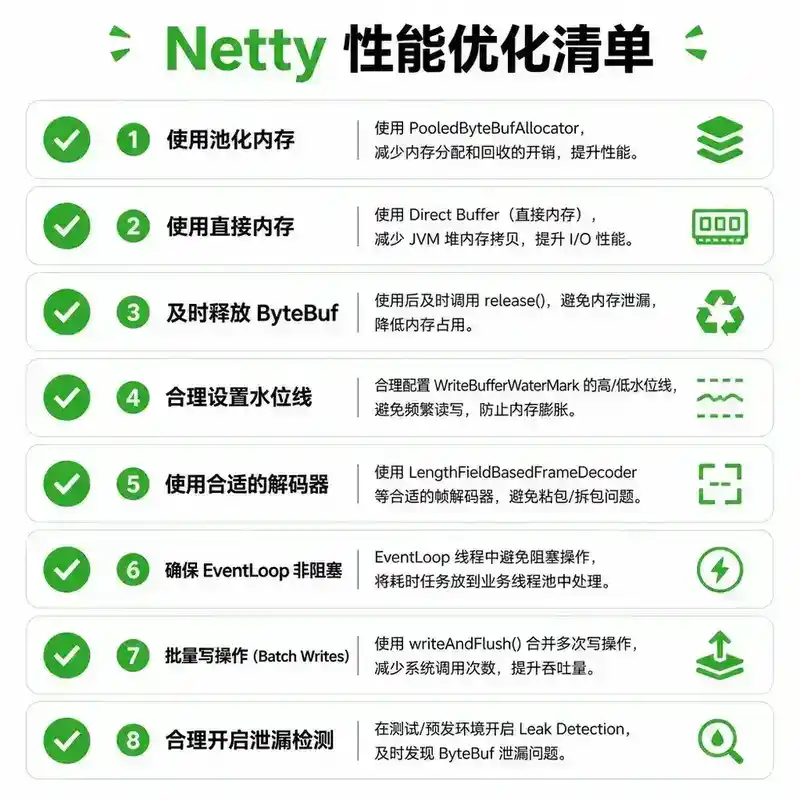
六、Netty 性能优化清单
- 使用池化内存:PooledByteBufAllocator 替代默认非池化分配器
- 使用直接内存:网络 I/O 用 Direct Buffer,减少一次拷贝
- 正确释放 ByteBuf:使用 SimpleChannelInboundHandler 或手动 release
- 配置合适的水位线:防止发送过快导致 OOM
- 选择合适的拆包器:二进制协议用 LengthFieldBasedFrameDecoder
- 避免 EventLoop 阻塞:耗时操作提交到业务线程池
- 合并多次 write:write() 后统一 flush(),减少系统调用
- 开启内存泄漏检测:开发环境 PARANOID,生产环境 SIMPLE
[图5:Netty性能优化清单——八大优化项图标和简要说明]
七、面试常见误区
- "ByteBuf 的 release() 就是释放内存" —— 对于池化 ByteBuf,release() 是将内存归还到池中。
- "Direct Buffer 不需要手动释放" —— Direct Buffer 不受 GC 管理,必须手动 release。
- "背压就是限制发送速度" —— Netty 的背压是限制接收速度(暂停读取),间接限制发送速度。
- "CompositeByteBuf 就是零拷贝" —— 只有在组件数量少时才是零拷贝,太多组件会退化为拷贝合并。
八、总结
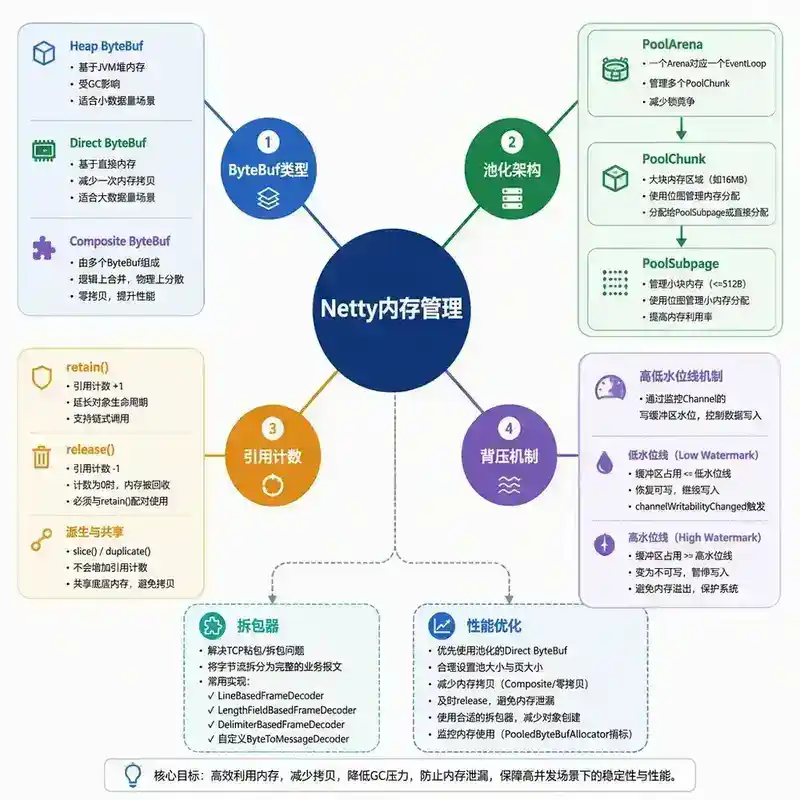
Netty 的内存管理核心:ByteBuf(读写分离+自动扩容)-> 池化内存(预分配+复用)-> 引用计数(精确控制生命周期)-> 拆包器(解决粘包拆包)-> 背压(防止内存溢出)。理解这些机制,不只是为了"会用 Netty",更是为了在遇到性能瓶颈或内存问题时,能快速定位到正确的组件和解决方案。
[图6:Netty内存管理全景图——ByteBuf类型/池化架构/引用计数/拆包器/背压的完整协作]
延伸阅读
- Netty 官方文档:Reference counted objects
- 《Netty 实战》第 5-6 章
- 本系列相关篇目:074(零拷贝)、079(Netty 线程模型)
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 Netty 内存管理的深度理解和实战经验。
Q1:Netty 的池化内存(PooledByteBufAllocator)在什么场景下反而比非池化内存(UnpooledByteBufAllocator)更慢?为什么?
池化内存在以下场景可能更慢:1)极短生命周期的 ByteBuf——如果 ByteBuf 创建后立即释放,池化的 acquire/release 开销(包括线程绑定的 PoolArena 查找、PoolChunk 的二叉树遍历)可能比非池化的直接 malloc/free 更大。2)高并发下 PoolArena 的锁竞争——每个线程绑定一个 PoolArena,但如果线程数远超 PoolArena 数量,会发生 Arena 竞争。3)频繁申请不同大小的 ByteBuf——池化按大小分类(tiny/small/normal/huge),如果每次申请的大小差异很大,池化需要频繁在不同 PoolChunkList 之间切换,缓存命中率低。4)内存碎片化——长时间运行后,池化内存可能产生碎片,导致分配效率下降。判断方法:用 Netty 的 -Dio.netty.allocator.numHeapArenas 和 -Dio.netty.allocator.numDirectArenas 调整 Arena 数量,用 JMH 对比池化和非池化在你的场景下的性能差异。
Q2:你使用 Netty 的 LengthFieldBasedFrameDecoder,但线上偶尔出现 TooLongFrameException。maxFrameLength 设置为 65536(64KB),但业务消息本身只有几百字节。为什么还会超限?
可能原因:1)消息长度字段被错误解析——如果 lengthFieldOffset 或 lengthFieldLength 配置错误,读取到的"长度值"可能是字节流中的其他数据。比如长度字段本应是 4 字节 int,但配置成了 2 字节 short,读取到的值可能非常大。2)半包/粘包导致长度字段被截断——TCP 拆包导致长度字段的 4 字节被拆分到两个 TCP 报文中,解码器只读取了部分字节。3)消息格式与配置不匹配——发送方实际发送的消息格式与解码器配置不一致。4)伪畸形数据——攻击者发送了畸形数据包。排查:用 Wireshark 抓包查看原始 TCP 数据,对比解码器配置,确认长度字段的实际位置和值。
Q3:Netty 的 ByteBuf 使用引用计数,但 GC 也会回收 DirectByteBuffer。为什么 Netty 不依赖 GC 来回收池化内存?
GC 回收 DirectByteBuffer 有三个问题:1)回收时机不可控——GC 可能在 ByteBuf 已经"逻辑上"不再使用后很久才触发,导致直接内存被长时间占用,造成"假性内存泄漏"。2)GC 只能回收 DirectByteBuffer 对象本身(Java 堆中的对象),释放堆外内存依赖 Cleaner 机制,而 Cleaner 的执行时机也不可控。3)池化内存的根本目的是"复用"——如果依赖 GC 回收,内存就归还到了操作系统而不是池中,失去了池化的意义。Netty 的引用计数让 ByteBuf 在"逻辑上"不再使用时立即归还到池中,不等待 GC,也不依赖 GC。这就是为什么 Netty 强调"谁最后使用谁释放"——如果依赖 GC,你永远不知道内存什么时候释放,也无法实现池化。
Q4:Netty 的背压机制通过暂停读取(setAutoRead(false))来间接限制发送速度。但如果发送方不理会 TCP 的流控(比如疯狂发送数据),Netty 的背压还能生效吗?
可以。Netty 的背压暂停读取(setAutoRead(false))后,Netty 不再从 Socket 中读取数据。TCP 的接收缓冲区会被发送方的数据填满,填满后 TCP 的滑动窗口变为 0,发送方的 TCP 协议栈会自动停止发送——这就是 TCP 的流量控制机制。所以 Netty 的背压是"应用层暂停读取 → TCP 接收缓冲区满 → TCP 零窗口 → 发送方 TCP 停止发送"的连锁反应。但有一个边界情况:如果发送方使用的是 UDP(没有流量控制),背压机制无效。或者如果发送方是恶意客户端,故意忽略 TCP 流控,TCP 协议栈不会允许这种情况——TCP 的流控是内核强制执行的,不是建议性的。
Q5:你在生产环境中启用了 Netty 的池化内存,但监控发现直接内存使用量持续增长,最终 OOM。但你已经确认所有 ByteBuf 都正确调用了 release()。这是什么原因?怎么排查?
可能的"隐式泄漏"原因:1)派生 ByteBuf 未释放——slice() 或 duplicate() 创建的 ByteBuf 与原始 ByteBuf 共享底层内存,即使原始 ByteBuf 释放了,派生 ByteBuf 仍然持有引用,底层内存不会归还。2)ChannelHandler 中的 write() 未释放——ctx.write(msg) 后,msg 的引用计数 +1,Netty 在发送完成后会自动 -1。但如果发送失败(如连接断开),Netty 可能不会触发 release。3)ByteBuf 被缓存——Handler 将 ByteBuf 缓存到某个 Map 中,缓存的 ByteBuf 不会被释放。4)池化内部碎片——PoolChunk 的碎片化导致部分内存无法被有效复用,虽然已归还但无法分配给新请求。排查:开启 -Dio.netty.leakDetection.level=PARANOID 定位泄漏点,用 jcmd <pid> VM.native_memory summary 查看直接内存的实际使用量,用 PooledByteBufAllocator.DEFAULT.dumpStats() 查看池化内存的统计信息。