覆盖考点:016|ArrayList 原理:扩容、随机访问、插入删除成本与 fail-fast
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:35–40 分钟(文末问答不计入)
ArrayList 是几乎每个 Java 程序员第一天就会用到的类,也是面试里最容易被"想当然"糊弄过去的考点——大多数人知道"它会自动扩容",但说不清扩容到底扩了多少、代价花在哪;知道"随机访问快",但说不清快的底层原因和边界在哪;知道"遍历时改列表会报错",但说不清这个报错机制本身其实并不可靠。这些细节恰恰是面试官用来区分"用过"和"懂"的分水岭。
面试官问到这一考点,通常按这条链追问:数组为什么能 O(1) 随机访问 → ArrayList 怎么把"定长数组"包装成"可变长列表" → 扩容具体怎么算、代价在哪 → 插入删除的成本模型 → fail-fast 是怎么实现的、为什么不能100%依赖它。本文按这个顺序展开。
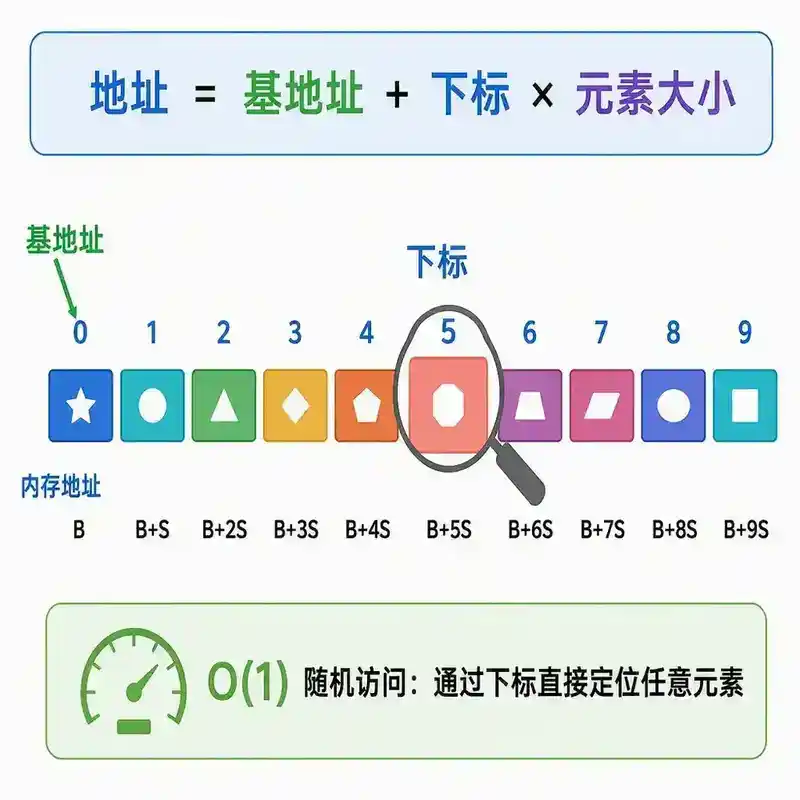
一、随机访问 O(1) 的底层原因
1. 数组是什么:一块连续内存 + 一个基地址
Java 里的数组在创建时会在堆上申请一整块连续的内存空间,JVM 只需要记住这块内存的起始地址(基地址),加上元素类型的固定大小,就能算出任意下标元素的内存地址:
元素地址 = 基地址 + 下标 × 元素大小
这是一个纯算术运算,不需要从头遍历、不需要跳转指针——无论访问下标 0 还是下标 99999,付出的代价完全一样,这就是数组随机访问 O(1) 的全部原因。这个特性反过来也决定了数组的两个硬约束:长度创建后不可变(因为这块连续内存的边界在申请时就定死了),元素类型必须固定大小(地址计算公式要求每个元素占用字节数相同)。
2. ArrayList 是数组的包装,不是新的数据结构
ArrayList 内部就是一个 Object 数组类型的 elementData 字段,外加一个记录当前元素个数的 size 字段。它给使用者的"可变长"体验,本质上是一层假象——每次容量不够时,偷偷换一块更大的连续内存,把旧数据搬过去。这也是为什么 ArrayList.get(index) 的时间复杂度和原生数组一样是 O(1):它只是把调用转发给了 elementData[index],没有引入任何额外的间接层。
public E get(int index) {
    Objects.checkIndex(index, size);
    return elementData(index);   // 内部就是 (E) elementData[index]
}
理解了这一点,后面所有"为什么扩容贵""为什么插入删除贵"的问题,都可以还原成同一句话:ArrayList 的一切代价,都是"连续内存"这个特性的副作用。
二、扩容机制:多留出来的那一半,换的是什么
1. 触发时机:add() 之前的容量检查
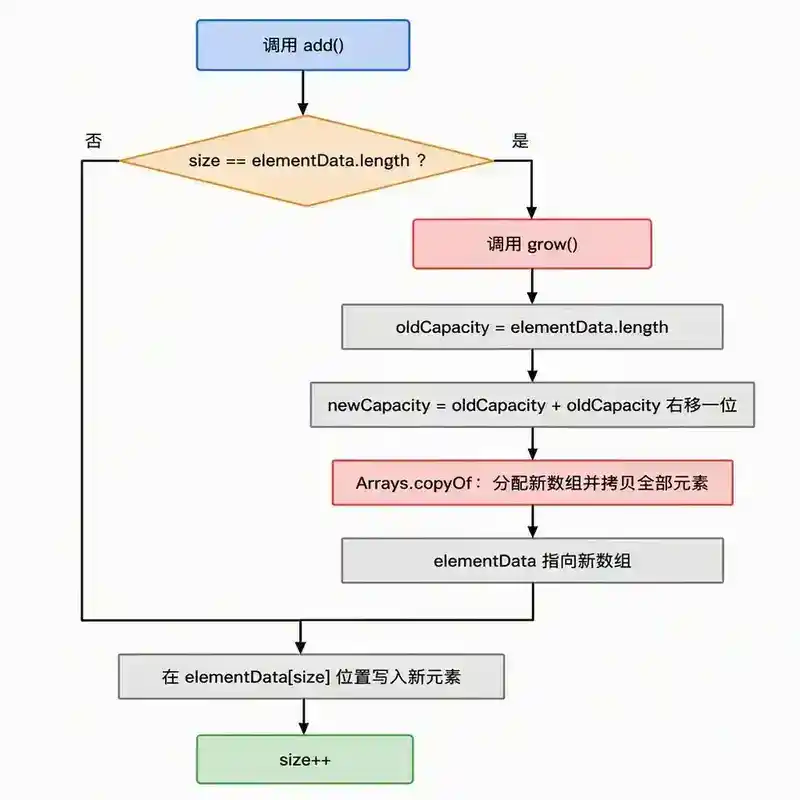
ArrayList 不会在初始化时就分配一个很大的数组,默认无参构造器甚至先给一个空数组占位,真正的容量分配发生在第一次 add() 时。每次 add() 前都会检查当前数组是否还有空位:
public boolean add(E e) {
    modCount++;
    add(e, elementData, size);
    return true;
}


private void add(E e, Object[ ] elementData, int s) {

    if (s == elementData.length)
        elementData = grow();      // 空间不够,先扩容
    elementData[s] = e;
    size = s + 1;
}
2. grow():按 1.5 倍扩容,而不是翻倍或者刚好够用
grow() 的核心计算逐字翻译过来是:
int oldCapacity = elementData.length;
int newCapacity = oldCapacity + (oldCapacity >> 1);   // 扩容为原来的 1.5 倍
oldCapacity >> 1 等价于 oldCapacity / 2(右移一位),所以新容量近似 1.5 × oldCapacity。这个 1.5 倍不是随口拍的数字,是一次权衡:
- 如果每次只多要 1 个位置(刚好够用),下一次
add()立刻又要扩容——扩容次数会随元素数量线性增长,而每次扩容都要整体搬迁数据,均摊代价退化成 O(n) 每次插入; - 如果每次翻倍(2 倍扩容,很多语言的动态数组默认这么做),扩容次数少了,但会造成大量暂时用不上的内存浪费,尤其是列表长期维持在某个规模不再增长时;
- 1.5 倍是介于两者之间的折中:扩容频率保持在对数级别(容量从 10 涨到 100 只需要约 6 次扩容),同时不会像翻倍那样浪费过多闲置内存。
3. 扩容的真实代价:申请新数组 + 整体搬迁
算出新容量之后,真正干活的是 Arrays.copyOf:
elementData = Arrays.copyOf(elementData, newCapacity);
这一行背后发生的事情是:JVM 在堆上申请一块全新的、更大的连续内存,然后用 System.arraycopy(底层是一条内存块拷贝指令,比逐个元素赋值快得多,但仍然是 O(n))把旧数组的全部元素整体搬过去,旧数组随后成为垃圾被 GC 回收。这意味着一次扩容的代价是 O(n)(n 为当前元素个数),但因为扩容不是每次插入都发生、而是呈指数级间隔发生,把这个代价摊到每一次 add() 上,均摊时间复杂度仍然是 O(1)——这是"均摊分析"(amortized analysis)在数据结构里最经典的应用案例之一。
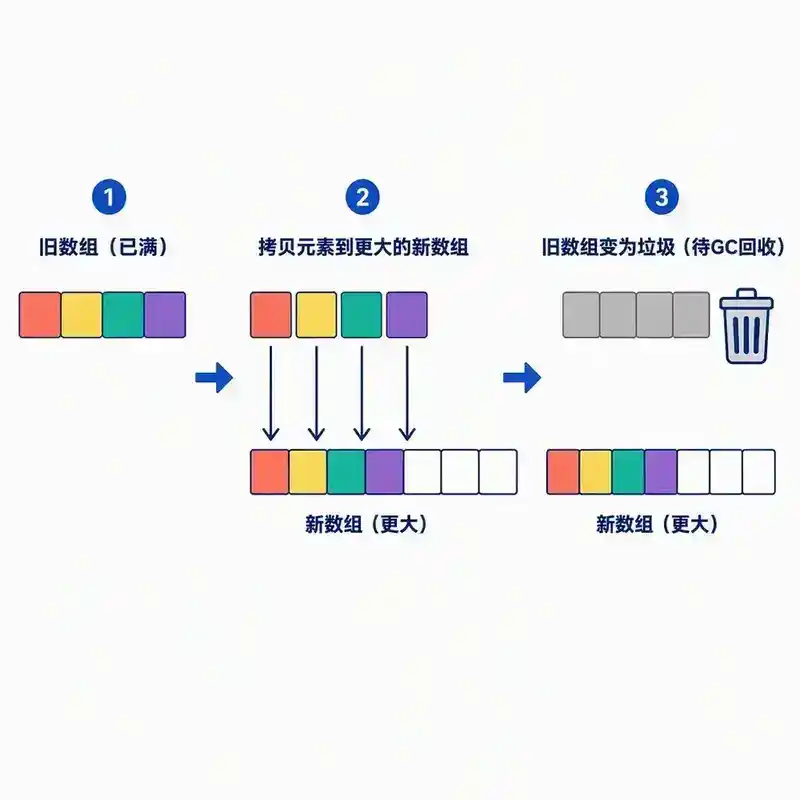
4. 生产上的直接影响:预估容量,少扩几次
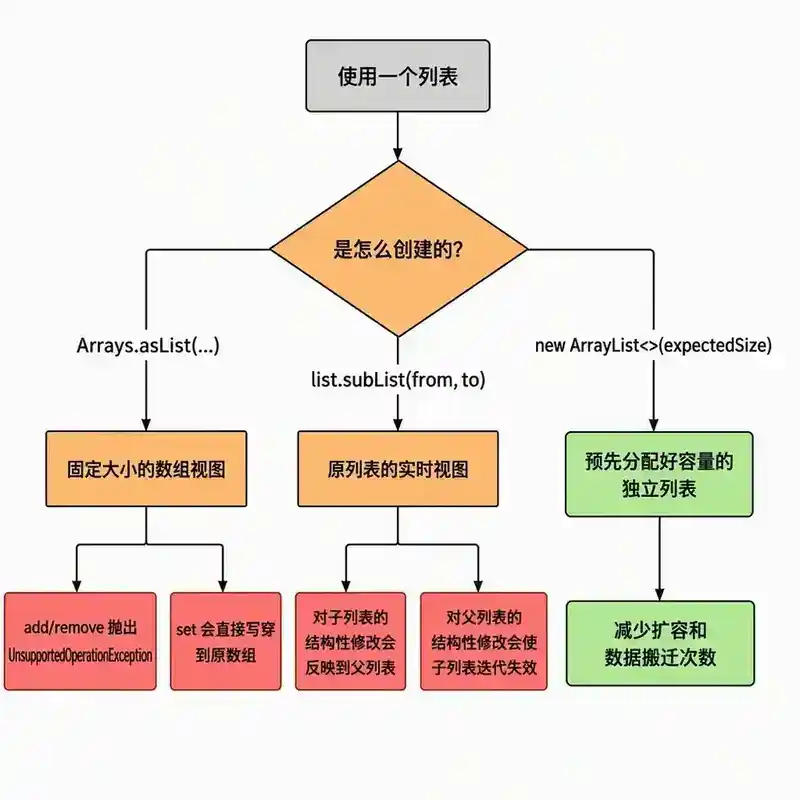
如果能提前预估元素规模,用带初始容量的构造器 new ArrayList<>(expectedSize) 比无参构造器有实打实的收益——少走几次"申请新内存 + 整体搬迁 + 旧数组变垃圾"的循环,尤其在大批量数据场景(比如一次性 add 十万个元素)下,差异是可以在 profiler 里直接看到的。反过来,如果完全不知道规模,也不必过度设计,1.5 倍扩容策略本身已经把最坏情况control在了可接受范围。
三、插入与删除:搬家范围决定成本
1. 尾部操作:O(1),不涉及搬家
在数组末尾 add(e) 或删除最后一个元素,除了扩容判断外不需要移动任何其他元素——直接在 size 位置写入,或者把最后一个位置清空、size--。这是 ArrayList 最便宜的操作。
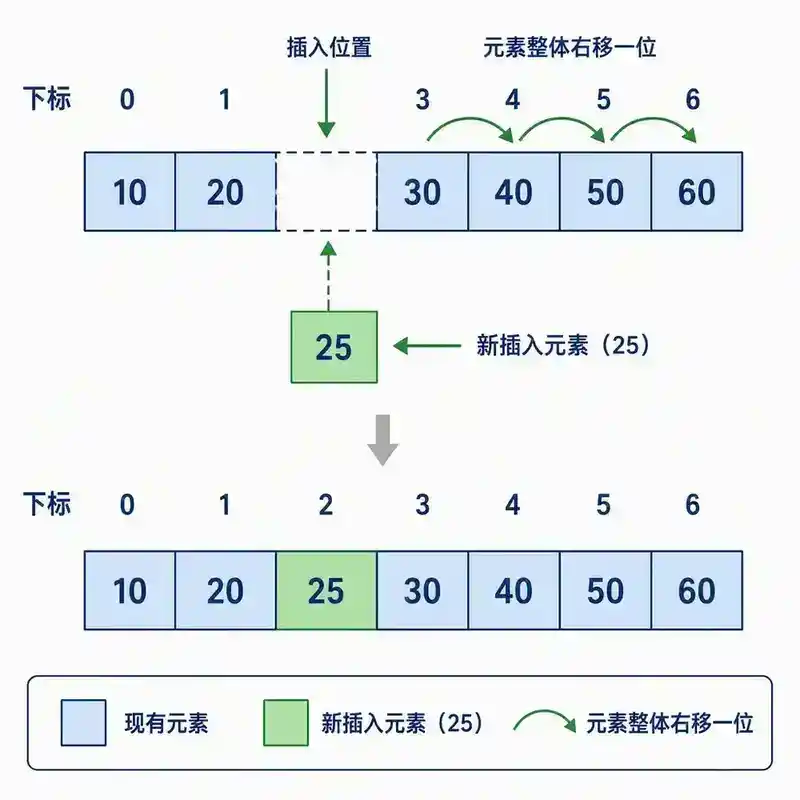
2. 中间/头部插入:O(n),插入点之后全部后移一格
add(int index, E element) 需要先把插入点及其之后的所有元素整体后移一位,腾出空位,再把新元素写进去:
public void add(int index, E element) {
    rangeCheckForAdd(index);
    modCount++;
    final int s;

    Object[ ] elementData;

    if ((s = size) == (elementData = this.elementData).length)
        elementData = grow();
    System.arraycopy(elementData, index,
                      elementData, index + 1,
                      s - index);          // 把 index 及之后的元素整体后移一位
    elementData[index] = element;
    size = s + 1;
}
移动的元素个数是 s - index——插入点越靠前,需要挪动的元素越多。在下标 0 插入是最坏情况,相当于把整个列表搬了一遍,代价是 O(n)。
3. 中间/头部删除:O(n),删除点之后全部前移一格
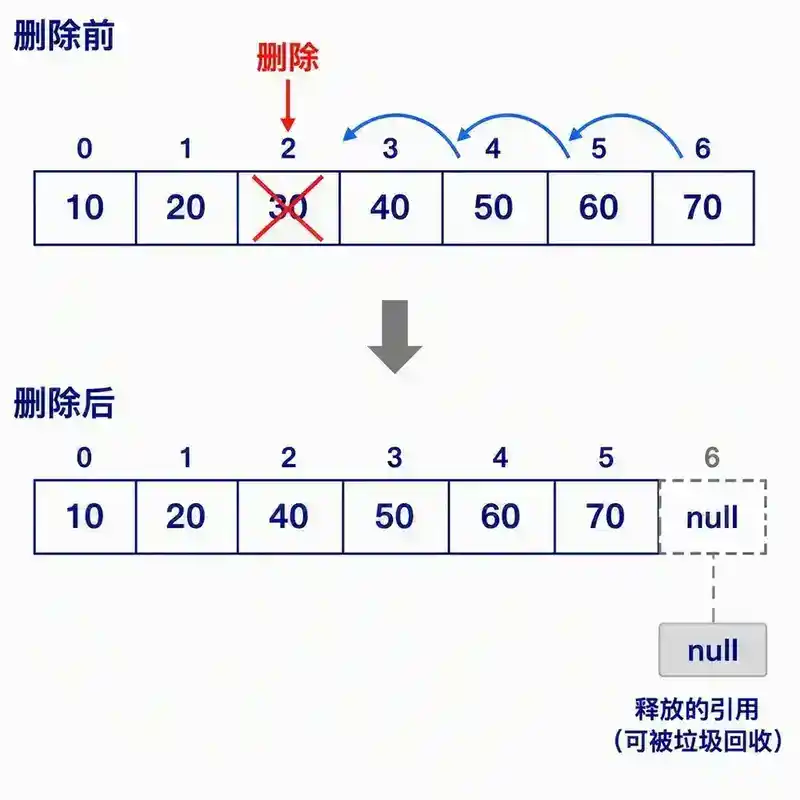
remove(int index) 是插入的镜像操作,把删除点之后的元素整体前移一位覆盖掉被删除的位置,再把末尾多出来的引用置空(避免"内存泄漏"——数组还在占着这个引用,对应对象无法被 GC 回收):
public E remove(int index) {
    Objects.checkIndex(index, size);

    final Object[ ] es = elementData;

    E oldValue = (E) es[index];
    fastRemove(es, index);
    return oldValue;
}


private void fastRemove(Object[ ] es, int index) {

    modCount++;
    final int newSize;
    if ((newSize = size - 1) > index)
        System.arraycopy(es, index + 1, es, index, newSize - index);
    es[newSize] = null;              // 清空末位引用,帮助 GC
}
4. 一张表说清楚成本模型
| 操作 | 位置 | 时间复杂度 | 原因 |
|---|---|---|---|
| get/set | 任意下标 | O(1) | 地址算术运算,无需搬家 |
| add(e) | 末尾 | O(1) 均摊 | 偶尔触发扩容,均摊后仍是常数 |
| add(index, e) | 中间/头部 | O(n) | 插入点之后整体后移 |
| remove(末尾元素) | 末尾 | O(1) | 无需搬家,仅置空 |
| remove(index) | 中间/头部 | O(n) | 删除点之后整体前移 |
一句话记忆:ArrayList 天生适合"读多、尾部写多"的场景,头部/中间频繁插入删除是它的软肋——如果业务场景恰好是这种模式(比如实现一个队列,频繁在头部出队),LinkedList 或 ArrayDeque 会是更合适的选择。
四、fail-fast:modCount 与它并不牢靠的保护
1. 现象:遍历时改列表,直接抛异常
List<String> list = new ArrayList<>(List.of("a", "b", "c"));
for (String s : list) {
    if (s.equals("b")) {
        list.remove(s);     // ConcurrentModificationException
    }
}
用 for-each(底层是 Iterator)遍历 ArrayList 时,如果直接调用列表自身的 add/remove 修改结构,几乎总会抛出 ConcurrentModificationException。这个异常不是"检测到并发线程冲突",它在单线程场景下同样会发生——它的真名叫 fail-fast 机制,目的是尽早暴露"遍历过程中列表结构被意外改变"这类逻辑错误,而不是让程序带着不一致的状态继续跑下去,之后在某个更隐蔽的地方出现更难排查的问题。
2. 实现原理:modCount 的一致性校验
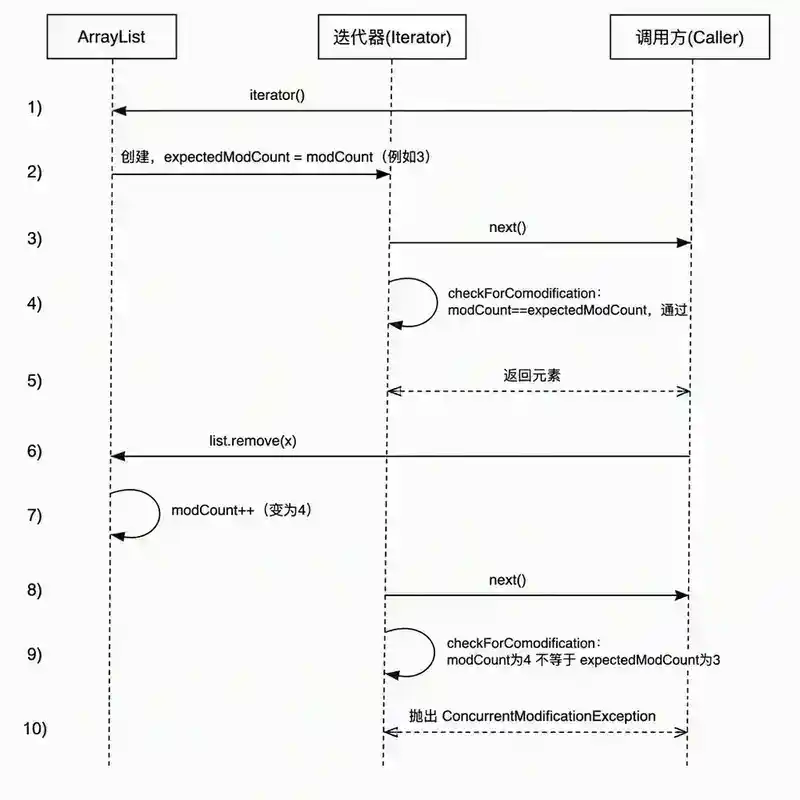
ArrayList 内部维护一个 modCount 字段,每次结构性修改(add、remove,注意 set 不算,因为它不改变列表长度和结构)都会让 modCount++。Iterator 在创建时记录了当时的 modCount 快照(expectedModCount),每次调用 next() 都会做一次校验:
final void checkForComodification() {
    if (modCount != expectedModCount)
        throw new ConcurrentModificationException();
}
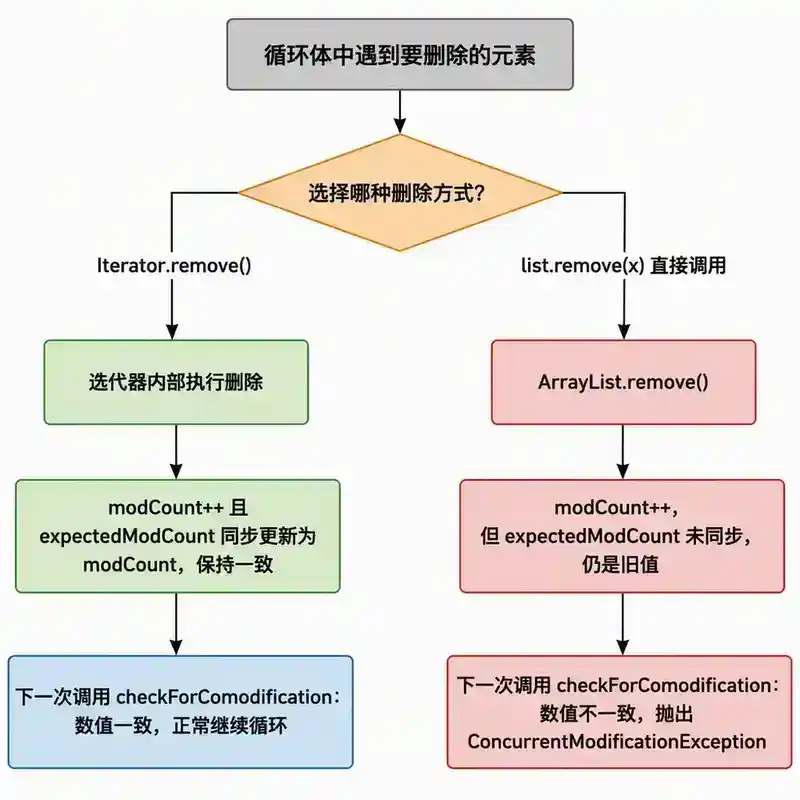
for (String s : list) 这种 for-each 写法,编译后就是 Iterator 的 hasNext() + next() 循环。当你在循环体内直接调用 list.remove(s),这次调用会让 ArrayList 自己的 modCount 递增,但迭代器手里的 expectedModCount 没有同步更新——下一次 next() 调用 checkForComodification() 时,两者不相等,异常被抛出。
3. 为什么"并不牢靠":只是尽力检测,不是正确性保证
fail-fast 这个名字本身就说明了它的定位——它的目标是尽早失败,而不是保证一定会失败或者保证并发安全。三个常见的认知误区:
- 它检测的是"结构性修改",不是"数据修改":如果只是
list.set(i, newValue)改变某个位置的值,modCount不会变化,遍历不会报错,但这同样可能是业务逻辑上的隐患,只是 fail-fast 机制根本不管这类修改; - 正确使用
**Iterator.remove()**不会触发异常:Iterator自带的remove()方法在删除元素后会同步更新expectedModCount = modCount,这是官方推荐的"遍历时安全删除"的写法; - 多线程场景下
**modCount**的校验本身没有同步保护:checkForComodification只是读了一个int字段做比较,没有加锁,JMM 层面不保证可见性和原子性——理论上存在"检测失败"(该抛异常时没抛,比如两次并发修改刚好让 modCount 数值绕回一致)的边界情况。fail-fast 从设计上就不是为并发安全设计的方案,多线程共享的列表要用CopyOnWriteArrayList或显式加锁,而不是依赖这个异常兜底。
五、容易被面试问到的边界与陷阱
1. 返回的不是真正的 ArrayList
Arrays.asList(1, 2, 3) 返回的是 Arrays 类内部的一个私有内部类 Arrays.ArrayList,它是对原数组的视图包装,不支持 add/remove(会抛 UnsupportedOperationException),因为它没有覆盖父类 AbstractList 里默认抛异常的这两个方法。更容易踩坑的是它对原数组的修改是双向可见的——通过这个视图 set() 一个值,会直接改到原数组上。
2. 是视图,不是新列表
list.subList(from, to) 返回的也是一个视图,对这个子列表的结构性修改会直接反映到原列表,反过来对原列表的结构性修改也会让子列表在下次访问时抛 ConcurrentModificationException(子列表自己维护了一份来自父列表的 modCount 快照)。如果需要一份真正独立的副本,要显式 new ArrayList<>(list.subList(from, to))。
3. 初始容量给太小,等于把扩容的坑留给自己
new ArrayList<>() 默认容量为 0(真正分配 10 个容量是在第一次 add() 时),如果明确知道后续要塞入的数据量级,直接在构造时传入接近目标规模的初始容量,能省下大部分不必要的扩容和数据搬迁。
六、面试追问链
| 追问角度 | 典型问题 |
|---|---|
| 原理 | 为什么数组随机访问是 O(1),ArrayList 的 get() 是不是也一样? |
| 扩容细节 | 扩容为什么是 1.5 倍而不是 2 倍?这个系数是怎么算出来的? |
| 成本模型 | 为什么头部插入删除是 O(n),末尾操作却接近 O(1)? |
| fail-fast | ConcurrentModificationException 是并发问题吗?单线程会不会触发? |
| 边界陷阱 | Arrays.asList() 返回的对象能不能调用 add()?为什么? |
| 工程实践 | 已知要插入 10 万条数据,应该怎么初始化 ArrayList? |
延伸阅读
- JDK 源码:
java.util.ArrayList(grow()、add()、remove()、Itr内部类) - 均摊分析(Amortized Analysis):动态数组扩容的经典应用场景
java.util.concurrent.CopyOnWriteArrayList:面向读多写少并发场景的替代方案java.util.ArrayDeque:双端队列场景下替代 LinkedList 的更优选择
问答(不计入阅读时长)
Q1:grow() 里为什么用**oldCapacity + (oldCapacity >> 1)**这种移位写法,而不是直接写**oldCapacity * 1.5**?
A:核心原因是类型和精度。oldCapacity 是 int,oldCapacity * 1.5 这个表达式会先把 1.5 当作 double,导致整个表达式被提升为浮点运算,再赋值回 int 还需要一次显式或隐式的类型转换,多了一次浮点运算和一次窄化转换的开销;而 oldCapacity >> 1 是纯整数右移,等价于整数除以 2 再向下取整,oldCapacity + (oldCapacity >> 1) 全程停留在 int 运算里,既避免了浮点开销,也避免了浮点转整数时可能出现的舍入歧义。在 JDK 这种被海量调用的基础类库代码里,这种"用移位代替除法/乘法"的写法是常见的性能微优化惯例,不是随手写的风格问题。
Q2:**new ArrayList<>()**和**new ArrayList<>(0)**有什么区别?
A:区别在于第一次扩容后的容量。无参构造器会把 elementData 指向一个共享的空数组常量 DEFAULTCAPACITY_EMPTY_ELEMENTDATA,第一次 add() 触发 grow() 时会走一条特殊判断路径,直接给到默认容量 10,而不是按 1.5 倍公式计算(0 的 1.5 倍还是 0,公式在这里没有意义);new ArrayList<>(0) 则是显式指定初始容量为 0,elementData 指向的是普通的空数组 EMPTY_ELEMENTDATA(不是那个默认容量专用的常量),第一次 add() 触发扩容时会严格按 1.5 倍公式计算,也就是从 0 开始算,同样会退化到走"至少给 1"这类边界修正逻辑,但不会自动跳到 10。实际效果上二者第一次扩容后通常都会得到一个较小的容量,但语义上无参构造器明确设计成"默认给你 10",而 ArrayList<>(0) 是"你明确要求 0,容量增长完全交给算法本身"——如果后续会大量 add,无参构造器路径通常更省一次扩容。
Q3:**list.remove(1)**和**list.remove(Integer.valueOf(1))**为什么结果不一样?
A:这是 remove 方法重载的经典陷阱。ArrayList 同时提供 remove(int index)(按下标删除)和 remove(Object o)(按值删除,找到第一个 equals 的元素删除)。list.remove(1) 传入的是基本类型 int 字面量 1,编译器优先匹配 remove(int index),删除的是下标 1 的元素;而 list.remove(Integer.valueOf(1)) 传入的是一个 Integer 对象,编译器匹配 remove(Object o),删除的是值等于 1 的第一个元素。如果列表内容恰好是 [5, 3, 1],list.remove(1) 删的是下标 1 的 3,list.remove(Integer.valueOf(1)) 删的是值为 1 的最后一个元素——两者结果完全不同。这也是为什么在 List<Integer> 上写删除逻辑时,很多团队会强制要求显式装箱或者用 removeIf 来消除这种歧义。
Q4:ArrayList 在扩容过程中如果被多个线程并发**add**,会发生什么?
A:ArrayList 完全没有为并发场景做任何同步保护,多线程并发 add 是未定义行为,可能出现的具体故障包括:两个线程同时读到相同的 size,都认为当前位置可以直接写入,导致其中一次写入被覆盖丢失(数据丢失,但不报错,是最危险的一种);也可能出现某个线程正在执行 Arrays.copyOf 搬迁数据到新数组的过程中,另一个线程仍持有旧数组的引用并对其写入,写入的数据永远丢失在即将被回收的旧数组里;还可能触发 size 字段的写覆盖,导致最终 size 与实际元素个数不一致,后续 get/remove 直接抛 ArrayIndexOutOfBoundsException 或读到 null。这些故障的共同点是不保证抛异常,往往表现为数据静默丢失或数量不对,比直接崩溃更难定位。生产环境需要并发写的场景应该用 Collections.synchronizedList 包装、CopyOnWriteArrayList,或者干脆用并发容器 + 无锁编程模型替代。
Q5:fail-fast(**ArrayList**的**ConcurrentModificationException**)和 fail-safe(**CopyOnWriteArrayList**)有什么本质区别?
A:本质区别在于要不要让遍历看到"正在发生的修改"。fail-fast 的策略是:遍历过程中一旦发现底层结构被改了(通过 modCount 比较),立刻抛异常终止,宁可让程序停下来也不让你继续用一个可能不一致的视图;fail-safe 的策略是:遍历开始时就基于当前数据做一份快照或独立副本(CopyOnWriteArrayList 的每次写操作都会整体复制出一份新数组),遍历过程中即使原数据被修改,遍历用的始终是那份旧快照,不会抛异常,但代价是你可能读到的是修改之前的旧数据,感知不到"刚刚发生的变化"。两者没有绝对的谁更好,fail-fast 适合"检测出并发修改就该报错"的场景(大多数单线程逻辑错误场景),fail-safe 适合"读多写少、容忍读到稍微过时的数据、但绝不能因为遍历而阻塞或报错"的场景(比如监听器列表)。
Q6:为什么**remove(size - 1)**(删除最后一个元素)不会触发**System.arraycopy**?
A:看 fastRemove 的判断条件 if ((newSize = size - 1) > index)——只有当"删除位置之后还有元素"时才需要搬迁。删除最后一个元素时,index 等于 size - 1,而 newSize 也等于 size - 1,两者相等,newSize > index 为 false,直接跳过 System.arraycopy,只执行 es[newSize] = null 把最后一个位置的引用置空。这正是"删除末尾元素的代价接近 O(1)"这句话在源码层面的确切依据——不是近似或者约定俗成的说法,而是这个 if 判断的直接后果。
Q7:已经用**ensureCapacity()**预留了容量,但实际塞入的元素远少于预期,会有什么代价?
A:ensureCapacity(minCapacity) 会立即真实分配出对应大小的底层数组(如果当前容量不够),如果预估过大、实际元素很少,代价是长期占用了一块用不上的连续内存——这块内存不会自动收缩,除非显式调用 trimToSize() 把 elementData 收缩到刚好等于 size 的大小。这在长生命周期的缓存类对象或者常驻内存的大列表场景里是值得关注的隐性浪费:预估容量是为了减少"扩容+搬迁"的次数,但预估过度就变成了纯粹的内存浪费,两者要在实际数据规模的基础上权衡,而不是"越大越保险"。
Q8:如果面试官问"ArrayList 默认容量是多少",怎么回答才算准确,而不是只说"10"?
A:更准确的回答分两层:声明周期上,new ArrayList<>() 创建后 elementData 初始并不是长度为 10 的数组,而是指向一个长度为 0 的共享空数组,此时列表事实容量为 0;真正的容量分配被推迟到第一次**add()**调用,这时 grow() 检测到当前是那个默认空数组标记,才会一次性分配出长度为 10 的数组。所以严谨的说法是"默认构造器在首次插入元素时才会分配长度为 10 的初始数组,而不是构造时就分配"——这个**延迟分配(lazy allocation)**的细节,正是很多人说得出"10"这个数字、但说不清"什么时候分配"的分水岭,也是面试官用来区分"记住结论"和"读过源码"的常见追问点。