覆盖考点:024|CopyOnWriteArrayList:写时复制、快照迭代器与适用边界
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:24 分钟(文末问答不计入)
上一篇讲的 HashSet、TreeSet 解决的是"去重"和"排序",这一篇要讲的 CopyOnWriteArrayList 解决的是另一个经典问题:多线程环境下怎么安全地遍历一个会被并发修改的列表。它不是靠缩小锁粒度,也不是靠无锁 CAS,而是走了一条更极端的路——读操作完全不加锁,把并发安全的全部代价转移到写操作上。这篇要讲清楚"写时复制"具体复制的是什么、迭代器的"快照一致性"到底保证了什么又放弃了什么,以及这种设计在什么场景下是最优解,什么场景下反而是最差的选择。
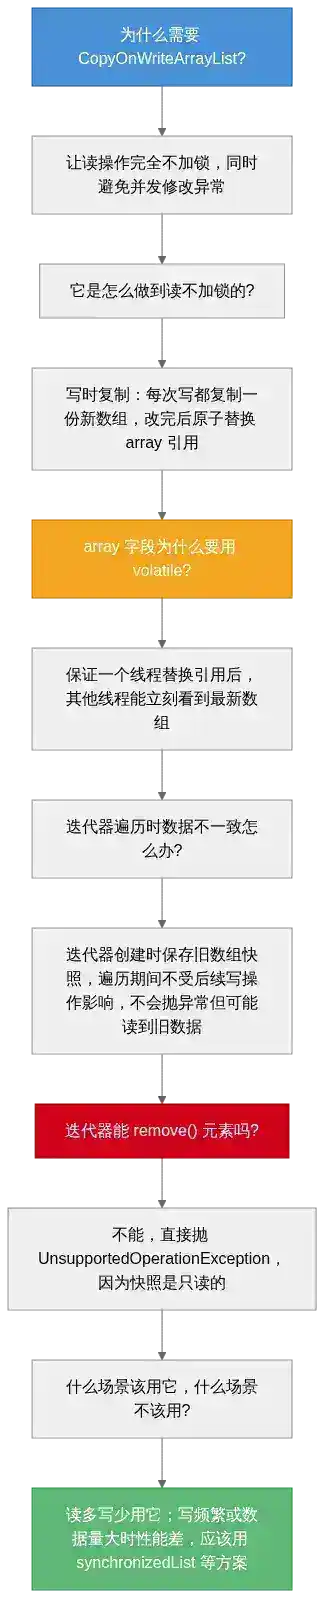
面试官在这个考点上通常这样追问:为什么不能直接给普通 ArrayList 加锁解决并发问题 → CopyOnWriteArrayList 是怎么做到读操作完全不加锁的 → array 字段为什么必须声明成 volatile → 迭代器遍历期间如果别的线程在增删元素,会发生什么 → 为什么迭代器调用 remove()/add()/set() 会直接抛异常 → 它最适合什么场景,最不适合什么场景。本文按这条链展开。
一、为什么需要它
多线程场景下遍历一个普通 ArrayList,同时有另一个线程在修改它,会遇到两种典型麻烦:
- 直接用
synchronized包住整个ArrayList的读写——能解决问题,但读操作也要抢锁,并发度差; - 不加锁直接读写——遍历时如果有别的线程正在
add()/remove(),很可能抛出ConcurrentModificationException。
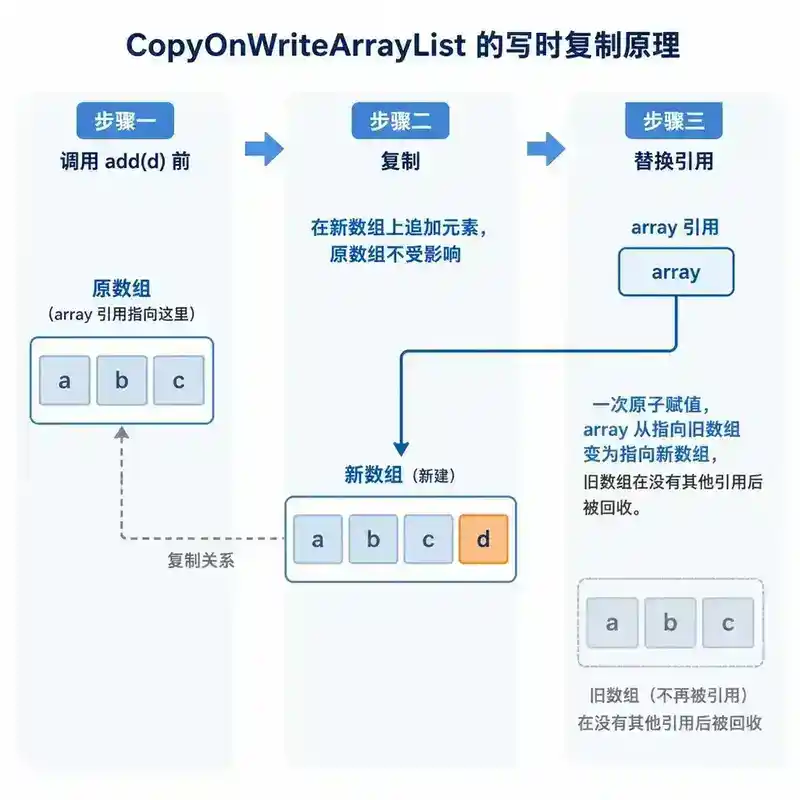
CopyOnWriteArrayList 想解决的就是这类"读多写少"场景:让读操作完全不用加锁,代价转移到写操作上。它的核心思路只有一句话:每次写操作都不修改原数组,而是复制一份新数组,在新数组上改完之后,用一次原子替换让新数组生效。
二、底层字段与写操作流程
CopyOnWriteArrayList 的核心字段其实很简单:
public class CopyOnWriteArrayList<E> implements List<E> {
    final transient ReentrantLock lock = new ReentrantLock();

    private transient volatile Object[ ] array;

}
两个关键点:
array是volatile的——保证一个线程写完新数组、替换引用之后,其他线程能立刻看到最新的引用(可见性);- 写操作用
ReentrantLock而不是synchronized,本质是一样的独占锁,只是换了个更灵活的 API。
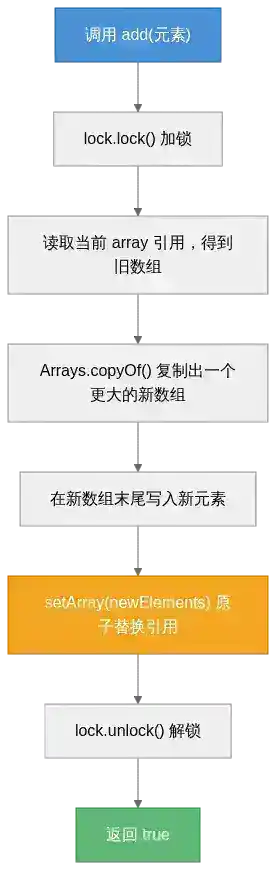
以 add(E e) 为例,源码流程大致是:
public boolean add(E e) {
    final ReentrantLock lock = this.lock;
    lock.lock();
    try {

        Object[ ] elements = getArray();

        int len = elements.length;

        Object[ ] newElements = Arrays.copyOf(elements, len + 1); // 复制整个数组

        newElements[len] = e;
        setArray(newElements); // 原子替换引用
        return true;
    } finally {
        lock.unlock();
    }
}
注意:加锁只锁写操作之间,不影响任何读操作。get(int index) 的实现只是 return array[index],完全不加锁,直接读当前 array 引用指向的数组——这就是它读性能高的根本原因。
三、迭代器的"快照一致性"
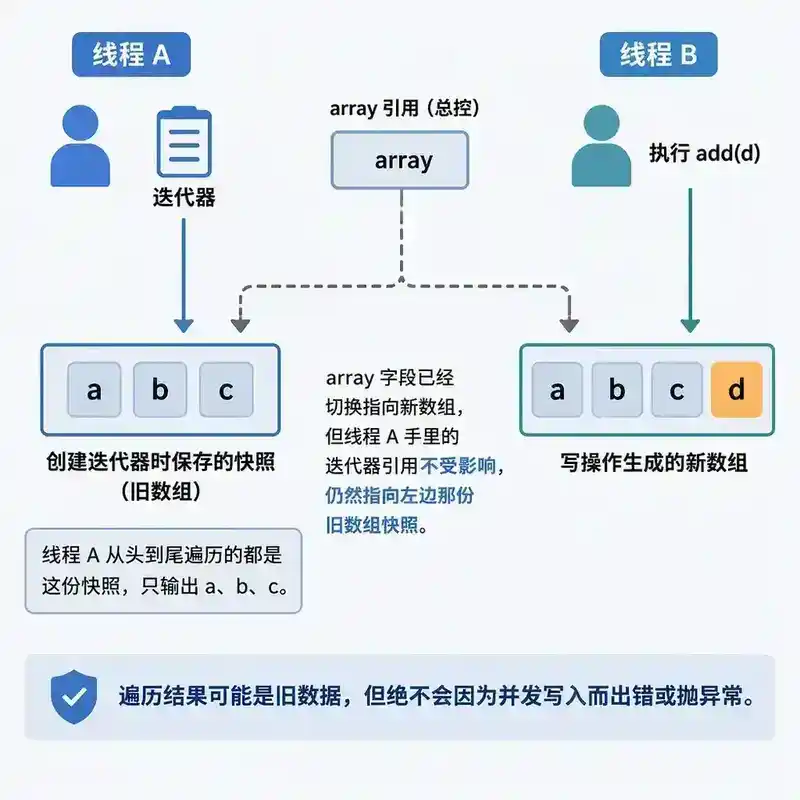
这是最容易被误解的一点。CopyOnWriteArrayList 的迭代器(iterator())在创建的那一刻,会把当前的**array**引用保存下来,遍历过程中完全基于这份快照工作,不会再去看 array 字段之后有没有变化。
List<String> list = new CopyOnWriteArrayList<>(List.of("a", "b", "c"));
Iterator<String> it = list.iterator();  // 拿到快照 ["a", "b", "c"]

list.add("d");  // 这一步会生成新数组,list.array 指向新数组

while (it.hasNext()) {
    System.out.println(it.next());  // 仍然只输出 a、b、c,看不到 d
}
遍历这份快照期间,即使有别的线程不断 add()/remove(),都不会抛 ConcurrentModificationException——因为迭代器根本不关心 array 字段的最新值,它手里攥着的是创建时那一份独立数组的引用,那份数组本身永远不会被修改(写操作只会生成新数组,不会就地改旧数组)。这种"遍历到的数据可能是旧的,但绝对不会因为并发修改而出错"的特性,通常叫弱一致性迭代器,或者更准确地说,是一种快照隔离——不是强一致(不保证读到最新),但保证一致(不会读到"半新半旧"的中间状态)。
四、迭代器为什么不支持 remove/add/set
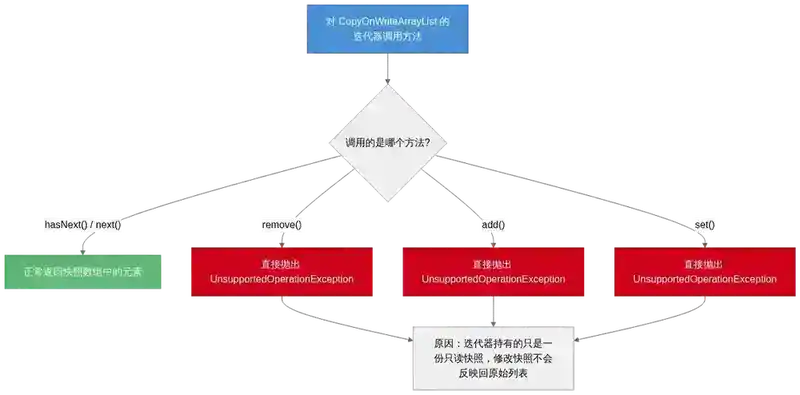
在这份快照迭代器上调用 remove()、add()、set(),会直接抛出 UnsupportedOperationException。原因很直接:迭代器手里的那份数组只是一个快照副本,不是原始数据的视图,对它做修改根本没有意义——改了这份快照,也不会反映回真正的 CopyOnWriteArrayList,所以 JDK 直接在语言层面禁止了这种操作,而不是让你改了却发现"没生效"。
五、适用场景与不适用场景
适用:读操作远远多于写操作,且写操作不频繁的场景。典型例子是事件监听器列表、黑白名单缓存——这类列表加载后几乎不变,但会被大量线程频繁遍历。读不加锁,天然支持高并发读。
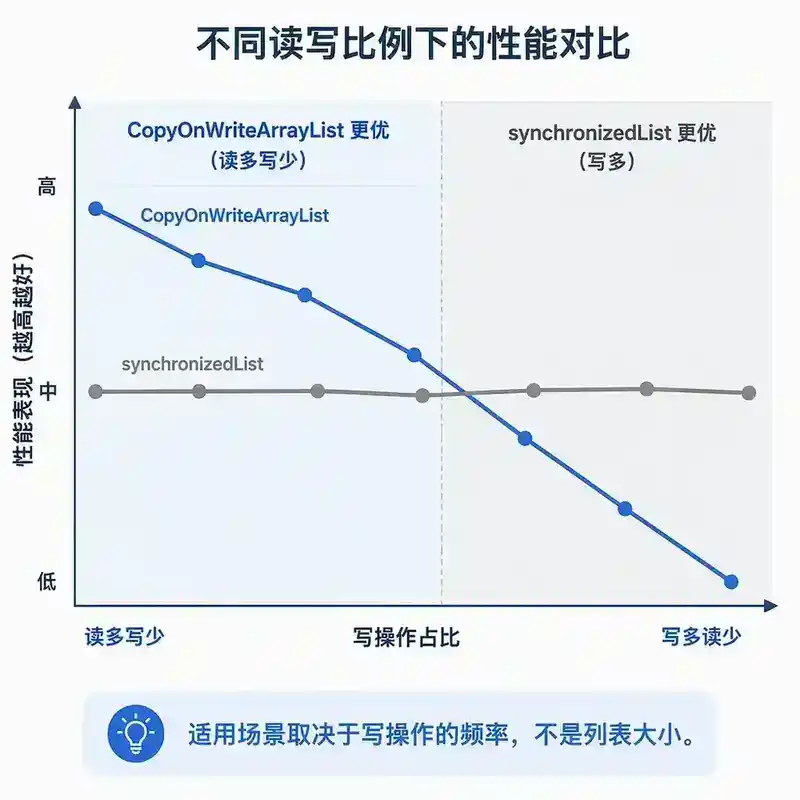
不适用:写操作频繁、或者列表本身很大的场景。原因很直白——每一次写操作都要把整个底层数组完整复制一遍,数组越大、写得越频繁,复制的开销就越大,退化到 O(n) 级别的写延迟和内存分配压力。如果业务场景是写多读少,CopyOnWriteArrayList 几乎是最差的选择。
六、和其他并发方案的对比
| 加锁策略 | 读性能 | 写性能 | 适用场景 | |
|---|---|---|---|---|
Collections.synchronizedList |
读写都加同一把锁 | 一般(读也要抢锁) | 一般 | 读写都不频繁,或简单场景 |
CopyOnWriteArrayList |
只在写时加锁,读完全不加锁 | 极高 | 差(写要整体复制数组) | 读多写少 |
ConcurrentHashMap(作为对比参考) |
分段/CAS,锁粒度细 | 高 | 高 | 读写都频繁的 Map 场景 |
CopyOnWriteArrayList 和 ConcurrentHashMap 走的是两条完全不同的路:后者靠缩小锁粒度换取读写都快,前者靠"读完全不加锁、写承担全部代价"换取极端场景下的读性能,两者不能互相替代,要看场景选。
七、常见误区
- 以为遍历时能实时看到其他线程刚写入的数据。 实际上迭代器基于创建时的快照,写操作之后的变化不会反映到已经创建的迭代器里。
- 在写多的场景下用它当"线程安全的 List"替代品。 每次写都要整体复制数组,数据量大或写频繁时性能会远差于
synchronizedList。 - 以为迭代器的 remove() 能删除元素。 会直接抛
UnsupportedOperationException,因为迭代器操作的只是一份只读快照。 - 把"写时复制"理解成"复制引用、节省内存"。 恰恰相反,每次写操作都会分配一个新的、和旧数组几乎一样大的数组,内存开销和 GC 压力都不小。
八、面试追问链
延伸阅读
CopyOnWriteArrayList源码(JDKjava.util.concurrent包)- 上一期:《HashSet 与 TreeSet:去重不是事后筛选,是从一开始就没让它进来》
- 《Java 并发编程实战》第 5 章:并发容器
问答(不计入阅读时长)
Q1:CopyOnWriteArrayList 的核心设计思路是什么?
A:把并发安全的代价从读操作转移到写操作上——读操作完全不加锁,直接读取当前 array 引用指向的数组;写操作(add/remove/set 等)先把整个底层数组完整复制一份,在新数组上完成修改,再用一次原子赋值把 array 引用切换到新数组。这样读操作永远不会和写操作竞争同一把锁。
Q2:为什么 array 字段要声明成 volatile?
A:volatile 保证的是可见性:当一个线程完成写操作、把 array 引用切换到新数组之后,其他线程能立刻看到这个最新的引用,而不会因为 CPU 缓存或指令重排导致读到过期的引用。如果不加 volatile,其他线程可能长时间还在读旧的 array 值。
Q3:写操作为什么用 ReentrantLock 而不是 synchronized?
A:本质上都是独占锁,效果类似,只是 ReentrantLock 提供了更灵活的 API(比如可以配合 tryLock()、支持公平锁等)。这里的锁只保护写操作之间的互斥——同一时刻只能有一个线程在复制数组、写入新元素,读操作完全不受这把锁影响,因为读操作根本不需要获取它。
Q4:迭代器遍历期间,如果别的线程在增删元素,会发生什么?
A:不会抛出 ConcurrentModificationException,也不会读到"半新半旧"的中间状态。原因是迭代器创建时就把当时的 array 引用保存为一份快照,遍历过程中只认这份快照,完全不关心 array 字段之后有没有被替换。这种保证"不会因并发修改出错,但可能读到旧数据"的特性称为快照一致性(或弱一致性)。
Q5:为什么迭代器上调用 remove()/add()/set() 会直接抛异常?
A:因为迭代器持有的只是一份独立的只读快照数组,不是原始列表的视图。对这份快照做修改,根本不会反映回真正的 CopyOnWriteArrayList——为了避免"改了却发现没生效"这种误导性行为,JDK 直接在这几个方法里抛出 UnsupportedOperationException。
Q6:CopyOnWriteArrayList 最适合什么场景,最不适合什么场景?
A:最适合读操作远多于写操作、且写不频繁的场景,比如事件监听器列表、几乎不变但被频繁遍历的黑白名单缓存。最不适合写操作频繁或者列表本身很大的场景——因为每次写都要把整个底层数组复制一遍,数据量越大、写得越频繁,开销就越大,性能会明显劣于加锁方案。
Q7:CopyOnWriteArrayList 和 Collections.synchronizedList 有什么本质区别?
A:synchronizedList 是读写都用同一把锁保护,任何时刻只能有一个线程在访问(读或写),并发度受限但内存开销小;CopyOnWriteArrayList 是读完全不加锁、写独占加锁,读的并发度极高,但代价是每次写都要复制整个数组,内存和 CPU 开销更大。两者是"读写都稳但一般"与"读极快但写极贵"的取舍关系,不能简单说谁更好,要看读写比例。
Q8:"写时复制"是不是意味着更省内存?
A:恰恰相反。每一次写操作都会新分配一个和原数组几乎一样大的数组,短时间内新旧两份数组会同时存在于内存中,写操作越频繁,临时对象越多,GC 压力也越大。"写时复制"省的不是内存,换来的是读操作不用加锁的并发性能,这是用内存和写开销换读性能的典型取舍。