覆盖考点:020|ConcurrentHashMap 原理:JDK 7 分段锁与 JDK 8 CAS+synchronized
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:39 分钟(文末问答不计入)
前面几篇把 HashMap 的底层结构、哈希扰动、容量设计讲透了,但反复强调了一句话:HashMap 完全没有同步机制,多线程并发操作是未定义行为。这一篇要解决的问题就是:如果业务场景确实需要一个线程安全的哈希表,ConcurrentHashMap 是怎么在保证线程安全的前提下,还能做到远比"整表加锁"更高的并发性能的。这道题的难点不在于记住"JDK 7 用分段锁、JDK 8 用 CAS+synchronized"这句结论,而在于说清楚这两代实现具体锁的是什么、为什么锁粒度能做得这么细、以及 size() 这种看似简单的方法在高并发场景下是怎么被重新设计的。
面试官在这个考点上通常这样追问:为什么不能直接给 HashMap 的每个方法加 synchronized 完事,Hashtable 这么做错在哪里 → JDK 7 的分段锁具体锁的是什么范围,并发度怎么确定 → JDK 8 为什么放弃分段锁,改用了什么机制,锁粒度细到什么程度 → put() 的具体流程是怎样的,什么时候用 CAS、什么时候用 synchronized → 并发场景下 size() 怎么保证统计相对准确 → 扩容时如果有其他线程还在读写,会发生什么。本文按这条链展开。
一、为什么不能给 HashMap 简单加锁了事
1. Hashtable 的做法及其代价
java.util 里最早的线程安全哈希表是 Hashtable(上一篇提到过),它的实现方式极其直接:几乎每一个公开方法(get、put、remove、size……)都用 synchronized 修饰,本质上是整表加一把锁。这样确实能保证线程安全,但代价是:任意时刻只允许一个线程操作这个表,即便两个线程访问的是完全不相关的两个桶,也必须排队等待——并发度被压缩到了 1,在高并发场景下几乎等同于把多线程退化成了单线程访问这个表。
2. 核心思路:把锁的范围做小
ConcurrentHashMap 从设计之初的目标就是解决这个问题:既要保证线程安全,又要让锁的范围尽可能小,让不同线程操作表里不同区域时可以真正并行执行、互不阻塞。JDK 7 和 JDK 8 用了两种不同的思路去实现这个目标,锁粒度一代比一代更细。
二、JDK 7:分段锁(Segment)架构
1. 两层结构:Segment 数组套 HashEntry 数组
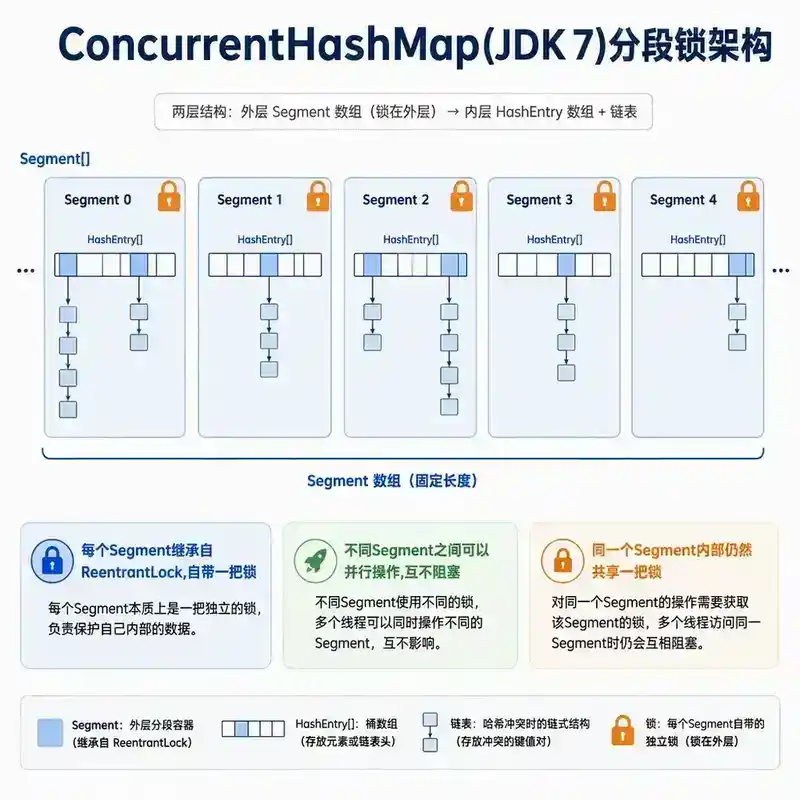
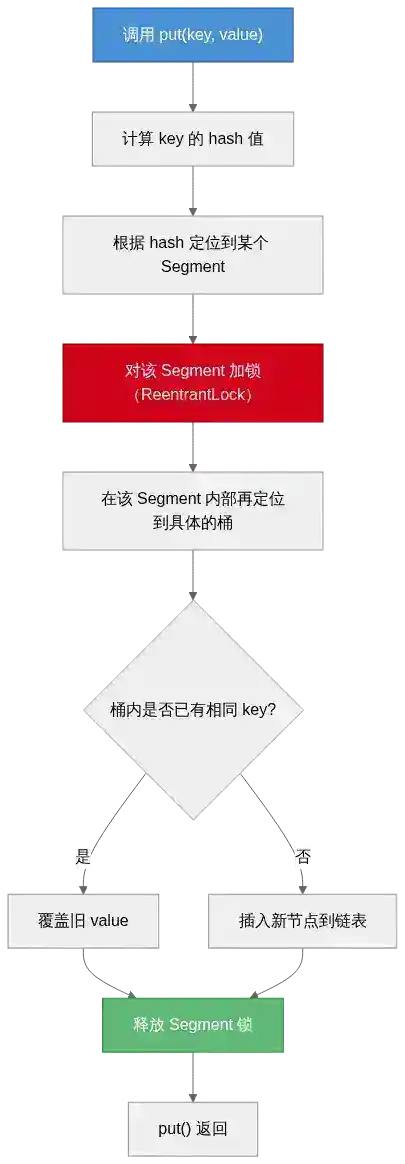
JDK 7 的 ConcurrentHashMap 内部维护一个 Segment 数组类型的 segments 数组,每个 Segment 本身又包含一个独立的 HashEntry 数组类型的 table 数组(结构上和 HashMap 的桶+链表很像),并且每个**Segment**继承自**ReentrantLock**,自带一把独立的锁。一个 key 先通过哈希运算决定落在哪个 Segment,再在这个 Segment 内部通过哈希运算决定落在哪个桶。
2. 并发度:由 Segment 数量决定,创建后不能更改
构造 ConcurrentHashMap 时可以指定 concurrencyLevel(并发度,默认 16),这个参数决定了 Segment 数组的长度(会被纠正为不小于该值的最近 2 的幂)。它的含义是"理论上最多支持多少个线程同时无冲突地写入"——只要不同线程操作的 key 落在不同的 Segment 里,它们持有的是不同的锁,可以真正并行执行 put 操作。这个数量在构造时就固定下来,之后无法调整,这是分段锁架构的一个先天限制:如果并发线程数远超预设的并发度,仍然会出现多个线程争抢同一个 Segment 锁的情况。
3. 分段锁架构的局限
这套架构虽然比 Hashtable 的整表锁细致得多,但仍有明显局限:并发度在创建时就固定,无法根据实际负载动态调整;size() 这类需要汇总所有数据的方法,仍然需要短暂地锁住所有 Segment(或者用一种"先不加锁试探性统计两次,两次结果一致就采信,不一致再加锁精确统计"的优化策略)才能给出准确值;粒度仍然是"一整个 Segment",而不是"某一个具体的桶",同一个 Segment 内的不同桶之间依然会互相阻塞。这些局限直接促成了 JDK 8 的重新设计。
三、JDK 8:抛弃分段锁,改用 CAS + synchronized
1. 数据结构回归 HashMap 的样子
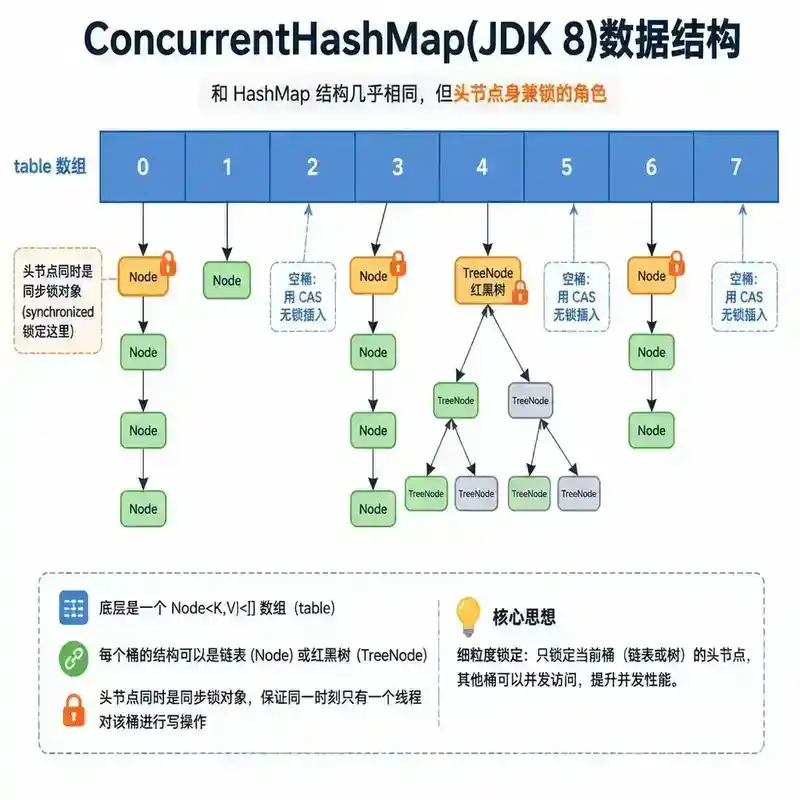
JDK 8 的 ConcurrentHashMap 不再有 Segment 这一层,内部结构变成了和 HashMap 一样的 Node 数组类型的 table(同样是数组+链表/红黑树三层结构,树化条件也和 HashMap 一致)。锁不再挂在某个"分段"对象上,而是直接使用**synchronized**锁住某个桶的头节点——这意味着锁的粒度从"一组桶(一个 Segment)"细化到了"单独一个桶",并且锁的数量不再受构造时某个固定参数限制,理论上锁的数量可以随桶的数量(也就是容量)一起动态变化。
2. put() 的具体流程:CAS 和 synchronized 各自负责什么
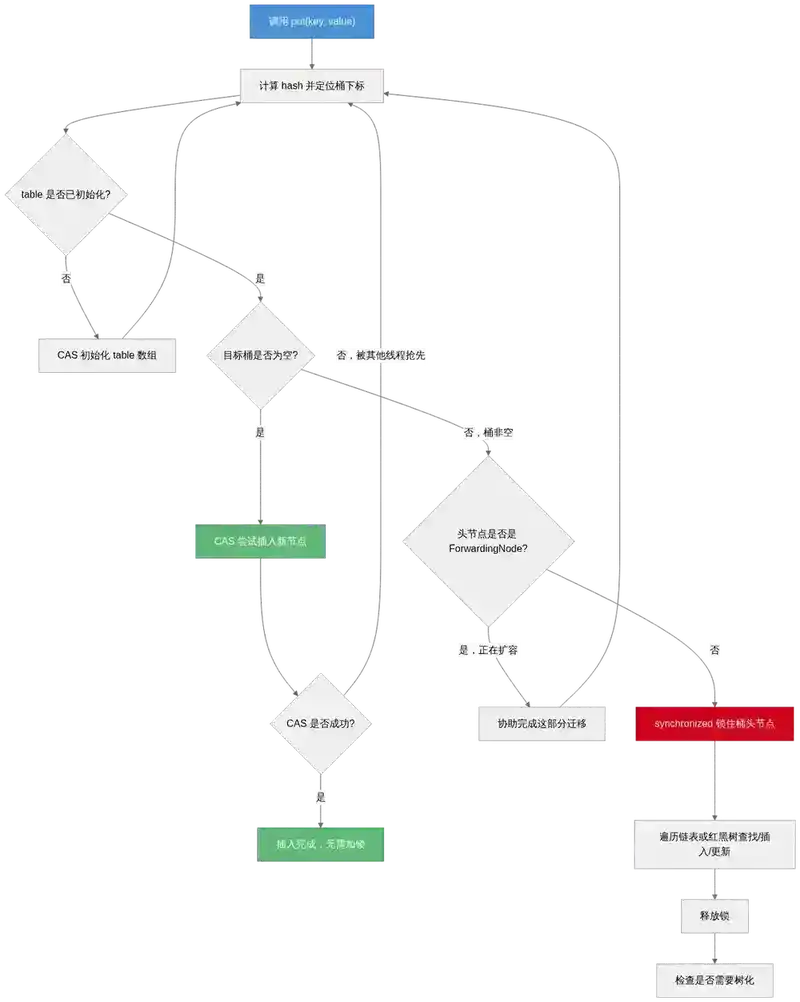
putVal() 的核心逻辑按桶的当前状态分成几种情况处理:
- 目标桶为空:直接用
CAS(Unsafe.compareAndSwapObject,或封装后的casTabAt)尝试把新节点设置进去。这一步完全不需要加锁——CAS 是一种无锁的原子操作,如果 CAS 失败(说明有另一个线程抢先写入了这个桶),当前线程会重新循环、重新判断桶的状态,而不是阻塞等待。 - 目标桶不为空:这时候需要遍历桶内的链表或红黑树来查找、插入或更新节点,这个遍历+修改的过程用
**synchronized**锁住这个桶的头节点(synchronized(f),f是桶内第一个Node),保证同一时刻只有一个线程能修改这个桶的内部结构,遍历插入完成后释放锁。 - 如果目标桶的头节点是特殊标记节点(
**ForwardingNode**,表示这个桶正在扩容迁移中):当前线程会协助完成这部分迁移工作(详见第五节),而不是简单地等待或者报错。
这个设计的精妙之处在于:空桶场景(第一次写入某个位置)用完全无锁的 CAS,只有真正涉及链表/树结构调整的场景才用锁,而且锁的范围严格限定在"这一个桶",不会影响其他桶的并发写入。相比 JDK 7 里"只要落在同一个 Segment 就要排队",JDK 8 的并发写入能力有了质的提升。
3. 为什么锁桶头节点是安全且够用的
选择锁"桶的头节点"而不是引入一个额外的锁对象,是一种节省内存开销的设计——不需要为每个桶单独分配一个锁对象,直接复用链表/树本身已经存在的头节点作为同步监视器(monitor)。因为对这个桶的所有修改操作都必须先获得这同一个头节点的锁才能进行,所以只要头节点引用没有变化,任何线程在持锁期间看到的桶内部状态就是一致的、不会被其他线程同时修改,这就足够保证桶内部数据结构(链表插入、树旋转等)操作的原子性和可见性。
四、size() 怎么在高并发下保持相对准确
1. 直接遍历累加的问题
如果 size() 简单地遍历所有桶累加节点数,在高并发场景下,遍历过程中很可能有其他线程正在同时插入或删除元素,导致统计结果和"某个精确时刻"的真实元素个数并不完全对应——但这在设计上是可以接受的,ConcurrentHashMap 的 size() 本身就只承诺一个近似准确的估计值,不追求绝对精确的强一致性(这也是"弱一致性"设计理念的一部分,后文第六节详细展开)。
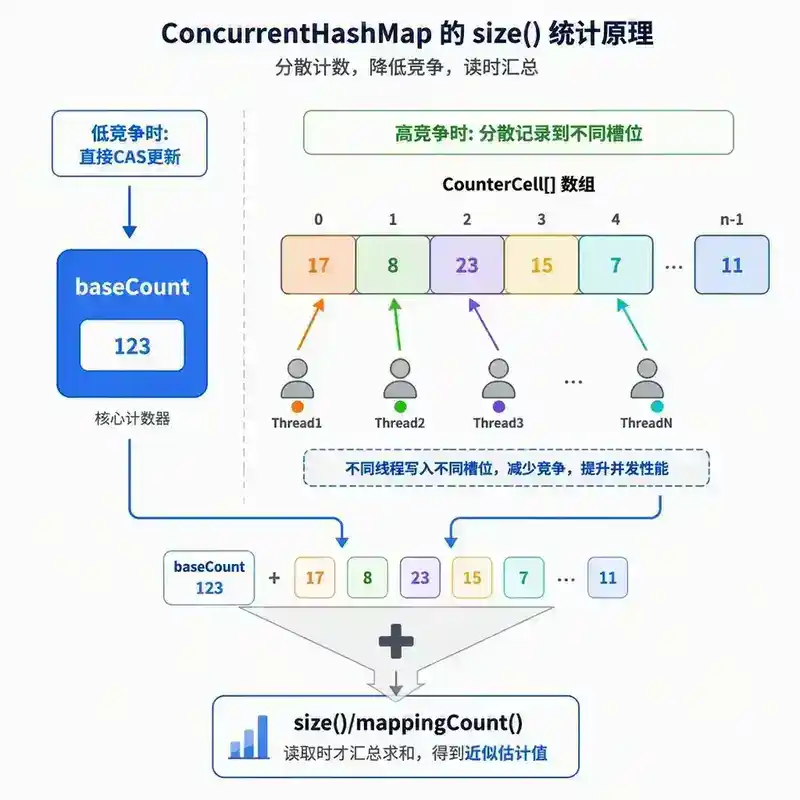
2. 分散计数:baseCount + CounterCell 数组
JDK 8 借用了和 LongAdder(java.util.concurrent.atomic)几乎一样的思路来维护元素总数,而不是维护一个单一的、每次修改都要 CAS 竞争的计数器:核心是一个 baseCount 字段,加上一个 CounterCell 数组类型的 counterCells 数组——每次插入或删除元素时,优先尝试 CAS 更新**baseCount**,如果 CAS 竞争激烈频繁失败,会退化为把增量记录到**counterCells**数组里某个(基于线程哈希选定的)槽位,不同线程尽量落在不同槽位上各自更新,减少了多线程同时竞争同一个计数器带来的性能损耗。size() 或 mappingCount() 需要总数时,把 baseCount 和 counterCells 数组里所有槽位的值加起来,就是当前的估计总数。这种"高频写入时分散计数、真正需要读取时再汇总"的思路,是应对"写多读少、且写入需要保证低延迟"场景的经典设计模式。
五、扩容:多线程协助搬迁
1. ForwardingNode:标记"这个桶正在搬家"
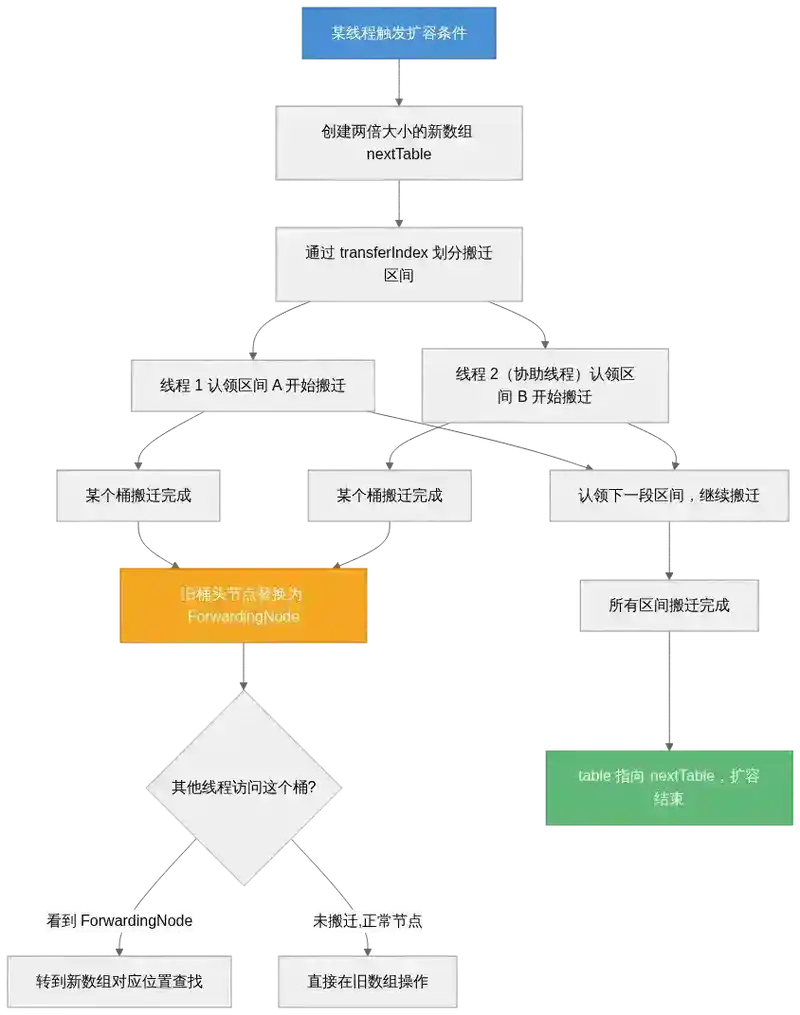
JDK 8 的扩容支持多个线程协助完成搬迁工作,而不是像 HashMap 那样只能由发起扩容的那个线程独自完成整个搬迁过程。核心机制是引入了一种特殊的哨兵节点 ForwardingNode——当某个桶已经被处理完(迁移到了新数组),发起扩容的线程会把旧桶的头节点替换成一个 ForwardingNode,其中记录了指向新数组的引用。如果此时另一个线程正想读取或写入这个桶,看到头节点是 ForwardingNode,就知道"这个位置的数据已经搬到新数组了",转而去新数组里定位查找,而不会读到一份过时或者残缺的数据。
2. transferIndex:多个线程各自认领一段区间去搬迁
扩容开始后,ConcurrentHashMap 用一个 transferIndex 字段(通过 CAS 更新)来协调多个愿意参与搬迁工作的线程,把整个旧数组按一定步长划分成若干区间,不同线程各自认领一段没有被处理过的区间独立搬迁,处理完自己的区间后再尝试认领下一段——这样搬迁工作本身也变成了并行任务,缩短了整体扩容耗时。任何线程在执行 put/get 等操作时,如果发现当前正处于扩容状态(通过检查 sizeCtl 字段的特殊负值标记得知),都有机会顺路帮忙处理一部分搬迁任务,而不是干等扩容完成。
六、JDK 7 与 JDK 8 的设计取舍对比
| 维度 | JDK 7(分段锁) | JDK 8(CAS + synchronized) |
|---|---|---|
| 锁粒度 | 一个 Segment(多个桶共享一把锁) | 单个桶(synchronized 锁桶头节点),空桶写入完全无锁 |
| 并发度上限 | 构造时固定,之后不可调整 | 理论上随容量动态变化,不受固定参数限制 |
| 数据结构 | Segment 数组套 HashEntry 数组,多一层间接 | 与 HashMap 一致的数组+链表/红黑树,无额外分段结构 |
| 内存开销 | 每个 Segment 额外的对象头和锁开销 | 复用桶头节点做同步监视器,节省额外锁对象开销 |
| 扩容 | 只在单个 Segment 内部进行,其余 Segment 不受影响 | 支持多线程协助搬迁,整体扩容更快 |
JDK 8 这次重写不是简单的"换个锁的实现",而是重新设计了整个并发控制思路——用更细粒度、更轻量的同步手段(CAS 优先、必要时才用轻量级的单桶锁),去掉了分段这层间接结构带来的额外开销,同时通过协助扩容进一步压缩了扩容期间的性能损耗。
七、常见误区与工程实践
1. 弱一致性:size()、迭代器都不是"绝对精确的某一时刻快照"
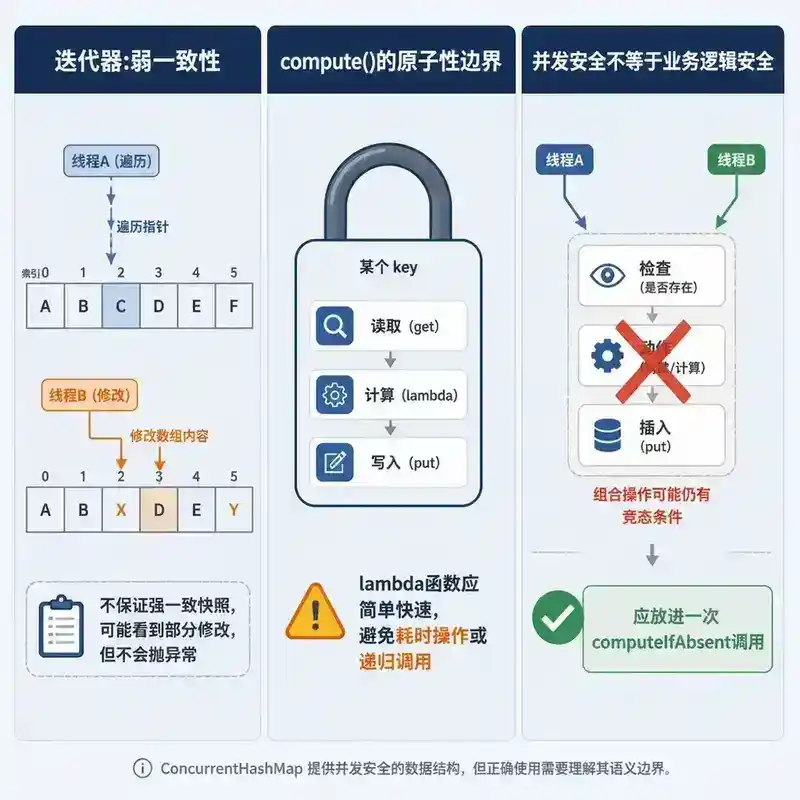
ConcurrentHashMap 的迭代器是弱一致性(weakly consistent)的:它保证不会抛出 ConcurrentModificationException(这点和 HashMap 的 fail-fast 迭代器不同),能够反映迭代开始后某些但不保证全部的修改,具体能看到哪些修改取决于迭代过程中数据被访问的具体时序。这意味着如果在遍历过程中,其他线程正在并发修改这个表,遍历结果既不保证一定包含所有新增的元素,也不保证一定排除所有已删除的元素——这是一种为了追求高并发性能而在一致性上做出的明确妥协,业务代码如果需要"某一时刻的精确快照"这种强一致性保证,ConcurrentHashMap 本身无法提供,需要额外的同步手段。
2. compute()/computeIfAbsent() 的原子性边界
ConcurrentHashMap 提供的 compute()、computeIfAbsent() 等方法能保证"对单个 key 的读取+计算+写入"这个组合操作是原子的(内部通过锁定该 key 所在桶的头节点实现),这是它相对于"先 get() 判断再 put()"这种手写组合操作的核心优势——后者在并发场景下存在明显的竞态条件(两个线程同时判断"key 不存在",都执行了写入,其中一次写入的结果被覆盖)。但需要特别注意:传入**compute()**的计算函数(lambda 表达式)本身应该是简单、快速、无副作用的,因为这个函数是在持有桶锁的情况下执行的,如果函数内部执行了耗时操作(比如网络调用)或者递归调用了同一个 ConcurrentHashMap 的其他修改方法,有可能导致锁被长时间占用,甚至(在某些递归调用场景下)触发死锁。
3. 不要认为"并发安全"等价于"业务逻辑没有竞态条件"
ConcurrentHashMap 保证的是内部数据结构层面的线程安全(不会因为并发访问导致链表断裂、数据丢失、抛出并发修改异常),但不能自动保证多个操作组合在一起时的业务逻辑正确性。比如"检查某个 key 是否存在,不存在则执行某个业务动作,再插入这个 key"这种跨越多个方法调用的逻辑,即便每个方法本身线程安全,组合起来仍然可能有竞态条件——正确的做法通常是把整个"检查+动作+插入"的逻辑放进一次 computeIfAbsent() 调用里,让这个组合操作本身具备原子性,而不是分开调用多个原子方法后自己拼接。
八、面试追问链
| 追问角度 | 典型问题 |
|---|---|
| 动机 | 为什么不直接给 HashMap 的方法加 synchronized,像 Hashtable 那样? |
| JDK 7 架构 | 分段锁具体锁的是什么范围?并发度怎么确定,能不能动态调整? |
| JDK 8 架构 | JDK 8 为什么放弃分段锁?put() 什么时候用 CAS,什么时候用 synchronized? |
| size() | 高并发场景下 size() 怎么保证相对准确,用了什么设计思路? |
| 扩容 | JDK 8 扩容时,其他线程还能不能正常读写?扩容能不能被多个线程一起完成? |
| 一致性 | ConcurrentHashMap 的迭代器和 size() 是强一致的吗?compute() 能保证什么原子性? |
延伸阅读
- JDK 源码:
java.util.concurrent.ConcurrentHashMap(putVal()、transfer()、addCount()) java.util.concurrent.atomic.LongAdder:分散计数思想的更通用实现,与 CounterCell 机制同源java.util.Hashtable与 JDK 7ConcurrentHashMap的分段锁:两代线程安全哈希表的设计对比- Doug Lea 关于 ConcurrentHashMap 设计的公开讨论:细粒度并发控制的取舍思路
- 弱一致性迭代器 vs fail-fast 迭代器:
java.util.concurrent包下容器的通用一致性模型
问答(不计入阅读时长)
Q1:为什么不能直接给 HashMap 的每个方法加 synchronized,像 Hashtable 那样?
A:技术上完全可以做到线程安全,但代价是并发度被压缩到 1——任意时刻只有一个线程能操作整个表,哪怕两个线程访问的是完全不相关的两个桶,也必须排队等待。Hashtable 就是这么做的,在高并发场景下几乎退化成单线程访问。ConcurrentHashMap 的设计目标就是把锁的范围做小,让不同区域的操作可以真正并行。
Q2:JDK 7 的分段锁具体锁的是什么范围?
A:锁的是一个 Segment。ConcurrentHashMap 内部维护 Segment 数组类型的 segments 数组,每个 Segment 自带一把 ReentrantLock,内部又有自己独立的 HashEntry 数组类型的 table。一个 key 先哈希定位到某个 Segment,再在该 Segment 内部哈希定位到具体桶。只要两个线程落在不同 Segment,就可以并行写入;落在同一个 Segment,哪怕是不同桶,也要排队。
Q3:并发度(concurrencyLevel)是怎么确定的,能不能动态调整?
A:构造时通过 concurrencyLevel 参数指定(默认 16),会被纠正为不小于该值的最近 2 的幂,决定了 Segment 数组的长度。这个值在构造时就固定下来,之后无法调整——如果实际并发线程数远超预设值,仍会出现多个线程争抢同一个 Segment 锁的情况。这是分段锁架构的先天限制,也是 JDK 8 重新设计的动因之一。
Q4:JDK 8 为什么放弃分段锁?改用了什么机制?
A:分段锁有几个局限:并发度创建后不可变、size() 这类汇总操作仍需短暂锁住所有 Segment、锁粒度是"一整个 Segment"而不是某一个桶。JDK 8 抛弃了 Segment 这层结构,数据结构回归和 HashMap 一样的 Node 数组类型的 table(数组+链表/红黑树),锁直接加在桶的头节点上(synchronized(f)),配合 CAS 处理空桶写入,锁粒度细化到单个桶,且数量随容量动态变化。
Q5:put() 的具体流程是怎样的?什么时候用 CAS,什么时候用 synchronized?
A:先计算 hash 定位桶。如果 table 未初始化,先 CAS 初始化。目标桶为空时,直接用 CAS(casTabAt)尝试插入新节点,完全不加锁,CAS 失败就重新循环判断。目标桶非空时,用 synchronized 锁住桶的头节点,遍历链表/红黑树完成查找、插入或更新,操作完释放锁。如果头节点是 ForwardingNode(表示这个桶正在扩容迁移),当前线程会协助完成迁移,而不是等待。
Q6:并发场景下 size() 怎么保证相对准确?用了什么设计思路?
A:JDK 8 借用了和 LongAdder 类似的分散计数思路:维护一个 baseCount 字段加上 CounterCell 数组类型的 counterCells 数组。每次插入或删除,优先 CAS 更新 baseCount;如果竞争激烈频繁失败,退化为把增量记录到 counterCells 里某个基于线程哈希选定的槽位,不同线程尽量落在不同槽位,减少竞争。size() 需要总数时,把 baseCount 和所有槽位的值加起来即可。这是"高频写入时分散计数、真正需要读取时再汇总"的经典模式,本身只承诺近似准确,不追求强一致性。
Q7:JDK 8 扩容时,其他线程还能不能正常读写?扩容能不能被多个线程一起完成?
A:可以。JDK 8 的扩容支持多线程协助搬迁:某个桶迁移完成后,发起扩容的线程会把旧桶头节点替换成 ForwardingNode,其中记录了指向新数组的引用。其他线程读写这个桶时,看到 ForwardingNode 就知道数据已经搬到新数组,转去新数组查找,不会读到过时数据。同时用 transferIndex(CAS 更新)把旧数组划分成若干区间,多个愿意协助的线程各自认领一段独立搬迁,处理完再认领下一段,整体扩容作为并行任务完成,缩短耗时。
Q8:ConcurrentHashMap 的迭代器和 size() 是强一致的吗?compute() 能保证什么原子性?
A:都不是强一致的。迭代器是弱一致性(weakly consistent):不会抛 ConcurrentModificationException,但遍历结果既不保证包含所有并发新增的元素,也不保证排除所有已删除的元素。size() 只是一个近似估计值。compute()/computeIfAbsent() 保证的是"对单个 key 的读取+计算+写入"这个组合操作的原子性(内部锁定该 key 所在桶的头节点实现),但传入的计算函数必须简单快速无副作用——因为这个函数是在持锁状态下执行的,耗时操作或递归调用同一个 Map 的其他修改方法可能导致锁被长时间占用甚至死锁。另外要注意,ConcurrentHashMap 保证的是内部数据结构层面的线程安全,不能自动保证多个操作组合在一起时的业务逻辑正确性。