覆盖考点:021|LinkedHashMap 与 LRU:访问顺序、淘汰钩子与缓存实现
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:36 分钟(文末问答不计入)
前几篇讲透了 HashMap 的结构、容量设计和 ConcurrentHashMap 的并发控制,但一个常被忽略的事实是:JDK 里还有一个几乎不需要额外代码就能实现 LRU(Least Recently Used,最近最少使用)缓存的容器——LinkedHashMap。很多人知道"LinkedHashMap 是有序的 HashMap",但说不清楚它的顺序具体是怎么维护的、为什么改一个构造参数就能从"插入顺序"变成"访问顺序",以及为什么重写一个看起来无关紧要的 protected 方法就能让它变成一个功能完整的缓存。这篇把这条链路从数据结构一直讲到可以直接抄的 LRU 实现。
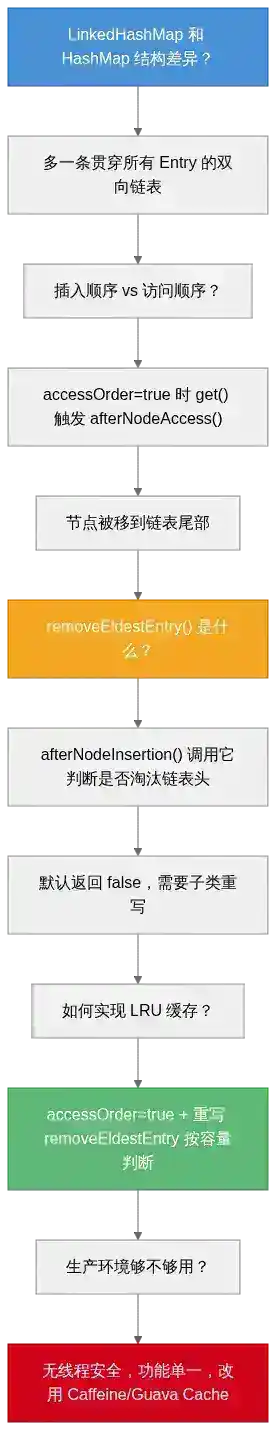
面试官在这个考点上通常这样追问:LinkedHashMap 和 HashMap 底层结构的区别是什么,"有序"具体体现在哪 → 访问顺序模式(accessOrder=true)是怎么维护顺序的,get() 操作为什么也会改变顺序 → removeEldestEntry() 是什么,为什么它是 LRU 缓存实现的关键 → 如何用几十行代码写出一个线程不安全但功能正确的 LRU 缓存 → 这种实现在生产环境里够不够用,Caffeine/Guava Cache 相比它多做了什么。本文按这条链展开。
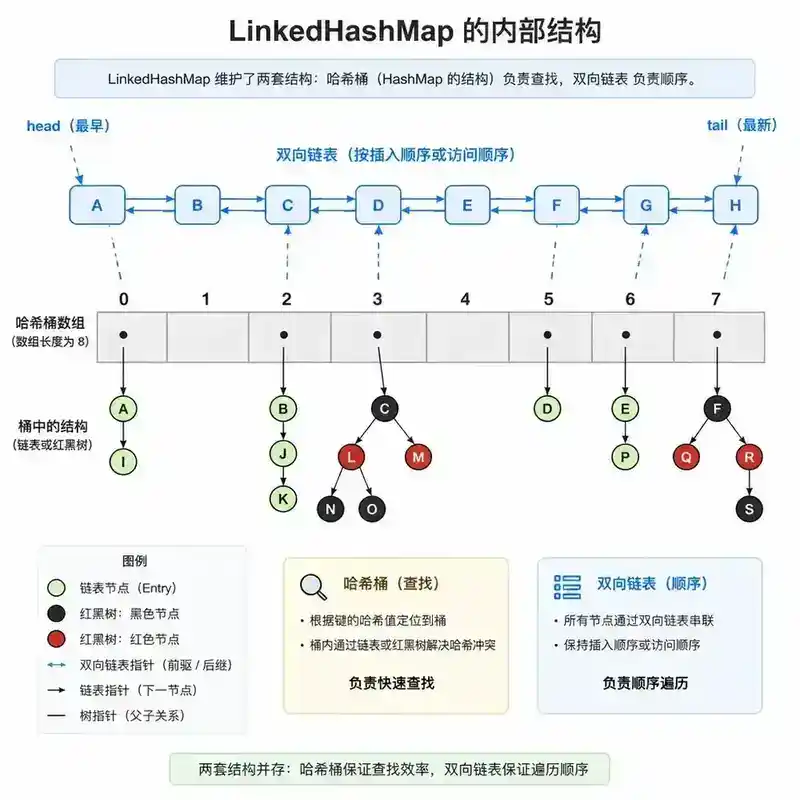
一、LinkedHashMap 的结构:HashMap 之上多一条双向链表
1. 继承关系与核心字段
LinkedHashMap 继承自 HashMap,几乎复用了后者全部的哈希桶逻辑(数组+链表/红黑树、扩容、哈希扰动这些统统不变)。它真正新增的是两个东西:一个内部类 LinkedHashMap.Entry<K,V>(继承 HashMap.Node,多了 before、after 两个引用字段),以及两个头尾指针 head、tail。每插入一个新节点,除了正常挂到哈希桶的链表/树里,还会被追加到这条双向链表的尾部(linkNodeLast())。这条双向链表把所有 Entry 串成一条线,决定了迭代 LinkedHashMap 时的遍历顺序——这也是"有序"的真正含义:哈希桶本身依然是无序的,有序性完全来自这条额外维护的双向链表。
2. 两种顺序模式:插入顺序 vs 访问顺序
构造 LinkedHashMap 时可以传入 accessOrder 参数(默认 false):
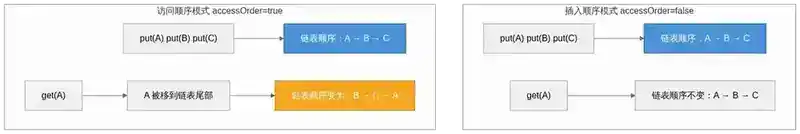
**accessOrder = false**(默认,插入顺序):双向链表的顺序就是元素插入的顺序,之后无论怎么get(),顺序都不会变化,只有新插入的元素会被追加到链表尾部,remove()会把节点从链表中摘除。**accessOrder = true**(访问顺序):每次get()、put()访问到某个已存在的节点,都会把这个节点从链表中摘下来重新挂到链表尾部(afterNodeAccess()),这样链表头部永远是"最久没被访问"的元素,链表尾部永远是"刚被访问过"的元素。这正是实现 LRU 缓存所需要的核心顺序语义。
3. afterNodeAccess():访问顺序模式的实现细节
accessOrder=true 时,get(key) 内部除了正常走 HashMap 的查找逻辑定位到节点,还会额外调用一次 afterNodeAccess(node)。这个方法做的事情很直接:如果这个节点不是当前链表的尾节点,就把它从当前位置摘下来(修正它前后节点的 before/after 引用),重新挂到 tail 之后。注意**containsKey()**不会触发这个顺序调整,只有 get()、getOrDefault()、put()(对已存在 key 的更新)会触发。这是一个容易被面试问到的细节:如果只是想"看一眼却不算访问",用 containsKey();如果想触发"最近访问"语义,必须用 get()。
二、removeEldestEntry():LRU 缓存实现的关键钩子
1. 这个方法默认什么都不做
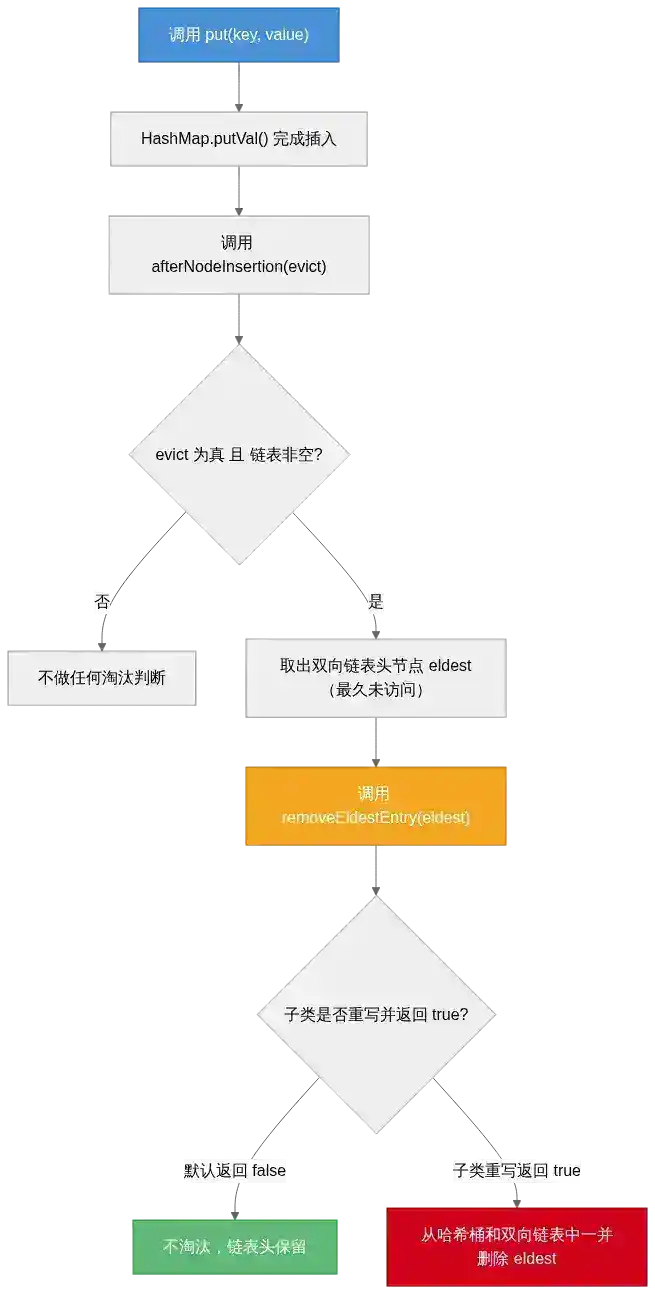
HashMap.putVal() 在插入新节点成功之后,末尾会调用一次 afterNodeInsertion(evict)。HashMap 里这个方法是空实现,但 LinkedHashMap 重写了它:如果 evict 为真且链表不为空,就取出链表的头节点(也就是"最久未被使用"的那个),调用 removeEldestEntry(eldest) 判断是否需要删除它,返回 true 则真正执行删除。**LinkedHashMap**自身对**removeEldestEntry()**的默认实现永远返回**false**——也就是说,如果不重写这个方法,LinkedHashMap 不会自动淘汰任何元素,行为和一个"维护了顺序的 HashMap"没有区别。
2. 重写它,就得到了一个 LRU 缓存
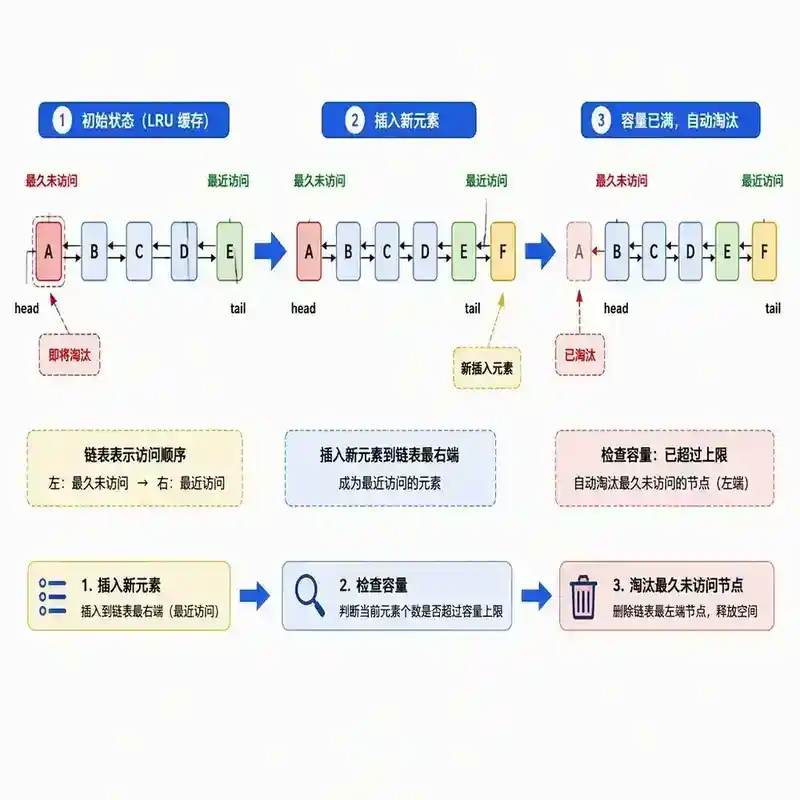
removeEldestEntry(Map.Entry<K,V> eldest) 是一个 protected 方法,专门留给子类重写。它接收的参数就是链表头部(最久未访问)的那个 Entry,返回值决定要不要把它删掉。最常见的用法是:在子类里维护一个容量上限,判断 size() > 上限 就返回 true。配合 accessOrder=true,这就构成了完整的 LRU 语义:链表头永远是最久未访问的元素,插入新元素超过容量时自动把它淘汰。
三、从零写一个 LRU 缓存
1. 核心实现:不到十行
public class LRUCache<K, V> extends LinkedHashMap<K, V> {
    private final int capacity;

    public LRUCache(int capacity) {
        // initialCapacity, loadFactor 用默认值即可;accessOrder 必须传 true
        super(16, 0.75f, true);
        this.capacity = capacity;
    }

    @Override
    protected boolean removeEldestEntry(Map.Entry<K, V> eldest) {
        return size() > capacity;
    }
}
这个实现只做了两件事:构造时把 accessOrder 设为 true,重写 removeEldestEntry() 用当前大小和容量上限比较。仅凭这两处改动,get()、put() 就自动具备了完整的 LRU 语义——不需要手写任何链表维护逻辑,因为 LinkedHashMap 内部已经把"访问即移到尾部"和"插入后检查是否淘汰头部"这两件事都做好了,子类只需要回答"现在要不要淘汰"这一个问题。
2. 这个实现的边界:不是线程安全的
LinkedHashMap 本身和 HashMap 一样不提供任何同步保证,accessOrder=true 模式下 get() 还会修改内部链表结构(严格来说 get() 已经不是一个只读操作了),这意味着多线程并发访问这个 LRUCache 会有线程安全问题,包括但不限于链表结构损坏、ConcurrentModificationException。如果需要线程安全的版本,最简单的办法是在外面包一层 synchronized(Collections.synchronizedMap() 或者手写锁),但这样并发度会退化到接近整表加锁;如果需要兼顾高并发和 LRU/LFU 等淘汰策略,通常会直接选用 Caffeine 或 Guava Cache 这类专门设计的缓存库。
四、常见误区
1. 以为 LinkedHashMap 默认就是 LRU
LinkedHashMap 默认构造是插入顺序、且默认不淘汰任何元素——它只是一个"记住插入顺序的 HashMap",和 LRU 没有任何关系。LRU 特性必须显式做两件事:构造时传 accessOrder=true,并重写 removeEldestEntry()。这是这个知识点上最容易被追问出漏洞的地方。
2. 混淆 containsKey() 和 get() 对顺序的影响
在 accessOrder=true 模式下,只有 get()(以及 getOrDefault()、对已有 key 的 put())会把节点移到链表尾部,containsKey() 不会触发这个调整。如果代码里先用 containsKey() 判断存在再用 get() 取值,顺序调整只会在第二次调用时发生——这通常没有问题,但如果误以为 containsKey() 也算一次"访问",可能会在理解淘汰顺序时产生偏差。
3. 以为重写 removeEldestEntry() 后删除操作是自动同步的
removeEldestEntry() 只负责判断"要不要删",真正的删除逻辑在 LinkedHashMap 内部帮你执行(从哈希桶和双向链表中都会摘除),子类不需要、也不应该在 removeEldestEntry() 里自己调用 remove() 去删除这个元素——那样反而会导致重复删除或者并发修改异常。
4. 认为 LinkedHashMap 的双向链表和红黑树/普通链表是同一套结构
一个 LinkedHashMap.Entry 同时存在于两套结构里:哈希桶那一层的链表或红黑树(继承自 HashMap,负责哈希查找),以及贯穿所有 Entry 的双向链表(before/after,负责维护顺序)。这两套结构是并存、独立更新的,遍历时用的是双向链表,哈希查找用的是桶内结构,理解这一点才能说清楚为什么 LinkedHashMap 既能保持 HashMap 级别的 O(1) 查找,又能保持确定的迭代顺序。
五、生产环境够不够用:与 Caffeine / Guava Cache 的对比
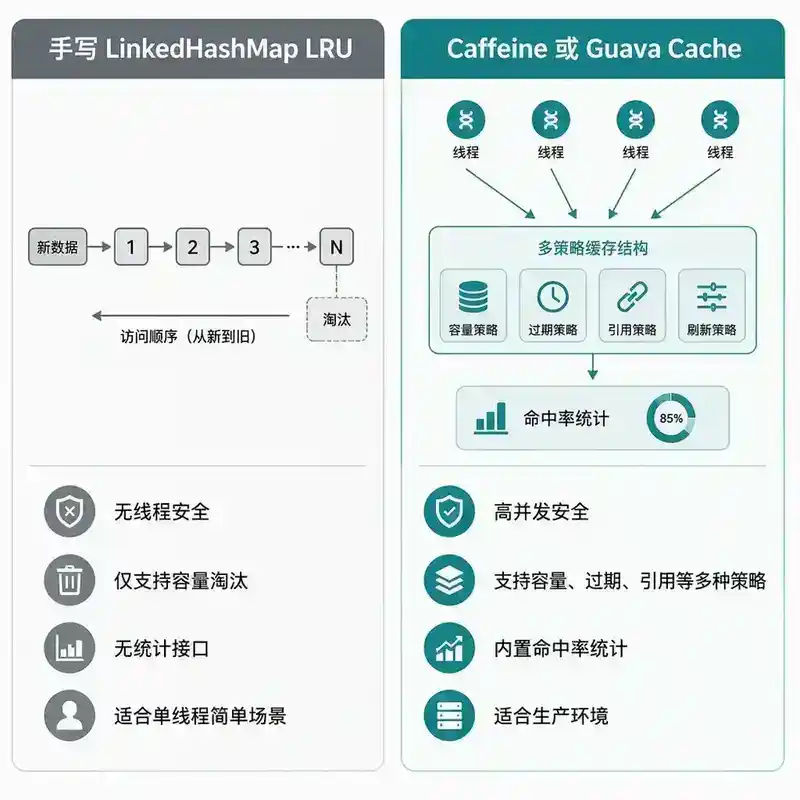
| 维度 | 手写 LinkedHashMap LRU | Caffeine / Guava Cache |
|---|---|---|
| 线程安全 | 无,需要额外加锁 | 内置,基于分段/无锁设计支持高并发 |
| 淘汰策略 | 仅支持容量触发的 LRU | 支持容量、时间(过期/刷新)、引用(弱引用/软引用)等多种策略组合 |
| 淘汰算法 | 严格 LRU(链表头淘汰) | Caffeine 用 W-TinyLFU,命中率通常优于严格 LRU |
| 统计与监控 | 无,需要自己加 | 内置命中率、加载耗时等统计接口 |
| 适用场景 | 单线程/低并发、教学与面试、简单本地缓存 | 生产环境的通用本地缓存 |
理解 LinkedHashMap 实现 LRU 的原理,价值不在于真的拿它上生产(除非场景足够简单、明确单线程),而在于这是理解所有"容量受限、按某种策略淘汰"缓存系统的最小可运行模型——Caffeine 的 W-TinyLFU、Redis 的 LRU 近似算法,思路上都是"维护某种顺序或频率信息,容量超限时淘汰信息最差的那个",LinkedHashMap 的实现是这类思想里最简单、最容易读懂源码的一个。
六、面试追问链
| 追问角度 | 典型问题 |
|---|---|
| 结构 | LinkedHashMap 和 HashMap 底层结构的区别是什么?"有序"具体体现在哪里? |
| 顺序模式 | 插入顺序和访问顺序有什么区别?accessOrder=true 时 get() 做了什么额外的事? |
| 关键钩子 | removeEldestEntry() 是什么?默认实现是什么样的?为什么它是 LRU 实现的关键? |
| 实现 | 如何用 LinkedHashMap 写一个 LRU 缓存?需要改哪两处? |
| 边界 | 这个实现线程安全吗?生产环境直接用够不够? |
| 对比 | 和 Caffeine/Guava Cache 相比,手写版本缺了什么? |
延伸阅读
- JDK 源码:
java.util.LinkedHashMap(afterNodeAccess()、afterNodeInsertion()、removeEldestEntry()) java.util.HashMap中预留的三个空钩子方法:afterNodeAccess()、afterNodeInsertion()、afterNodeRemoval(),专为子类扩展设计- Caffeine 官方文档:W-TinyLFU 淘汰算法与 LinkedHashMap 版 LRU 的命中率对比
- Redis 的近似 LRU 算法:为什么大规模场景下很少使用严格 LRU
Collections.synchronizedMap()与手写细粒度锁:给非线程安全容器包装同步语义的两种思路
问答(不计入阅读时长)
Q1:LinkedHashMap 和 HashMap 底层结构的区别是什么?"有序"具体体现在哪里?
A:LinkedHashMap 继承自 HashMap,完全复用了后者的哈希桶+链表/红黑树结构,哈希查找逻辑不变。它新增的是一个内部 Entry 类型(多了 before、after 引用)和 head/tail 两个指针,把所有 Entry 用一条双向链表串联起来。"有序"完全来自这条额外维护的双向链表——哈希桶本身依然是无序的,遍历顺序由双向链表决定,与桶的物理排列无关。
Q2:插入顺序和访问顺序有什么区别?accessOrder=true 时 get() 做了什么额外的事?
A:accessOrder=false(默认)是插入顺序:链表顺序等于元素插入的顺序,之后无论怎么 get(),顺序都不变。accessOrder=true 是访问顺序:每次 get()、getOrDefault(),或对已存在 key 的 put(),都会调用 afterNodeAccess() 把这个节点从当前位置摘下、重新挂到链表尾部,使链表头部始终是最久未被访问的元素。注意 containsKey() 不会触发这个调整。
Q3:removeEldestEntry() 是什么?默认实现是什么样的?为什么它是 LRU 实现的关键?
A:它是一个 protected 方法,在 HashMap.putVal() 插入成功后被 afterNodeInsertion(evict) 调用,参数是双向链表头节点(最久未访问的元素),返回值决定要不要删除它。LinkedHashMap 自身的默认实现永远返回 false,也就是默认不会自动淘汰任何元素。它是 LRU 实现的关键,因为它是唯一一个"决定淘汰与否"的钩子——只要重写它并结合访问顺序,就能得到完整的 LRU 语义,不需要手写任何链表维护逻辑。
Q4:如何用 LinkedHashMap 写一个 LRU 缓存?需要改哪两处?
A:只需要两处改动:构造时把 accessOrder 设为 true(继承 LinkedHashMap 的三参数构造器 super(initialCapacity, loadFactor, true));重写 removeEldestEntry(Map.Entry<K,V> eldest),返回 size() > 容量上限。这两处改动之后,get()/put() 就自动具备完整的 LRU 语义——链表维护和淘汰判断的触发都由 LinkedHashMap 内部完成,子类只需要回答"现在要不要淘汰"这一个问题。
Q5:这个手写实现线程安全吗?生产环境直接用够不够?
A:不是线程安全的。LinkedHashMap 本身和 HashMap 一样不提供任何同步保证,而且 accessOrder=true 模式下 get() 也会修改内部链表结构,严格来说已经不是纯读操作了,多线程并发访问会有链表结构损坏、ConcurrentModificationException 等风险。如果要用,最简单的办法是外面包一层 synchronized,但并发度会退化到接近整表加锁;生产环境如果需要兼顾高并发和淘汰策略,通常直接选用专门设计的缓存库。
Q6:和 Caffeine / Guava Cache 相比,手写版本缺了什么?
A:手写版本只支持基于容量的严格 LRU 淘汰,没有线程安全保证,也没有统计接口。Caffeine/Guava Cache 内置高并发安全设计,支持容量、过期(写后过期/访问后过期)、引用(弱引用/软引用)等多种淘汰策略的组合,还提供命中率、加载耗时等监控指标;Caffeine 使用的 W-TinyLFU 算法命中率通常也优于严格 LRU。手写 LinkedHashMap 版本的价值在于理解原理和面试场景,而不是直接用于生产。
Q7:为什么 removeEldestEntry() 不需要自己调用 remove() 去删除元素?
A:因为 removeEldestEntry() 只负责回答"要不要删"这个布尔判断,真正的删除动作(同时从哈希桶结构和双向链表中摘除节点)由 LinkedHashMap 内部在拿到 true 返回值后自动执行。如果在 removeEldestEntry() 里自己再调用一次 remove(),会导致对同一个节点的重复删除操作,可能引发异常或者数据结构不一致。
Q8:一个 LinkedHashMap.Entry 存在于几套结构里?它们分别负责什么?
A:存在于两套并存且独立更新的结构里:一套是继承自 HashMap 的哈希桶层(数组+链表/红黑树),负责 O(1) 的哈希查找;另一套是贯穿所有 Entry 的双向链表(before/after),负责维护插入或访问顺序。遍历 LinkedHashMap 走的是双向链表,哈希查找走的是桶内结构——正是这种"两套结构并存"的设计,让 LinkedHashMap 既能保持 HashMap 级别的查找效率,又能提供确定的迭代顺序。