覆盖考点:029|Lambda 表达式:函数式接口、方法引用、变量捕获与执行模型
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:26 分钟(文末问答不计入)
上一篇讲的泛型解决的是编译期类型检查的问题,这一篇要讲的 Lambda 表达式,很多人第一反应是"匿名内部类的语法糖",但这个理解并不准确——Lambda 背后有一整套函数式接口、方法引用、变量捕获规则,以及和匿名内部类完全不同的编译执行模型。这篇要把这套体系从"为什么需要它"讲到"编译后到底变成了什么"。
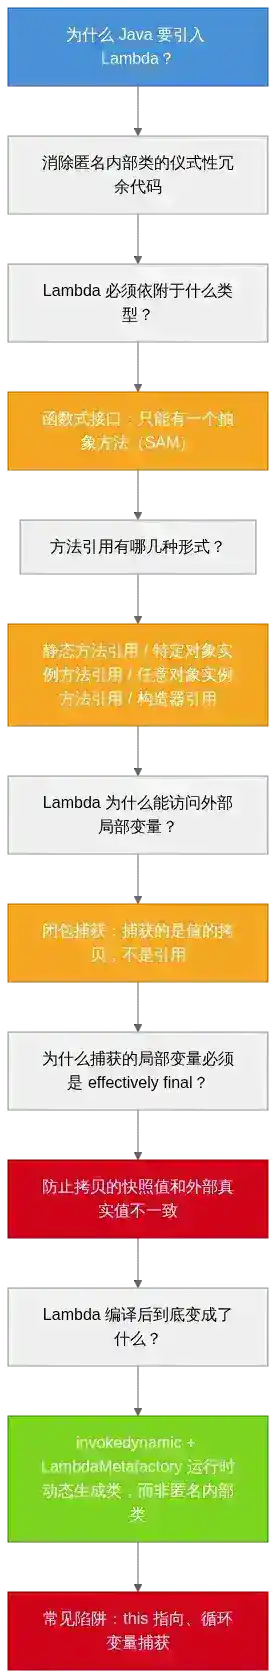
面试官在这个考点上通常这样追问:Lambda 表达式的类型是什么,能不能直接用 var 声明 → 函数式接口的定义是什么,@FunctionalInterface 注解不写会怎样 → 方法引用有哪几种形式 → 为什么 Lambda 捕获的局部变量必须是 effectively final → Lambda 编译后到底变成了什么,和匿名内部类有什么本质区别 → Lambda 里的 this 到底指向谁。本文按这条链展开。
一、为什么 Java 要引入 Lambda
在 Lambda 出现之前,如果你想把一段"行为"当作参数传递(比如给线程传一个任务、给排序传一个比较规则),只能写匿名内部类:
Runnable r = new Runnable() {
    @Override
    public void run() {
        System.out.println("执行任务");
    }
};
这种写法啰嗦,而且每次都要重复接口名、方法名这些"仪式性"代码,真正有价值的只有方法体那一行。Lambda 表达式就是为了消除这种冗余:Runnable r = () -> System.out.println("执行任务");。但 Lambda 不只是语法糖,它背后有一整套"函数式接口 + 方法引用 + 变量捕获 + 独立的编译执行模型",这篇要把这套体系讲透。
二、函数式接口:Lambda 的落脚点
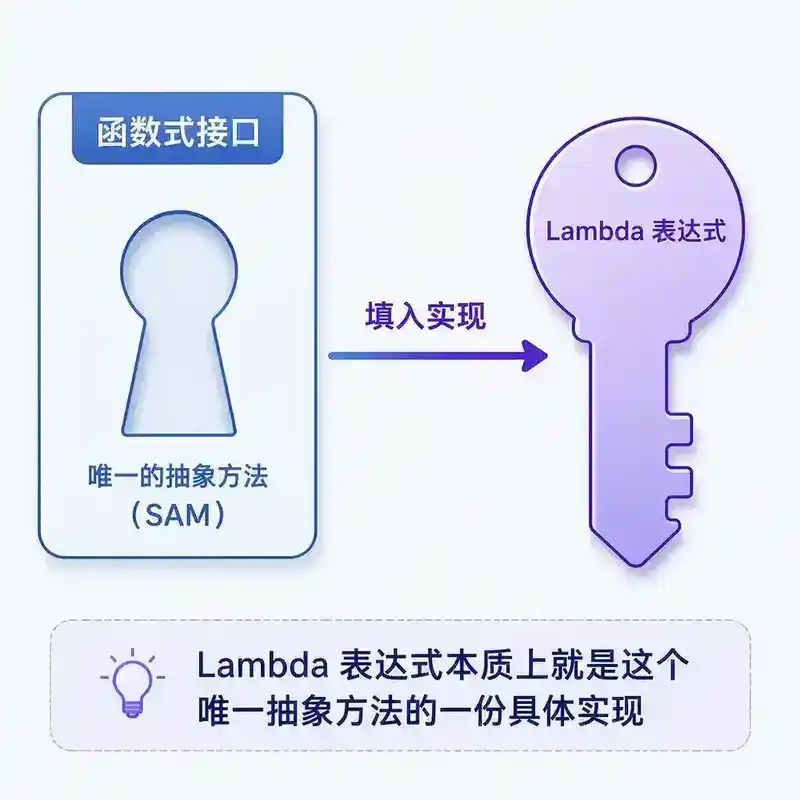
Lambda 表达式不能独立存在,它必须赋值给一个函数式接口类型的变量或者作为参数传递。函数式接口的定义很简单:一个接口里只能有一个抽象方法(可以有任意多个默认方法和静态方法,这些不算)。@FunctionalInterface 注解不是必需的,但加上之后,如果接口不小心多定义了一个抽象方法,编译器会立刻报错,起到"契约保护"的作用。
java.util.function 包提供了一批开箱即用的通用函数式接口:
| 接口 | 抽象方法 | 用途 |
|---|---|---|
Runnable |
void run() |
无参无返回值 |
Supplier<T> |
T get() |
无参,提供一个值 |
Consumer<T> |
void accept(T t) |
消费一个值,无返回 |
Function<T,R> |
R apply(T t) |
输入转输出 |
Predicate<T> |
boolean test(T t) |
判断条件 |
BiFunction<T,U,R> |
R apply(T t, U u) |
两个输入转一个输出 |
理解了这张表,看到任何 Lambda 表达式时,第一反应应该是:它到底要赋值给哪个函数式接口?这决定了它的参数个数和返回值类型该怎么写。
三、方法引用:比 Lambda 更进一步的简化
如果 Lambda 的方法体只是简单地调用一个已有方法,可以进一步简化成方法引用,用 :: 语法。方法引用一共有四种形式:
- 静态方法引用:
Integer::parseInt,等价于s -> Integer.parseInt(s)。 - 特定对象的实例方法引用:
someList::add,等价于x -> someList.add(x)——someList是一个已经存在的具体对象。 - 任意对象的实例方法引用:
String::length,等价于s -> s.length()——注意这里第一个参数变成了调用者本身,s.length()里的s就是 Lambda 参数列表里的那个对象。 - 构造器引用:
ArrayList::new,等价于() -> new ArrayList<>()。
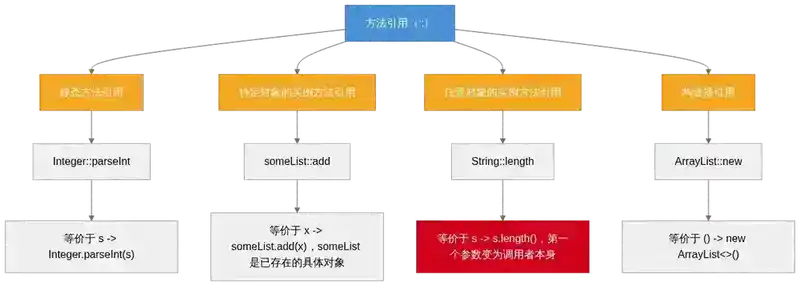
第三种"任意对象的实例方法引用"是最容易搞混的一种——String::length 看起来像是调用静态方法,但它实际展开成 (String s) -> s.length(),参数列表里的第一个参数会变成方法的调用者。
四、闭包与变量捕获:Lambda 如何"记住"外部变量
Lambda 表达式可以访问定义它时所在作用域里的局部变量,这种能力叫闭包(closure)。但 Java 对这种捕获加了一条硬性限制:被捕获的局部变量必须是事实最终变量(effectively final)——也就是说,这个变量即使没有显式加 final 关键字,也必须是"赋值之后从未再被修改过"的状态。如果你试图在 Lambda 里修改一个捕获的外部局部变量,编译器会直接报错。
int count = 0;
Runnable r = () -> {
    count++; // 编译错误:不能修改被捕获的局部变量
};
为什么必须是 effectively final?因为 Lambda 捕获的不是变量本身,而是变量在捕获那一刻的值的一份拷贝(对于局部变量)。如果允许修改,Lambda 内部看到的值和外部方法里的值随时可能不一致,尤其是当 Lambda 被传到另一个线程执行、而外部方法早已执行完毕、栈帧已经被销毁的情况下,"修改后同步"这件事根本无法实现。禁止修改,从根本上避免了这类数据不一致和生命周期错位的问题。
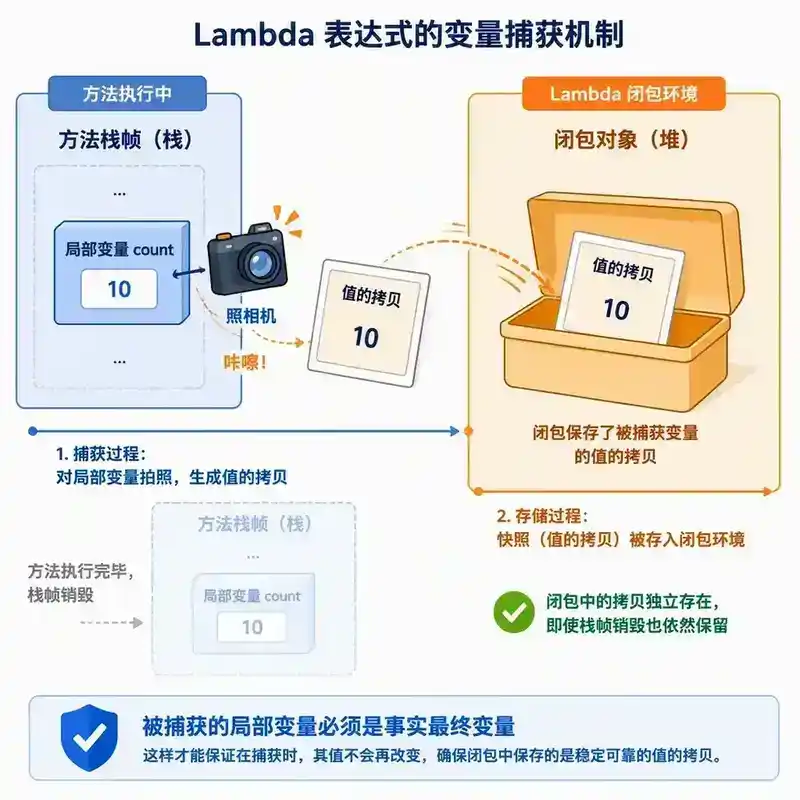
需要注意的是,这条限制只针对局部变量。如果 Lambda 捕获的是实例字段或者静态字段,就没有这个限制,因为字段本身就是通过对象引用或类引用访问的,不存在"栈帧销毁后失效"的问题,修改字段值是完全允许的。
五、执行模型:Lambda 编译后变成了什么
一个常见的误解是"Lambda 底层就是匿名内部类"。实际上完全不是。匿名内部类在编译期会生成一个独立的 .class 文件(比如 Outer$1.class),而 Lambda 表达式编译后,字节码里出现的是一条 invokedynamic 指令,指向 LambdaMetafactory。真正生成实现类的时机被推迟到了运行时第一次执行到这条指令的时候,由 LambdaMetafactory 动态生成一个实现该函数式接口的类(通常基于 invokedynamic + 方法句柄机制),生成完之后会被缓存,同一处 Lambda 表达式不会重复生成。
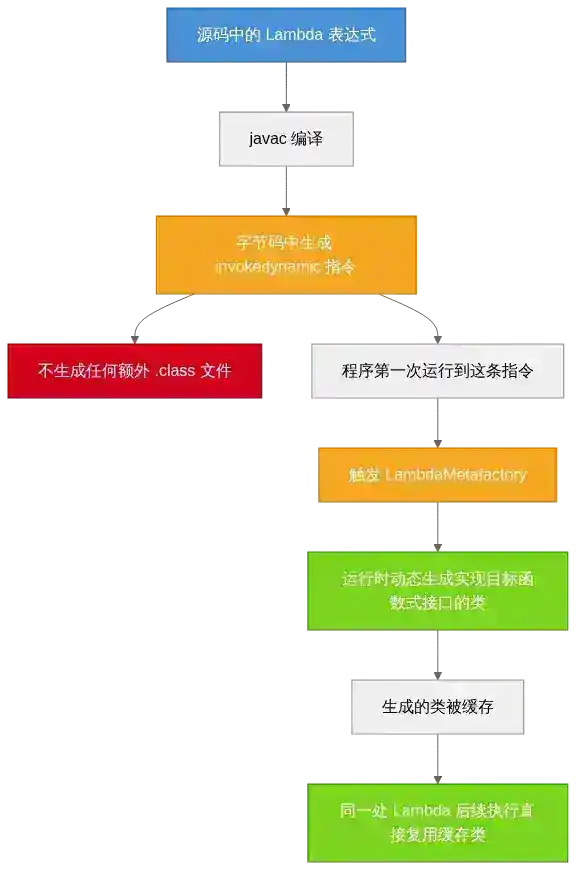
这个设计的好处是:不会像匿名内部类那样,每写一个 Lambda 就在编译产物里多一个 class 文件(大量 Lambda 会导致 class 文件数量膨胀),而是把类的生成推迟到运行时按需完成。
六、常见陷阱
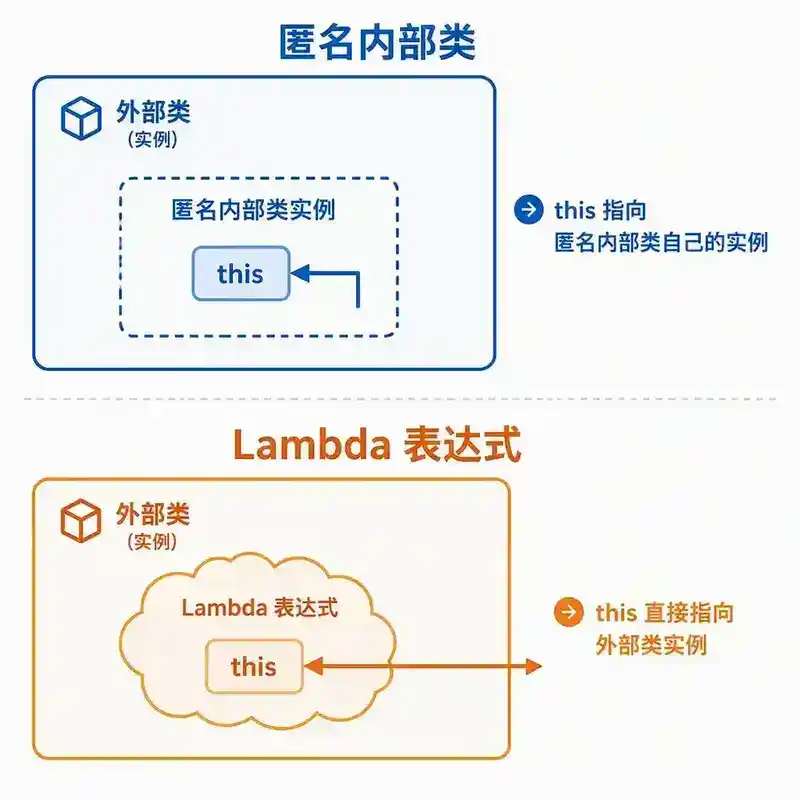
- this 指向的陷阱:匿名内部类里的
this指向匿名内部类自己的实例;而 Lambda 表达式里的**this**指向的是外部类的实例,因为 Lambda 不会创建新的作用域层级,它"共享"外层的 this。这个区别在两者混用、或者从匿名内部类改写成 Lambda 时特别容易踩坑。
- 循环变量捕获:在传统
for循环里用可变的循环变量(比如int i)无法直接被 Lambda 捕获(因为i会被反复修改,不是 effectively final),必须额外声明一个中间变量。而forEach结合方法引用则天然没有这个问题,因为每次迭代拿到的是一个新的、独立的、事实最终的变量。 - 误以为捕获的是变量的引用:对局部变量,捕获的是值的拷贝;对实例字段,捕获的是通过 this 引用间接访问,字段值的变化在 Lambda 执行时是能看到最新值的——这两种"看起来相似"的捕获行为,底层机制完全不同,容易被搞混。
- 过度使用 Lambda 影响调试:Lambda 表达式在异常堆栈里显示的方法名通常是编译器生成的合成名字(类似
lambda$method$0),可读性不如具名方法,链式调用嵌套过深时定位问题会比较麻烦。
七、面试追问链
延伸阅读
- 《Java 语言规范》第 15.27 节关于 Lambda 表达式的定义
java.lang.invoke.LambdaMetafactory源码与invokedynamic指令机制- 上一期:《Java 泛型:类型信息只活在编译期,运行时早就被抹掉了》
问答(不计入阅读时长)
Q1:Lambda 表达式的类型是什么?能直接写**var x = () -> {}**吗?
A:Lambda 表达式本身没有独立的"Lambda 类型",它的类型取决于它被赋值的目标函数式接口——同一个 () -> System.out.println("hi") 赋给 Runnable 就是 Runnable,赋给别的只有一个无参无返回值抽象方法的接口,它就是那个接口。因此 var x = () -> {} 无法编译,因为编译器不知道该把它推断成哪个具体的函数式接口类型,缺少了目标类型上下文。
Q2:**@FunctionalInterface**注解不写会怎样?
A:不写也完全不影响功能,只要接口本身只有一个抽象方法,Lambda 照样能用。这个注解纯粹是给编译器加的一层"契约保护":加了之后,如果有人不小心往这个接口里多加了一个抽象方法,编译器会立刻报错提醒,属于防御性的最佳实践,不是语法强制要求。
Q3:**String::length**为什么不是"调用 String 类的静态方法"?
A:因为 String 没有名为 length 的静态方法,length() 是实例方法。这种写法属于方法引用的第三种形式——"任意对象的实例方法引用",它的等价 Lambda 是 (String s) -> s.length(),也就是说方法引用参数列表里的第一个参数,会变成调用这个实例方法的对象本身,而不是传给方法的普通参数。
Q4:为什么 Lambda 里不能对捕获的局部变量做**count++**这样的操作,但能对实例字段这么做?
A:因为两者捕获的机制完全不同。局部变量存在于方法的栈帧里,Lambda 捕获它时拿到的是当时那个值的一份拷贝;如果允许修改,Lambda 内部看到的值和外部方法里的值可能不同步,尤其是外部方法已经执行完、栈帧已经销毁的情况下,这种不一致根本没法处理。而实例字段是通过对象引用间接访问的,字段存在于堆上的对象里,不存在"栈帧销毁后失效"的问题,所以可以自由读写,看到的永远是最新值。
Q5:如果没有 Lambda 也没有闭包这些机制,纯用匿名内部类能不能模拟出同样效果?
A:功能上基本可以,匿名内部类同样能捕获外部的 effectively final 局部变量,这条限制不是 Lambda 独有的,早在匿名内部类时代就存在。真正的区别在于编译产物和运行机制:匿名内部类会在编译期生成一个独立的 .class 文件,而 Lambda 编译后只在字节码里留一条 invokedynamic 指令,实现类的生成被推迟到运行时由 LambdaMetafactory 按需完成,两者的执行模型完全不同。
Q6:**this**在 Lambda 里到底指向谁,有没有办法验证?
A:Lambda 表达式内部的 this 指向定义这个 Lambda 时所在的外部类实例,而不是 Lambda 自己(因为 Lambda 根本不创建新的类层级)。可以写一段测试代码:在外部类的某个方法里分别用匿名内部类和 Lambda 打印 this.getClass().getName() 或者 this.toString(),匿名内部类会打印出类似 Outer$1 的合成类名,而 Lambda 里的 this 打印出的是外部类本身的类名,直观地验证了两者行为不同。
Q7:为什么传统**for**循环里的循环变量不能直接被 Lambda 捕获,但**forEach**里可以?
A:传统 for (int i = 0; i < n; i++) 里的 i 在每次迭代中都会被修改(i++),不满足 effectively final 的要求,所以 Lambda 无法直接捕获它,必须额外声明一个中间变量把当前值复制出来才能用。而 forEach(x -> ...) 或者 for (Type x : collection) 这种写法,每次迭代拿到的 x 都是一个新声明的、独立的、赋值后不再改变的变量,天然满足 effectively final,所以可以直接被 Lambda 捕获,不需要额外处理。
Q8:调试时看到异常堆栈里出现**lambda$someMethod$0**这样的方法名,是什么意思?
A:这是编译器为 Lambda 表达式生成的合成方法名,命名规则大致是 lambda$所在方法名$序号。因为 Lambda 表达式的方法体最终会被编译成一个私有的合成方法,供运行时生成的实现类去调用,这个名字不是你写的,而是编译器自动生成的。看到这种名字时,说明异常发生在某个 Lambda 表达式内部,可以结合行号信息定位到具体是哪一段 Lambda 代码出了问题。