覆盖考点:022|TreeMap 与红黑树:有序映射、比较器、一致性和复杂度
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:38 分钟(文末问答不计入)
前几篇讲的 HashMap、LinkedHashMap、ConcurrentHashMap,共同点是查找快(均摊 O(1)),但都不天然保证"按 key 排序"这件事——LinkedHashMap 保证的是插入或访问顺序,不是大小顺序。如果业务场景需要一个"随时能按 key 大小顺序遍历、还能快速找到某个范围内所有元素"的 Map,TreeMap 是标准库里的答案。它的查找、插入、删除都是 O(log n),比哈希表的均摊 O(1) 慢,但换来的是任何时刻都保持有序——这背后的支撑结构是红黑树,一种自平衡二叉查找树。这篇要讲清楚 TreeMap 是怎么用红黑树维持顺序的,比较器(Comparator)在其中扮演什么角色,以及一个容易被面试问倒的细节:TreeMap 判断两个 key 是否相等,用的根本不是 equals()。
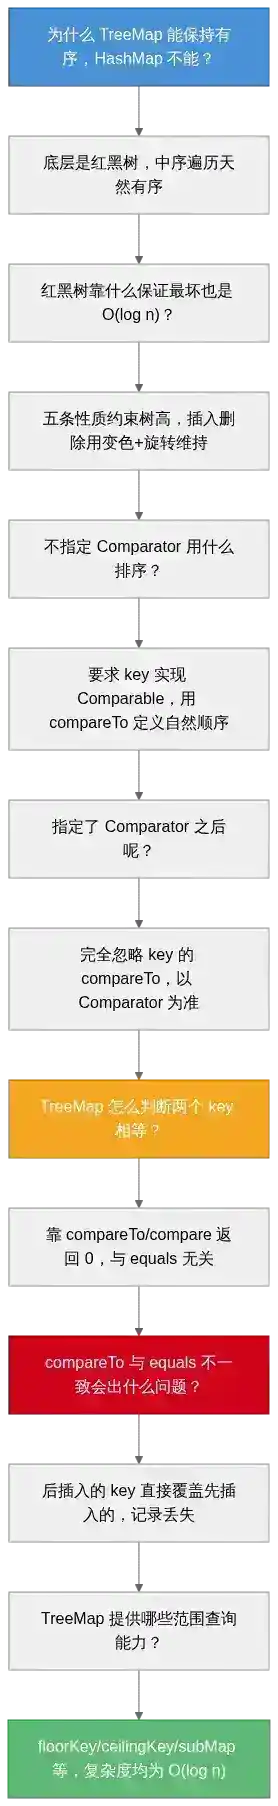
面试官在这个考点上通常这样追问:为什么 TreeMap 能保持有序,HashMap 不能 → 红黑树是什么,它靠什么规则做到"最坏情况下也是 O(log n)"而不会退化成链表 → TreeMap 不指定 Comparator 时用什么规则排序,指定了 Comparator 之后又会怎样 → TreeMap 用什么方法判断两个 key 相等,这和 HashMap 有什么本质不同 → Comparator 和元素的 equals()/hashCode() 不一致会出什么问题 → TreeMap 提供的范围查询方法有哪些,分别是怎么利用树结构做到高效的。本文按这条链展开。
一、为什么需要红黑树,而不是普通二叉查找树
1. 普通二叉查找树的退化问题
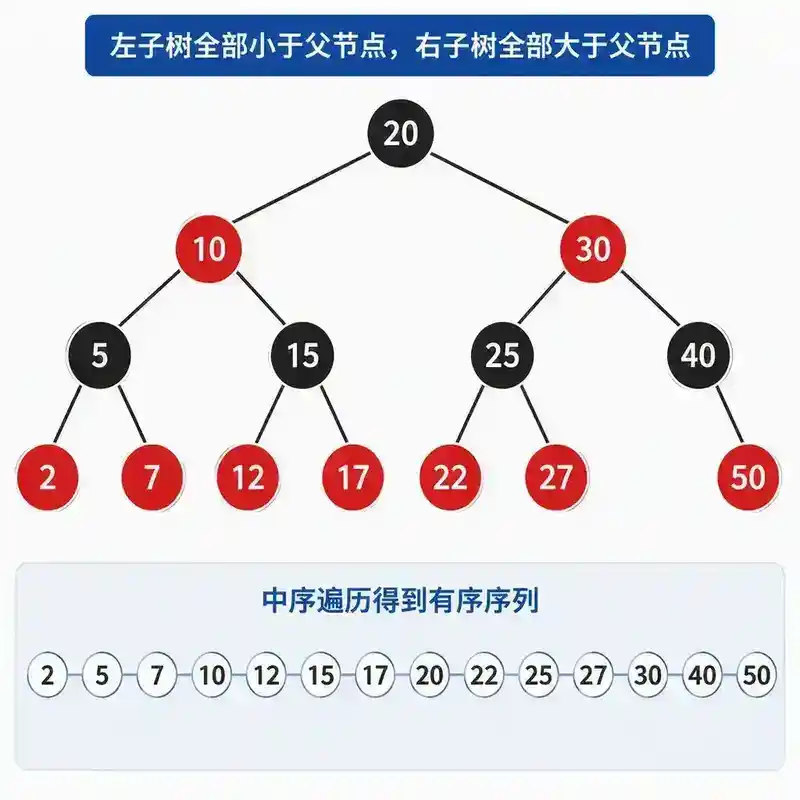
二叉查找树(BST)的基本规则很简单:每个节点的左子树所有 key 都小于它,右子树所有 key 都大于它,查找时每一步都能排除一半的候选范围,理想情况下查找复杂度是 O(log n)。但如果插入的 key 恰好是有序或接近有序的序列(比如依次插入 1、2、3、4、5),树会退化成一条链表,查找复杂度退化成 O(n)——这时二叉查找树完全失去了它存在的意义。
2. 红黑树:给二叉查找树加上自平衡规则
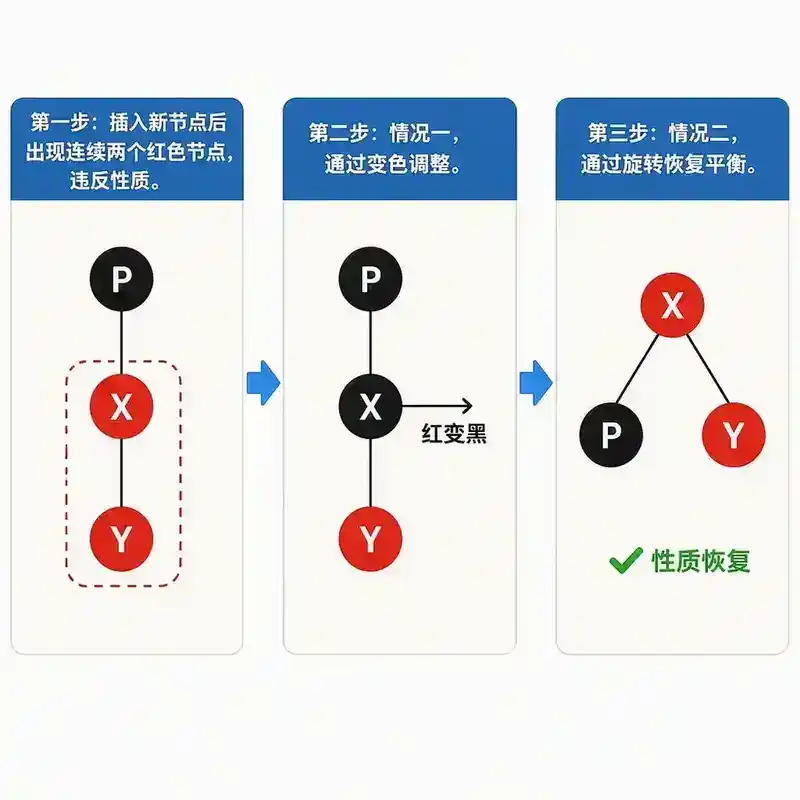
红黑树在普通二叉查找树的基础上,给每个节点额外标记一个颜色(红或黑),并维护五条性质(根节点为黑、红节点的子节点必为黑、每个叶子的空节点视为黑、任意节点到其所有叶子路径上的黑节点数量相同等),通过插入和删除时的"变色+旋转"操作维持这些性质。这些性质共同保证了:从根到任意叶子的最长路径不会超过最短路径的 2 倍——也就是说,树的高度始终被限制在 O(log n) 量级,无论插入顺序如何,都不会退化成链表。这正是红黑树相比普通 BST 的核心价值:用较低的维护成本(旋转+变色),换来最坏情况下依然是 O(log n) 的稳定性能。
3. 为什么不用更严格平衡的 AVL 树
AVL 树对平衡性的要求更严格(任意节点左右子树高度差不超过 1),查找效率理论上比红黑树略高,但插入和删除时为了维持这个更严格的平衡条件,需要更频繁的旋转操作。红黑树放宽了平衡条件(只保证"最长路径不超过最短路径 2 倍"这种弱平衡),换来的是插入删除时旋转次数更少、平均性能更好。Java 标准库里 TreeMap、TreeSet,以及 JDK 8 HashMap 树化后的桶内结构,都选择了红黑树而不是 AVL 树,本质上是在"查找效率"和"插入删除效率"之间选择了更均衡的一侧。
二、排序依据:Comparable 与 Comparator
1. 不指定 Comparator:依赖元素的自然顺序
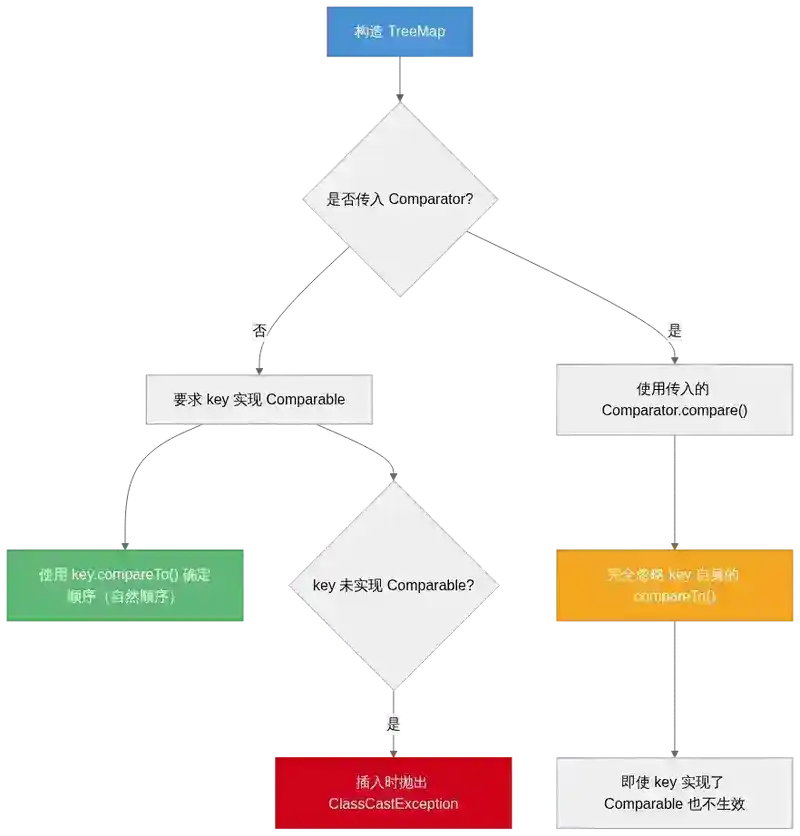
TreeMap 如果不传入 Comparator,会要求 key 类型实现 Comparable 接口,用它的 compareTo() 方法确定顺序——这称为"自然顺序"(natural ordering)。String、Integer、Long 等包装类都已经实现了 Comparable,按各自的语义定义了自然顺序(数值大小、字典序等)。如果 key 类型没有实现 Comparable,且构造时没有传 Comparator,插入元素时会直接抛出 ClassCastException。
2. 指定 Comparator:自定义排序规则,且优先级更高
构造 TreeMap 时可以传入一个 Comparator<K>,一旦传入,TreeMap 内部所有比较操作都会使用这个 Comparator,完全忽略 key 类型自身的**compareTo()**——即使 key 类型实现了 Comparable,只要构造时传了 Comparator,就以 Comparator 为准。这给了业务代码很大的灵活性:比如需要按字符串长度排序而不是字典序,或者需要倒序排列,都可以通过传入自定义 Comparator 实现,不需要修改 key 类型本身的代码。
三、关键细节:TreeMap 用 compareTo/compare 判断相等,不用 equals
1. 这是最容易被面试问倒的一点
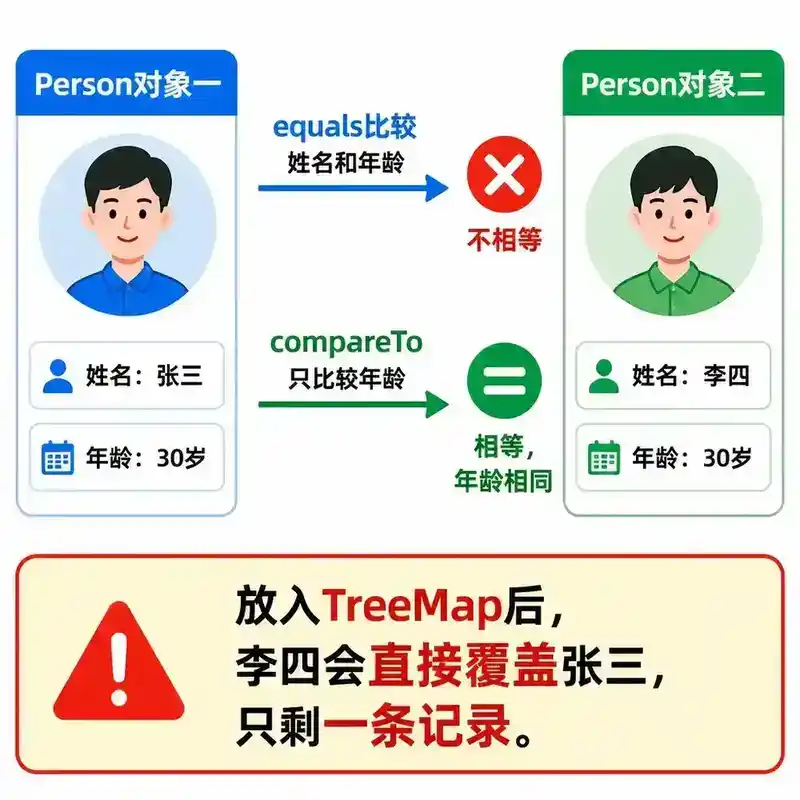
HashMap 判断两个 key 是否是"同一个 key",用的是 hashCode() 定位桶 + equals() 精确比较。但 TreeMap 完全不同:它判断两个 key 是否相等,依据的是**compareTo()**(或传入的**Comparator.compare()**)返回值是否为 0,根本不会调用 equals()。这意味着:如果一个类的 compareTo() 实现和 equals() 的判等逻辑不一致(比如 compareTo() 只比较对象的某一个字段,但 equals() 比较了所有字段),把这个类的对象放进 TreeMap 当 key,会出现"两个用 equals() 判断不相等的对象,在 TreeMap 里被当成同一个 key"的诡异现象——后插入的会直接覆盖先插入的,而不是新增一条记录。
2. 一个具体的例子
假设有一个 Person 类,equals() 比较姓名和年龄两个字段,但 compareTo() 只按年龄排序。把两个姓名不同、年龄相同的 Person 对象依次放进 TreeMap<Person, String>,因为 compareTo() 返回 0,TreeMap 会认为这是同一个 key,第二次 put() 会覆盖第一次的 value,而不是新增一条记录——即使 equals() 判断这两个对象明显不相等。这种"实现了 Comparable 但 compareTo() 与 equals() 不一致"的情况,官方文档称为与 equals 不一致的 Comparable(inconsistent with equals),JDK 文档明确建议避免这种实现,尤其是当这个类的对象会被放进有序集合(TreeMap、TreeSet)时。
四、TreeMap 的范围查询能力
1. 普通 HashMap 做不到的事
HashMap 只能做精确查找(给定 key,返回 value),做不到"查找所有小于某个值的 key"或者"查找刚好比某个 key 大的下一个 key"这类范围相关的查询——因为哈希表的桶位置和 key 的大小顺序完全没有关系。TreeMap 因为底层是有序的红黑树,天然支持这类操作,而且复杂度都是 O(log n),不需要遍历整棵树。
2. 常用的范围查询方法
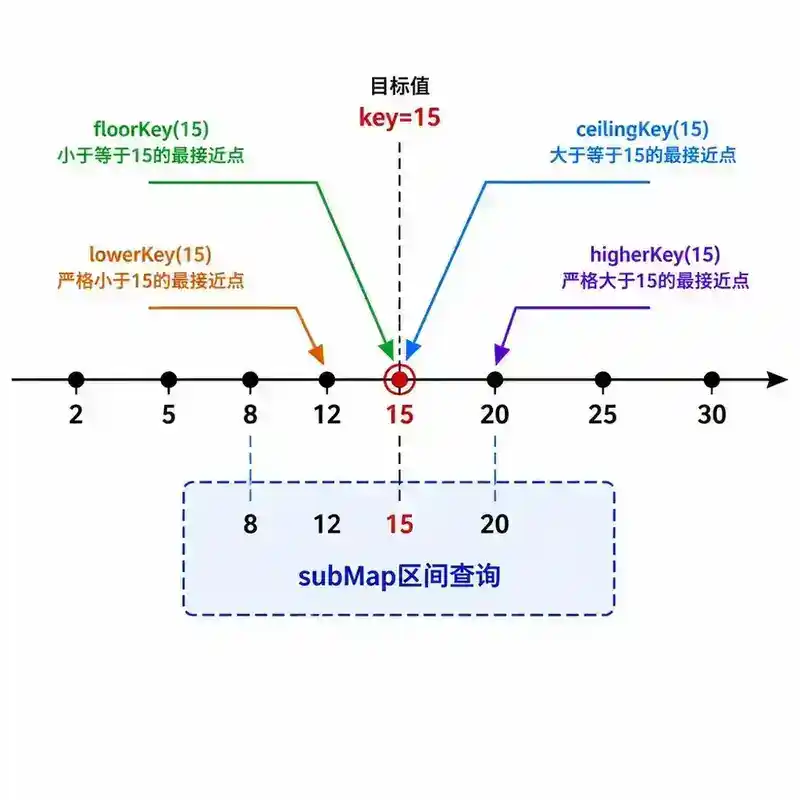
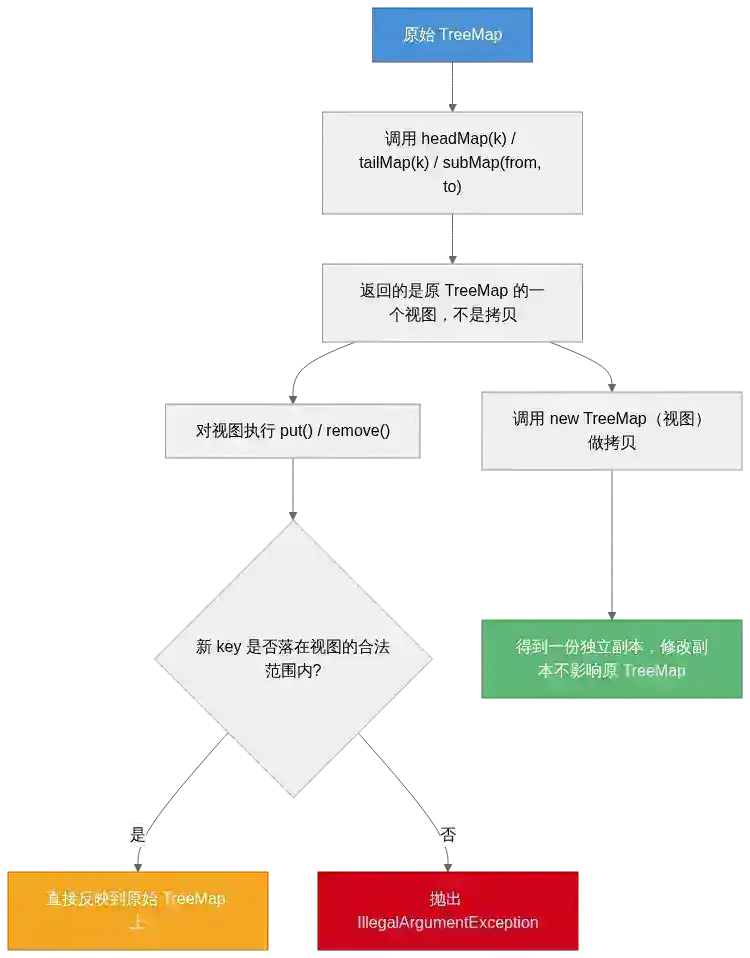
firstKey()/lastKey():返回最小 / 最大的 key,直接沿树的最左 / 最右路径走到底,O(log n)。floorKey(k)/ceilingKey(k):返回小于等于 / 大于等于给定 key 的最接近的那个 key(不存在则返回 null)。lowerKey(k)/higherKey(k):返回严格小于 / 严格大于给定 key 的最接近的那个 key。headMap(k)/tailMap(k)/subMap(from, to):返回原树的一个视图(不是拷贝),分别对应"小于给定 key 的所有条目""大于等于给定 key 的所有条目""某个区间内的所有条目",对视图的修改会直接反映到原TreeMap上。
这些方法在实际业务中很常用:比如实现一个"按时间戳存储事件,查询某个时间点之前最近一次事件"的场景,用 floorKey() 一次调用就能完成,如果用 HashMap 则需要遍历所有 key 手动比较。
五、TreeMap 与其他 Map 实现的对比
| 维度 | HashMap | LinkedHashMap | TreeMap |
|---|---|---|---|
| 底层结构 | 数组+链表/红黑树 | HashMap 结构+双向链表 | 纯红黑树 |
| 查找/插入复杂度 | 均摊 O(1) | 均摊 O(1) | O(log n) |
| 遍历顺序 | 无序 | 插入顺序或访问顺序 | key 的自然顺序或 Comparator 顺序 |
| 相等判断依据 | hashCode() + equals() | 同 HashMap | compareTo()/compare(),与 equals() 无关 |
| 范围查询 | 不支持 | 不支持 | 原生支持(floorKey/subMap 等) |
| null key | 允许一个 | 允许一个 | 不允许(无 Comparator 时会抛 NPE) |
六、常见误区
1. 以为 TreeMap 排序性能损耗很小,可以随便用来替代 HashMap
TreeMap 的查找/插入是 O(log n),HashMap 是均摊 O(1)。在数据量较大且不需要排序的场景下盲目用 TreeMap 替代 HashMap,会带来不必要的性能损耗——只有真正需要"始终保持有序"或者"频繁做范围查询"的场景,才值得选择 TreeMap。
2. 把用于排序的字段和用于判等的字段设计得不一致
如前面第三节所讲,compareTo() 和 equals() 逻辑不一致会导致 TreeMap 里出现"本该是两条记录却被当成一条"的诡异 bug。设计可比较类型时,如果这个类型可能被放进有序集合,compareTo() 的判等逻辑(返回 0 的条件)应该和 equals() 保持一致,或者清楚地知道并接受这种不一致带来的后果。
3. 认为 TreeMap 支持 null key
TreeMap 在没有指定 Comparator 的情况下不允许 null key——因为插入 null 时需要调用它的 compareTo() 与其他 key 比较,null.compareTo() 直接抛出 NullPointerException。即使指定了 Comparator,也要看这个 Comparator 的实现是否处理了 null,否则同样会抛异常。这一点和 HashMap 允许一个 null key 明显不同。
4. 忽略 headMap/tailMap/subMap 返回的是视图而不是拷贝
对 headMap()、tailMap()、subMap() 返回的子 Map 进行的插入或删除操作,会直接影响原始的 TreeMap(前提是插入的 key 落在这个视图的合法范围内,否则会抛 IllegalArgumentException)。如果需要一份独立的拷贝而不影响原数据,需要显式地用 new TreeMap<>(subMap) 做一次复制。
七、面试追问链
| 追问角度 | 典型问题 |
|---|---|
| 动机 | 为什么 TreeMap 能保持有序,HashMap 不能? |
| 数据结构 | 红黑树是什么?它靠什么规则保证最坏情况也是 O(log n)? |
| 排序依据 | 不指定 Comparator 时用什么排序?指定了 Comparator 之后呢? |
| 相等判断 | TreeMap 怎么判断两个 key 相等?这和 HashMap 有什么本质区别? |
| 一致性陷阱 | compareTo() 和 equals() 不一致会出什么问题? |
| 能力边界 | TreeMap 提供哪些范围查询方法?分别怎么利用树结构做到高效? |
延伸阅读
- JDK 源码:
java.util.TreeMap(put()、getEntry()、fixAfterInsertion()中的旋转与变色逻辑) - 《算法(第 4 版)》红黑树章节:左倾红黑树的插入实现,与 JDK 版本思路类似但实现细节不同
Comparable接口文档:关于"与 equals 不一致的 Comparable"的官方警告说明java.util.TreeSet:内部直接委托给 TreeMap 实现,理解 TreeMap 即理解 TreeSet- AVL 树与红黑树的旋转次数对比:为什么大多数标准库选择红黑树而非 AVL 树
问答(不计入阅读时长)
Q1:为什么 TreeMap 能保持有序,HashMap 不能?
A:HashMap 的元素位置由 key 的哈希值决定,哈希值和 key 的大小顺序没有任何关系,所以遍历顺序是无序的。TreeMap 底层是一棵红黑树,红黑树本质上是一棵二叉查找树:每个节点左子树的所有 key 都小于它,右子树都大于它。对这棵树做中序遍历,天然就能得到按 key 大小排列的有序序列——有序性是这棵树的结构本身保证的,不是遍历时额外排序出来的。
Q2:红黑树是什么?它靠什么规则保证最坏情况也是 O(log n)?
A:红黑树是在普通二叉查找树基础上,给每个节点标记红或黑两种颜色,并维护五条性质(根为黑、红节点的子节点必为黑、每个叶子的空节点视为黑、任意节点到其所有叶子路径的黑节点数相同等)的自平衡树。这些性质共同保证了从根到任意叶子的最长路径不会超过最短路径的 2 倍,也就是把树的高度限制在 O(log n) 量级。插入或删除节点破坏这些性质时,通过"变色+旋转"恢复,保证无论插入顺序如何,树都不会退化成链表。
Q3:不指定 Comparator 时用什么排序?指定了 Comparator 之后呢?
A:不指定 Comparator 时,TreeMap 要求 key 类型实现 Comparable 接口,用它的 compareTo() 方法确定顺序,这称为自然顺序;如果 key 没实现 Comparable,插入时会抛出 ClassCastException。一旦构造时传入了 Comparator,TreeMap 内部所有比较操作都会用这个 Comparator,完全忽略 key 自身的 compareTo()——哪怕 key 类型已经实现了 Comparable,只要传了 Comparator,就以 Comparator 为准。
Q4:TreeMap 怎么判断两个 key 相等?这和 HashMap 有什么本质区别?
A:HashMap 判断两个 key 是否相同,依据的是 hashCode() 定位桶再用 equals() 精确比较。TreeMap 完全不同:它判断两个 key 是否相等,依据的是 compareTo()(或 Comparator.compare())的返回值是否为 0,根本不会调用 equals()。这是两者最本质的区别——一个依赖哈希+判等,一个依赖比较大小。
Q5:compareTo() 和 equals() 不一致会出什么问题?
A:如果一个类的 compareTo() 判等逻辑和 equals() 不一致(比如 compareTo() 只比较某一个字段,equals() 比较全部字段),把这类对象放进 TreeMap 当 key 会出现诡异现象:两个用 equals() 判断明显不相等的对象,只要 compareTo() 返回 0,就会被 TreeMap 当成同一个 key,后插入的直接覆盖先插入的,而不是新增一条记录。JDK 文档把这种情况称为"与 equals 不一致的 Comparable",并明确建议放入有序集合的类型要避免这种设计。
Q6:TreeMap 提供哪些范围查询方法?分别怎么利用树结构做到高效?
A:firstKey()/lastKey() 沿树的最左/最右路径走到底找到最小/最大 key;floorKey(k)/ceilingKey(k) 返回小于等于/大于等于给定 key 的最接近值;lowerKey(k)/higherKey(k) 返回严格小于/严格大于给定 key 的最接近值;headMap(k)/tailMap(k)/subMap(from, to) 返回原树的一个视图,分别对应"小于给定 key""大于等于给定 key""某个区间内"的所有条目。这些操作都是 O(log n),因为可以沿着树的比较路径直接定位,不需要遍历整棵树。
Q7:TreeMap 支持 null key 吗?
A:不支持(除非传入的 Comparator 显式处理了 null)。因为插入 null 时需要调用它的 compareTo() 与其他 key 比较,null 本身没有 compareTo() 方法,直接调用会抛出 NullPointerException。这一点和 HashMap 允许一个 null key 明显不同,是两者行为差异里容易被忽略的一个细节。
Q8:headMap/tailMap/subMap 返回的是原数据的拷贝吗?
A:不是,返回的是原始 TreeMap 的一个视图。对这个视图执行插入或删除操作,会直接反映到原始 TreeMap 上(前提是插入的 key 落在这个视图的合法范围内,否则会抛出 IllegalArgumentException)。如果需要一份独立的、不影响原数据的拷贝,需要显式调用 new TreeMap<>(subMap) 做一次复制。