覆盖考点:023|HashSet 与 TreeSet:底层实现、hashCode/equals 一致性与 compareTo 陷阱
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:30 分钟(文末问答不计入)
前几篇讲透了 HashMap 和 TreeMap,这一篇要讲的 HashSet、TreeSet 看起来是两个全新的数据结构,但拆开源码会发现一个关键事实:它们并不是独立实现的,而是直接包了一层壳的 HashMap 和 TreeMap。这意味着前面几期讲过的哈希冲突、扩容、树化、红黑树排序、compareTo() 与 equals() 不一致这些细节,全部原样适用于对应的 Set 实现——只是很多人平时用 Set 只关心"能不能去重",完全没意识到这层底层依赖关系,也因此更容易在 hashCode()/equals()/compareTo() 的一致性问题上栽跟头。
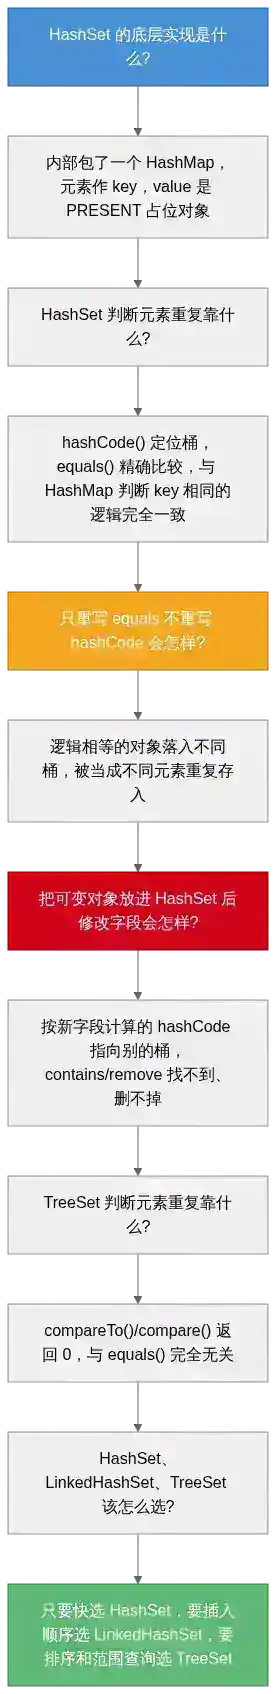
面试官在这个考点上通常这样追问:HashSet 和 TreeSet 底层到底是什么,是不是独立实现的数据结构 → HashSet 判断元素是否重复的依据是什么 → 只重写 equals() 不重写 hashCode() 会出什么问题 → 把可变对象放进 HashSet 后修改了参与哈希计算的字段会怎样 → TreeSet 判断重复的依据和 HashSet 一样吗 → HashSet、LinkedHashSet、TreeSet 三者该怎么选。本文按这条链展开。
一、为什么需要 Set:List 去重的痛点
如果只有 List,要保证元素不重复,唯一的办法是每次插入前手动遍历一次,检查 contains():
List<String> list = new ArrayList<>();
if (!list.contains(name)) {
    list.add(name);
}
这个 contains() 是 O(n) 的线性扫描。数据量一大,去重成本直接失控。Set 的价值就在这里:它把"元素是否已存在"这件事,从遍历比较变成了结构定位——用哈希或者树的比较路径直接算出/找到位置,把 O(n) 降到 O(1) 或 O(log n)。
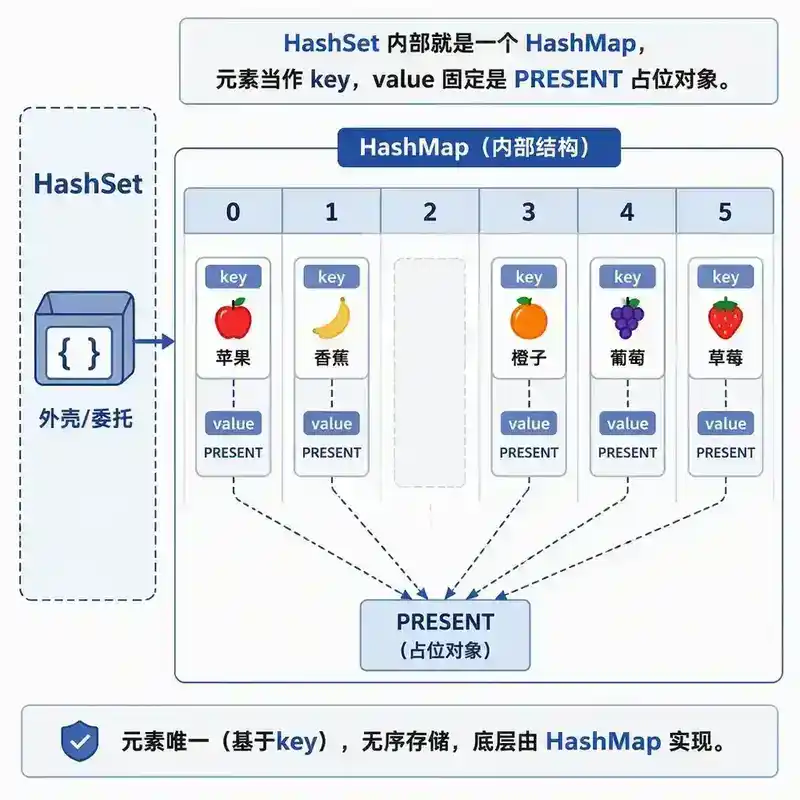
但这只是表面。往下挖一层就会发现一件更关键的事:**HashSet 和 TreeSet 根本不是独立实现的数据结构,它们是包了一层壳的 HashMap 和 TreeMap。**理解了这一点,前面几期讲过的 HashMap、TreeMap 的所有底层细节,几乎可以原样搬过来用。
二、HashSet 的底层:一个只用 key 的 HashMap
翻开 JDK 源码,HashSet 的字段只有一个:
public class HashSet<E> implements Set<E> {
    private transient HashMap<E, Object> map;
    private static final Object PRESENT = new Object();

    public boolean add(E e) {
        return map.put(e, PRESENT) == null;
    }

    public boolean contains(Object o) {
        return map.containsKey(o);
    }

    public boolean remove(Object o) {
        return map.remove(o) == PRESENT;
    }
}
add() 直接把元素塞给 HashMap.put() 当 key,value 永远是同一个占位对象 PRESENT,谁都不关心它的值,只关心这个 key 在不在。HashMap.put() 的返回值语义是"如果 key 已存在,返回旧 value;否则返回 null"——HashSet 借用这个返回值,== null 就意味着这是一次全新插入,也就是 add() 该返回 true 的时候。
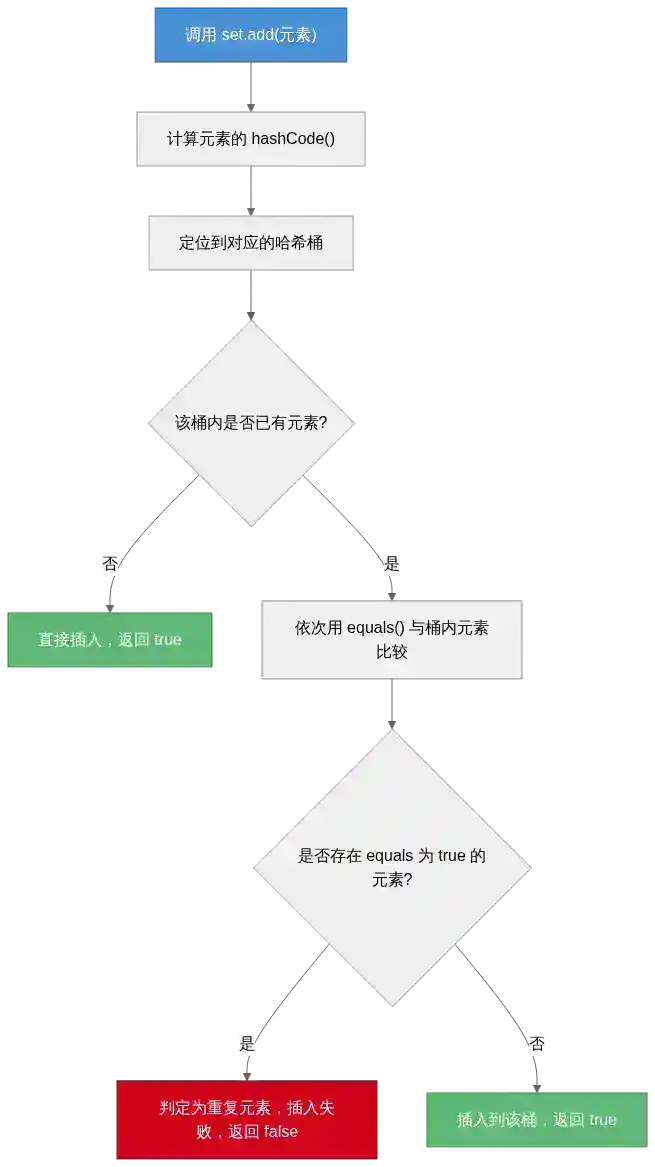
这带来一个直接推论:**HashSet**判断"元素是否重复",用的和**HashMap**判断"key 是否相同"完全一样的逻辑——先比**hashCode()**,落在同一个桶里之后再用**equals()**精确比较。 只要 hashCode() 不同,两个元素永远不会被判定为重复,无论它们的业务含义看起来多么"一样"。
这也解释了一条经典规则:自定义类型要放进**HashSet**,必须同时重写**hashCode()**和**equals()**,而且两者要遵守同一套"相等"标准。 只重写 equals() 不重写 hashCode(),会出现这样的怪事:
Set<Point> points = new HashSet<>();
points.add(new Point(1, 1));
points.add(new Point(1, 1));   // equals 认为相等,但 hashCode 默认用对象地址,不同
System.out.println(points.size()); // 输出 2,不是 1
equals() 说这两个 Point是一样的,但因为没重写 hashCode(),它们默认落在不同的桶里,HashMap 连比较 equals() 的机会都没有——两个"相等"的对象被当成两个不同的 key 存了进去。这不是 bug,是契约没遵守:JDK 明确要求"两个对象用 equals() 判断相等,hashCode() 就必须相等",反过来不要求。
三、一个更隐蔽的陷阱:可变对象改了参与哈希的字段
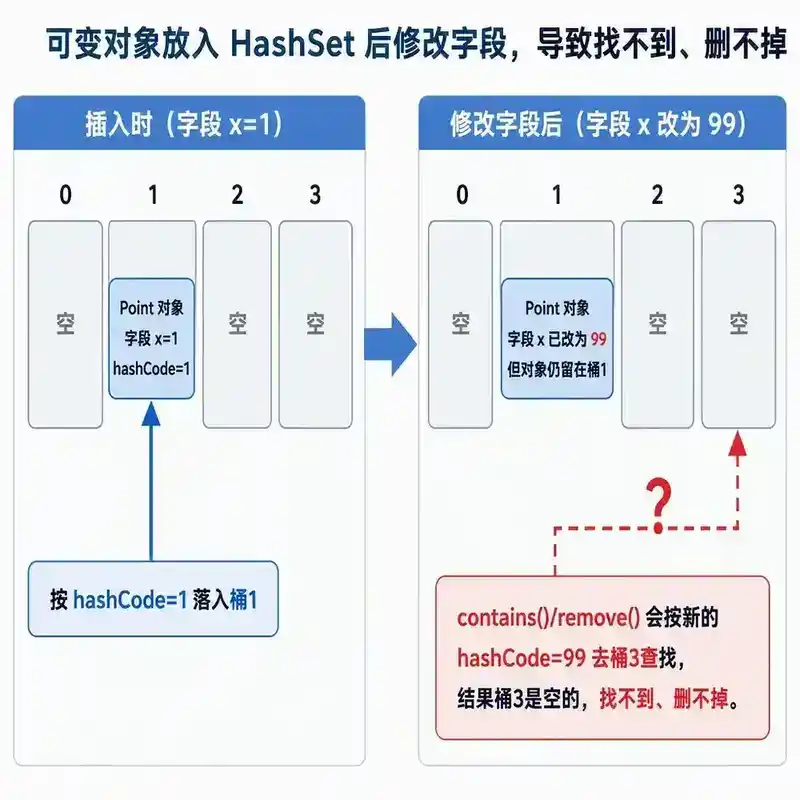
比 hashCode/equals 不一致更容易踩、也更难发现的坑是:把一个可变对象放进**HashSet**之后,又去修改它参与**hashCode()**计算的字段。
class Point {
    int x, y;
    // hashCode() 里用了 x 和 y
}

Set<Point> set = new HashSet<>();
Point p = new Point(1, 1);
set.add(p);          // 按 hashCode(1,1) 落入桶 A

p.x = 99;             // 修改了参与 hashCode 计算的字段

set.contains(p);      // 按 hashCode(99,1) 去桶 B 找,找不到!
set.remove(p);        // 同理,删不掉
对象本身还在集合里,物理上一直待在桶 A,但因为字段变了,重新计算出来的 hashCode() 指向了桶 B。之后所有基于当前对象状态的查找、删除操作,都会去错误的桶里找一个根本不存在于那里的东西——结果就是这个元素"卡"在集合里,contains() 返回 false,remove() 也删不掉,但遍历 set 又能明明白白看到它。
这就是为什么一条常见建议是:放入**HashSet**(以及作为**HashMap**的 key)的对象,最好是不可变的,或者至少不要在放入之后修改参与 hashCode() 计算的字段。
四、TreeSet 的底层:一个只用 key 的 TreeMap
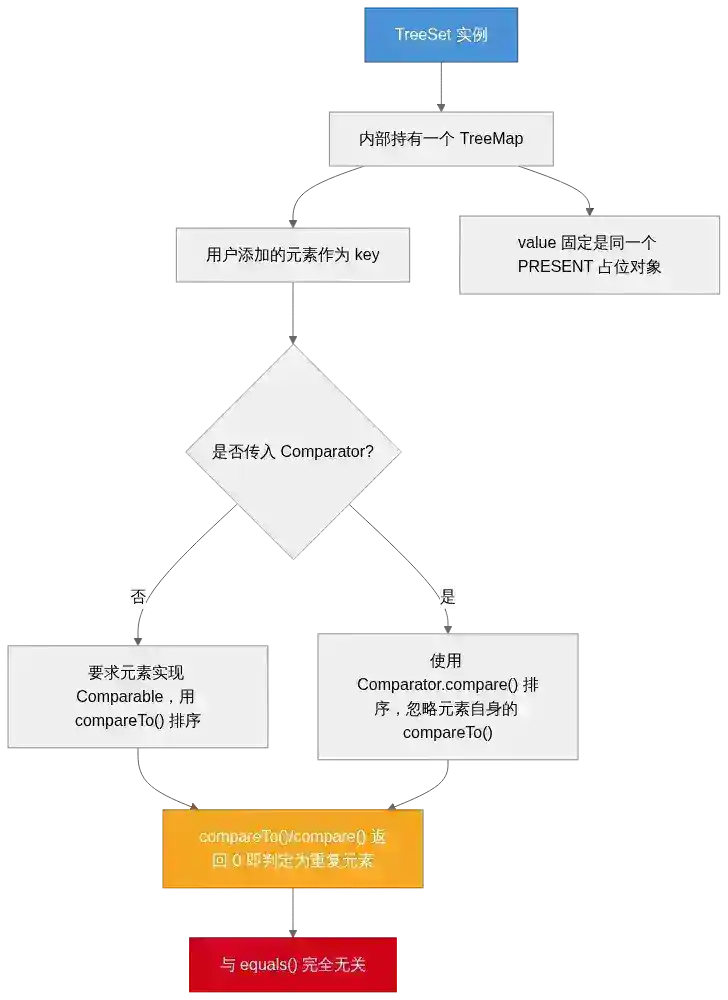
TreeSet 的套路和 HashSet 一模一样,只是壳换成了 TreeMap:
public class TreeSet<E> implements NavigableSet<E> {
    private transient NavigableMap<E, Object> m;
    private static final Object PRESENT = new Object();

    public boolean add(E e) {
        return m.put(e, PRESENT) == null;
    }
}
上一期讲过,TreeMap 判断两个 key 是否相等,靠的是 compareTo()(或 Comparator.compare())返回 0,和**equals()**完全无关。这条规则原样套用到 TreeSet:
class Person implements Comparable<Person> {
    String name;
    int age;
    public int compareTo(Person o) { return Integer.compare(this.age, o.age); } // 只比年龄
}

Set<Person> set = new TreeSet<>();
set.add(new Person("张三", 25));
set.add(new Person("李四", 25));  // age 相同,compareTo 返回 0
System.out.println(set.size());   // 输出 1,李四被"去重"掉了
两个人姓名完全不同,equals() 判断显然不相等,但因为 compareTo() 只比较年龄、返回了 0,TreeSet 就认定这是"重复元素",第二次 add() 直接被吞掉,返回 false。这不是异常,是 TreeSet(和 TreeMap)的设计契约本身——JDK 文档把这种 compareTo() 与 equals() 不一致的类型专门点名警告过。
另一个常见的翻车点:往 TreeSet 里放没有实现 Comparable 的自定义类型,且没有传 Comparator,插入时会直接抛 ClassCastException——因为 TreeSet 必须靠比较来决定元素放在树的哪个位置,没有比较依据,它没法工作。
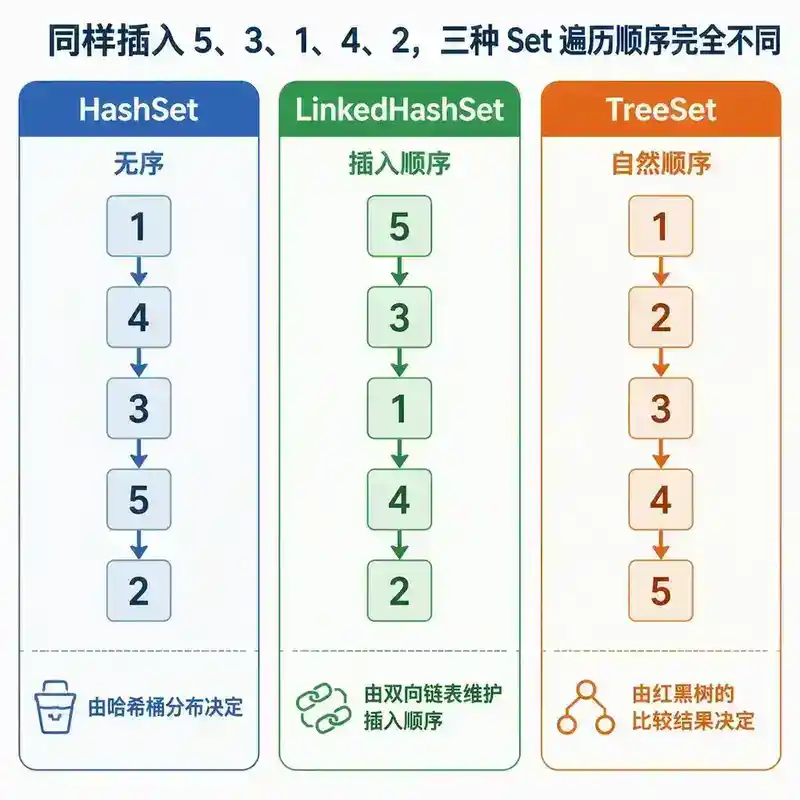
五、三者对比:HashSet / LinkedHashSet / TreeSet
| 底层结构 | 遍历顺序 | 相等性依据 | 允许 null | 查找/插入复杂度 | |
|---|---|---|---|---|---|
| HashSet | HashMap | 无序(取决于哈希桶分布) | hashCode + equals | 允许一个 null | O(1) |
| LinkedHashSet | HashMap + 双向链表 | 插入顺序 | hashCode + equals | 允许一个 null | O(1) |
| TreeSet | TreeMap(红黑树) | key 的自然顺序/Comparator 顺序 | compareTo/compare | 不允许(除非 Comparator 处理 null) | O(log n) |
LinkedHashSet 继承自 HashSet,只是内部换成了带双向链表的 LinkedHashMap——这也是为什么它能保持插入顺序,同时保留 O(1) 的查找效率。三者的选择原则很直接:不关心顺序、只要快,选 HashSet;要保留插入顺序,选 LinkedHashSet;要一直保持排序状态、还要做范围查询,选 TreeSet。
六、去重发生在什么时候
一个容易被忽略但很本质的问题:去重是在**add()**调用的那一刻发生的,不是在遍历或输出的时候才做的。Set 从头到尾都不存在重复元素这种中间状态——每一次 add(),都会先完整走一遍"定位 + 比较"的流程,判定为已存在就直接拒绝,判定为不存在才真正插入。这也是为什么 Set 的 add() 返回值是 boolean,而不是像 List.add() 那样恒为 true——返回值本身就在告诉你"这次插入是不是被去重逻辑拦下了"。
七、常见误区
- 以为
**HashSet**是独立实现的数据结构。 它就是一个HashMap<E, Object>,所有关于HashMap的哈希冲突、扩容、树化细节全部适用。 - 只重写
**equals()**,不重写**hashCode()**。 会导致逻辑相等的对象被当成不同元素重复存入,参见第二节。 - 放入可变对象后修改了参与哈希计算的字段。 会导致元素"名义上还在集合里,但找不到也删不掉",参见第三节。
- 认为
**TreeSet**的去重依据是**equals()**。 实际依据是compareTo()/compare(),两者不一致时会发生非预期的"去重",参见第四节。 - 往
**TreeSet**放没实现**Comparable**的类型又不给**Comparator**。 插入即抛ClassCastException。 - 以为
**Set**完全不允许 null。HashSet/LinkedHashSet允许一个 null 元素(因为底层HashMap允许一个 null key),TreeSet默认不允许。
八、面试追问链
延伸阅读
HashSet/TreeSet源码(JDKjava.util包)- 上一期:《TreeMap 与红黑树:排序不是遍历时才做的事》
- 《Effective Java》条目 11:覆盖 equals 时总要覆盖 hashCode
问答(不计入阅读时长)
Q1:HashSet 的底层到底是什么?
A:HashSet 不是独立实现的数据结构,它内部就是一个 HashMap<E, Object>。用户添加的元素被当作这个 HashMap 的 key,value 固定是同一个占位对象 PRESENT,谁都不关心它的值。add() 方法直接调用 map.put(e, PRESENT),利用 put() 的返回值(key 已存在返回旧 value,否则返回 null)来判断这次插入是否成功。
Q2:HashSet 判断两个元素是否重复,依据是什么?
A:和 HashMap 判断 key 是否相同完全一致的逻辑——先计算元素的 hashCode() 定位到哈希桶,落在同一个桶里之后再用 equals() 逐个精确比较。只要 hashCode() 不同,两个元素无论业务上多么"相同",都不会被判定为重复。
Q3:为什么自定义类型放进 HashSet,只重写 equals() 不重写 hashCode() 会出问题?
A:因为定位桶靠的是 hashCode(),不是 equals()。如果两个对象 equals() 判断相等,但默认的 hashCode()(通常基于对象内存地址)不同,它们会落入不同的桶,HashMap 根本没有机会调用 equals() 去比较,于是两个"相等"的对象会被当成两个不同元素同时存入。JDK 的契约是:equals 相等则 hashCode 必须相等,反过来不要求。
Q4:把可变对象放进 HashSet 后,又修改了它参与 hashCode 计算的字段,会发生什么?
A:对象在物理上仍然待在插入时计算出的那个桶里,但之后所有 contains()、remove() 调用都会用当前字段值重新计算 hashCode(),得到一个新的桶位置去查找。新桶里根本没有这个对象,于是表现为"明明遍历能看到它,却找不到、也删不掉"。这也是为什么放入 HashSet(或作为 HashMap 的 key)的对象最好是不可变的。
Q5:TreeSet 的底层是什么?它判断元素重复的依据和 HashSet 一样吗?
A:TreeSet 内部持有一个 TreeMap<E, Object>,元素同样是 key,value 固定是 PRESENT。但判断重复的依据完全不同:TreeSet 靠 compareTo()(或传入的 Comparator.compare())的返回值是否为 0,跟 equals() 没有任何关系。这意味着两个 equals() 明显不相等的对象,只要 compareTo() 返回 0,第二个就会被当成"重复元素"直接丢弃。
Q6:往 TreeSet 里放一个没实现 Comparable 的类型,又没传 Comparator,会怎样?
A:插入时直接抛出 ClassCastException。因为 TreeSet 必须靠比较结果来确定元素在树中的位置,没有 Comparable 也没有 Comparator,它没有任何依据完成这次比较。
Q7:HashSet、LinkedHashSet、TreeSet 三者的遍历顺序和适用场景有什么区别?
A:HashSet 遍历顺序由哈希桶分布决定,基本无序,但插入/查找是 O(1),最快;LinkedHashSet 在 HashSet 基础上用双向链表维护插入顺序,遍历结果就是插入顺序,代价和 HashSet 接近;TreeSet 底层是红黑树,始终保持元素按自然顺序或指定 Comparator 排好序,还能做范围查询(如 floor/ceiling/subSet),但复杂度是 O(log n)。选择原则:不关心顺序选 HashSet,要保留插入顺序选 LinkedHashSet,要一直有序或要范围查询选 TreeSet。
Q8:这三种 Set 都允许存 null 元素吗?
A:不一样。HashSet 和 LinkedHashSet 允许存一个 null 元素,因为它们底层的 HashMap/LinkedHashMap 本身允许一个 null key。TreeSet 默认不允许 null,因为插入时需要调用 compareTo() 跟树中已有元素比较,null 没有这个方法,直接调用会抛出 NullPointerException(除非传入的 Comparator 显式处理了 null 的情况)。