覆盖考点:030|Stream API:惰性计算、并行流与 Collector 三要素
适合读者:高级 Java 工程师、技术专家、架构师候选人
预计阅读时长:26 分钟(文末问答不计入)
上一篇讲的 Lambda 表达式,是让"行为"能作为参数传递的语言机制;这一篇要讲的 Stream API,是建立在 Lambda 之上、专门用来描述"数据处理流程"的声明式框架。很多人把 Stream 当成"更好看的 for 循环",但它真正的价值在于把过滤、转换、统计这些步骤变成一条惰性求值的流水线——终结操作触发之前,什么都不会真正执行。这篇要讲清楚这条流水线背后的三件事:惰性计算的真实执行模型、并行流什么时候该用什么时候会翻车,以及 Collector 到底是怎么把流变成集合的。
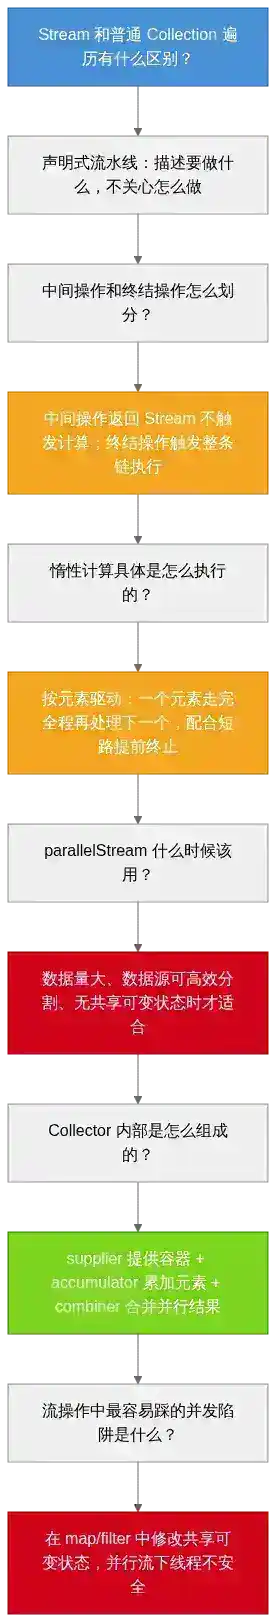
面试官在这个考点上通常这样追问:中间操作和终结操作有什么区别 → 为什么写了一长串 filter().map().peek() 却什么都没打印 → Stream 的惰性计算具体是怎么执行的,短路操作是怎么提前结束的 → 并行流的底层机制是什么,什么场景下用它反而更慢 → Collector 由哪几个组件构成,groupingBy 内部到底做了什么 → 一个 Stream 能不能被使用两次。本文按这条链展开。
一、Stream 到底解决了什么问题
在 Stream 出现之前,处理集合基本靠 for 循环加一堆临时变量:过滤、转换、统计,每一步都要手写循环体,代码里全是"怎么做"的细节,"要做什么"反而被淹没了。
List<String> names = new ArrayList<>();
for (Employee e : employees) {
    if (e.getAge() > 30) {
        names.add(e.getName());
    }
}
用 Stream 改写:
List<String> names = employees.stream()
    .filter(e -> e.getAge() > 30)
    .map(Employee::getName)
    .collect(Collectors.toList());
表面上看是链式调用更简洁,但真正的价值不在"少写代码",而在于 Stream 把"数据处理流程"描述成了一条声明式的流水线——你只管描述每一步要做什么,具体怎么执行、要不要并行、要不要提前终止,都交给 Stream 框架决定。这篇要讲清楚这条流水线背后的三件事:惰性计算、并行流、Collector 机制,以及每一个都容易踩的坑。
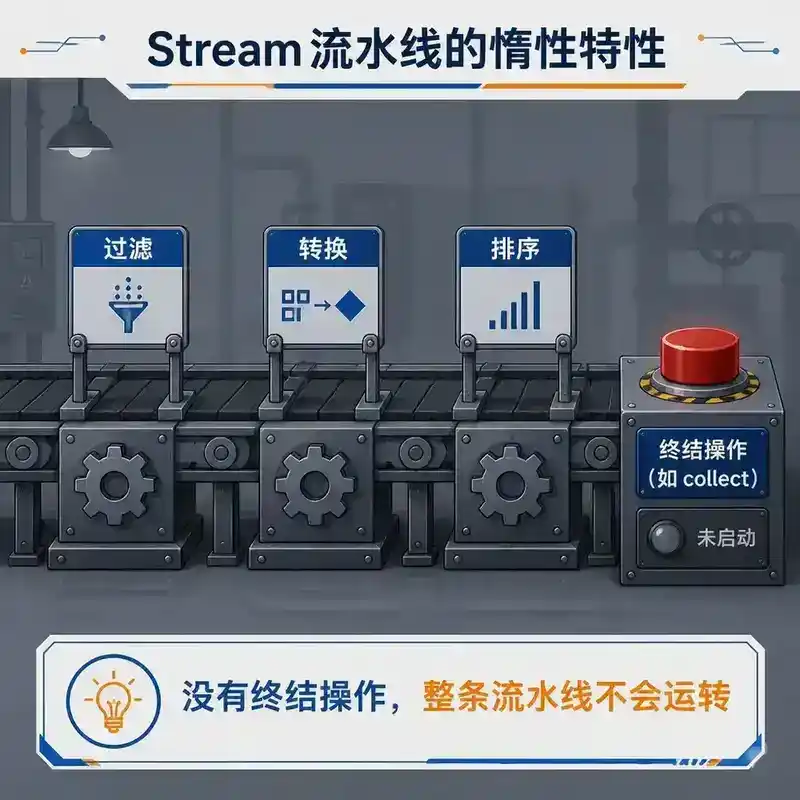
二、中间操作与终结操作:Stream 的两种角色
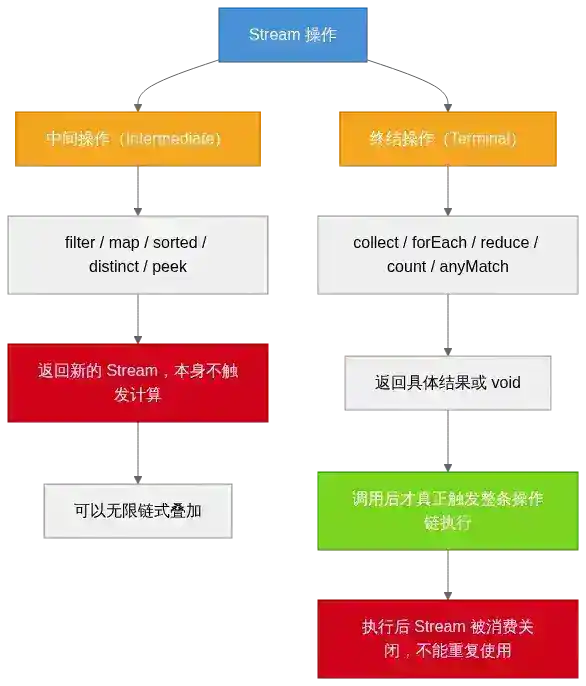
Stream 上的方法分成两类,区分它们是理解一切的前提:
- 中间操作(intermediate operation):如
filter、map、sorted、distinct、peek。这些方法的返回值仍然是一个Stream,本身不会触发任何实际计算,只是把"要做的事"记录到操作链里,然后返回一个新的 Stream 描述对象,可以继续链下去。 - 终结操作(terminal operation):如
collect、forEach、reduce、count、anyMatch、findFirst。这些方法的返回值不是 Stream(是具体的值、集合,或者void),调用它们才会真正触发整条操作链从头到尾执行一遍。一个 Stream 只能有一个终结操作,用过一次就"关闭"了,不能重复使用。
Stream<Employee> s = employees.stream().filter(e -> e.getAge() > 30); // 什么都没发生
List<String> result = s.map(Employee::getName).collect(Collectors.toList()); // 这里才真正执行
三、惰性计算:不是"延迟一点点",是"按需驱动"
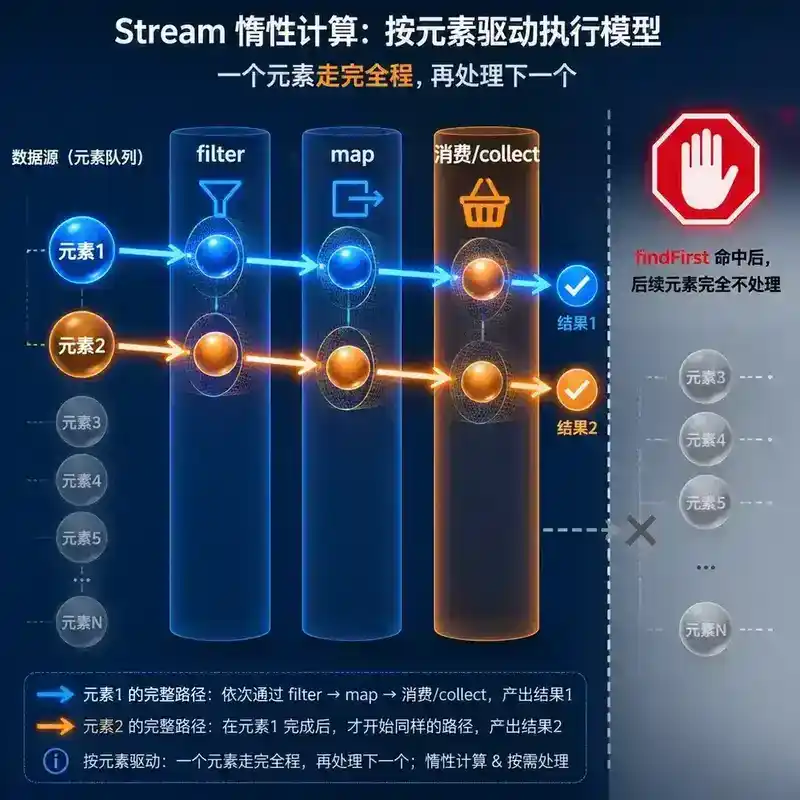
很多人把惰性计算理解成"中间操作先攒起来,最后统一批量跑一遍",这只对了一半。Stream 真正的执行模型是按元素驱动、逐个走完整条链:终结操作触发后,Stream 会一次取一个元素,让这个元素依次经过 filter、map 等每一个中间操作,直到被消费或者被过滤掉,然后再取下一个元素——而不是先让所有元素都跑完 filter,再统一跑 map。
这个模型带来一个重要的性能特性:短路操作可以让整条链提前结束,不需要处理完全部数据。
Optional<String> first = employees.stream()
    .filter(e -> e.getAge() > 30)
    .map(Employee::getName)
    .findFirst(); // 找到第一个满足条件的就立刻停止,后面的元素完全不会被处理
如果 employees 有一百万条数据,但满足条件的第一个元素排在第 10 位,findFirst 会让整条链只跑 10 次,剩下的 99 万多条数据根本不会进入 filter 和 map。这在 for 循环里当然也能用 break 实现,但 Stream 的声明式写法让这种"按需计算、提前终止"的行为变成了框架自动提供的能力,不需要手写控制流。
需要特别注意的一个陷阱:如果一个 Stream 从未调用终结操作,它上面挂的所有中间操作、包括**peek**里的打印语句,全部都不会执行——这是新手最容易踩的坑,写了一长串 filter().map().peek(System.out::println),忘了加 .collect(...) 或 .forEach(...),结果程序什么都没打印,因为整条链根本没有被"启动"过。
四、并行流:什么时候该用,什么时候会翻车
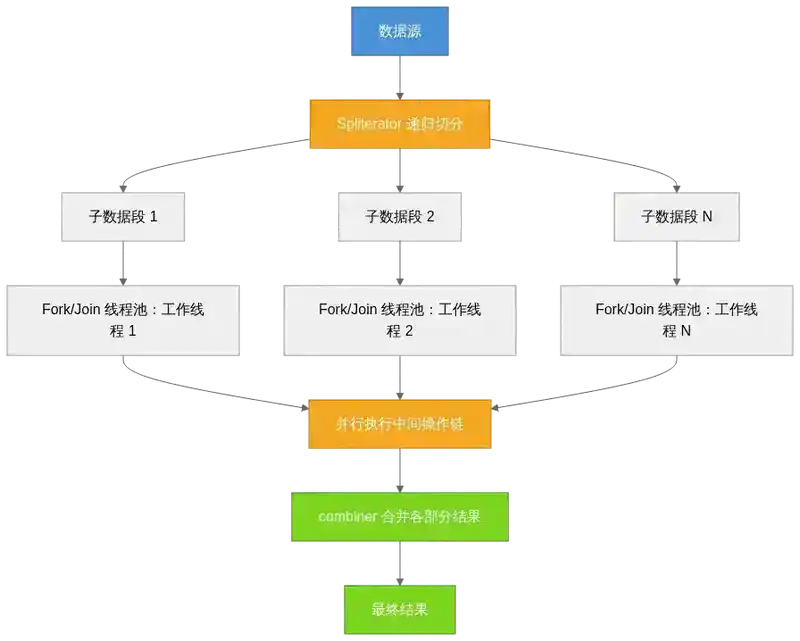
把 .stream() 换成 .parallelStream()(或者在已有 Stream 上调用 .parallel()),Stream 会尝试用多个线程并行处理数据。它的底层机制是:先用 Spliterator 把数据源递归地切分成多个子部分,再交给 Fork/Join 框架的线程池并行处理每个子部分,最后把各部分的结果合并起来。
long count = hugeList.parallelStream()
    .filter(e -> isExpensive(e))
    .count();
但并行流不是"无脑加速器",用错场景反而会更慢或者出错:
- 数据量太小时,线程调度和结果合并的开销比串行处理本身还大——几十上百条数据用并行流,基本是负优化。
- 数据源如果不支持高效分割(比如
LinkedList,只能从头遍历,没法快速定位中间位置),Spliterator切分效率很差,并行反而拖慢速度;相对地,ArrayList、数组这类支持随机访问的数据结构分割效率高,更适合并行。 - 有序敏感的操作(比如
forEach里依赖处理顺序、或者limit/skip依赖元素顺序)在并行流下,结果的产生顺序是不确定的,除非显式用forEachOrdered,否则不要假设处理顺序和数据原始顺序一致。 - 对共享可变状态做非线程安全的操作是最危险的坑:如果在
parallelStream().forEach(e -> list.add(e.getName()))里往一个普通ArrayList塞数据,多线程并发写入非线程安全的集合,会导致数据丢失甚至抛异常。并行流的每一步操作本身要保证无副作用、线程安全,才能安全并行。
五、Collector:到底是怎么把流变成集合的
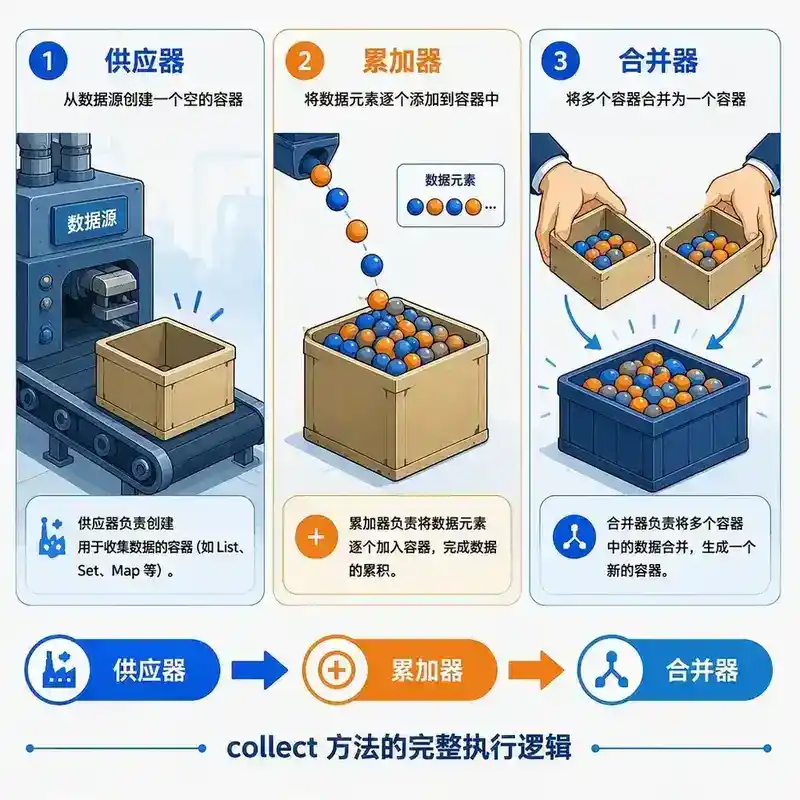
collect(Collectors.toList()) 看起来是一个黑盒方法,但它背后的机制其实很规整——任何一个 Collector 都由三个核心组件构成:
- supplier:提供一个新的、空的结果容器(比如
new ArrayList<>())。 - accumulator:定义"如何把一个元素塞进这个容器"的逻辑(比如
list.add(element))。 - combiner:定义"两个部分结果容器如何合并成一个"的逻辑(比如
list1.addAll(list2))——这一步只有在并行流场景下才会真正被用到,串行流不需要合并。
Map<Department, List<Employee>> byDept = employees.stream()
    .collect(Collectors.groupingBy(Employee::getDepartment));
groupingBy 内部就是用一个 Map 作为容器(supplier),对每个元素按分组键找到对应的 List 再 add 进去(accumulator),并行场景下再把多个线程各自产生的 Map 合并起来(combiner)。理解了这三要素,看到任何自定义 Collector.of(supplier, accumulator, combiner) 的写法就不会觉得陌生。
六、常见陷阱与误区
- 在
**map**、**filter**里写有副作用的代码。 中间操作的 Lambda 应该是无副作用的纯函数,如果在map里修改外部共享变量,串行流可能表现正常,一旦切换成并行流,多线程同时修改同一个变量会导致结果不确定,这类 bug 往往只在并行场景下才暴露。 **peek**被当作调试打印的"安全"手段。peek本质上也是中间操作,同样遵守惰性计算规则——如果流没有终结操作,peek里的打印语句根本不会执行;另外peek设计的初衷是用于调试观察,不建议在peek里写有业务意义的副作用逻辑。- 对一个 Stream 调用两次终结操作。 Stream 是一次性的,用过一次终结操作后再次调用任何操作会抛出
IllegalStateException: stream has already been operated upon or closed,需要重新从数据源生成一个新的 Stream。 - 认为并行流一定比串行流快。 具体是否更快取决于数据量、数据结构、每个元素处理的计算成本、以及是否存在共享状态竞争,没有测过就默认用并行流,很可能是负优化。
- 无限流忘记加
**limit**。Stream.iterate(0, i -> i + 1)生成的是无限流,如果后面忘了limit(n)又调用了collect这种非短路终结操作,程序会一直跑下去直到内存耗尽或者卡死。
七、面试追问链
延伸阅读
- 《Java 8 实战》第 4-6 章关于 Stream 与 Collector 的详解
java.util.stream.Collector接口源码,理解supplier/accumulator/combiner/characteristics四个方法- 上一期:《Lambda 表达式:语法糖只是表象,真正的机制是编译器帮你造了一个类》
问答(不计入阅读时长)
Q1:为什么写了一长串**.filter().map().peek(System.out::println)**,程序运行后什么都没打印?
A:因为这条链上全部都是中间操作,中间操作只是把"要做的事"记录到操作链里,本身不会触发任何实际计算。如果链的末尾没有调用 collect、forEach、count 这类终结操作,整条流水线就从未被"启动"过,包括 peek 里的打印语句也不会执行。只要补上一个终结操作,之前记录的所有操作才会真正跑一遍。
Q2:**findFirst()**为什么可能比手写**for**循环加**break**更快,还是差不多?
A:性能上两者本质接近,都是找到第一个满足条件的元素就提前停止,不处理剩下的数据——这正是 Stream 惰性计算模型里"按元素驱动、支持短路"带来的能力。区别主要在写法上:for + break 需要手写控制流,findFirst 把这个能力做成了声明式的框架行为,可读性更好,性能上不会比手写循环差太多。
Q3:一个 Stream 用过**collect**之后,还能再对它调用**forEach**吗?
A:不能。Stream 是一次性的,一旦调用过一次终结操作(比如 collect),这个 Stream 就被视为已经"关闭",再对它调用任何操作都会抛出 IllegalStateException: stream has already been operated upon or closed。如果需要重新遍历,必须从原始数据源重新生成一个新的 Stream(比如再调用一次 list.stream())。
Q4:**LinkedList.stream().parallel()**为什么并行效果通常不好?
A:因为并行流依赖 Spliterator 把数据源切分成多个子部分交给不同线程处理,而 LinkedList 只能从头开始逐个遍历,没法快速定位到中间位置,切分效率很差;相比之下 ArrayList 或数组支持通过下标直接随机访问,切分成本很低。数据源本身是否易于高效分割,直接决定了并行流能不能真正发挥并行的优势。
Q5:**parallelStream().forEach(e -> resultList.add(e))**这段代码有什么问题?
A:resultList 如果是普通的 ArrayList,不是线程安全的集合,而 parallelStream 下的 forEach 会有多个线程同时执行这段 Lambda,多线程并发调用非线程安全的 add 方法,会导致数据丢失、越界异常甚至死循环等不可预期的问题。正确做法是用 collect(Collectors.toList()) 让框架通过 Collector 的三要素机制安全地收集结果,而不是在 forEach 里手动写有副作用的收集逻辑。
Q6:**Collectors.groupingBy**内部到底做了什么,为什么能直接分组?
A:groupingBy 本质上就是一个预先配置好的 Collector:它的 supplier 提供一个空的 Map 作为容器;accumulator 对流里的每个元素,根据你传入的分类函数算出分组键,找到 Map 里对应键的 List(如果没有就新建一个),再把元素加进去;combiner 则是在并行流场景下,把多个线程各自产生的 Map 按键合并起来。理解了这三个组件的分工,groupingBy 就不再是一个黑盒方法。
Q7:什么时候应该优先用并行流,什么时候不该用?
A:数据量足够大(能覆盖线程调度和合并的开销)、数据源支持高效分割(比如 ArrayList、数组)、每个元素的处理逻辑本身计算量较大、并且流水线上的操作没有共享可变状态时,并行流才有意义;反之,数据量小、数据源是链表类结构、或者操作里有依赖顺序、依赖共享状态的逻辑,用并行流很可能是负优化,甚至引入线程安全问题,这种情况老老实实用串行流更稳妥。
Q8:**Stream.iterate(0, i -> i + 1)**这种无限流,为什么有时候程序会一直卡住?
A:因为 iterate 生成的是一个没有边界的无限流,如果后面直接跟一个非短路的终结操作(比如 collect 或 count,注意 count 在某些实现下对无限流也无法优化提前返回),Stream 会不断尝试生成下一个元素,永远不会自然结束,最终耗尽内存或者看起来像是卡死了。正确用法是配合 limit(n) 这样的中间操作先截取一段有限长度,再进行后续的终结操作。