一、JVM 调优不是"调参数",而是"解决问题"
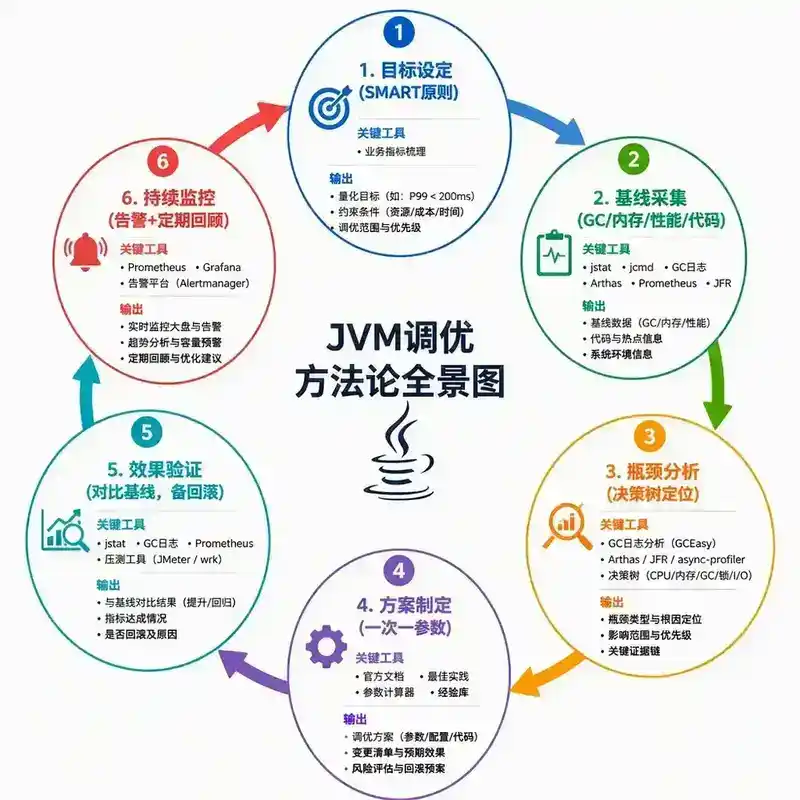
很多工程师对 JVM 调优的理解停留在"改几个参数然后重启"的层面。真正的 JVM 调优是一个闭环工程:明确目标 -> 采集基线 -> 分析瓶颈 -> 制定方案 -> 调整参数 -> 验证效果 -> 持续监控。缺少任何一个环节,调优就可能变成"瞎调"——参数改了,问题没解决,或者解决了旧问题引入了新问题。
本文是 04 JVM 原理与调优分类的收官篇,将前面 19 篇文章的知识串联起来,提供一个可复用的调优框架。无论你面对的是 GC 问题、内存问题还是性能问题,这套方法论都能帮你系统化地找到解决方案。
二、第一步:设定可量化的调优目标
2.1 什么是"好"的 JVM 性能
没有绝对的好,只有"满足业务需求"的好。在开始调优之前,你需要明确回答三个问题:
问题 1:当前的实际问题是什么?
不要用"性能不好"这种模糊描述。要具体到可量化的指标:
- "用户反馈下单接口偶尔需要 5 秒才响应" -> 目标:P99 响应时间 < 500ms
- "凌晨 2 点服务 OOM 重启" -> 目标:堆使用率稳定在 70% 以下,无 OOM
- "GC 日志显示 Full GC 每小时 3 次" -> 目标:Full GC 频率 < 每天 1 次
- "服务启动需要 3 分钟" -> 目标:启动时间 < 60 秒
问题 2:业务 SLA 是什么?
不同的业务场景对 JVM 的要求完全不同:
- 在线交易系统:P99 延迟 < 100ms,必须低延迟收集器(ZGC/Shenandoah/G1)
- 后台批处理:吞吐量 > 95%,可以用高吞吐收集器(Parallel GC)
- 实时计算:延迟 < 10ms,需要 ZGC 或 Shenandoah
- 微服务容器化:内存占用 < 2GB,需要精细控制堆大小和 Metaspace
问题 3:当前的瓶颈在哪?
不要先入为主地认为"GC 有问题"。瓶颈可能是:
- GC 暂停时间过长 -> 收集器选型或参数问题
- 线程竞争严重 -> 锁优化或线程池配置问题
- 内存分配速率过高 -> 代码层面对象创建过多
- 数据库/网络 I/O 慢 -> 不是 JVM 层面的问题
2.2 目标设定的 SMART 原则
- Specific(具体):不是"减少 GC 暂停",而是"GC P99 暂停时间 < 50ms"
- Measurable(可量化):能用 jstat、GC 日志、APM 工具直接测量
- Achievable(可实现):结合硬件资源和收集器能力设定合理目标
- Relevant(相关性):目标直接解决用户的痛点
- Time-bound(有时限):设定观察周期,比如"压测 30 分钟稳定达标"
三、第二步:采集基线数据
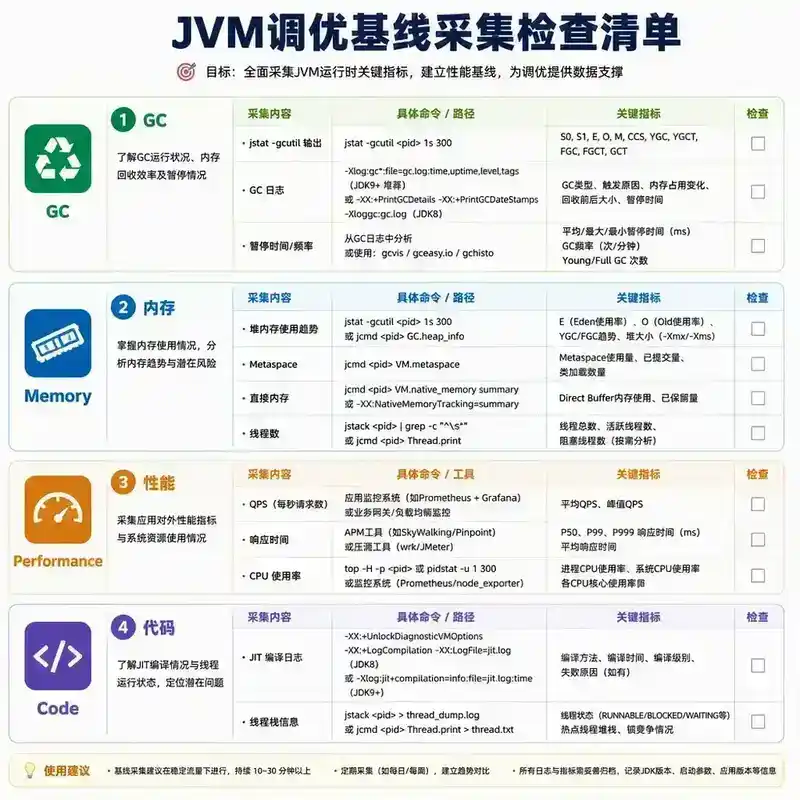
基线(Baseline)是调优前系统在正常负载下的性能数据。没有基线,你无法判断调优是否有效。
需要采集四个维度的基线数据:
- GC 相关:jstat -gcutil 输出、GC 日志、暂停时间/频率/持续时间、各代使用率趋势
- 内存相关:堆使用率、Metaspace 使用率、直接内存使用量(NMT)、线程数
- 性能相关:接口 QPS 和响应时间(P50/P99/P999)、CPU 使用率
- 代码相关:JIT 编译日志(-XX:+PrintCompilation)、线程栈(jstack)
采集最佳实践:在正常业务负载下采集至少 30 分钟,记录采集时的环境信息(JVM 版本、GC 收集器、堆大小),将基线数据存档便于后续对比。
[图1:JVM调优基线采集检查清单——GC/内存/性能/代码四个维度需要采集的指标和命令]
四、第三步:分析瓶颈
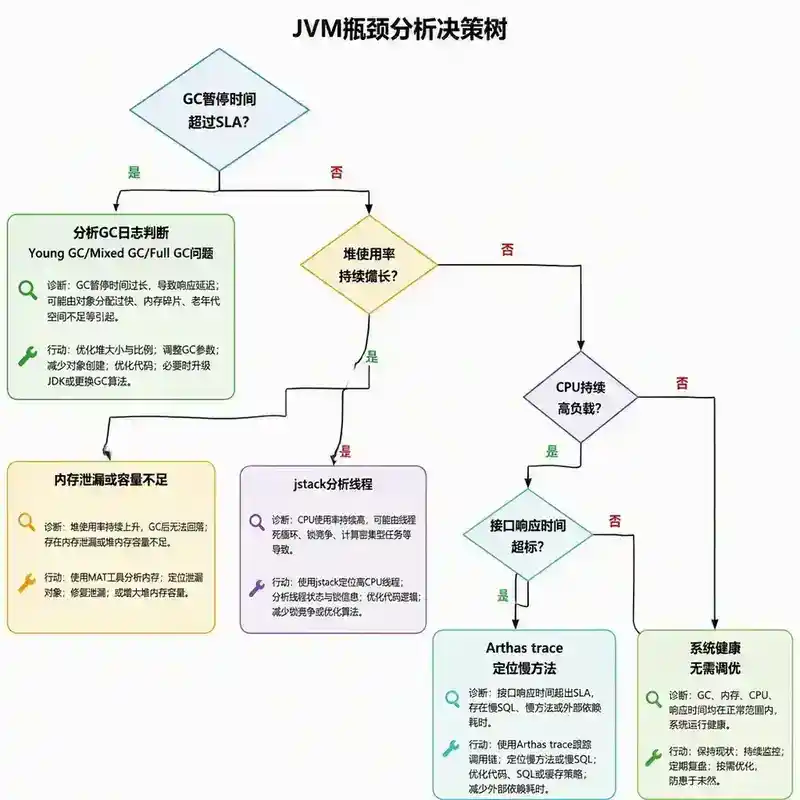
拿到基线数据后,按以下顺序分析:
GC 暂停时间是否超过 SLA?是 -> 分析 GC 日志,判断是 Young GC 还是 Mixed/Full GC 导致。Young GC 频繁 -> Eden 太小或分配速率高。Mixed GC 回收不佳 -> 晋升速率高。Full GC 频发 -> 内存泄漏、碎片化、并发模式失败。
堆使用率是否持续增长?是 -> 内存泄漏(dump 分析)或容量不足。否 -> 继续。
CPU 是否持续高负载?是 -> jstack 分析线程,判断是业务计算还是 GC 线程。否 -> 继续。
接口响应时间是否超过 SLA?是 -> 用 Arthas trace 定位慢方法。否 -> 系统健康,不需要调优。
瓶颈优先级:1. 导致服务不可用的问题(OOM、频繁 Full GC)。2. 违反 SLA 的问题(P99 延迟超标)。3. 影响用户体验但未超标的问题。4. 优化空间有限的微调。
[图2:JVM瓶颈分析决策树——从GC暂停时间->堆使用率->CPU->响应时间,每个分支标注判断标准]
五、第四步:制定调优方案
先代码,后参数。很多性能问题本质上是代码问题,调参数只是"治标"。
常见问题的调优方案:
Young GC 频繁:增大年轻代(-Xmn 或 -XX:NewRatio)、减少对象分配速率(代码优化)、调大 SurvivorRatio 让 Eden 更大。
Mixed GC 回收不佳(G1):降低 G1MixedGCLiveThresholdPercent(默认 85%,可降到 65%)、增加 G1MixedGCCountTarget(默认 8,可增加到 16)、降低 G1HeapWastePercent(默认 5%)。
Full GC 频发:内存泄漏 -> dump 分析 + 修复代码。碎片化 -> 增大 G1HeapRegionSize 减少 Humongous Object 数量。CMS Concurrent Mode Failure -> 降低 CMSInitiatingOccupancyFraction。容量不足 -> 增大堆。
启动慢:降低编译阈值、减少编译线程数、考虑 AOT 编译或 GraalVM Native Image。
一次只改一个参数——这是调优最重要的原则。如果一次改了三个参数,你不知道哪个参数起了作用、哪个参数带来了副作用。
六、第五步:验证效果
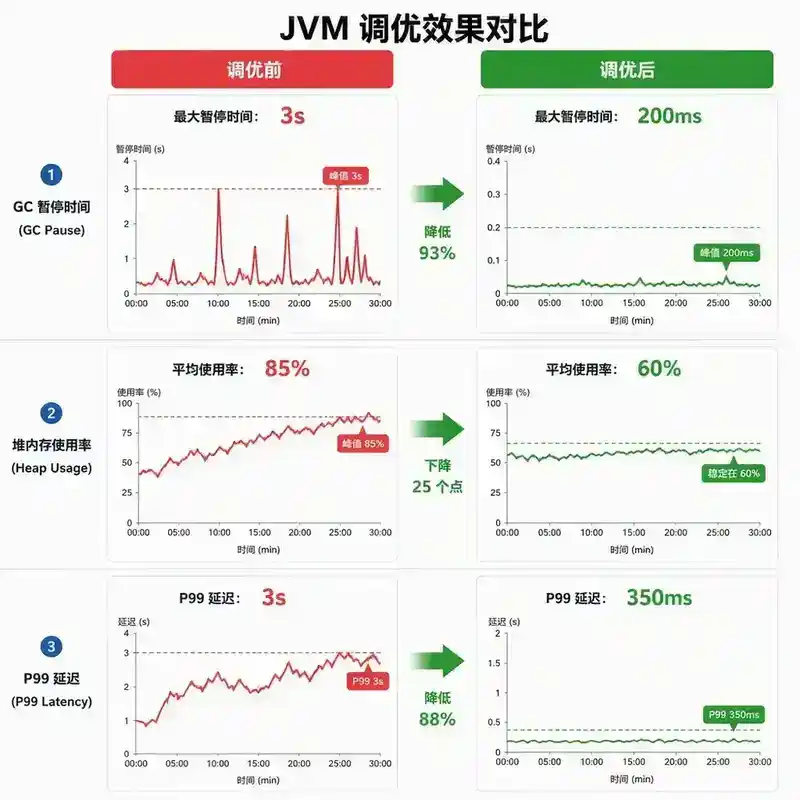
调优后,在相同负载下重新采集基线数据,与调优前对比。观察足够长的时间(至少 30 分钟,最好覆盖一个业务高峰周期),对比同样的负载,关注副作用(增大年轻代减少了 Young GC 频率,但每次暂停时间可能变长)。
每次调优前必须准备好回滚方案:记录当前的所有 JVM 参数,确保可以通过重启或配置变更快速回滚,设定明确的回滚触发条件(如"GC 暂停时间超过 500ms 连续 3 次")。
[图3:调优效果验证对比图——调优前后GC暂停时间、堆使用率、接口响应时间对比]
七、第六步:持续监控与迭代
调优不是一次性的工作。业务增长、代码变更、流量变化都会影响 JVM 的表现。建立持续监控机制:GC 日志持续采集(保留至少 7 天)、关键指标告警(Full GC 频率、GC 暂停时间、堆使用率)、定期回顾 GC 日志、每次重大版本发布后对比 GC 行为。
[图6:JVM调优方法论全景图——目标设定->基线采集->瓶颈分析->方案制定->效果验证->持续监控的闭环]
八、完整的调优案例
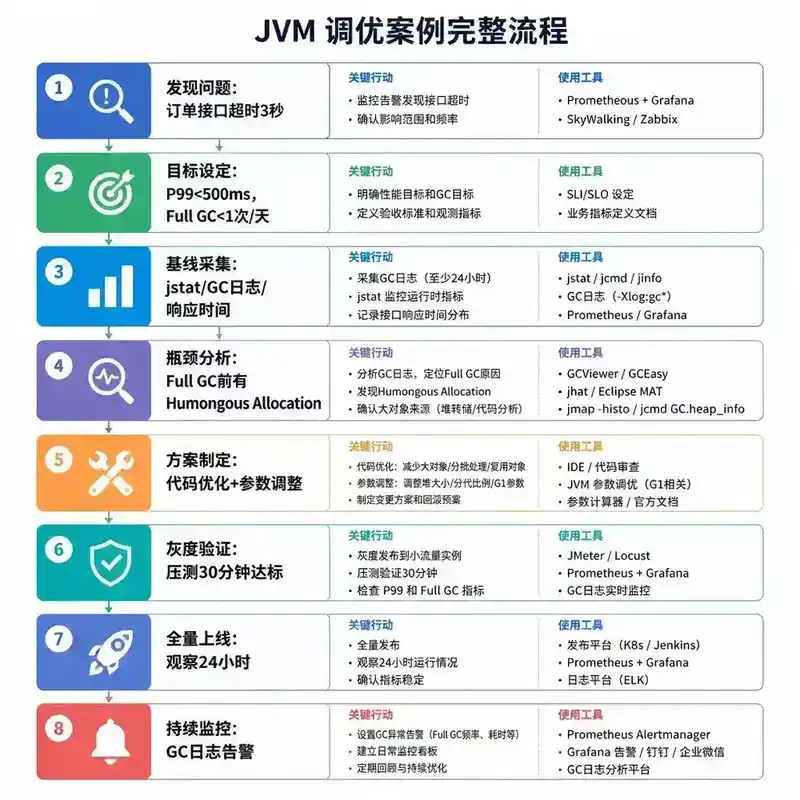
背景:订单服务,日均 QPS 5000,使用 G1,堆 4GB。用户反馈下单接口偶尔超时(3 秒+)。
目标:P99 响应时间 < 500ms,Full GC 频率 < 每天 1 次。
基线:jstat 显示 Young GC 每 3 秒一次,暂停 15-30ms。Mixed GC 每 5 分钟一次,暂停 40-150ms,偶尔 800ms。Full GC 每天 2-3 次,暂停 1.5-3 秒。GC 日志中 Full GC 前有 Humongous Allocation 标记。
瓶颈:Full GC 前的大量 Humongous Allocation 表明订单处理中创建了大对象。Mixed GC 偶尔 800ms 说明回收效率不稳定。
方案:1. 代码层面:将一次性加载全量数据改为分页加载。2. 参数层面:调大 G1HeapRegionSize 从 4MB 到 8MB。3. 参数层面:降低 IHOP 从 45% 到 35%。
验证:压测 30 分钟,Full GC 消失,Mixed GC 最大暂停降到 200ms,P99 响应时间降到 350ms。
上线:灰度发布,观察 24 小时,确认无异常后全量发布。
[图4:调优案例完整流程图——从发现问题到全量上线的完整步骤]
九、JVM 参数速查表
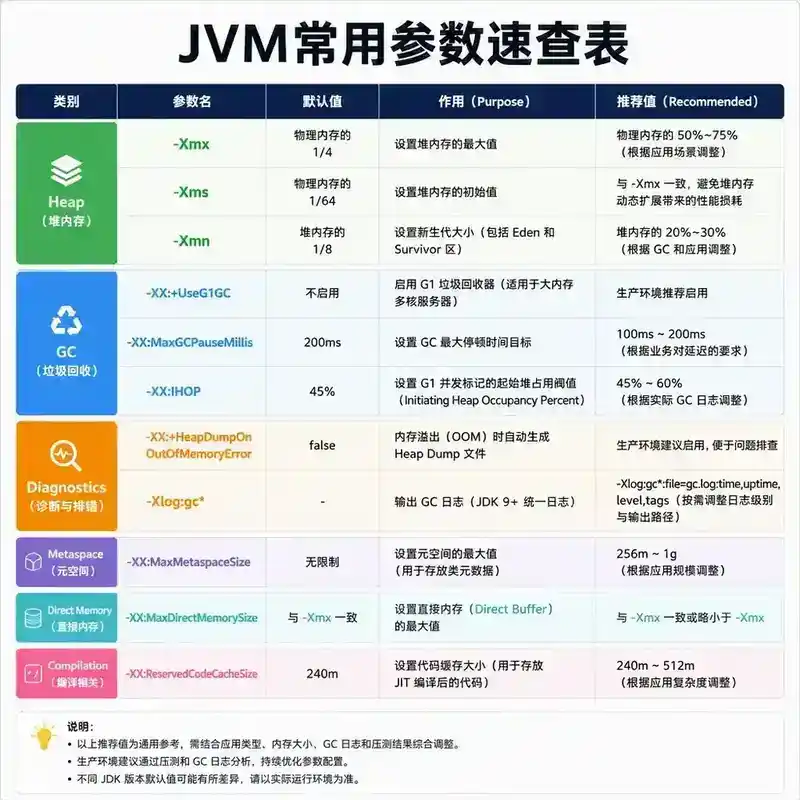
| 类别 | 参数 | 默认值 | 作用 | 推荐 |
|---|---|---|---|---|
| 堆 | -Xmx | 物理内存的 1/4 | 最大堆大小 | 容器环境的 50-75% |
| 堆 | -Xms | 物理内存的 1/64 | 初始堆大小 | 与 -Xmx 相同 |
| 堆 | -Xmn | 自动 | 年轻代大小 | 根据分配速率调整 |
| GC | -XX:+UseG1GC | JDK 9+ 默认 | 使用 G1 收集器 | 大多数场景推荐 |
| GC | -XX:MaxGCPauseMillis | 200 | G1 暂停目标 | 在线服务设 50-100ms |
| GC | -XX:InitiatingHeapOccupancyPercent | 45 | G1 并发标记触发阈值 | 晋升快可降到 35 |
| 诊断 | -XX:+HeapDumpOnOutOfMemoryError | 关闭 | OOM 时自动 dump | 生产环境必须开启 |
| 诊断 | -Xlog:gc*=info:file=gc.log | 关闭 | GC 日志 | 生产环境必须开启 |
| Metaspace | -XX:MaxMetaspaceSize | 无限制 | 元空间上限 | 建议设 256-512m |
| 直接内存 | -XX:MaxDirectMemorySize | 等于 -Xmx | 直接内存上限 | NIO 场景显式设置 |
| 编译 | -XX:ReservedCodeCacheSize | 240m | CodeCache 大小 | 大型应用设 512m |
[图5:JVM常用参数速查表——按类别组织的参数表,列出参数名、默认值、作用、推荐值]
十、总结
JVM 调优方法论的核心是系统化、可量化、可回滚:
- 目标设定:SMART 原则,明确要解决什么问题
- 基线采集:GC/内存/性能/代码四个维度的数据
- 瓶颈分析:决策树定位,先代码后参数
- 方案制定:一次只改一个参数
- 效果验证:对比基线,关注副作用,备好回滚
- 持续监控:调优是持续迭代的过程
记住:最好的调优是让 JVM 自己管理好自己。 JDK 的默认参数在大多数场景下已经足够好。只有在明确出现性能问题且有数据支撑时,才需要介入调优。避免"预防性调优"——在没问题时调参数,可能引入新问题。
延伸阅读
- 《深入理解 Java 虚拟机》(周志明)第 5 章,调优案例分析与实战
- Oracle 官方文档:Java Platform, Standard Edition HotSpot Virtual Machine Garbage Collection Tuning Guide
- 本系列分类 04 JVM 原理与调优(051-070)全部 20 篇文章
面试官视角:提问与回答
以下问题从面试官视角出发,考察你对 JVM 调优的系统化思维和实战经验。
Q1:你说"一次只改一个参数",但你的老板说"下周就要上线,来不及慢慢调"。同时你发现服务有三个问题:Full GC 频繁、Young GC 频繁、启动慢。你会怎么排优先级?
这种情况下,我会按"影响面"和"修复成本"两个维度排优先级。1)Full GC 频繁是最高优先级——它直接导致服务不可用(长时间的 STW 暂停),必须优先解决。解决方案是增大堆或降低 IHOP,代价是一次重启,收益是消除服务不可用。2)Young GC 频繁是次优先级——它影响吞吐量但不导致不可用,可以在 Full GC 问题解决后,用 jstat 观察分配速率,如果分配速率正常只是 Eden 太小,调整 NewRatio 即可。3)启动慢是低优先级——它不影响运行时的稳定性,可以在后续版本中优化编译阈值或引入 AOT。如果老板坚持一次上线,我会把 Full GC 和 Young GC 相关的参数(IHOP + NewRatio)一起改,但明确告知"启动慢"的问题需要单独排期处理。关键是用数据说话:Full GC 数据说明"不改会宕机",Young GC 数据说明"改了吞吐量提升",启动慢的数据说明"不影响线上稳定性"。
Q2:你调优后发现 GC 暂停时间从 2 秒降到了 50ms,但 CPU 使用率从 30% 升到了 55%。你会怎么判断这是"优化成功"还是"引入了新问题"?
这是一个典型的 GC 调优的权衡取舍——降低了暂停时间,但增加了 CPU 开销。判断标准:1)55% 的 CPU 使用率是否还留有安全余量(通常 < 70% 是安全的)。2)CPU 增加是否影响业务线程的吞吐量——如果 CPU 高了但业务 QPS 也高了,说明 GC 更高效了,是好事。3)CPU 增加是否导致其他副作用(如容器 CPU throttling)。如果 CPU 从 30% 到 55% 但还在安全范围内,且业务性能提升了,这就是成功的优化。如果 CPU 接近 80% 且出现 throttling,说明需要调整策略——比如稍微放宽暂停时间目标(从 50ms 调到 100ms),减少 GC 的 CPU 消耗。GC 调优本质上是"暂停时间 vs 吞吐量 vs CPU 开销"的三角权衡,没有绝对最优,只有最适合业务场景的平衡点。
Q3:你接手了一个没有 GC 日志、没有基线数据、没有配置文档的老服务,现在用户反馈偶尔卡顿。你如何从零开始建立调优基线?
从零开始的排查顺序:1)先用 jps 确认进程,用 jinfo 导出当前所有 JVM 参数(包括默认值),这是最宝贵的"配置基线"。2)用 jstat -gcutil 观察 5-10 分钟,看 GC 频率和各代使用率趋势,快速判断 GC 是否健康。3)用 jstack 截图线程状态分布,看是否有大量 BLOCKED 或 WAITING 线程。4)如果 GC 看起来有问题,加上 -Xlog:gc*=info 和 -XX:+HeapDumpOnOutOfMemoryError 参数,重启后观察 24 小时。5)如果问题紧急不能等,用 jcmd GC.heap_dump 导出 dump 分析内存分布,用 Arthas dashboard 观察实时指标。6)建立"临时基线":记录当前的 jstat 输出、GC 频率、线程状态,作为后续调优的对比基准。关键是不要因为没有基线就放弃数据驱动的思路——"临时基线"虽然不完美,但比"凭感觉调"好得多。
Q4:你给一个服务调优后,GC 表现完美,但一周后服务又出现 Full GC。你检查发现是业务数据量增长了 3 倍。你之前的调优是不是"失败"了?怎么避免这种情况?
这不叫失败,这叫"调优方案的目标容量被突破"。任何调优方案都是在特定容量假设下有效的——当初调优时假设数据量是 X,现在变成了 3X,方案自然需要调整。避免这种情况的方法:1)在调优时做容量规划——不仅考虑当前数据量,还要考虑未来 3-6 个月的增长预期。2)建立自动扩容机制——如果堆使用率超过 80% 持续 10 分钟,自动触发扩容或告警。3)设置 GC 关键指标的告警阈值——Full GC 频率 > 1 次/天、暂停时间 > 500ms 等,在问题恶化前发现。4)定期回顾(每月)GC 日志趋势,提前发现堆使用率增长趋势。调优不是一次性工程,而是需要根据业务增长持续迭代的运维活动。
Q5:你在调优一个容器化微服务,容器限制 2GB 内存。你发现如果把 -Xmx 设到 1.5GB,堆够了但 Metaspace + 线程栈 + 直接内存会超 2GB;如果 -Xmx 设到 1.2GB,堆又不够用。你怎么解决这个矛盾?
这是容器化场景下经典的"内存预算"问题。JVM 进程总内存 = 堆 + Metaspace + 线程栈 × N + 直接内存 + CodeCache + 其他。解决方案:1)先做"内存预算表"——用 NMT(Native Memory Tracking)或 jcmd VM.native_memory 精确统计各区域的实际占用。2)重点优化线程栈(-Xss):如果默认 1MB,线程数 200,就是 200MB。如果业务不需要深递归,可以降到 512KB 甚至 256KB,节省 100-150MB。3)限制 Metaspace:-XX:MaxMetaspaceSize=128m(很多微服务 128MB 足够)。4)限制直接内存:-XX:MaxDirectMemorySize=128m(除非使用 Netty 等需要大量直接内存)。5)限制 CodeCache:-XX:ReservedCodeCacheSize=128m。6)如果以上优化后还不够,考虑升级 JDK 版本(JDK 17+ 的内存管理更高效)、使用 GraalVM Native Image(编译为原生二进制,内存占用降低 50-80%)、或者增加容器内存限制。如果这些都不行,坦率地向团队说明"2GB 不够",用数据说服扩容。