阅读时间:约 45 分钟 | 难度:中级 → 高级 | 适用对象:Java 后端工程师、DevOps/SRE 工程师、架构师
一、为什么需要健康检查与精细发布?
在 Kubernetes 上运行生产级 Java 应用,仅仅把 Pod 拉起来是不够的。一个 Pod 进入了 Running 状态,并不意味着它已经准备好接受流量——Spring 容器可能还在初始化、数据库连接池可能还没建立、缓存预热可能还没完成。同样,当你执行滚动更新时,如果不加控制,新 Pod 还没准备好就被挂上流量,老 Pod 又已经被干掉了,造成请求失败。
Kubernetes 提供了一套完整的机制来应对这些场景:
- 健康检查(Probes):让 K8s 知道 Pod 什么时候"真的"可以干活、什么时候"真的"出问题了、什么时候该重启
- 滚动更新(Rolling Update):用一种可控的方式,逐步替换旧版本 Pod
- Pod 中断预算(PDB):在集群维护或缩容时,保证至少有一定数量的 Pod 存活
- 优雅终止(Graceful Shutdown):让 Pod 在被干掉之前,有足够的时间把手头的工作做完、把连接关掉
下面我们逐一深入。
二、三种探针:Liveness、Readiness、Startup
2.1 探针的本质
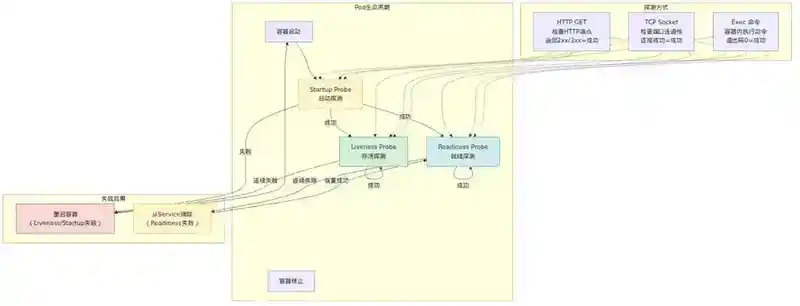
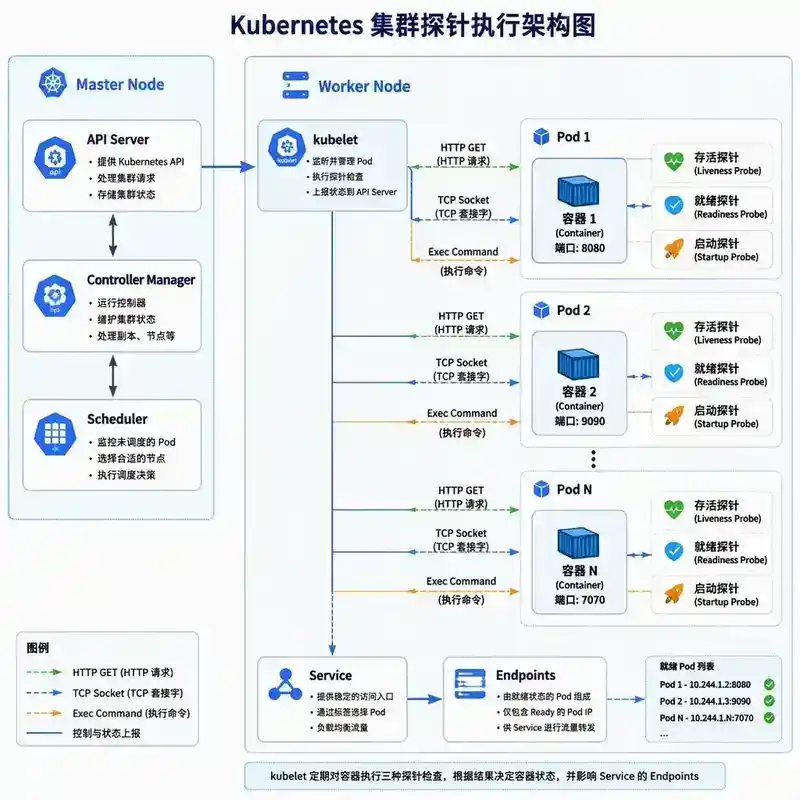
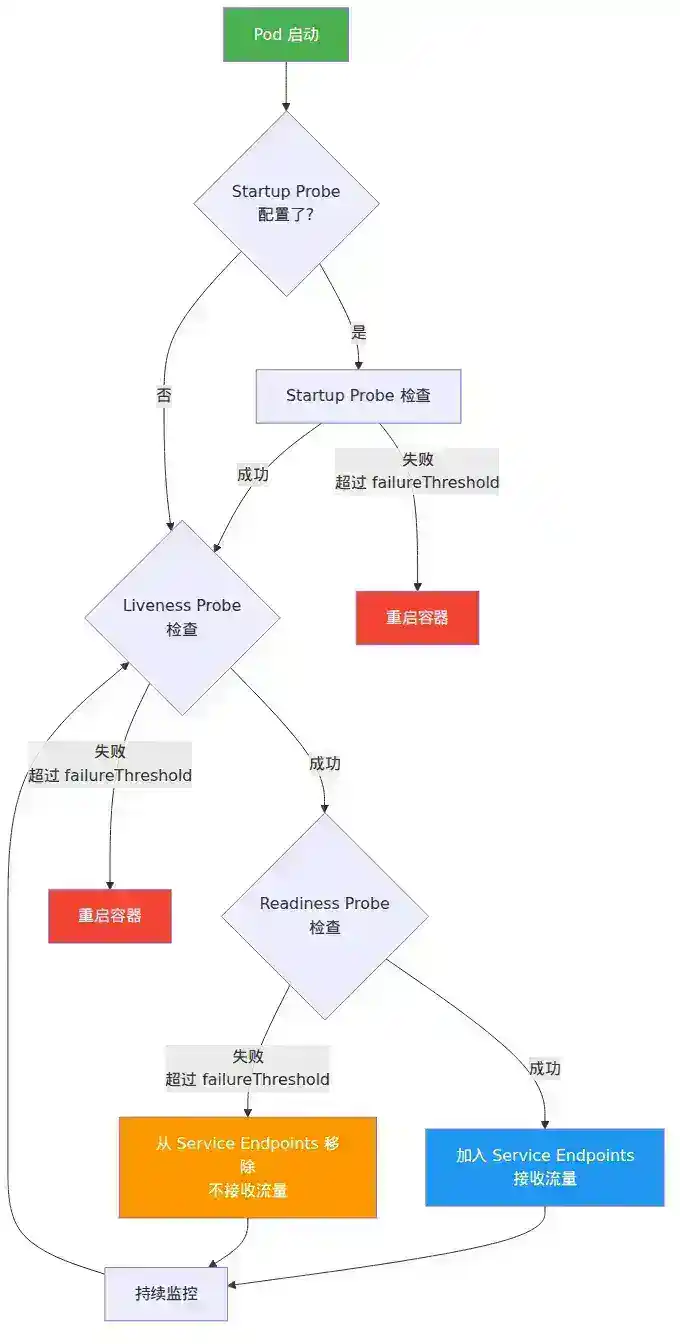
探针(Probe)是 kubelet 对 Pod 内容器执行的周期性诊断。kubelet 根据探针的返回结果决定是重启容器、还是把 Pod 从 Service 的 Endpoints 中摘除。
三种探针各有分工
| 探针 | 用途 | 失败后果 |
|---|---|---|
| Liveness Probe | 判断容器是否还活着(是否需要重启) | 重启容器 |
| Readiness Probe | 判断容器是否准备好接收流量 | 从 Service Endpoints 中移除 |
| Startup Probe | 判断容器是否已完成启动 | 启动期间失败则重启;成功后 Liveness 接管 |
2.2 Liveness Probe:你死了吗?
Liveness 回答的是"进程是否还处于健康状态"——注意,不是"进程是否还在",OOM 或进程退出 kubelet 本来就会重启。Liveness 解决的是进程还活着但已经废了的场景:死锁、无限循环卡死、JVM Full GC 导致 STW 过长等。
三种探测方式:
livenessProbe:
  httpGet:
    path: /actuator/health/liveness
    port: 8080
  initialDelaySeconds: 30
  periodSeconds: 10
  failureThreshold: 3
httpGet:最常用,应用暴露一个健康检查端点tcpSocket:检查端口是否可连接,适用于非 HTTP 服务exec:在容器内执行命令,根据退出码判断
关键参数:
initialDelaySeconds:容器启动后多久开始探测(给应用启动时间)periodSeconds:探测间隔failureThreshold:连续失败多少次才算失败timeoutSeconds:单次探测超时
2.3 Readiness Probe:你能干活了吗?
Readiness 回答的是"容器是否准备好接收请求"。一个典型的 Spring Boot 应用,Running 状态可能在 3 秒内就达到了,但真正能处理请求可能要 30 秒——数据库连接、缓存加载、RPC 客户端初始化都需要时间。
readinessProbe:
  httpGet:
    path: /actuator/health/readiness
    port: 8080
  initialDelaySeconds: 10
  periodSeconds: 5
  failureThreshold: 3
Readiness 与 Liveness 的核心区别:
- Readiness 失败 → Pod 从 Service 摘除,但不重启容器
- Liveness 失败 → 容器被重启
2.4 Startup Probe:启动慢怎么办?
如果你的应用启动需要 90 秒,而 Liveness 的 initialDelaySeconds 设为 30 秒,那 Liveness 会在应用还没启动完的时候就判定失败,把容器杀了——这就是"启动雪崩"。
Startup Probe 专门解决这个问题:
startupProbe:
  httpGet:
    path: /actuator/health
    port: 8080
  failureThreshold: 30
  periodSeconds: 3
- 在 Startup Probe 成功之前,Liveness 和 Readiness 不会执行
failureThreshold * periodSeconds = 30 * 3 = 90秒,给足启动时间- Startup Probe 一旦成功,Liveness 接管
最佳实践: 对于启动时间超过 30 秒的 Java 应用,务必配置 Startup Probe,将 Liveness 的 initialDelaySeconds 设为 0,完全交给 Startup 控制预热期。
2.5 Spring Boot Actuator 的探针端点
Spring Boot 2.3+ 内置了探针端点:
management:
  endpoints:
    web:
      exposure:
        include: health
  endpoint:
    health:
      probes:
        enabled: true
      group:
        liveness:
          include: livenessState
        readiness:
          include: readinessState, db, redis
/actuator/health/liveness:只检查livenessState(进程本身是否存活)/actuator/health/readiness:检查readinessState+ 外部依赖(DB、Redis、MQ 等)
Readiness 的 HealthIndicator 设计原则: 把外部依赖(数据库、Redis、消息队列)放进 Readiness 检查组,但不要放进 Liveness——DB 挂了不应该导致 Pod 重启,而是应该从 Service 摘除,等 DB 恢复后自动恢复。
三、滚动更新(Rolling Update)机制
3.1 Deployment 的更新策略
Deployment 有两种更新策略:
- Recreate:先删光所有旧 Pod,再创建新 Pod → 有停机时间
- RollingUpdate:逐步替换,新旧共存 → 零停机(默认)
滚动更新的核心是两个参数:
spec:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 25%
      maxSurge: 25%
3.2 maxUnavailable 与 maxSurge
这两个参数控制滚动更新的"节奏":
| 参数 | 含义 | 示例(replicas=10) |
|---|---|---|
maxUnavailable |
最多有多少 Pod 可以处于不可用状态 | 25% → 最多 2.5 个,向下取整 = 2 |
maxSurge |
最多可以超出期望副本数多少个 Pod | 25% → 最多 2.5 个,向上取整 = 3 |
滚动更新过程(replicas=10, maxUnavailable=25%, maxSurge=25%)
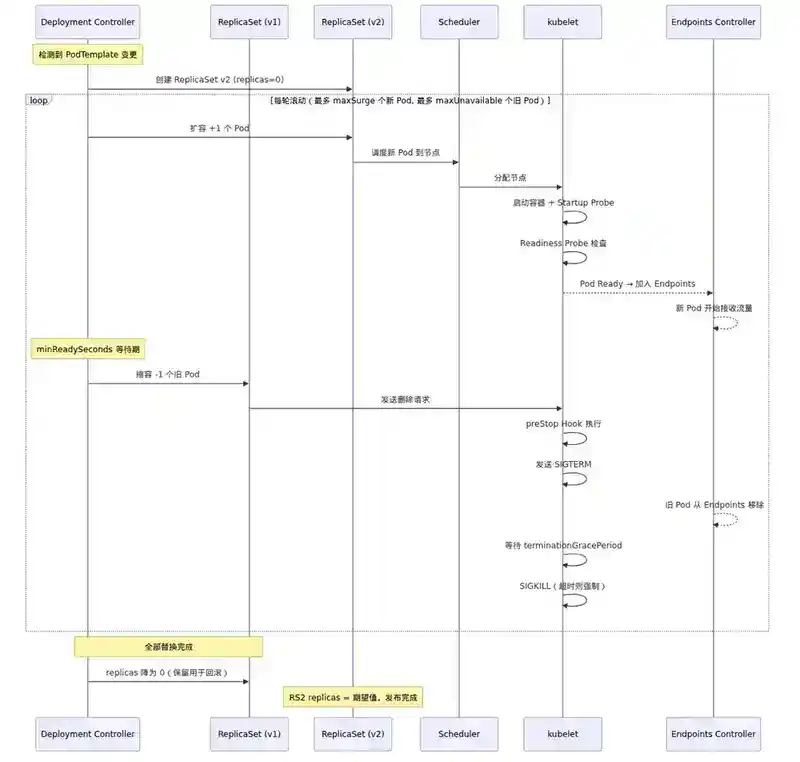
(见 fig1:滚动更新时序图)
关键公式:
- 更新期间最大 Pod 数 = replicas + maxSurge = 10 + 3 = 13
- 更新期间最小可用 Pod 数 = replicas - maxUnavailable = 10 - 2 = 8
3.3 滚动更新的完整流程
- Deployment Controller 检测到 PodTemplate 变更
- 创建新的 ReplicaSet(RS-v2),RS-v1 保持不变
- 逐步扩容 RS-v2(每次最多
maxSurge个),同时缩容 RS-v1(每次最多maxUnavailable个) - 新 Pod 必须通过 Readiness Probe 才会被计入"可用"
- 旧 Pod 收到 SIGTERM 后优雅终止
- 全部替换完成后,RS-v1 的 replicas 变为 0(保留历史 RS 用于回滚)
3.4 minReadySeconds
minReadySeconds 是新人 Pod 的"冷静期"——Pod 通过 Readiness 后,还要等待 minReadySeconds 秒才被视为"可用"。这个参数防止 Pod 刚通过 Readiness 就立刻被认为是健康的,实际上可能还有瞬态问题。
spec:
  minReadySeconds: 10
在这个期间,如果 Pod 变得不健康,它不会被计入可用 Pod,滚动更新会暂停。
3.5 progressDeadlineSeconds
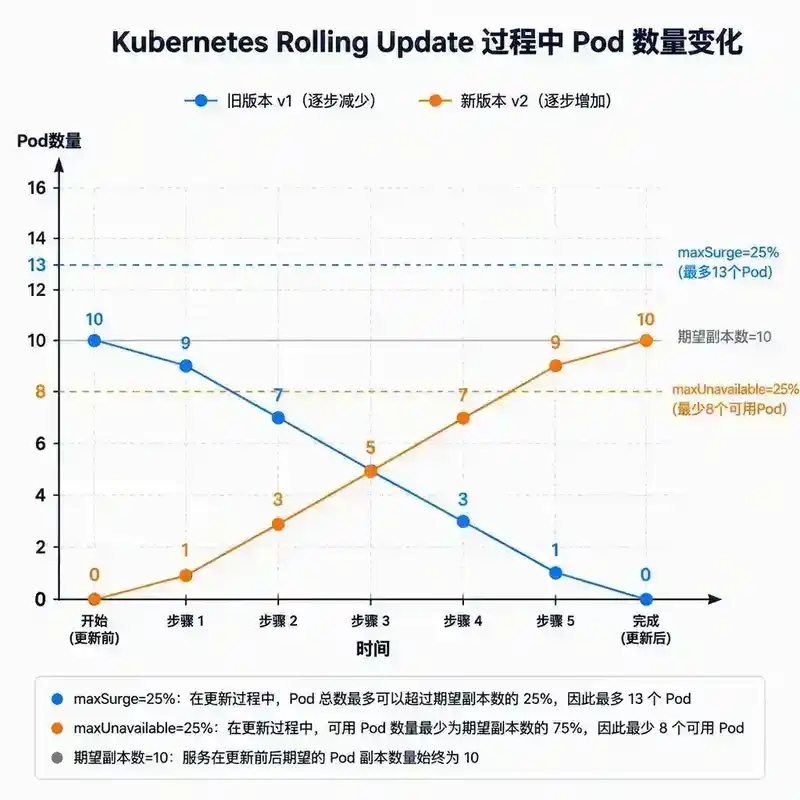
如果滚动更新在 progressDeadlineSeconds 内没有取得进展(比如新 Pod 一直无法通过 Readiness),Deployment 会被标记为 Progressing=False,状态为 ProgressDeadlineExceeded。这比无限期卡住好得多。
四、Pod 中断预算(PDB)
4.1 PDB 解决什么问题?
PDB 是"自愿中断"的防护网。自愿中断包括:
- 节点 Drain(kubectl drain,用于节点维护)
- Deployment 缩容
- 集群自动缩容器(Cluster Autoscaler)移除节点
- HPA 缩容
PDB 保证在这些操作发生时,至少有一定数量的 Pod 保持可用。
4.2 PDB 配置
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: myapp-pdb
spec:
  minAvailable: 2
  # 或使用 maxUnavailable: 1
  selector:
    matchLabels:
      app: myapp
minAvailable: 2:任何自愿中断操作,必须保证至少 2 个 Pod 可用maxUnavailable: 1:任何自愿中断操作,最多允许 1 个 Pod 不可用
4.3 PDB 与滚动更新的关系
PDB 不影响滚动更新——滚动更新是 Deployment Controller 自己控制的,PDB 只管"自愿中断"(Eviction API)。但滚动更新期间如果同时发生节点 Drain,PDB 会阻止 Drain 操作过多 Pod。
4.4 PDB 的实际效果
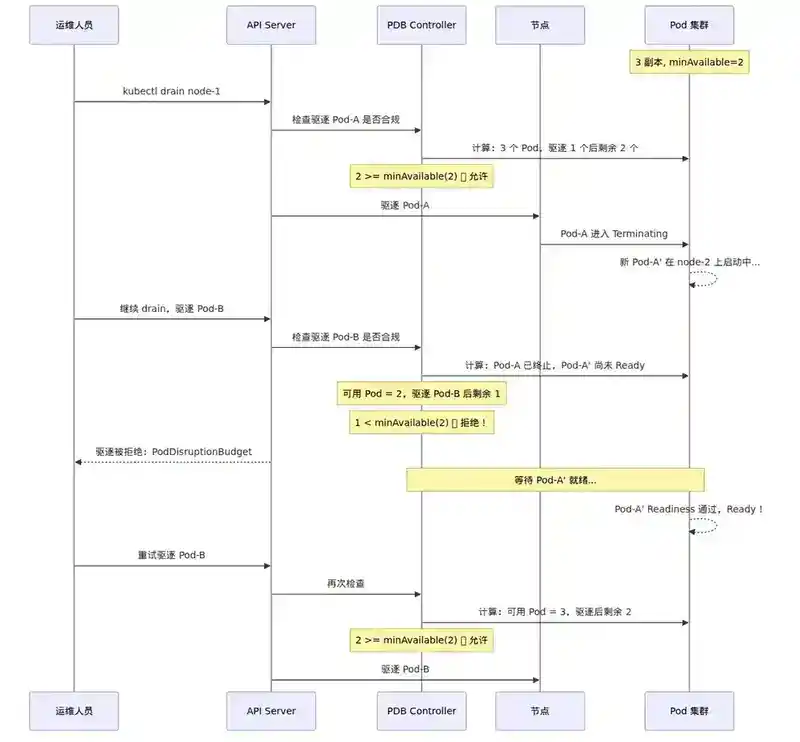
(见 fig2:PDB 阻止过量驱逐示意图)
场景:3 副本,minAvailable=2
- 节点 Drain → 一次只能驱逐 1 个 Pod(保留 2 个)
- 如果已经驱逐了 1 个,新 Pod 还没 Ready → 第 2 个驱逐被拒绝
- 驱逐被拒绝后,kubectl drain 会重试,直到新 Pod Ready 或超时
五、优雅终止(Graceful Shutdown)
5.1 整个链路的优雅终止
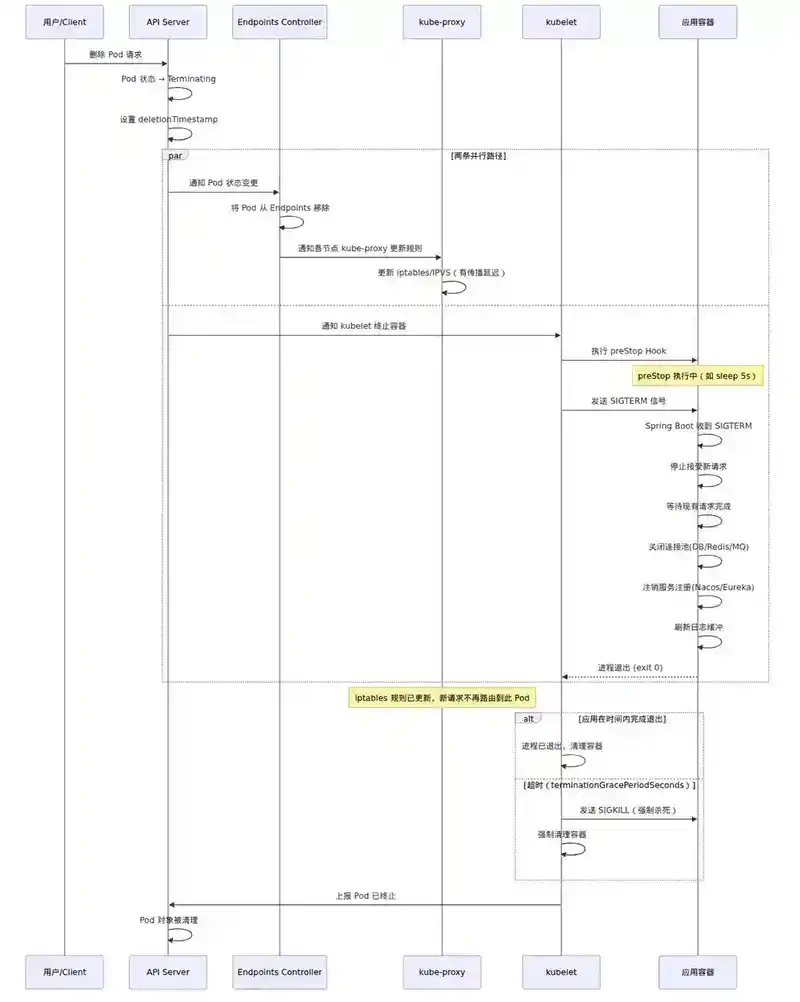
当一个 Pod 被删除时(无论是手动删除、滚动更新、还是节点 Drain),完整的终止流程是:
(见 fig3:Pod 终止完整时序图)
1. API Server 收到删除请求
2. Pod 状态变为 Terminating
3. 同时发生两件事:
   a. Endpoints Controller 将 Pod 从 Service Endpoints 中移除
   b. kubelet 向容器发送 SIGTERM
4. 应用收到 SIGTERM 后开始优雅关闭
5. 等待 terminationGracePeriodSeconds(默认 30 秒)
6. 超时后 kubelet 发送 SIGKILL 强制杀死
5.2 terminationGracePeriodSeconds
spec:
  terminationGracePeriodSeconds: 60
这个参数决定了 Pod 从收到 SIGTERM 到被 SIGKILL 之间的时间窗口。对于 Java 应用,这个值应该足够大,以覆盖:
- 正在处理的请求完成
- 连接池关闭
- 注册中心(Nacos/Eureka)下线
- 日志刷新
典型值:
- Web 应用:30-60 秒
- 批处理任务:120-300 秒
- 长连接服务:60-120 秒
5.3 preStop Hook
preStop 钩子在 SIGTERM 发送之前执行,可以用于自定义清理逻辑:
lifecycle:
  preStop:
    exec:
      command: ["/bin/sh", "-c", "sleep 10"]
preStop 的典型用途:
- 额外的延迟,确保 Endpoints 变更已经传播到所有 kube-proxy
- 调用应用的健康检查"下线"端点
- 等待正在处理的请求完成
一个关键细节:preStop 的执行时间包含在 terminationGracePeriodSeconds 里。如果 preStop 花了 10 秒,那应用实际处理 SIGTERM 的时间就少了 10 秒。
5.4 Spring Boot 的优雅关闭
Spring Boot 2.3+ 内置了优雅关闭:
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
当收到 SIGTERM 时:
- Spring Boot 停止接受新请求
- 等待正在处理的请求完成(最多
timeout-per-shutdown-phase) - 关闭
@PreDestroy方法 - 关闭 Bean 容器
- 进程退出
5.5 Endpoints 传播延迟——为什么需要 preStop sleep?
当 Pod 被标记为 Terminating 时,Endpoints Controller 会同时将它从 Endpoints 中移除。但这个变更需要传播到每个节点上的 kube-proxy,而 kube-proxy 更新 iptables/IPVS 规则需要时间。
这个延迟通常在 1-5 秒。 如果应用在 Endpoints 变更还没传播完就退出了,kube-proxy 仍然会把请求路由到这个已经退出的 Pod,导致连接被拒绝。
经典的解决方案:
lifecycle:
  preStop:
    exec:
      command: ["/bin/sh", "-c", "sleep 5"]
让 Pod 在 SIGTERM 之前先等 5 秒,确保 iptables 规则已经更新。
5.6 连接排空与优雅关闭的顺序
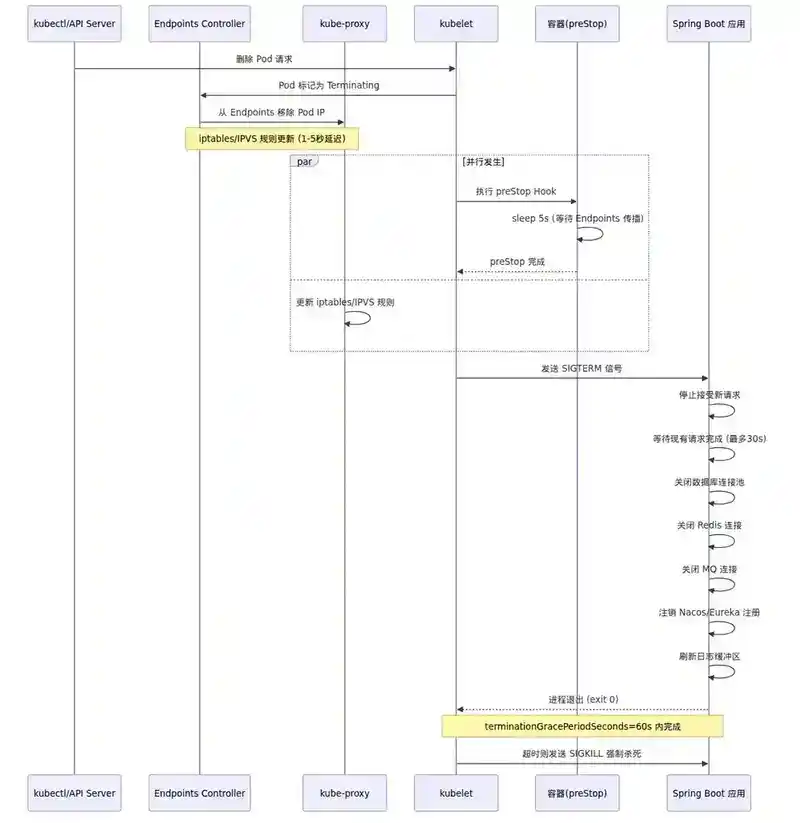
完整的优雅关闭链路:
- preStop sleep 5s → 等待 Endpoints 变更传播
- SIGTERM → Spring Boot 收到信号
- 停止接受新请求 → Tomcat/Netty 关闭 acceptor 线程
- 等待现有请求完成 → 最多
timeout-per-shutdown-phase - 关闭外部连接 → 数据库连接池、Redis 连接、MQ 连接
- 注销服务注册 → Nacos/Eureka 下线
- 进程退出 → 或超时后被 SIGKILL
六、各组件协同:一个完整的发布流程
(见 fig4:完整发布流程各组件协同图)
当你执行 kubectl apply -f deployment.yaml 更新镜像版本时,以下组件协同工作:
| 组件 | 职责 |
|---|---|
| Deployment Controller | 创建新 RS,控制滚动节奏 |
| ReplicaSet Controller | 确保 Pod 数符合期望 |
| Scheduler | 为新 Pod 选择节点 |
| kubelet | 启动容器、执行探针、管理生命周期 |
| Endpoints Controller | 管理 Service Endpoints |
| kube-proxy | 更新 iptables/IPVS 规则 |
| PDB | 限制自愿中断 |
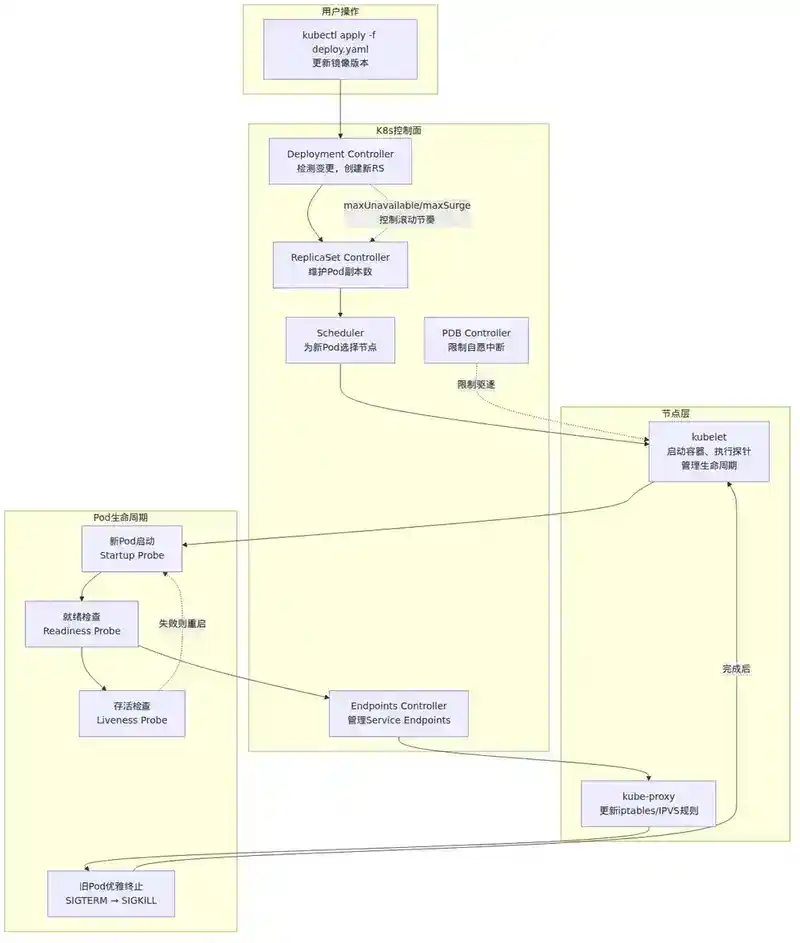
每个组件独立工作,但通过 Kubernetes 的声明式模型最终协同。理解它们之间的时序关系,才能在生产环境中排查"为什么我的滚动更新卡住了"或"为什么更新期间有请求失败"。
七、生产环境踩坑与最佳实践
7.1 探针配置反模式
反模式 1:Liveness 检查了外部依赖
# 错误:DB 挂了不应该重启 Pod
livenessProbe:
  httpGet:
    path: /actuator/health  # 包含了 DB 检查
修正: Liveness 只检查 livenessState,Readiness 检查外部依赖。
反模式 2:Liveness 的 initialDelaySeconds 太小
livenessProbe:
  initialDelaySeconds: 10  # 应用启动需要 60 秒
修正: 使用 Startup Probe 覆盖启动期。
反模式 3:Readiness 的 failureThreshold 太小
readinessProbe:
  failureThreshold: 1  # 一次失败就摘除
修正: 设为 3-5,避免瞬态故障导致 Pod 被频繁摘除/加入。
7.2 滚动更新配置指南
配置推荐:
spec:
  replicas: 3
  minReadySeconds: 10
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 0    # 绝对不能少 Pod
      maxSurge: 1          # 先扩容再缩容
maxUnavailable: 0+maxSurge: 1:先创建新 Pod,等新 Pod Ready 后再删旧 Pod- 适用于对可用性要求极高的场景
- 代价:需要更多资源(临时多出 1 个 Pod)
7.3 PDB 配置指南
minAvailable通常设为replicas - 1或ceil(replicas / 2)- 不要设成
replicas(等于禁止任何中断) - 单副本的 PDB 没有意义
- PDB 标签选择器必须精确匹配,避免误匹配
7.4 优雅关闭配置清单
# Deployment
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 60
      containers:
      - name: app
        lifecycle:
          preStop:
            exec:
              command: ["/bin/sh", "-c", "sleep 5"]
# Spring Boot application.yml
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
八、总结
| 机制 | 核心问题 | 关键参数 |
|---|---|---|
| Liveness Probe | 容器是否还活着? | failureThreshold, periodSeconds |
| Readiness Probe | 容器能否接收流量? | failureThreshold, periodSeconds |
| Startup Probe | 启动是否完成? | failureThreshold × periodSeconds |
| Rolling Update | 如何逐步替换 Pod? | maxUnavailable, maxSurge, minReadySeconds |
| PDB | 维护时如何保证可用性? | minAvailable / maxUnavailable |
| Graceful Shutdown | 如何优雅退出? | terminationGracePeriodSeconds, preStop |
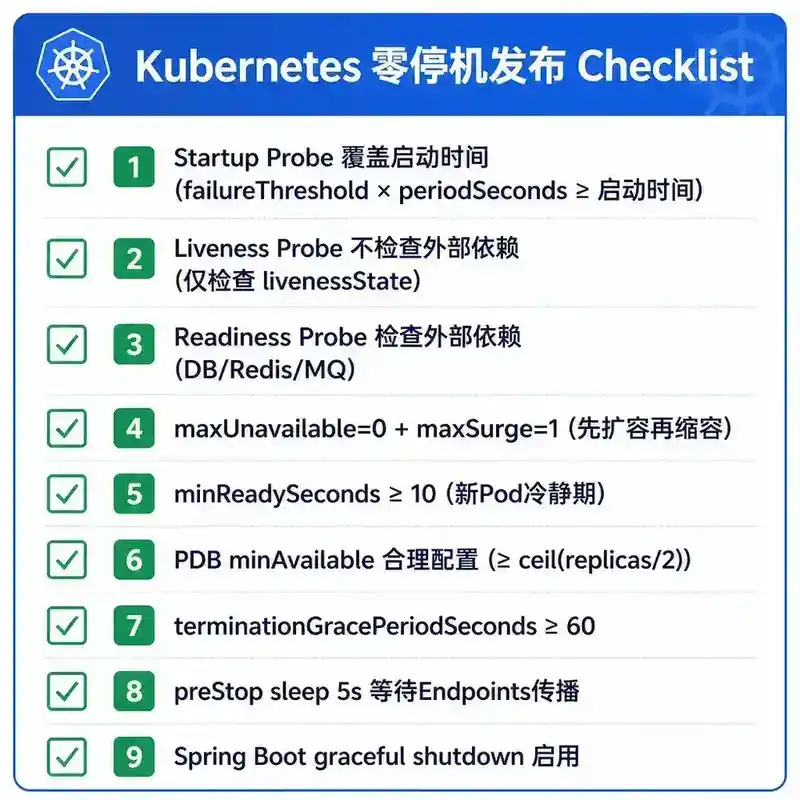
这些机制不是孤立的——它们共同构成了 Kubernetes 应用的"生命周期安全网"。一个生产级的 Java 应用,必须同时正确配置这六个方面,才能实现真正的零停机发布。
九、面试官视角提问
以下问题从面试官角度出发,考察候选人对 K8s 健康检查与发布机制的理解深度和实战经验。
Q1: 一个 Pod 的 Readiness Probe 失败了,Liveness Probe 也失败了,K8s 会怎么处理?这两个失败是先后发生还是同时发生?如果 Readiness 先失败,Liveness 后失败,Pod 最终会怎样?
Q2: 你的 Deployment 有 10 个副本,滚动更新时发现新 Pod 一直处于 ContainerCreating 状态,但旧 Pod 还在被逐步删除。这个过程中最多会损失多少个 Pod 的可用性?maxUnavailable=25% 和 maxSurge=25% 的情况下,实际可用 Pod 最少是多少?
Q3: 在不使用 Service Mesh 的情况下,如何彻底消除滚动更新期间的请求失败?请从 Pod 生命周期、Endpoints 传播、应用层连接排空三个层面给出完整方案。
Q4: PDB 的 minAvailable 设为 2,但 Deployment 只有 2 个副本。现在要执行 kubectl drain 一个节点,上面恰好有 1 个 Pod。这个 drain 操作会成功吗?如果会失败,有什么办法绕过?
Q5: 你的 Spring Boot 应用配置了 server.shutdown=graceful,timeout-per-shutdown-phase=30s,terminationGracePeriodSeconds=30。但运维反馈说 Pod 重启时经常有 502 错误。可能的原因是什么?如何排查?
Q6: 一个多副本的 StatefulSet 应用,既有 Liveness Probe 又有 Readiness Probe,还有 Startup Probe。现在执行滚动更新,新 Pod 启动时间约 120 秒。请设计完整的探针参数,并说明为什么这样设置。
参考答案
A1:Readiness 与 Liveness 同时失败的场景分析
Readiness Probe 和 Liveness Probe 是两套独立运行的探测机制,kubelet 对它们各自维护独立的状态机。它们可能先后失败,也可能在同一探测周期内都失败——取决于应用究竟出了什么问题。
场景分析:
- Readiness 先失败,Liveness 后失败(最常见):比如数据库连接池耗尽。Readiness 检查
/actuator/health/readiness时发现 DB 连不上,先标记为 NotReady,Pod 被从 Service Endpoints 摘除。此时 Pod 还在运行,但 Liveness 只检查/actuator/health/liveness(只看 livenessState),livenessState 可能仍然是 UP,所以 Liveness 暂时不会失败。如果问题持续恶化——比如 DB 连接池耗尽导致线程全部阻塞,JVM 进入死锁状态——后续 Liveness 检查也会失败。此时 Pod 被 kubelet 重启。 - 同时失败:如果应用进程整体 hang 住(比如 Full GC 的 STW 时间过长),Readiness 和 Liveness 的 HTTP 请求都会超时,两者在同一周期内同时失败。Readiness 失败 → 摘除流量;Liveness 失败 → 重启容器。两者独立执行,不存在"谁先谁后"的互斥关系。
- 最终结果:Pod 会被重启(Liveness 失败触发),重启后如果问题根因没解决(比如 DB 仍然不可用),新 Pod 启动后 Readiness 可能再次失败,但 Liveness 正常(因为进程本身活得好好的)。这就是典型的"Pod Running 但不 Ready"状态。
关键点:面试官想听到的是——你能否区分"进程级故障"(Liveness 管)和"依赖级故障"(Readiness 管),以及两者独立运作的机制。
A2:滚动更新中 Pod 可用性损失计算
已知条件:replicas=10,maxUnavailable=25%,maxSurge=25%。
- maxUnavailable = floor(10 × 25%) = floor(2.5) = 2
- maxSurge = ceil(10 × 25%) = ceil(2.5) = 3
滚动更新期间,新 Pod 一直 ContainerCreating(比如镜像拉取失败或节点资源不足),这意味着新 Pod 永远不会通过 Readiness,不会被计入"可用"。
过程推演:
- 初始状态:10 个旧 Pod 全部可用
- 第一轮:创建 3 个新 Pod(maxSurge=3),但全部卡在 ContainerCreating。同时可以删除 2 个旧 Pod(maxUnavailable=2)。此时可用 Pod = 10 - 2 = 8。
- 第二轮:新 Pod 仍然没 Ready,但旧 Pod 已被删了 2 个。此时控制器发现"可用 Pod 数 = 8,小于期望的 10",同时新 Pod 也没 Ready,滚动更新会暂停——因为最多只能有 2 个不可用,再删就超过 maxUnavailable 了。
实际可用 Pod 最少是 8 个。控制器不会继续删除旧 Pod,因为那会违反 maxUnavailable 约束。
面试官追问:如果 maxUnavailable=0 呢?答案:一个旧 Pod 都不会被删,滚动更新会卡住不动,直到新 Pod 变成 Ready 或超时(progressDeadlineSeconds)。
A3:不使用 Service Mesh 实现零停机滚动更新
从三个层面给出完整方案:
第一层:Pod 生命周期
spec:
  terminationGracePeriodSeconds: 60
  containers:
  - name: app
    lifecycle:
      preStop:
        exec:
          command: ["/bin/sh", "-c", "sleep 5"]
    readinessProbe:
      httpGet:
        path: /actuator/health/readiness
        port: 8080
      initialDelaySeconds: 10
      periodSeconds: 5
      failureThreshold: 3
preStop sleep 5:给 Endpoints 传播留出时间窗口terminationGracePeriodSeconds: 60:确保应用有足够时间处理完现有请求- Readiness Probe 确保只有真正可用的 Pod 才接收流量
第二层:Endpoints 传播优化
- 使用
kube-proxy的 IPVS 模式(而非 iptables),IPVS 使用哈希表做规则匹配,规则更新是 O(1) 的,而 iptables 是 O(n) 的线性匹配 - 配置
minReadySeconds: 10,让 Pod 通过 Readiness 后再等 10 秒才被视为可用,这间接给了 Endpoints 传播时间 - 考虑使用 EndpointSlice(K8s 1.21+ 默认启用),它比传统 Endpoints 对象更高效,更新传播更快
第三层:应用层连接排空
# Spring Boot
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
应用层要做到:
- 收到 SIGTERM 后立即停止接受新连接(Tomcat/Netty 关闭 acceptor)
- 等待现有请求处理完成(
timeout-per-shutdown-phase) - 关闭数据库连接池、Redis 连接池
- 从注册中心(Nacos/Eureka)主动注销,而不是等心跳超时
完整的零停机保障链: preStop sleep 5s → Endpoints 摘除 → SIGTERM → 停止接受新请求 → 等待现有请求完成 → 关闭连接池 → 注销注册中心 → 进程退出
面试官想听到的关键词:preStop 延迟、IPVS vs iptables、EndpointSlice、Spring Boot graceful shutdown、注册中心主动注销、minReadySeconds。
A4:PDB drain 阻塞问题分析
结论:drain 操作会失败。
原因:PDB 的 minAvailable=2 意味着在任何自愿中断操作下,必须保证至少 2 个 Pod 可用。Deployment 只有 2 个副本,如果要驱逐其中 1 个 Pod,可用 Pod 变为 1,违反了 minAvailable=2 的约束。Eviction API 会拒绝这次驱逐,kubectl drain 收到拒绝后报错。
绕过方法(按推荐度排序):
- 临时调整 PDB(推荐):
kubectl patch pdb myapp-pdb -p '{"spec":{"minAvailable":1}}'
kubectl drain <node> --ignore-daemonsets --delete-emptydir-data
kubectl patch pdb myapp-pdb -p '{"spec":{"minAvailable":2}}'
先降低 minAvailable,drain 完成后恢复。 2. 使用 --disable-eviction 强制 drain:
kubectl drain <node> --disable-eviction --ignore-daemonsets --delete-emptydir-data
--disable-eviction 会绕过 Eviction API,直接 delete pod(不走 PDB 检查)。但这是危险的——它会忽略 PDB 保护,可能导致服务不可用。仅在维护窗口或确认可以接受短暂不可用时使用。
3. 先扩容再 drain:
kubectl scale deployment myapp --replicas=3
# 等待新 Pod Ready
kubectl drain <node> --ignore-daemonsets
扩容到 3 副本,驱逐 1 个后还剩 2 个,满足 minAvailable=2。
面试官追问:如果 PDB 用的是 maxUnavailable: 1 呢?答案:minAvailable=2 意味着 2 副本下 maxUnavailable=0,两者等价。但用 maxUnavailable=1 的话,2 副本下允许 1 个不可用,drain 会成功——但这也意味着 PDB 实际没起到保护作用。所以 PDB 参数的选择需要和副本数匹配。
A5:502 错误排查
最可能的原因:Endpoints 传播延迟。
时间线分析:
- Pod 收到 SIGTERM,
terminationGracePeriodSeconds=30开始倒计时 - Spring Boot
timeout-per-shutdown-phase=30s,等待现有请求完成 - 但 Endpoints Controller 摘除 Pod 到 kube-proxy 更新 iptables 规则有 1-5 秒延迟
- 在这个延迟窗口内,kube-proxy 仍然把新请求路由到这个正在关闭的 Pod
- 如果 Pod 已经关闭了 Tomcat acceptor(停止接受新连接),新请求会收到连接被拒绝 → 502
具体排查步骤:
- 确认是不是 preStop 缺失:检查 Deployment 是否有
preStophook。如果没有,SIGTERM 和 Endpoints 摘除几乎同时发生,没有给 iptables 规则更新留时间。 - 检查 terminationGracePeriodSeconds 是否够用:
timeout-per-shutdown-phase=30+terminationGracePeriodSeconds=30,preStop 的时间也包含在内。如果请求处理超过 30 秒,Pod 会被 SIGKILL 强制杀死。 - 查看应用日志:确认是否有
Graceful shutdown相关日志,以及是否有请求在关闭期间被拒绝。 - 检查 kube-proxy 模式:iptables 模式规则更新慢,IPVS 模式更快。
kubectl logs -n kube-system kube-proxy-xxx查看。
修复方案:
lifecycle:
  preStop:
    exec:
      command: ["/bin/sh", "-c", "sleep 5"]  # 关键:给 Endpoints 传播留时间

spec:
  terminationGracePeriodSeconds: 45  # 5s preStop + 30s graceful + 10s buffer
面试官想听到的深度:能区分 502 的多种可能原因——Endpoints 延迟、preStop 缺失、terminationGracePeriodSeconds 不足、连接池未排空、注册中心未注销,并能给出系统性排查方案而不仅仅是"加个 preStop sleep"。
A6:StatefulSet 的完整探针参数设计
需求:多副本 StatefulSet,启动时间约 120 秒,需要滚动更新。
spec:
  containers:
  - name: app
    startupProbe:
      httpGet:
        path: /actuator/health
        port: 8080
      failureThreshold: 30     # 30 × 5 = 150 秒
      periodSeconds: 5
    livenessProbe:
      httpGet:
        path: /actuator/health/liveness
        port: 8080
      initialDelaySeconds: 0   # 完全交给 startupProbe
      periodSeconds: 10
      failureThreshold: 3      # 30 秒内连续 3 次失败才重启
      timeoutSeconds: 5
    readinessProbe:
      httpGet:
        path: /actuator/health/readiness
        port: 8080
      initialDelaySeconds: 0   # 交给 startupProbe
      periodSeconds: 5
      failureThreshold: 3      # 15 秒内连续失败才摘除
      timeoutSeconds: 5
设计理由:
- Startup Probe:
failureThreshold × periodSeconds = 30 × 5 = 150秒,超过 120 秒的启动时间,留 30 秒 buffer。在 Startup Probe 成功之前,Liveness 和 Readiness 都不会执行,避免了"启动雪崩"。 - Liveness Probe:
initialDelaySeconds=0——因为 Startup Probe 已经覆盖了启动期,Liveness 不需要额外延迟。periodSeconds=10,不要过于频繁,避免给应用增加负担。failureThreshold=3——连续 30 秒不健康才重启,给应用自愈的机会。 - Readiness Probe:
periodSeconds=5,比 Liveness 更频繁——流量切换需要更快的响应。failureThreshold=3——连续 15 秒不健康才摘除,避免瞬态抖动导致 Pod 被频繁摘除加入。 - StatefulSet 特殊考量:
- StatefulSet 的 Pod 名称是固定的(如
app-0、app-1),滚动更新是逆序进行的(从app-N到app-0) - StatefulSet 的
podManagementPolicy默认是OrderedReady,意味着app-2必须 Ready 后才会更新app-1 - 如果使用了持久卷(PVC),确保新 Pod 能正确挂载之前的 PVC
- StatefulSet 的 Pod 名称是固定的(如
为什么不这样设计(常见错误):
- 不用 Startup Probe,把 Liveness 的
initialDelaySeconds设为 130:如果以后启动时间变长,又要手动调整,维护成本高,且容易遗漏 - Readiness 的
failureThreshold设为 1:瞬态故障(如短暂的 GC 停顿)会导致 Pod 被频繁摘除和加入,引起流量抖动 - Liveness 检查了外部依赖:DB 宕机会导致所有 Pod 被连环重启,造成更大的故障
面试官追问:如果启动时间从 120 秒变成 300 秒怎么办?答:只需调整 Startup Probe 的 failureThreshold(比如改为 60,60 × 5 = 300),Liveness 和 Readiness 不用动。