阅读时间:约 45 分钟 | 难度:中高级 适用读者:Java 后端工程师、DevOps 工程师、架构师 前置知识:Docker 基础、YAML 语法、Linux 网络基础
一、引言:为什么需要理解 Kubernetes 核心对象
Kubernetes(K8s)已经成为容器编排的事实标准。无论你用的是阿里云 ACK、腾讯云 TKE 还是自建集群,K8s 都在你的应用下面默默运转。很多 Java 工程师对 K8s 的理解停留在"能部署就行"——但面试官真正想考察的,是你对声明式 API 设计哲学的理解,以及这些核心对象在生产环境中的坑和最佳实践。
Kubernetes 的核心对象体系可以概括为五个层次:
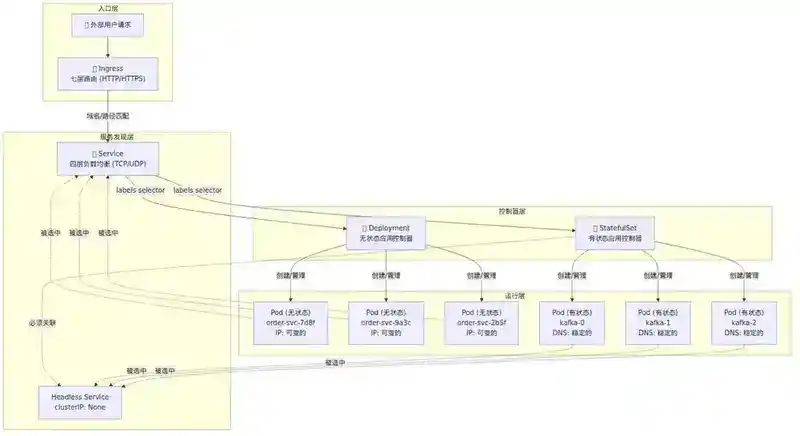
- Pod:最小的调度和运行单元
- Deployment:无状态应用的声明式部署控制器
- StatefulSet:有状态应用的部署控制器
- Service:服务发现与负载均衡抽象
- Ingress:七层 HTTP/HTTPS 路由入口
本文从设计原理出发,结合源码级细节和生产实践,深入剖析这五个核心对象。
二、Pod:最小调度单元
2.1 Pod 是什么,为什么不是容器
很多人刚接触 K8s 时会问:既然 Docker 已经能运行容器了,为什么还要套一层 Pod?
Pod 是 Kubernetes 的最小调度单元,不是最小运行单元。 容器仍然是最小运行单元,但 K8s 不会直接调度单个容器——它调度的最小粒度是 Pod。
设计 Pod 有两个核心原因:
原因一:解决"紧密耦合"容器的协作问题。 假设你有一个 Java 应用容器和一个日志收集 sidecar 容器(如 Filebeat),它们需要共享文件系统、共享网络命名空间。如果直接调度两个独立容器,编排它们在同一台机器上运行、共享资源会非常复杂。Pod 把这种"一组需要紧密协作的容器"抽象为一个原子调度单元。
原因二:简化容器运行时接口(CRI)。 K8s 只调度 Pod,不调度容器。这意味 K8s 只需要定义 Pod 的接口,底层可以用 Docker、containerd、CRI-O 等任意容器运行时,只要它们能创建 Pod 就行。
2.2 Pod 内部的网络与存储模型
Pod 内部的所有容器共享两个关键资源:
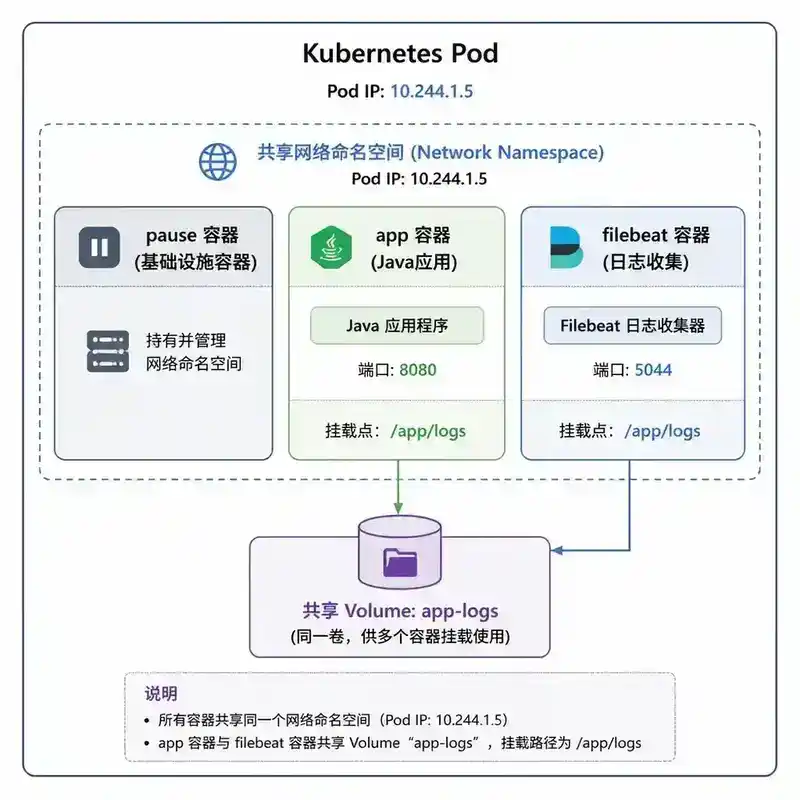
共享网络命名空间(Network Namespace):
- 同一个 Pod 内的容器共享同一个 IP 地址和端口空间
- 容器之间通过
localhost通信,无需 service 发现 - 这意味着 Pod 内容器不能绑定相同端口
共享存储卷(Volume):
- Pod 内所有容器可以挂载同一个 Volume
- 这是 sidecar 模式(日志收集、代理注入)的物理基础
# 一个典型的 Pod 内部结构
Pod IP: 10.244.1.5
├── pause 容器(基础设施容器,持有网络命名空间)
├── app 容器(Java 应用,端口 8080)
│   └── 挂载 /app/logs → Volume: app-logs
└── filebeat 容器(日志收集,端口 5044)
    └── 挂载 /app/logs → Volume: app-logs(同一个卷)
2.3 pause 容器:Pod 的"地基"
每个 Pod 启动时,kubelet 会先创建一个 pause 容器(也叫 infra 容器)。这个容器极其轻量,只做一件事——持有 Pod 的网络命名空间和 IPC 命名空间。
Pod 内的其他容器启动时,会 --net=container:pause 加入 pause 容器的命名空间。这意味着:
- pause 容器挂了 = Pod 网络命名空间没了 = 整个 Pod 需要重建
- pause 容器是 Pod 生命周期的"锚点"
2.4 Pod 生命周期
Pod 生命周期有五个关键阶段:
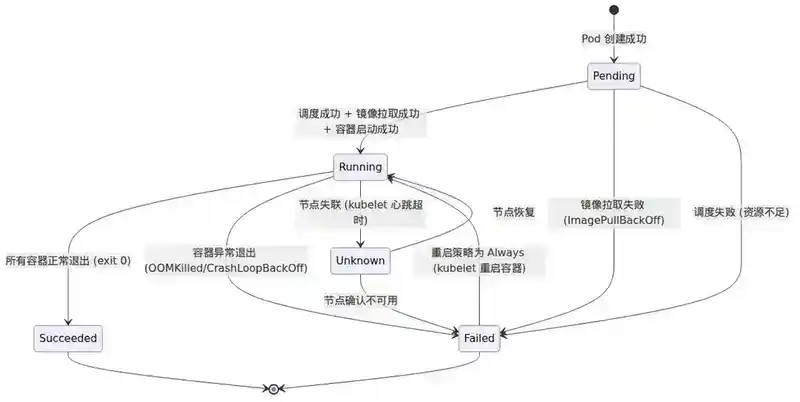
| 阶段 | 含义 | 常见原因 |
|---|---|---|
| Pending | Pod 已创建但容器未启动 | 调度中、镜像拉取中、资源不足 |
| Running | 至少有一个容器在运行 | 正常运行状态 |
| Succeeded | 所有容器正常退出(exit 0) | Job/CronJob 完成 |
| Failed | 所有容器终止,至少一个异常退出 | 应用 crash、OOMKilled |
| Unknown | 无法获取 Pod 状态 | 节点失联、kubelet 异常 |
除此之外,Pod 还有 Conditions 字段,比 Phase 更细粒度:
PodScheduled:是否已调度到节点ContainersReady:所有容器是否就绪Initialized:所有 init 容器是否完成Ready:Pod 是否可接受流量
2.5 Init 容器与 Sidecar 容器
K8s 1.28 之前,只有两种容器类型:init 容器和普通容器。1.28 引入了 sidecar 容器(带 restartPolicy: Always 的 init 容器),解决了 sidecar 启动顺序问题。
apiVersion: v1
kind: Pod
metadata:
  name: app-with-sidecar
spec:
  initContainers:
  - name: init-db
    image: busybox
    command: ['sh', '-c', 'until nc -z db 3306; do sleep 2; done']
  - name: sidecar-proxy
    image: envoyproxy/envoy
    restartPolicy: Always  # 1.28+ sidecar 特性
  containers:
  - name: app
    image: my-java-app:latest
Init 容器:按顺序执行,全部成功后才会启动普通容器。用于数据库就绪检查、配置文件生成等初始化任务。
Sidecar 容器(1.28+):与普通容器并行运行,但在普通容器之前启动。用于服务网格代理、日志收集等需要在应用启动前就绪的场景。
2.6 探针:让 Pod 真正"可用"
Pod 的 Running 状态不等于"可以接受流量"。K8s 提供三种探针来精确控制 Pod 的就绪和存活:
| 探针类型 | 作用 | 失败后果 | 典型用途 |
|---|---|---|---|
| livenessProbe | 判断容器是否存活 | 重启容器 | 死锁检测、内存泄漏恢复 |
| readinessProbe | 判断容器是否可接受流量 | 从 Service 摘除 | 依赖就绪检查、预热完成 |
| startupProbe | 判断容器是否启动完成 | 阻塞其他探针 | 启动慢的应用保护 |
关键配置参数:
livenessProbe:
  httpGet:
    path: /actuator/health/liveness
    port: 8080
  initialDelaySeconds: 30   # 启动后等待时间
  periodSeconds: 10          # 探测间隔
  timeoutSeconds: 5          # 超时时间
  failureThreshold: 3        # 失败多少次才判定为失败
  successThreshold: 1        # 成功多少次才判定为成功
生产环境最佳实践:
readinessProbe应检查关键依赖(数据库连接池、缓存连接),而不仅仅是 HTTP 200livenessProbe应足够轻量,避免依赖外部服务(外部服务挂了会导致级联重启)- 启动慢的应用(如 Spring Boot)一定要设置
startupProbe,否则initialDelaySeconds过长会导致就绪延迟,过短会导致提前被 kill
2.7 资源限制与 QoS
Pod 的 CPU 和内存通过 requests 和 limits 控制:
resources:
  requests:
    memory: "512Mi"
    cpu: "500m"
  limits:
    memory: "1Gi"
    cpu: "1000m"
- requests:调度器用来决定 Pod 放在哪个节点上(保证的基本资源量)
- limits:容器能使用的资源上限
根据 requests 和 limits 的关系,Pod 分为三个 QoS 等级:
| QoS 等级 | 条件 | OOM 优先级 |
|---|---|---|
| Guaranteed | requests == limits(所有容器) | 最低被杀 |
| Burstable | requests < limits | 中等被杀 |
| BestEffort | 未设置 requests 和 limits | 最先被杀 |
生产环境建议:核心服务设为 Guaranteed,非关键服务设为 Burstable。永远不要用 BestEffort。
三、Deployment:声明式部署与滚动更新
3.1 从 ReplicaSet 到 Deployment
要理解 Deployment,先理解 ReplicaSet:
ReplicaSet:保证指定数量的 Pod 副本始终运行。它是"命令式"的——你告诉它"保持 3 个副本",它就持续 reconcile 到 3 个。
Deployment:在 ReplicaSet 之上加了声明式更新能力。你声明"我的应用应该是 my-app:v2 这个版本",Deployment 负责通过创建新 ReplicaSet、逐步替换 Pod 来完成更新。
Deployment 的核心设计模式是控制器模式(Controller Pattern):声明期望状态 → 控制器持续 reconcile 实际状态 → 趋近期望状态。
3.2 Deployment 的核心字段
apiVersion: apps/v1
kind: Deployment
metadata:
  name: order-service
spec:
  replicas: 3                    # 期望副本数
  revisionHistoryLimit: 10       # 保留的历史 ReplicaSet 数量
  strategy:
    type: RollingUpdate          # 更新策略
    rollingUpdate:
      maxSurge: 1                # 滚动更新时最多超出几个 Pod
      maxUnavailable: 0          # 滚动更新时最多几个 Pod 不可用
  selector:
    matchLabels:
      app: order-service
  template:                      # Pod 模板
    metadata:
      labels:
        app: order-service
        version: v2
    spec:
      containers:
      - name: app
        image: order-service:v2
        ports:
        - containerPort: 8080
3.3 滚动更新机制详解
Deployment 的滚动更新是面试高频考点。核心流程如下:
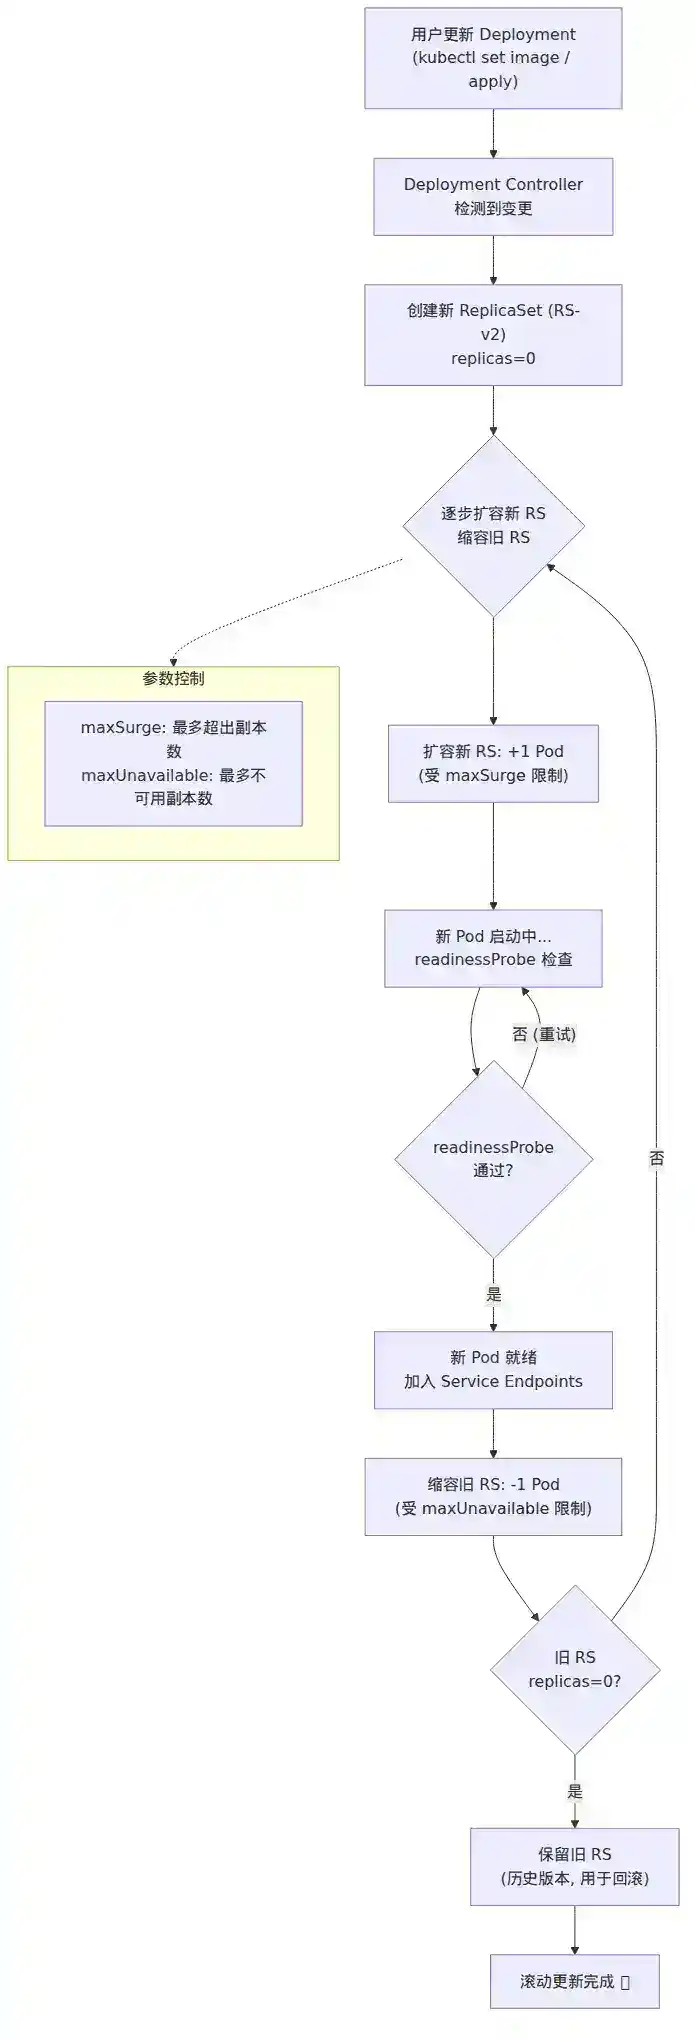
步骤分解:
- 用户更新 Deployment(如修改 image tag)
- Deployment Controller 创建新 ReplicaSet(RS-v2),replicas=0
- 逐步扩容新 RS、缩容旧 RS,步长由
maxSurge和maxUnavailable控制 - 新 Pod 通过 readinessProbe 后,才摘除旧 Pod
- 旧 RS 缩容到 0,保留(数量由
revisionHistoryLimit决定)用于回滚
maxSurge 和 maxUnavailable 的作用:
假设 replicas = 3, maxSurge = 1, maxUnavailable = 0:
Step 1: RS-v1=3, RS-v2=0 → 创建 1 个新 Pod
Step 2: RS-v1=3, RS-v2=1 → 新 Pod Ready → 删除 1 个旧 Pod
Step 3: RS-v1=2, RS-v2=1 → 创建 1 个新 Pod
Step 4: RS-v1=2, RS-v2=2 → 新 Pod Ready → 删除 1 个旧 Pod
... 依此类推
maxUnavailable=0 的含义:滚动更新期间,可用 Pod 数始终 ≥ replicas(即 3 个)。这是生产环境推荐设置——宁可慢一点,也不能损失可用性。
3.4 回滚机制
# 查看历史版本
kubectl rollout history deployment/order-service

# 回滚到上一版本
kubectl rollout undo deployment/order-service

# 回滚到指定版本
kubectl rollout undo deployment/order-service --to-revision=3
回滚本质上是把旧 ReplicaSet 重新扩容,把当前 ReplicaSet 缩容。因为旧 RS 的 Pod 模板保留了完整的配置,所以回滚是可靠的。
重要:回滚只回滚 Pod 模板(image、env、resources 等),不会回滚关联的 Service、ConfigMap、Ingress 等资源——这些需要单独管理。
3.5 蓝绿部署与金丝雀发布
Deployment 原生只支持滚动更新。蓝绿部署和金丝雀发布需要额外工具或模式:
蓝绿部署:准备两套完整的 Deployment(blue 和 green),通过切换 Service 的 selector 来切换流量。优点是瞬间切换,缺点是资源翻倍。
金丝雀发布:新版本只部署少量 Pod(如 1 个),配合 Ingress 或 Service Mesh(如 Istio)按比例引流。如果新版本正常,逐步扩大比例。
四、StatefulSet:有状态应用管理
4.1 为什么需要 StatefulSet
Deployment 管理的 Pod 是无状态的、可互换的。Pod 名称随机(如 order-service-7d8f9b6c-abcde),挂了就换一个新的,IP 也会变。
但有状态应用(数据库、消息队列、分布式存储)需要:
- 稳定的网络标识:每个 Pod 有固定的 DNS 名称
- 稳定的持久化存储:Pod 重建后仍挂载同一个 Volume
- 有序的部署和扩缩容:按 0→1→2 顺序启动,按 2→1→0 顺序缩容
- 有序的滚动更新:按 2→1→0 顺序更新
StatefulSet 就是为满足这些需求设计的。
4.2 StatefulSet 的核心特性
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: kafka
spec:
  serviceName: kafka-headless   # 必须关联一个 Headless Service
  replicas: 3
  podManagementPolicy: OrderedReady  # 或 Parallel
  updateStrategy:
    type: RollingUpdate
    rollingUpdate:
      partition: 0               # 分区更新
  volumeClaimTemplates:          # 为每个 Pod 独立创建 PVC
  - metadata:
      name: data
    spec:
      accessModes: ["ReadWriteOnce"]
      resources:
        requests:
          storage: 100Gi
  selector:
    matchLabels:
      app: kafka
  template:
    metadata:
      labels:
        app: kafka
    spec:
      containers:
      - name: kafka
        image: confluentinc/cp-kafka:7.5.0
四个核心特性:
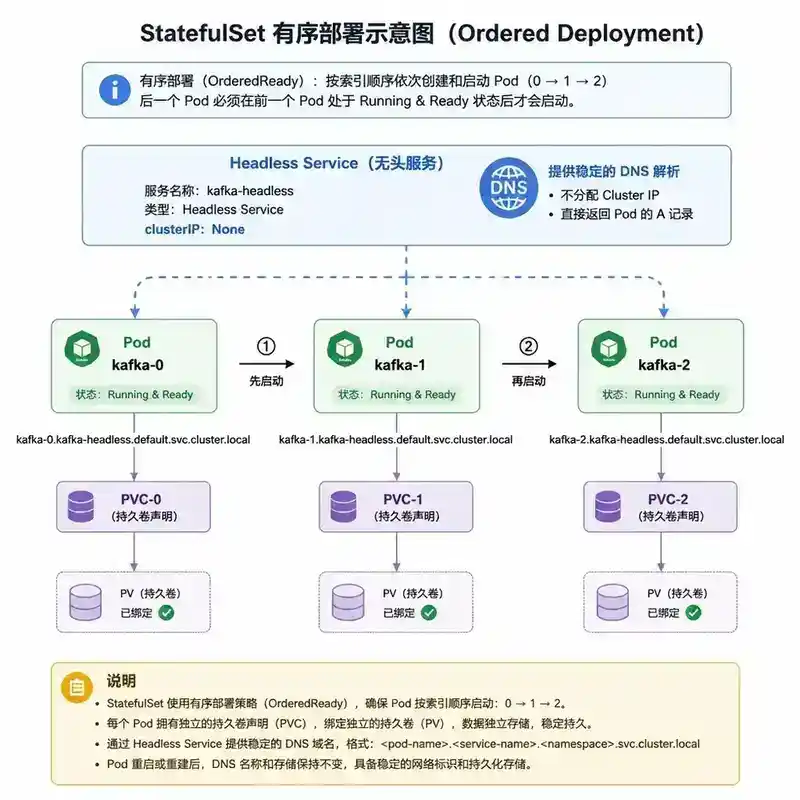
1. 稳定的网络标识 每个 Pod 有固定名称:{statefulset-name}-{ordinal},如 kafka-0、kafka-1、kafka-2。
配合 Headless Service,每个 Pod 有独立的 DNS 记录:
kafka-0.kafka-headless.default.svc.cluster.local
kafka-1.kafka-headless.default.svc.cluster.local
kafka-2.kafka-headless.default.svc.cluster.local
2. 稳定的持久化存储volumeClaimTemplates 为每个 Pod 创建独立的 PVC。Pod 重建后,同名 PVC 重新绑定——数据不丢失。PVC 的生命周期独立于 Pod,即使 StatefulSet 被删除,PVC 也不会自动删除。
3. 有序部署(podManagementPolicy: OrderedReady)
- 启动:严格按
kafka-0 → kafka-1 → kafka-2顺序,每个 Pod 必须 Ready 后才能启动下一个 - 缩容:严格按
kafka-2 → kafka-1 → kafka-0顺序,每个 Pod 必须完全停止后才能缩容下一个 - 这保证了 Kafka、ZooKeeper 等集群的 leader 选举不会混乱
4. 有序滚动更新
- 默认从最大序号开始更新,倒序进行
partition字段可以实现金丝雀更新:如果 partition=2,则只有序号 ≥2 的 Pod 更新(即 kafka-2),kafka-0 和 kafka-1 不变
4.3 Headless Service 的作用
StatefulSet 必须关联一个 clusterIP: None 的 Headless Service。它与普通 Service 的区别:
| 特性 | 普通 Service | Headless Service |
|---|---|---|
| Cluster IP | 分配一个虚拟 IP | 无 Cluster IP |
| DNS 解析 | 返回 Cluster IP | 返回所有 Pod IP |
| 用途 | 负载均衡 | 服务发现(每个 Pod 独立访问) |
对于 Kafka 这样的应用,客户端需要知道每个 broker 的地址——Headless Service 让客户端通过 DNS 发现所有 Pod。
4.4 StatefulSet vs Deployment 选型
| 场景 | 选择 | 原因 |
|---|---|---|
| 无状态 API 服务 | Deployment | 快速扩缩容,Pod 可互换 |
| 数据库、消息队列 | StatefulSet | 需要稳定网络标识和持久存储 |
| 缓存集群(Redis Cluster) | StatefulSet | 节点间需要互相识别 |
| 定时任务 | CronJob | 一次性或周期性执行 |
| 每个节点一个 Pod | DaemonSet | 日志收集、监控 agent |
五、Service:服务发现与负载均衡
5.1 Service 的本质
Service 是 Kubernetes 中最容易被误解的对象。很多人以为 Service 是一个"代理"或"负载均衡器",但实际上:
Service 是一个虚拟的、逻辑上的服务抽象——它本身不处理任何流量。 Service 本质上是一组 iptables/IPVS 规则的集合,这些规则由 kube-proxy 在节点上维护。
当你创建一个 Service 时:
- kube-proxy 在节点上添加 iptables/IPVS 规则
- 流量到达节点后,规则将流量转发到 Service 选择的后端 Pod
- Service 本身没有进程、不监听端口、不转发流量
5.2 四种 Service 类型
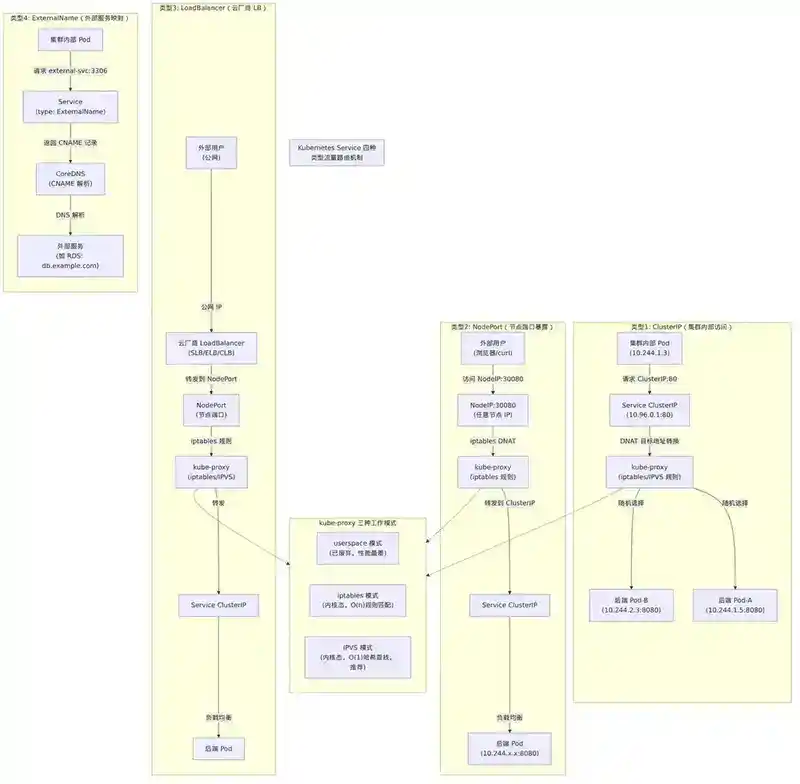
| 类型 | 访问范围 | Cluster IP | 实现方式 | 典型场景 |
|---|---|---|---|---|
| ClusterIP | 集群内部 | 分配 | iptables/IPVS | 微服务间通信 |
| NodePort | 节点 IP + 端口 | 分配 | iptables + 节点端口 | 开发测试、简单暴露 |
| LoadBalancer | 外部 | 分配 | 云厂商 LB | 生产环境外部访问 |
| ExternalName | 不适用 | 无 | DNS CNAME | 外部服务映射 |
ClusterIP 流量路径(iptables 模式):
请求 → Service ClusterIP:80
  → iptables 随机选择:
    → Pod-A 10.244.1.5:8080
    → Pod-B 10.244.2.3:8080
    → Pod-C 10.244.1.7:8080
5.3 kube-proxy 的三种模式
kube-proxy 是 Service 的底层实现引擎,有三种工作模式:
| 模式 | 原理 | 性能 | 特性 |
|---|---|---|---|
| userspace | 请求到 kube-proxy 用户态进程转发 | 最差 | 已废弃 |
| iptables | 内核态 iptables 规则转发 | 中等 | 规则数多时性能下降 |
| IPVS | 内核态 IPVS 负载均衡 | 最优 | 支持多种调度算法 |
IPVS 模式的优势:
- 支持 rr(轮询)、lc(最少连接)、dh(目标哈希)、sh(源哈希)等调度算法
- 规则数量多时性能远优于 iptables(iptables 是 O(n) 链式匹配,IPVS 是 O(1) 哈希查找)
- 生产环境强烈推荐使用 IPVS 模式
5.4 Service 与 Endpoints
Service 通过 selector 匹配 Pod 的 labels,自动创建 Endpoints 对象:
# Service 自动创建的 Endpoints
apiVersion: v1
kind: Endpoints
metadata:
  name: order-service
subsets:
- addresses:
  - ip: 10.244.1.5
  - ip: 10.244.2.3
  - ip: 10.244.1.7
  ports:
  - port: 8080
Endpoints 的更新机制:
- kube-controller-manager 中的 Endpoints Controller 持续 watch Pod 变化
- Pod 的 readinessProbe 失败 → Endpoints 摘除该 Pod IP
- 这就是为什么 readinessProbe 失败后 Pod 不会重启,但会被 Service 摘除
EndpointSlice(1.21+ GA): 当 Service 后端有大量 Pod 时,单个 Endpoints 对象会变得巨大(每次更新都要全量传输)。EndpointSlice 将 Endpoints 拆分为多个小对象,每个默认最多 100 个 endpoint,显著提升扩展性。
5.5 无 Selector 的 Service
Service 可以不设置 selector,手动创建 Endpoints:
apiVersion: v1
kind: Service
metadata:
  name: external-db
spec:
  ports:
  - port: 3306
---
apiVersion: v1
kind: Endpoints
metadata:
  name: external-db
subsets:
- addresses:
  - ip: 192.168.1.100      # 集群外部的数据库 IP
  ports:
  - port: 3306
用途:将集群外部的服务(如自建数据库、第三方 API)映射为集群内的 Service,让应用代码无需知道外部地址。
六、Ingress:七层路由与流量管理
6.1 Ingress 的工作原理
Service 解决的是四层(TCP/UDP)的流量路由问题。但在 HTTP/HTTPS 层面,我们需要更细粒度的控制:
- 根据域名路由:
api.example.com→api-service,web.example.com→web-service - 根据路径路由:
/api/v1→v1-service,/api/v2→v2-service - TLS 终止、限流、重写、跨域等七层功能
这就是 Ingress 的职责。
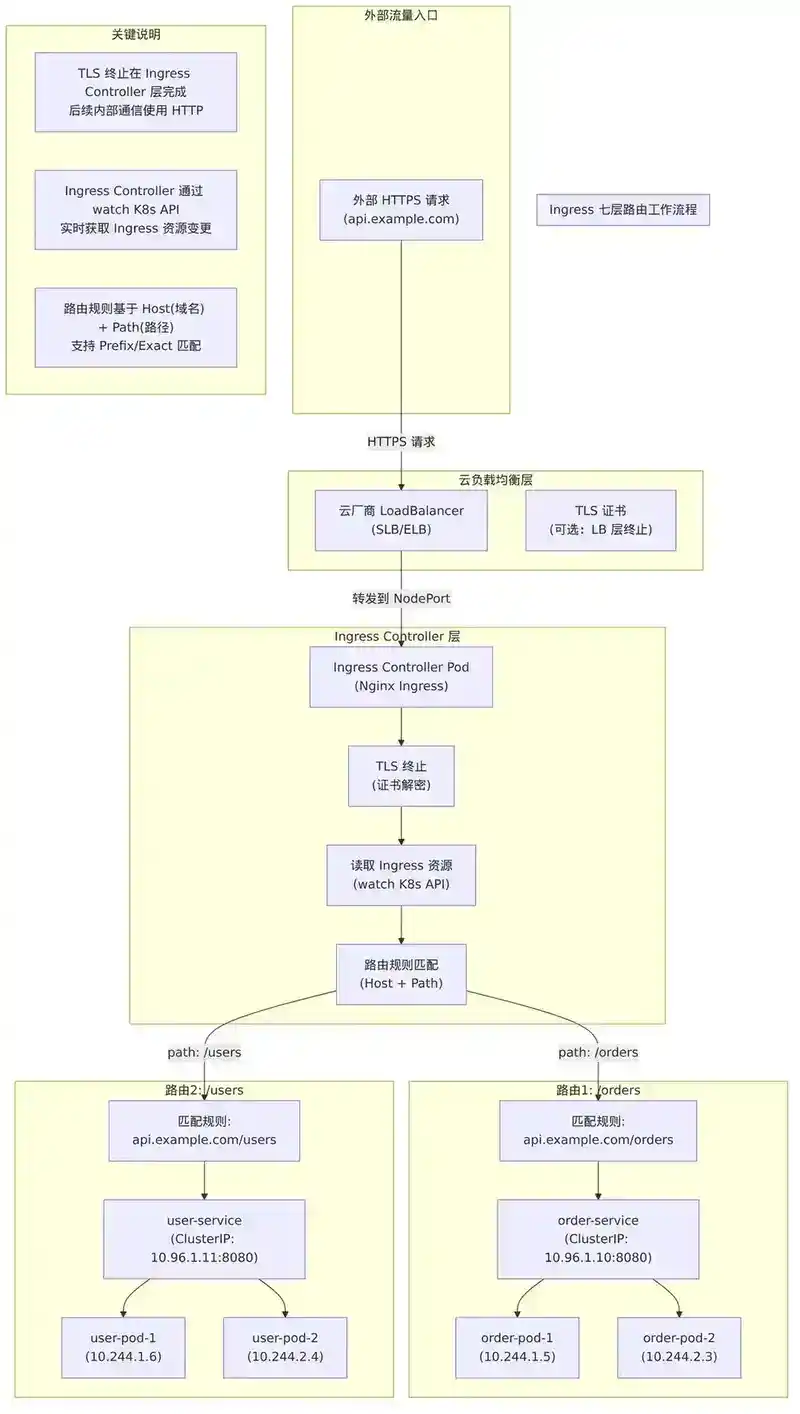
6.2 Ingress 的核心组件
Ingress 不是一个独立工作的对象——它需要三个组件配合:
| 组件 | 职责 | 示例 |
|---|---|---|
| Ingress 资源 | 声明路由规则(域名、路径、TLS) | YAML 配置 |
| Ingress Controller | 实际处理流量的控制器 Pod | Nginx Ingress、Traefik、Istio Gateway |
| LoadBalancer Service | 将外部流量导入 Ingress Controller | 云厂商 LB 或 NodePort |
apiVersion: networking.k8s.io/v1
kind: Ingress
metadata:
  name: app-ingress
  annotations:
    nginx.ingress.kubernetes.io/rewrite-target: /
    nginx.ingress.kubernetes.io/ssl-redirect: "true"
spec:
  ingressClassName: nginx
  tls:
  - hosts:
    - api.example.com
    secretName: api-tls-secret
  rules:
  - host: api.example.com
    http:
      paths:
      - path: /orders
        pathType: Prefix
        backend:
          service:
            name: order-service
            port:
              number: 8080
      - path: /users
        pathType: Prefix
        backend:
          service:
            name: user-service
            port:
              number: 8080
6.3 pathType 的三种模式
| pathType | 匹配规则 | 示例 |
|---|---|---|
| Prefix | 路径前缀匹配,/foo 匹配 /foo、/foo/bar |
最常用 |
| Exact | 精确匹配,/foo 只匹配 /foo |
健康检查端点 |
| ImplementationSpecific | 由 Ingress Controller 决定 | 取决于具体实现 |
6.4 Ingress Controller 的演进:Gateway API
Ingress 的局限性在复杂场景下逐渐暴露:
- 不同 Ingress Controller 的 annotation 互不兼容——迁移成本高
- 跨命名空间路由、流量分割、A/B 测试等高级功能需要特定 controller 支持
- 缺乏角色分离(平台管理员 vs 应用开发者)
Gateway API(K8s SIG-Network 推出的下一代入口网关标准)解决了这些问题:
# Gateway API 示例
apiVersion: gateway.networking.k8s.io/v1
kind: HTTPRoute
metadata:
  name: order-route
spec:
  parentRefs:
  - name: app-gateway
  rules:
  - matches:
    - path:
        type: PathPrefix
        value: /orders
    backendRefs:
    - name: order-service-v1
      port: 8080
      weight: 90          # 90% 流量到 v1
    - name: order-service-v2
      port: 8080
      weight: 10          # 10% 流量到 v2(金丝雀)
Ingress vs Gateway API 对比:
| 维度 | Ingress | Gateway API |
|---|---|---|
| 标准化 | 弱(依赖 annotation) | 强(原生字段) |
| 角色分离 | 无 | GatewayClass/ Gateway/ Route 三层 |
| 流量管理 | 基础路由 | 权重、镜像、header match |
| 跨命名空间 | 不支持 | 支持 |
| 生态成熟度 | 非常成熟 | 快速发展中 |
七、五个核心对象的协作关系
这五个对象不是各自孤立的——它们组合在一起,构成了 Kubernetes 应用部署的完整体系:
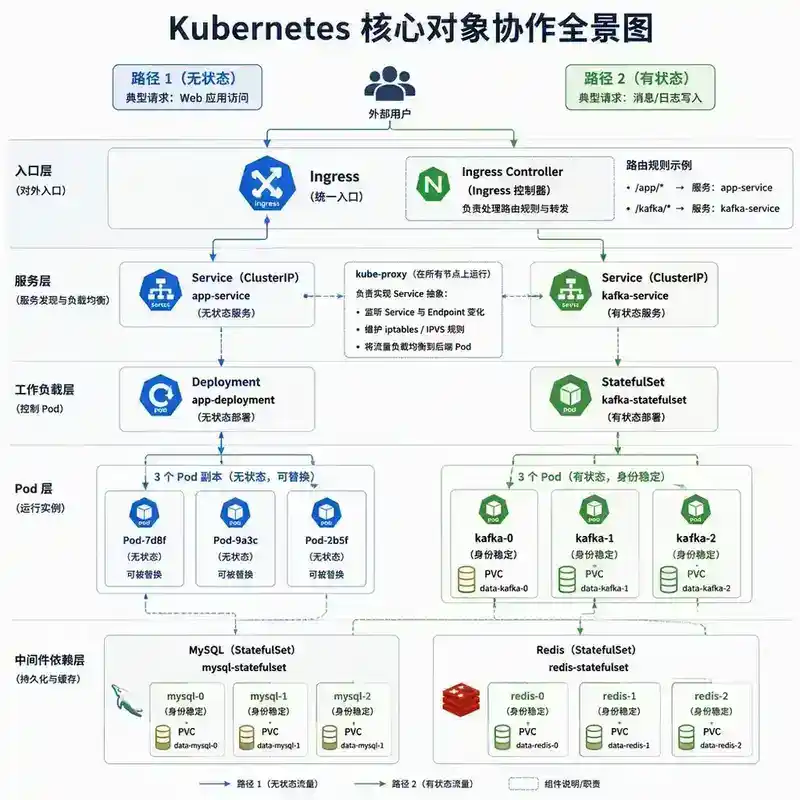
外部用户
  │
  ▼
Ingress (根据域名/路径路由)
  │
  ▼
Service (负载均衡到 Pod)
  │
  ├──▶ Pod (Deployment 管理)
  │     ├── Pod-7d8f (无状态,可替换)
  │     ├── Pod-9a3c (无状态,可替换)
  │     └── Pod-2b5f (无状态,可替换)
  │
  └──▶ Pod (StatefulSet 管理)
        ├── db-0 (有状态,稳定标识)
        ├── db-1 (有状态,稳定标识)
        └── db-2 (有状态,稳定标识)
关键协作规则:
- Deployment/StatefulSet → Pod:创建和管理 Pod 的生命周期
- Pod → Service:通过 labels 被 Service 的 selector 选中
- Service → Ingress:作为 Ingress 的 backend
- StatefulSet → Headless Service:必须关联 Headless Service 以提供稳定的 DNS
八、实战案例:一个典型的微服务部署
假设我们要在 K8s 上部署一个订单系统,包含以下组件:
- order-service(无状态 API):3 副本,滚动更新
- mysql(数据库):1 副本 StatefulSet,持久化存储
- redis(缓存):3 副本 StatefulSet,集群模式
- nginx(Ingress):入口路由,TLS 终止
完整部署架构:
                       ┌──────────────┐
                       │  Cloud LB    │
                       └──────┬───────┘
                              │
                       ┌──────▼───────┐
                       │ Nginx Ingress│  (Ingress Controller)
                       │  Controller  │
                       └──────┬───────┘
                              │
              ┌───────────────┼───────────────┐
              │               │               │
     ┌────────▼─────┐  ┌─────▼──────┐  ┌─────▼──────┐
     │ order-svc    │  │ user-svc   │  │ gateway    │
     │ (ClusterIP)  │  │ (ClusterIP)│  │ (ClusterIP)│
     └──────┬───────┘  └─────┬──────┘  └─────┬──────┘
            │                │                │
     ┌──────▼───────┐  ┌─────▼──────┐  ┌─────▼──────┐
     │ order-deploy │  │ user-deploy│  │ gateway    │
     │  (Deploy)    │  │  (Deploy)  │  │ (Deploy)   │
     └──────┬───────┘  └────────────┘  └────────────┘
            │
     ┌──────┼──────────────────┐
     │      │                  │
┌────▼──┐ ┌─▼──────┐  ┌───────▼──┐
│ MySQL │ │ Redis  │  │ RocketMQ │
│  STS  │ │  STS   │  │   STS    │
│(1副本)│ │(3副本) │  │ (2副本)  │
└───────┘ └────────┘  └──────────┘
关键配置要点:
- Deployment 的 readinessProbe:检查数据库连接、Redis 连接是否就绪,而不仅仅是 HTTP 200
- StatefulSet 的 podManagementPolicy:数据库用
OrderedReady,缓存集群可用Parallel加速启动 - Service 的 sessionAffinity:如果应用使用了 session sticky,需要设置
sessionAffinity: ClientIP - Ingress 的 CORS 配置:通过 annotation 配置跨域,而不是在应用代码中配置
九、常见生产环境问题与排查思路
9.1 Pod 一直 Pending
原因排查优先级:
kubectl describe pod查看 Events- 最常见原因:资源不足(CPU/内存不够)、PVC 未绑定、节点有 taint/toleration 不匹配
- 镜像拉取失败(ImagePullBackOff)——检查镜像仓库权限和镜像 tag 是否正确
9.2 Service 访问不到 Pod
排查步骤:
- 确认 Service 的 selector 和 Pod 的 labels 是否匹配(
kubectl get endpoints检查) - 确认 Pod 的 readinessProbe 是否通过(
kubectl get pods -o wide查看 READY 列) - 确认 kube-proxy 规则是否生效(进节点
iptables -t nat -L | grep <service-name>) - 确认网络插件(CNI)是否正常工作
9.3 Deployment 滚动更新卡住
常见原因:
- 新 Pod 的 readinessProbe 一直失败 → 卡在"等待新 Pod ready"
maxUnavailable=0且maxSurge=0→ 没有余量,无法更新- 新 Pod 无法调度(资源不足)→ 卡在 Pending
9.4 StatefulSet Pod 无法启动
排查重点:
- PVC 是否绑定成功(
kubectl get pvc) - 前一个序号的 Pod 是否 Ready(OrderedReady 策略下,Pod-1 必须等 Pod-0 Ready)
- 存储后端是否正常(CSI driver 问题)
十、面试问答
以下问题从面试官视角设计,考察对 Kubernetes 核心对象的深入理解。先尝试自己回答,再对照参考答案。
Q1:Service 的 ClusterIP 模式是如何实现负载均衡的?流量真的经过 ClusterIP 这个虚拟 IP 吗?
面试官意图:考察对 kube-proxy 原理的理解,区分"逻辑抽象"和"物理实现"。
参考答案:流量不经过 ClusterIP 这个虚拟 IP——它只是一个逻辑标识。实际上,kube-proxy 在节点上维护 iptables/IPVS 规则,这些规则将目标地址为 ClusterIP 的流量随机转发到后端 Pod 的 IP。以 iptables 模式为例:每个 Service 创建一条 iptables 链,链中为每个后端 Pod 创建一条规则,用 statistic 模块实现随机选择。这本质上是 DNAT(目标地址转换)——流量到达节点后,内核将目标地址从 ClusterIP 改为 Pod IP,然后走正常的网络栈转发。
Q2:Deployment 的滚动更新过程中,如果新 Pod 的 readinessProbe 一直失败,会发生什么?旧 Pod 会被删除吗?
面试官意图:考察对滚动更新安全机制的深入理解。
参考答案:不会。Deployment Controller 的逻辑是:先创建新 Pod → 等待新 Pod Ready → 再删除旧 Pod。如果新 Pod 的 readinessProbe 一直失败,Controller 会一直等待(不会删除旧 Pod),最终滚动更新超时,但旧 Pod 完好无损。这就是 Deployment 的"安全失败"设计——宁可更新失败,也不影响线上服务。排查方法是 kubectl describe deployment 查看 Conditions,以及 kubectl logs 查看新 Pod 的启动日志。
Q3:StatefulSet 的 Pod 挂了,重建后 IP 会变吗?为什么?
面试官意图:考察对 StatefulSet 网络标识机制的理解,以及和 Deployment 的区别。
参考答案:Pod 的 IP 会变,但 DNS 名称不变。StatefulSet 保证的是稳定的网络标识({name}-{ordinal}.{headless-service}.{namespace}.svc.cluster.local),而不是 IP 地址。Pod 重建后,DNS 记录会更新指向新 IP。这就是为什么有状态应用(如 Kafka)应该通过 DNS 名称(kafka-0.kafka-headless)而不是 IP 地址来互相发现——DNS 名称是稳定的,IP 是临时的。这也是为什么 StatefulSet 必须关联 Headless Service——它需要 DNS 来提供稳定的网络标识。
Q4:Ingress 和 Service(LoadBalancer 类型)的区别是什么?什么时候用 Ingress,什么时候用 LoadBalancer Service?
面试官意图:考察对四层和七层负载均衡的理解,以及架构选型能力。
参考答案:核心区别是工作层级:Service(LoadBalancer)工作在四层,只能按 IP:Port 转发,无法按域名/路径路由;Ingress 工作在七层,可以按 HTTP Host/Path 路由,支持 TLS 终止、限流、重写等高级功能。选型:如果只有一个服务需要暴露,用 LoadBalancer Service 最简单;如果多个服务需要共享同一个入口(按域名/路径区分),用 Ingress 可以节省 LB 成本(一个 LB 服务多个应用)。生产环境的标准做法是:一个 Ingress Controller(用 LoadBalancer Service 暴露)+ 多个 Ingress 资源定义路由规则。
Q5:Pod 的 requests 和 limits 有什么区别?如果只设置 limits 不设置 requests 会怎样?
面试官意图:考察对资源管理和 QoS 机制的理解。
参考答案:requests 是调度器用来决定 Pod 放在哪里的"保证资源量",limits 是容器能使用的上限。如果只设置 limits 不设置 requests,K8s 会自动将 requests 设为等于 limits——这意味着这个 Pod 的 QoS 等级是 Guaranteed(最高优先级,最不容易被 OOM Kill)。但这个行为可能不是你想要的:如果 limits 设得很大,requests 也会变得很大,导致调度器找不到足够资源的节点,Pod 一直 Pending。最佳实践:requests 和 limits 分开设置,requests 根据实际使用量设置(加 20% buffer),limits 根据容量规划设置。
Q6:如果你要设计一个零宕机时间的滚动更新方案,需要考虑哪些因素?
面试官意图:考察系统设计能力和对 Kubernetes 机制的综合运用。
参考答案:零宕机滚动更新需要考虑以下方面:
- Pod 层面:配置正确的
readinessProbe(确保新 Pod 完全就绪后才接受流量)和preStophook(给旧 Pod 足够时间处理完现有请求,建议 sleep 5-10 秒) - Deployment 层面:设置
maxSurge > 0且maxUnavailable = 0,确保更新期间可用副本数不减少 - Service 层面:确认
publishNotReadyAddresses: false(默认),确保未就绪的 Pod 不会被加入 Service 后端 - 应用层面:应用需要处理 SIGTERM 信号,实现优雅关闭(Spring Boot 的
graceful shutdown);应用需要无状态或外部化状态 - Ingress 层面:如果有 Ingress,确认 Ingress Controller 的端点更新延迟(通常几秒),避免短暂地将流量路由到已终止的 Pod
- 数据库兼容:确保新旧版本应用兼容同一数据库 schema(先执行数据库迁移,再更新应用)
本文完。 下一篇预告:236|Kubernetes 调度器原理:资源调度、亲和性、污点容忍与自定义调度器。