考点 236|阅读时间约 45 分钟 涵盖:调度器原理、亲和性、污点容忍、QoS 与自动伸缩
一、引言:为什么调度与资源管理是 K8s 的核心
Kubernetes 的本质是一个分布式资源编排系统。它把成百上千台物理机/虚拟机抽象为一个统一的资源池,然后回答两个核心问题:
- Pod 应该跑在哪台机器上?(调度)
- 每个 Pod 能用多少资源?不够了怎么办?(资源管理)
这两个问题看似简单,但在一套承载数千个服务、数十万容器的生产集群中,调度决策的质量直接影响集群的资源利用率、服务稳定性、故障恢复能力。一个糟糕的调度策略可能在流量高峰时将关键服务集中到少数节点,导致雪崩;一个不合理的资源限制可能让 JVM 应用被 OOM Killer 反复杀死。
本文从调度器内部原理出发,逐步覆盖亲和性、污点容忍、QoS 模型和自动伸缩,帮你建立完整的知识体系。
二、调度器原理:从 Pod 创建到节点绑定
2.1 调度器在 K8s 架构中的位置
Pod 的创建流程中,调度器是承上启下的关键环节:
用户/Controller 创建 Pod → API Server 写入 etcd
    → Scheduler Watch 到未调度的 Pod(nodeName 为空)
        → 执行调度算法,选出最优节点
            → 向 API Server 写入 Binding(设置 nodeName)
                → 目标节点 kubelet 感知到 Binding,拉取镜像启动容器
调度器不直接操作 Pod,而是通过 API Server 的 Watch 机制异步工作。整个过程是声明式 + 异步的,这也是 K8s 控制循环(Control Loop)的核心范式。
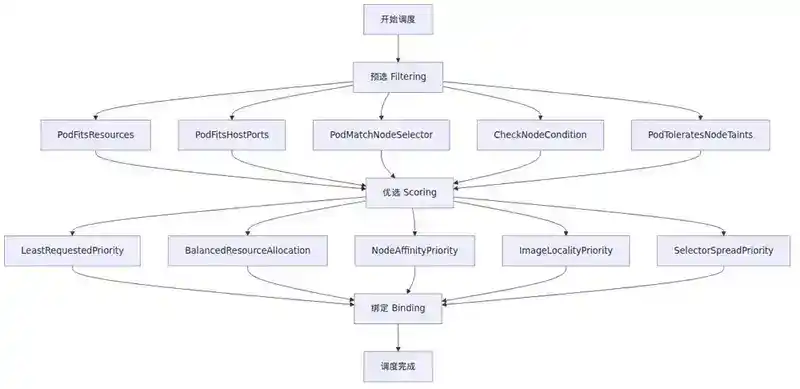
2.2 调度流程:预选 → 优选 → 绑定

kube-scheduler 的默认调度过程分为三个阶段:
阶段一:预选(Filtering / Predicates)
预选阶段的目的是一票否决:把明显不满足 Pod 需求的节点全部过滤掉。常见的预选规则包括:
| 预选规则 | 作用 |
|---|---|
PodFitsResources |
节点剩余 CPU/内存是否满足 Pod 的 requests |
PodFitsHostPorts |
Pod 声明的 HostPort 是否被占用 |
PodMatchNodeSelector |
节点标签是否匹配 Pod 的 nodeSelector |
CheckNodeCondition |
节点是否处于 Ready 状态 |
NoDiskConflict |
声明的 GCE PD/AWS EBS 卷是否冲突 |
PodToleratesNodeTaints |
Pod 是否能容忍节点的所有污点 |
预选是并发执行的,各规则独立判断,任一规则不通过则节点被淘汰,不进入后续阶段。
阶段二:优选(Scoring / Priorities)
预选后剩余的节点进入优选阶段,每个节点被若干打分函数评分,最后加权求和得到总分。默认的打分函数包括:
| 打分函数 | 逻辑 |
|---|---|
LeastRequestedPriority |
已用资源越少,分越高(倾向于打散) |
MostRequestedPriority |
已用资源越多,分越高(倾向于装箱,未默认启用) |
BalancedResourceAllocation |
CPU 和内存使用比例越均衡,分越高 |
NodeAffinityPriority |
匹配 Pod 亲和性偏好时加分 |
TaintTolerationPriority |
匹配容忍时加分 |
ImageLocalityPriority |
节点已有镜像时加分(减少拉取时间) |
SelectorSpreadPriority |
将同一 Service/Controller 的 Pod 分散到不同节点 |
每个打分函数返回 0-10 分,最终分数 = Σ(权重 × 打分函数得分)。调度器选择总分最高的节点。
阶段三:绑定(Binding)
选定最优节点后,调度器向 API Server 提交一个 Binding 对象。这一步是乐观并发的——如果这期间节点资源被其他 Pod 占用导致不满足条件,kubelet 会执行 Admission 检查并拒绝,调度器重新调度。
2.3 调度框架(Scheduling Framework)
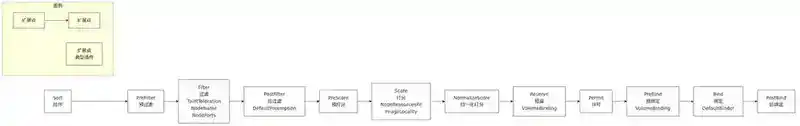
从 Kubernetes 1.15 开始,调度器被重构为插件化架构——调度框架(Scheduling Framework)。一个 Pod 的调度过程经过一系列扩展点,每个扩展点可以注册多个插件:
Sort → PreFilter → Filter → PostFilter → PreScore → Score → NormalizeScore → Reserve → Permit → PreBind → Bind → PostBind
| 扩展点 | 作用 | 典型插件 |
|---|---|---|
Sort |
对等待调度的 Pod 排序 | PrioritySort |
PreFilter |
预处理 Pod 信息,计算 Filter 所需的共享数据 | NodeResourcesFit |
Filter |
等同于预选,过滤不合规节点 | NodeUnschedulable, NodePorts, TaintToleration |
PostFilter |
Filter 后无可用节点时介入(如抢占) | DefaultPreemption |
PreScore |
打分前预处理 | InterPodAffinity |
Score |
对节点打分 | NodeResourcesFit, ImageLocality |
NormalizeScore |
分数归一化 | — |
Reserve |
预留资源,防止资源被其他 Pod 占用 | VolumeBinding |
Permit |
允许/拒绝/等待调度 | — |
PreBind |
绑定前准备工作(如挂载卷) | VolumeBinding |
Bind |
执行绑定 | DefaultBinder |
PostBind |
绑定后通知 | — |
这种设计让调度器高度可扩展。你可以用 Go 编写自定义插件并编译进调度器,也可以通过 Scheduler Extender(HTTP 回调)实现外部扩展。
2.4 多调度器与自定义调度器
一个集群可以运行多个调度器。Pod 通过 spec.schedulerName 指定使用哪个调度器:
apiVersion: v1
kind: Pod
metadata:
  name: my-pod
spec:
  schedulerName: my-custom-scheduler  # 默认是 default-scheduler
  containers:
  - name: app
    image: nginx
自定义调度器的典型场景:
- GPU 调度:根据 GPU 型号、拓扑亲和性做精细化调度(如 Volcano)
- 批处理调度:支持 Gang Scheduling(一批任务同时启动,否则都不启动)
- 成本优化:优先调度到竞价实例,失败再回退到按量实例
三、亲和性:精确控制 Pod 的"邻居"关系
Pod 默认可以被调度到任何满足资源需求的节点。但实际生产环境中,我们经常需要更精细的控制。亲和性(Affinity)就是为此设计的。
3.1 节点亲和性(Node Affinity)
节点亲和性让 Pod 表达"我想调度到(或不想调度到)具有特定标签的节点"。
两种策略:
requiredDuringSchedulingIgnoredDuringExecution:硬约束,必须满足,否则 Pod 无法调度preferredDuringSchedulingIgnoredDuringExecution:软偏好,尽量满足,不满足也可以调度
注意名称中的 IgnoredDuringExecution:亲和性只在调度时生效,Pod 运行后如果节点标签变化,不会驱逐 Pod。
apiVersion: v1
kind: Pod
metadata:
  name: gpu-pod
spec:
  affinity:
    nodeAffinity:
      # 硬约束:节点必须有 gpu-type=nvidia-a100 标签
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: gpu-type
            operator: In
            values:
            - nvidia-a100
            - nvidia-h100
      # 软偏好:优先选择 ssd=true 的节点
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 80
        preference:
          matchExpressions:
          - key: disk-type
            operator: In
            values:
            - ssd
      - weight: 20
        preference:
          matchExpressions:
          - key: zone
            operator: In
            values:
            - zone-a
  containers:
  - name: training
    image: pytorch/pytorch:latest
关键点:
matchExpressions支持In、NotIn、Exists、DoesNotExist、Gt、Lt等操作符- 软偏好中的
weight是 1-100 的权重,多个偏好加权求和 nodeSelectorTerms之间是 OR 关系,内部的matchExpressions是 AND 关系
3.2 Pod 亲和性与反亲和性(Pod Affinity / Anti-Affinity)
Pod 亲和性控制的是 Pod 与 Pod 之间的关系——不是"Pod 想去什么节点",而是"Pod 想和哪些 Pod 做邻居"。
两种类型:
podAffinity:与指定 Pod 调度到同一拓扑域(如同一节点、同一可用区)podAntiAffinity:与指定 Pod 调度到不同拓扑域
关键概念:拓扑域(topologyKey)
topologyKey 定义了"邻居"的范围——是一个 Kubernetes 节点标签。常见值:
| topologyKey | 含义 |
|---|---|
kubernetes.io/hostname |
同一节点(主机名) |
topology.kubernetes.io/zone |
同一可用区 |
topology.kubernetes.io/region |
同一地域 |
apiVersion: apps/v1
kind: Deployment
metadata:
  name: redis
  labels:
    app: redis
spec:
  replicas: 3
  selector:
    matchLabels:
      app: redis
  template:
    metadata:
      labels:
        app: redis
    spec:
      affinity:
        # 反亲和性:不要把同一个 Redis 的多个副本调度到同一节点
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchExpressions:
              - key: app
                operator: In
                values:
                - redis
            topologyKey: kubernetes.io/hostname
      containers:
      - name: redis
        image: redis:7
这个配置确保 Redis 的 3 个副本分布在 3 个不同节点上(如果集群满足条件),避免单节点故障导致所有副本同时不可用。
Pod 亲和性的典型应用:
# 将 Web 应用调度到与 Redis 同一节点,减少网络延迟
affinity:
  podAffinity:
    requiredDuringSchedulingIgnoredDuringExecution:
    - labelSelector:
        matchExpressions:
        - key: app
          operator: In
          values:
          - redis
      topologyKey: kubernetes.io/hostname
性能注意事项:
- Pod 亲和性/反亲和性在大规模集群中开销较大,因为调度器需要扫描所有符合标签的 Pod
- 如果节点数很少但
requiredDuringScheduling的反亲和性要求很高,会导致 Pod 永远无法调度 - 尽量使用
preferredDuringScheduling而不是required,给调度器更多灵活性
3.3 nodeSelector vs Node Affinity
nodeSelector 是最简单的节点选择方式,但功能有限——只支持精确的 key=value 匹配(AND 逻辑)。Node Affinity 是 nodeSelector 的超集,支持:
- 表达式匹配(In、NotIn、Exists、Gt、Lt)
- 软偏好(preferred)+ 硬约束(required)
- 多个 nodeSelectorTerms 间的 OR 逻辑
实际生产环境中,优先使用 Node Affinity 替代 nodeSelector。
四、污点与容忍:反向控制节点准入
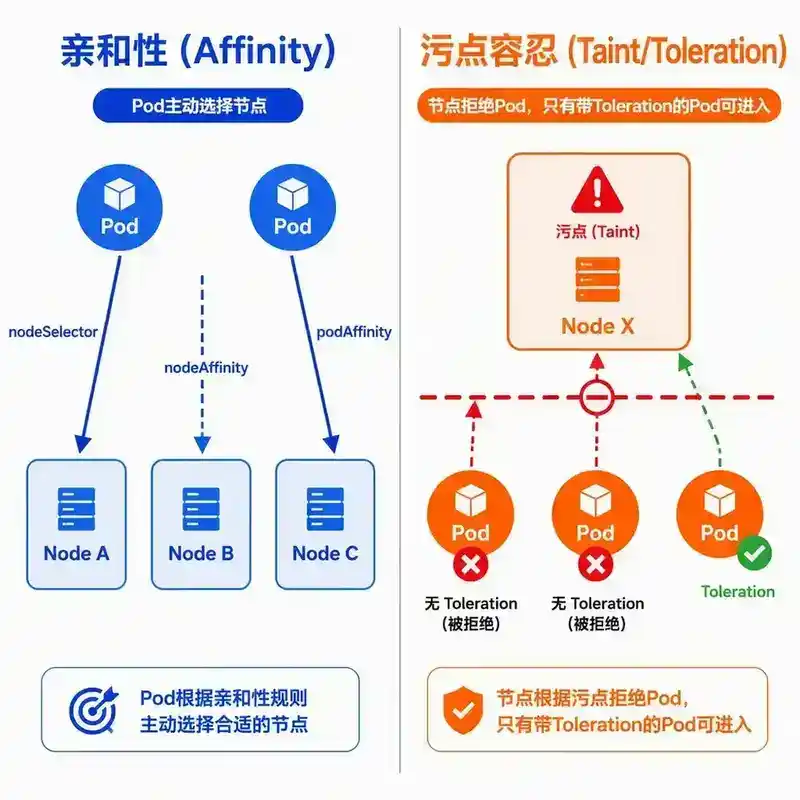
亲和性是 Pod "选择"节点的机制,而**污点(Taint)和容忍(Toleration)**是节点"拒绝"Pod 的机制——两者是同一个硬币的两面。
4.1 核心概念
- Taint(污点):打在节点上,表示"这个节点有某种限制"
- Toleration(容忍):写在 Pod 上,表示"这个 Pod 能接受某种限制"
一个节点可以有多个 Taint,一个 Pod 可以有多个 Toleration。Pod 能被调度到某个节点,当且仅当它容忍了该节点的所有 Taint。
4.2 Taint 的组成
kubectl taint nodes node1 key1=value1:NoSchedule
#                    │     │      │      └── Effect(效果)
#                    │     │      └── Value(值)
#                    │     └── Key(键)
#                    └── 节点名
一个 Taint 由三部分组成:key=value:effect。value 可以省略(key:effect)。
三种 Effect:
| Effect | 行为 |
|---|---|
NoSchedule |
不调度新 Pod 到此节点(已有 Pod 不受影响) |
PreferNoSchedule |
尽量不调度新 Pod(软约束) |
NoExecute |
不调度新 Pod,且驱逐已有不匹配容忍的 Pod |
NoExecute 是最强力的——它不仅阻止新 Pod,还会驱逐已在运行的 Pod。可以配合 tolerationSeconds 给 Pod 一个"宽限期":
tolerations:
- key: node.kubernetes.io/not-ready
  operator: Exists
  effect: NoExecute
  tolerationSeconds: 300   # 节点 NotReady 后 300 秒才被驱逐
4.3 Toleration 匹配规则
apiVersion: v1
kind: Pod
metadata:
  name: special-pod
spec:
  tolerations:
  # 容忍所有带有 key=special 且 effect=NoSchedule 的污点
  - key: special
    operator: Equal
    value: "true"
    effect: NoSchedule
  # 容忍所有带有 key=gpu 的污点,不管 value 和 effect
  - key: gpu
    operator: Exists
  containers:
  - name: app
    image: nginx
匹配规则:
operator: Equal:key、value、effect 三者完全匹配operator: Exists:key 匹配即可,value 和 effect 无所谓- 空的
key+operator: Exists匹配所有(很少用) - 空的
effect匹配所有 effect
4.4 内置污点:K8s 的自动保护机制
Kubernetes 的节点控制器(Node Controller)会自动给异常节点打上污点,保护集群稳定性:
| 内置污点 | 触发条件 |
|---|---|
node.kubernetes.io/not-ready:NoExecute |
节点 NotReady |
node.kubernetes.io/unreachable:NoExecute |
节点不可达 |
node.kubernetes.io/out-of-disk:NoSchedule |
磁盘空间不足 |
node.kubernetes.io/memory-pressure:NoSchedule |
内存压力 |
node.kubernetes.io/disk-pressure:NoSchedule |
磁盘压力 |
node.kubernetes.io/pid-pressure:NoSchedule |
PID 压力 |
node.kubernetes.io/network-unavailable:NoSchedule |
网络不可用 |
node.kubernetes.io/unschedulable:NoSchedule |
节点被 cordon |
这些内置污点与 tolerationSeconds 配合,构成了 K8s 的自动故障转移机制。一个没有显式容忍这些污点的普通 Pod,实际上被 K8s 自动添加了默认容忍:
# K8s 自动为 Pod 添加的默认容忍
tolerations:
- key: node.kubernetes.io/not-ready
  operator: Exists
  effect: NoExecute
  tolerationSeconds: 300
- key: node.kubernetes.io/unreachable
  operator: Exists
  effect: NoExecute
  tolerationSeconds: 300
这意味着节点 NotReady 后,Pod 有 300 秒的容忍时间,之后才会被驱逐到其他节点。
4.5 实战场景:专用节点池
一个典型的生产集群资源隔离方案,结合 Node Affinity + Taint/Toleration:
# 给 GPU 节点打上标签和污点
kubectl label node gpu-node-1 node-role=gpu
kubectl label node gpu-node-2 node-role=gpu
kubectl taint node gpu-node-1 gpu=true:NoSchedule
kubectl taint node gpu-node-2 gpu=true:NoSchedule

# 给高内存节点打标签
kubectl label node mem-node-1 node-role=memory-intensive
kubectl label node mem-node-2 node-role=memory-intensive
# GPU 任务的 Pod 配置
spec:
  tolerations:
  - key: gpu
    operator: Equal
    value: "true"
    effect: NoSchedule
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: node-role
            operator: In
            values:
            - gpu
这样 GPU 节点只接受专门配置了容忍的 GPU Pod,普通 Pod 不会被调度到 GPU 节点上——同时 GPU Pod 也只调度到 GPU 节点。
设计原则:
- Taint/Toleration 控制准入(能不能来)
- Node Affinity 控制倾向(想去哪)
- 两者配合做独占式节点池:Taint 排斥其他 Pod,Node Affinity 确保 Pod 只去目标节点
五、QoS 模型:资源不足时,先杀谁?
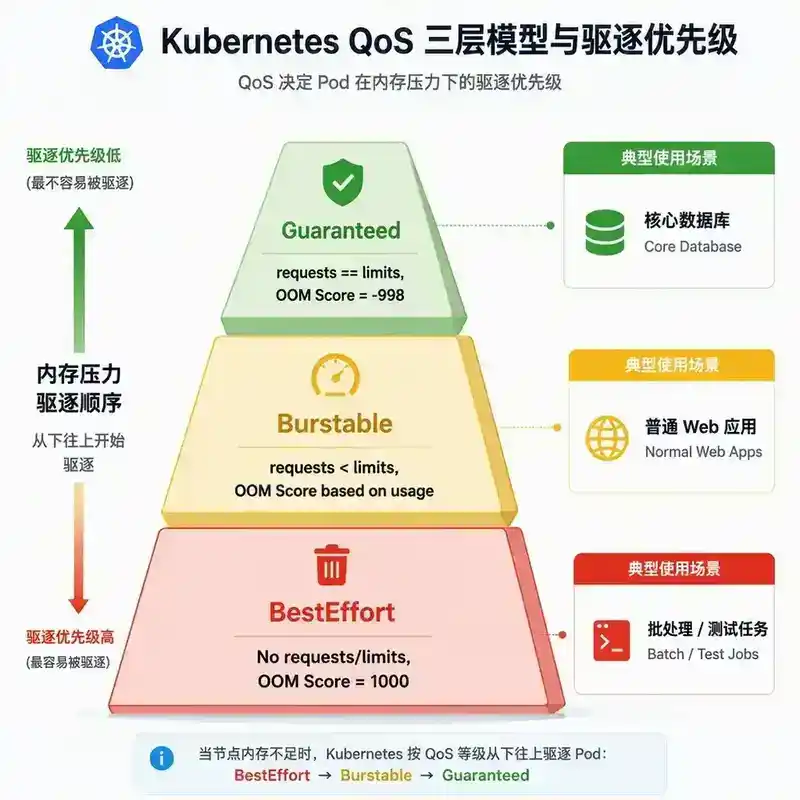
Kubernetes 通过 QoS(Quality of Service) 模型对 Pod 进行分级。当节点资源(尤其是内存)紧张时,kubelet 按照 QoS 等级从低到高驱逐 Pod。
5.1 三种 QoS 等级
QoS 等级由 Pod 中每个容器的 requests 和 limits 决定,具体规则:
| QoS 等级 | 判定条件 |
|---|---|
| Guaranteed | 每个容器都设置了 CPU 和 Memory 的 requests 和 limits,且 requests == limits |
| Burstable | 至少一个容器设置了 requests 或 limits,但不满足 Guaranteed 条件 |
| BestEffort | 没有任何容器设置 requests 或 limits |
# Guaranteed:requests == limits
spec:
  containers:
  - name: app
    image: myapp:latest
    resources:
      requests:
        cpu: "500m"
        memory: "512Mi"
      limits:
        cpu: "500m"
        memory: "512Mi"

# Burstable:requests < limits
spec:
  containers:
  - name: app
    image: myapp:latest
    resources:
      requests:
        cpu: "250m"
        memory: "256Mi"
      limits:
        cpu: "1000m"
        memory: "1Gi"

# BestEffort:没有 resources 配置
spec:
  containers:
  - name: app
    image: myapp:latest
5.2 驱逐顺序与 OOM Score
当节点内存不足时,kubelet 的驱逐顺序:
BestEffort → Burstable(使用量超过 requests 的) → Burstable(使用量不超过 requests 的) → Guaranteed
底层实现依赖于 Linux 的 OOM Score。kubelet 根据 QoS 等级计算 OOM Score:
- Guaranteed:OOM Score = -998(几乎不会被 OOM Killer 杀死)
- BestEffort:OOM Score = 1000(最先被杀死)
- Burstable:OOM Score = 基于内存使用量计算,越接近 limit 分数越高
OOM Score 范围是 -1000 到 1000,分数越高越容易被杀死。可以通过以下命令查看:
# 进入容器查看 OOM Score
cat /proc/1/oom_score
cat /proc/1/oom_score_adj
5.3 资源驱逐机制
除了 Node 级别的 OOM,kubelet 还有一套软驱逐和硬驱逐机制:
硬驱逐(Hard Eviction):资源使用量达到阈值,立即驱逐 Pod。
# kubelet 配置
evictionHard:
  memory.available: "200Mi"       # 可用内存 < 200Mi 时驱逐
  nodefs.available: "10%"         # 磁盘可用 < 10% 时驱逐
  nodefs.inodesFree: "5%"         # inode 可用 < 5% 时驱逐
  imagefs.available: "15%"        # 镜像文件系统可用 < 15% 时驱逐
软驱逐(Soft Eviction):资源使用量超过阈值并持续一段时间后驱逐。
evictionSoft:
  memory.available: "500Mi"
evictionSoftGracePeriod:
  memory.available: "1m30s"       # 超过阈值 90 秒后才驱逐
5.4 生产实践建议
- 关键服务使用 Guaranteed QoS:确保核心服务在内存压力下不会被驱逐
- 为所有容器设置 requests:这是调度的基础依据,缺失 requests 会导致调度器无法做出正确的资源判断
- limits 不应过高:过高的 limits 导致节点过度承诺(overcommit),增加 OOM 风险
- CPU 是可压缩资源:CPU 不够时 Pod 会被 throttle(限速),但不会被杀死;内存是不可压缩资源,不够就会 OOM Kill
- 监控 Pod 驱逐事件:频繁的驱逐表明集群资源不足或 Pod 配置不合理
六、自动伸缩:让集群随负载呼吸
Kubernetes 提供了多维度的自动伸缩能力,覆盖 Pod 层面和节点层面。
6.1 HPA:水平 Pod 自动伸缩
HPA(Horizontal Pod Autoscaler)根据 CPU/内存使用率或自定义指标,自动调整 Deployment、StatefulSet 的副本数。
核心原理:
HPA 控制器每隔 15 秒(可通过 --horizontal-pod-autoscaler-sync-period 调整)
    → 从 Metrics API 获取当前指标值
        → 计算 desiredReplicas = ceil(currentReplicas × (currentMetric / targetMetric))
            → 调整 Deployment 的 replicas 字段
计算公式:
desiredReplicas = ceil(currentReplicas × (currentMetricValue / desiredMetricValue))
例如:当前 3 个副本,CPU 使用率 80%,目标 50% → desiredReplicas = ceil(3 × 80/50) = 5
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 2
  maxReplicas: 10
  metrics:
  # CPU 指标
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 60
  # 内存指标
  - type: Resource
    resource:
      name: memory
      target:
        type: AverageValue
        averageValue: 512Mi
  # 自定义指标(需要 Prometheus Adapter 等)
  - type: Pods
    pods:
      metric:
        name: http_requests_per_second
      target:
        type: AverageValue
        averageValue: "1000"
  behavior:
    # 扩容行为
    scaleUp:
      stabilizationWindowSeconds: 0    # 扩容不等待,立即响应
      policies:
      - type: Percent
        value: 100
        periodSeconds: 15              # 每 15 秒最多翻倍
      - type: Pods
        value: 4
        periodSeconds: 15              # 每 15 秒最多增加 4 个 Pod
      selectPolicy: Max
    # 缩容行为
    scaleDown:
      stabilizationWindowSeconds: 300  # 缩容前等待 5 分钟,防止抖动
      policies:
      - type: Pods
        value: 1
        periodSeconds: 60              # 每分钟最多减少 1 个 Pod
HPA 的局限:
- 依赖 Metrics Server 或自定义 Metrics API
- 基于 CPU/内存的 HPA 响应较慢(需要积累足够的数据点)
- 无法处理"冷启动"场景(从 0 副本开始)
6.2 VPA:垂直 Pod 自动伸缩
VPA(Vertical Pod Autoscaler)自动调整 Pod 的 requests 和 limits,而不是副本数。适用于"请求量稳定但资源配置不合理"的场景。
VPA 有三种运行模式:
| 模式 | 行为 |
|---|---|
Off |
只提供建议,不自动调整 |
Initial |
只在 Pod 创建时设置 resources |
Auto |
自动调整(会驱逐 Pod 重建) |
Recreate |
自动调整,驱逐重建 Pod |
apiVersion: autoscaling.k8s.io/v1
kind: VerticalPodAutoscaler
metadata:
  name: myapp-vpa
spec:
  targetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  updatePolicy:
    updateMode: Auto
  resourcePolicy:
    containerPolicies:
    - containerName: '*'
      minAllowed:
        cpu: "100m"
        memory: "128Mi"
      maxAllowed:
        cpu: "2"
        memory: "4Gi"
      controlledResources: ["cpu", "memory"]
注意:VPA 和 HPA 的冲突
VPA 修改 requests 会改变 HPA 的 CPU 利用率计算基准,两者同时使用可能导致行为异常。如果需要同时使用,设置 VPA 为 Off 模式(仅建议),或使用 controlledResources 限制 VPA 只调整内存。
6.3 Cluster Autoscaler:节点级自动伸缩
Cluster Autoscaler(CA)在集群层面自动增减节点:
- 扩容:当有 Pod 因资源不足无法调度(Pending 状态)时,CA 向云厂商申请新节点
- 缩容:当节点利用率持续低于阈值,CA 将 Pod 重新调度到其他节点后,回收空闲节点
CA 工作流程:
1. 每 10 秒检查是否有 Pending Pod
2. 如果有 Pending Pod 且现有节点无法满足:
   → 判断节点组(Node Group)是否在最大节点数限制内
   → 调用云厂商 API 增加节点
3. 每 10 秒检查是否有低利用率节点:
   → 节点上 Pod 的 requests 总和 < 节点容量的 50%(默认)
   → 节点上的 Pod 可以安全迁移到其他节点
   → 调用云厂商 API 删除节点
CA 与 HPA 的配合:
流量增加 → HPA 扩容 Pod → Pod Pending(资源不足) → CA 增加节点 → Pod 调度成功
流量减少 → HPA 缩容 Pod → 节点空闲 → CA 回收节点
6.4 KEDA:事件驱动的自动伸缩
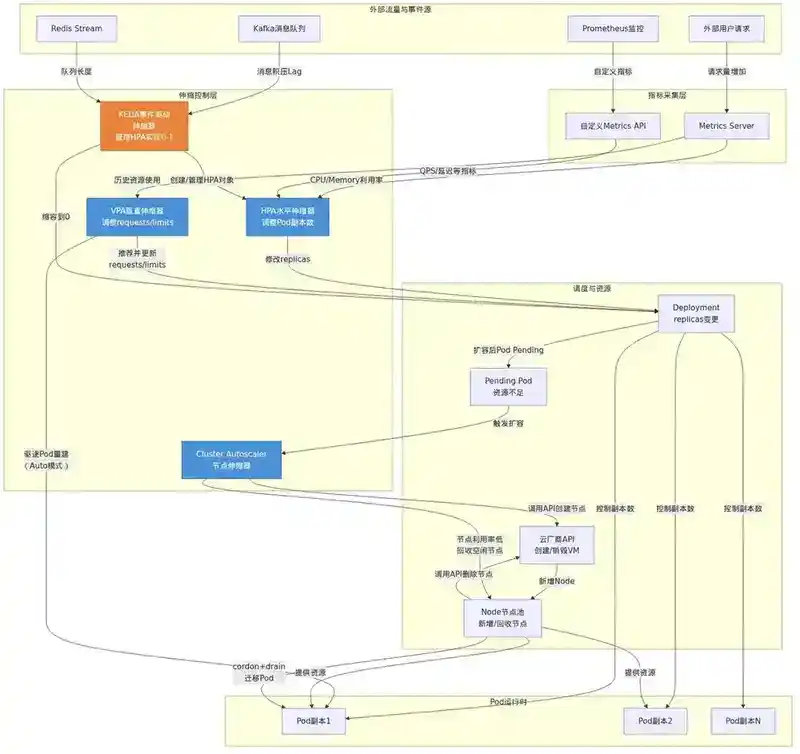
KEDA(Kubernetes Event-driven Autoscaling)扩展了 HPA,支持从 0 到 1 的伸缩,以及基于各种事件源(Kafka、RabbitMQ、Redis、Prometheus 等)的伸缩。
apiVersion: keda.sh/v1alpha1
kind: ScaledObject
metadata:
  name: kafka-consumer-scaler
spec:
  scaleTargetRef:
    name: kafka-consumer
  minReplicaCount: 0    # 支持缩容到 0
  maxReplicaCount: 30
  triggers:
  - type: kafka
    metadata:
      bootstrapServers: kafka:9092
      consumerGroup: my-group
      topic: orders
      lagThreshold: "100"    # 积压超过 100 条就扩容
KEDA 的核心价值:
- 缩容到 0:没有消息时完全停止消费者,节省资源
- 事件驱动:基于消息积压、队列长度等业务指标伸缩,比 CPU 指标更精准
- 与 HPA 兼容:KEDA 底层管理 HPA 对象,不引入新的 API
七、总结:调度与资源管理的全景图
┌─────────────────────────────────────────────────────────────────┐
│                     K8s 调度与资源管理全景                        │
├─────────────────────────────────────────────────────────────────┤
│                                                                 │
│  ┌──────────┐    ┌──────────┐    ┌──────────┐                  │
│  │ 亲和性    │    │ 污点容忍  │    │ 拓扑分布  │                  │
│  │ Affinity │    │ Taint/   │    │ Topology │                  │
│  │ Pod 选择  │    │ Toleration│    │ Spread   │                  │
│  │ 节点      │    │ 节点拒绝  │    │ 跨域均衡  │                  │
│  └────┬─────┘    └────┬─────┘    └────┬─────┘                  │
│       │               │               │                         │
│       └───────────────┼───────────────┘                         │
│                       ▼                                         │
│              ┌────────────────┐                                 │
│              │   调度器        │                                 │
│              │  Filter→Score  │                                 │
│              │  →Bind         │                                 │
│              └───────┬────────┘                                 │
│                      │                                          │
│       ┌──────────────┼──────────────┐                           │
│       ▼              ▼              ▼                           │
│  ┌──────────┐ ┌──────────┐ ┌──────────────┐                    │
│  │  QoS     │ │ 资源配额  │ │ 自动伸缩      │                    │
│  │ G/B/BE   │ │ RQ/LQ    │ │ HPA/VPA/CA   │                    │
│  │ 驱逐保护  │ │ 隔离限制  │ │ 弹性伸缩      │                    │
│  └──────────┘ └──────────┘ └──────────────┘                    │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
八、面试提问与深度解析
以下问题从面试官视角出发,考察候选人对 K8s 调度与资源管理的深层理解——不是背概念,而是理解为什么这样设计和生产环境如何落地。
Q1:调度器的预选和优选阶段分别做什么?如果一个 Pod 同时设置了 nodeSelector 和 PodAntiAffinity,两者分别在哪个阶段处理?
回答:
预选(Filtering)是一票否决式的硬过滤——每个节点都要通过所有预选规则,任一规则不通过则直接淘汰。优选(Scoring)是对通过预选的节点打分排序,选最高分。
nodeSelector在预选阶段由PodMatchNodeSelector规则处理。它检查节点标签是否包含 Pod 声明的所有 key=value 对,本质是简单的 AND 逻辑匹配。PodAntiAffinity分两种情况:requiredDuringScheduling在预选阶段由InterPodAffinity插件的 Filter 扩展点处理,不满足的节点直接淘汰。preferredDuringScheduling在优选阶段由InterPodAffinity插件的 Score 扩展点处理,匹配越多得分越高。
追问: 如果集群有 3 个节点,但 Pod 设置了 requiredDuringScheduling 的 PodAntiAffinity 要求与另外 3 个已运行的 Pod 不在同一节点(topologyKey=hostname),且每个节点恰好各运行了 1 个这样的 Pod,结果会怎样?→ Pod 永远 Pending,因为预选后没有可用节点。这就是为什么生产环境要谨慎使用 required 反亲和性。
Q2:什么时候用 Node Affinity,什么时候用 Taint/Toleration?两者可以互换吗?
回答:
两者不可互换,解决的是不同方向的问题:
| 维度 | Node Affinity | Taint / Toleration |
|---|---|---|
| 控制方向 | Pod 主动选择节点 | 节点主动排斥 Pod |
| 典型场景 | "我的服务需要 GPU" | "GPU 节点不给普通服务用" |
| 默认行为 | 所有节点都可选 | 无 Toleration 的 Pod 被排斥 |
| 粒度 | 按 Pod 配置 | 按节点配置 |
关键区别: 如果只用 Node Affinity 把 GPU Pod 调度到 GPU 节点,普通 Pod 仍然可能被调度到 GPU 节点(当其他节点资源不足时)。加上 Taint 才能确保普通 Pod 永远不调度到 GPU 节点。反过来,如果只用 Taint 给 GPU 节点打上 gpu=true:NoSchedule,GPU Pod 虽然配置了 Toleration,但调度器可能把它调度到普通节点,浪费了 GPU 资源。
生产最佳实践: 两者配合使用——Taint 排斥不需要的 Pod,Node Affinity 吸引需要的 Pod。这是"专用节点池"的标准做法。
Q3:一个 Burstable Pod 的 requests 是 256Mi,limits 是 1Gi,当前实际使用 800Mi。节点内存不足时,它和 BestEffort Pod 谁先被驱逐?为什么?
回答:
BestEffort Pod 先被驱逐。
K8s 驱逐顺序:BestEffort → Burstable(超过 requests 的)→ Burstable(未超过 requests 的)→ Guaranteed。
这个 Burstable Pod 实际使用 800Mi,超过了 requests 的 256Mi,属于"超过 requests 的 Burstable"。它在驱逐队列中排在 BestEffort 之后,但在"未超过 requests 的 Burstable"之前。
底层 OOM Score 计算逻辑:
- BestEffort:OOM Score = 1000(最高优先级被杀)
- Burstable:OOM Score = max(0, 1000 - 1000 × memoryRequestBytes / machineMemoryCapacityBytes) + 实际使用量超出 requests 的惩罚
- Guaranteed:OOM Score = -998(几乎不会被杀)
追问: 如果这个 Burstable Pod 的实际使用降到 200Mi(低于 requests),驱逐顺序会变吗?→ 会,它变为"未超过 requests 的 Burstable",排在后面。但如果节点内存继续恶化,OOM Killer 最终还是会按实际使用量排序——使用 200Mi 的 Pod 和实际使用 10Gi 的 Pod 相比,后者 OOM Score 更高,更先被杀。OOM Score 并非只看 QoS 等级,实际内存使用量也是关键因子。
Q4:HPA 的 CPU 利用率是基于 requests 还是 limits 计算的?如果 Pod 没有设置 requests 会发生什么?
回答:
HPA 的 CPU 利用率基于 requests 计算。公式:
utilization = (当前所有 Pod 的 CPU 使用量总和) / (sum(Pod[i].spec.containers[*].resources.requests.cpu)) × 100%
计算 desiredReplicas 时:
desiredReplicas = ceil(currentReplicas × currentUtilization / targetUtilization)
如果 Pod 没有设置 requests,HPA 无法计算利用率——metrics API 返回的 utilization 值为空,HPA 控制器会跳过该指标,不会触发扩缩容。这正是为什么所有需要 HPA 的工作负载都必须设置 requests。
陷阱: 如果 HPA 基于 CPU utilization 时,一些 Pod 的 requests 设为 100m,另一些设为 1000m,平均值会失去意义。实际生产环境建议使用 AverageValue 类型的指标(如 averageValue: "500m")替代 Utilization 类型,避免因 requests 配置不均导致的误判。
追问: 如果使用 AverageValue 类型,HPA 的计算公式是什么?→ desiredReplicas = ceil(currentReplicas × currentAverageValue / targetAverageValue),不再依赖 requests 做分母。
Q5:你有一个 StatefulSet 部署的 Kafka 集群,3 个 Broker,要求每个 Broker 在不同可用区,且同一可用区最多一个 Broker。如何用亲和性/反亲和性实现?
回答:
核心思路是用 podAntiAffinity + topologyKey: topology.kubernetes.io/zone:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: kafka
spec:
  serviceName: kafka
  replicas: 3
  selector:
    matchLabels:
      app: kafka
  template:
    metadata:
      labels:
        app: kafka
    spec:
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
          - labelSelector:
              matchLabels:
                app: kafka
            topologyKey: topology.kubernetes.io/zone
      containers:
      - name: kafka
        image: confluentinc/cp-kafka:7.5.0
为什么用 StatefulSet 而非 Deployment? Kafka Broker 需要稳定的网络标识和持久存储——每个 Broker 的 broker.id 需要与 Pod 序号绑定,数据目录需要 PVC 持久化。Deployment 的 Pod 是"无状态可互换"的,不适合 Kafka。
注意事项:
- 如果集群只有 2 个可用区但
replicas: 3,第 3 个 Pod 会永久 Pending。解决方案:用preferredDuringScheduling替代required,或者确保可用区数 ≥ 副本数。 - Kafka 的
advertised.listeners需要配置为每个 Pod 的稳定域名,如kafka-0.kafka.default.svc.cluster.local:9092。
Q6:Cluster Autoscaler 判断节点是否可以缩容的依据是什么?如果一个节点上运行着 DaemonSet 的 Pod,会影响缩容吗?
回答:
CA 判断节点可缩容需同时满足以下条件:
- 节点上所有 Pod(除 DaemonSet Pod 和 Mirror Pod 外)的 requests 总和 < 节点可分配资源的 50%(默认阈值,可通过
--scale-down-utilization-threshold调整)。 - 节点上所有 Pod 可以安全迁移到其他节点——CA 会模拟将这些 Pod 调度到其他节点,确认不会导致 Pending。
- 节点上没有阻止缩容的注解,如
"cluster-autoscaler.kubernetes.io/safe-to-evict": "false"。 - 节点不在缩容冷却期内(默认 10 分钟)。
DaemonSet Pod 的影响: CA 在判断时会忽略 DaemonSet Pod 的 requests——因为 DaemonSet Pod 是每个节点必有的,迁移到其他节点后目标节点上本来就有一个,所以不需要额外计算它们的资源。但 DaemonSet Pod 的存在本身不影响缩容判断,CA 会正常缩容。
补充: 如果 Pod 有本地存储(EmptyDir 除外),或设置了 PDB 导致迁移会导致 PDB 违规,该 Pod 也会阻止所在节点的缩容。
Q7:VPA 在 Auto 模式下会驱逐 Pod 重建,这会对服务可用性造成什么影响?如何规避?
回答:
影响:
- 服务中断:Pod 被驱逐到新 Pod 启动就绪之间存在空窗期,期间该 Pod 不提供服务。
- 级联风险:如果 VPA 同时调整多个 Pod,可能导致服务整体不可用。
- 与 HPA 冲突:VPA 修改 requests 后,HPA 的 CPU 利用率计算基准变化,可能导致 HPA 出现非预期的扩缩容行为。
- 状态丢失:如果 Pod 不依赖持久化存储(如内存缓存),驱逐后状态丢失。
规避措施:
- 配置 PodDisruptionBudget(PDB):确保驱逐期间至少有
minAvailable个 Pod 在运行。 - 使用
**updateMode: Initial**:只在 Pod 首次创建时设置 resources,不驱逐运行中的 Pod。 - 限制 VPA 的调整范围:通过
minAllowed/maxAllowed防止极端调整。 - VPA 与 HPA 分离:如果必须同时使用,让 VPA 只调整内存(
controlledResources: ["memory"]),HPA 基于 CPU 伸缩。 - 逐步放量:先使用
Off模式观察 VPA 的建议值,验证合理后再切换到Auto。
Q8:一个 Pod 设置了**requiredDuringSchedulingIgnoredDuringExecution**的 Node Affinity 指向**zone=zone-a**,但同时 zone-a 所有节点都被打上了**maintenance=true:NoSchedule**的污点,且 Pod 没有对应的 toleration。Pod 最终能被调度吗?
回答:
不能。Pod 会永久 Pending。
调度流程:
- 预选阶段,
PodMatchNodeSelector检查节点标签 → zone-a 的节点通过(匹配zone=zone-a),其他 zone 的节点被过滤。 - 预选阶段,
PodToleratesNodeTaints检查污点容忍 → zone-a 的节点全部失败(Pod 没有 toleration formaintenance=true:NoSchedule)。 - 预选后,可用节点数为 0 → Pod 进入 Pending 状态,事件中显示
0/N nodes are available。
关键点: 预选规则是 AND 关系——所有规则都必须通过。Node Affinity 和 Taint/Toleration 是两套独立的过滤机制,不会互相"覆盖"或"抵消"。
实际场景: 这正好说明了为什么 Node Affinity 和 Taint/Toleration 需要配合使用——如果你想独占 zone-a 节点做维护,不加 Taint 的 Pod 仍然可能被调度上去(只要资源够),加了 Taint 才能确保只有配置了 Toleration 的 Pod 才被准入。
Q9:描述从用户提交一个 Deployment 到 Pod 运行在节点上的完整流程,重点说明调度和资源管理相关的每个步骤。
回答:
完整流程如下(按时间顺序):
1. kubectl apply -f deployment.yaml
   → 客户端将 YAML 序列化为 JSON,发送 POST 请求到 API Server

2. API Server 接收请求
   → 认证(Authentication):验证用户身份
   → 授权(Authorization):RBAC 检查用户是否有 create deployments 权限
   → 准入控制(Admission Control):例如 LimitRanger 设置默认 requests/limits,
     ResourceQuota 检查命名空间配额是否超限
   → 写入 etcd,返回 Deployment 对象

3. Deployment Controller(kube-controller-manager 内)
   → Watch 到新 Deployment → 创建 ReplicaSet → ReplicaSet Controller 创建 Pod
   → Pod 写入 etcd 时 nodeName 为空,status.phase = Pending

4. Scheduler 介入
   → Watch 到 nodeName 为空的 Pod,放入调度队列
   → Sort 阶段:按优先级排序(PriorityClass)
   → PreFilter:预处理 Pod 信息
   → Filter(预选):
     · PodFitsResources:节点剩余 CPU/内存 >= Pod 的 requests
     · PodMatchNodeSelector:匹配 nodeSelector / Node Affinity
     · PodToleratesNodeTaints:匹配 Taint/Toleration
     · CheckNodeCondition:节点 Ready?
     · PodFitsHostPorts:HostPort 冲突?
     · 其他 Filter 插件...
   → PostFilter:如果 Filter 后无可用节点 → 抢占(Preemption)低优先级 Pod
   → Score(优选):
     · NodeResourcesFit:资源均衡度打分
     · ImageLocality:镜像已有加分
     · InterPodAffinity:Pod 亲和性匹配加分
     · 其他 Score 插件...
   → Reserve:预留资源(乐观并发)
   → Permit:等待/批准
   → Bind:向 API Server 提交 Binding 对象,设置 nodeName

5. 目标节点 kubelet
   → Watch 到 nodeName 指向自己的 Pod
   → 再次执行 Admission(如 PodSecurityPolicy 检查)
   → 调用 CRI(Container Runtime Interface)拉取镜像、创建容器
   → 调用 CNI(Container Network Interface)配置网络
   → 调用 CSI(Container Storage Interface)挂载存储卷
   → 更新 Pod status 为 Running

6. 资源管理相关
   → kubelet 通过 Cgroup 设置 CPU/内存限制(limits)
   → kubelet 上报 Node Status(包含剩余资源)给 API Server
   → 如果发生 OOM:内核 OOM Killer 按 oom_score_adj 杀进程
   → kubelet 监控资源使用,触发驱逐(Eviction)
面试官视角追问: Admission Control 环节中,如果 LimitRanger 给 Pod 设置了默认 limits=500m CPU,但 Pod 自己的 requests=1000m,最终生效的是什么?→ requests 不会超过 limits(单容器),LimitRanger 会将 limits 提升到至少等于 requests,所以最终 limits=1000m,requests=1000m。
Q10:你如何设计一个大规模 K8s 集群的调度策略,以确保 GPU 训练任务、在线服务和批处理任务互不干扰?请给出具体的亲和性、污点、QoS 和伸缩策略。
回答:
设计思路: 三种工作负载的资源需求和 SLA 完全不同,需要从物理隔离(节点池)→ 调度策略(准入+倾向)→ 资源保障(QoS)→ 弹性伸缩四个层面设计。
1. 节点池划分(物理隔离)
| 节点池 | 标签 | 用途 |
|---|---|---|
| gpu-pool | workload-type=gpu |
GPU 训练任务 |
| service-pool | workload-type=online |
在线服务(低延迟) |
| batch-pool | workload-type=batch |
批处理/离线任务 |
2. 污点与容忍(准入控制)
# GPU 节点:只接受 GPU 任务
kubectl taint node gpu-{1..8} workload-type=gpu:NoSchedule

# 在线服务节点:拒绝批处理任务
kubectl taint node service-{1..20} workload-type=online:NoSchedule

# 批处理节点:可以被抢占,接受在线服务溢出
kubectl taint node batch-{1..10} workload-type=batch:NoSchedule
3. 亲和性策略(倾向控制)
# GPU 训练任务 Pod
spec:
  tolerations:
  - key: workload-type
    operator: Equal
    value: gpu
    effect: NoSchedule
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: workload-type
            operator: In
            values: [gpu]
    # 高优先级训练任务可以抢占批处理
  priorityClassName: high-priority

# 在线服务 Pod
spec:
  tolerations:
  - key: workload-type
    operator: Equal
    value: online
    effect: NoSchedule
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: workload-type
            operator: In
            values: [online]
    # 反亲和性:同一服务的 Pod 分散到不同节点
    podAntiAffinity:
      preferredDuringSchedulingIgnoredDuringExecution:
      - weight: 100
        podAffinityTerm:
          labelSelector:
            matchLabels:
              app: my-service
          topologyKey: kubernetes.io/hostname

# 批处理任务 Pod
spec:
  tolerations:
  - key: workload-type
    operator: Equal
    value: batch
    effect: NoSchedule
  priorityClassName: low-priority  # 可被抢占
4. QoS 策略
| 工作负载 | QoS | 原因 |
|---|---|---|
| 在线服务 | Guaranteed | 核心服务不能因 OOM 被驱逐 |
| GPU 训练 | Guaranteed 或 Burstable(上限设置好) | 训练任务中断代价高(Checkpoint 开销大) |
| 批处理 | Burstable 或 BestEffort | 可接受被驱逐,重试即可 |
5. 自动伸缩策略
| 工作负载 | 伸缩策略 | 说明 |
|---|---|---|
| 在线服务 | HPA(CPU/Memory + 自定义指标) | 基于 QPS/延迟伸缩 |
| GPU 训练 | KEDA + 任务队列 | 基于待训练任务数伸缩,无任务时缩容到 0 |
| 批处理 | KEDA + 消息队列 | 基于 Kafka lag/Redis 队列长度伸缩 |
| 集群节点 | Cluster Autoscaler + 多节点组 | 每个节点组独立设置 min/max |
6. 关键补充
- 优先级与抢占(PriorityClass):在线服务 > GPU 训练 > 批处理。当资源紧张时,低优先级 Pod 被抢占腾出资源给高优先级 Pod。
- ResourceQuota:限制每个命名空间的资源总量,防止某个团队过度消耗。
- LimitRange:给未设置 requests/limits 的 Pod 默认值,防止"裸 Pod"影响调度。
- 调度器插件:对于 GPU 拓扑感知调度(如 NVLink 亲和性),使用 Volcano 等第三方调度器替代默认调度器。
本文是「Java 技术专家与架构师面试:250 个高频考点总览」系列第 236 篇。