阅读时间:约 45 分钟 | 适用对象:Java 技术专家 / 架构师面试准备
一、引言:手工运维的极限
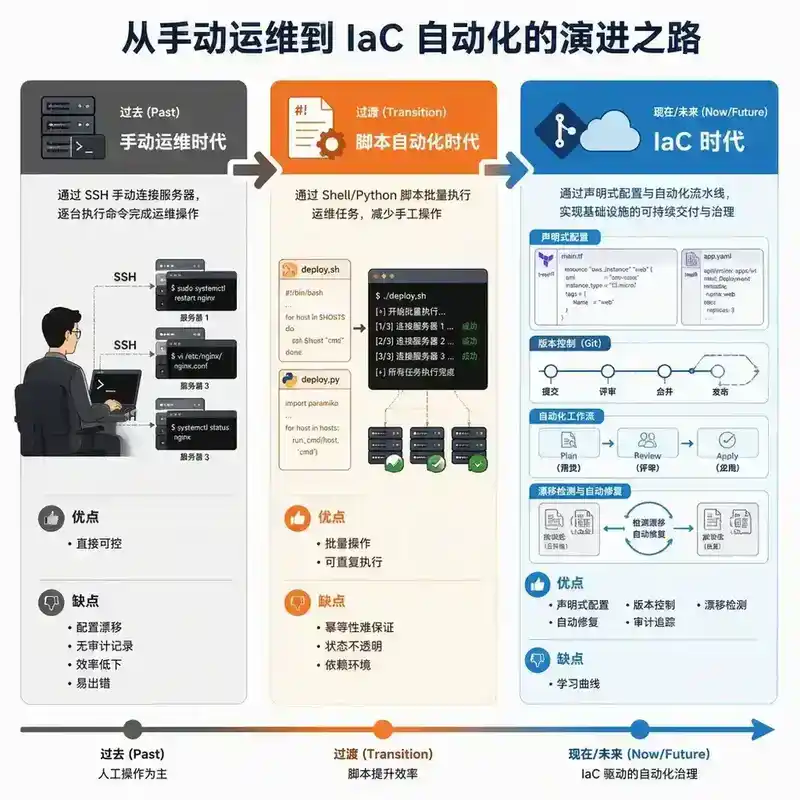
想象这样一个场景:你在一家互联网公司负责后端服务,线上有 50 台服务器,分别运行着 API 网关、消息队列、缓存集群、数据库集群。某天,安全团队要求所有服务器统一升级 OpenSSL 版本,并新增一条 iptables 规则。
如果你还在用 SSH 逐台登录、手动执行命令,这不仅是体力活,更是一场灾难——你可能在第 37 台机器上漏掉了某条命令,然后凌晨三点被报警电话叫醒。
这就是 IaC(Infrastructure as Code)要解决的问题。IaC 的核心思想很简单:用代码描述基础设施的最终形态,让工具自动将实际环境调整到目标状态。它把服务器、网络、存储等基础设施资源当作软件一样管理——版本控制、代码审查、自动化测试、持续交付,这些软件工程的优秀实践全部可以应用到基础设施上。
IaC 不是简单的"脚本自动化",二者有本质区别:
| 维度 | 脚本自动化 | IaC |
|---|---|---|
| 目标 | 执行一系列操作 | 描述最终状态 |
| 幂等性 | 通常不保证 | 天然保证 |
| 回滚 | 需要写回滚脚本 | 版本控制 + 状态回溯 |
| 可审查性 | 依赖脚本注释 | 声明式 DSL,意图清晰 |
| 依赖管理 | 手动处理 | 自动解析 DAG |
二、命令式 vs 声明式:两种范式
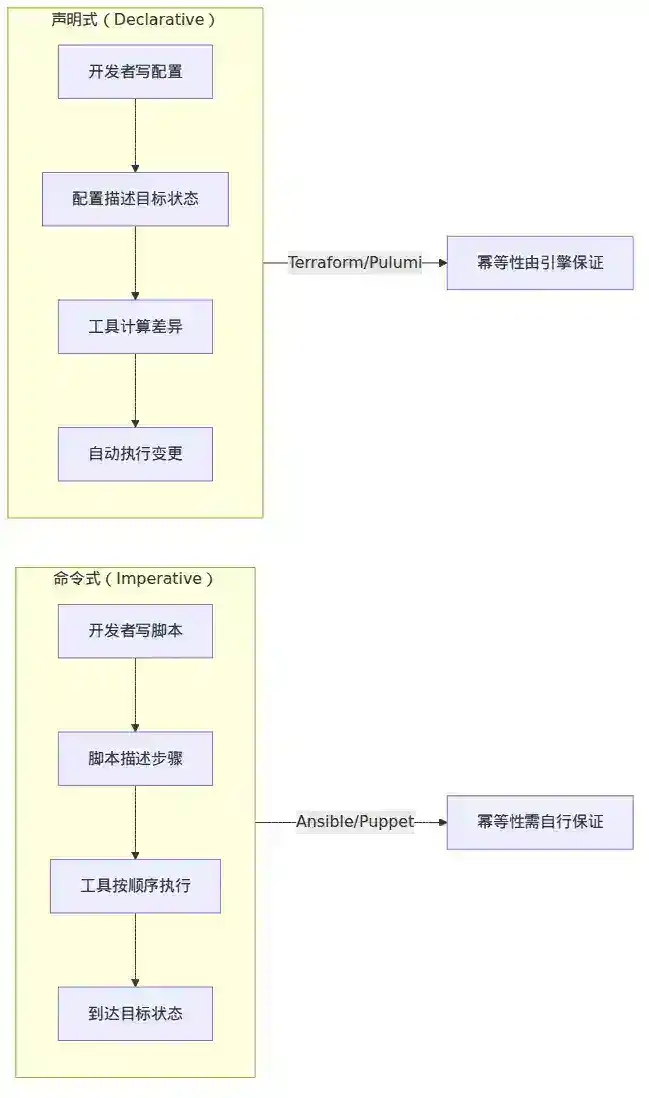
命令式 IaC 的代表是 Ansible 和早期的 Puppet。你写的是"怎么做"——安装这个包、启动那个服务、创建这个用户。工具忠实地执行你的每一步指令,但它不知道你的最终目标是什么。
声明式 IaC 的代表是 Terraform、Pulumi 和 Kubernetes YAML。你写的是"要什么"——需要 3 台 EC2 实例、一个 RDS 数据库、一个 VPC 网络。工具自己计算当前状态和目标状态的差异,然后生成执行计划。
命令式示例(Ansible):
- name: Install nginx
  apt:
    name: nginx
    state: present
- name: Start nginx
  service:
    name: nginx
    state: started
声明式示例(Terraform):
resource "aws_instance" "web" {
  ami           = "ami-0c55b159cbfafe1f0"
  instance_type = "t3.micro"
  count         = 3
}
声明式的优势在于可预测性。无论你运行 1 次还是 100 次,结果都一样——这就是幂等性。而命令式脚本如果中间某步失败,你需要额外处理"已经执行了哪些步骤、该从哪恢复"的问题。
但声明式并非银弹。它的表达能力受限于 DSL 的设计——如果你需要"先检测磁盘使用率,如果超过 80% 就扩容,否则不做任何操作",这种带条件判断的逻辑在声明式 DSL 中很难优雅表达。这也是为什么实践中经常混合使用两种范式。
三、状态管理:IaC 的灵魂
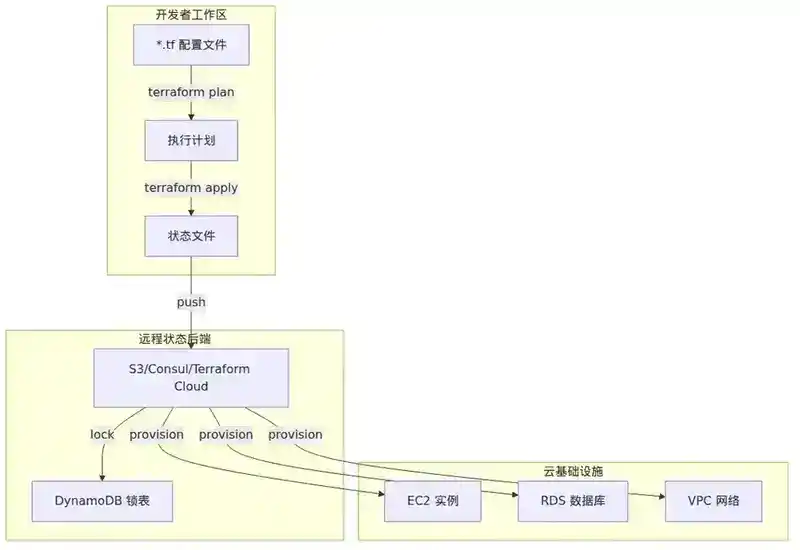
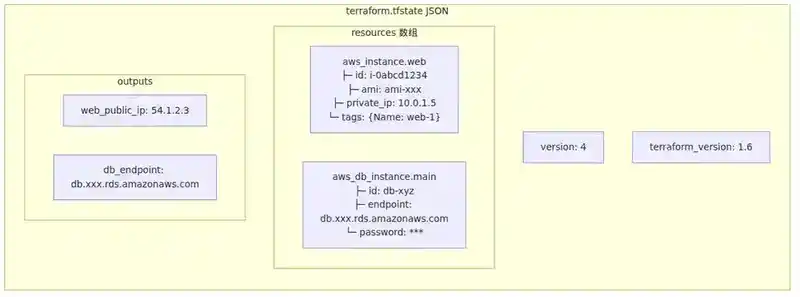
状态文件(如 Terraform 的 terraform.tfstate)是 IaC 工具最核心也最容易被忽视的部分。它记录了"工具上次创建了什么",是连接"配置文件"和"实际基础设施"的桥梁。
状态文件的核心作用:
- 映射关系:将配置文件中的资源标识符(如
aws_instance.web)映射到云平台的实际资源 ID(如i-0abcd1234) - 差异计算:对比当前状态和期望配置,生成增量变更计划
- 依赖追踪:记录资源之间的依赖关系,确保销毁顺序正确
状态管理的关键问题:
(1)状态文件放哪里?
初学者常犯的错误是把状态文件放在本地 Git 仓库里。这会导致两个严重问题:
- 多人协作时,A 的 apply 不会反映在 B 的状态文件中,B 再次 apply 可能创建重复资源
- 状态文件可能包含敏感信息(数据库密码、API 密钥等),提交到 Git 是安全风险
正确的做法是使用远程状态后端:AWS S3 + DynamoDB 锁、Google Cloud Storage、Terraform Cloud、或自建的 Consul 集群。
(2)状态锁(State Locking)
当两人同时执行 terraform apply 时会发生什么?如果没有锁机制,两人都读取了同一个状态文件,各自计算差异,各自执行变更——结果可能是资源重复创建,或者更糟,状态文件被 A 覆盖后 B 的操作导致资源"孤儿化"(实际存在但状态文件中没有记录)。
远程后端通过分布式锁解决这个问题。以 AWS 为例,DynamoDB 表提供强一致性锁:第一个执行 apply 的人获取锁,后续的人等待或报错。
(3)状态迁移
当基础设施重构时(比如把某个资源从一个模块移到另一个模块),你需要手动编辑状态文件,或者使用 terraform state mv 命令。这类似于数据库的 schema migration——操作不当会导致严重问题。
四、变更审查:Plan → Review → Apply
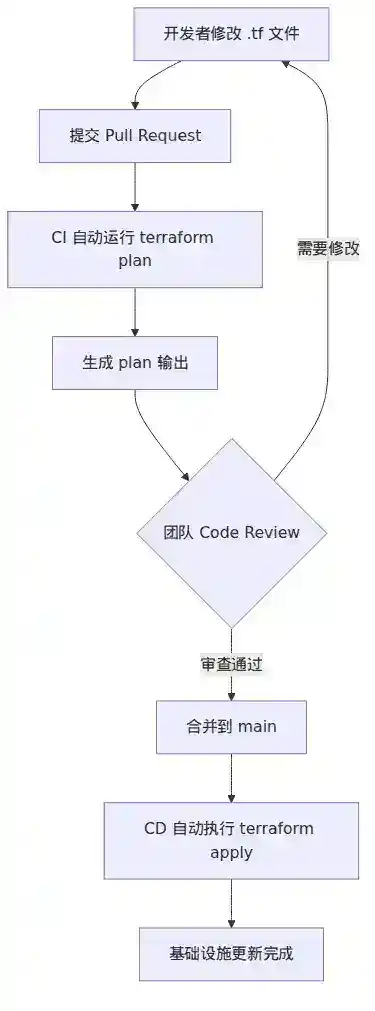
IaC 最大的变革不在于"自动化配置",而在于将软件工程的变更管理流程引入基础设施运维。传统运维中,一个配置变更通常是这样的:运维人员收到需求 → 登录服务器 → 手动修改 → 没出问题就万事大吉。
有了 IaC 后,流程变成了:
- Plan(计划):开发者修改配置代码,提交 PR。CI 自动运行
terraform plan,生成变更预览。这个预览精确到"将创建 X 个资源、修改 Y 个资源、销毁 Z 个资源"。 - Review(审查):团队成员审查 plan 输出,就像审查代码一样。关键审查点:
- 是否有资源被意外销毁?(
-/+ destroy and recreate标记) - 变更是否影响了安全组规则?
- 是否引入了新的成本?
- 数据库实例类型变更是否在维护窗口内?
- 是否有资源被意外销毁?(
- Apply(应用):PR 合并后,CD 自动执行
terraform apply,将变更应用到实际环境。
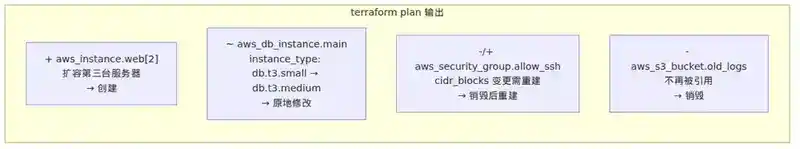
一个成熟的 IaC 变更审查流程还需要考虑:
- 多环境策略:dev/staging/prod 使用相同的代码模板,但通过变量文件区分参数。确保 staging 先验证通过后再推 prod。
- 变更窗口:数据库类型变更、安全组变更等高风险操作,必须在变更窗口内执行,且准备好回滚方案。
- 合规审计:所有变更都有 Git 记录——谁、什么时间、改了什么、谁审批的。这对于 SOC2、ISO 27001 等合规认证至关重要。
五、漂移检测:守护基础设施的免疫系统
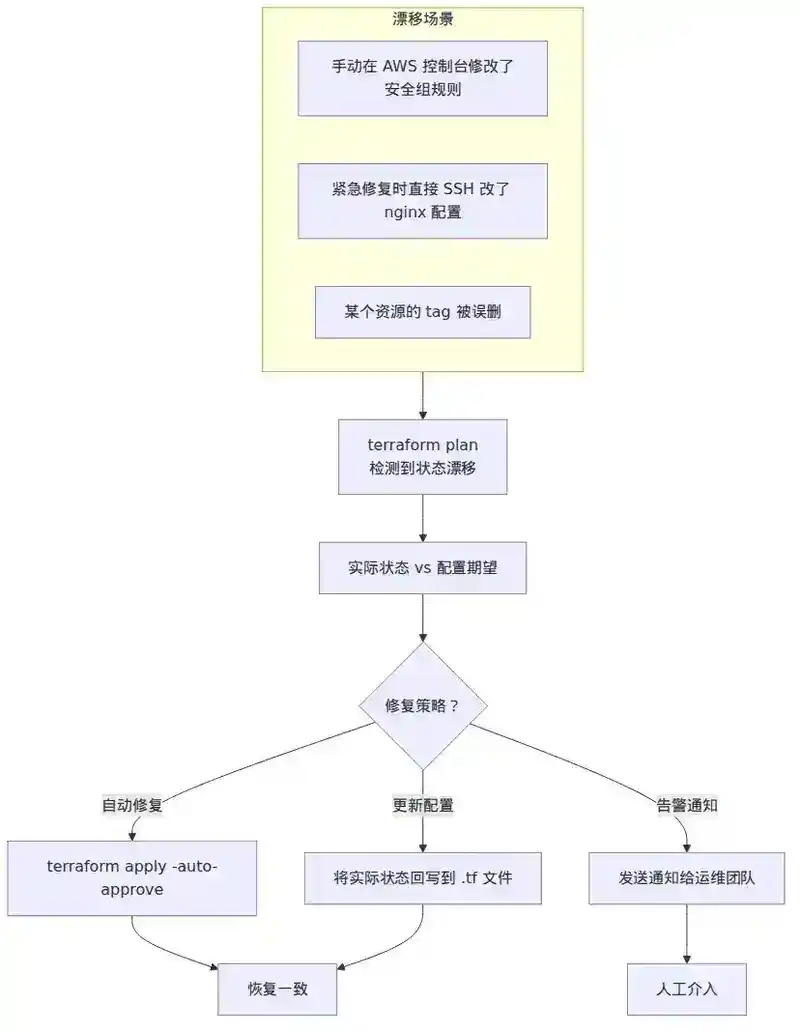
漂移(Drift)是指基础设施的实际状态偏离了 IaC 代码定义的期望状态。这是每个使用 IaC 的团队迟早会遇到的问题。
漂移的常见原因:
- 手动变更:运维人员为了紧急修复,直接登录 AWS 控制台修改了安全组规则,但没有更新对应的 Terraform 代码
- 外部服务变更:AMI 被废弃、SSL 证书过期、DNS 记录被第三方修改
- 资源被部分删除:某人手动删除了一个 EC2 实例,但 ALB 的 target group 还指向它
- 并发操作冲突:两个 IaC 工具同时操作同一资源(比如 Terraform 和 CloudFormation 混用)
漂移检测的实现:
Terraform 的 terraform plan 本质上就是在做漂移检测——它读取状态文件(上次 apply 的结果),然后调用云平台 API 查询实际资源状态,最后对比差异。如果发现了差异(比如某个 tag 值变了),plan 会标记出来。
更进一步,可以在 CI/CD 中设置定时任务(比如每天凌晨),自动运行 terraform plan -detailed-exitcode:
- 返回码 0:无差异,一切正常
- 返回码 1:执行出错
- 返回码 2:检测到漂移,触发告警
自动修复 vs 人工介入:
对于非破坏性漂移(如 tag 变更、实例数不足),可以配置自动修复。对于可能导致服务中断的漂移(如安全组规则变更),应该在人工确认后修复。
六、IaC 在 Java 生态中的实践
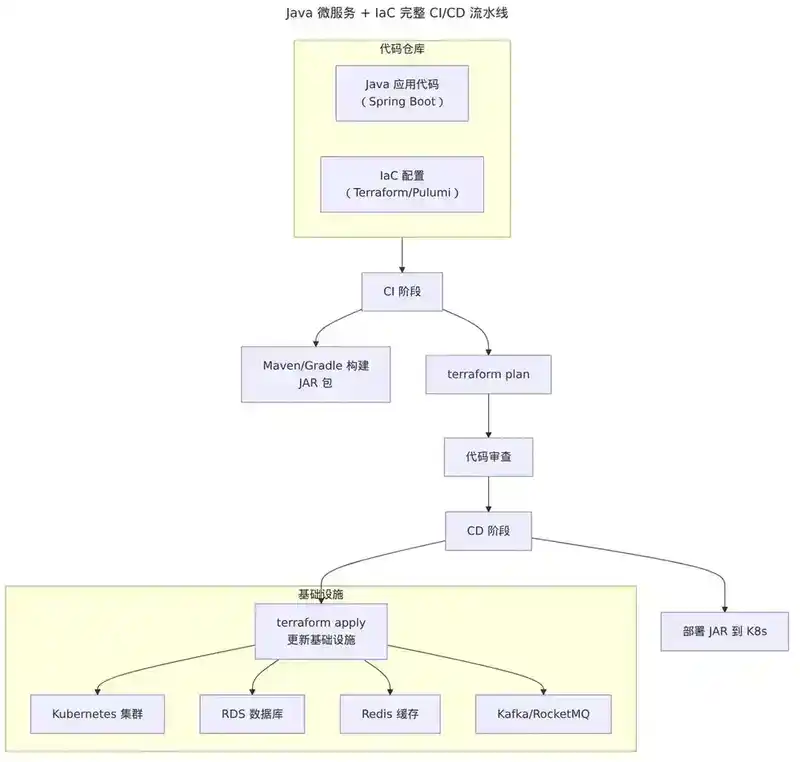
对于 Java 开发者来说,IaC 不是运维的专属领地。以下是几个典型的 IaC 应用场景:
(1)环境配置管理(Spring Cloud Config + IaC)
Spring Cloud Config 管理应用配置,IaC 管理基础设施配置。二者配合:
- IaC 创建 Config Server 所需的资源(数据库、消息队列等),并将连接信息(endpoint、端口等)写入 AWS Parameter Store 或 HashiCorp Vault
- Spring Cloud Config 从 Parameter Store/Vault 读取这些基础设施参数,注入到应用中
(2)容器化部署(Kubernetes YAML 即声明式 IaC)
Kubernetes 的 YAML 清单本质上是声明式 IaC 的一种实现。你声明期望的 Pod 数量、资源限制、服务暴露方式,Kubernetes 的控制平面(Controller Manager)持续调谐实际状态到期望状态。这跟 Terraform 的思想完全一致。
(3)Testcontainers + IaC
在集成测试中使用 Testcontainers 启动真实的基础设施容器(MySQL、Redis、Kafka),配合 IaC 脚本初始化 schema 和测试数据。这确保了测试环境与生产环境的基础设施行为一致。
(4)Pulumi + Java
Pulumi 是一个可以用通用编程语言(Java、TypeScript、Python、Go)编写 IaC 的工具。对 Java 开发者特别友好——你可以用熟悉的语言、IDE 的自动补全、类型检查来编写基础设施代码:
// Pulumi Java 示例:创建 AWS S3 Bucket
var bucket = new Bucket("my-bucket", BucketArgs.builder()
    .acl("private")
    .versioning(new BucketVersioningArgs("Enabled"))
    .tags(Map.of("Environment", "Production", "Team", "Platform"))
    .build());
七、总结
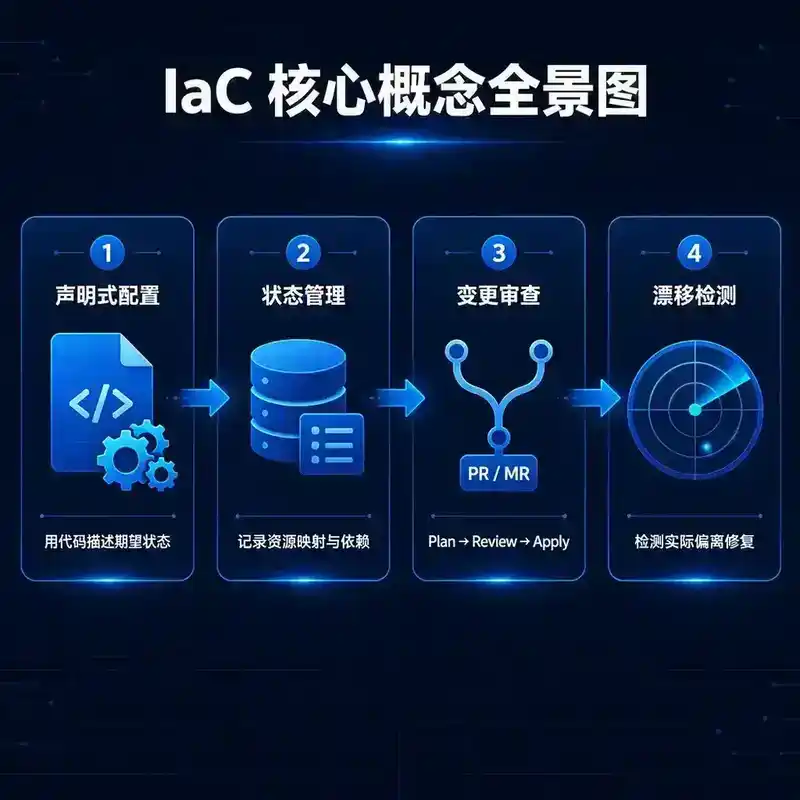
IaC 不是某个工具的代名词,而是一种理念:用代码定义基础设施,让自动化保证一致性。它的核心收益不是"省了几分钟手动操作",而是:
- 可复现:任何环境(dev/staging/prod/灾备)都可以从同一套代码重建
- 可审计:所有变更都是 Git 的一条 commit,who/when/what/why 一目了然
- 可协作:同一个 Pull Request 流程,开发者和运维者平等参与
- 可测试:terraform plan 就是基础设施的"编译检查";Terratest 等工具可以做集成测试
- 可回滚:Git revert + terraform apply 就能回到上一个版本
面试官视角提问
以下问题不计入 40 分钟阅读时间,建议在掌握正文内容后尝试回答。
Q1:Terraform 的**terraform plan**和**terraform apply**之间,如果有人手动修改了资源,会发生什么?
Q2:如果团队中有 5 个开发者在各自分支上修改 Terraform 配置,如何保证他们不会互相覆盖?你们项目中是怎么处理状态锁的?
Q3:你提到 Terraform 的状态文件可能包含敏感信息。如果状态文件已经不小心提交到了 Git 仓库,你会怎么处理?需要做哪些清理步骤?
Q4:假设你们公司同时使用 Terraform 和 Kubernetes,K8s 的 YAML 清单和 Terraform 的 HCL 配置如何分工?哪些资源应该由 Terraform 管理,哪些由 K8s 管理?
Q5:你们有没有遇到过 Terraform 状态文件损坏的情况?如果发生了,有哪些恢复手段?
Q6:Pulumi 用 Java 写 IaC 听起来很美好,但它和 Terraform HCL 相比,在实际大团队协作中有什么劣势?
Q7:漂移检测发现 50 个资源不一致,你如何判断哪些需要立即修复、哪些可以延后?优先级排序的逻辑是什么?
Q8:如果要在企业内推广 IaC,但运维团队习惯手动操作、抵触代码化,你会怎么推动?
面试官视角回答
Q1:Terraform 的**terraform plan**和**terraform apply**之间,如果有人手动修改了资源,会发生什么?
这取决于具体情况。terraform apply 执行时,Terraform 不会复用 plan 阶段的结果,而是重新调用云平台 API 查询资源的实际状态,然后与状态文件中的记录进行对比。如果发现实际状态与状态文件记录不一致(即发生漂移),Terraform 会将其纳入本次变更计划中。
具体来说,有三种情况:
- 手动修改了配置文件中声明的属性(如改了 instance_type):Terraform 检测到实际状态不等于配置期望,会在 apply 中将其改回配置定义的值。
- 手动修改了配置文件中未声明的属性(如手动加了 tag):Terraform 默认不会处理,除非你开启了某些 provider 的检测机制或使用了
lifecycle规则。部分 provider 会检测到默认值被覆盖并尝试修正。 - 手动删除了资源:Terraform 发现资源不存在,会在 apply 中重新创建它。
这其实是 Terraform 的核心设计哲学:以代码为准,持续调谐。Plan 输出只是一个"快照",apply 时仍会做实时校验。
Q2:如果团队中有 5 个开发者在各自分支上修改 Terraform 配置,如何保证他们不会互相覆盖?你们项目中是怎么处理状态锁的?
核心机制是远程状态后端 + 分布式锁。我们项目中使用 AWS S3 作为状态后端,DynamoDB 作为锁表:
terraform {
  backend "s3" {
    bucket         = "my-terraform-state"
    key            = "prod/terraform.tfstate"
    region         = "us-east-1"
    dynamodb_table = "terraform-locks"
    encrypt        = true
  }
}
并发控制流程:
- 开发者 A 执行
terraform apply,Terraform 在 DynamoDB 表中写入一条锁记录(包含操作者、时间戳、操作类型) - 开发者 B 同时执行
terraform apply,Terraform 尝试在 DynamoDB 中写入锁,发现已存在,报错Error acquiring the state lock,提示锁持有者信息 - 开发者 A 的操作完成后,Terraform 自动释放锁,B 可以继续
此外,团队还需要配合 Git 工作流:
- 每个开发者在自己的分支上修改
.tf文件,提交 PR - CI 在 PR 阶段运行
terraform plan(只读,不需要锁) - PR 合并到 main 后,CD 自动执行
terraform apply(串行执行,天然避免并发) - 紧急情况下需要手动 apply,通过
terraform force-unlock强制释放锁(但必须在确认锁持有者已中断操作后使用)
Q3:你提到 Terraform 的状态文件可能包含敏感信息。如果状态文件已经不小心提交到了 Git 仓库,你会怎么处理?需要做哪些清理步骤?
这是一个严重的安全事件,需要立即处理。步骤分紧急止血和彻底清理两阶段。
紧急止血(第一时间):
- 立即轮换所有在状态文件中暴露的密钥:数据库密码、API 密钥、SSL 私钥等
- 检查云平台审计日志,确认是否有异常访问(如果有人拿到了密钥,可能已经利用)
- 通知安全团队,评估影响范围
彻底清理(Git 历史):
使用 git filter-branch(传统方式)或 BFG Repo-Cleaner(推荐,更快)删除历史中的所有状态文件,然后用 git push --force 覆盖远程历史。但注意:如果仓库已被 fork 或有其他人 clone 过,他们本地仍有历史记录,需要通知所有人重新 clone。
预防措施(更重要):
- 在
.gitignore中添加*.tfstate和*.tfstate.backup - 使用远程状态后端(S3 + 加密),绝不在本地存储状态文件
- 配置 Git pre-commit hook 扫描敏感信息
- 在 CI 中集成 git-secrets 或 truffleHog 做提交前检查
- 对于已存在的敏感信息,使用
sensitive = true标记 output 变量,避免在 plan 输出中打印
Q4:假设你们公司同时使用 Terraform 和 Kubernetes,K8s 的 YAML 清单和 Terraform 的 HCL 配置如何分工?哪些资源应该由 Terraform 管理,哪些由 K8s 管理?
这是一个经典的 IaC 分层问题。我的分工原则是:Terraform 管理集群级别的"基础设施",Kubernetes 管理集群内部的"工作负载"。
Terraform 管理的资源(集群层):
- 云服务商的基础资源:VPC、子网、安全组、NAT 网关、负载均衡器(ALB/NLB)
- Kubernetes 集群本身:EKS/GKE/AKS 集群的创建、节点组、IAM 角色、OIDC provider
- 集群外依赖:RDS 数据库、ElastiCache Redis、SQS 队列、S3 存储桶
- DNS 记录:Route53 中的域名解析
- 服务账号和密钥:IAM Role for Service Account(IRSA)
- 集群级别的 K8s 资源:命名空间、RBAC、StorageClass、LimitRange
Kubernetes 管理的资源(工作负载层):
- 应用部署:Deployment、StatefulSet、DaemonSet
- 服务暴露:Service、Ingress(注意:Ingress Controller 的安装由 Terraform 的 Helm provider 完成)
- 配置管理:ConfigMap、Secret(建议用 External Secrets Operator 从 Vault/Parameter Store 同步)
- 自动伸缩:HPA、VPA、PodDisruptionBudget
- 网络策略:NetworkPolicy
- 服务网格:Istio 的 VirtualService、DestinationRule
边界处理的关键点:
- Terraform 用 Helm provider 或 Kubernetes provider 管理部分 K8s 资源(如 cert-manager、external-dns 等基础设施组件的安装),但不直接管理业务 Deployment
- 避免双向依赖:不要让 Terraform 等待 K8s 中的 Pod 就绪,也不要让 K8s 中的 Pod 依赖 Terraform 创建的资源 ID(通过 External Secrets 解耦)
- Terraform 输出 K8s 需要的连接信息(RDS endpoint、Redis host 等)到 AWS Parameter Store 或 Vault,K8s 通过 External Secrets Operator 拉取
Q5:你们有没有遇到过 Terraform 状态文件损坏的情况?如果发生了,有哪些恢复手段?
状态文件损坏确实发生过,常见原因包括:网络中断导致上传不完整、S3 版本冲突、手动编辑状态文件出错的 JSON 格式问题。
恢复手段,按优先级排列:
方案一:从远程后端的版本历史恢复(最常用)
S3 后端默认开启版本控制,通过 AWS Console 或 CLI 找到上一个正常版本,下载后替换即可。
方案二:从本地备份恢复
Terraform 在每次 apply 前会自动生成 terraform.tfstate.backup,这是上一次的正常状态。如果远程损坏,可以先恢复到本地备份,再 push 上去。
方案三:使用**terraform refresh**重建
这是最后的手段——删除损坏的状态文件,运行 terraform refresh,Terraform 会扫描所有云资源,重建状态文件。但这种方式有风险:
- 只能恢复 Terraform 能识别和理解格式的资源,如果资源配置格式变了可能不兼容
- 可能遗漏某些资源,导致下次 apply 时重复创建
- 需要手动验证所有资源都被正确导入
方案四:**terraform import**逐个导入
如果 refresh 也无法完整恢复,需要通过 terraform import 逐个将已有资源导入状态文件。这是最费时但最可控的方式。
预防措施:
- S3 必须开启版本控制和跨区域复制
- 配置
terraform apply前的状态备份 - 定期执行
terraform plan -detailed-exitcode作为健康检查 - 禁止手动编辑状态文件,只用
terraform state子命令操作
Q6:Pulumi 用 Java 写 IaC 听起来很美好,但它和 Terraform HCL 相比,在实际大团队协作中有什么劣势?
Pulumi 的 Java SDK 确实降低了上手门槛,但在大团队场景下有以下几个明显的劣势:
1. 表达力过度带来的混乱
HCL 是一种受限的 DSL,它能做的事情有限——这在大团队中反而是优势。每个人写的 Terraform 配置看起来很相似,review 起来高效。而 Java 是通用语言,不同开发者可以写出风格迥异的 IaC 代码:
- 有人用 Builder 模式,有人用构造函数,有人用工厂模式
- 有人把业务逻辑(循环、条件判断)大量嵌入 IaC 代码,导致预览输出不可预测
- 实习生可能写出复杂的抽象层,增加了排查问题的难度
2. 依赖管理和版本冲突
Java 项目的依赖管理(Maven/Gradle)本身就是一门学问。Pulumi 的 Java provider 依赖云服务商的 SDK(如 AWS SDK for Java),这些 SDK 的版本冲突、传递依赖、CVE 漏洞修复都会成为 IaC 维护者的负担。而 Terraform 的 provider 是独立的二进制文件,版本管理完全隔离。
3. CI/CD 集成复杂度
Terraform 只需要一个二进制文件,CI 环境准备极简。Pulumi 需要 JDK + Maven/Gradle + Pulumi CLI + Pulumi Java SDK 的完整工具链,CI 环境搭建和维护成本显著更高。
4. Plan 输出的可读性
Terraform 的 plan 输出是结构化的,每个资源的变更清晰可见。Pulumi 的 preview 输出虽然也展示了资源变更,但当 Java 代码中有复杂的循环和条件逻辑时,preview 的变化可能难以归因到具体哪行代码。
5. 社区生态和最佳实践
Terraform 有庞大的社区、成熟的模块注册表(Terraform Registry)、大量的开源模块和文档。Pulumi 虽然也在增长,但 Java 生态中的 IaC 最佳实践远不如 HCL 成熟。
何时用 Pulumi 更合适:
- 小团队或单人项目,开发者都是 Java 背景
- 需要复杂逻辑的 IaC(如动态生成大量资源、与外部 API 交互)
- 公司已有 Java 基础设施工具链,希望统一技术栈
Q7:漂移检测发现 50 个资源不一致,你如何判断哪些需要立即修复、哪些可以延后?优先级排序的逻辑是什么?
面对 50 个漂移告警,不能盲目全量修复,需要按风险等级分批处理。我的优先级排序框架如下:
P0(立即修复,分钟级):安全相关
- 安全组规则被放宽(如 0.0.0.0/0 的 SSH 访问)
- IAM 策略被修改,权限被扩大
- 加密配置被关闭(如 S3 bucket 的 SSE 加密、RDS 的加密被禁用)
- S3 bucket 的 public access block 被修改
P1(24 小时内修复):可用性相关
- 实例数量减少(auto scaling group 的 desired capacity 被调低)
- 负载均衡器的健康检查配置被修改
- 数据库实例类型被降级
- 备份策略被修改或关闭
P2(本周内修复):合规和成本相关
- 资源标签(tags)被删除或修改(影响成本归因和合规审计)
- 日志保留策略被缩短
- 非关键资源(如开发环境)的配置漂移
P3(可延后到下个迭代):优化类
- 非关键资源的小幅配置差异
- 不影响功能的外观性变更
判断流程:
- 先按资源类型分组,识别是单个资源还是批量漂移(批量漂移可能意味着系统性问题)
- 检查 Git 历史,看是否有人最近修改了配置但未 apply(可能是"善意的漂移"——有人手动修了紧急问题但忘了回写代码)
- 对于需要立即修复的漂移,先执行
terraform plan -target=resource_name验证修复范围,确认不会产生副作用 - 修复后,在事件管理系统中记录漂移原因和修复措施,定期复盘减少漂移发生
Q8:如果要在企业内推广 IaC,但运维团队习惯手动操作、抵触代码化,你会怎么推动?
这是一个技术+管理+心理的综合问题,不能靠"领导强制要求"来推动。我的策略是"渐进式说服 + 价值证明 + 低门槛入门":
第一阶段:找到痛点,建立信任(1-2 个月)
- 不做全盘推广,而是找一个运维团队最头疼的场景切入。比如"每次扩容都要手动操作 20 步,耗时 2 小时,还容易出错"——用 Terraform 把这个流程自动化,展示 2 分钟完成的 demo
- 让运维团队参与 Code Review,而不是把 IaC 强加给他们。代码审查时,运维专家的经验非常有价值(比如他们知道"这个安全组规则在生产环境会导致 XX 问题"),这让他们感受到自己的知识被尊重和编码化
第二阶段:降低门槛,消除恐惧(2-3 个月)
- 提供模板和脚手架工具,新人只需修改几个变量就能创建一套标准基础设施
- 建立 IaC 模块库(类似 Terraform Registry 的内部版),让运维团队可以复用已验证的模块
- 设置"安全网":CI 中自动运行
terraform plan,review 时高亮显示"将要销毁的资源"和"安全组变更",降低运维人员对"误操作"的恐惧 - 关键:保留手动操作的"逃生通道"。初期可以说"紧急情况下可以在控制台手动操作,但 24 小时内必须回写到 IaC 代码"
第三阶段:制度化,形成习惯(3-6 个月)
- 把 IaC 审查纳入变更管理流程:所有基础设施变更必须通过 PR,手动操作需要走例外审批
- 建立漂移检测的自动化告警,让"手动操作后被 IaC 检测到"成为自然的反馈循环
- 定期分享 IaC 带来的价值:减少了多少次生产事故、变更回滚从 2 小时缩短到 5 分钟、新环境搭建从 3 天缩短到 1 小时
最关键的沟通技巧:
- 不要说"你们的手动操作方式落后",而是说"我们把你们宝贵的经验编码化,让新人也能安全操作"
- 不要一次性替换所有手动流程,而是逐步替换,让运维团队有适应期
- 承认 IaC 的局限性:不是所有场景都适合 IaC(如一次性紧急排查),避免过度承诺