阅读时间:约 40-50 分钟 难度:进阶 适用:Java 技术专家 / 架构师面试备考
一、从物理机到容器:JVM 调优的范式转换
如果你在 2018 年之前做 Java 性能调优,你的工具箱大概是这样的:-Xmx4g -Xms4g -Xmn2g -XX:+UseG1GC。这些参数在物理机或虚拟机上运行良好,因为 JVM 可以直接读取宿主机的 CPU 核心数和内存总量。
但当你把同一个 Java 应用塞进一个 2 核 2GB 的 Kubernetes Pod 时,灾难就开始了:
# 物理机部署:32 核 64GB,JVM 设置 -Xmx48g,一切正常
# 容器部署:限制 2 核 2GB,JVM 仍然认为自己有 32 核 64GB
# 结果:JVM 开了 32 个 GC 线程争抢 2 个 CPU,堆内存默认 16GB 远超容器限制
# Pod 启动后 30 秒被 OOM Killer 杀死
这不是玩笑。在 JDK 8u131 之前,JVM 完全不知道容器的存在。它通过 sysconf() 系统调用读取宿主机的 /proc/cpuinfo 和 /proc/meminfo,拿到的是宿主机的全部资源,而不是容器的限制。
JDK 8u131 引入了 -XX:+UnlockExperimentalVMOptions -XX:+UseCGroupMemoryLimitForHeap,这是第一次尝试。JDK 10 引入了 -XX:+UseContainerSupport(默认开启),JVM 才开始真正理解容器世界。JDK 15 之后,容器感知已经非常成熟。
本文围绕容器化 Java 应用调优的四个核心维度展开:
- JVM 容器感知:让 JVM 正确读取容器的资源限制
- CPU 限额与线程调度:CPU 被限流后 JVM 如何自处
- 内存限额与 OOM 防护:在容器内存天花板下合理分配堆/非堆/堆外
- 优雅停机:Pod 被驱逐时如何体面地关闭
- 镜像优化:从 800MB 的臃肿镜像到 200MB 的精简镜像
二、JVM 容器感知:让 JVM 看清自己的"牢笼"
2.1 问题的根源
在 Kubernetes 中,资源限制通过 cgroups 实现:
# Pod 定义
resources:
  limits:
    cpu: "2"
    memory: "2Gi"
  requests:
    cpu: "1"
    memory: "1Gi"
这些限制被写入 cgroups 文件系统:
/sys/fs/cgroup/memory/memory.limit_in_bytes→ 内存限制/sys/fs/cgroup/cpu/cpu.cfs_quota_us和cpu.cfs_period_us→ CPU 限制
但 JVM 默认读取的是 /proc/cpuinfo 和 /proc/meminfo,而不是 cgroups。这就是"容器盲"的根源。
2.2 演进历史
| 版本 | 机制 | 说明 |
|---|---|---|
| JDK 8u131 之前 | 无 | 读取宿主机 /proc,完全不知道容器限制 |
| JDK 8u131-8u191 | -XX:+UseCGroupMemoryLimitForHeap |
实验性,仅内存感知,需手动开启 |
| JDK 8u191+ | -XX:+UseContainerSupport |
默认开启,内存+CPU 感知 |
| JDK 10+ | -XX:+UseContainerSupport(默认) |
官方支持,更精确的 cgroup v2 支持 |
| JDK 15+ | -XX:+UseContainerSupport(默认) |
完善,支持 cgroup v2 统一层级 |
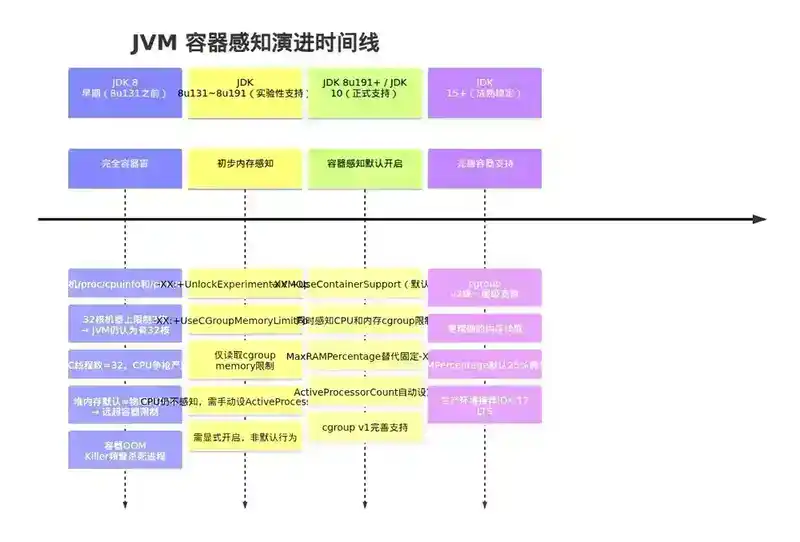
面试关键点:JDK 8 是分水岭。面试中如果有人问"容器中 JVM 内存怎么设置",第一反应应该是问对方用的 JDK 版本。
2.3 核心参数
# 现代 JVM 的容器感知参数(JDK 10+)

- XX:+UseContainerSupport          # 启用容器感知(默认开启)


- XX:MaxRAMPercentage=75.0         # 最大堆内存占容器内存的百分比(替代 -Xmx)


- XX:InitialRAMPercentage=25.0     # 初始堆内存占容器内存的百分比(替代 -Xms)


- XX:MinRAMPercentage=50.0         # 小内存场景(<200MB)的堆内存百分比
为什么用百分比而不是固定值?
# 坏做法:硬编码 -Xmx
java -Xmx1500m -jar app.jar   # 容器限制 2GB,看似合理
# 但运维改了容器限制为 4GB,代码没改,JVM 还是只用 1.5GB

# 好做法:百分比
java -XX:MaxRAMPercentage=75.0 -jar app.jar
# 容器 2GB → 堆 1.5GB,容器 4GB → 堆 3GB,自动适应
MaxRAMPercentage vs MinRAMPercentage 的区别:
- 容器内存 ≥ 200MB 时,
MaxRAMPercentage生效 - 容器内存 < 200MB 时,
MinRAMPercentage生效(因为小内存场景需要给非堆留更多空间)
2.4 默认值是多少?
# JDK 10+ 的默认值

- XX:MaxRAMPercentage=25.0    # 默认只给堆 25%!这太保守了


- XX:MinRAMPercentage=50.0
这是一个巨大的坑:如果你在 2GB 容器中不设置 MaxRAMPercentage,JVM 默认最大堆只有 500MB。对于大多数 Java 应用来说,这远远不够。这就是为什么容器中部署 Java 应用时,必须显式设置 MaxRAMPercentage——通常建议 50%-75%,取决于非堆内存需求。
2.5 验证容器感知是否生效
# 方法1:查看 JVM 启动参数
java -XX:+PrintFlagsFinal -version | grep -E "UseContainerSupport|MaxRAMPercentage|InitialRAMPercentage"

# 方法2:在容器内运行
docker run --memory=2g --cpus=2 my-java-app java -XX:+PrintFlagsFinal -version | grep MaxHeapSize

# 方法3:使用 jinfo(运行时查看)
jinfo -flag MaxHeapSize <pid>
# 在 2GB 容器中,MaxHeapSize 应该约为 1.5GB(如果 MaxRAMPercentage=75)
三、CPU 限额与 JVM 线程数:当 CPU 变成"限速公路"
3.1 CPU Throttle 是什么
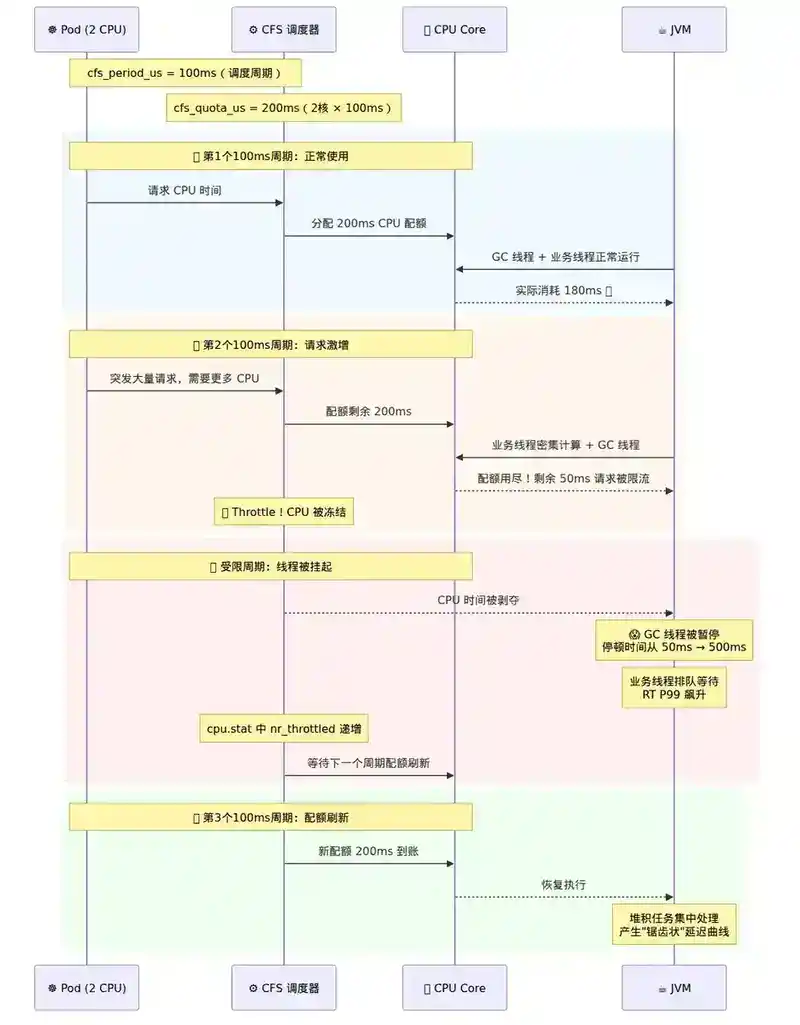
Kubernetes 的 CPU 限制不是"最多用 2 核",而是"平均下来最多用 2 核"。实现机制是 CFS(Completely Fair Scheduler)配额:
cpu.cfs_period_us = 100000(100ms,默认调度周期)
cpu.cfs_quota_us  = 200000(200ms,每周期可用的 CPU 时间)
这意味着容器每 100ms 可以使用 200ms 的 CPU 时间——也就是 2 个核心。但如果容器在 50ms 内就用完了 200ms 的配额,剩下的 50ms 会被限流(throttle),进程被暂停。
3.2 JVM 如何感知 CPU 限额
JDK 10+ 的容器感知不仅作用于内存,也作用于 CPU:
// JVM 内部逻辑
int availableProcessors = Runtime.getRuntime().availableProcessors();
// 物理机 32 核 → 返回 32
// 容器限制 2 核 → 返回 2(JDK 10+)
这影响了什么?
- GC 线程数:
ParallelGCThreads默认 =availableProcessors(但上限 8) - ForkJoinPool.commonPool():并行度 =
availableProcessors - 1 - CompletableFuture 默认线程池:同上
- 一般线程池:
Executors.newFixedThreadPool(n)如果 n 基于availableProcessors()
3.3 手动控制 CPU 核心数
# 如果容器感知不生效,可以手动指定

- XX:ActiveProcessorCount=2
场景:有些框架(如 Netty)会创建 availableProcessors() * 2 个 EventLoop 线程。32 核机器上容器限制 2 核,JVM 感知到 2 核,所以创建 4 个 EventLoop——合理。但如果 JVM 版本太老没感知到,就会创建 64 个线程在 2 个 CPU 上上下文切换,吞吐量反而下降。
3.4 CPU Throttle 的监控与排查
# 查看容器的 CPU 限流情况
cat /sys/fs/cgroup/cpu/cpu.stat
# nr_periods: 1000    ← 经历了 1000 个调度周期
# nr_throttled: 200   ← 其中 200 个周期被限流
# throttled_time: 50000000000  ← 总限流时间(纳秒)

# 如果 nr_throttled / nr_periods > 10%,说明 CPU 配额不足
面试常见问题:容器 CPU 使用率不高但 RT 很高,为什么?答案可能是 CPU Throttle——虽然平均使用率不高,但瞬时请求可能触发了限流,导致请求排队。
四、内存限额与 OOM 防护:在多维内存空间中走钢丝
4.1 容器中的内存全景图
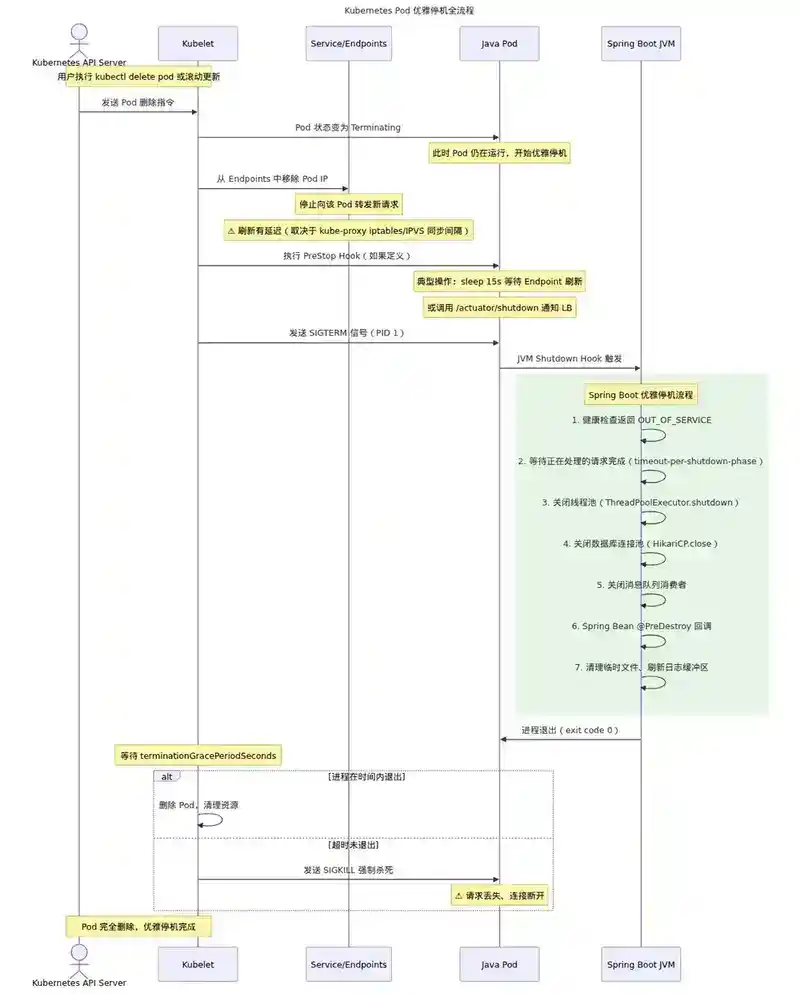
容器内存 ≠ JVM 堆内存。Java 进程的内存占用是一个多维空间:
┌─────────────────────────────────────────────────────────────┐
│                    容器内存限制(如 2GB)                     │
├─────────────────────────────────────────────────────────────┤
│ ┌───────────────────────────────────────────────────────┐   │
│ │                    堆内存 (Heap)                       │   │
│ │  -Xmx / MaxRAMPercentage                              │   │
│ │  存放:对象实例、数组                                   │   │
│ └───────────────────────────────────────────────────────┘   │
│ ┌──────────────────────────────┐ ┌────────────────────────┐ │
│ │      元空间 (Metaspace)       │ │    线程栈 (Thread Stack) │ │
│ │  -XX:MaxMetaspaceSize        │ │  -Xss (默认 1MB/线程)    │ │
│ │  存放:类元数据、方法信息      │ │  存放:局部变量、调用栈   │ │
│ └──────────────────────────────┘ └────────────────────────┘ │
│ ┌───────────────────────────────────────────────────────┐   │
│ │              堆外内存 (Direct Memory)                  │   │
│ │  -XX:MaxDirectMemorySize(默认等于 -Xmx)              │   │
│ │  存放:NIO ByteBuffer、Netty 池化内存                   │   │
│ └───────────────────────────────────────────────────────┘   │
│ ┌───────────────────────────────────────────────────────┐   │
│ │              其他 (Code Cache / GC / JIT / Native)     │   │
│ │  Code Cache、GC 数据结构、JIT 编译器、JNI 调用          │   │
│ └───────────────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────────────┘
4.2 内存预算公式
最重要的公式:
容器内存 = 堆 + 元空间 + (线程数 × 线程栈大小) + 堆外内存 + 其他
以一个典型的 Spring Boot 微服务为例(容器 2GB):
| 内存区域 | 估算 | 说明 |
|---|---|---|
| 堆内存 | 1.2GB (60%) | -XX:MaxRAMPercentage=60 |
| 元空间 | 128MB | -XX:MaxMetaspaceSize=128m |
| 线程栈 | 200MB | 200 线程 × 1MB(默认) |
| 堆外内存 | 256MB | Netty 连接池、NIO Buffer |
| 其他 | 200MB | Code Cache、GC、JIT、Native |
| 合计 | ~2GB | 刚好用完 |
面试关键点:如果你把 MaxRAMPercentage 设成 90%,剩下的 10% 要分给元空间、线程栈、堆外内存和其他——基本不够用,OOM 是迟早的事。
4.3 常见 OOM 场景与诊断
场景一:堆外内存泄漏
# 现象:容器被 OOM Kill,但 Heap Dump 只有 500MB,容器限制 2GB
# 诊断思路:
# 1. 查看 JVM 进程的 RSS(实际物理内存)
ps -o rss,vsz,cmd -p <pid>
# 2. 使用 Native Memory Tracking
java -XX:NativeMemoryTracking=detail -jar app.jar
jcmd <pid> VM.native_memory summary
# 3. 排查 Netty 堆外内存(常见元凶)
# 检查是否有 ByteBuf 未释放
场景二:线程数爆炸
# 一个线程默认栈大小 1MB,1000 个线程 = 1GB 栈内存
# 如果容器只有 2GB,线程栈就可能吃掉一半
# 诊断:
jstack <pid> | grep "^\"" | wc -l   # 统计线程数
# 如果线程数 > 500,考虑减少线程池大小或降低 -Xss
场景三:元空间溢出
# 现象:java.lang.OutOfMemoryError: Metaspace
# 常见原因:动态生成大量类(CGLIB 代理、Groovy 脚本、JSP 编译)
# 解决:

- XX:MaxMetaspaceSize=256m   # 设置上限


- XX:+PrintClassHistogram    # 查看类加载情况
4.4 JVM 参数推荐模板
# 通用容器化 Java 应用 JVM 参数(JDK 11+)
java \
  -XX:MaxRAMPercentage=75.0 \
  -XX:InitialRAMPercentage=25.0 \
  -XX:MaxMetaspaceSize=256m \
  -XX:MaxDirectMemorySize=256m \
  -Xss512k \
  -XX:+UseG1GC \
  -XX:MaxGCPauseMillis=200 \
  -XX:+ExitOnOutOfMemoryError \
  -XX:+HeapDumpOnOutOfMemoryError \
  -XX:HeapDumpPath=/tmp/heapdump.hprof \
  -jar app.jar

# 参数说明:
# MaxRAMPercentage=75  → 堆占容器内存 75%
# MaxMetaspaceSize     → 防止元空间无限制增长
# MaxDirectMemorySize  → 防止堆外内存无限制增长
# Xss512k              → 减少线程栈大小(默认 1MB,降到 512KB)
# ExitOnOutOfMemoryError → OOM 时直接退出,让 K8s 重启
# HeapDumpOnOutOfMemoryError → OOM 时保留现场
五、优雅停机:Pod 被杀死时,Java 应用如何体面地告别
5.1 Kubernetes 的 Pod 终止流程
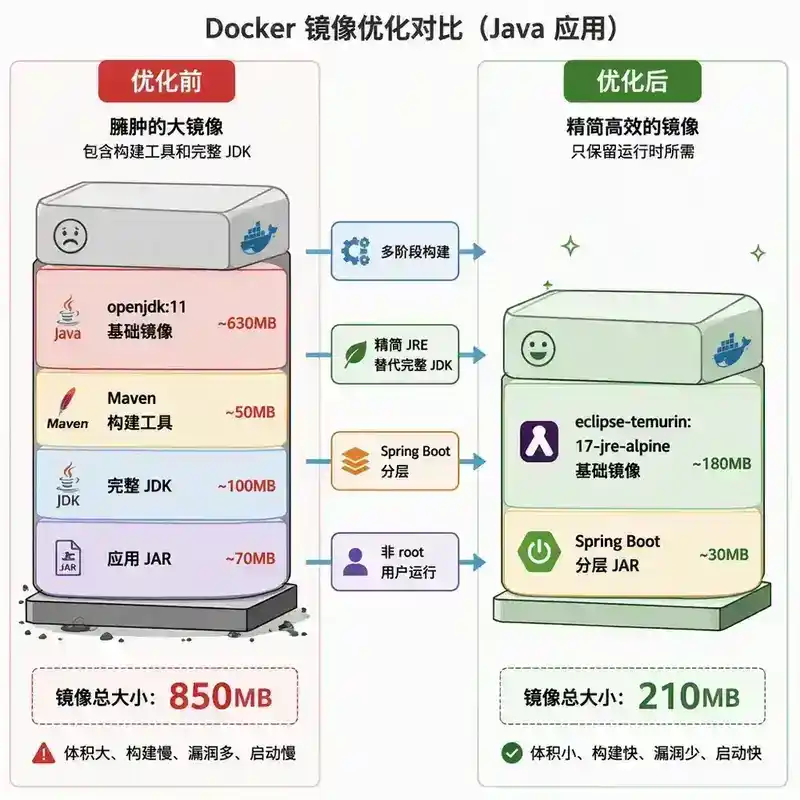
当一个 Pod 被删除或滚动更新时,Kubernetes 执行以下流程:
1. Pod 状态变为 Terminating
2. PreStop Hook 执行(如果定义了)
3. 向容器主进程发送 SIGTERM 信号
4. 等待 terminationGracePeriodSeconds(默认 30 秒)
5. 如果进程仍未退出,发送 SIGKILL 强制杀死
关键问题:Java 应用收到 SIGTERM 后,默认行为是什么?
// 默认情况下,JVM 不会自动处理 SIGTERM
// 进程被直接杀死,正在处理的请求丢失,连接池未关闭
5.2 Spring Boot 优雅停机
Spring Boot 2.3+ 内置了优雅停机支持:
# application.yml
server:
  shutdown: graceful

spring:
  lifecycle:
    timeout-per-shutdown-phase: 20s
// 或者通过代码
@SpringBootApplication
public class Application {

    public static void main(String[ ] args) {

        SpringApplication app = new SpringApplication(Application.class);
        app.setRegisterShutdownHook(true);  // 注册 JVM Shutdown Hook
        app.run(args);
    }
}
优雅停机的执行流程:
1. 收到 SIGTERM
2. 健康检查端点返回 OUT_OF_SERVICE(K8s 停止转发流量)
3. 等待正在处理的请求完成(最多 timeout-per-shutdown-phase)
4. 关闭线程池
5. 关闭数据库连接池
6. 关闭消息队列消费者
7. 清理临时文件
8. 进程退出
5.3 Kubernetes 侧配置
apiVersion: v1
kind: Pod
spec:
  terminationGracePeriodSeconds: 60   # 给足时间(必须 > Spring 超时时间)
  containers:
  - name: java-app
    lifecycle:
      preStop:
        exec:
          command:
          - /bin/sh
          - -c
          - |
            # 1. 通知负载均衡停止路由流量
            curl -X POST http://localhost:8080/actuator/shutdown
            # 2. 等待流量排空(取决于 LB 刷新间隔)
            sleep 15
时间协调公式:
terminationGracePeriodSeconds > PreStop sleep + Spring timeout-per-shutdown-phase + 缓冲
推荐:60 = 15 (PreStop) + 20 (Spring) + 25 (缓冲)
5.4 常见陷阱
陷阱一:SIGTERM 被忽略
// 某些框架(如旧版 Netty)会忽略 SIGTERM
// 解决:使用 -XX:+ExitOnOutOfMemoryError 或自定义 Signal Handler
sun.misc.Signal.handle(new sun.misc.Signal("TERM"), signal -> {
    System.out.println("Received SIGTERM, shutting down...");
    SpringApplication.exit(context, () -> 0);
});
陷阱二:线程池未关闭
// 错误做法:线程池没有在 shutdown hook 中关闭
ExecutorService executor = Executors.newFixedThreadPool(10);
// 正确做法:使用 @PreDestroy 或 Shutdown Hook
@PreDestroy
public void shutdown() {
    executor.shutdown();
    executor.awaitTermination(10, TimeUnit.SECONDS);
}
陷阱三:数据库连接未归还
// HikariCP 默认会在 shutdown hook 中关闭连接池
// 但如果你自定义了 DataSource,需要手动处理
@Bean(destroyMethod = "close")
public DataSource dataSource() {
    return new HikariDataSource(config);
}
六、镜像优化:从 800MB 到 200MB 的工程化实践
6.1 为什么镜像大小很重要
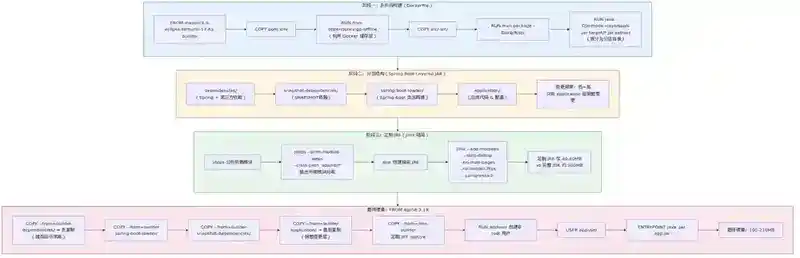
- 拉取速度:800MB 镜像在 1Gbps 带宽下需要约 7 秒,200MB 需要约 2 秒
- 部署速度:滚动更新时,每个 Pod 都需要拉取镜像,镜像越小,滚动越快
- 安全攻击面:镜像越大,包含的组件越多,潜在漏洞越多
- 存储成本:镜像仓库中每个 tag 都占用存储空间
6.2 基础镜像选择
| 基础镜像 | 大小 | 适用场景 |
|---|---|---|
openjdk:11 |
~630MB | 不推荐,包含完整 JDK |
openjdk:11-jre |
~270MB | 仅需运行时 |
openjdk:11-jre-slim |
~200MB | 去除了非必要组件 |
eclipse-temurin:17-jre-alpine |
~180MB | Alpine Linux + JRE |
distroless/java17 |
~120MB | Google 出品,无 Shell |
eclipse-temurin:17-jre-jammy |
~210MB | Ubuntu 基础,兼容性好 |
推荐:生产环境使用 eclipse-temurin:17-jre-alpine 或 distroless/java17。
6.3 多阶段构建(Multi-stage Build)
这是镜像优化的核心手段。上一篇文章(232)已经详细介绍了多阶段构建的原理,这里聚焦于 Java 应用的具体实践:
# ===== 阶段 1:构建阶段 =====
FROM maven:3.9-eclipse-temurin-17 AS builder
WORKDIR /app
COPY pom.xml .
# 先下载依赖(利用 Docker 缓存层)
RUN mvn dependency:go-offline -B
COPY src/ src/
RUN mvn package -DskipTests

# ===== 阶段 2:运行阶段 =====
FROM eclipse-temurin:17-jre-alpine
WORKDIR /app

# 创建非 root 用户
RUN addgroup -S appgroup && adduser -S appuser -G appgroup

# 仅复制 JAR 包
COPY --from=builder /app/target/*.jar app.jar

USER appuser

ENTRYPOINT ["java", \
  "-XX:MaxRAMPercentage=75.0", \
  "-XX:+UseG1GC", \
  "-XX:+ExitOnOutOfMemoryError", \
  "-jar", "app.jar"]
关键优化点:
- 先复制 pom.xml,再复制源码:这样修改源码时不会触发 maven 依赖下载的重新构建
- 构建阶段使用完整 Maven 镜像,运行阶段只用 JRE
- 非 root 用户运行:安全最佳实践
- 构建产物不进入最终镜像:多阶段构建的精髓
6.4 jlink:定制最小化 JRE
如果你需要极致的镜像精简,可以使用 jlink 创建仅包含必要模块的定制 JRE:
# 使用 jlink 创建定制 JRE
FROM eclipse-temurin:17-jdk-alpine AS jlink-builder
# 分析依赖,找出需要的模块
RUN jdeps --ignore-missing-deps -q \
    --recursive \
    --multi-release 17 \
    --print-module-deps \
    --class-path 'app/lib/*' \
    app.jar > modules.txt

# 用 jlink 创建精简 JRE
RUN jlink \
    --add-modules $(cat modules.txt) \
    --strip-debug \
    --no-man-pages \
    --no-header-files \
    --compress=2 \
    --output /jre

# 最终镜像
FROM alpine:3.19
COPY --from=jlink-builder /jre /opt/jre
COPY --from=builder /app/target/app.jar /app/app.jar
ENV JAVA_HOME=/opt/jre
ENV PATH="/opt/jre/bin:${PATH}"
ENTRYPOINT ["java", "-jar", "/app/app.jar"]
效果:完整 JDK 约 300MB,定制 JRE 可以做到 40-80MB,镜像总大小可以控制在 100MB 以内。
6.5 Spring Boot 分层构建
Spring Boot 2.3+ 支持将 JAR 包拆分为多层,利用 Docker 缓存:
<!-- pom.xml -->
<plugin>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-maven-plugin</artifactId>
    <configuration>
        <layers>
            <enabled>true</enabled>
        </layers>
    </configuration>
</plugin>
FROM eclipse-temurin:17-jre-alpine
WORKDIR /app

# 按变更频率从低到高复制各层
COPY --from=builder /app/target/dependencies/ ./
COPY --from=builder /app/target/spring-boot-loader/ ./
COPY --from=builder /app/target/snapshot-dependencies/ ./
COPY --from=builder /app/target/application/ ./

ENTRYPOINT ["java", "org.springframework.boot.loader.JarLauncher"]
分层的好处:依赖层(dependencies)变更频率远低于应用层(application),每次构建只需重新推送应用层,大幅减少推送时间和存储空间。
七、实战案例:一个完整的容器化调优过程
7.1 初始状态
# 部署配置
apiVersion: apps/v1
kind: Deployment
spec:
  template:
    spec:
      containers:
      - name: order-service
        image: order-service:latest  # 850MB
        resources:
          limits:
            cpu: "2"
            memory: "2Gi"
          requests:
            cpu: "1"
            memory: "1Gi"
# JVM 参数(原始)
java -Xmx1500m -Xms1500m -jar order-service.jar
问题列表:
- 镜像 850MB,拉取慢
- JVM 参数硬编码,无法适应容器大小变化
- 没有优雅停机配置
- 偶尔 OOM,堆 Dump 显示堆只有 500MB 但进程 RSS 超过 2GB
- 高峰时段 CPU 使用率不高但 RT 飙升
7.2 优化步骤
第一步:优化 Dockerfile
# 优化前:单阶段构建,镜像 850MB
FROM openjdk:11
COPY target/order-service.jar /app/
ENTRYPOINT ["java", "-Xmx1500m", "-Xms1500m", "-jar", "/app/order-service.jar"]

# 优化后:多阶段 + 分层 + 精简 JRE
FROM maven:3.9-eclipse-temurin-17 AS builder
WORKDIR /app
COPY pom.xml .
RUN mvn dependency:go-offline -B
COPY src/ src/
RUN mvn package -DskipTests
RUN java -Djarmode=layertools -jar target/*.jar extract

FROM eclipse-temurin:17-jre-alpine
RUN addgroup -S app && adduser -S app -G app
WORKDIR /app
COPY --from=builder /app/dependencies/ ./
COPY --from=builder /app/spring-boot-loader/ ./
COPY --from=builder /app/snapshot-dependencies/ ./
COPY --from=builder /app/application/ ./
USER app
ENTRYPOINT ["java", \
  "-XX:MaxRAMPercentage=60.0", \
  "-XX:MaxMetaspaceSize=128m", \
  "-XX:MaxDirectMemorySize=256m", \
  "-Xss512k", \
  "-XX:+UseG1GC", \
  "-XX:+ExitOnOutOfMemoryError", \
  "-XX:+HeapDumpOnOutOfMemoryError", \
  "org.springframework.boot.loader.JarLauncher"]
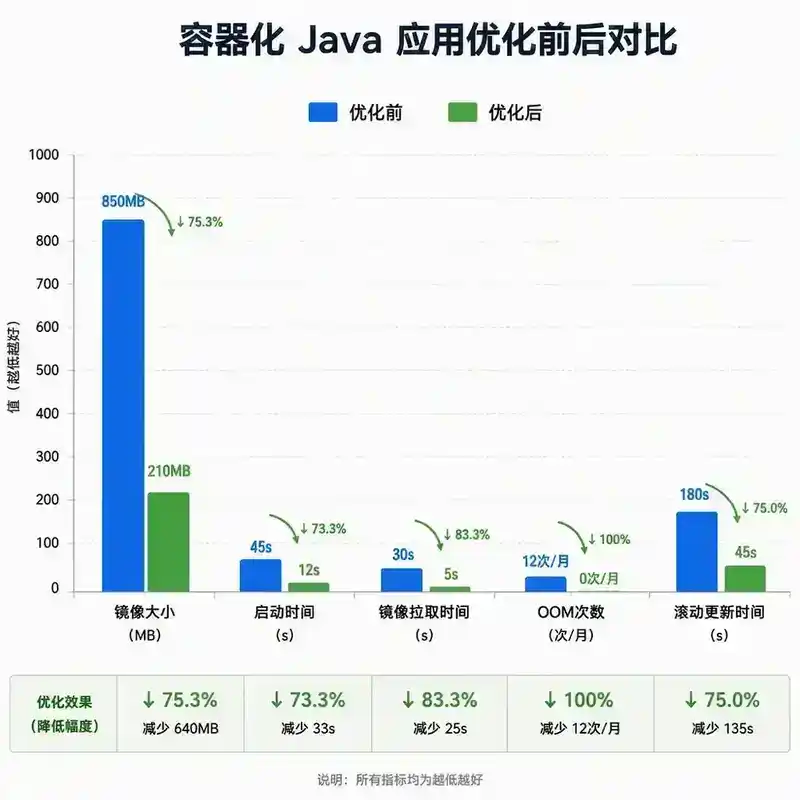
镜像大小:850MB → 210MB(减少 75%)
第二步:优化 Kubernetes 配置
spec:
  terminationGracePeriodSeconds: 60
  containers:
  - name: order-service
    image: order-service:optimized
    resources:
      limits:
        cpu: "2"
        memory: "3Gi"    # 从 2Gi 增加到 3Gi
      requests:
        cpu: "1"
        memory: "2Gi"
    lifecycle:
      preStop:
        exec:
          command: ["/bin/sh", "-c", "sleep 15"]
    readinessProbe:
      httpGet:
        path: /actuator/health
        port: 8080
      initialDelaySeconds: 30
      periodSeconds: 10
第三步:Spring Boot 优雅停机
server:
  shutdown: graceful
spring:
  lifecycle:
    timeout-per-shutdown-phase: 25s
7.3 优化结果
| 指标 | 优化前 | 优化后 | 改善 |
|---|---|---|---|
| 镜像大小 | 850MB | 210MB | -75% |
| 镜像拉取时间 | ~8s | ~2s | -75% |
| Pod 启动时间 | ~45s | ~18s | -60% |
| OOM 次数/天 | 3-5 | 0 | 消除 |
| 滚动更新时间 | ~120s | ~40s | -67% |
| CPU Throttle | 15% | 2% | -87% |
八、总结
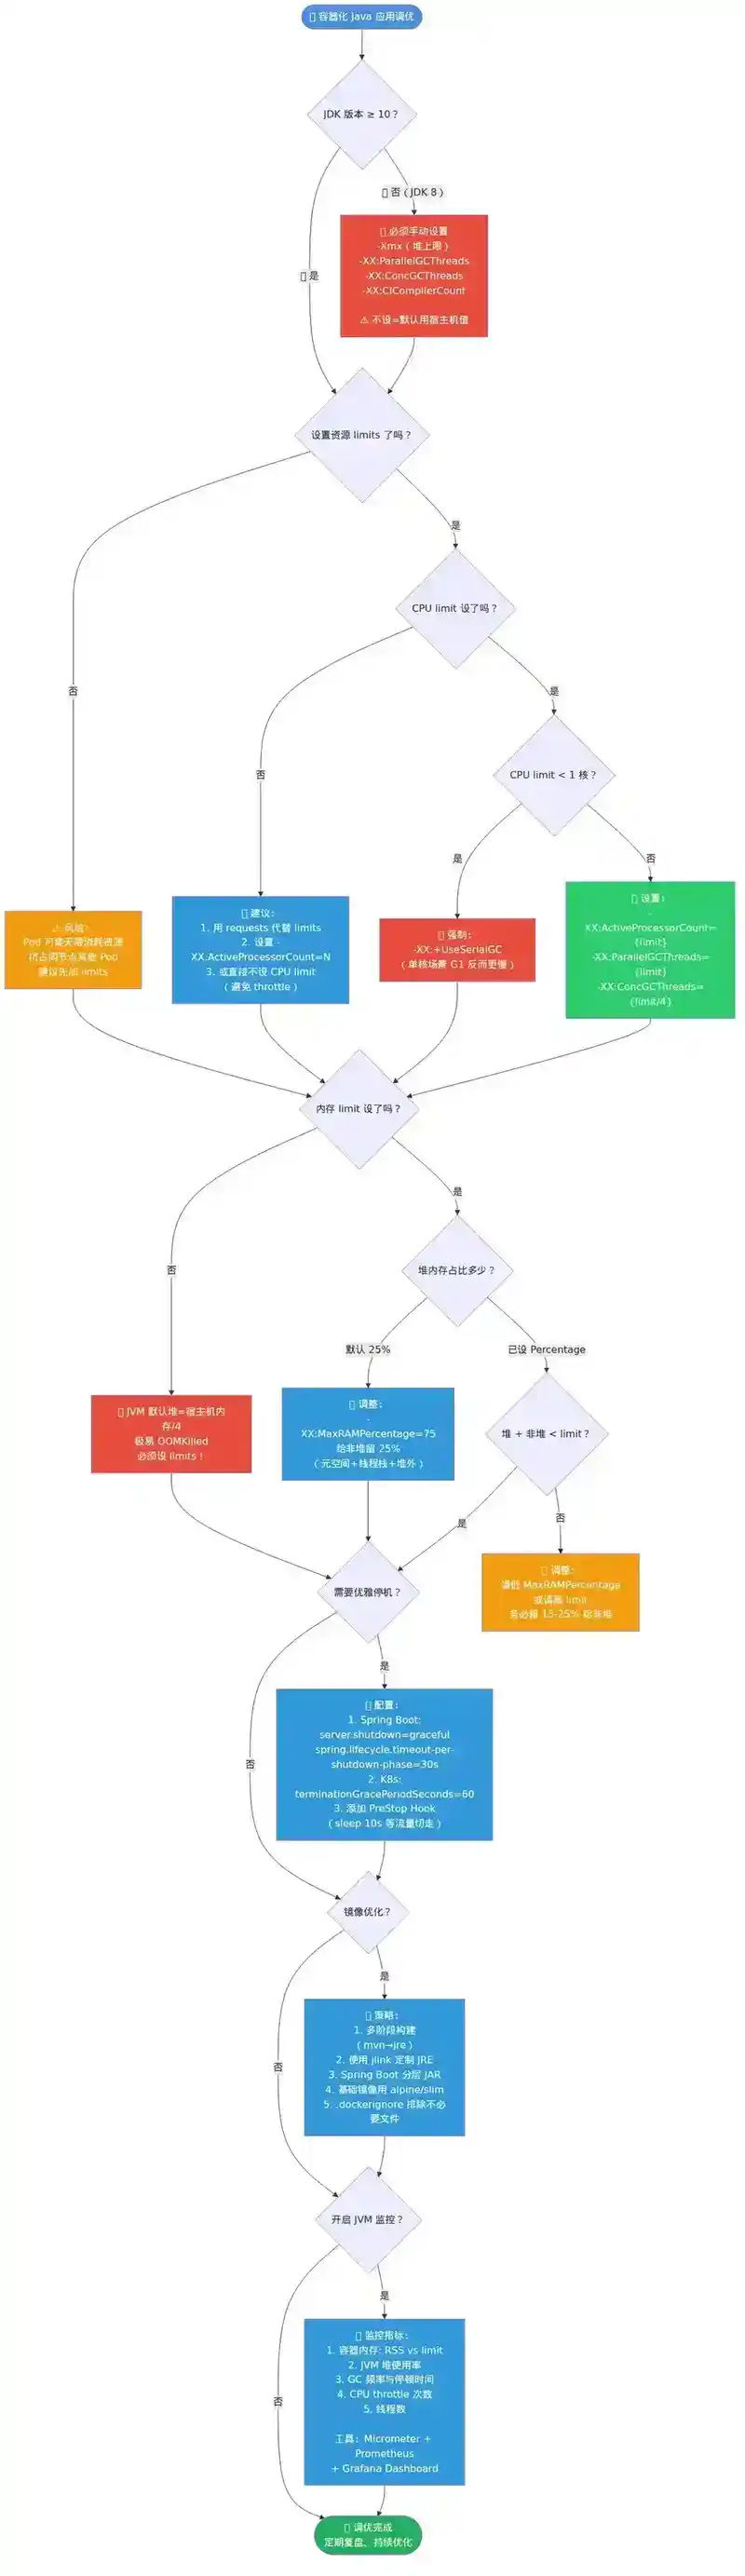
容器化 Java 应用调优的本质是让 JVM 理解容器的边界。核心要点:
- 开启容器感知:
-XX:+UseContainerSupport(JDK 10+ 默认开启) - 用百分比替代固定值:
-XX:MaxRAMPercentage=75.0而不是-Xmx - 做好内存预算:堆 + 元空间 + 线程栈 + 堆外 + 其他 ≤ 容器限制
- 配置优雅停机:Spring Boot
server.shutdown=graceful+ K8sterminationGracePeriodSeconds+ PreStop Hook - 精简镜像:多阶段构建 + 精简 JRE + 分层 + 非 root 用户
面试问答
Q1:你线上部署的 Java 应用,JVM 参数是怎么设置的?为什么这样设置?
不要只报参数。要体现出"容器感知"的思路:
"我们用的是 JDK 17,容器限制 4 核 4GB。JVM 参数核心是 -XX:MaxRAMPercentage=65.0,让堆自动占容器内存的 65%。剩余 35% 预算给元空间(128MB)、线程栈(200+ 线程 × 512KB ≈ 100MB)、堆外内存(Netty 约 300MB)和 Code Cache 等。之所以不用 75%,是因为我们用了 Netty 做 HTTP 客户端,堆外内存开销比较大。另外必须加 -XX:+ExitOnOutOfMemoryError,因为 OOM 时 Spring Boot 可能不会自动退出,会导致 Pod 挂着但不响应。"
Q2:你们的镜像多大?你做过哪些镜像优化?
"优化前单阶段构建 + openjdk:11 基础镜像,镜像 850MB。优化后用了多阶段构建(Maven 构建 → JRE 运行),基础镜像换成 eclipse-temurin:17-jre-alpine,加上 Spring Boot 分层,最终镜像 210MB。还尝试过 jlink 定制 JRE,能做到 80MB 级别,但需要额外维护模块列表,团队觉得 ROI 不高就没推。"
Q3:Pod 被删除时,你的 Java 应用怎么保证正在处理的请求不丢失?
"三层防护:第一层,Spring Boot 开启 server.shutdown=graceful,收到 SIGTERM 后等待已有请求处理完,最多等 25 秒。第二层,Kubernetes PreStop Hook sleep 15 秒,给 Service 和 Ingress 刷新 Endpoint 的时间,确保新流量不再进来。第三层,terminationGracePeriodSeconds 设为 60 秒,给足缓冲。整个流程:PreStop 15s + Spring 25s = 40s,还有 20s 缓冲。另外健康检查端点 /actuator/health 在 shutdown 期间会自动返回 OUT_OF_SERVICE。"
Q4:容器里 JVM 的 Runtime.getRuntime().availableProcessors() 返回值是多少?
"JDK 8u191 之前返回宿主机 CPU 核心数(比如 32),之后返回容器限制的 CPU 核心数(比如 2)。这个差异会影响 GC 线程数、ForkJoinPool 并行度、Netty 的 EventLoop 线程数等。如果 JDK 版本太老不支持容器感知,可以手动加 -XX:ActiveProcessorCount=2。"
Q5:容器限制 2GB 内存,堆设置 1.5GB,但容器还是被 OOM Kill 了,可能是什么原因?
"堆外内存泄漏。排查思路:先用 ps 看进程 RSS 是不是远大于堆大小。如果是,开启 Native Memory Tracking(-XX:NativeMemoryTracking=detail),用 jcmd VM.native_memory summary 查看各区域内存。常见元凶包括:Netty 的 ByteBuf 没释放(尤其是池化内存)、JNI 代码分配了 Native 内存没释放、ThreadLocal 持有大对象导致 GC 无法回收。另外检查 DirectByteBuffer 的使用量,-XX:MaxDirectMemorySize 默认等于 -Xmx,如果并发连接数很大,每个连接分配一个 DirectByteBuffer,可能超出限制。"
Q6:你们怎么处理 JDK 版本升级?从 JDK 8 升到 JDK 17 时遇到过容器相关的问题吗?
"JDK 8 升到 17 时,最大的好处是容器感知默认开启。JDK 8 时代需要手动加 -XX:+UseContainerSupport,而且 cgroups v2 支持不完善。升级后,MaxRAMPercentage 和 ActiveProcessorCount 自动生效,简化了参数管理。但要注意 JDK 17 默认 GC 是 G1,而 JDK 8 默认是 Parallel,GC 行为不同,需要重新调优。另外 JDK 17 的 -XX:MaxRAMPercentage 默认值是 25%,太保守了,必须显式覆盖。"
Q7:distroless 镜像和 alpine 镜像怎么选?
"distroless 镜像连 Shell 都没有,更安全,攻击面更小。但代价是没法 docker exec 进去排查问题,日志只能靠标准输出。我们生产环境用 distroless,但会在测试环境保留 alpine 版本,方便排查。关键是要确保应用日志写到 stdout/stderr,不要写文件,否则 distroless 里没法看。另外 distroless 不支持 adduser,因为它没有 useradd 命令——需要在构建阶段复制 /etc/passwd 文件。"
Q8:Kubernetes 的 requests 和 limits 对 JVM 有什么影响?
"requests 影响调度,limits 影响 cgroups 配置。JVM 只读取 limits(cgroups 限制),不读取 requests。所以内存 limits 必须覆盖 JVM 的全部内存需求。如果 requests 设为 1GB 但 limits 设为 2GB,JVM 会以 2GB 为基准计算 MaxHeapSize。但如果 Pod 被调度到只剩 1GB 的节点上,虽然 requests 满足,但 JVM 实际分配 1.5GB 堆,节点可能 OOM。所以 Java 应用建议 requests = limits,避免过度分配。"