阅读时间:约 40-50 分钟 难度:进阶 前置知识:Linux 基础、Git、至少一种编程语言的构建工具(Maven/Gradle/npm 等)
一、引言:为什么需要 CI/CD
想象一个场景:你的团队有 10 个开发,每个人在自己的分支上改代码,每周五下午手动合并、手动打包、手动部署到测试环境。这个过程通常需要 2-3 个小时,而且经常出现"在我机器上能跑啊"、"合并冲突了"、"配置文件忘了改"这类问题。
这就是 CI/CD 要解决的核心问题:把人从重复、易错的交付流程中解放出来,让软件交付变得快速、可靠、可重复。
CI/CD 不是某个工具,而是一套工程实践——它规定了代码从开发者提交到生产环境运行的完整路径上,每个环节应该做什么、由谁来做、如何验证。
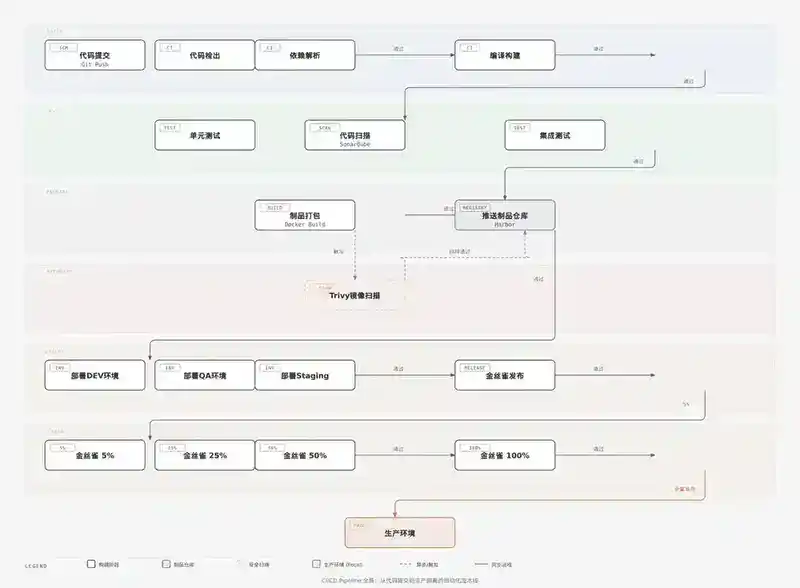
一张全景图可以帮你建立总体认知:
二、CI 与 CD:概念辨析
2.1 CI(Continuous Integration,持续集成)
CI 的核心很简单:高频地将代码变更合并到主干,并自动验证。
关键实践:
- 每个开发至少每天向主干合并一次代码
- 每次合并触发自动化构建和测试
- 构建失败必须在 10 分钟内修复("broken build is a stop-the-line event")
CI 的反馈循环是"分钟级"的。你 push 一段代码,3-5 分钟后就知道它是否破坏了构建、是否引入了回归 bug。
2.2 CD 的两层含义
CD 是个有歧义的缩写,业界通常指两层:
| 层次 | 全称 | 含义 | 关键特征 |
|---|---|---|---|
| Continuous Delivery | 持续交付 | 代码随时可部署到生产,但需要人工触发 | 部署按钮存在,但需要人按 |
| Continuous Deployment | 持续部署 | 代码通过全部验证后自动部署到生产 | 全自动,无人干预 |
大多数公司做的是 Continuous Delivery,而不是 Continuous Deployment。因为生产部署涉及合规、业务窗口、灰度验证等需要人工判断的环节。
2.3 CI/CD 流水线全景
流水线本质上是一个有向无环图(DAG),每个节点代表一个阶段,边代表依赖关系。一个典型的流水线如下:
代码提交 → 构建 → 单元测试 → 代码扫描 → 集成测试 → 制品上传 → 部署开发 → 部署测试 → 部署预发 → 部署生产
                                                                    ↘ 安全扫描  ↗
每个阶段都是一个门禁(Gate):前一阶段失败,后续阶段不执行。这就是"pipeline"这个名字的由来——像管道一样,每个节点都有阀门。
三、构建阶段:从源码到制品
3.1 构建的本质
构建是把人类可读的源代码变成机器可执行的制品的过程。对于 Java 项目,这就是 javac + jar/war;对于前端项目,这就是 npm build + bundle;对于 Go 项目,这就是 go build。
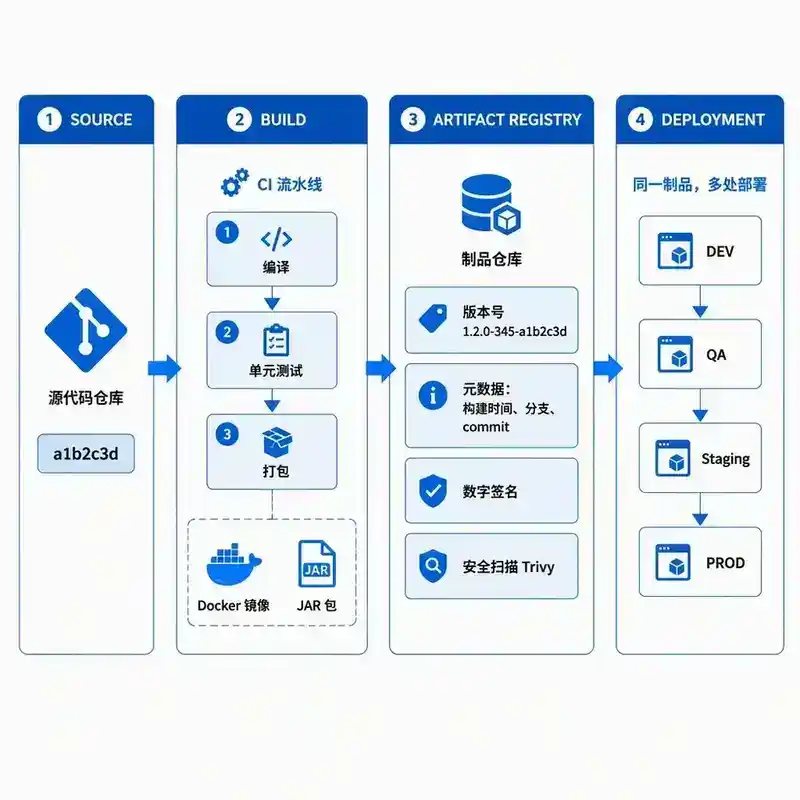
构建阶段的核心输出是不可变的制品(Immutable Artifact)——一次构建,多处部署。同一个制品先在开发环境部署,验证通过后推到测试环境,再推到预发、生产。绝不允许在不同环境重新构建。
3.2 构建的六个关键步骤
1. 代码检出(Checkout)——从 Git 拉取指定分支/commit
2. 依赖解析(Resolve)——下载并缓存依赖(Maven/Gradle/npm/go mod)
3. 编译/转译(Compile)——源码→字节码/二进制
4. 单元测试(Unit Test)——快速反馈,通常在构建阶段并行执行
5. 打包(Package)——将编译产物打包为可部署的制品(JAR/Docker Image/tar.gz)
6. 推送制品(Push)——将制品上传到制品仓库
3.3 构建缓存策略
构建时间直接影响 CI 反馈速度。一个 20 分钟的构建意味着每个 MR 至少要等 20 分钟才能知道结果——这对开发体验是灾难性的。
关键的缓存策略:
- 依赖缓存:Maven 的
~/.m2/repository、Gradle 的~/.gradle/caches、npm 的node_modules。这些应该在 CI 环境中持久化,避免每次重新下载。 - 增量编译:只编译变更的文件。Gradle 的
incremental compilation、Maven 的mvn compile(非 clean compile)都支持增量编译。 - 构建产物缓存:如果项目有多个模块,之前构建过的模块可以直接复用。Gradle 的 Build Cache 和 Maven 的
mvn install到本地仓库都实现了这个思想。 - 分层 Docker 构建:利用 Docker 的分层缓存机制,将变化频率低的层(如 OS 依赖)放在前面,变化频率高的层(如应用代码)放在后面。
3.4 构建工具选型
| 语言 | 主流工具 | 特点 |
|---|---|---|
| Java | Maven | 声明式、约定优于配置、中央仓库生态 |
| Java | Gradle | 增量构建、构建缓存、DSL 灵活、性能优于 Maven |
| JavaScript/TS | npm/yarn/pnpm | pnpm 磁盘效率最高 |
| Go | go mod | 官方工具链内置,简洁 |
| Python | poetry/pip | poetry 锁定依赖版本,比 pip+requirements.txt 更可靠 |
| C/C++ | CMake + Ninja | Ninja 比 Make 更快 |
四、测试阶段:分层验证策略
4.1 测试金字塔
CI/CD 中的测试遵循测试金字塔模型:
        ╱  E2E 测试 ╲         少量,慢,验证关键业务流程
       ╱───────────────╲
      ╱   集成测试      ╲       中等数量,验证模块间交互
     ╱───────────────────╲
    ╱     单元测试        ╲      大量,快,验证函数/方法级逻辑
   ╱─────────────────────────╲
核心原则:越下层的测试越多、越快、越稳定。如果单元测试能覆盖的场景,就不要用集成测试;如果集成测试能覆盖的场景,就不要用 E2E 测试。
4.2 CI 流水线中的测试编排
在流水线中,测试应该按速度从快到慢的顺序执行,实现"快速失败":
单元测试(秒级)→ 组件测试(秒级)→ 集成测试(分钟级)→ E2E 测试(分钟级)→ 性能测试(分钟级)
如果单元测试失败了,就没有必要跑集成测试和 E2E 测试——浪费资源。
4.3 测试数据与环境管理
集成测试和 E2E 测试最大的挑战是测试数据和环境:
- 测试数据:使用 fixture 或 factory 模式生成测试数据,测试结束后自动清理。不要依赖共享数据库中的固定数据——那会导致测试之间相互干扰。
- 环境隔离:每个流水线实例应该有独立的测试环境。Docker Compose 或 Testcontainers 是很好的选择——在测试启动时拉起 MySQL/Redis/Kafka 等依赖,测试结束后销毁。
- 服务虚拟化:对于外部依赖(支付网关、短信服务),使用 WireMock 或 Mountebank 模拟,避免测试依赖外部服务导致不稳定。
4.4 代码质量门禁
除了功能测试,CI 流水线还应该包含代码质量检查:
- 静态分析:SonarQube、Checkstyle、ESLint。检查代码规范、潜在 bug、安全漏洞。
- 代码覆盖率:JaCoCo(Java)、Istanbul(JS)。设置覆盖率阈值,低于阈值则构建失败。但注意:覆盖率是必要不充分条件——高覆盖率不等于高质量,低覆盖率一定有问题。
- 依赖扫描:OWASP Dependency-Check、Snyk。检查第三方依赖是否有已知漏洞。
五、制品管理:不可变交付单元
5.1 什么是制品
制品是构建过程的输出,是部署的唯一输入。制品必须是:
- 不可变:构建完成后,制品内容不再改变。配置通过环境变量或配置中心注入,而不是修改制品。
- 可追溯:每个制品都能追溯到它的源代码(Git commit SHA)、构建时间、构建参数。
- 自包含:制品包含运行所需的一切(或明确声明依赖),不依赖构建环境的任何临时文件。
5.2 制品仓库体系
开发者 push 代码 → CI 构建 → 推送制品 → 制品仓库 → CD 拉取 → 部署
常见的制品仓库:
| 制品类型 | 仓库 | 特点 |
|---|---|---|
| JAR/WAR | Nexus、Artifactory | 支持 Maven/Gradle,代理中央仓库 |
| Docker Image | Harbor、Docker Hub、ECR | 镜像扫描、签名、复制 |
| npm 包 | Verdaccio、npm registry | 私有包管理 |
| Helm Chart | ChartMuseum、Harbor | K8s 应用包管理 |
| 通用文件 | JFrog Artifactory | 支持所有格式 |
5.3 制品版本策略
制品的版本号应该包含足够的信息来追溯来源:
<版本号>-<构建号>-<commit SHA>
例:1.2.0-345-a1b2c3d
或者更简单的:
<分支名>-<commit SHA>-<时间戳>
例:main-a1b2c3d-20240601120000
不要用 SNAPSHOT 做生产部署。SNAPSHOT 是可变的(每次构建可能不同),违背了不可变制品原则。
5.4 制品清理与保留策略
制品仓库的存储成本会随时间快速增长。需要制定清理策略:
- 生产部署过的制品:永久保留
- 发布分支(release/*)的制品:保留 90 天
- 开发分支的制品:保留 30 天
- SNAPSHOT:保留最近 5 个版本
六、部署策略:从安全到效率
6.1 部署策略对比
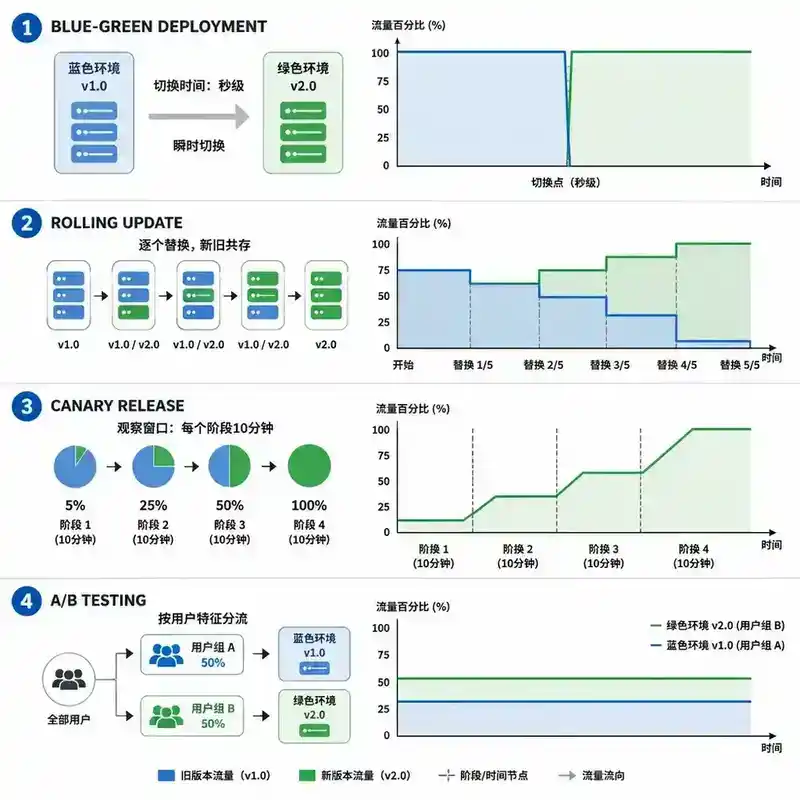
部署策略的选择直接影响系统的可用性和风险。以下是四种主流策略:
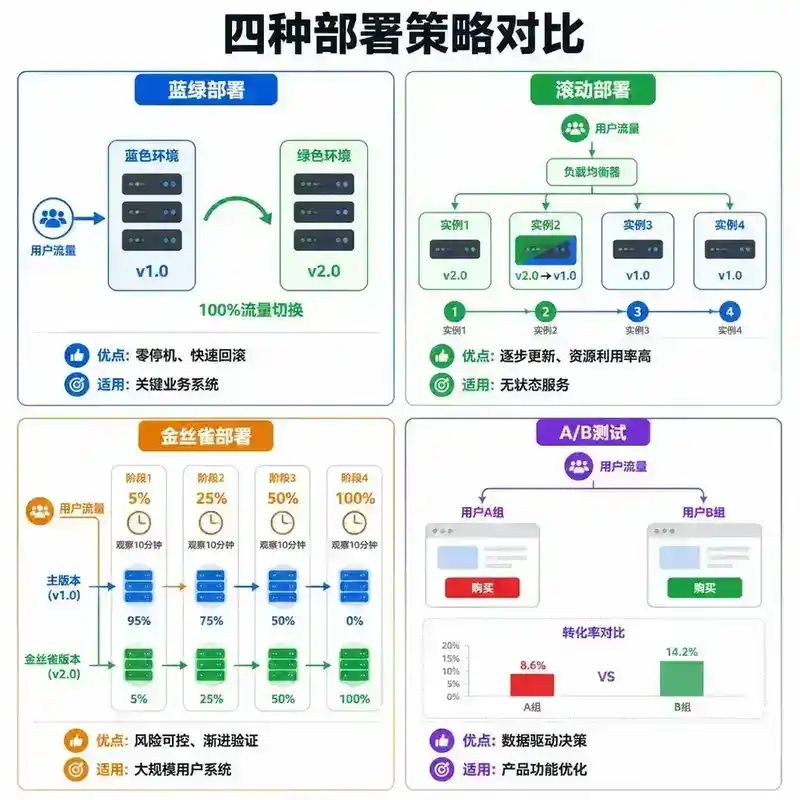
蓝绿部署(Blue-Green)
蓝色环境(v1.0)── 100% 流量
绿色环境(v2.0)── 0% 流量(部署好,等待切换)

切换后:
蓝色环境(v1.0)── 0% 流量
绿色环境(v2.0)── 100% 流量
优点:瞬间切换,回滚只需把流量切回蓝色环境。 缺点:需要双倍资源。 适用:对可用性要求极高的核心服务。
滚动部署(Rolling Update)
逐个替换实例:
实例1: v1.0 → v2.0
实例2: v1.0 → v2.0(等实例1健康检查通过后)
实例3: v1.0 → v2.0
...
优点:不需要额外资源,逐步替换,有问题可以停止。 缺点:部署期间新旧版本共存,需要处理兼容性。 适用:大多数无状态服务的默认选择。
金丝雀部署(Canary Release)
v2.0: 5% 流量 → 观察 10 分钟 → 没问题 → 25% → 50% → 100%
                         ↓ 有问题
                    立即回滚,只影响 5% 用户
优点:风险最小,用真实流量验证新版本。 缺点:需要流量管理基础设施(如 Istio/网关)。 适用:核心业务、高风险变更。
A/B 测试
与金丝雀部署不同,A/B 测试的目的是比较效果而非验证稳定性。比如:A 版本用红色按钮,B 版本用绿色按钮,看哪个转化率更高。A/B 测试通常按用户特征(用户 ID 哈希、地区等)分流,而非随机比例。
6.2 部署与环境管理
环境层级应该遵循"越往后越像生产"的原则:
开发环境(DEV):快速迭代,允许不稳定
测试环境(QA):功能验证,环境相对稳定
预发环境(Staging):生产环境的镜像,最终验证
生产环境(PROD):正式环境
关键规则:
- DEV 和 QA 可以共用一个 K8s 集群,但用不同的 namespace 隔离
- Staging 应该有独立的集群,配置与生产一致(但规模可以缩小)
- 配置文件(application.yml)应该与代码分离,通过 ConfigMap/配置中心注入
- 数据库 schema 变更应该通过 Flyway/Liquibase 等迁移工具管理,不要手动执行 SQL
七、回滚机制:快速恢复
7.1 回滚的第一性原理
回滚的目标不是"恢复上一版本",而是在最短时间内恢复服务可用性。这两个目标有时是矛盾的——如果上一版本也有 bug,恢复它并不能解决问题。
因此,回滚策略应该分层次:
| 层级 | 策略 | 恢复时间 | 适用场景 |
|---|---|---|---|
| 流量切换 | 切回旧环境(蓝绿) | 秒级 | 蓝绿部署 |
| 版本回退 | 部署上一个制品 | 分钟级 | 滚动部署 |
| 配置回滚 | 回退配置中心配置 | 秒级 | 配置变更导致的问题 |
| Feature Flag | 关闭特性开关 | 秒级 | 新功能有 bug,但不想整体回滚 |
| 数据修复 | 执行补偿脚本 | 小时级 | 数据被错误修改 |
7.2 回滚的技术实现
1. 蓝绿部署的回滚:切换负载均衡器,把流量切回蓝色环境。这是最快的回滚方式。
2. K8s 滚动部署的回滚:
kubectl rollout undo deployment/myapp          # 回滚到上一个版本
kubectl rollout undo deployment/myapp --to-revision=3  # 回滚到指定版本
kubectl rollout history deployment/myapp        # 查看部署历史
3. 数据库回滚的挑战:这是最复杂的部分。改代码容易,改数据难。
- 向前兼容的 schema 变更:新增列(有默认值)、新增表——不需要回滚,旧版本代码可以忽略。
- 破坏性 schema 变更:删除列、重命名列——需要分阶段执行:
- 阶段 1:代码同时读写新旧列
- 阶段 2:迁移数据到新列
- 阶段 3:代码只读新列
- 阶段 4:删除旧列(等确认不需要回滚后)
7.3 回滚决策清单
部署后发现异常,应该回滚还是向前修复?决策矩阵:
| 问题类型 | 建议 | 理由 |
|---|---|---|
| 错误率飙升 > 1% | 立即回滚 | 宁可错杀,不可放过 |
| 响应时间劣化 > 50% | 立即回滚 | 可能是雪崩的前兆 |
| 非核心功能小 bug | 向前修复 | 回滚代价 > bug 影响 |
| 数据不一致 | 先止损(限流),再修复 | 回滚不能修复数据 |
八、流水线即代码(Pipeline as Code)
8.1 为什么 Pipeline as Code
早期的 CI/CD 工具(如 Jenkins 1.x)通过 Web UI 配置流水线,这有几个致命问题:
- 流水线配置无法版本控制
- 无法 Code Review
- 无法在分支间复制和调整
- 配置丢失后无法恢复
Pipeline as Code 的核心思想:流水线配置和代码放在同一个仓库,受版本控制,随代码一起演进。
8.2 主流实现
Jenkinsfile(Jenkins)
pipeline {
    agent any
    stages {
        stage('Build') {
            steps {
                sh 'mvn clean compile'
            }
        }
        stage('Test') {
            steps {
                sh 'mvn test'
            }
        }
        stage('Package') {
            steps {
                sh 'mvn package -DskipTests'
            }
        }
    }
    post {
        failure {
            // 发送通知
        }
    }
}
GitHub Actions
name: CI
on: [push, pull_request]
jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - name: Build
        run: mvn compile
      - name: Test
        run: mvn test
      - name: Package
        run: mvn package -DskipTests
GitLab CI
stages:
  - build
  - test
  - deploy

build:
  stage: build
  script:
    - mvn compile

test:
  stage: test
  script:
    - mvn test

deploy:
  stage: deploy
  script:
    - ./deploy.sh
  only:
    - main
8.3 流水线设计的工程原则
DRY 原则:提取公共步骤为模板或共享库。Jenkins 有 Shared Library,GitLab CI 有 extends 和 include,GitHub Actions 有 composite actions 和 reusable workflows。
单一职责:每个 stage 只做一件事。不要把编译、测试、部署写在同一个 stage 里。
幂等性:同样的流水线跑两次,结果应该一致。避免依赖外部可变状态。
安全性:敏感信息(密码、Token、密钥)通过平台提供的 Secret 管理机制注入,绝不要硬编码在流水线文件中。
九、安全与质量门禁
9.1 Shift Left 安全
传统的安全测试在开发完成后才执行,发现问题时修复成本已经很高。Shift Left 的理念是将安全测试尽可能左移到开发阶段:
传统模式:开发 → 测试 → 安全扫描(最后)→ 发现漏洞 → 修复成本高
Shift Left:开发 → 安全扫描(并行)→ 测试 → 修复成本低
流水线中应该集成的安全检查:
| 阶段 | 检查项 | 工具 |
|---|---|---|
| 编码阶段 | IDE 插件实时检查 | SonarLint、Snyk IDE Plugin |
| 代码提交 | Pre-commit hook | git-secrets、detect-secrets |
| 构建阶段 | 静态应用安全测试(SAST) | SonarQube、Checkmarx |
| 构建阶段 | 依赖扫描(SCA) | OWASP Dependency-Check、Snyk |
| 制品阶段 | 镜像扫描 | Trivy、Clair |
| 部署后 | 动态应用安全测试(DAST) | OWASP ZAP |
9.2 质量门禁设计
质量门禁不是"一刀切"的,应该根据项目阶段和风险等级设置不同的阈值:
# 示例:GitLab CI 中的质量门禁配置
quality_gate:
  stage: verify
  script:
    - mvn sonar:sonar
    - |
      # 等待 SonarQube 分析完成
      quality_status=$(curl -s "sonarqube/api/qualitygates/project_status?projectKey=myproject")
      if [ "$quality_status" != "OK" ]; then
        echo "质量门禁未通过,构建失败"
        exit 1
      fi
  rules:
    - if: $CI_MERGE_REQUEST_TARGET_BRANCH_NAME == "main"
      # 合并到 main 分支时强制检查
质量门禁的典型指标:
- 新增代码覆盖率 > 80%
- 阻断和严重问题 = 0
- 重复代码密度 < 3%
- 安全漏洞(Critical) = 0
十、度量与持续改进
10.1 CI/CD 核心指标
Google 的 DORA 团队定义了四个衡量软件交付效能的关键指标:
| 指标 | 定义 | 精英水平 | 中位水平 |
|---|---|---|---|
| 部署频率(DF) | 生产部署的频率 | 按需(每天多次) | 每周-每月 |
| 变更前置时间(LTC) | 从代码提交到生产上线的时间 | 小于 1 小时 | 1 天-1 周 |
| 变更失败率(CFR) | 导致服务降级的变更比例 | 0-15% | 16-30% |
| 失败恢复时间(MTTR) | 从故障发生到恢复的时间 | 小于 1 小时 | 1 天-1 周 |
10.2 流水线效率度量
除了 DORA 指标,还要关注流水线本身的效率:
- 流水线执行时间:从提交到获得 CI 结果的时间。应该控制在 10 分钟以内。
- 流水线成功率:流水线通过率。低于 80% 说明测试不稳定或者环境有问题。
- 队列等待时间:从提交到流水线开始执行的时间。如果这个时间很长,说明 CI 资源不足。
- Flaky test 比例:不稳定的测试占总测试的比例。超过 1% 就需要治理。
10.3 持续改进循环
CI/CD 不是一次性搭建就完事的,需要持续优化:
度量 → 分析瓶颈 → 改进 → 再度量
常见的优化方向:
- 并行化:将独立的 stage 并行执行
- 测试分层:将慢的测试拆分到单独的 stage,允许快速阶段先给反馈
- 资源扩容:增加 CI runner 数量
- 缓存优化:优化依赖缓存策略,减少重复下载
十一、CI/CD 工具链选型
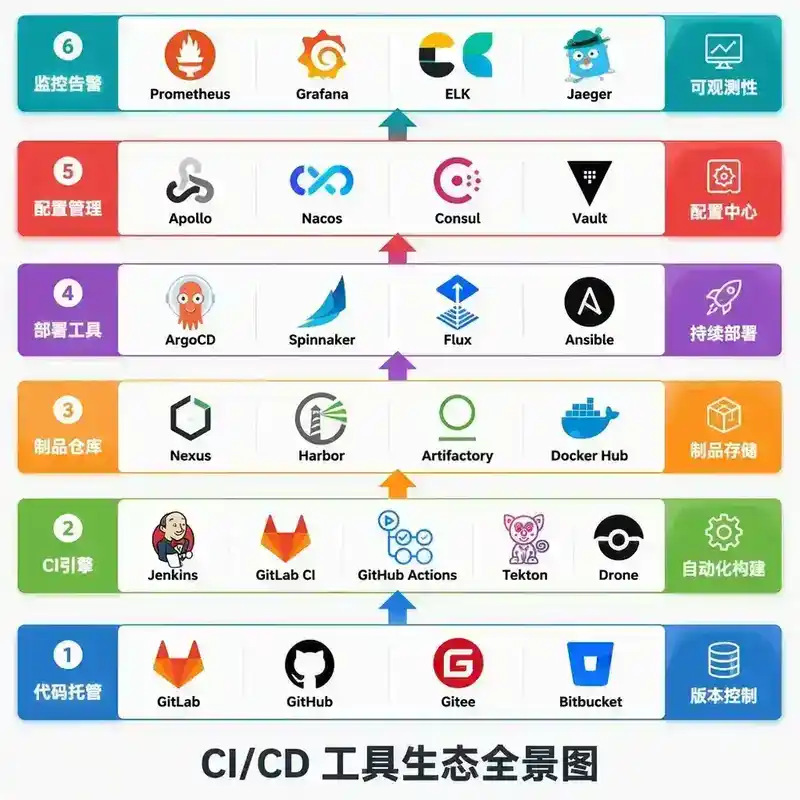
| 环节 | 工具选项 | 适用场景 |
|---|---|---|
| 代码托管 | GitLab、GitHub、Gitee、Bitbucket | - |
| CI 引擎 | Jenkins、GitLab CI、GitHub Actions、Tekton、Drone | Jenkins 最灵活但维护成本高;云原生优先 Tekton/Argo |
| 制品仓库 | Nexus、Artifactory、Harbor、Docker Hub | 企业内网用 Nexus/Harbor |
| 部署 | ArgoCD、Spinnaker、Flux、Ansible | K8s 环境首选 ArgoCD |
| 配置管理 | Apollo、Nacos、Consul、Vault | Vault 侧重密钥管理 |
| 监控告警 | Prometheus+Grafana、ELK、Jaeger | - |
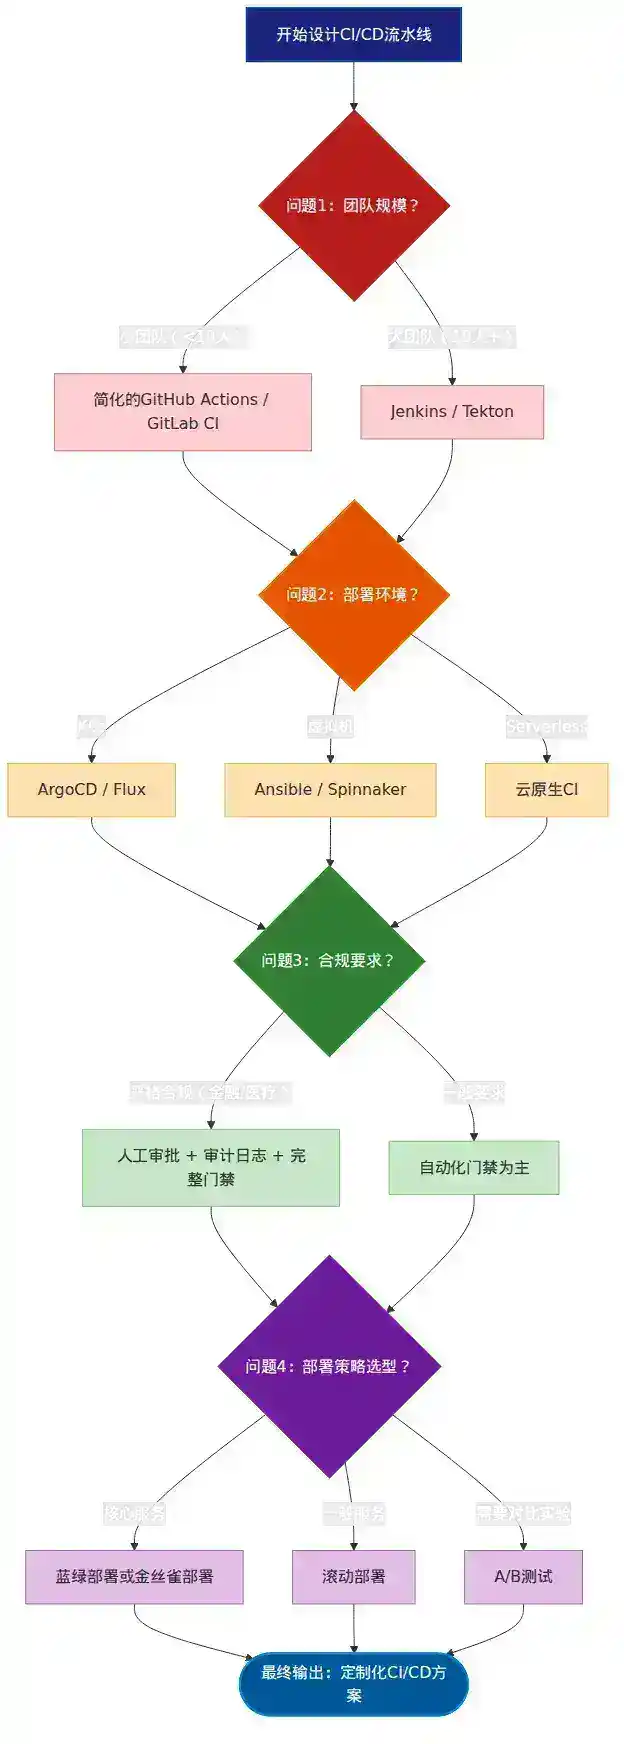
十二、实战:设计一个完整的 CI/CD 流水线
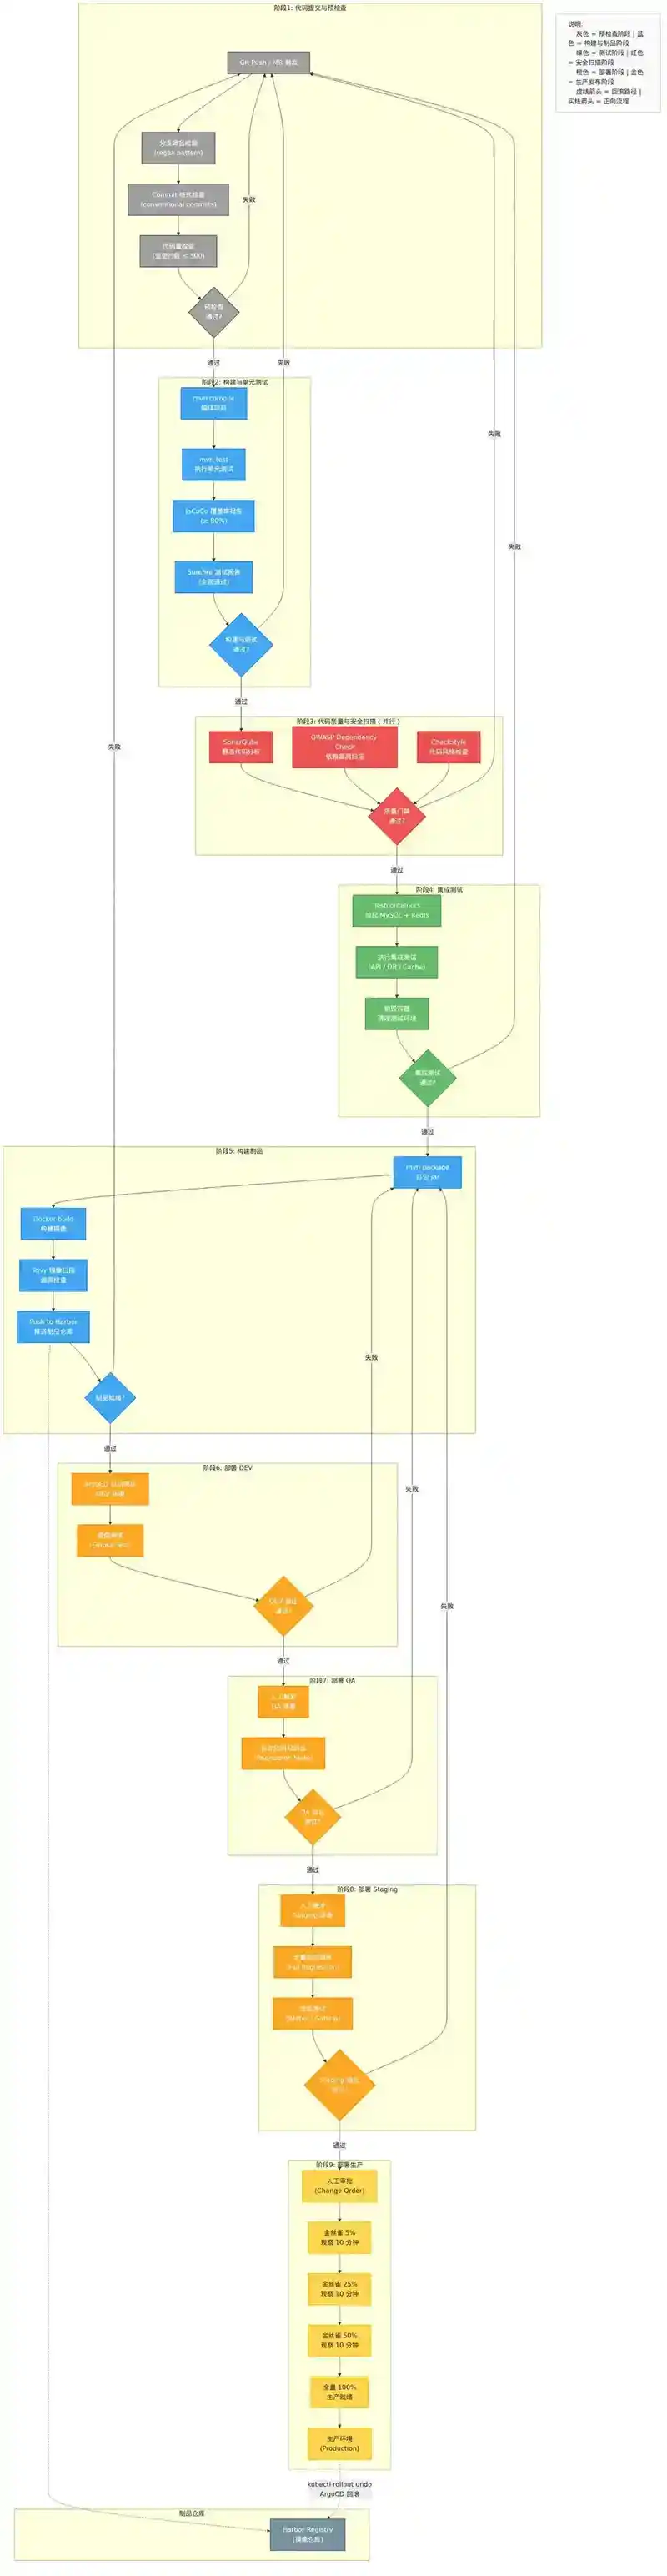
假设我们有一个 Spring Boot 微服务,部署在 K8s 上,我们来设计它的完整流水线:
阶段 1:代码提交与预检查
开发者 push → 触发流水线
  ├── 分支命名检查(feature/*, bugfix/*, hotfix/*)
  ├── Commit message 格式检查(conventional commits)
  └── 代码量检查(单次提交不超过 500 行,超大 MR 需要特殊审批)
阶段 2:构建与单元测试
mvn clean compile → 并行执行 → mvn test
  ├── JaCoCo 覆盖率报告
  └── Surefire 测试报告
阶段 3:代码质量与安全扫描
并行执行:
  ├── SonarQube 静态分析
  ├── OWASP Dependency-Check 依赖扫描
  └── Checkstyle 代码风格检查
阶段 4:集成测试
Testcontainers 拉起 MySQL + Redis → 执行集成测试 → 销毁容器
阶段 5:构建制品
mvn package -DskipTests → Docker build → Docker push to Harbor
  ├── 镜像标签:<version>-<build_number>-<commit_sha>
  └── Trivy 镜像扫描
阶段 6:部署到开发环境
ArgoCD 自动同步 → DEV K8s 集群 → 冒烟测试
阶段 7:部署到测试环境
人工触发 → QA K8s 集群 → 自动化回归测试
阶段 8:部署到预发环境
人工触发 → Staging K8s 集群 → 全量回归测试 → 性能测试
阶段 9:部署到生产环境
人工审批 → 金丝雀发布(5% → 25% → 50% → 100%)
  ├── 每个阶段观察 10 分钟
  ├── 监控错误率、延迟、CPU/内存
  └── 异常时自动回滚
回滚路径
生产异常 → 自动或人工触发回滚
  ├── kubectl rollout undo(K8s 滚动部署)
  └── 或切换 ArgoCD 指向上一个版本的 Git commit
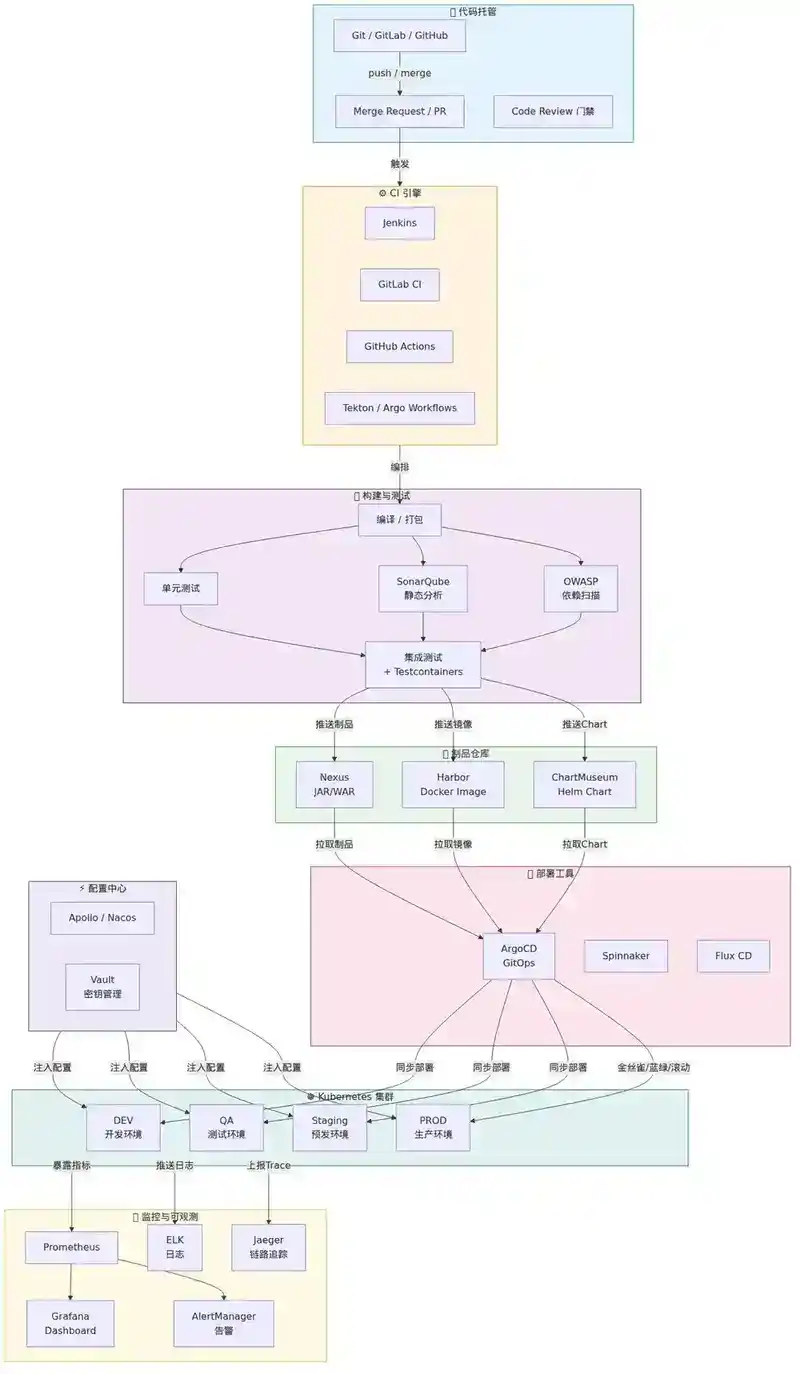
十三、常见反模式与避坑指南
反模式 1:流水线里写业务逻辑
流水线不是代码的延伸,不要把复杂的业务脚本放在流水线里。流水线应该只负责编排,复杂逻辑放到独立的脚本或工具中。
反模式 2:跳过测试
"这个改动很小,跳过测试吧"——这是最常见的导致生产故障的原因。流水线里的测试不是为了找茬,而是为了保护你。
反模式 3:人工步骤过多
流水线里每增加一个人工审批步骤,部署频率就降低一个数量级。应该用自动化门禁替代人工审批,人工审批只在真正需要判断的环节(如生产部署)保留。
反模式 4:环境不一致
"测试环境没这个问题"——多半是因为环境和生产不一致。用 Docker 镜像统一环境,用配置中心管理差异,用 Infrastructure as Code 管理基础设施。
反模式 5:把 Jenkins 当成 Cron 服务器
Jenkins 本质是 CI 引擎,不是定时任务调度器。定时任务应该用专门的调度系统(如 Airflow、XXL-Job)。
十四、总结
CI/CD 流水线的设计没有银弹。选择什么工具、采用什么策略,取决于你的组织规模、技术栈、合规要求和工程文化。但有一些原则是通用的:
- 一切皆代码:流水线、基础设施、配置都应该版本化
- 不可变制品:一次构建,到处部署
- 快速失败:测试按速度从快到慢排列,有问题尽快暴露
- 渐进式部署:永远不要一次性把所有流量切到新版本
- 可观测性驱动:没有监控的部署就是盲飞
- 持续改进:度量、分析、优化、再度量
记住:CI/CD 的目标不是"多快能部署",而是**"多安全、多可靠地交付价值"**。
面试官视角:CI/CD 高频提问
以下问题从面试官视角出发,考察候选人对 CI/CD 的深入理解而非表面记忆。回答这些问题需要结合工程实践经验。
Q1:你们的 CI/CD 流水线从代码提交到生产上线需要多长时间?你会如何缩短这个时间?
Q2:如果流水线中有一个测试不稳定(flaky test),经常随机失败,你会怎么处理?直接删除、跳过还是修复?
Q3:数据库 schema 变更如何集成到 CI/CD 流水线中?回滚时如何处理 schema 变更?
Q4:蓝绿部署和金丝雀部署在 K8s 上分别怎么实现?需要什么额外组件?
Q5:你的流水线中制品是不可变的吗?如果有人修改了配置但没有重新构建,制品和配置的对应关系如何保证?
Q6:多微服务环境下,如何设计流水线?每个服务独立流水线还是统一流水线?服务之间的依赖如何管理?
Q7:如果生产部署后发现严重 bug,你的回滚流程是什么?从发现问题到完全恢复,每一步需要多长时间?
Q8:如何确保流水线本身的安全性?如果流水线配置文件被恶意修改,会导致什么后果?
Q9:你们的 CI/CD 工具链选型是怎么考虑的?为什么选 Jenkins/GitLab CI/GitHub Actions?
Q10:你如何衡量 CI/CD 流水线的效果?有哪些关键指标?
本文覆盖了 CI/CD 流水线设计的核心领域:构建、测试、部署、回滚和制品管理。每个环节都可以单独深入——比如"制品管理"可以延伸到容器镜像构建优化、Helm Chart 模板设计、多集群分发等话题。建议结合你实际使用的工具链,在实验环境中搭建一个完整流水线,才能真正理解每个决策背后的权衡。
面试官视角:参考答案
以下参考答案从面试官评判标准出发,不仅给出正确方向,也标注了候选人常见的误区和加分项。
Q1:你们的 CI/CD 流水线从代码提交到生产上线需要多长时间?你会如何缩短这个时间?
评判要点:面试官想看的不是"10 分钟"或"1 小时"这个数字,而是你如何分析瓶颈、如何量化、如何优化。
参考答案:从提交到上线通常 15-30 分钟,瓶颈一般在测试阶段(集成测试和 E2E 测试)。缩短策略:① 测试并行化——将独立的测试套件拆分为多个 job 并行执行;② 分层反馈——单元测试 2 分钟出结果,集成测试 8 分钟,E2E 测试 15 分钟,让开发者尽早获得反馈;③ 缓存优化——依赖缓存(Maven/Gradle/npm)和构建产物缓存,将构建时间从 5 分钟降到 30 秒;④ 增量测试——只跑变更代码相关的测试,而非全量回归。常见误区:候选人只说"加机器"而不分析瓶颈在哪,说明缺乏工程思维。
Q2:如果流水线中有一个测试不稳定(flaky test),经常随机失败,你会怎么处理?直接删除、跳过还是修复?
评判要点:考察候选人对工程质量的敬畏心和实际处理能力。
参考答案:绝对不直接删除或跳过。处理流程:① 先隔离——将 flaky test 移到单独的 quarantine suite,不阻塞主流水线,但持续运行收集数据;② 分类分析——flaky test 通常有三类原因:测试间数据污染(共享状态未清理)、时间依赖(硬编码 sleep 或依赖系统时间)、外部依赖不稳定(网络/第三方服务);③ 修复——对于数据污染,引入测试隔离机制(每个测试用例独立的数据库/事务回滚);对于时间依赖,用 Clock abstraction 替代 System.currentTimeMillis();对于外部依赖,用 WireMock/Mountebank 模拟;④ 防线——引入 flaky test 自动检测(重复运行同一测试 10 次,全部通过才算通过)。加分项:提到 flaky test 是"狼来了"效应——频繁误报会让团队对 CI 失败不再敏感,这是比 flaky test 本身更大的问题。
Q3:数据库 schema 变更如何集成到 CI/CD 流水线中?回滚时如何处理 schema 变更?
评判要点:这是区分"会用工具"和"理解工程"的分水岭问题。
参考答案:Schema 变更通过 Flyway 或 Liquibase 管理,迁移脚本和代码放在同一个仓库,随应用一起部署。关键原则:① 迁移脚本和应用代码是同一个版本——不能出现"先部署代码再手动执行 SQL"的情况;② 迁移脚本必须是幂等的;③ 向后兼容优先——新增列给默认值,新增表没关系,但删除列/重命名列需要分阶段执行(Expand-Contract 模式)。回滚处理:向前回滚(roll-forward)优于向后回滚(roll-back)。向后回滚(undo 迁移脚本)风险极高——如果 v2 迁移已经写入了数据,v1 的 schema 装不下这些数据。正确做法是再写一个 v3 迁移脚本修复问题。常见误区:候选人说"回滚时执行反向迁移脚本",面试官会追问"如果 v2 迁移脚本插入了一千万条数据,反向迁移脚本怎么处理这些数据?"——答不上来说明没有生产经验。
Q4:蓝绿部署和金丝雀部署在 K8s 上分别怎么实现?需要什么额外组件?
评判要点:考察对 K8s 网络模型和部署原语的理解深度。
参考答案:蓝绿部署在 K8s 上的实现:创建两套完整的 Deployment + Service(blue-service 和 green-service),通过 Ingress/Gateway 指向当前活跃的 Service。切换时修改 Ingress 的 backend 指向(或修改 Service selector),K8s 原生不支持蓝绿部署的一键切换,需要 Argo Rollouts 或自行实现。金丝雀部署在 K8s 上的实现:需要 Service Mesh(Istio/Linkerd)或 Ingress Controller(Nginx Ingress 的 canary annotation)来实现流量分割。例如 Nginx Ingress:nginx.ingress.kubernetes.io/canary: "true" + canary-weight: "5" 实现 5% 流量到金丝雀版本。加分项:提到 Argo Rollouts 同时支持蓝绿和金丝雀两种策略,且与 K8s 原生资源(Deployment/Service)无缝集成,是目前 K8s 生态的最佳实践。
Q5:你的流水线中制品是不可变的吗?如果有人修改了配置但没有重新构建,制品和配置的对应关系如何保证?
评判要点:考察对"不可变基础设施"原则的理解和配置管理实践。
参考答案:制品是不可变的——Docker Image 构建后不再修改,配置通过 ConfigMap/配置中心(Apollo/Nacos)在运行时注入。制品和配置的对应关系通过以下方式保证:① 制品标签包含版本号和 commit SHA,配置版本单独管理(ConfigMap 的 resourceVersion 或配置中心的发布版本号);② 部署记录关联制品版本和配置版本——每次部署在 ArgoCD/Jenkins 中记录"制品 v1.2.0-345-a1b2c3d + 配置 v20240601-001"的组合;③ 配置变更也走流水线——修改配置中心的值需要通过 Git 仓库提交、CR、自动部署,而不是手动在配置中心 Web UI 上改。常见误区:候选人说"我们直接改配置中心,重启应用就生效"——面试官会追问"那你怎么知道当前生产环境用的是哪个版本的配置?出问题怎么回滚配置?"
Q6:多微服务环境下,如何设计流水线?每个服务独立流水线还是统一流水线?服务之间的依赖如何管理?
评判要点:考察对微服务架构下 CI/CD 复杂度的认识。
参考答案:每个服务独立流水线,但共享流水线模板(Jenkins Shared Library 或 GitHub Actions reusable workflow)。统一流水线(monorepo + 单一流水线)在超过 5 个服务后会成为瓶颈——任何服务的构建失败会阻塞所有服务。服务间依赖管理:① 契约测试(Contract Testing)——用 Pact 框架验证服务间的 API 契约,不需要真正启动依赖服务;② 端到端测试在独立的流水线中运行——不是每个服务的 CI 都跑全链路 E2E,而是定期(如每天)或合并到主干后触发 E2E 流水线;③ 版本兼容矩阵——明确每个服务的 API 版本兼容策略(向后兼容几个版本),避免"升级 A 服务必须先升级 B 服务"的耦合。加分项:提到"服务间依赖应该是一棵树,不是一张网"——如果部署服务 A 需要同时部署服务 B 和 C,说明架构设计有问题,不是 CI/CD 能解决的。
Q7:如果生产部署后发现严重 bug,你的回滚流程是什么?从发现问题到完全恢复,每一步需要多长时间?
评判要点:考察应急响应能力和对"恢复时间"的量化管理。
参考答案:完整的回滚流程:① 告警触发(0-1 分钟)——监控系统检测到错误率飙升,自动告警;② 问题确认(1-3 分钟)——值班人员确认是新版本导致的,而非外部依赖或基础设施问题;③ 决策(即时)——按"回滚决策清单"判断:错误率 > 1% 或 P99 延迟 > 2x baseline → 立即回滚;④ 执行回滚(1-5 分钟)——蓝绿部署:切换 Ingress backend(秒级);滚动部署:kubectl rollout undo(分钟级,取决于 Pod 启动时间);⑤ 验证恢复(1-2 分钟)——检查错误率、延迟、业务指标是否恢复正常;⑥ 事后复盘(事后)——分析根因、改进流程。总目标:从发现到恢复 < 10 分钟。关键点:回滚演练——每个月至少做一次回滚演练,确保流程真实可用。常见误区:候选人只说了"回滚代码",忽略了数据库和配置的回滚——多数故障不是代码 bug,而是配置错误或数据问题。
Q8:如何确保流水线本身的安全性?如果流水线配置文件被恶意修改,会导致什么后果?
评判要点:考察安全意识和纵深防御思维。
参考答案:流水线是攻击面的高价值目标——它有权访问源代码、制品仓库、K8s 集群和云资源。安全措施:① 流水线配置文件(Jenkinsfile/.github/workflows/*.yml)受分支保护——合并到 main 需要 CR 审批,不允许直接 push;② 敏感信息通过平台 Secret 管理(GitHub Secrets、Jenkins Credentials、Vault),绝不硬编码,且日志中自动脱敏;③ 最小权限原则——CI runner 的 ServiceAccount 只授予构建和部署所需的最小权限(如只能 push 到特定 namespace 的特定 registry);④ 流水线中执行的外部脚本必须来自受信任的仓库,防止供应链攻击;⑤ 流水线执行结果审计——谁在什么时间部署了什么版本到哪个环境,日志保留至少 90 天。被恶意修改的后果:攻击者可以注入恶意代码到制品中、窃取生产环境凭证、删除生产资源、篡改部署记录。加分项:提到 SLSA(Supply-chain Levels for Software Artifacts)框架,这是 Google 提出的软件供应链安全标准,从构建平台、源码、依赖、构建过程四个维度保障制品安全。
Q9:你们的 CI/CD 工具链选型是怎么考虑的?为什么选 Jenkins/GitLab CI/GitHub Actions?
评判要点:考察技术选型的工程思维——不是"哪个好"而是"为什么适合我们"。
参考答案:选型考量维度:① 团队规模与技能——Jenkins 最灵活但 Groovy 脚本维护成本高,适合 50+ 人的大团队有专职 DevOps 的情况;GitLab CI 和 GitHub Actions 上手快,适合中小团队;② 部署环境——如果主要部署在 K8s 上,Tekton/Argo Workflows 天然支持 K8s 原生资源;③ 合规要求——金融/医疗行业需要私有化部署,GitHub Actions 的 SaaS 模式不适合;④ 生态集成——GitHub Actions 的 Marketplace 有大量现成的 Action,GitLab CI 与 GitLab 生态(Issue、MR、Container Registry)紧密集成;⑤ 成本——自建 Jenkins 的机器成本和维护人力 vs SaaS 方案的订阅费用。我们的选择:GitLab CI(代码托管、CI、制品仓库、CD 一键打通,减少工具链碎片化)+ ArgoCD(K8s GitOps 部署)+ Harbor(镜像仓库)。常见误区:候选人只说"某某工具好用"而不分析团队上下文,说明缺乏工程判断力。
Q10:你如何衡量 CI/CD 流水线的效果?有哪些关键指标?
评判要点:考察数据驱动改进的工程文化。
参考答案:分两层指标——DORA 四大指标(业务层面)+ 流水线工程指标(效率层面)。DORA 指标:① 部署频率(目标:每天多次);② 变更前置时间(目标:< 1 小时);③ 变更失败率(目标:< 15%);④ 失败恢复时间(目标:< 1 小时)。流水线工程指标:① 流水线执行时间(P50/P95,目标 P95 < 10 分钟);② 流水线成功率(目标 > 90%);③ Flaky test 比例(目标 < 1%);④ 队列等待时间(目标 < 2 分钟);⑤ 构建缓存命中率(目标 > 80%)。关键实践:建立 CI/CD 效能看板,每周回顾趋势,发现劣化及时干预。加分项:提到"不要只关注速度,要关注稳定性"——部署频率从每周 1 次提升到每天 10 次,但如果变更失败率从 5% 升到 30%,这是倒退而不是进步。CI/CD 的终极目标是可靠地快速交付价值,不是单纯追求速度。
以上参考答案展示了面试官期望的深度:不仅知道"怎么做",更理解"为什么这样做"、"不这样做的后果"以及"在什么场景下选择什么方案"。建议结合自己的项目经验,用 STAR 法则(Situation-Task-Action-Result)准备每个问题的回答。