考点 220:接口 RT 突增排查——依赖、慢 SQL、GC、线程池、网络与流量变化阅读时间:约 40-50 分钟 | 难度:中高级
一、引言:RT 突增,生产环境的午夜凶铃
凌晨两点,告警电话响起:核心接口 P99 延迟从 200ms 飙升至 8 秒,用户投诉暴涨。你从床上弹起来,打开监控大盘,CPU、内存、网络看起来都正常——问题出在哪?
RT(Response Time,响应时间) 是衡量接口性能最核心的指标。它不是你调优出来的"最佳值",而是系统当前状态的真实投影。当 RT 突然飙升,意味着系统某个环节的平衡被打破了。
本文将从六个维度系统拆解 RT 突增的排查思路:依赖服务、慢 SQL、GC、线程池、网络、流量变化。每个维度都配有排查工具、典型案例和可落地的解决方案。
先建立认知:RT 的构成
客户端 → [DNS] → [负载均衡] → [应用服务器] → [依赖服务/数据库/缓存]
         |←──────────────── RT(端到端)─────────────────→|
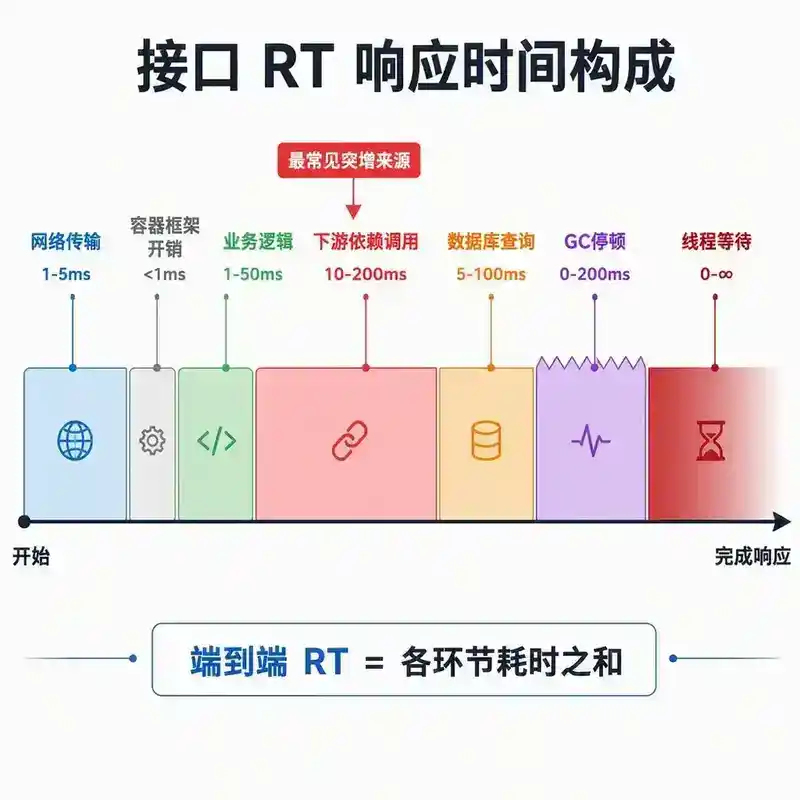
一个典型的 Java 微服务接口 RT 由以下部分组成:
| 环节 | 典型耗时 | 突增特征 |
|---|---|---|
| 网络传输 | 1-5ms | 跨机房/跨地域时暴涨 |
| 容器/框架开销 | <1ms | 基本稳定 |
| 业务逻辑 | 1-50ms | 随数据量/复杂度变化 |
| 下游依赖调用 | 10-200ms | 最常见突增来源 |
| 数据库查询 | 5-100ms | 慢 SQL 是主要元凶 |
| GC 停顿 | 0-200ms | 突刺型,间歇性 |
| 线程等待 | 0-∞ | 线程池满时指数级增长 |
二、排查方法论:先定位,再深入
RT 突增排查最大的陷阱是凭直觉直接跳到某个环节。经验丰富的工程师会遵循一套系统的方法论。
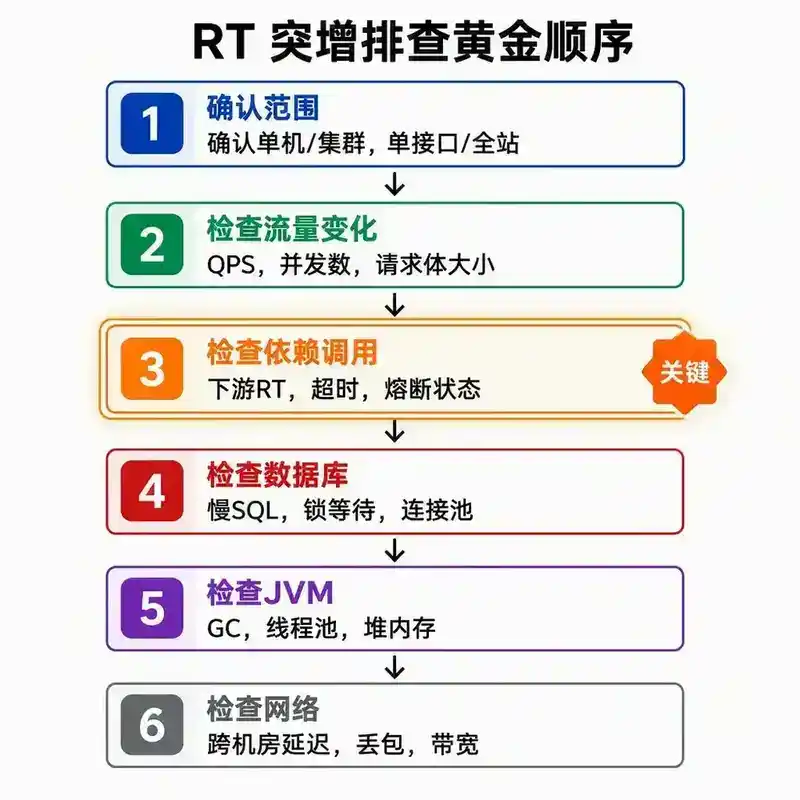
2.1 黄金排查顺序
第一步:确认范围(单机/集群?单接口/全站?)
第二步:检查流量变化(QPS、并发数、请求体大小)
第三步:检查依赖调用(下游 RT、超时、熔断状态)
第四步:检查数据库(慢 SQL、锁等待、连接池)
第五步:检查 JVM(GC、线程池、堆内存)
第六步:检查网络(跨机房延迟、丢包、带宽)
2.2 关键监控指标速查表
| 指标 | 工具 | 异常阈值 |
|---|---|---|
| 接口 RT(P50/P90/P99) | Prometheus + Grafana | 超过基线 2 倍 |
| QPS | 同上 | 突增/突降均需关注 |
| 错误率 | 同上 | >1% |
| 下游调用 RT | Skywalking/Jaeger | 超过超时阈值 50% |
| 慢 SQL 数量 | Druid/Skywalking | >10 条/分钟 |
| GC 停顿时间 | JVM 监控 | >100ms/次 |
| 线程池活跃线程 | Micrometer | 接近 corePoolSize |
| 网络延迟 | ping/tcpping | RTT > 10ms(内网) |
三、维度一:依赖服务——RT 突增的头号嫌疑犯
3.1 为什么依赖服务最容易出问题
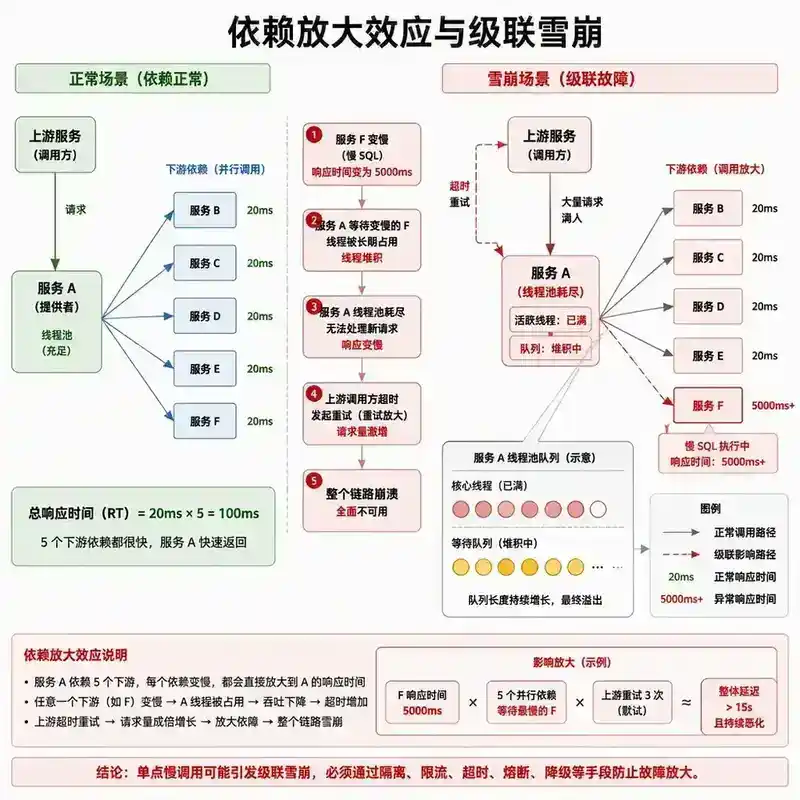
在微服务架构中,一个接口通常需要调用多个下游服务。假设你的接口依赖 5 个下游服务,每个超时 2 秒,最坏情况下(串行调用)RT 就是 10 秒。这就是依赖放大效应。
更隐蔽的是级联雪崩:下游服务 A 变慢 → 你的服务线程堆积 → 线程池耗尽 → 你的服务变慢 → 上游超时 → 整个链路崩溃。
3.2 排查步骤
第一步:看链路追踪
Spring Cloud Sleuth + Zipkin 或 Skywalking 是主力工具。关键看:
traceId: xxxxx
├── /api/order/create [8000ms] ← 你的接口
│   ├── userService.getUserInfo [50ms]   ← 正常
│   ├── inventoryService.checkStock [5000ms] ← 异常!通常 20ms
│   ├── couponService.queryCoupon [2000ms] ← 异常!通常 30ms
│   └── paymentService.createPayment [500ms] ← 正常
一眼定位:inventoryService 和 couponService 是主要耗时。
第二步:检查下游服务状态
# 查看下游服务的 RT 监控
# 关注:是否全集群变慢?还是个别实例慢?
# 个别实例慢 → 可能是宿主机问题、实例 Full GC、网络抖动
# 全集群慢 → 可能是数据库慢、上游流量冲击、配置变更
第三步:检查熔断和限流状态
// Sentinel Dashboard 或 Hystrix Dashboard 查看
// 关键指标:
// - circuitBreakerOpen:熔断器是否打开
// - flowControlRejected:是否被限流
// - threadPoolRejected:线程池是否拒绝
3.3 常见根因与解决方案
| 根因 | 表现 | 解决方案 |
|---|---|---|
| 下游慢 SQL | 依赖 RT 周期性飙升 | 推动下游优化 SQL |
| 下游 GC | 依赖 RT 呈毛刺状 | 推动下游 JVM 调优 |
| 下游线程池满 | 依赖 RT 指数增长 | 下游扩容或限流 |
| 超时设置不合理 | 请求堆积 | 设置合理的 connectTimeout/readTimeout |
| 未使用连接池 | 每次新建连接 | 使用 HttpClient 连接池 |
| 序列化开销大 | 响应体过大 | 按需返回字段、启用压缩 |
3.4 代码级防御
// 不好的做法:无限等待
RestTemplate restTemplate = new RestTemplate();
String result = restTemplate.getForObject(url, String.class); // 无超时

// 推荐做法:设置合理的超时和重试
@Bean
public RestTemplate restTemplate() {
    HttpComponentsClientHttpRequestFactory factory =
        new HttpComponentsClientHttpRequestFactory();
    factory.setConnectTimeout(2000);     // 连接超时 2s
    factory.setReadTimeout(5000);        // 读取超时 5s
    factory.setConnectionRequestTimeout(1000); // 从连接池获取连接超时 1s
    return new RestTemplate(factory);
}

// 更好的做法:使用 Resilience4j 增加熔断保护
@CircuitBreaker(name = "inventoryService", fallbackMethod = "inventoryFallback")
public InventoryDTO checkStock(String skuId) {
    // 实际调用
}
四、维度二:慢 SQL——数据库层面的性能杀手
4.1 慢 SQL 为什么会导致 RT 突增
数据库是绝大多数业务系统的瓶颈点。一条 SQL 从 20ms 变成 2000ms,不是逐渐变慢——它往往是一个突变。常见触发点:
- 数据量越过阈值:索引失效、全表扫描
- 锁竞争:大事务持有行锁/表锁
- 连接池耗尽:慢查询占满连接
- 统计信息过期:优化器选错执行计划
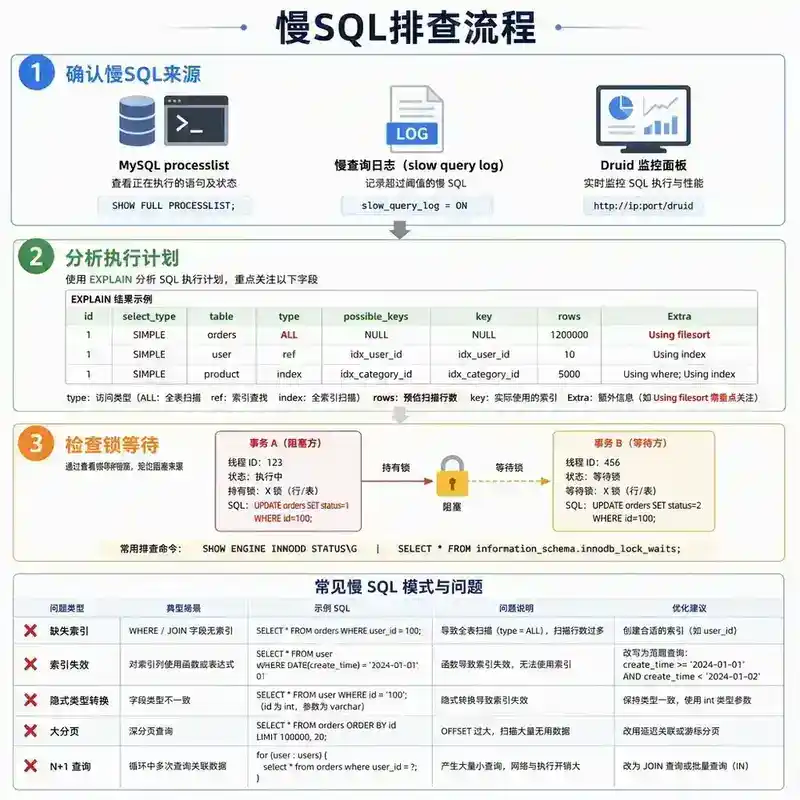
4.2 排查流程
第一步:确认慢 SQL 来源
-- MySQL:查看当前正在执行的慢查询
SHOW FULL PROCESSLIST;

-- 查看慢查询日志
-- my.cnf: slow_query_log=1, long_query_time=0.5
-- 或用 pt-query-digest 分析慢日志
pt-query-digest /var/log/mysql/slow.log

-- Druid 监控(Spring Boot 集成)
-- 访问 /druid/sql.html 查看 SQL 监控面板
第二步:分析执行计划
EXPLAIN SELECT o.*, u.name FROM orders o
JOIN users u ON o.user_id = u.id
WHERE o.create_time > '2024-01-01' AND o.status = 1;

-- 关键字段解读:
-- type: ALL(全表扫描)= 最差,ref/index = 较好,const = 最优
-- rows: 预估扫描行数,过大说明需要优化
-- Extra: Using filesort/Using temporary = 需要优化
-- key: 实际使用的索引,NULL = 未使用索引
第三步:检查锁等待
-- MySQL 8.0 查看锁等待
SELECT
    r.trx_id waiting_trx_id,
    r.trx_mysql_thread_id waiting_thread,
    r.trx_query waiting_query,
    b.trx_id blocking_trx_id,
    b.trx_mysql_thread_id blocking_thread,
    b.trx_query blocking_query
FROM information_schema.innodb_lock_waits w
JOIN information_schema.innodb_trx b ON b.trx_id = w.blocking_trx_id
JOIN information_schema.innodb_trx r ON r.trx_id = w.requesting_trx_id;
4.3 常见慢 SQL 模式与优化
| 模式 | 示例 | 优化 |
|---|---|---|
| 缺失索引 | WHERE user&#95;id = 123 无索引 |
添加 INDEX idx&#95;user&#95;id(user&#95;id) |
| 索引失效 | WHERE DATE(create&#95;time) = '2024-01-01' |
改为 WHERE create&#95;time &gt;= '2024-01-01' AND create&#95;time &lt; '2024-01-02' |
| 隐式类型转换 | WHERE phone = 13800138000(phone 是 VARCHAR) |
改为 WHERE phone = '13800138000' |
| 大分页 | LIMIT 100000, 20 |
游标分页:WHERE id &gt; last&#95;id LIMIT 20 |
| N+1 查询 | 循环中逐条查询 | 批量查询或 JOIN |
| 大事务 | 事务中夹杂 RPC 调用 | 拆小事务,RPC 放事务外 |
4.4 连接池排查
// 连接池是 RT 突增的常见放大器
// 慢 SQL → 连接持有时间变长 → 连接池耗尽 → 新请求等待连接 → RT 进一步恶化

// Druid 监控关键指标:
// ActiveCount:当前活跃连接数
// WaitThreadCount:等待获取连接的线程数 ← 关注这个
// 如果 WaitThreadCount > 0,说明连接池不够用
# 连接池配置建议
spring:
  datasource:
    druid:
      initial-size: 10
      min-idle: 10
      max-active: 50          # 不宜过大,MySQL 连接数有限
      max-wait: 3000          # 获取连接最大等待时间
      test-on-borrow: true    # 验证连接有效性
      validation-query: SELECT 1
      # 关键:慢 SQL 监控
      filter:
        stat:
          log-slow-sql: true
          slow-sql-millis: 1000
五、维度三:GC——JVM 内部的"暂停风暴"
5.1 GC 如何影响 RT
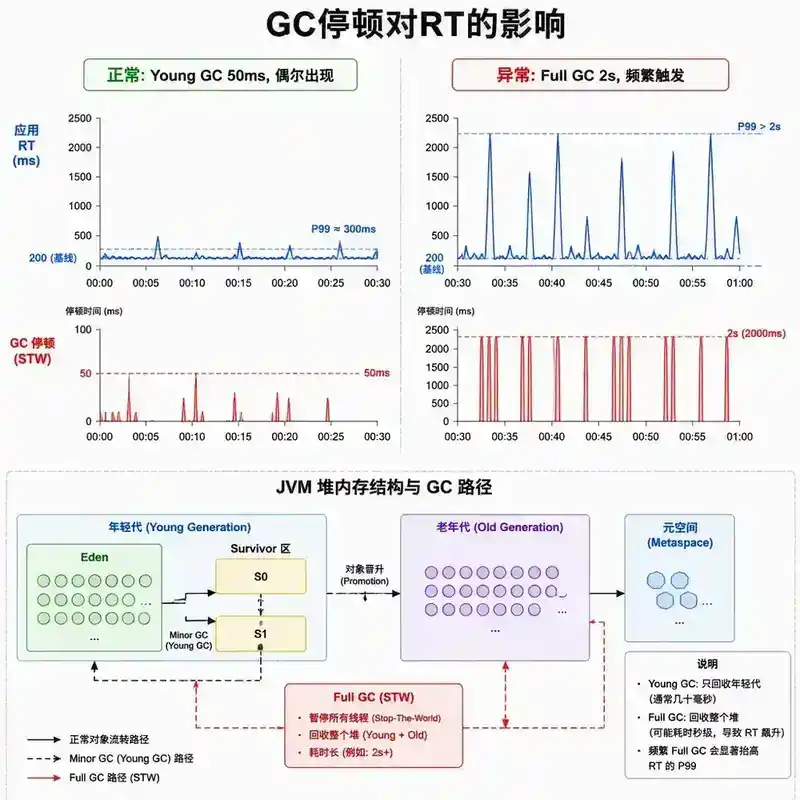
GC(Garbage Collection)是 JVM 自动内存管理的核心机制,但它有一个致命副作用:Stop-The-World(STW)。在 STW 期间,所有应用线程暂停,RT 因此增加。
RT 突增与 GC 的关联模式:
正常:RT 基线 200ms,GC 偶尔 50ms STW,P99 约 300ms
异常:Full GC 频繁,每次 2s STW,P99 飙升至 2s+
5.2 排查 GC 问题
关键 GC 指标:
# 查看 GC 日志(JDK 8)

- XX:+PrintGCDetails -XX:+PrintGCDateStamps -Xloggc:/path/to/gc.log


# 查看 GC 日志(JDK 11+)

- Xlog:gc*:file=/path/to/gc.log:time,level,tags


# 使用 jstat 实时查看
jstat -gc <pid> 1000 10   # 每秒打印一次,共 10 次

# 关键输出列:
# YGC/Full GC 次数
# YGCT/FGCT 总耗时
# GCT 总 GC 时间
分析 GC 日志的工具:
- GCViewer:可视化 GC 日志,直观看到停顿分布
- gceasy.io:在线分析,给出优化建议
- Arthas:
dashboard命令查看 GC 情况
5.3 常见 GC 问题与排查
| 问题 | 表现 | 排查方向 |
|---|---|---|
| Young GC 频繁 | 每秒多次,每次 10-30ms | 年轻代太小 / 对象分配速率过高 |
| Full GC 频繁 | 几分钟一次,每次 1-5s | 老年代太小 / 内存泄漏 / 大对象直接进入老年代 |
| 单次 GC 时间过长 | 偶尔出现,每次 5s+ | 堆内存过大 / 碎片化严重 |
| 晋升失败 | Full GC 后内存仍高 | 老年代空间不足,考虑扩容 |
5.4 GC 调优实战
# 典型 4C8G 应用的 GC 参数

- Xms4g -Xmx4g                    # 堆 4G,避免动态调整


- Xmn2g                           # 年轻代 2G(堆的一半)


- XX:+UseG1GC                     # 使用 G1(JDK 9+ 默认)


- XX:MaxGCPauseMillis=200         # 期望最大停顿 200ms


- XX:G1HeapRegionSize=4m          # Region 大小


- XX:InitiatingHeapOccupancyPercent=45  # 并发标记开始的堆占用阈值


- XX:+PrintGCDetails


- XX:+PrintGCDateStamps


- Xloggc:/var/log/app/gc.log


- XX:+UseGCLogFileRotation


- XX:NumberOfGCLogFiles=10


- XX:GCLogFileSize=100M


- XX:+HeapDumpOnOutOfMemoryError


- XX:HeapDumpPath=/var/log/app/heapdump.hprof
G1 调优核心思路:
- 设定合理的停顿目标:
MaxGCPauseMillis不是越短越好,太短反而导致 GC 频率增加 - 监控 Mixed GC:如果 Mixed GC 频繁且效果差,考虑增大
G1MixedGCLiveThresholdPercent - 关注 Humongous 对象:G1 对大对象(超过 Region 50%)不友好,避免创建超大对象
5.5 内存泄漏排查
# Step 1: 使用 jmap 导出堆转储
jmap -dump:live,format=b,file=/tmp/heap.hprof <pid>

# Step 2: 使用 MAT 或 JProfiler 分析
# 重点关注:Dominator Tree(支配树)中的大对象
# 常见泄漏模式:
# - ThreadLocal 未清理
# - 静态集合无限增长
# - 连接未关闭
# - 监听器未取消注册
六、维度四:线程池——并发能力的"隐形天花板"
6.1 线程池如何导致 RT 突增
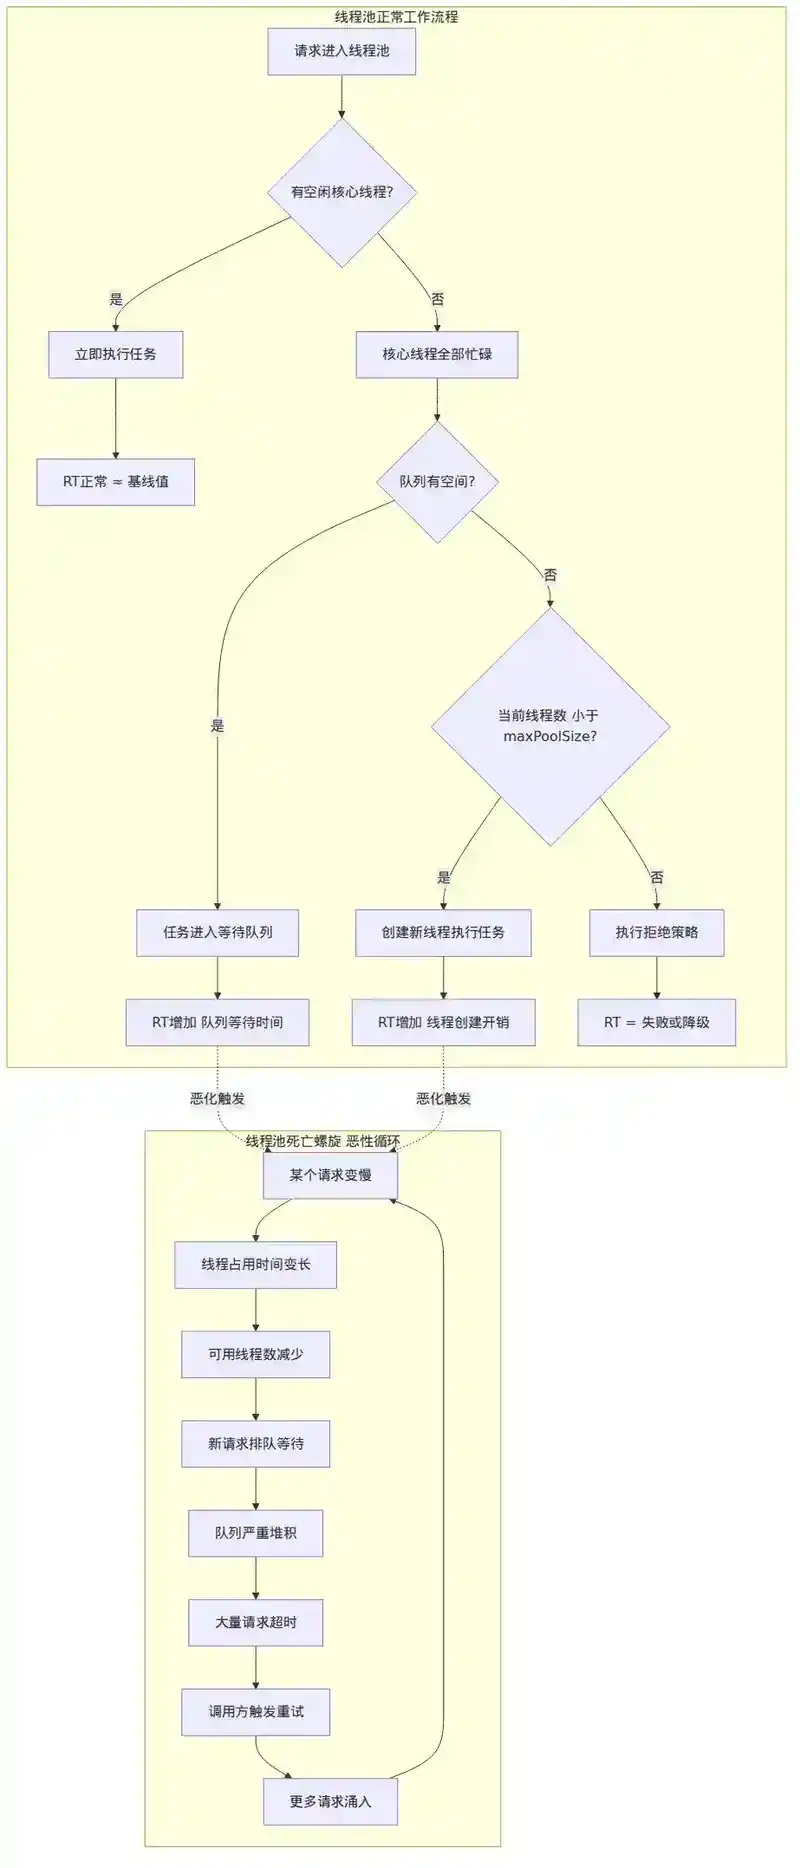
线程池是 Java 并发编程的基石,但配置不当会直接导致 RT 飙升:
请求进入 → 提交到线程池
  → 核心线程有空闲 → 立即执行(RT 正常)
  → 核心线程忙 → 进入队列等待(RT 增加队列等待时间)
  → 队列满 → 创建新线程到 maxPoolSize(RT 增加创建开销)
  → 线程也满 → 执行拒绝策略(RT = 失败或降级)
线程池的"死亡螺旋":
某个请求变慢 → 线程占用时间变长 → 可用线程减少
→ 新请求排队等待 → 队列堆积 → 请求超时
→ 调用方重试 → 更多请求涌入 → 线程池彻底崩溃
6.2 排查线程池问题
# Arthas 查看线程池状态
thread -b                    # 找出阻塞线程
thread -n 5                  # 最忙的 5 个线程
thread --state WAITING       # 查看 WAITING 线程

# 查看线程池 MBean
# 通过 jconsole 或 jmxterm 查看
# java.util.concurrent:type=ThreadPoolExecutor,name=*
# 关键属性:
# - ActiveCount:当前活跃线程
# - PoolSize:当前线程数
# - QueueSize:队列中等待的任务数 ← 最关键的指标
# - CompletedTaskCount:已完成任务数
# - RejectedCount:被拒绝的任务数
6.3 线程池配置原则
// 线程池配置:没有银弹,但有一套计算逻辑

// CPU 密集型任务
int cpuCore = Runtime.getRuntime().availableProcessors();
ThreadPoolExecutor cpuPool = new ThreadPoolExecutor(
    cpuCore + 1,           // corePoolSize
    cpuCore + 1,           // maxPoolSize(CPU 密集型不建超出核心数)
    60, TimeUnit.SECONDS,
    new LinkedBlockingQueue<>(1000),
    new ThreadPoolExecutor.CallerRunsPolicy() // 让调用线程执行,防止丢任务
);

// IO 密集型任务
ThreadPoolExecutor ioPool = new ThreadPoolExecutor(
    cpuCore * 2,           // corePoolSize
    cpuCore * 4,           // maxPoolSize
    60, TimeUnit.SECONDS,
    new LinkedBlockingQueue<>(5000),
    new ThreadPoolExecutor.CallerRunsPolicy()
);

// 更精确的公式(考虑阻塞系数):
// 线程数 = CPU核心数 * (1 + 平均等待时间 / 平均计算时间)
// 例如:8核CPU,平均等待时间 100ms,平均计算时间 20ms
// 线程数 = 8 * (1 + 100/20) = 48
6.4 线程池监控最佳实践
@Component
public class ThreadPoolMonitor {

    @Scheduled(fixedRate = 10000)
    public void monitorThreadPools() {
        for (Map.Entry<String, ThreadPoolExecutor> entry : pools.entrySet()) {
            ThreadPoolExecutor pool = entry.getValue();
            String name = entry.getKey();

            int active = pool.getActiveCount();
            int queue = pool.getQueue().size();
            long completed = pool.getCompletedTaskCount();
            int poolSize = pool.getPoolSize();

            // 告警条件
            if (active >= pool.getCorePoolSize() * 0.8) {
                log.warn("线程池[{}]活跃线程接近上限: active={}, core={}",
                    name, active, pool.getCorePoolSize());
            }
            if (queue > 100) {
                log.warn("线程池[{}]队列堆积: queue={}", name, queue);
            }

            // 上报到监控系统
            meterRegistry.gauge(name + ".active", active);
            meterRegistry.gauge(name + ".queue", queue);
        }
    }
}
七、维度五:网络——最容易被忽视的因子
7.1 网络问题为什么难排查
网络问题就像幽灵——时有时无,难以复现,且监控通常不覆盖网络层。但网络延迟对 RT 的影响是实打实的:
- 内网延迟 1-5ms:正常
- 跨可用区延迟 3-10ms:可接受
- 跨地域延迟 30-100ms:对 RT 影响显著
- 丢包或抖动:RT 出现毛刺,重试加剧问题
7.2 排查方法
# 基础连通性
ping -c 100 <目标IP>     # 查看 RTT 和丢包率

# TCP 层延迟(避免 ICMP 被限速)
tcpping <目标IP> <port>

# 路径追踪
traceroute <目标IP>

# 抓包分析(终极手段)
tcpdump -i eth0 -w /tmp/capture.pcap host <目标IP> and port <port>
# 然后用 Wireshark 分析:
# - TCP 重传率
# - TCP 窗口大小
# - 三次握手耗时
# - TLS 握手耗时

# 查看网络统计
netstat -s | grep -i retransmit   # TCP 重传统计
ss -ti                              # 查看每个连接的 TCP 信息(RTT、重传等)
7.3 网络优化策略
| 策略 | 说明 | 效果 |
|---|---|---|
| 同机房部署 | 依赖服务部署在同一机房 | 延迟降至 1-3ms |
| 连接池复用 | 避免频繁 TCP 握手 | 减少 1-3 次 RTT |
| HTTP/2 或 gRPC | 多路复用,减少连接数 | 减少连接开销 |
| 减少序列化体积 | 启用 gzip、使用 protobuf | 减少传输时间 |
| TCP 参数调优 | tcp_nodelay、keepalive | 减少小包延迟 |
7.4 网络问题的典型特征
正常 RT 分布:  [200ms, 210ms, 205ms, 198ms, 220ms, 215ms]  ← 稳定
CPU 问题 RT 分布:[200ms, 300ms, 280ms, 250ms, 350ms, 310ms]  ← 整体上移
GC 问题 RT 分布: [200ms, 200ms, 2000ms, 200ms, 200ms, 1800ms] ← 毛刺
网络问题 RT 分布:[200ms, 500ms, 200ms, 800ms, 200ms, 1000ms] ← 随机毛刺 + 部分超时

经验法则:如果你的 P50 很低但 P99 很高,且毛刺不规律,
不伴随 CPU/GC 变化,大概率是网络问题。
八、维度六:流量变化——最直接的触发因素
8.1 流量变化如何影响 RT
流量变化是 RT 突增最直接的触发因素,但常被误认为是"代码问题":
| 流量变化类型 | 对 RT 的影响 | 典型场景 |
|---|---|---|
| QPS 突增 | 线程池/连接池打满,请求排队 | 秒杀、大促、热点事件 |
| 请求体增大 | 序列化/反序列化耗时增加,带宽占用 | 批量导入、数据迁移 |
| 慢请求占比增加 | 少量慢请求拖垮线程池 | 大客户查询、报表导出 |
| 调用链变化 | 上游调用方式改变 | 从异步改为同步、增加了重试 |
8.2 排查方法
# 1. 查看 QPS 变化
# Prometheus: rate(http_requests_total[5m])

# 2. 查看请求体大小
# Nginx access log 中的 $body_bytes_sent
# 或通过 Skywalking 的请求体大小监控

# 3. 分析请求分布
# 是否有某个用户/某个接口的请求量突然大增?
# 是否有某个入参值导致慢查询?
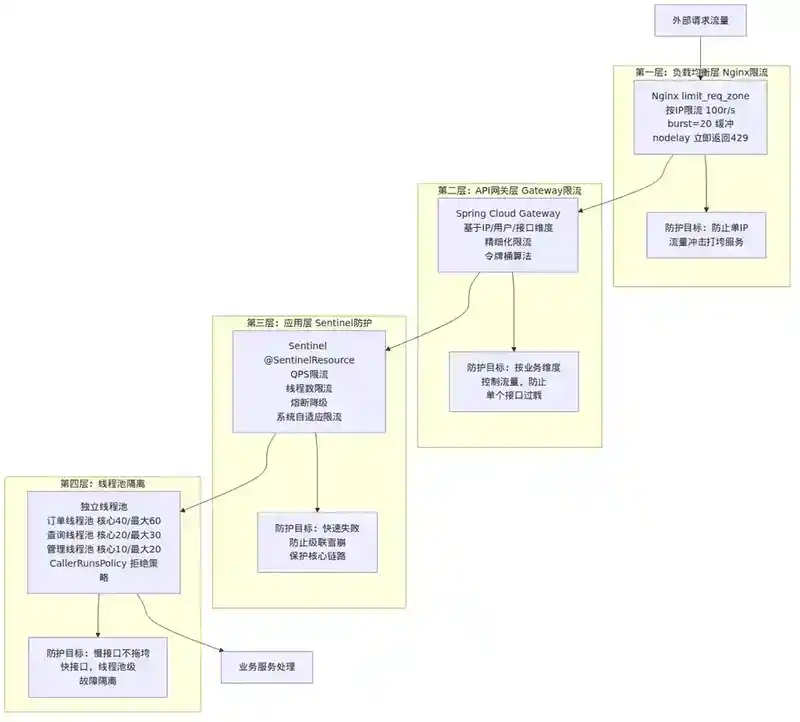
8.3 流量防护体系
// 多层次流量防护

// 第一层:负载均衡层限流(Nginx)
// limit_req_zone $binary_remote_addr zone=perip:10m rate=100r/s;
// limit_req zone=perip burst=20 nodelay;

// 第二层:网关层限流(Spring Cloud Gateway)
@Bean
public KeyResolver ipKeyResolver() {
    return exchange -> Mono.just(
        exchange.getRequest().getRemoteAddress().getAddress().getHostAddress()
    );
}

// 第三层:应用层限流(Sentinel)
@SentinelResource(value = "createOrder",
    blockHandler = "createOrderBlockHandler")
public OrderDTO createOrder(CreateOrderRequest request) {
    // 业务逻辑
}

// 第四层:线程池隔离(Hystrix 线程池隔离 / Sentinel 线程隔离)
// 将不同接口分配到不同线程池,避免慢接口拖垮快接口
九、实战案例:一次完整的 RT 突增排查
9.1 背景
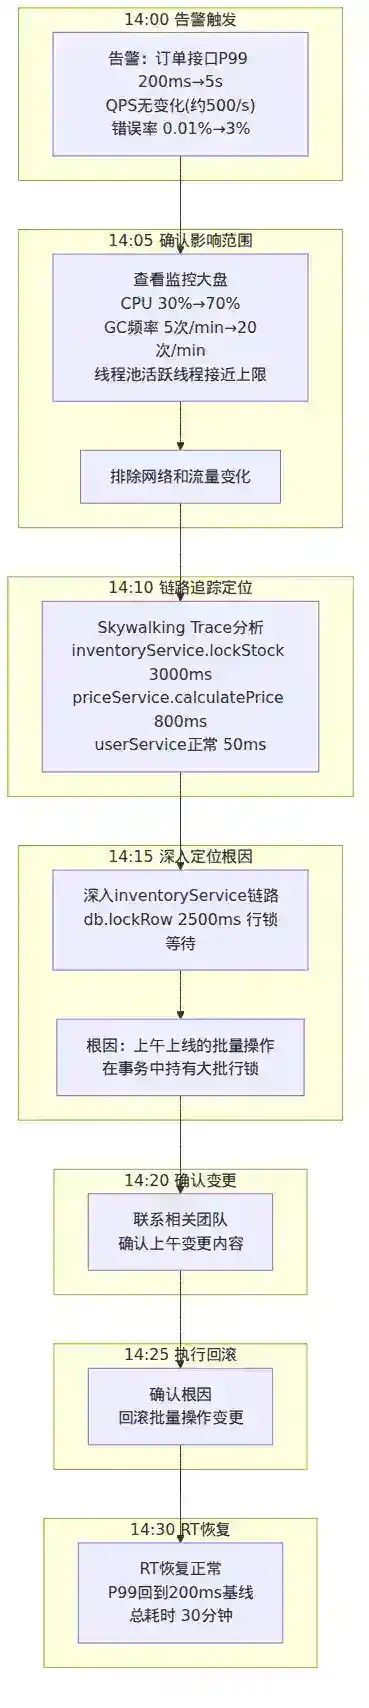
某电商系统,订单创建接口 /api/order/create 在 14:00 突然出现 RT 飙涨:
- 基线 P99:200ms
- 异常 P99:5000ms
- QPS 无明显变化(约 500/s)
- 错误率从 0.01% 升至 3%
9.2 排查过程
Step 1:看监控大盘
接口 RT  ↑ 从 14:00 开始飙升
CPU 使用率 ↑ 从 30% 升至 70%
GC 频率 ↑ Young GC 从 5次/min 升至 20次/min
线程池活跃线程 ↑ 接近 maxPoolSize
Step 2:看链路追踪
traceId: abc123
├── /api/order/create [5000ms]
│   ├── userService.getUserInfo [50ms]     ← 正常
│   ├── inventoryService.lockStock [3000ms] ← 异常!基线 50ms
│   ├── priceService.calculatePrice [800ms] ← 异常!基线 30ms
│   └── orderService.saveOrder [100ms]     ← 正常
Step 3:分析 inventoryService 慢的原因
进入 inventoryService 的链路追踪:
├── inventoryService.lockStock [3000ms]
│   ├── db.queryStock [30ms]        ← 正常
│   ├── db.lockRow [2500ms]         ← 异常!行锁等待
│   └── cache.updateStock [10ms]    ← 正常
Step 4:找到根因
db.lockRow 慢是因为当天上午上线了一个批量操作,该操作在事务中持有大批行锁,导致订单创建的库存锁定发生锁等待。
Step 5:解决
- 临时:将批量操作的事务隔离级别调整为 READ COMMITTED
- 长期:将批量操作拆分为小批量 + 每批独立事务
9.3 排查时间线
14:00 - 告警触发
14:05 - 确认影响范围,排除网络和流量变化
14:10 - 通过链路追踪定位到 inventoryService
14:15 - 深入 inventoryService 发现锁等待
14:20 - 联系相关团队确认变更
14:25 - 确认根因并回滚变更
14:30 - RT 恢复正常
总耗时:30 分钟
十、排查工具速查表
| 场景 | 工具 | 命令/入口 |
|---|---|---|
| 链路追踪 | Skywalking / Jaeger | Dashboard 查看 trace |
| 慢 SQL | Druid / 慢查询日志 | /druid/sql.html |
| JVM 实时诊断 | Arthas | dashboard / thread / jad |
| GC 分析 | GCViewer / gceasy.io | 上传 GC 日志 |
| 线程堆栈 | jstack | jstack &lt;pid&gt; &gt; thread.dump |
| 堆内存分析 | MAT / JProfiler | 分析 heap dump |
| 网络诊断 | tcpdump + Wireshark | 抓包分析 |
| 实时监控 | Prometheus + Grafana | 自定义 Dashboard |
| 日志聚合 | ELK / SLS | 关键字搜索 + 时间聚合 |
十一、总结:RT 突增排查的"心法"
11.1 排查优先级口诀
流量先看,依赖紧追,
SQL 慢查,GC 别漏,
线程池满,网络兜底。
11.2 建立事前防御体系
| 层次 | 措施 | 目的 |
|---|---|---|
| 代码层 | 超时设置、熔断降级、重试策略 | 防止依赖故障扩散 |
| 框架层 | 线程池监控、连接池监控、限流 | 感知系统容量 |
| JVM 层 | GC 日志、堆转储、JMX 监控 | 快速定位内存问题 |
| 基础设施 | 网络监控、数据库慢查询告警 | 覆盖底层问题 |
| 流程层 | 变更记录、灰度发布、回滚预案 | 快速止损 |
11.3 一句话总结
RT 突增排查的核心不是"找到问题",而是用最短时间缩小排查范围。建立完善的监控体系,让 90% 的问题在 5 分钟内定位到具体环节,剩下的 10% 才是真正需要深度排查的疑难杂症。
十二、面试问答
以下问题从面试官视角出发,考察对 RT 排查的系统性理解和实战经验。
Q1:线上某个接口的 P99 从 200ms 飙升至 5s,但 P50 几乎没变,最可能的原因是什么?
P50 不变但 P99 飙升,说明大部分请求正常,但存在少量长尾请求。最可能的原因:
- GC 停顿:Full GC 导致部分请求被 STW 停顿,P99 出现毛刺
- 网络抖动:部分 TCP 连接出现重传,导致个别请求延迟高
- 锁竞争:少量请求在数据库行锁或 JVM 锁上等待
- 线程池排队:峰值时刻线程池打满,少量请求排队等待
排查思路:先看 GC 日志(排除 GC),再看 P99 是否有规律(周期性 = GC,随机 = 网络),最后通过链路追踪看具体慢在哪个环节。
Q2:为什么说"下游服务变慢"是 RT 突增最常见的根因?请从架构角度解释依赖放大效应。
微服务架构中,一个接口通常需要调用多个下游服务。依赖放大效应体现在:
- 串行累积:如果接口串行调用 5 个下游,每个 200ms,RT 就是 1s。如果其中一个变慢至 5s,RT 就是 5.5s
- 线程池放大:下游变慢 → 线程占用时间变长 → 可用线程减少 → 新请求排队 → 排队时间叠加到 RT
- 重试放大:下游超时触发重试 → 请求量翻倍 → 下游压力更大 → 更慢 → 恶性循环
- 级联雪崩:你的服务变慢 → 上游超时 → 上游线程池满 → 上游也变慢 → 整个链路崩溃
这就是为什么一个底层服务的慢 SQL 可能导致整个产品页面不可用。
Q3:线程池的核心线程数你一般怎么设置?给你一个 8 核 CPU 的服务器,处理一个平均耗时 50ms(其中 I/O 等待 40ms)的接口,你会设置多大的线程池?
使用阻塞系数公式:
最优线程数 = CPU核心数 × (1 + 平均等待时间 / 平均计算时间)
本题:8 核,总耗时 50ms,IO 等待 40ms,计算时间 = 50 - 40 = 10ms
最优线程数 = 8 × (1 + 40/10) = 8 × 5 = 40
所以 corePoolSize 设为 40 左右。但实际还需要考虑:
- 数据库连接池大小:如果只有 20 个连接,40 个线程大部分在等连接
- 下游服务承载能力:40 个并发是否超过下游限制
- 内存开销:每个线程 1MB 栈空间,40 个线程 = 40MB
实际配置建议:corePoolSize=40, maxPoolSize=60, queue=1000,同时监控队列堆积情况动态调整。
Q4:G1 和 CMS 选哪个?什么场景下 G1 可能不如 CMS?
优先选 G1(JDK 9+ 默认),G1 的优势:
- 可预测的停顿时间(MaxGCPauseMillis)
- 自动碎片整理
- 大堆(>4G)表现优秀
G1 不如 CMS 的场景:
- 堆较小(<4G):G1 的 Remember Set 开销占比大,CMS 更轻量
- 低延迟要求极高(<10ms):G1 的 Mixed GC 可能仍有百毫秒级停顿,CMS 的并发标记+并发清除停顿更短(但 CMS 有碎片化问题和 Concurrent Mode Failure 风险)
- 大对象密集:G1 对超过 Region 50% 的 Humongous 对象处理笨拙
实际建议: JDK 11+ 用 G1 基本不会错,CMS 在 JDK 14 已被移除。如果 G1 满足不了延迟要求,考虑 ZGC 或 Shenandoah。
Q5:线上数据库突然出现大量慢查询,但 SQL 本身没有变化,执行计划也没变,可能是什么原因?
SQL 和执行计划都没变,但突然变慢,可能原因:
- 数据量变化:表数据量增长导致索引树层数增加,或扫描行数增大
- 锁竞争:其他事务持有行锁/间隙锁,导致当前查询等待
- Buffer Pool 命中率下降:其他查询占满 Buffer Pool,当前查询需要大量磁盘 I/O
- 连接数打满:数据库连接数接近上限,新查询需要排队
- 磁盘 I/O 瓶颈:宿主机其他进程抢占磁盘 I/O
- 统计信息与实际数据分布偏差:虽然执行计划看起来一样,但 optimizer 基于统计信息做的决策可能已经不准确
排查:先看 SHOW PROCESSLIST 确认是否有锁等待,再看 SHOW ENGINE INNODB STATUS 检查 Buffer Pool 命中率和锁情况,最后检查磁盘 I/O 和连接数。
Q6:你们的系统做了哪些 RT 突增的预防措施?如果让你从零搭建一套保障体系,你会怎么做?
已有措施:
- 全链路追踪(Skywalking),关键接口设置 RT 告警阈值
- 依赖服务熔断降级(Sentinel),核心链路有 fallback
- 慢 SQL 监控(Druid + 告警),超过 500ms 自动通知
- JVM 监控(GC 频率、堆内存、线程池),接入 Prometheus + Grafana
- 限流(Nginx + Sentinel),防止突发流量打垮系统
- 灰度发布,每次变更只影响 10% 流量,快速回滚
从零搭建的思路:
- 第一优先级:监控 —— 没有监控就没有排查依据。先上 APM(Skywalking),再补基础设施监控(Prometheus)
- 第二优先级:告警 —— 接口 RT 告警、错误率告警、慢 SQL 告警、GC 告警。告警要分级,避免告警疲劳
- 第三优先级:防御 —— 超时、熔断、限流、降级,防止故障扩散
- 第四优先级:演练 —— 定期做故障注入和混沌工程,验证防御体系是否有效
- 第五优先级:文档 —— 每次故障的排查过程形成文档,沉淀排查手册
📌 本文是"Java 技术专家与架构师面试:250 个高频考点"系列的第 220 篇。 下一篇预告:考点 221|分布式事务:2PC、TCC、Saga、消息最终一致性。